研报速递
艾瑞这份连续做了七年的行业研究报告,提供了一个相对冷静的视角。它把2024年中国人工智能产业的盘子量了出来——2697 亿元,同比增长 26.2%。这个数字不算小,但报告同时很坦诚地指出:增速比预期要低。
增速低,不代表行业没戏,而是说明钱没有想象中流得那么顺畅。这一期,我们就顺着这笔钱,追三个问题:它在产业的哪一层流动,流进了哪个行业的口袋,又是以什么方式流动的。搞清楚这三件事,企业才知道自己的投入该放在哪里。
一、盘子的真面目:2697 亿,但增速低于预期 |
|
2024年为什么没达到预期?报告给出了三个很实在的原因。
● 大模型在真实业务场景里的表现,还没有完全满足客户的需求。演示效果好,不等于放到生产环境里就稳。很多客户试过之后,发现离“能放心用”还有距离。
● 建设成本高。上一个项目,不只是买模型,还要在数据基础、算力资源、组织机制上投入不少,很多企业算完账,选择先停在探索阶段。
● 模型调用费用持续下降。这听起来是好事,但对市场规模的统计来说,单价降了,同样的用量对应的金额就少了,数字自然涨得慢。
这三条放在一起看,其实说明了一件事:2024年不是需求不足,而是“供需之间还没对上”。客户想要能直接解决业务问题的方案,供应商还在打磨产品;价格在降,但客户对效果的信任还没建立起来。这个错位,恰恰是2025年被 DeepSeek 打破的起点。
二、钱在三个层之间怎么流 |
要看清钱流向哪里,先得看清产业的骨架。艾瑞把整个产业分成三层:基础层(算力、数据、算法)、模型层与工具层(大模型、开发平台、智能体平台)、应用层(AI+金融、医疗、工业、政务、零售等)。
钱在这三层里的分布,很能说明问题。从2024年的投融资数据看,语言及多模态赛道最受资本青睐,全年融资事件193起,遥遥领先;视觉模态80起,基础层76起,机器人40起,自动驾驶28起。而在基础层内部,AI 芯片类投资占比超过一半。
一个值得琢磨的流向 钱优先流向的,不是离客户最近的应用层,而是离“卡位”最近的基础层和模型层——芯片、算力、大模型。原因不难理解:应用可以有很多家,但底层能力一旦卡住,整条链都要看它的脸色。这和企业经营的道理一样:越靠近上游、越难被替代的环节,越先拿到钱。 |
但报告也提醒,这种流向并不均衡。应用层虽然项目多,单个项目的金额却普遍不大,大量企业还在“跑马圈地”,靠低价和投流抢位置。这构成了2024年中国 AI 产业最真实的一幅图景:上游热闹,下游拥挤,中间还在找平衡。
三、算力的过山车:从短缺,到闲置,再到推理爆发 |
2023 年 | 短缺:抢卡、囤卡 “百模大战”推高训练算力需求,叠加芯片出口管制,算力一度供不应求,出现囤卡抢卡的现象。 |
2024 年 | 过剩:部分地区智算中心闲置 前期布局的算力陆续到位,训练需求却放缓,部分智算中心出现闲置。于是“算力是否投资过剩”成了热门话题。 |
2025 年 | 回暖:推理需求爆发 DeepSeek 系列开源模型带动应用落地,推理侧算力需求大幅上涨,智算中心的利用率有望逐步提高。 |
报告对2024年“算力闲置”的解释,很值得管理者细读:这不是简单的建多了,而是供需错配。一些地方的算力规划脱离了当地产业的实际需求,供给侧跑在了需求侧前面;与此同时,真正能用的高性能算力,其实一直紧缺。
2025年初的一个细节,把这种转变说得很清楚。DeepSeek 发布开源模型后,英伟达股价单日跌幅接近20%。这不是因为算力不重要了,而是因为算法优化显著降低了训练成本,削弱了对进口高端显卡的依赖。报告的原话是:中国基于算法优化与技术创新,进一步突破了模型层性能表现,增强了产业自主可控的能力。
算力这件事,从来不是“越多越好”,而是“用得上才好”。建了一堆没人用的算力,是成本;建了刚好够用、还能持续产生价值的算力,才是资产。这条道理,放在企业的任何一项投入上都成立。 |
四、B 端:项目制是主战场,谁在掏钱 |
看完了上游,再看离钱最近的地方。2024年,B端(企业和政府客户)仍然是大模型变现的主战场,主要方式是项目制。招投标数据能说明很多问题:这一年,中国大模型中标项目的数量和金额都在快速增长。
钱主要流进了哪些行业?报告给出了两组分布:
行业 | 项目数量占比 | 项目金额占比 |
政务 | 11% | 34.6% |
教科 | 25% | 15.9% |
能源 | 11% | 11.1% |
通信 | 26% | 11.0% |
金融 | 9% | 3.7% |
其他 | 17% | 23.5% |
这张表读起来很有意思。通信和教科的项目数量最多,但单笔金额不大;政务项目数量只占11%,金额却占了三分之一还多——说明政务项目是典型的“大单、少数”。金融虽然项目不少,金额占比却不高,反映出金融行业对数据安全和合规的要求更高,落地更谨慎。
供给这一侧,中标的主力是科大讯飞、百度、智谱、火山引擎、阿里云、腾讯云等。2025年初 DeepSeek 开源之后,又带动了一轮新的合作浪潮,基础层、平台层、应用层纷纷接入。
项目制的两面性项目制的好处是收入确定、见效快,一笔合同签下来,收入就落了袋;坏处是难以规模化、难以沉淀,做完一个项目,团队要重新去谈下一个。这也是为什么报告把“按效果付费”“订阅制”列为值得关注的新模式——它们能改变收入曲线的形状。 |
五、C 端:热闹是真的,赚钱是另一回事 |
2024年,国内大模型厂商打了一场很激烈的价格战。字节跳动把大模型的计价单位从“分”降到“厘”,对外宣称价格比同行低99%;阿里云通义千问最高降价97%;百度宣布两款主力大模型免费。到了C端,各家又开启买量投流,据公开报道,仅2024年10月,kimi、豆包、腾讯元宝等应用的广告投放支出就超过了3亿元。
价格战和投流,换来了用户,却没有换来稳定的收入。报告判断得很直接:大多数 C 端 AI 产品仍面临用户黏性不足、收费持续性不足的问题,产品形态尚未稳定,生态壁垒尚未建立。换句话说,C端是一个流量生意,谁都能进来,谁也留不住谁。
C 端和 B 端,是两种不同的生意 C端讲的是流量和规模,靠免费吸引用户,再靠订阅、增值服务慢慢转化,考验的是产品体验和运营能力;B端讲的是价值和交付,靠解决具体业务问题收钱,考验的是行业理解和交付能力。用做C端的思路做B端,往往赚不到钱;用做B端的思路做C端,往往留不住人。企业想切入 AI,得先想清楚自己做的是哪一种。 |
六、工具层:淘金热里,卖铲子的先赚到钱 |
大模型训练越来越依赖分布式,于是出现了 DeepSpeed、Megatron、Colossal-AI 这类分布式开发框架;模型的生命周期管理越来越复杂,MLOps 就分化出了专门面向大模型的 LLMOps 平台;而为了让企业不用从零搭建,厂商又推出了一体机,把硬件和软件打包在一起。
一体机这门生意,在2024年之后的走热,很值得注意。它以 DeepSeek 这类开源模型为核心,具备开源部署、本地化应用(保障数据隐私)、低成本、可快速定制的特点,精准满足政府、金融、医疗、工业制造这些对数据安全要求高的行业。报告预计,2025年适配 DeepSeek 的一体机市场会进一步升温。
淘金热里,最先赚到钱的,往往不是挖金子的人,而是卖铲子、卖水的人。AI 这一轮也一样——当所有人都在抢着做应用时,那些提供开发框架、部署平台、一体机的公司,反而先把钱赚稳了。 |
七、2024 的教训与 2025 的转折 |
把前面几条串起来,2024年其实给行业上了一堂很实在的课:光有技术不够,得让客户算得过账。大模型性能在提升,但如果落地成本高、见效慢,客户就会停在“试一试”的阶段。
2025年初,DeepSeek 的出现,恰好把这个结打开了一道口子。它通过结构化稀疏注意力、混合专家系统等算法优化,显著降低了训练成本,也让推理的成本大幅下降。更重要的是,它选择了开源。
开源带来的连锁反应是深远的。一方面,中小企业终于用得起大模型了,不用再从零训练;另一方面,围绕开源模型的微调、蒸馏、RAG 等落地路径迅速成熟——企业可以根据自己的业务,选一条成本最低、效果最合适的技术路线。报告把这条路径讲得很清楚:不是每个企业都要自己训练模型,更多企业需要的是“用好别人的模型”。
2697亿元 2024 年中国 AI 产业规模同比增长 26.2% | 32.1% 2025 至 2029 年预计年复合增长率 | 1万亿 2029 年产业规模预计突破 |
八、2026 年的三个判断 |
判断一:政策把方向和时间表都摆出来了
国务院《关于深入实施“人工智能+”行动的意见》、国务院办公厅《关于适应人工智能技术发展助力构建就业友好型发展方式的意见》等文件,从产业方向、应用场景、人才支撑等角度给出了明确部署。政策的意义,不只是给钱、给项目,更是给了一个相对确定的预期——哪些方向被鼓励,哪些边界要注意。对企业的含义是:跟着政策的方向走,试错成本会更低。
判断二:智能体从“概念”走向“可交付”
报告提到,MCP 等智能体开发协议及工具逐渐成熟,让智能体产品“可自主完成复杂任务”的实用性明显提升。到了2026年,智能体已经不只是发布会上的演示,而是开始被真正部署进业务流程。这意味着企业采购的对象,正在从“一个模型”变成“一个能干活的角色”,考核方式也要跟着调整。
判断三:具身智能成为下一个战略高地
报告把具身智能称为“连接数字智能与物理世界的关键技术,是下一代 AI 竞争的战略高地”。它的发展,需要解决硬件加速、软件优化、跨行业生态协作等一系列挑战。对制造、物流、零售这些有大量物理作业的行业来说,这个方向值得提前关注,但不必急着All in——它离大规模商用,还有一段路要走。
九、给企业的判断:钱该往哪里投 |
第一 | 先判断你处在产业链的哪一层。 是做基础能力(算力、芯片),做模型与工具,还是做应用?三层生意的逻辑完全不同:基础层拼的是投入和壁垒,模型层拼的是技术和生态,应用层拼的是场景和交付。先想清楚自己是谁,再谈投多少。 |
第二 | 优先投“能算清账”的环节。 报告里B端项目制之所以能成,是因为它能对应到具体的业务价值和预算科目。如果你要投的环节,说不清能省多少钱、提多少效,那它大概率会停在试点阶段。 |
第三 | 善用开源与工具,别什么都自己造。 DeepSeek 的启示是,不是每个企业都要自己训练模型。用成熟的开源模型,加上微调、RAG、一体机这些现成的工具,能以低得多的成本,跑出可用的方案。 |
第四 | 把“项目制”慢慢变成“可持续的能力”。 项目做完就结束,能力却可以沉淀。每做完一个项目,问一句:这次跑通的方法、积累的数据、培养的人,能不能复用到下一个场景?能复用,才叫资产。 |
第五 | 别忽视“人”这一层。 报告反复提到,落地难不只是技术问题,还有组织机制和人才的问题。系统可以买,但把系统用出效果的能力,买不来。这一条,往往是最容易被低估、却最决定成败的。 |
十、落到具体角色:你在这一段上要做什么 |
各位总经理、副总经理 您要决定的,是企业在 AI 产业链上站哪个位置、投多少、用什么节奏。建议先做一件事:把公司现有的 AI 相关投入盘一遍,看它们分别落在基础、模型还是应用层,是不是都在为同一个目标服务。报告提醒我们,2024年很多项目停在探索阶段,原因不是技术不行,而是没算清账。所以今年定投入时,先把验收口径定下来,比先把预算批下来更重要。 |
各位人力资源负责人 产业在变,岗位也在变。三件事值得排进计划:一是看清哪些岗位的工作内容正在被改写,尤其是数据分析、客服、内容、初级技术这类重复性强的岗位;二是补上“既懂业务又懂 AI”的复合人才,这类人现在最稀缺;三是把培养体系跑起来,让现有队伍逐步具备用 AI 的能力,而不是一味从外面挖人。 |
各位业务条线负责人 无论您管的是生产、销售还是供应链,都可以先问一句:我这条线上,哪个环节最费人、最重复、最容易算出效果?从那里切入,用现成的工具和开源模型,先跑一个小项目,把账算清楚,再谈扩大。别一上来就追求“全流程智能化”,那往往是最容易失败的做法。 |
各位财务、采购负责人 这一年,AI 的采购逻辑在变。建议在评估方案时,重点看三件事:能不能按用量或效果计价、能不能复用现有工具、供应商所在赛道是不是已经跑出稳定收入。这三点,能帮你避开那些“听起来很美、算起来很贵”的项目。 |
读完整份报告,我最想强调的一点是:中国 AI 产业的钱,并没有消失,它只是在重新找位置。2024年增速低于预期,不是行业退潮,而是从“讲故事”转向“算账”的必经阶段。那些能把技术变成可计量价值的环节,正在慢慢把钱吸过去。
对企业的启发也很清楚:不要被宏大的数字迷住,也不要被暂时的低增速吓退。真正该做的,是看清自己所在的这一层、这一个环节,然后老老实实地回答一个问题——我这笔投入,能不能算清楚它带来的价值。能,就投;不能,就先想清楚再投。
产业的钱流向哪里,最终取决于价值在哪里被创造出来。这句话,放在2024年成立,放在2026年,依然成立。
一个产业真正的成熟,不是看它的规模有多大,而是看它的每一笔钱,都能说清楚花在了哪里、换回了什么。中国 AI 产业,正在走完这一步。 |
如果这篇对你有启发,欢迎点赞、在看,或转发给同样在判断 AI 投入的同行。 |
你所在的企业,今年的 AI 预算主要投在了哪一层?是买算力、买模型,还是做应用?欢迎在评论区聊聊。 |
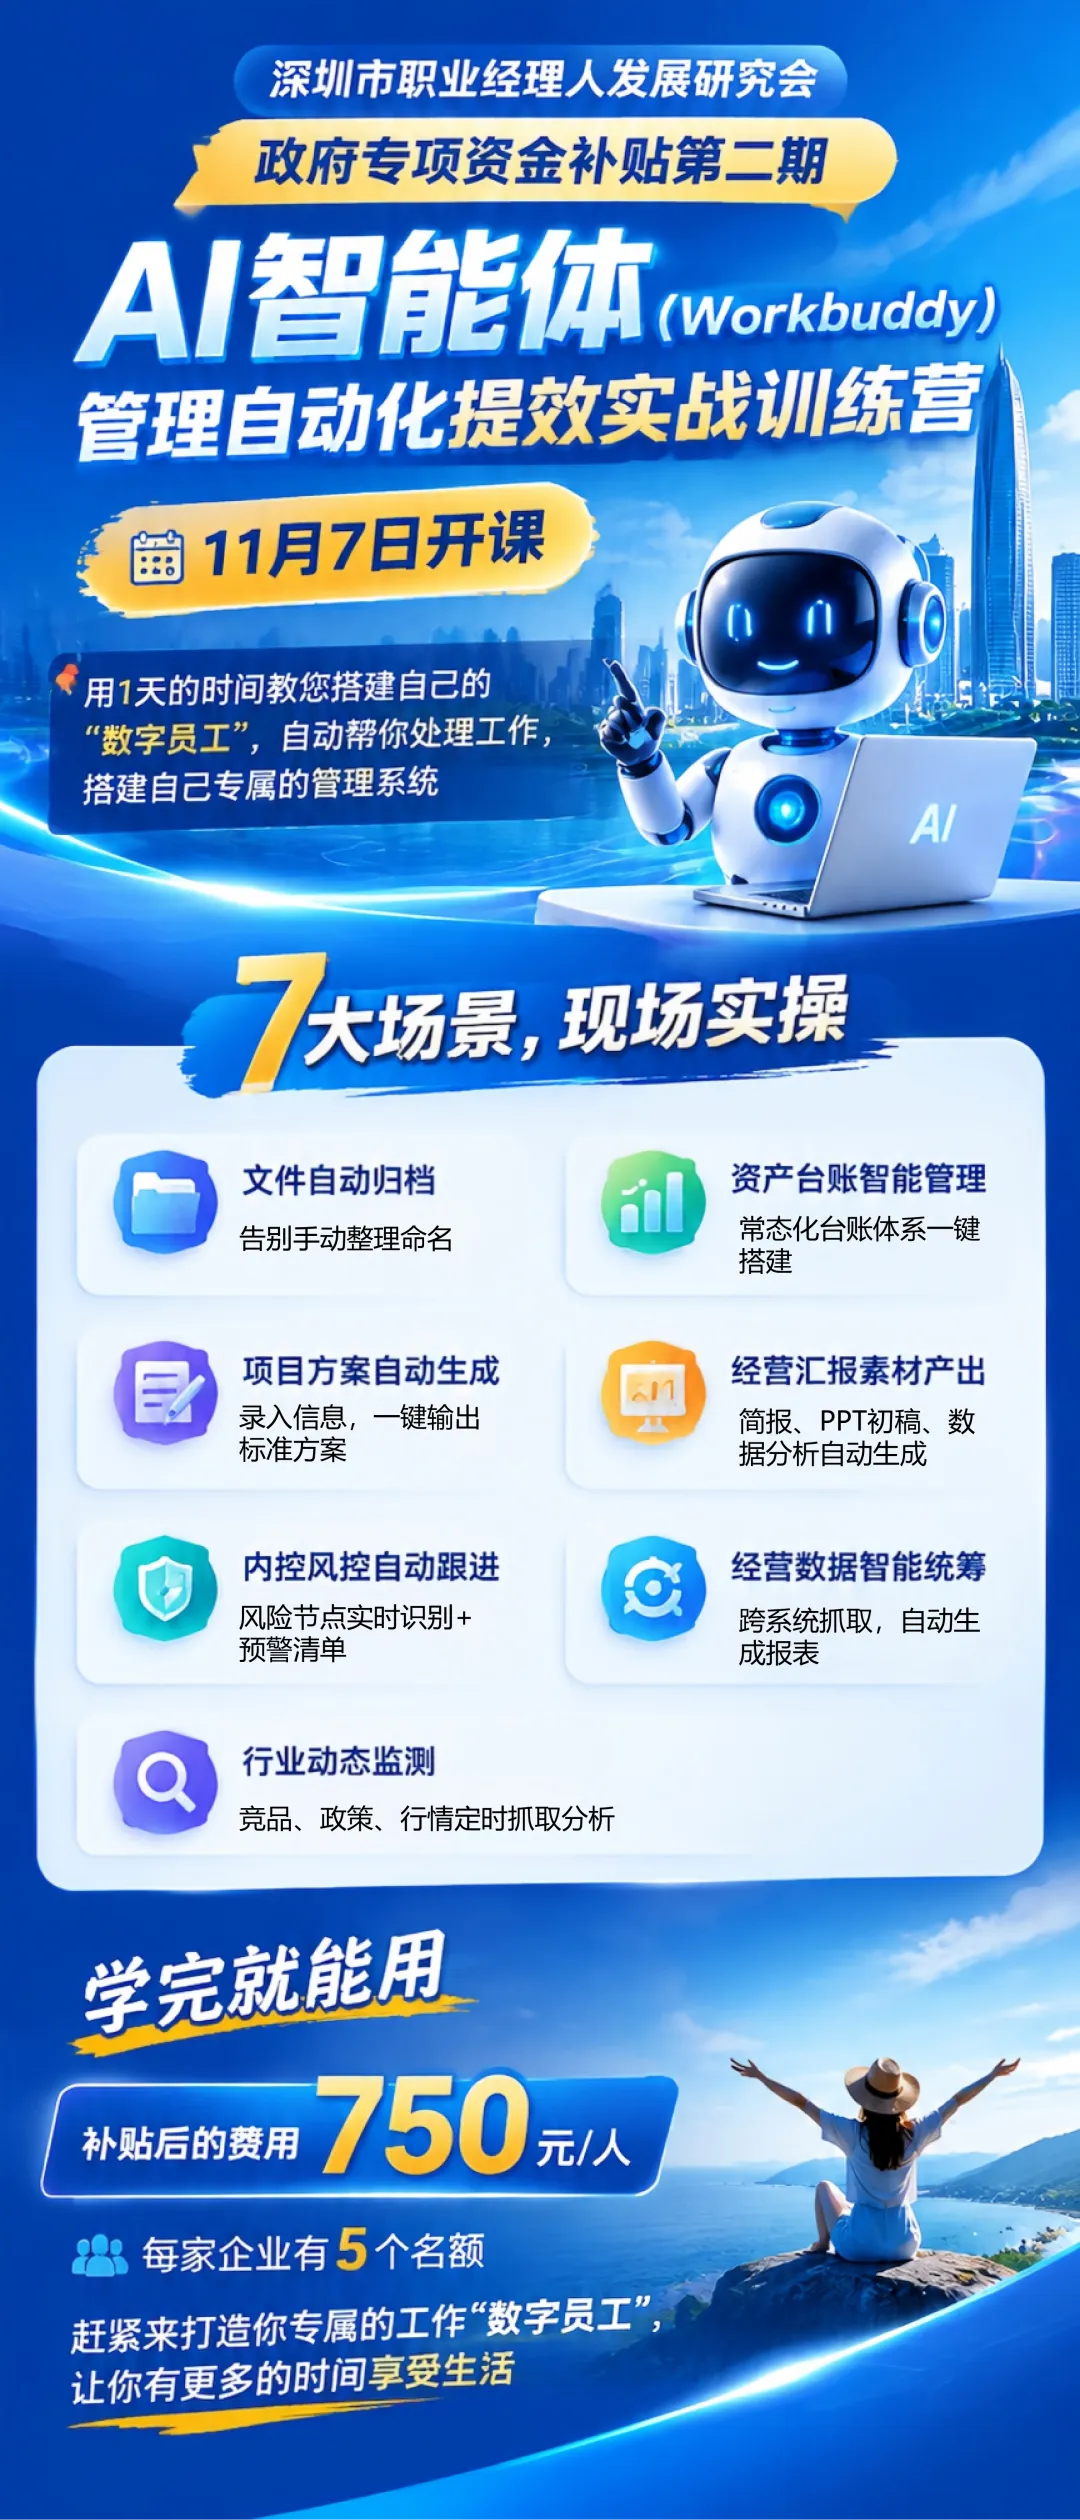
近期课程 · 11月7日 | |
课程 名称 | 《AI 智能体(Workbuddy)管理自动化提效实战训练营》 |
上课 时间 | 11月7日(周六) |
上课 地点 | 深圳 · 福田八卦岭经理大厦 |
怎么上 | 一天实战,边学边练,带走能直接用的管理自动化工具
|
扫码 报名 |
|
近期课程 · 11月28-29日 | |
课程 名称 | 《AI+职业经理人公益培养计划·二阶《团队绩效制胜》——从团伙做事到团队作战训练营》 |
上课 时间 | 11月28-29日(周六、周日) |
上课 地点 | 深圳 · 福田八卦岭经理大厦 |
怎么上 | 2天的训练营,解决识人育人、绩效考核、激励闭环与落地执行等带团队的问题,教你如何打造一支高绩效团队 |
扫码 报名 |
|
§ 我们还能为你的团队和组织提供: |
对团队 | 职业经理人培训 · 培养 · 陪跑:胜任力建模、人才测评、成长规划、分层培训、导师陪跑,面向基层到高层的完整管理人才培养链条。 | |
对组织 | 人才价值链管理体系咨询:价值创造、价值评价、价值分配的体系搭建,把人才管理真正嵌入经营逻辑。 | |
对专项 | 定制化内训与咨询:围绕企业实际课题,从需求调研到方案设计再到落地交付的全过程服务。 | |
以上各项工作,企业完全有能力依靠自己的力量推进。只是在实践中,如果有专业的加持,效率会更高、弯路会更少——识人用人可以借助第三方视角更客观,不必仅凭经验判断;人才培养可以沿用成熟的模型与路径,不必从零摸索;体系落地也不止于课堂本身,有人持续跟进盯着“人才有没有真的变”。 |
深圳市职业经理人发展研究会 专注职业经理人培训 · 培养 · 陪跑 人才价值链管理体系咨询 咨询与合作:韦老师 13823395410(微信同号) 本文为独立解读,仅供参考,不构成任何决策建议。 |
版权与引用声明 • 不复制、摘抄、翻译报告原文,所有框架与观点均为重新梳理与独立分析; • 标题与章节结构由本文重新拟定,图表为自制或据报告数据整理; • 所有引用数据均标注来源与年份,不同机构口径存在差异的部分已如实注明; • 报告版权归原出品方所有,建议通过正规渠道获取正版报告; • 本文为独立解读,仅供参考,不构成任何投资、采购或决策建议。 |
主要数据来源 艾瑞咨询《2024年中国人工智能产业研究报告》(2025年发布,51页);报告引用的招投标数据(智能超参数)、投融资数据及澎湃调研《2024年人工智能公众态度调查报告》。 2026年产业动态参考:国务院《关于深入实施“人工智能+”行动的意见》(国发〔2025〕11号);国务院办公厅《关于适应人工智能技术发展助力构建就业友好型发展方式的意见》(国办发〔2026〕29号);公开披露的 DeepSeek 模型与企业实践信息。 |
专项补贴—AI+职业经理人公益培养计划 · 管理者8阶成长体系,驱动企业真增长
<<左右滑动查看更多>>
<<左右滑动查看更多>>
研究会简介
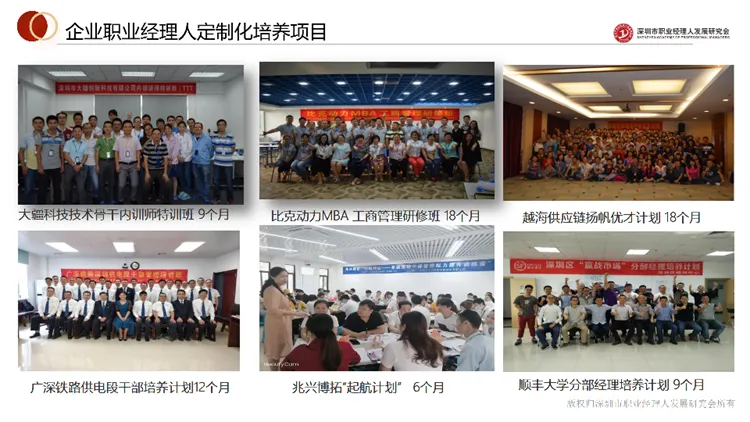
深圳市职业经理人发展研究会是由哈工大、中大、深大、广外、广州大学5所大学的教授牵头发起,并由300名职业经理人,50个行业标杆性企业联合成立的高端职业经理人智库组织。
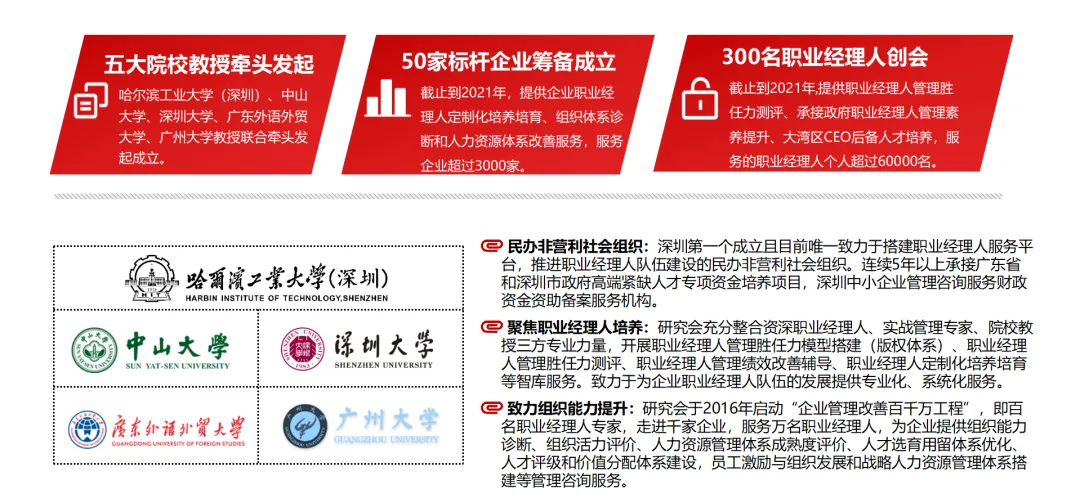
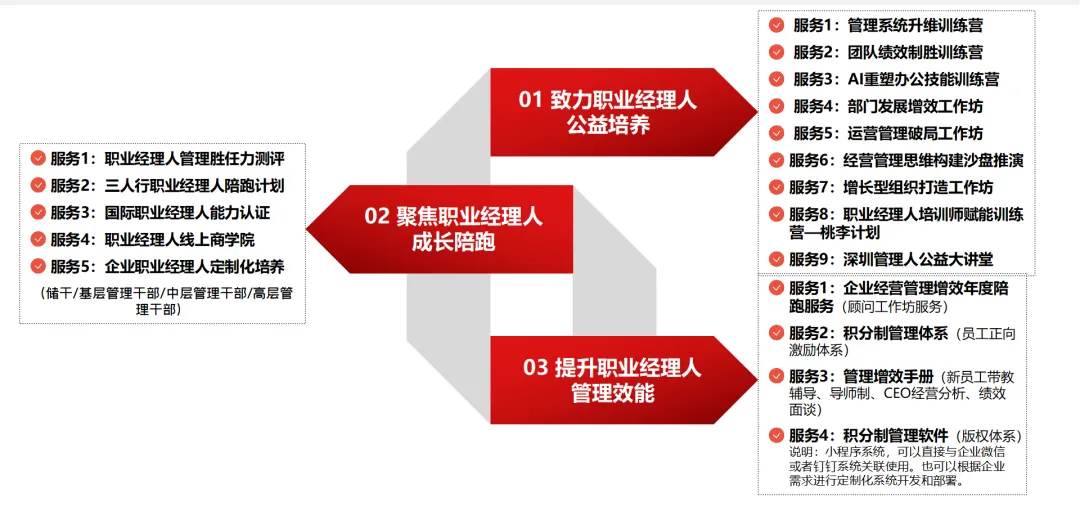
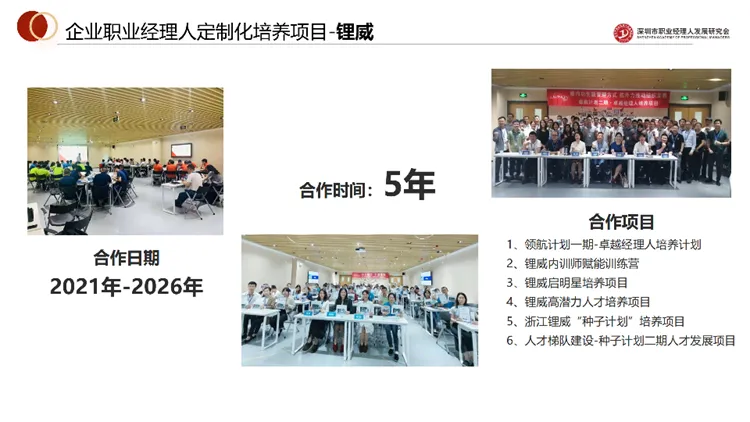
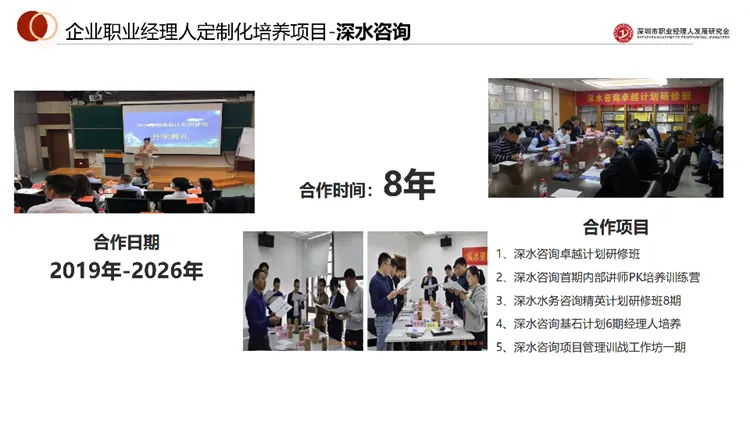
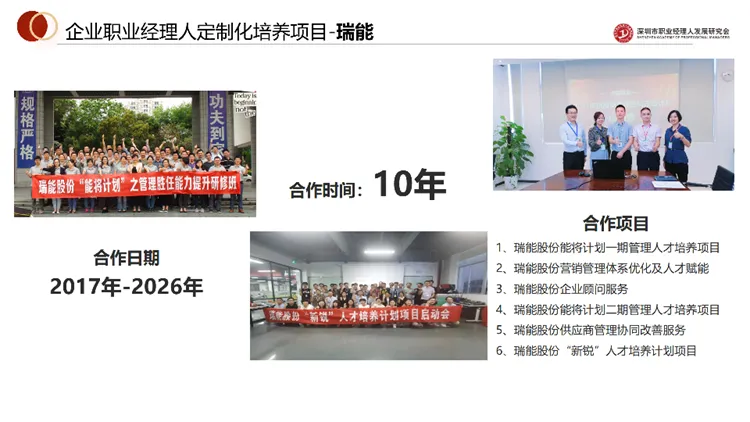
研究会自成立以来致力于为企业提供职业经理人的培训、培养和陪跑服务,开发了中小企业职业经理人胜任力模型,通过胜任力模型对职业经理人开展能力测评、职业规划、导师陪跑、人才培训和标企职业经理人选育用留交流等服务,不断通过精深化的人才服务体系促进企业职业经理人队伍的职业化水平和专业化能力的提升。
在培养职业经理人的同时,研究会同步关注企业组织力提升,创建了中小企业人才价值链管理体系搭建服务,为企业搭建人才的价值创造、价值评价和价值分配体系,促进职业经理人的人力资源价值发挥。