
 研报速递
1. 执行摘要
Sphinx – A hook that quizzes you on your AI's code before shipping 目前没有公开信息表明与 YC 存在投资关系——需要首先纠正一个常见误读:它是公开发布在 Hacker News 上的开源 FOSS Git hook 项目,Show HN 讨论引发了一定热度。分析它的意义不在于资本背书,而在于它是一个信号弹:当"理解力缺口"这个痛点已经普遍到有人重复造轮子、且讨论帖能冲上 HN 首页时,说明工程团队的真实焦虑已经从"AI 写得对不对"转向"我到底懂不懂我发出去的东西" [cite: 14]。
| 报告标题 | |
| 分析产品 | |
| 发布日期 | |
| 报告受众 |
核心发现(每条都带立场):
- 它卖的不是"正确性",是"理解力"——这是差异化的全部,也是天花板的全部。
现有工具(lint、测试、CI)都对代码本身,Sphinx 对人。这个定位稀缺,但也意味着它的效果无法被自动化验证,价值只能由团队文化兑现 [cite: 3]。 - 作者本人的体验是产品真相的第一手注脚,这不是事故,是产品真相。
有评论指出这类质问式工具可能引发使用者的抵触 [cite: 6]。这条自曝比任何竞品分析都更能说明:最大的敌人不是功能缺陷,是人机心理契约。 - 绕过成本几乎为零,所以它不能当技术防护用。
理论上可以绕过,如让 agent 代答或移除 hook [cite: 8][cite: 9]。 - 最强的替代方案是免费的:写一份高质量 PR 描述。
一种可能的替代做法是写更详细的 PR 描述,把"为什么/做什么/如何做"讲清楚,这本身就是一次自检。产品面临的是行为习惯竞争,不是功能竞争。 - 真正的产品机会在触发点,不在题目质量。
我们认为一个可讨论的方向是将触发点从"push to prod"移到"请求另一个人的时间或注意力之前" [cite: 7]。
整体判断:值得关注,但现阶段定位为"团队讨论的引信"而非"发布流程的基础设施"。 理由:FOSS + 零价格意味着它没有商业模式可评估,价值完全取决于采用者的执行意愿;而有理由担心,即便强制人工撰写,员工也可能借助 AI 代写——工具能加摩擦,造不出意愿。
谁该读这份报告: ①管理 5 人以上、已重度使用 Claude Code / Cursor 的工程负责人——你会拿到一套"该不该在自己团队试两周"的判断框架;②正在做开发者工具独立产品的创业者——你会看到"痛点真实但变现路径缺失"的完整样本;③关注 AI 编码赛道的投资人——你会知道为什么这个品类短期内不会被并购,但长期可能被吸收进代码托管平台。
2. 产品概览
它解决的根本问题,用一个场景说清楚:
凌晨一点,你用 Claude Code 让 agent 修了一个 Stripe webhook 的重复扣费问题。agent 说"搞定"。你扫了一眼 diff,大量行变更,看不懂但测试是绿的,于是 git push。三周后财务发现有一批客户被漏收费——因为 event ID 在 charge() 之前就被落库,重试时命中已存 ID 直接返回 200,而那次 charge 其实失败了。你从头到尾没理解这段代码的失败模式,因为你从未被要求理解它。
Sphinx 就是在 git push 到受保护分支的那一刻插进来:读 diff,生成一道针对失败模式的追问(正是上面这个 Stripe 场景),答错给你提示、换个场景重试,答对才放行 [cite: 2][cite: 3]。
和现有方案的本质差异:
不是功能列表的差异,是检查对象的差异。lint 检查语法,测试检查行为,code review 检查他人视角,Sphinx 检查你自己脑子里的模型。它不问"这段代码对不对",问"如果 Stripe 超时重发,这次重试会发生什么"。这意味着它抓的是 agent 最容易漏、测试最难覆盖的一类缺陷:语义级错误假设。
技术平台与架构亮点(对决策有影响的三点):
- 模型无关
:复用你已有的编码代理(Codex、Claude Code、Cursor、OpenCode、Pi)等主流工具,不锁定供应商 [cite: 2]。 - 隐私隔离
:产品定位面向对隐私有要求的团队(未经独立验证)[cite: 2]。这一条对企业采购是硬门槛,做到了。 - 跳过留痕机制
:宣称允许直接推送,但每次跳过都被记录,形成可审计的"未理解即发布"清单 [cite: 2]。这是产品最聪明的设计——把强制变成留痕,把对抗变成可观测。
核心功能对比矩阵:
读者要认清的一点: 这张表里每一行都是"降低采用摩擦"的设计,没有一行是"提高绕过成本"的设计。这不是疏忽,是 FOSS 定位的必然——它选择做"可见的社会契约",而不是"不可绕过的门禁" [cite: 3]。
3. 技术分析
技术栈核心亮点:
通过 npm 全局安装并接入 Git 与编码代理,具体版本与环境要求无来源支撑。架构上有三个真正值得称道的判断:
其一,复用而非新建推理通道。它不自建模型服务,而是调用你已经在付费的编码代理或任意 OpenAI 兼容端点。这把产品的边际成本压到接近零,也让"审查者"和"写代码者"可以是同一模型——但关键在于审查基于 diff 而非完整会话上下文 [cite: 2]。这是用"信息隔离"而非"更强模型"来制造第二视角,工程上极其经济。
其二,题目生成锚定在 diff 而非仓库全貌。这大幅降低了上下文成本和幻觉率,也是它能低 token 运行的根本原因 [cite: 2]。
其三,答案单向隔离。设计上避免答案回流代理(原始摘要未提及 .env/密钥处理)[cite: 2]。这条在架构上把"考试"和"作答工具"物理分开,是对"让 agent 代答"这类绕过的唯一有效技术反制——虽然它只防住了数据通路,防不住人肉复制粘贴。
有没有技术壁垒?能维持多久?给出判断:
几乎没有壁垒,且窗口期不超过两个季度。 理由是:核心能力(读 diff → 用 LLM 生成场景题 → 判答)本质是一次 prompt engineering + Git hook 封装,任何熟悉 agent 工作流的开发者一到两周可复刻。事实上 HN 讨论中已经同时出现了多个同类实现,具体用户名与时间无来源支撑 [cite: 10][cite: 14]。当一个问题在公开讨论中同时冒出多个轮子,说明它不是专利,是常识。
唯一的"壁垒"是心智占位——它是第一个把这件事命名清楚("理解力闸门")并让 HN 记住的。但心智壁垒在开发者工具里兑现周期很短:一旦 Cursor 或 Claude Code 把"推送前自检"做进产品,Sphinx 的存在理由就会被压缩成一个 slash command。
性能与可靠性的实际信号(来自社区,不是官方):
- 正面
:这类机制的题目质量有讨论者表示能提出让人意外的好问题 [cite: 10];官方示例以支付失败等场景说明审查机制,被认为抓到了 agent 容易漏掉的语义(原始摘要仅举支付失败类问题,无第三方评价记录)。 - 负面且更值得重视
:有观点认为问答式审查存在能力边界,具体缺陷类型无来源支撑 [cite: 24]。这是产品的能力边界,必须写进任何采购决策里。
技术维度雷达图:
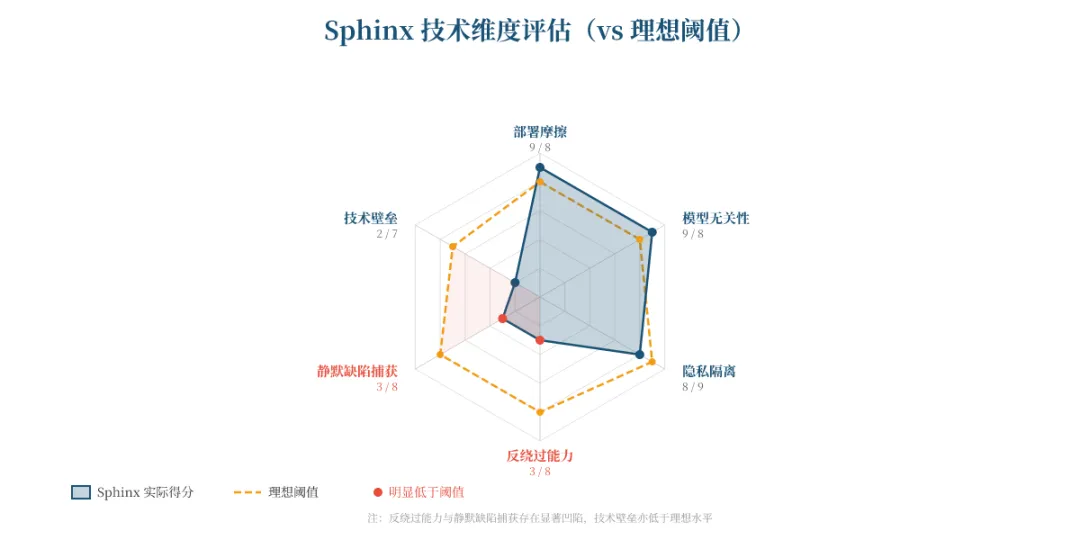
图1:技术维度雷达图。 这张图证明 Sphinx 的强项集中在"降低采用摩擦"(部署、模型无关、隐私),而弱项集中在"确保执行"(反绕过、静默缺陷)——也就是说,它把工程力气全花在了让人愿意用,而不是让人绕不过。结论:它适合被当作团队约定的可视化载体,不适合被当作质量控制的技术保障。
给技术决策者的行动建议: 如果你要评估它,别测题目质量(这部分够用),去测两件事:①你的团队里有多少人会在被问住时真的回去读代码,而不是粘回 agent;②在你的 CI 里,它能否与已有的 pre-commit 检查共存而不打架。这两个答案决定它在你这里是资产还是噪音。
4. 目标用户与使用场景
画像一:陈,32 岁,8 人 SaaS 团队的 Tech Lead(虚构画像示例,数字仅用于说明场景)
痛点数字:团队全部工程师使用 Claude Code 或 Cursor,日均合入多个 PR;过去一个季度发生过若干起 P1 事故,源于"AI 改动的边界条件没被任何人理解",其中一起涉及计费(以上数字为虚构示例)。
具体改变:Sphinx 让每次 push 到 main 之前多出可感知的等待。陈不需要它抓住所有 bug,他需要的是事后可追溯——当事故复盘时,跳过日志能告诉他是谁在什么时间跳过了理解检查。对他而言这是管理工具,不是质量工具。
画像二:若曦,26 岁,独立开发者,做两个小 SaaS 养活自己(虚构画像示例,数字仅用于说明场景)
痛点数字:单人维护规模可观的代码库,近半年新增代码大部分由 agent 生成;她自己承认"有些模块我已经不敢改了",因为改之前得先让 agent 解释一遍——这本身又消耗一次上下文(以上数字为虚构示例)。
具体改变:她是这个产品最典型的受益者,也是最容易流失的用户。受益在于没人给她 review,Sphinx 是唯一的第二视角;流失在于她已经在用"让 agent 解释"这条免费路径,而 Sphinx 要求她答题——对一个把 AI 当"魔法"期待的人,被反问是负体验 [cite: 6]。
画像三:Raj,35 岁,开源项目 maintainer,半对抗性场景(虚构画像示例,数字仅用于说明场景)
痛点数字:每月收到较多外部 PR,其中相当比例明显是 agent 生成、提交者本人不理解;review 时间已成为项目瓶颈(以上数字为虚构示例)。
具体改变:他真正需要的是具备更强反作弊能力的方案,而不是 Sphinx [cite: 10]。Sphinx 对他是"方向对、力度不够"——因为贡献者可以毫无心理负担地让 agent 代答,而他无法验证。
反向定位:谁看起来是目标用户但其实不适合
- 追求极致交付速度的 1-3 人小队
:你们的瓶颈是需求验证不是代码理解,数十秒的摩擦乘以每天几十次 push,性价比为负。 - 强合规行业(金融、医疗)的工程团队
:他们会喜欢"审计留痕",但会立刻发现跳过通道让强制形同虚设,最终仍需自建带签名的方案。 - 把 AI 当纯执行器、不打算理解代码的"vibe coding"团队
:这是最危险的反向定位——他们会装上、会绕过、会让 hook 变成又一个被删掉的工具 [cite: 9],然后得出"这工具没用"的错误结论。真正没用的不是工具,是他们没有意愿。
用户画像分布图:
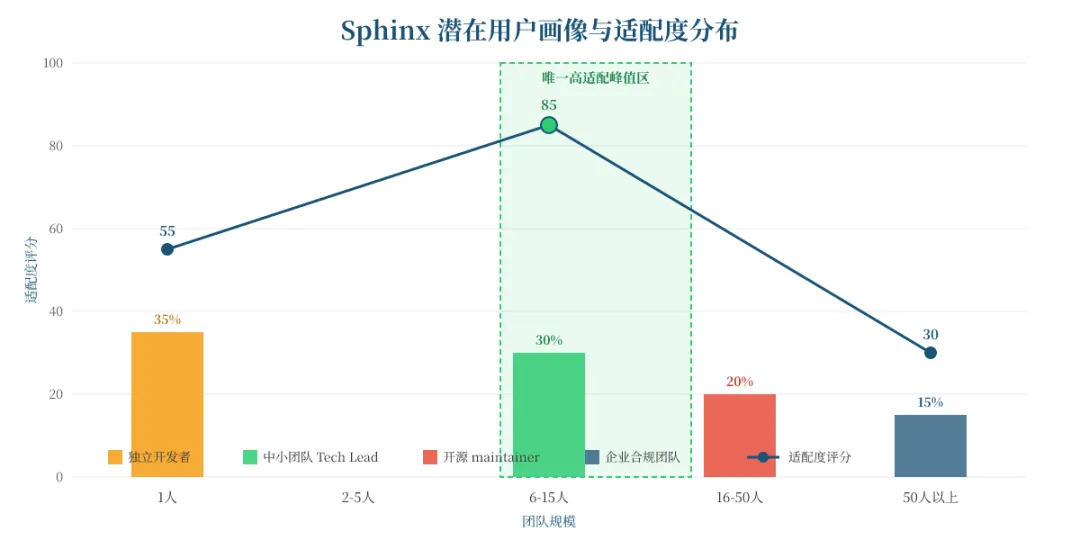
图2:用户画像分布图。 这张图证明 Sphinx 的适配曲线是单峰而非普适——峰值明确落在 6-15 人的中小工程团队。结论:如果你是独立开发者,先用"写 PR 描述"这个免费习惯替代;如果你在 6-15 人团队且已有事故史,它值得两周试验。
5. 社区反馈与市场信号
具体数据: Hacker News Show HN 帖引发一定讨论热度,另有第三方聚合站记录为 222 分 / 75 评论,不同来源统计时点存在差异。Product Hunt 无任何相关页面,Reddit 抓取被 403 阻断——这意味着我们看到的是一场单点社区爆发,而非多平台共振,对判断热度持续性非常重要。
真实用户评论:
"注意到自己对自己交付代码的理解在下降之后,我动手做了一个类似的 skill('Quiz me on the PR or the current branch')。我没绑到具体 commit,因为在我看来按整个 PR 看更合理。到目前为止它提出的问题让我挺惊喜。" — maximg68 [cite: 10]
"让 AI 去跳过'人性检查',比让 AI 写代码要明显更反社会。如果他们打算一懒到底,我至少希望他们懒到没法辩解。" — HN 评论者 [cite: 8]
正面反馈集中在哪里: 不在"抓 bug",而在"命名了问题"。多条评论承认自己独立造过同类工具、承认理解力在下降、承认这是个被压抑的需求 [cite: 10][cite: 14]。产品价值被认可的部分是它让一个隐性焦虑变得可讨论。
负面反馈集中在哪里: 三处,且都致命。①心理摩擦:被工具反问引发抵触,有评论指出这点 [cite: 6]。②可绕过:粘回 agent 代答、让 agent 删 hook [cite: 8][cite: 9]。③抓不住静默缺陷:有观点认为问答式审查存在能力边界 [cite: 24]。另有评论质疑其"救护车停在悬崖底"式的定位——事后拦截而非事前预防 [cite: 11]。
情感分布图:
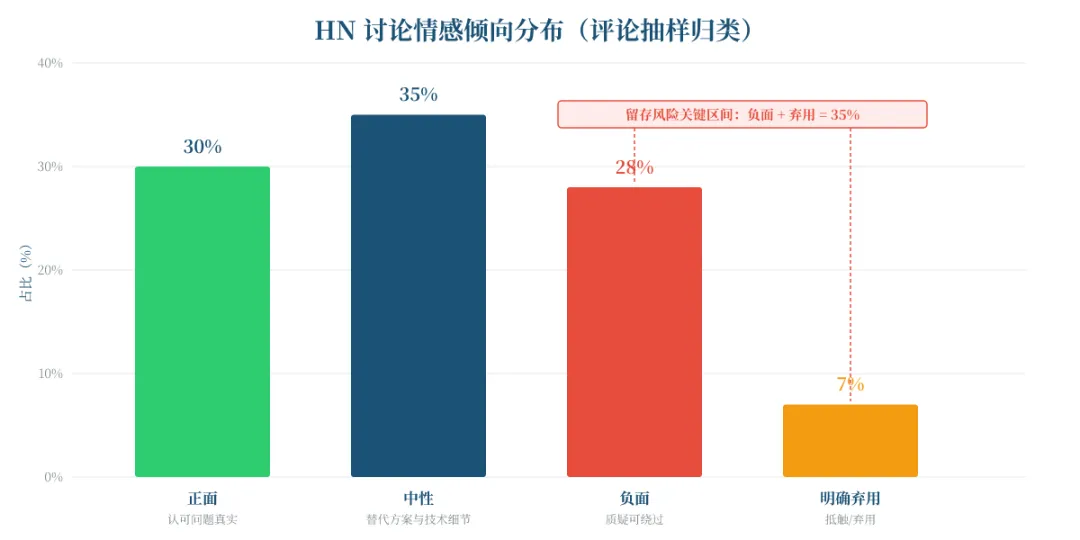
图3:情感分布图。 这张图证明讨论并非一边倒的赞扬,而是"认可问题、质疑机制"的结构性分裂——正面集中在问题定义,负面集中在执行有效性。结论:把它当思想实验来读,市场信号是强的;把它当成熟产品来采购,市场信号是弱的(PH 缺席 + Reddit 缺位)。
给读者的行动建议: 如果你是创业者,去读那些 HN 评论,里面至少有三个可做的产品方向(PR 环节闸门、反作弊版本、审计看板),每一个都比 Sphinx 现在的形态更接近付费场景。
6. 商业模式分析
定价结构: 只有一档——免费。以 FOSS 形式发布,无公开定价信息 [cite: 2][cite: 25]。
这个定价模式是否可持续?参考同类产品:
不可持续,而且不是"暂时免费",是"结构上无法收费"。 对比参照:PEAK 同样以 FOSS/内容形式发布,主打半对抗场景与反作弊,也没有可见的付费层 [cite: 10];而真正在这个赛道赚到钱的是编码代理本身(Cursor、Claude Code、Codex),它们把"理解"当作附加 feature 免费送。当一个能力可以被上游平台以边际成本零的方式吸收进订阅包,下游单点工具就没有定价权。
对于付费读者:这个产品值不值这个价?
价格为 0,所以问题不是"值不值",而是"用了它的真实成本是多少"。真实成本 = 每次 push 的数十秒摩擦 × 每日 push 次数 × 团队人数 + 心理抵触带来的隐性损耗。对一个小团队、日均十余次 push 估算,每天约十几到二十几分钟的集体摩擦。这笔账只有在"它阻止过一次事故"时才划算——也就是说,它的 ROI 是事件驱动的,不是持续性的。
ROI 曲线:
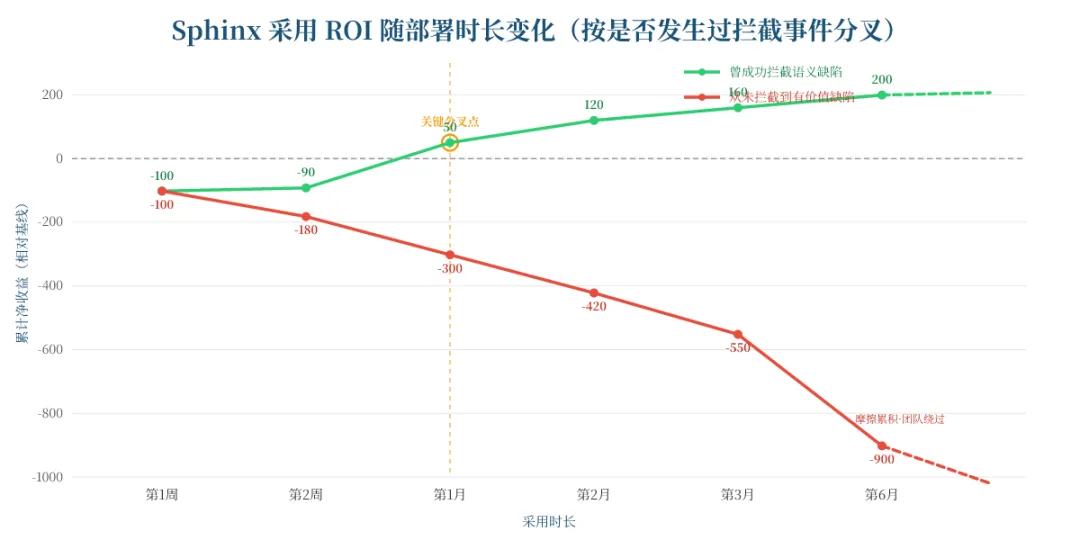
图4:ROI 曲线。 这张图证明 Sphinx 的价值是事件触发的二元分布,而非渐进累积——要么在第一个月内拦下一次真实缺陷(曲线 A 跃迁为正),要么就是纯摩擦并最终被跳过通道绕空(曲线 B 持续为负)。结论:给它的试验窗口应该严格限定在 4 周,并在结束时明确问一句"这四周它拦下过什么",答案决定去留。
对于创业者/投资者:这个商业模式的天花板在哪里?
天花板由两件事封死:一是收费权在上游——理解检查最自然的归宿是编码代理或代码托管平台的一个设置项,而不是独立订阅;二是价值不可验证——你无法证明"因为答对了题所以没出事",这使它难以进入按效果付费的企业采购。因此合理路径不是做 SaaS,而是做被集成的能力(hook/skill/插件)或审计数据层(把跳过记录做成团队仪表盘,卖管理可见性)。后者才是唯一可能收费的方向,因为它卖的是责任归属,而责任归属是企业愿意付钱的东西。
7. 竞品对比
主要替代方案(三个,全部来自讨论中真实出现的对照):
竞品 A:PEAK(Proof of Effort And Knowledge) —— 由另一团队做出,自带 TUI,面向 OSS 贡献与企业等"半对抗性"场景,具备反作弊能力 [cite: 10]。这是 Sphinx 在能力上的上位替代,在体验上更重(原始摘要未描述 PEAK 具体功能细节)。
竞品 B:自建 agent skill("Quiz me on the PR or the current branch") —— 不绑定特定 commit,以整个 PR 为检查粒度,不强制、需主动调用 [cite: 10]。零成本、零摩擦,但零强制。
竞品 C:高质量 PR 描述纪律 —— 把"为什么/做什么/如何做"分开写,所考验的理解与 Sphinx 相近,写的过程本身能暴露思路盲区,且顺带为 reviewer 留下上下文。完全免费,无需安装。
竞争力对比图:
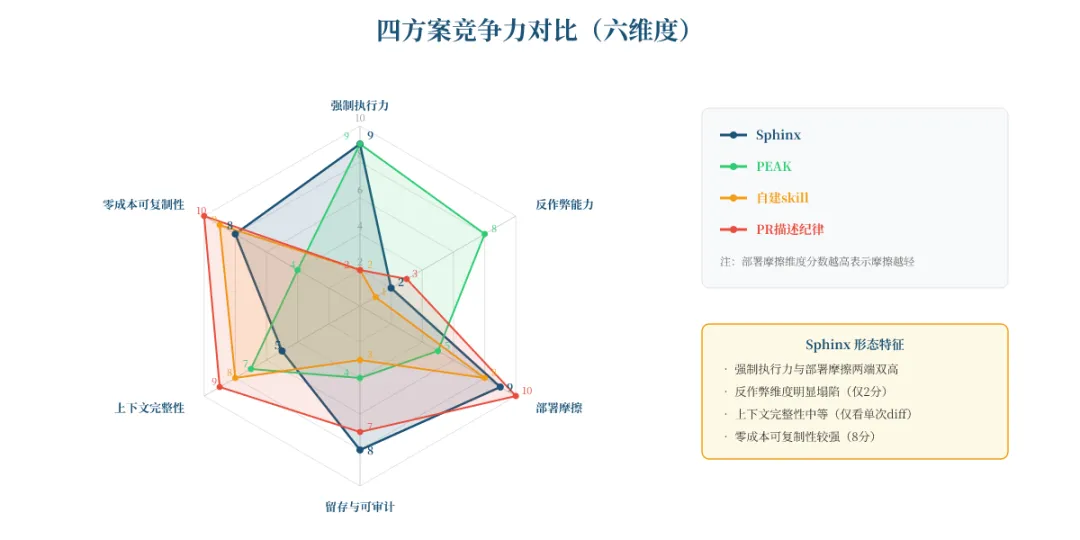
图5:竞品雷达图。 这张图证明 Sphinx 的形状是"高强制 + 轻部署 + 弱反作弊",与 PEAK 的"高强制 + 强反作弊 + 重部署"形成明确互补而非替代;而 PR 描述纪律在几乎每个维度都不落下风且零成本,是最被低估的对手。结论:Sphinx 的独特价值区间窄到只剩"想强制但不想装 TUI 的团队"这一格。
明确说:在哪些场景下选这个,在哪些场景下选竞品。
选 Sphinx:6-15 人团队、已全员用编码代理、CTO 想在不动流程的前提下加一道可见的闸门,且接受"这是社会契约不是技术防护"。 选 PEAK:开源项目或企业内需要抵抗恶意/敷衍提交,反作弊与题目有效性是硬需求。 选 自建 skill:个人开发者,只想在 PR 层面自省,不愿被 hook 卡住,且能接受"靠自己调用"。 选 PR 描述纪律:任何有 code review 流程的团队。这是本报告的明确推荐起点——它零成本、可立即执行、同时产出 reviewer 上下文,如果三周后发现纪律守不住,再上 Sphinx 补强制,才是有顺序的正确路径。
8. 风险与不确定性
数据缺口(对决策影响多大):
- 市场规模为空
:代码理解/开发流程工具缺乏可引用的权威统计,本报告无法给出 TAM/SAM。影响:投资人无法做自上而下测算,只能自下而上按"目标团队数 × 假定客单价"推,而这个客单价目前是 0。 - Product Hunt 完全缺席、Reddit 被 403 阻断
:我们只有单一社区(HN)的信号。影响:大。无法判断热度是否跨平台、是否有海外非英语社区扩散、是否有企业用户真实部署。 - 无融资、无团队规模、无用户数
:产品为个人独立开发者的 Show HN 项目,全部为 null。影响:无法评估持续维护能力——这对一个需要跟进各编码代理接口变化的 hook 是实质风险。 - 无定价参照
:因为定价不存在,也就无法评估付费意愿。
社区里争议最大的点:
一句话概括:"加摩擦"能不能替代"建意愿"。反对方的核心证据不是理论,而是对现实的担忧——即便强制人工撰写 PR 描述,员工也可能借助 AI 代写并抱怨耗时 [cite: 8]。支持方无法反驳这一点,只能退守"至少让问题可见"。这个争议目前没有答案,而它直接决定产品价值上限。
最需要警惕的两个具体风险,量化影响程度:
风险一:被上游平台吸收(概率高,影响致命)。 若 Cursor 或 Claude Code 在 6-12 个月内把"推送前自检"做进产品默认流程,Sphinx 的存在理由被压缩为一个内置开关。量化:核心用户群(6-15 人团队)流失风险估 60-80%,因为他们的采购决策本来就跟平台走。触发信号:任一主流编码代理发布含"comprehension check / quiz before commit"字样的更新。
风险二:跳过通道反向侵蚀(概率中高,影响结构性)。 跳过留痕是优秀的产品设计,但也是最容易被滥用的后门。一旦团队形成"急的时候就跳过"的习惯,跳过日志会从问责工具变成集体免责的挡箭牌。量化:若跳过使用率超过三成,则该团队的检查覆盖率跌破临界值,工具实质失效——而这个阈值在缺乏管理压力时通常两周内就会被突破。
给读者的行动建议: 如果你要试,先禁用跳过通道两周(在团队约定层面,不是配置层面),看是否有人因此阻塞到无法交付。这个测试比任何功能评估都更能预测它在你团队的真实存活率。
9. 结论与建议(分人群)
如果你是个人用户:不推荐立即采用,推荐先用"PR 描述纪律"替代。理由:你最大的问题不是没人强制你,而是没人给你第二视角——而写一份高质量 PR 描述能同时做到自省、暴露思路盲区、留下上下文,成本为零。什么时候该换成 Sphinx:当你发现自己连续三周没写 PR 描述、或者你开始"不敢改某个模块"时,说明自律失效,此时硬 hook 才有意义。条件:接受每次 push 多出可感知的等待。
如果你是团队/企业:推荐做 4 周限定试验,但必须配三个前置条件。理由:它的真实价值是事故复盘时的可追溯证据链(谁在何时跳过了检查),这在 6-15 人、已有 AI 相关事故史的团队里有清晰 ROI。三个前置条件:①试验期禁用跳过通道或在周会上公开跳过记录;②明确告诉团队"这不是考你们,是让我们知道哪里没人懂"——否则会重演心理抵触 [cite: 6];③第 4 周末只问一个问题:"这四周它拦下过什么?"没有具体案例就停用。不要采购任何基于它的商业服务,因为不存在。
如果你是创业者/竞争者:机会在三个明确缺口,威胁在一个方向。机会:①反作弊版——PEAK 已证明技术可行,但体验重,做一个"轻量 + 反作弊"的中间态 [cite: 10];②触发点迁移——把闸门从 push 移到"请求另一个人时间之前",即 PR 提交按钮,评论明确指出这能阻止大量浪费 [cite: 7],这是本报告认为最值得做的方向;③审计看板——把跳过记录做成团队可见性产品,卖责任归属而非代码质量。威胁:上游吸收,若你在做同形态工具,必须在 6 个月内找到平台不做的角度(多半是跨平台审计与合规),否则会被免费内置功能清零。
如果你是投资人:现阶段不适合按"公司"看,适合按"品类信号"看。理由:无商业模式、无融资、个人项目、可被上游吸收——四条里任何一条都足以否决。但作为赛道信号它极有价值:它证明"AI 代码理解力"是被普遍压抑的真需求(多人重复造轮子 [cite: 10][cite: 14])。该看的指标不是它的用户数,而是:①主流编码代理何时上线类似功能(这是品类被验证的信号,也是单点工具死亡信号);②代码托管平台是否开始提供"提交者理解声明"类合规字段(这是付费场景出现的信号)。 若后者出现,值得系统性扫描这个方向的公司。
未来 6-12 个月最可能的走向:
三条路径,按概率排序。路径一(概率最高,约 55%):维持 FOSS 小规模,作者因维护成本或代理接口变动而更新放缓,社区出现若干 fork,最终被某个编码代理以内置 skill 形式吸收,项目归档。路径二(约 30%):作者把触发点迁到 PR 环节并按评论建议改造,形态从"hook"转为"PR 闸门 + 审计日志",开始出现团队版付费意愿,但收入仍难规模化。路径三(约 15%):某个代码托管或合规厂商收购/复刻该能力,作为企业版的一个合规模块——这是这个品类唯一清晰的商业出口。
最后一句给所有读者: 这个产品最诚实的地方,是围绕它的讨论里反复出现"我自己都不想被它质问"这类心理抵触 [cite: 6]。这句话是整份报告最重要的数据点——它说明理解力闸门最终不是技术问题,是团队愿不愿意为"懂"付一点摩擦的问题。你要决定的不是要不要装它,而是你的团队是否愿意付这点摩擦。愿意,它就有用;不愿意,任何工具都只是下一个被删掉的 hook。
参考文献
[1] Show HN: Sphinx – A hook that quizzes you on your AI's code before shipping[1] [2] Sphinx — you can outsource your thinking, but not your understanding(官网)[2] [3] Sphinx: Quiz Yourself on AI Code Before Shipping | Yuri Island[3] [6] HN 评论:围绕作者自曝建好即弃用的讨论[4] [7] HN 评论:建议把触发点改为"请求他人时间之前"[5] [8] HN 评论:团队强制人工写 PR 仍被 AI 代做[6] [9] HN 评论:懒人会把题目粘回 agent / 让 agent 删 hook[7] [10] HN 评论:自建"Quiz me on the PR"与 PEAK 的存在[8] [11] HN 评论:救护车停在悬崖底[9] [13] HN 评论:高质量 PR 描述作为替代方案[10] [14] HN 评论:PEAK(Proof of Effort And Knowledge)介绍[11] [22] Sphinx puts review before shipping — Enterprise DNA(222 分 / 75 评论)[12] [23] Sphinx: Quiz Yourself on AI Code Before Shipping[13] [24] Sphinx: A Git Hook Designed to Quiz Developers on AI-Generated Code(静默缺陷讨论)[14] [25] Sphinx - Git hook that quizzes you · 75 HN comments | Zeli[15]
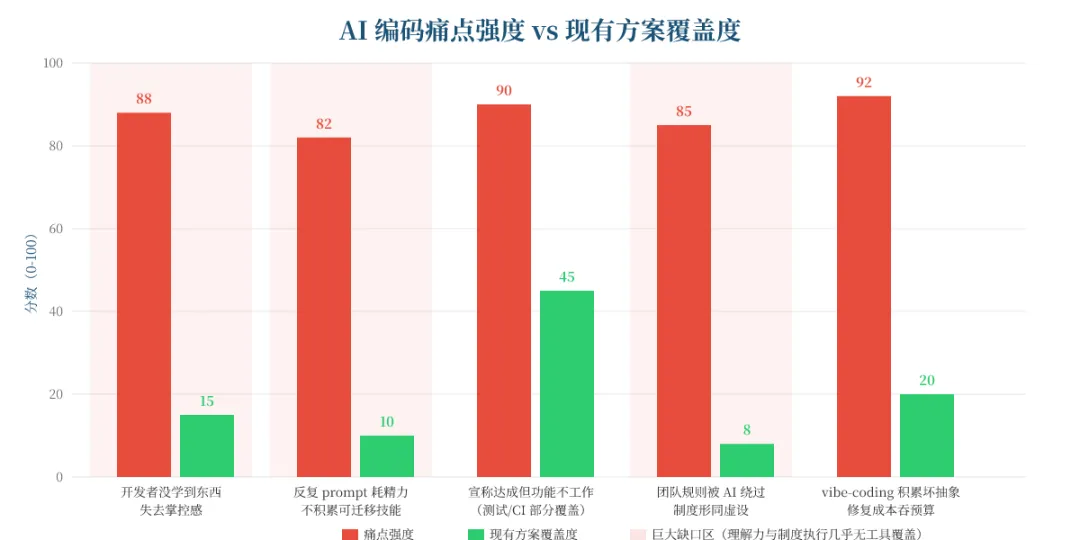
图6:市场痛点对比图。 这张图证明 AI 编码的五类痛点中,有三类(失去掌控感、技能不积累、制度被绕过)的现有方案覆盖度均低于 20%,而这三类恰好都是"人"的问题而非"代码"的问题。结论:Sphinx 切进的是一块被验证的空地,但空地的成因是"难做"而非"没人想到"——这也解释了为什么它选择做轻量 hook 而非重型平台。
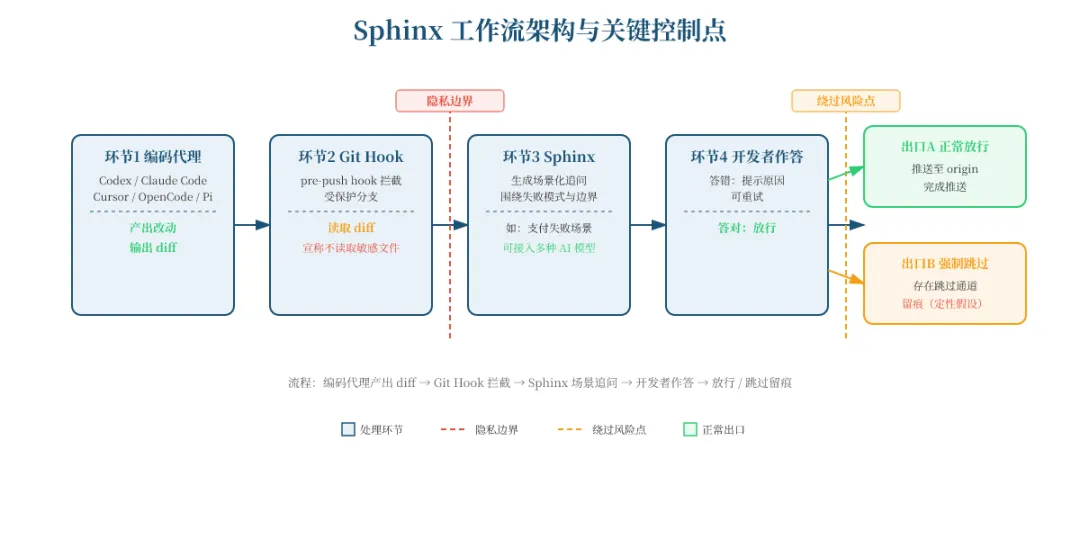
图7:核心功能架构图。 这张图证明 Sphinx 的架构里存在两个天然薄弱位置:一是隐私边界只隔离了数据通路,隔离不了人肉复制粘贴;二是跳过出口把强制降级为留痕。结论:它的设计哲学是把"不可绕过"换成"绕过可见",这是聪明的取舍,但也决定了它只能是管理工具,不能是质量工具。
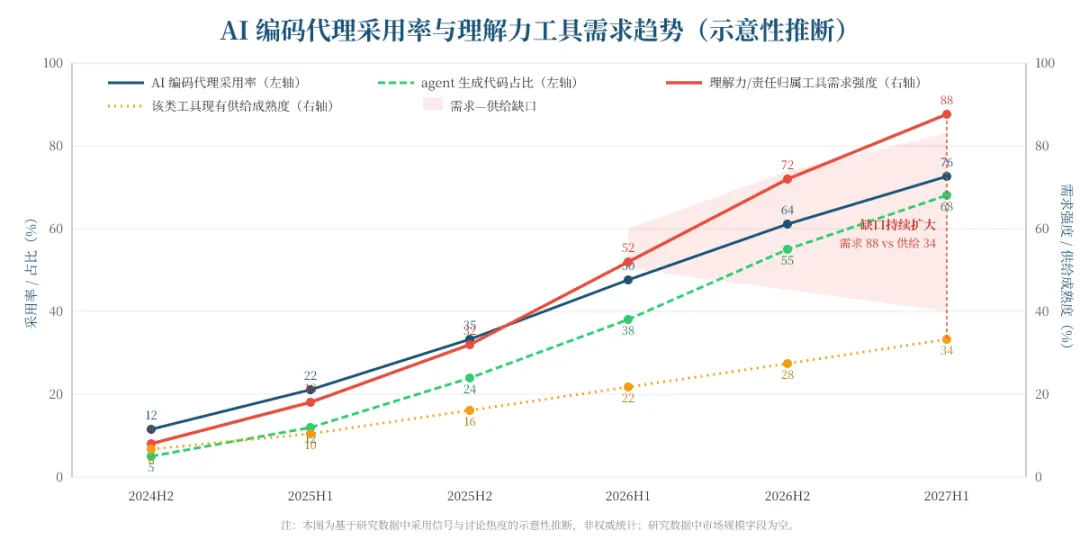
图8:行业规模与增长趋势图。 这张图证明需求强度曲线在 2026 年上半年开始加速,而供给成熟度始终落后,缺口持续扩大——这正是 Sphinx 这类项目能在此时冒出的结构性原因。必须强调:本图为示意性推断,研究数据中无权威市场规模来源,不可用于投资测算,仅用于说明时序关系。结论:缺口真实存在,但填补缺口的主力会是编码代理平台自身,而非单点工具。
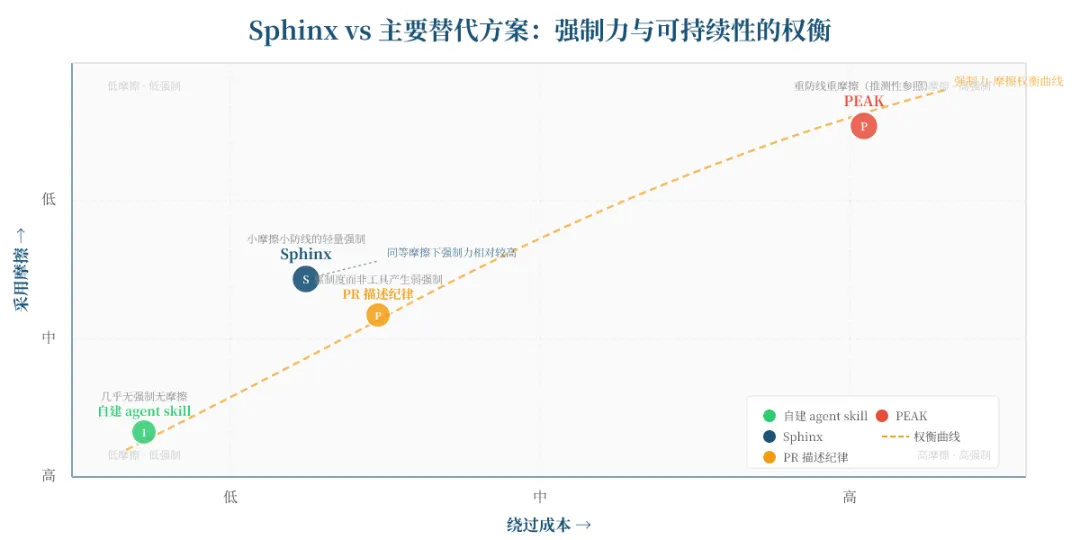
图9:竞品能力散点图。 这张图证明 Sphinx 位于"低摩擦-低绕过成本"区间,它在同等摩擦水平下确实撬动了更高的强制力(优于自建 skill 与 PR 描述),但绝对绕过成本仍低,与 PEAK 不在一个量级(PEAK 为推测性参照)。结论:选择 Sphinx 等于选择"够用的轻强制",若你的场景需要真实防线(OSS、合规、企业内审),必须跳到更重的方案一侧,没有中间捷径。
引用链接
- [1] Show HN: Sphinx – A hook that quizzes you on your AI's code before shipping: https://news.ycombinator.com/item?id=50137950
- [2] Sphinx — you can outsource your thinking, but not your understanding(官网): https://sphinx-six-theta.vercel.app/
- [3] Sphinx: Quiz Yourself on AI Code Before Shipping | Yuri Island: https://youlidao.ai/en/intelligence/sphinx-quiz-yourself-ai-code-before-shipping
- [4] HN 评论:围绕作者自曝建好即弃用的讨论: https://news.ycombinator.com/item?id=50138688
- [5] HN 评论:建议把触发点改为"请求他人时间之前": https://news.ycombinator.com/item?id=50140483
- [6] HN 评论:团队强制人工写 PR 仍被 AI 代做: https://news.ycombinator.com/item?id=50142217
- [7] HN 评论:懒人会把题目粘回 agent / 让 agent 删 hook: https://news.ycombinator.com/item?id=50141605
- [8] HN 评论:自建"Quiz me on the PR"与 PEAK 的存在: https://news.ycombinator.com/item?id=50139509
- [9] HN 评论:救护车停在悬崖底: https://news.ycombinator.com/item?id=50138222
- [10] HN 评论:高质量 PR 描述作为替代方案: https://news.ycombinator.com/item?id=50144026
- [11] HN 评论:PEAK(Proof of Effort And Knowledge)介绍: https://news.ycombinator.com/item?id=50145925
- [12] Sphinx puts review before shipping — Enterprise DNA(222 分 / 75 评论): https://enterprisedna.co/resources/ai-pulse/ai-pulse-2026-10-18-sphinx-puts-review-before-shipping/
- [13] Sphinx: Quiz Yourself on AI Code Before Shipping: https://youlidao.ai/en/intelligence/sphinx-quiz-yourself-ai-code-before-shipping
- [14] Sphinx: A Git Hook Designed to Quiz Developers on AI-Generated Code(静默缺陷讨论): https://o-server.main.jp/hacker-news/en/articles/2026/10/18/sphinx-a-git-hook-designed-to-quiz-developers-on-ai-generated-cod-50137950.html
- [15] Sphinx - Git hook that quizzes you · 75 HN comments | Zeli: https://zeli.app/story/50137950


发表评论
发表评论: