
 研报速递
清新研究团队针对 TypeSafe AI 的 Jev‑1.13.0(System One 机器原生决策模型)发布了深度研究报告,核心结论:Jev 是 AI 接口范式创新,适合做系统高速判断闸门,但内部模型技术尚未公开,存在失效边界,需以风险试点验证而非宣传数据作为落地依据。(文末附报告获取方式)
前 OpenAI 参与者打造的 Jev(System One)一夜出圈,号称速度最高提升上百倍、输出 token 免费。
网上铺天盖地都是 “百倍提速、几百倍降价、消灭幻觉” 的宣传。
目前它应该是外网最火的大模型了,帖子获得了三千多万的浏览量。
热潮之下,我们需要拨开营销迷雾,看清这款 “不爱说话” 的 AI 的真实能力与致命边界。
当整个 AI 行业都在疯狂卷聊天、卷推理、卷 “系统二” 深度思考的时候,TypeSafe AI 拿出了一个反常识的产品:Jev。
一个不跟人对话,专门给软件做快速判断的 AI 模型。
2026 年 9 月 15 日,Jev‑1.13 正式开放早期访问,背靠 4000 万美元种子轮融资,创始人 Diogo Almeida 是 InstructGPT、RLHF 的核心参与者,曾经亲手参与塑造了 ChatGPT 的对话范式,如今却转身做了一个 “拒绝聊天” 的模型。
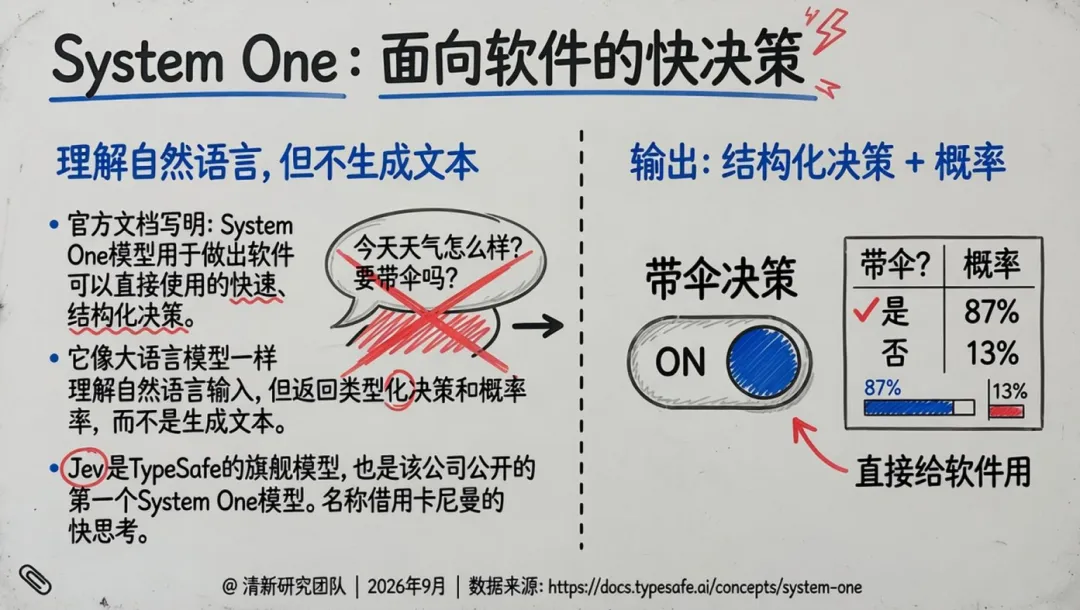
一、什么是 Jev:AI 的 “反射神经”,而非新的超级大脑
丹尼尔・卡尼曼在《思考,快与慢》中将人类思维分成两套系统:
系统一:快思考,直觉、瞬间判断,不需要长篇大论,看到信息立刻给出结论。
系统二:慢思考,深度推理、推演、写文章、做复杂计算。
Jev 定位为面向快速、聚焦判断的模型。
它能看得懂人类的自然语言,却不输出自由文本。
你给它一段业务状态(state),同时给出一套候选答案集合,它直接返回选项、评分以及完整概率分布,代码拿到结果就可以直接执行,不需要再做复杂文本解析。
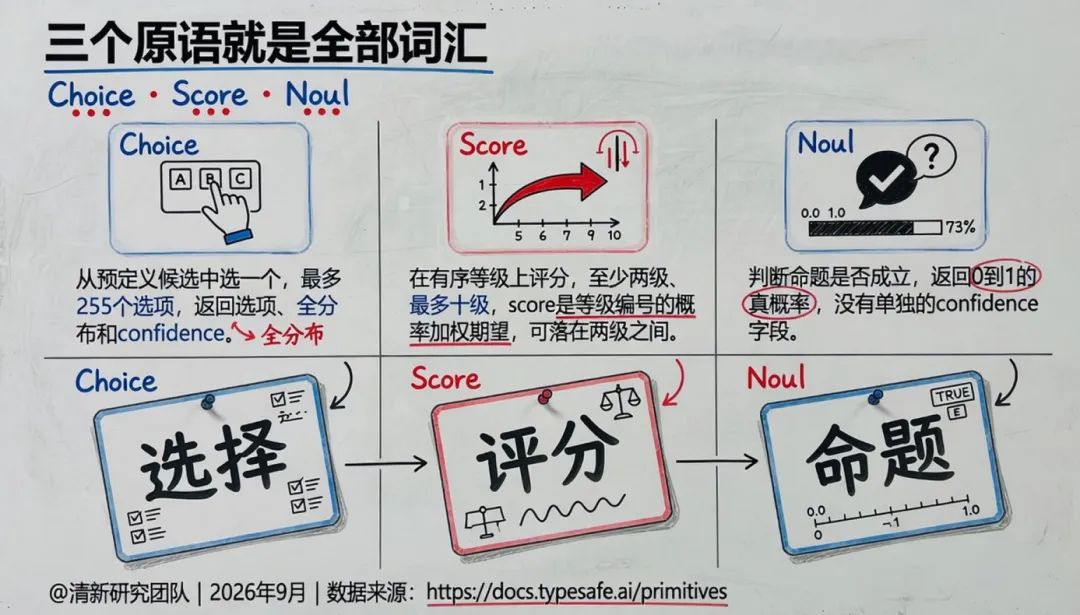
它对外展现的三个最核心的原语,也是全部能力的入口:
Choice(选择):从预设候选集合挑选,返回全部选项的概率分布与置信度;
Score(打分):针对有序等级输出概率加权后的分数;
Noul(命题真伪):输出 0‑1 之间命题成立的概率。
过去我们用普通大模型做分类、路由任务,流程是:调用大模型生成文本→期望它输出 JSON→程序解析字符串→处理解析失败、重试。
大量时间、成本浪费在逐 token 生成和纠错重试上。
Jev 改写了这套产品契约:输入开放语义,输出封闭集合。模型不可以凭空生成候选以外的答案,从接口层面杜绝格式错乱。
划重点:零非法输出 ≠ 零幻觉。
它不会编造不存在的选项,不会输出无法解析乱码,但完全可以把一个错误的合法选项给出很高概率。
格式安全做到了,语义判断依然会出错,只是错误变得可观测、可门控、可回放。
更有意思的特性是共享状态并行多问题计算。
一次送入业务上下文 state,可以同时抛出十几个甚至几十个判断问题,模型读取一遍 state,并行返回全部结果。
官方 Cookbook 案例,13 个问题合并一次调用,对比 13 次独立调用,成本降低 11.5 倍,速度提升 9.6 倍。
这是它低成本、低延迟最核心的来源之一。
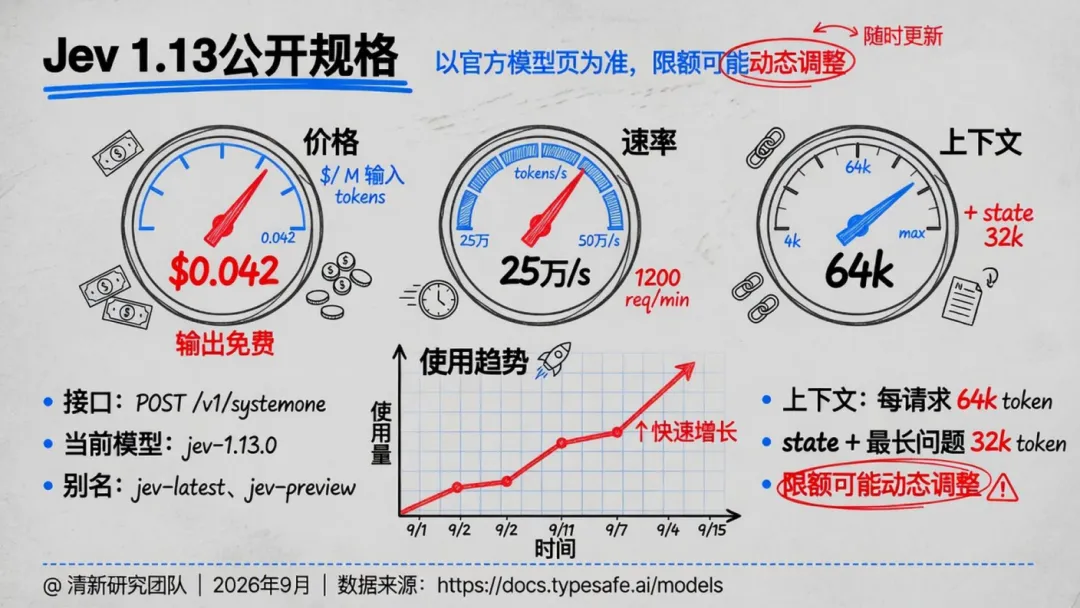
公开规格上:最大上下文 64k token,其中业务状态 state 上限 32k;仅支持文本输入,不支持图像音视频;不允许客户做微调、LoRA,全部用户共用同一套权重;英文能力最优,中日韩语言可用,但官方明确提示性能会衰减,业务落地必须拿自有数据重测;定价输入 $0.042 / 百万 token,输出 token免费,接口速率可达 25 万 token/s。
二、并非万能神器:哪些场景适合它,哪些不要碰
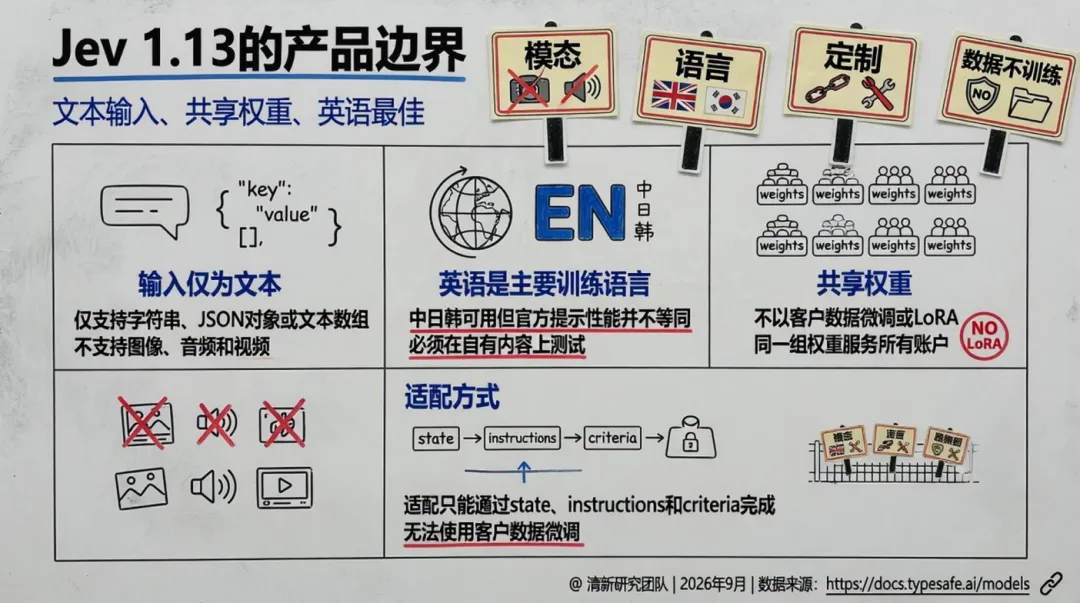
报告给出硬性五重门槛,五个条件必须同时满足,才适合把 Jev 接入业务;缺任意一条,就不能当做最终求解器。
✅适合落地场景: 输入以文本为主;答案动作可以预先枚举;判断可在数秒完成;调用频率高;业务系统允许基于置信度做分流。
典型案例:客服工单路由、风控安全预筛、发票分流、Agent 工具风险门控、检索过滤、内容标签。
Jev 并非要取代大语言模型。
恰恰相反,报告的核心观点是二者是分工,而不是替代。
一个完整 AI Agent 系统可以分层:Jev 负责高速反射判断闸门;通用大模型承担规划、创作、长链推理、生成新问题。
Jev 充当看门人和分流器:高置信直接自动执行,中置信转人工审核,低置信直接拒绝,把复杂推理交给强生成模型。
❌不适合的场景: 开放写作、代码生成、复杂数学运算、长链条规划、创造全新动作、原生多模态任务。
不要指望它写方案、做推导,它生来就不是干这个的。
三、褪去光环:被营销放大的数字,和藏在暗处的失效边界
网络广为流传 193.6 倍、444.6 倍速度与成本提升,这份报告做了最重要的澄清:
该数字来自官方 4 组特定工作流,属于真实收益的高端区间,前提是短而密集的输入、西海岸网络访问。
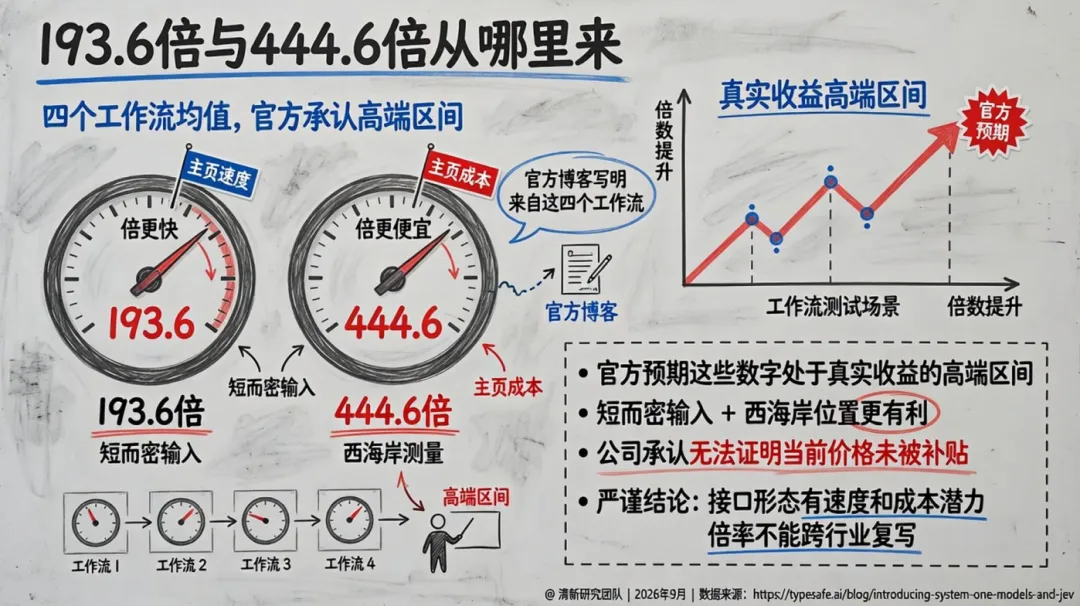
当前低价不排除存在资本补贴,该倍率不能不加验证直接套用到各行各业。
同时报告完整梳理官方文档披露的九类失败模式,字面理解偏差、数学计数错误、日期比较失误、长状态信息干扰、多跳间接推理失效、对抗输入扰动等等。
其中一个极具颠覆性的现象叫结构不变量缺口,互补问题返回的概率相加,不一定等于 1。
官方示例,同一份工单,问 “是否退款” Noul 给出 0.72;问 “是否非退款” Noul 给出 0.47,两者相加 1.19。
这意味着,Jev 返回的概率,是绑定提问句式的条件评分,不是可以直接拿来做数学加减的物理量。
还有一个高频关键词 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习),很多宣传将其渲染为已经成熟、可复现的革命性算法。
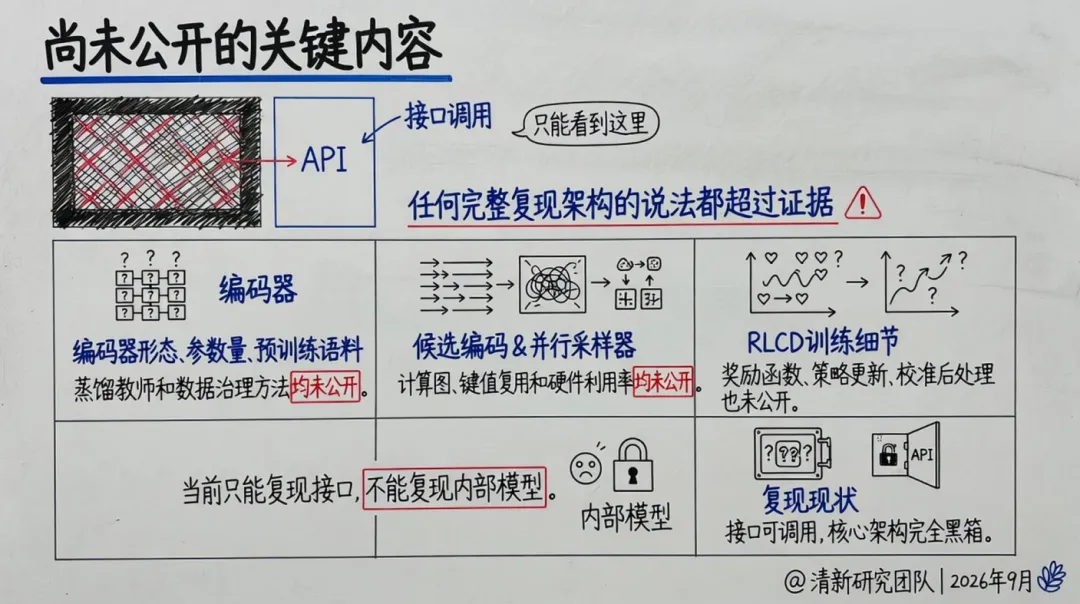
RLCD 目前只是一个训练目标名称,没有公开论文,没有公开奖励函数、训练配方,不属于可复现的科研成果,仅仅代表厂商想要达成的训练方向,不能当作已经被验证的新算法。
大量底层信息处于黑箱状态,编码器架构、参数量、预训练语料、蒸馏来源全部没有对外披露。
四、行业启示
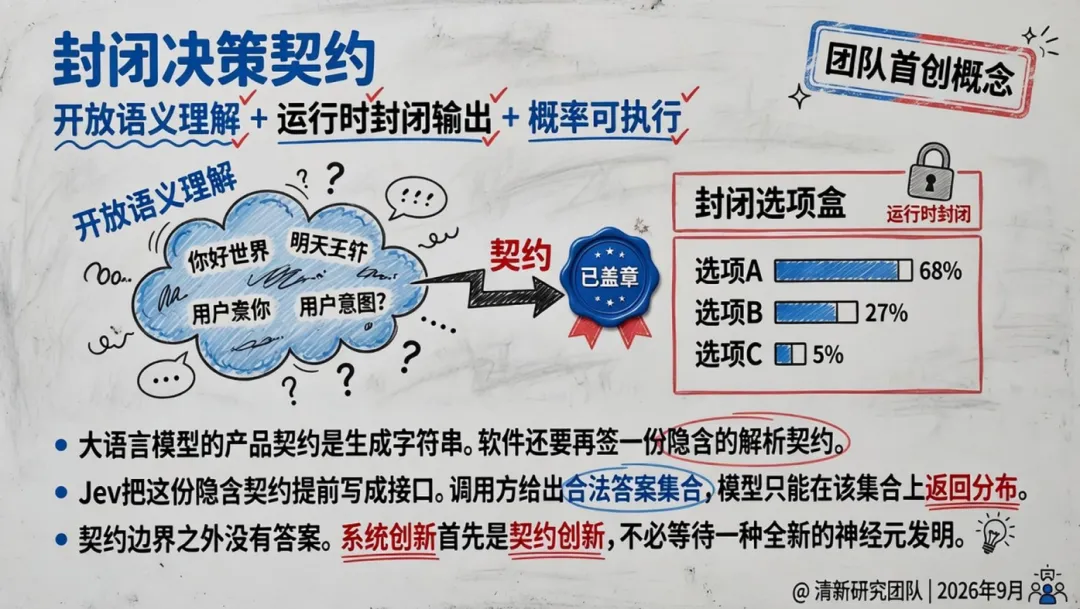
过去大模型的契约是,我给你输入文本,我输出任意字符串。
软件开发者被迫额外增加一层解析契约,小心翼翼处理它输出的各种意外格式。
Jev 把隐含契约提到接口层面,调用方定义合法答案集合,模型只能在集合之内返回带概率的判断。
这给整个 AI 工程带来新思路,AI 系统不一定全部要堆给一个 “全能大脑”。
还可以分层设计:
高速反射层(Jev 这类决策模型):处理海量高频简单语义判断;
执行层:代码承担算术、规则、业务动作;
发现层(通用大模型):负责创新、长推理、提出新问题;
验证层:真实业务结果回流,持续校准模型概率。
这也是报告提出的四层计算栈框架。
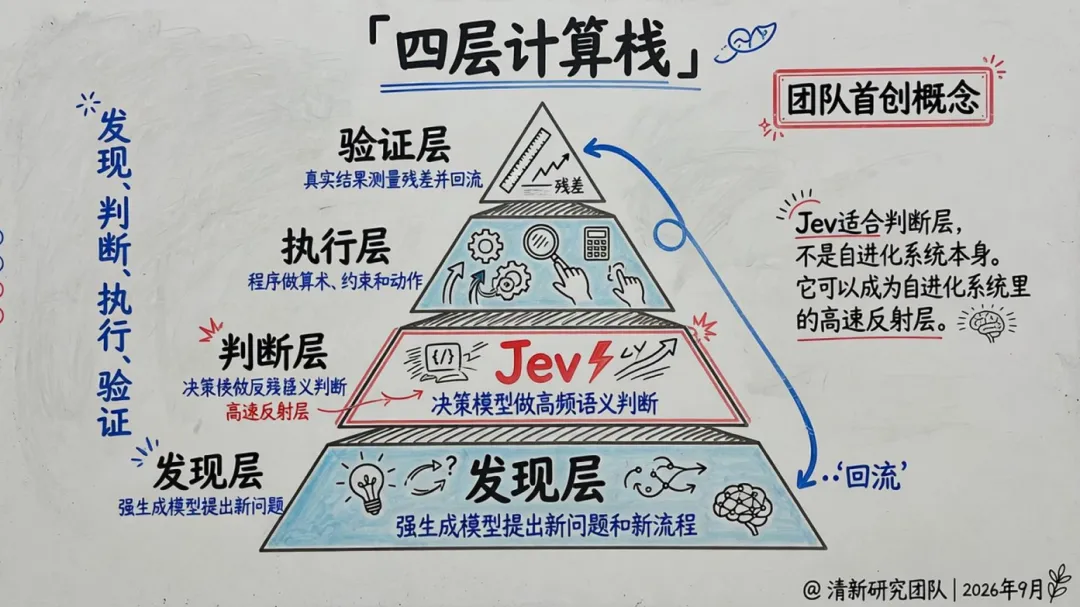
AI Agent 工业化落地,不一定追求一个什么都能干的超级模型,而是把不同能力拆分到不同组件,各司其职。
不要上来就大规模上线,建议做四周风险导向试点验收,验收指标优先看风险覆盖率、单位经济,而不是片面追求平均准确率。
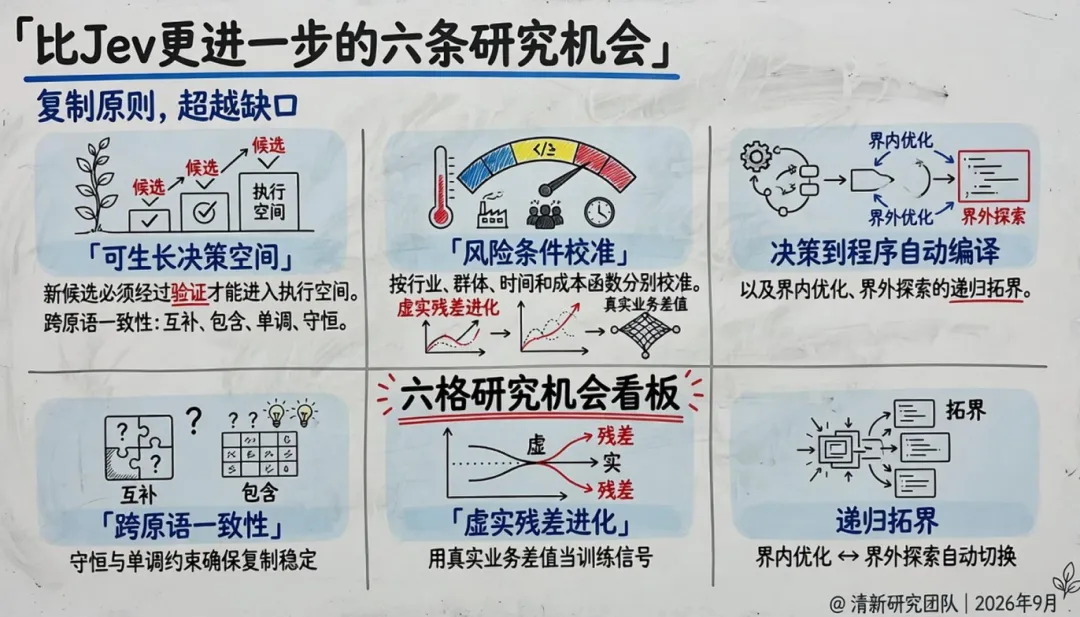
写在最后
Jev 的出现,戳中了 AI 行业长期被忽视的痛点:软件系统海量的高频判断需求。
它在接口与工程范式上实现了创新,但模型内核依旧是黑箱,尚缺乏充分公开证据支撑。
扫描下方二维码,获取《Jev深度研究报告-System One与机器原生决策智能》完整报告。
本报告内容由 AI 辅助生成。后续我们将持续迭代这套研究生成体系,不断优化分析能力,输出更高质量的行业深度研究报告。
ZeeLin自进化AI框架测试版已更新至0.1.4版本
新版现已支持Windows和MacOS双平台。无论你是独立开发者、产品经理、内容创作者、企事业单位人员,还是团队管理者,都可以在ZeeLin中找到适合自己的AI工作方式。
请用浏览器打开网址,一键安装:
https://www.zeelin.cn/#/zeelin
想看更多AI领域的深度内容,记得关注「清新研究」公众号和视频号。这里会持续更新前沿AI深度研究报告,也会分享AI音乐、AI视频、AI产品等方向的精彩洞察,干货不断,不要错过。


发表评论
发表评论: