研报速递
腾讯混元4(Hy4)研究报告深度解读
从一张冰箱照片说起
腾讯技术工程在发布当天做过一组实测,其中一个场景很能说明这份报告到底在讲什么。测试者拍了一张塞得满满当当的冰箱照片,要求模型给一家三口排未来三天的九顿饭,额外采购不超过 100 元,每顿做饭不超过 40 分钟。
模型先把照片按区域放大,逐层盘点,认出番茄、黄瓜、西葫芦、冷冻混合蔬菜、面包和调味品,还估了数量。有几样它没认准,左侧中层的粉色真空包装可能是鸡肉、猪排、火腿或鱼,右门的白色大罐可能是酸奶、奶油或奶酪酱。它把这四处疑点列出来,标成待确认,后面的菜单对这些食材做保守处理。接着它排采购清单、排三天菜单。测试者又追加了一个变化,第二天晚上多来两位客人,一位吃素,一位对花生过敏,预算不增,第三天伙食不受影响。模型重新算库存、重排分配,给了防浪费的兜底方案。
这个任务做成靠的是三件事叠在一起。看得见图,会调用放大裁剪这类工具,能在几十步里一直记住库存、预算和禁忌没有走丢。同一份报告里还有另一个数字,在一套叫 Hy-FrontierMath T5 的数学题上,混元4 拿 13.0 分,GPT 拿 97.5 分。
把这两件事放在一起,整份报告就读通了。混元4 被训练成一个很会干活、很会用工具的模型,一旦把工具收走、要求它凭自己想到底,它和闭源前沿之间还隔着一层。下面把这一层是什么、怎么量出来的、以及这个量法有没有问题,逐层讲清楚。
先把考场上的名词过一遍认全
后面每一节都要用到这些词,先在这里把它们讲清楚,尽可能不留裸奔的术语。
设想你让模型修一个开源项目里的 bug。你给它的全部输入就是一句话,去把这个仓库里登录过期报错的毛病修好。模型要自己打开终端、看目录、读代码、改文件、跑测试、看报错、再改、再跑,直到测试全绿或者时间用完。这一整串动作,就是智能体(agent)。模型在这串动作里调用的终端、编辑器、搜索、浏览器,统称工具(tools)。而规定它能用哪些工具、最多能走多少步、每步给多少时间、失败怎么判、最后怎么算分的那套外部程序,叫脚手架(harness,报告注脚里也写作 scaffold)。
考生是模型,考场是脚手架,后面会反复用到。
基准(benchmark)是一套固定的考卷加一套固定的判分规则。它由一堆题目和一套流程组成,报出来的只是一个数字。同一套题,换个脚手架、换个判分员、换个采样方式,分数就会变。报告附录里 34 行,就是 34 套考卷。
开源权重(open-weight)指模型参数文件公开可下载,别人可以自己部署、微调。它和日常说的开源不完全等同,训练数据、训练代码、完整配方通常并不公开。报告反复用这个词,是在给自己划坐标系,它比的是「开源权重模型」这一档,而把 GPT、Claude 放在「顶尖闭源模型」另一档。这两个坐标系的分法,决定了报告的全部叙事。
770B 与 MoE。B 是十亿参数。770B 是模型里参数的总量。混合专家(MoE)的做法,是把网络里的一部分做成许多并列的专家子网络,每次处理一个词,只挑其中少数几个专家参与计算,靠一个路由去挑。类比成医院,770B 相当于全院的花名册,每次看病只由分诊台叫两三个专科医生下来,其余医生不参与。所以参数总量可以做得很大,单次推理的算力却不按同样比例涨。报告没有披露每次激活多少参数、有多少个专家、路由怎么设计,这些都留给了随权重发布的系统卡片(system card)。
预训练与后训练。预训练决定模型知道什么,靠海量文本把语言和世界知识压进参数。后训练决定模型怎么接话,包括听指令、按格式输出、用工具、以及在高难度题上一步步想。报告说 Hy4 相对 Preview 两边规模都扩了,这个说法在分数上有对应,工具类和指令类涨得多,纯数学裸考涨得少。后面会回到这点。
长上下文与长程任务是两件事。长上下文问的是一次能读进去多少文字,比如能不能一口气读完二十万字。长程任务问的是能连续干多久、中间不迷路,比如跨几十步始终记得三天菜单的预算还剩多少。报告正文把「长上下文理解大幅提升」和「长程任务」并列当卖点,但附录里没有一套专门测上下文长度的考卷,能反映长程的 Goal2Repo 反而是混元4 分数最难看的一档。这个错位后面单独讲。
pass@1、pass@5、avg@3、报最优。这是同一道题做几次、取哪一次的问题。pass@1 是只许做一次,做对就算过。pass@5 是允许做五次,只要有一次做对就算过,报告的 ZeroBench 注脚写的是每题跑 10 次独立运行来估计 pass@5。avg@3 是跑三次取平均分,Goal2Repo 用的就是它。报最优(best-of-N)是跑若干次,把最好的那一次报出来。这四种口径报出来的数,含义完全不同。一份表里如果混着用,横向比大小就要小心。
LLM-as-judge,让一个模型去读另一个模型的答案并打分。像「生成的网页好不好看」「PPT 排得专业不专业」这类题没有标准答案,只能这么判。于是裁判是谁、裁判跑在什么脚手架上、评分细则怎么写,都成了会改变分数的变量。报告有多套内部基准用它。
Codex 与 Claude Code,两个智能体脚手架,一个来自 OpenAI,一个来自 Anthropic。它们规定模型能开什么终端、能改什么文件、能跑多少轮。报告注脚里有一句很关键的话,在约十套考卷上,GPT 系列模型用 Codex 评,其他模型用 Claude Code 评。这一条的分量,后面讲评测公允性时完整拆开。
研究级数学与形式化证明。FrontierMath、ProofBench 这类题,不是「算出 x 等于几」,而是「构造一个满足某性质的对象」或者「写出一个机器能逐步检查的证明」。它没有选项,没有答题模板,判分靠严格验证器。会做高考题和会做这个,是两种活。
RSI,递归自我改进(recursive self-improvement),指模型参与改进模型本身,比如自己调数据、改架构、定训练策略、把一个小模型训得更好。报告说 Hy4 正在为这条路做准备。
34 套考卷,其实是九种量法
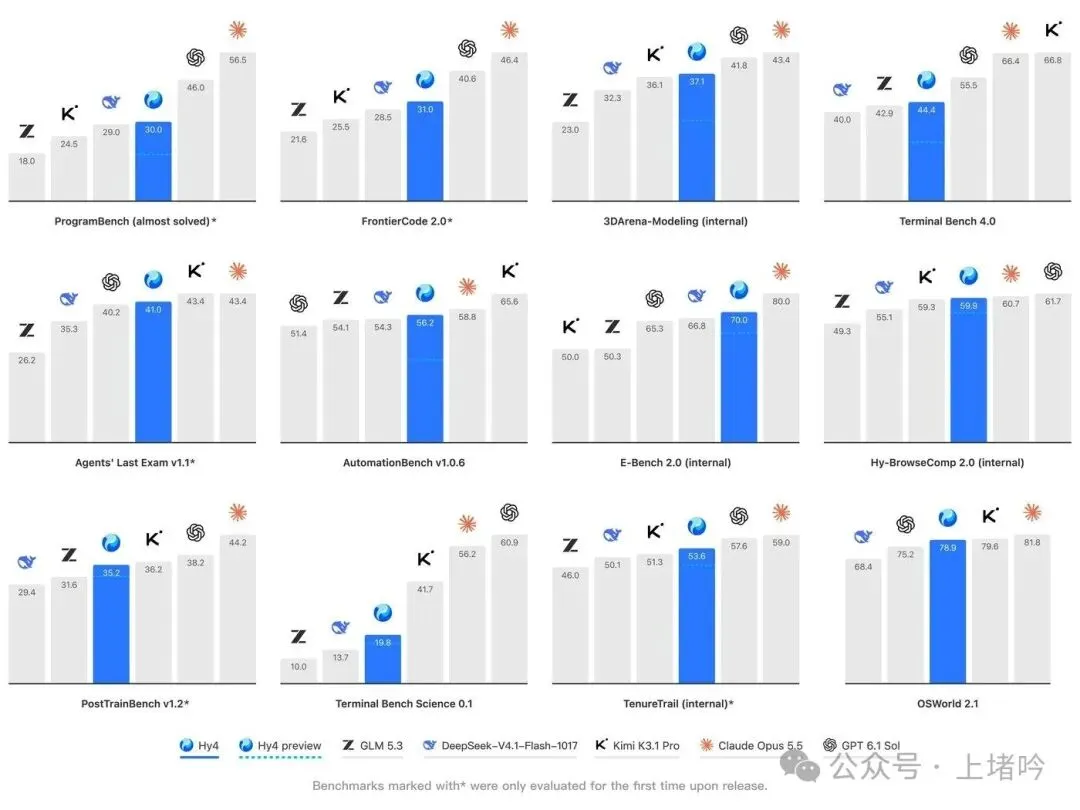
图注|报告开头挑出来的 12 项基准,蓝色是混元4。这些题大多允许工具或多步执行,蓝柱普遍居中偏上,个别还排到第一。(来源|腾讯混元 Introducing Hy4 原报告配图)
按任务类别分,附录 A 是七组。按判分方式分,是九类。后一种分法才决定一个分数能信到什么程度。基准名长得像,考的东西未必是一回事;名字里带同一个词,判分也可能完全不同。
第一类,闭卷学术题,答案唯一,机器验算。Humanity's Last Exam 由 CAIS 与 Scale AI 在 2025 年做成,从七万多道投稿里筛出 2500 道,近千名专家、五百多家机构、五十个国家参与出题,覆盖上百个学科,其中约七成六要给出精确短答案,约两成四是选择题,一成四带图。题目闭式、答案可自动判,还专门留了一批不公开的私有题,用来量模型有没有把公开题背下来。官方自己写得很清楚,在这套题上拿高分,说明模型在闭卷的前沿学术知识上到了专家水平,并不等于能自主做研究,更不等于通用人工智能。
FrontierMath 是 Epoch AI 的另一条路线,题目原创、不公开、答案是可以计算验证的闭式结果,按难度分四档,最难的第四档由数学教授和博士后设计,人做一道可能要几天。它难在算,更难在得自己找切入点。腾讯表里的 Hy-FrontierMath T5 名字几乎一样,那是腾讯内部变体,和 Epoch AI 官方那套没有关系,ProofBench 同样是内部基准。名字借用了公开基准的威信,分数却不能和公开榜对照。这一类题的价值在于答案能自动判对错,猜对的概率被压得很低,适合拿来做强化学习;边界在于它量的是闭卷学术能力,量不出一个人能不能把课题从零推到结果。
第二类,代码补丁,隐藏测试说了算。SWE-bench 的做法很朴素,从真实 GitHub 议题和对应的合并请求里取题,把仓库和问题描述给模型,让它改代码,再用两套测试判分。FAIL_TO_PASS 是原来红、修完该绿的测试,PASS_TO_PASS 是前后都该绿的测试,用来确认没把别的功能改坏。OpenAI 后来请 93 位有 Python 经验的开发者筛了 1699 个样本,留下 500 个人工确认没毛病的,就是 SWE-bench Verified。它承认原版有三处硬伤,单元测试写得过窄甚至和议题无关,会误杀正确解法;问题描述欠明确,模型猜不到要求;开发环境不稳,正确的补丁也可能被判错。这类基准看着最硬,误差却藏在测试本身。也有报道提过用十来行代码骗过测试框架的案例,此处只当背景,不拿它下结论。
第三类,容器化终端任务,查最终状态。Terminal-Bench 把题放进 Docker 容器,给一句自然语言指令,最后跑一段隐藏脚本检查系统状态,文件改没改、服务起没起、配置对不对。它考的是长程自治,读报错、走岔了能退回来、几十步之后还记得目标。这类榜排的是「模型加脚手架」这个组合,模型只占其中一项。附录 B 里 Terminal-Bench 4.0 的注脚写得具体,Claude Code 脚手架、最多 500 轮、每次试验 13 小时、16 核 CPU 与 32GB 内存封顶、三个依赖 GPU 的题另给一块 H100。光看这串配置就知道,分数里有相当一部分是考场给的。
第四类,真实电脑操作。OSWorld 是港大与 Salesforce 等机构做的,369 道真实任务放在 Ubuntu、Windows、macOS 的虚拟机里,涵盖浏览器、办公软件、编辑器、文件系统和跨应用流程,每题配一份初始状态配置和一段可执行的判分脚本,检查的是文件到底重命名了没有,不是回答听起来对不对。论文里人类完成 72.36%,当时最好的模型只有 12.24%,卡在界面定位和操作知识上。八道依赖 Google Drive 的题可以排除,分母变成 361。2025 年 7 月的 OSWorld-Verified 修了社区报上来的错题、网站结构变化和判分函数缺陷,官方提醒跨版本分数不要直接比。Epoch AI 后来指出三条结构性限制,约一成五的题只用终端命令就能做完,另有约三成可以用 Python 脚本替代原本要点的界面,约一成题存在判分函数损坏或描述要求不可能动作。报告用的是 OSWorld 2.1,分数 78.9,和论文里那个 12.24% 之间隔了两年、两个版本和几轮判分修订,摆在一起看会得出完全错误的结论。
第五类,浏览检索,难找但好验。OpenAI 的 BrowseComp 有 1266 道题,用反向出题法造题,先从一条难找的事实出发,把它改写成满足若干约束的短答案问题,答案好验,线索难找,要求模型反复搜、组合条件、不轻易放弃。题目里埋了 canary 唯一标记,一旦整套题进了训练语料,可以顺着这个标记查出来。腾讯内部的 Hy-BrowseComp 2.0 和 Hy-LifeSearch 名字相近,判分换了路子,附录 B 写前者由 LLM 裁判对照唯一参考答案打分,后者由 LLM 裁判按逐题评分细则打分。同样的检索活,从精确比对换成模型打分,分数的性质就变了。
第六类,业务工作流。Zapier 的 AutomationBench 是这类里判分最干净的。它模拟 47 个 SaaS 应用、约 500 个 API 端点,六个业务域各 100 道公开任务,另有一批不公开的 657 道保留任务,官方榜跑的是保留集。模型拿到一条触发消息,要自己搜出该调哪个接口,读懂藏在邮箱或表格里的业务规则,把几个系统都改到正确状态。判分是一组确定性断言,检查最终环境状态,还有反向断言专门抓给所有人群发一遍这种取巧做法。一道题十条断言过了九条,得分仍是零,部分分只作诊断不进榜。整套流程没有 LLM 裁判,同样的终态两次跑分一致,运行间波动通常在百分之一以内,每道题花了多少钱也一并公布。
这里要多停一下。附录 B 里写了腾讯用的是「Zapier 公开的 600 个任务,按官方方法评测」,而 Zapier 官方榜跑的是不公开的 657 道保留集。公开集可以拿来调模型、调脚手架,保留集不行。同一套基准,选公开集还是保留集,抗污染能力差一大截。这条注脚不显眼,却直接决定了这一行的分数能和谁比。
对照着看 E-Bench 2.0 的注脚,分数合并最终数据库状态检查与 LLM 裁判;PPTGen-Bench 是整体美感评估与关键缺陷惩罚;Tag-bench 是 LLM 裁判加程序化验证器。同样是办公任务,判分从确定性断言一路滑向模型审美,可信度要一档一档往下调。
第七类,视觉问答,看不清还是想不明白。MMMU-Pro 是把 MMMU 硬化过的版本,三步都冲着堵捷径去。先让四个纯文本模型不看图各答十次,能被其中三个答对的题一律剔掉,因为这些题不看图也能做;再把选项从四个扩到十个,随机猜中率从 25% 掉到一成出头;最后把题干和选项整个嵌进照片或截图里,逼模型先从图里把字读出来。最终 3460 个评分项,是 1730 道题乘两种设置。论文里各家模型相对原版 MMMU 掉了 16.8% 到 26.9%,光是把四个选项换成十个,GPT-4o 就从 64.7% 掉到 54.0%。有个细节很说明问题,LLaVA-OneVision-72B 的 OCR 准确率能到 87.8%,纯视觉设置下却只有 24%,把字认出来和把字在图里的作用想明白,是两件事。人类基线 85.4% 沿用原版 MMMU 的专家数据折算,没有在这套题上重测,这一条也常被各种发布报告有意忽略。
ZeroBench 是另一路,100 道主问题加 334 道子问题,视觉谜题,严格字符串匹配,报 pass@1、pass@5 和 pass^5,工具辅助与不用工具的结果分开列,题目里同样埋 canary。100 道题意味着每题值一个百分点,一两道题的判分修正就能撬动整行分数,官方后来确实做过一次 0.71% 的判分订正。腾讯的 BuddyVQA Atlas 是内部基准,专挑小字、细线、局部小目标和需要定位的题,考点和前两者都不重合,不能互相替代。
第八类,长程职业任务。伯克利 RDI 的 Agents' Last Exam 用了 1500 多道来自真实职业项目的题,覆盖 55 个非体力职业,300 多位专家、100 多家机构参与,全图形界面加命令行环境,判分用确定性的代码检查器对照可验证的交付物,没有人工主观分。它把题分成三档,最难的 Last-Exam 档,所有受测的前沿智能体都是 0%。同一个组合在 Terminal-Bench 上能拿 82%,在 ALE 全量上只有 24%,最硬档归零。最常见的失败模样是智能体回一句「Done. All checks pass.」,交付物却缺文件、数目不对或者违反了明写的约束。报告里 Agents' Last Exam v1.1 那行,混元4 41.0、GPT 40.2、Claude 43.4,和官方公开的整体分数口径不同,可能是子集或不同档位,不能直接对照。
Cognition 的 FrontierCode 把判分往工程现实又推了一步。它不问测试过没过,问维护者愿不愿意把这个 PR 合进去,按行为正确性、回归安全、机械整洁度、测试写对没有、改动范围、代码质量几项评。ProgramBench 考从零搭出一个完整程序,Goal2Repo 是腾讯内部的长程自我调试。这类题把会不会和能不能坚持几十步混在一起测,分数低了不好归因,这是它们天然的代价。
第九类,主观生成与相对名次。网页好不好看、PPT 专不专业、3D 模型美不美,没有标准答案,只能让裁判打分或者两两盲评。3DArena-Modeling 的注脚写的是盲评两两比较得出的 Elo 分换算成百分比。Elo 来自棋类,用 Bradley-Terry 一类的模型把两两胜负换成相对强度,100 分的差距大致对应 64% 的胜率。它量的是在这批对手面前排第几。换一批对手、换一段提示词分布,名次就变,绝对能力有多少并不由它给出。长度、格式、语气这些与质量无关的因素对盲评的影响已经被反复量出来,所以严谨的榜会给置信区间,还会做风格控制后的再排名。
把九类摊开,再回头看附录 A,一张表里挤着精确匹配、隐藏测试、容器终态检查、确定性断言、模型裁判、Elo 换算,以及带工具与不带工具两套采样。这些数不是同一种量。
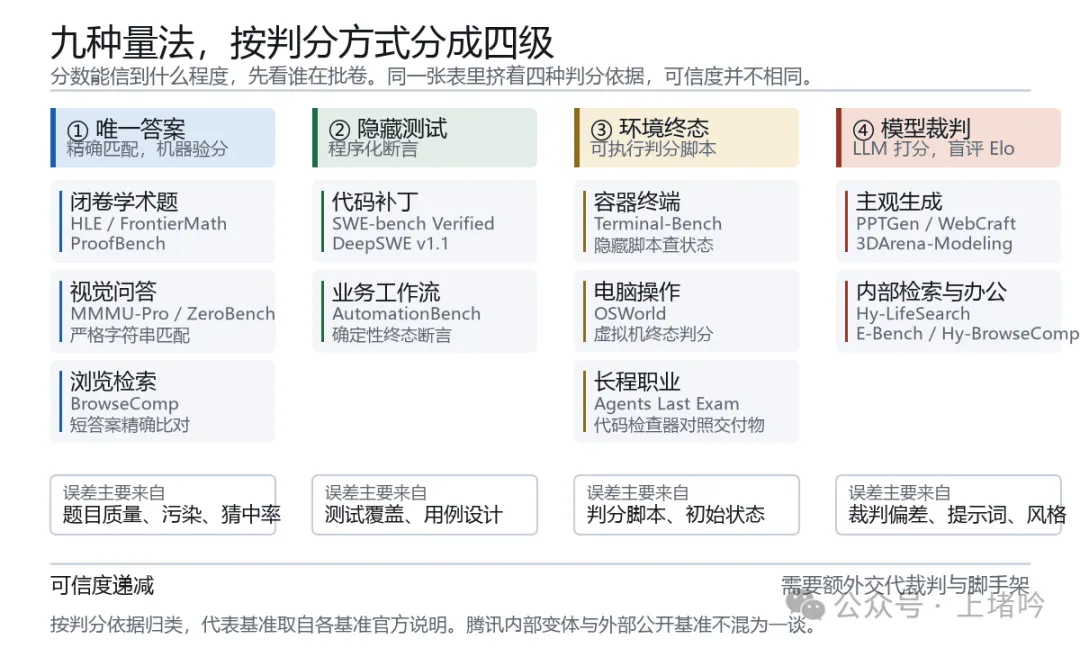
图注|把 34 套考卷按判分依据归成四级。越往右,分数里混进的裁判主观因素越多,越需要额外交代脚手架与提示词。(来源|本文据各基准官方说明整理)
谁在批卷,分数就替谁说话
九类卷子共用四道关口,哪一道没交代清楚,分数就要打折。
第一道,自动判分和模型裁判是两种东西。前者的误差来自题目出得好不好、测试写得全不全;后者的误差还要再叠一层裁判自己的脾气。CALM 那套量化框架把 LLM 裁判的偏差列了十二类。位置偏差是同一对答案换个先后,判断就翻;长度偏差是写得长的更容易得高分,哪怕更啰嗦更不准;自我增强偏差是裁判偏向自己生成的答案。此外还有同情消退,挂上知名模型名字和匿名打分结果不一样;从众,提示里说九成人认为 A 好,裁判就跟着走;权威,挂个假引用就加分;干扰,塞一段无关的饮食描述也能改判;谬误放任,只看最终答案对不对,放过中间推理里的逻辑错。再加上情绪、身份标记、以及告诉它这是改过的版本就多给分。后来的压力测试里,强模型当裁判在诱导条件下的错误率能超过五成。
缓解办法不复杂,把答案顺序交换着跑两遍,用多个裁判投票,尽量做两两比较,少给单个答案打绝对分,让裁判和被测模型错开来源。回到腾讯这份报告,附录 B 里 Hy-LifeSearch、Hy-BrowseComp 2.0、Agents' First Exam-IF、Tag-bench、E-Bench 2.0、PPTGen-Bench 都点了 LLM 裁判,WebCraftBench 写的是贴合人类偏好的评审视角,3DArena 走盲评 Elo。这几行的分数,和 DeepSWE、FrontierMath 那种机器验分的分数,不该放在同一个可信度档位上读。
第二道,同一道题做几次、取哪一次。Codex 论文给过 pass@k 的无偏估计,1 减去组合数 C(n-c,k) 除以 C(n,k),n 是总采样数,c 是其中正确的条数,n 不小于 k。k 取 1 时化为正确率 c/n。这个量回答的是 k 次机会里至少有一次做对的概率,也就是答案池里是否存在一个正确解,它不回答用户随手用一次能不能成。把 pass@5 当成日常可用率,是读这类表最常见的错。更严的是 pass^5,五次全做对才算过,和 pass@5 差一个符号,含义反过来。avg@3 是三次取平均,报最优是跑若干次挑最好那次。HumanEval 那 164 道手写 Python 题后来被加了更强的测试,同一批模型分数明显下滑,判分强度一变,分数就跟着变。
附录 A 里 APEX-Agents 标 pass@1,ZeroBench 标 pass@5,Goal2Repo 是 avg@3,OSWorld 2.1 报完整分与部分分,3DArena 是 Elo 换算,总注脚又说报告的是最高评分采样中的最佳值。六种口径写在同一张表里,横比大小这个动作本身就站不住。
第三道,题目有没有被背下来。公开的测试集迟早会进训练语料,模型把答案记住了,推理能力没跟上,分数就虚高,这叫基准污染。防法大致三条。把题藏起来,HLE 留私有集,FrontierMath 不公开原题,AutomationBench 官方榜跑保留集。按时间切开,LiveCodeBench 只收模型发布日期之后的题。重新造一套同分布的题,GSM1k 就是照着 GSM8k 的分布重出一遍,看分数掉不掉。题里还会埋 canary GUID 一类的唯一标记,方便事后查泄漏,再用 n-gram、MinHash、Min-K% 或困惑度去做成员推断。
腾讯这份表约 19 套是内部基准,题目不公开,理论上天然抗污染。但同一枚硬币的另一面是别人没法复现,也没有第三方替它挑过错题。抗污染和可复现在这里此消彼长,不能只说前一半。HLE 从 2500 题定稿到 2025 年 10 月又分出 HLE-Rolling 动态更新版,连公开基准自己都在改题换题,跨版本比分数同样要小心。
第四道,误差棒。100 道题的卷子,多做对两道就是两分;AutomationBench 用 657 道保留题,官方说运行间波动通常在百分之一以内。样本量差六倍,同样的三分差距,一边可能是噪声,一边可能是真信号。给置信区间、重复试验的标准差、显著性检验,本来是让分数可解释的常规动作,附录 A 全表没有。HLE 官方榜的做法可以对照,它按 95% 置信区间定名次,两个模型的区间重叠就并列,不按裸分排先后。
同一张表里的数,能直接横比吗
把前面两节的道理收拢到一个具体的量上,就是脚手架究竟能撬动多少分。
2026 年有一篇立场论文叫《Stop Comparing LLM Agents Without Disclosing the Harness》,做了 3 个前沿模型乘 3 种脚手架、在 100 道 SWE-bench Verified 题上的对照实验,提出绑定约束假说,在长程任务上,性能方差主要由脚手架而非模型决定。汇总出来的数字是,脚手架引起的方差 18.48,模型引起的方差 2.37,比值 7.80;固定模型只换脚手架,pass@1 变动 8.5 到 13.0 个百分点,固定脚手架只换模型,只变 2.5 到 5.0 个百分点;九组模型对与脚手架对的比较里,六组在换脚手架后排名反转。同一季还有别的独立证据往一个方向走,HAL 记录过同一个模型跨脚手架接近 48 个百分点的落差,而六个前沿模型在标准化脚手架下只差 4.9 个百分点;只改系统提示词、工具选择和执行流,模型不动,Terminal-Bench 也能从 52.8% 走到 66.5%。
这些数字来自论文与几份二手分析的汇总,我没来得及逐页核对原 PDF,但量级应该可信,精确值可以参照一下。论文自己也写了适用边界,只在长程任务、且模型水平相近时成立,短问答或者能力差距悬殊的比较不在此列。
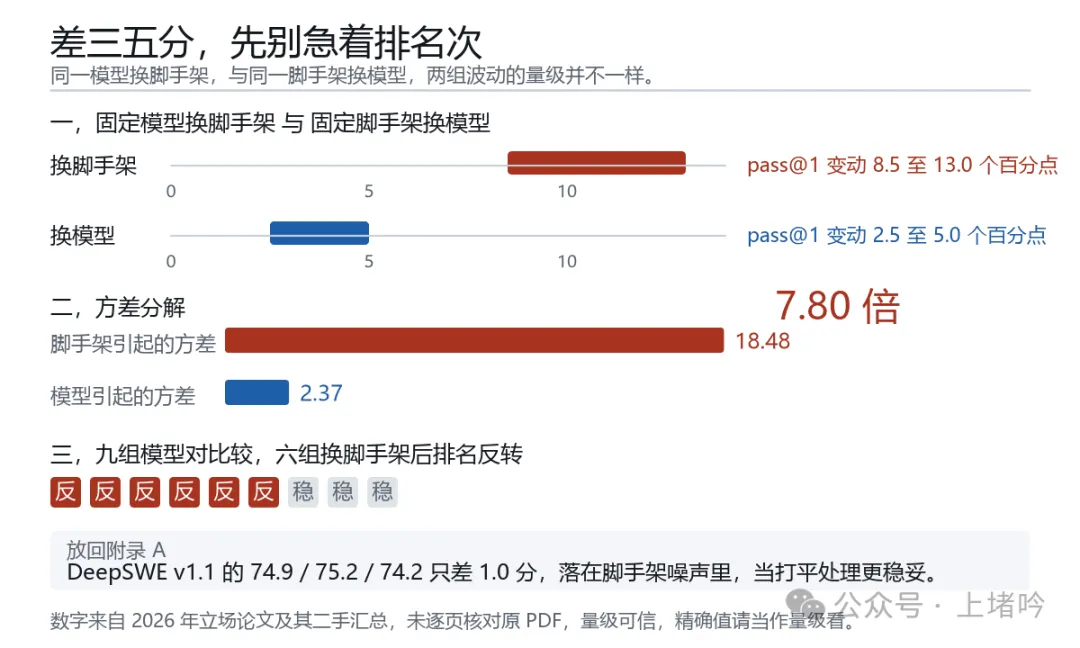
图注|脚手架引起的波动比换模型大一个量级。附录 A 里那些差三五分的格子,落在这条噪声带里。(来源|本文据 2026 年立场论文与二手汇总整理,精确值未逐页核对原 PDF)
把这个量级放回附录 A,结论很直白。表里那些差三五分的格子,比如 DeepSWE v1.1 的 74.9 对 75.2 对 74.2,或者混元4 反超 GPT 的几行,落在脚手架能随手撬动的区间里,当打平处理感觉更稳妥。但13.0 对 97.5 那种八十多分的落差,换一套脚手架肯定不至于翻过来,方向仍然可信。这也解释了为什么附录 B 那些看着琐碎的注脚得逐条细读,Codex 与 Claude Code 的版本号、500 轮上限、13 小时超时、16 核与 32GB 的封顶、有没有内容过滤拦截,每一行都是在给分数基准线做解释。
还有一层更根本的问题,也许可以复现。一份分数要让别人验,至少得给出题目、判分脚本、脚手架版本、采样次数、失败与超时的处理方式,以及成本。附录 B 给了脚手架和部分资源上限,没有给题目、判分脚本和逐题结果,约 19 套内部基准连题面都不公开。Zapier 把公开 600 题的代码放在 GitHub 上,允许任何人本地重跑;SWE-bench Verified 把 1699 个样本的人工标注全部放出;ALE 把数据集、代码和命令行子集开源。这几种做法的差别,比同一行里差三五分要大得多。
判分方式也许可以判断这个数最多能说明啥,样本量决定它经不经得起抖一抖。至于能不能和旁边那一格比,得看脚手架的情况。三样缺一样,分数就只能当方向读——一个大概的比较。
所以回头细看,报告正文与附录分数是发布方披露的事实,而方法注脚是发布方给出的评测条件,从分数形态反推的机制解释可以理解为都是推断。外部基准的官方页与论文用来说明各类考卷的设计,很难与腾讯内部变体混为一谈。中文发布稿与公众号实测只补了背景,没有仔细阐述分数来源。
混元4到底动了哪几处?
按「原来是什么、改了什么、为什么这么改」逐项梳理一遍吧。
规模从不到 300B 爬到 770B。发布节奏是 2026 年 2 月重建基础设施之后,平均每两个月一个大版本,先出 Preview 收反馈,再出正式版。Hy3 系列不到 300B,Hy4 系列 770B,下一代 Hy5 还要更大。参数往上堆,配合 MoE 控制单次算力,是这一代最基础的动作。
首次加视觉能力。这倒并不是说「从此能看图了」,这里要拆成三层。图像先被切成小块送进编码器,变成一串向量,再接进语言模型;模型因此能把图里的细节和文字一起推理。视觉、推理、工具调用三者叠起来,报告说它能做细粒度图像识别、复杂图表解析和视觉数学。但把图切成小块再压缩,最先丢掉的就是小字、细线和局部小目标。后面「戴上眼镜和摘下眼镜」那组带工具 81 分、无工具 55.6 分的落差,根子就在这里。个人理解和真正的多模态原生是有差距的,半挂和拼接的LLaVa思路。
图注|原报告「视觉与电脑操作」节的示例图,航拍影像与模型输出界面并排。报告用它说明首次加入的细粒度图像识别与复杂图表解析。(来源|腾讯混元 Introducing Hy4 原报告配图)
首次支持电脑操作(Computer Use)。同时打通命令行和图形界面,等于给智能体装上了手。针对 Blender、CAD 这类专业软件,以及需要跨好几个应用才能干完的长流程,做了专项训练。之所以要专门练,是因为这类软件的菜单、状态、报错都和普通网页不同,不练就只会点错地方。
垂直场景的数据是现造的。金融方向造了数千个真实工作空间、上万个任务,覆盖基金研究、证券分析、量化策略、资产配置、公司金融、财税会计,还拉了腾讯金融科技 FiT 一起做 213 位专家的众测,其中 153 位来自外部头部机构,七成从业五年以上,跑 579 个真实金融任务。前端方向练复杂交互、业务逻辑、状态管理、前后端联动;游戏方向和腾讯 IEG 的开发者共建数据与评测,适配 UE、Unity、Godot,还扩到多人联机。这些数据的共同点是有明确对错、有可验证的成品,正好适合拿来训练「会干活」的模型。
检索专项优化。针对时效检索、多源整合、事实一致性校验做了一轮,报告说幻觉率从 Preview 的 15.76% 降到 5.45%,猜测导致的错误率从 23.1% 降到 5.6%。这里有个坑,中文发布稿写的是幻觉率 12.95% 降到 7.2%,同一个指标两套数。讲评测公允性那一节会说到这个不一致。
Co-Design 与产品协同。报告把「和产品团队一起设计」当成方法,不是谦辞。元宝、WorkBuddy、CodeBuddy、ima 既是落地场景,也是数据来源和评测来源。这也解释了为什么报告里有一整节是产品方证言,那四家里有腾讯自家产品。
安全侧做了减法。训练里只留防守性网络安全材料,也就是 PoC 生成和漏洞修复,把漏洞利用、逆向、渗透这类攻击性内容过滤掉,再请玄武和科恩实验室做密码分析、逆向、漏洞利用方向的红队审计,结论是进攻性能力未见突出风险。生物安全方向给了一个具体分数,Hy-BioExperimentBench 30.4 分(满分 100),低于高危阈值,内部专家审计的说法是基础知识掌握较好,把知识转成可执行实验方案的能力有限。
报告没告诉你的部分。训练数据构成、对齐方法、上下文长度、专家数量与路由、算力规模,全都没写。报告结尾说,等开源权重时会同步发一份全面的系统卡片,详述安全评估和更多技术细节。所以现在这份文档的技术披露是有些单薄的,作为发布稿来解读似乎更准确。
十三分和九十七点五分之差
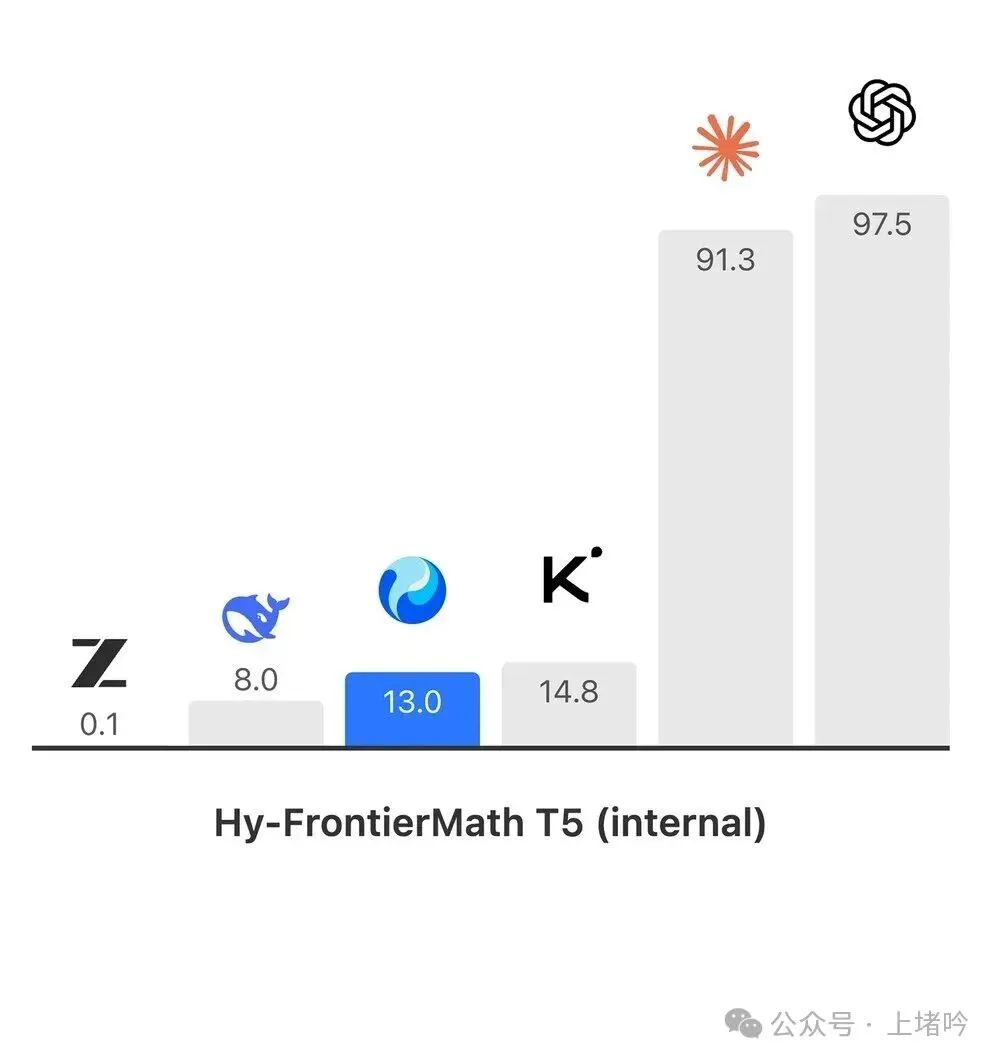
图注|报告「展望」节自己挑出的第一处差距。研究级数学题上混元4 13.0 分,GPT 97.5 分,Claude 91.3 分,三个开源权重模型都在 15 分以下。(来源|腾讯混元 Introducing Hy4 原报告配图)
先把这行数字摆完整。
差 84.5 分。这个数量级要先解释清楚,它不是「差一点」,是两种东西。
这套卷子考的是什么。研究级数学题通常长这样,给出一个前人没解决的构造问题,或者要求证明某个命题对所有情形成立。模型要自己决定从哪条路切进去,中间几十步推理不能断,最后还要给出一个能被验证器逐行检查的答案。它没有选择题的运气成分,也没有「背过类似题就能套」的捷径。ProofBench 更硬一层,要求产出形式化证明,每一步都得合规则,光给答案不算。
为什么会出现 0.0。GLM-5.3 在两项上都是 0.0,DeepSeek 是 0.0 到 8.0,Kimi 3.9 到 14.8。0.0 有两种读法,一是这套题一道都没做对,二是评测流程压根没跑通、验证器没收到可判的东西。报告注脚没有为这两项单独交代失败情形,所以我只能把两种可能都摆着,不下定论(推断)。
为什么混元4 会在这里掉队。这里要引一条反例才不会讲偏。HLE-Full 是 Humanity's Last Exam,一套高难度百科级问答,允许带工具,混元4 拿 59.1,GPT 60.6,Claude 67.7。同一批模型,换一套允许查资料、允许用工具的题,差距立刻缩到几分。所以不能说混元4 不会推理。差别在于题目准不准用工具,以及要不要凭自己把一条很长的推理链从头走到尾。
再往前一步是我的推断,报告没给训练细节,只能从分数形态反推。数学和代码这类题有一个别的领域没有的特点,答案能自动判对错。有了自动判分,就可以在后训练阶段做大规模强化学习,让模型反复尝试、错了就调、对了就加固,这条路业内叫可验证奖励强化学习(RLVR)。再叠上测试时算力,也就是允许模型在给出答案前先在内部想很长一串,裸考数学的成绩会被拉得很高。97.5 和 13.0 这种分布,像是「有没有把后训练算力和思考预算重押在这条路上」的分水岭。混元4 这一代的重心明显放在工具、智能体、垂直场景,纯推理这条线的投入相对少(推断)。
闭源内部也有分化。ProofBench 上 GPT 70.5、Claude 42.2,差 28 分。可见「闭源都强」不成立,具体强在哪一项,各家不一样。这一点在比较时要记住,报告的闭源锚点只有两个模型,换一家结论可能就变。
二十三点二和七十四点零
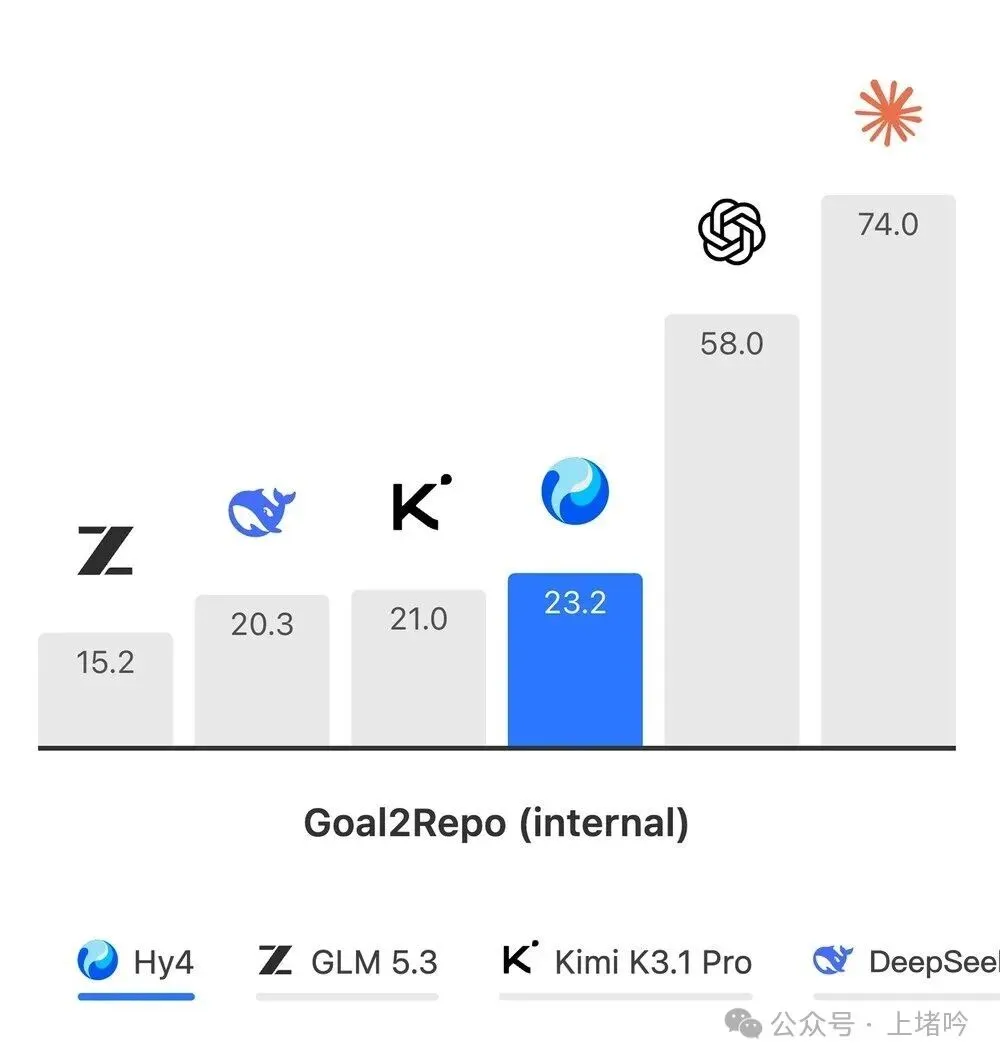
图注|报告点名的第二处差距,长程编码任务 Goal2Repo。混元4 23.2 分,GPT 58.0 分,Claude 74.0 分,四个开源权重模型挤在 15 到 23 分。(来源|腾讯混元 Introducing Hy4 原报告配图)
Goal2Repo 这一行的落差仅次于数学,但它的机制比数学好讲,因为注脚把流程写全了。
注脚大意是,给智能体一份自包含的规格说明书作为目标,考它长程编码和自我调试;智能体可以多次提交,隐藏测试集每次返回通过率反馈,失败有惩罚,一直跑到全部通过或者预算耗尽;GPT 系列跑 codex v0.166.0,其他模型跑 claude-code v2.1.316,取三次平均(avg@3)。
把这件真事从第一步走到最后一步。第一步,模型读规格,规划要建哪些文件、写哪些模块。第二步,写代码并提交。第三步,隐藏测试跑一遍,告诉它通过了百分之多少,注意不是告诉它错在哪一行。第四步,它得自己从通过率的变化反推哪块出了问题,改完再提交。第五步,重复,每一步都要记得前面改过什么、为什么改、还剩多少预算,失败还要扣分。第六步,要么全绿,要么钱花完。全程跑三次取平均。
分数是 Hy4 preview 18.1,Hy4 23.2,GLM 15.2,DeepSeek 20.3,Kimi 21.0,GPT 58.0,Claude 74.0。四个国产开源挤在 15 到 23 这一小段,两个闭源在 58 和 74。
这里差的不是代码写得好不好。DeepSWE v1.1 那一行,混元4 74.9,GPT 75.2,Claude 74.2,Kimi 75.5,几乎完全持平,说明单次写代码这件事上大家一样强。Goal2Repo 难在「能不能在几十轮里不迷路」。每多一轮,就要多记一分上下文、多扛一次失败、多一次别把前面修好的东西又改坏。这是长程状态保持和从失败里恢复的能力,上下文窗口再长也不会自动送给你(推断)。
同一节的另一行也印证这个分野。Terminal-Bench-Science 0.1 上混元4 19.8,GPT 57.0 到 60.9,Claude 58.7;但 TenureTrail 上混元4 53.6,GPT 57.6,Claude 59.0,几乎贴住。TenureTrail 是七大学科 123 项可执行科研任务,注脚说它考「研究智能体能否在这些任务上取得可验证的进展」。同样是科研场景,一个贴住、一个差四十分,说明差距落在任务要求的连续步数和自我纠错强度上,不在「懂不懂科学」。
顺带回答一个前面埋的问题。报告正文说长上下文理解大幅提升,附录里没有 RULER、LongBench 这类专门测上下文长度的考卷。能读多长和能干多久是两回事,而能干多久的那一格,恰恰是混元4 分数最不好看的一格。卖点和证据之间,这里有个缺口。
让 AI 自己造 AI
Foundation Model Bench 那一行,Hy4 preview 13.6,Hy4 28.1,GLM 25.6,DeepSeek 36.3,Kimi 25.1,GPT 41.3,Claude 55.4。
注脚只给了一句定义,这套基准测智能体能不能通过训练数据、架构、训练策略去优化一个领域专用基础模型。翻成一件具体的事,就是给你一个还不太行的小模型,让你自己挑数据、改网络结构、定训练超参,把它训得更好,最后用训出来的模型效果打分。
这一步跨得比写代码大。写代码时,反馈是明确的,测试红了就是错了。训模型时,反馈又慢又含糊, loss 降了不代表效果好了,换一批数据可能这几项涨那几项掉,一次实验要跑很久,还得自己决定下一个实验试什么。它要求模型同时扮演研究员和工程师,会提假设、会设计对照、会读结果、会换方向。
报告里有一处值得放在一起看。它在「科研与 AI 研发」那一节说,混元4 正为递归自我改进做准备,配合 Hyra 2.0 脚手架优化了内部同架构小模型的预训练基础设施,还自动训出了一个在多项评测上优于官方 Jev 基线的变体,并开源了由这套体系协同研发的单细胞表征模型 HyCell 和物理场模型 HyPDE。这是很实的成果。但同一份报告的 Foundation Model Bench 上,混元4 只有 28.1,低于 GPT 41.3,低于 Claude 55.4,甚至低于 DeepSeek 36.3。
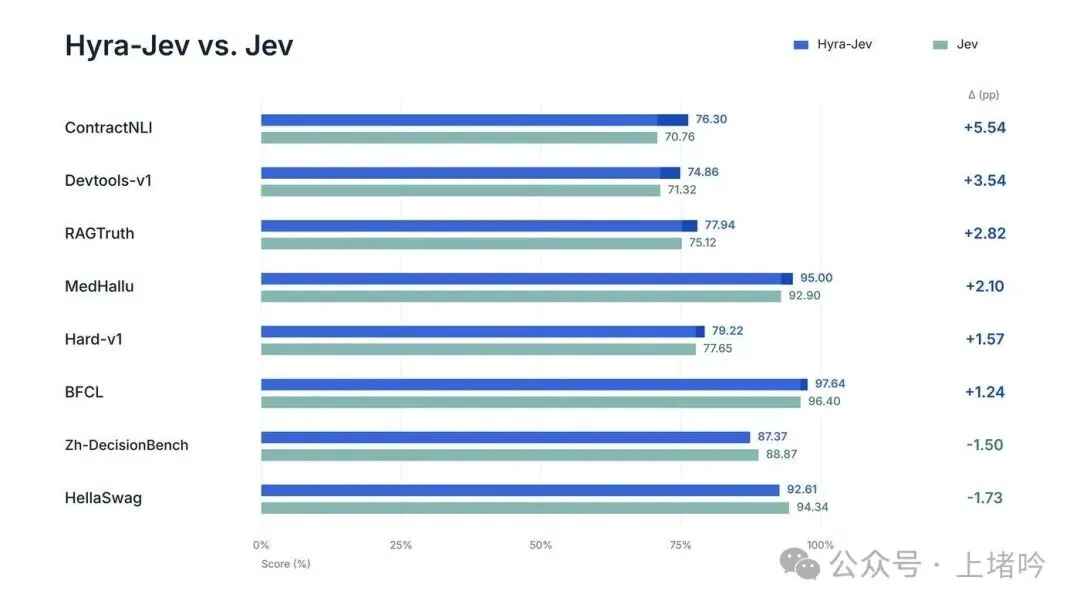
图注|报告「科研与 AI 研发」节的成果图,混元4 配合 Hyra 2.0 自动训出的变体与官方 Jev 基线对比。八项里六项高于基线,两项略低,最大涨幅 5.54 分。(来源|腾讯混元 Introducing Hy4 原报告配图)
两种读法。一是「在有人搭好脚手架、限定好范围的具体工程任务上能出成果」和「在开放式优化任务上自主达到前沿水平」本来就是两档能力,两者不矛盾。二是自动训出变体这件事发生在 Hyra 2.0 的辅助框架里,基准考的却是智能体自己搞定全流程,评测条件和实际成果之间有落差。报告没有交代这两者用的设置是否一致,我只能把疑问摆出来,不能替它回答(推断)。
这一格另有一处反常。DeepSeek 36.3 高于混元4 28.1,而这一代的 DeepSeek-V4.1-Flash-1017 在多数智能体基准上并不突出。说明「造模型」这条能力和「干活」那条能力,在国产开源内部也不是同一批模型领先。
戴上眼镜和摘下眼镜
这一节是整份报告信息量最大的一处,也是最容易被一句话带过的地方。
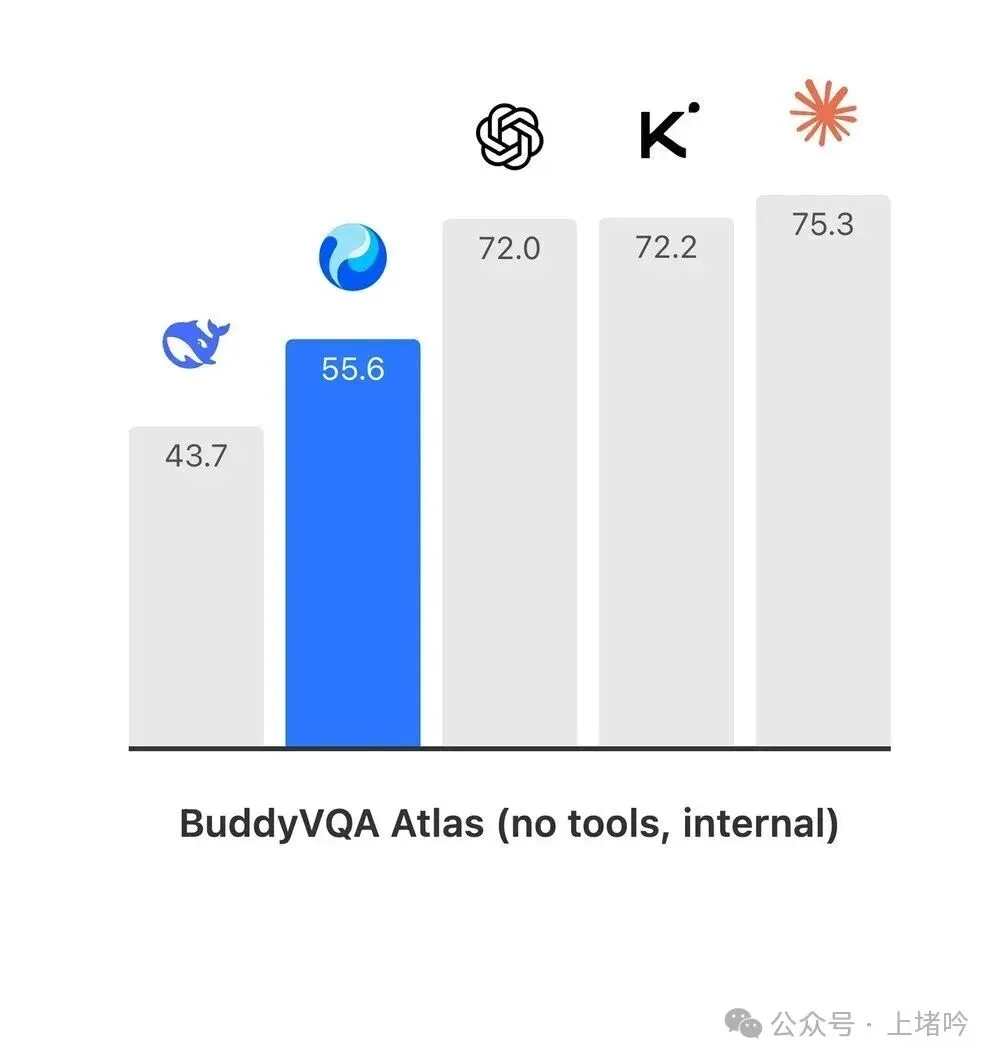
图注|报告点名的第四处差距,禁用工具的 BuddyVQA Atlas。混元4 55.6 分,GPT 72.0 分,Kimi 72.2 分,Claude 75.3 分。(来源|腾讯混元 Introducing Hy4 原报告配图)
注脚把这套卷子写得很具体,它考从图片里回答问题,覆盖识别、计数、比较、OCR、空间方位和定位,并且专门挑「整图直答容易失败」的题,比如小字、细线、局部小目标、需要定位的地方。
带工具时发生了什么。模型不只是看一眼图,它可以先把图裁一块出来、放大、再跑一遍 OCR,或者转个角度、换个区域重新看。开头讲的冰箱照片就是这个流程,按区域放大、逐层盘点。这时候答对一道小字题,靠的是「知道该去哪一块放大」这个决策,加上工具把像素喂清楚。混元4 拿 81.0,和 Claude 81.3、Kimi 80.2、GPT 79.1 在同一档。
把工具收走之后。模型只能把整张图一次性压成向量序列,直接回答。小字在切成图块和压缩的过程中最先丢信息,细线更容易糊掉,局部小目标在整个画面里占比太小。这时候拼的是视觉编码器把细节保下来的能力,也就是原生感知。
于是落差出来了。混元4 从 81.0 掉到 55.6,掉了 25.4 分。GPT 从 79.1 掉到 72.0,Claude 从 81.3 掉到 75.3,各掉 7 分上下。Kimi 从 80.2 掉到 72.2,掉 8 分。DeepSeek 从 76.2 掉到 43.7,掉 32.5 分,比混元4 还陡。
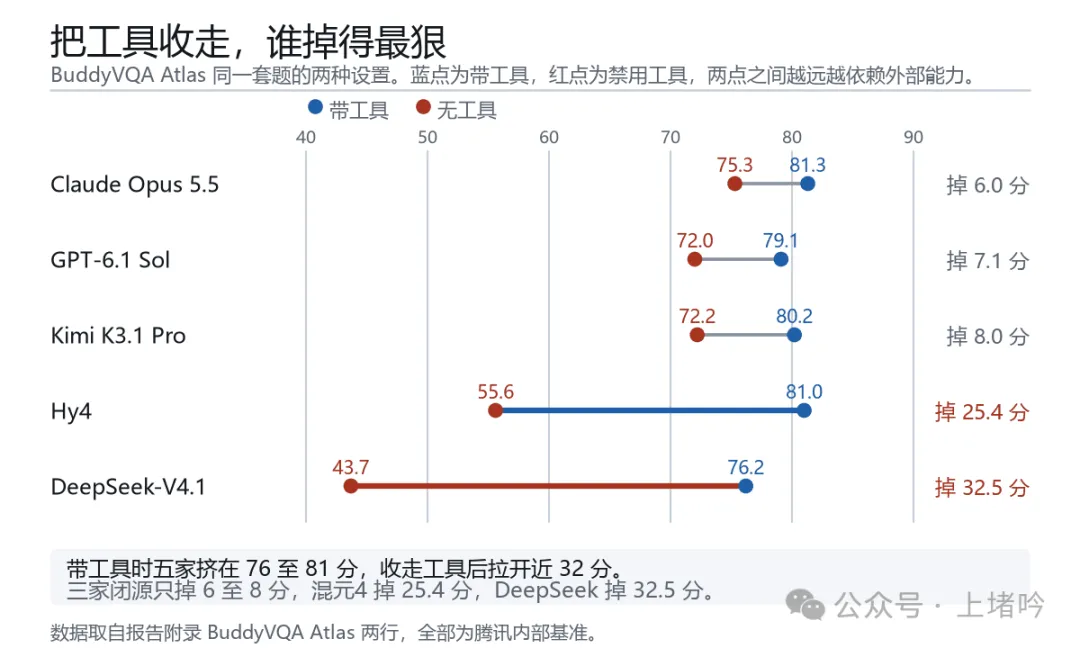
图注|同一套题两种设置的哑铃图,蓝点为带工具、红点为禁用工具。三家闭源只掉 6 至 8 分,混元4 掉 25.4 分,DeepSeek 掉 32.5 分。(来源|本文据报告附录两行数据绘制)
这个落差说明什么。混元4 在带工具的视觉问答上能追平闭源,很大一部分是工具补出来的。工具把「看不清」这个前置难题绕过去了,模型只要会决定裁哪一块就够了。一旦不允许绕,原始感知的差距就露出来。这也是为什么 MMMU-Pro 上混元4 78.6、GPT 84.9、Claude 88.2 只差 6 到 10 分,MMMU-Pro 的题目更偏学科知识与图文理解,对细粒度像素的依赖没有 BuddyVQA 那么极端。
换成一句朴素的话,戴眼镜时大家考得差不多,摘了眼镜,谁裸眼好使就分出来了。工具能补差距,但补的是结果,不是眼睛(这句是机制解释,属推断)。
报告正文把「首次引入视觉理解」当作这一代的主要升级之一,还在元宝的证言里给了多模态智能体任务完成率提升 36.8%、多模态问答提升 15.8% 的数字,那是和腾讯自家上一代视觉模型比。跟闭源前沿比,附录给出的是另一种图景。
一条能把前面几节串起来的规律
把四组对照并排放,规律就自己出来了。
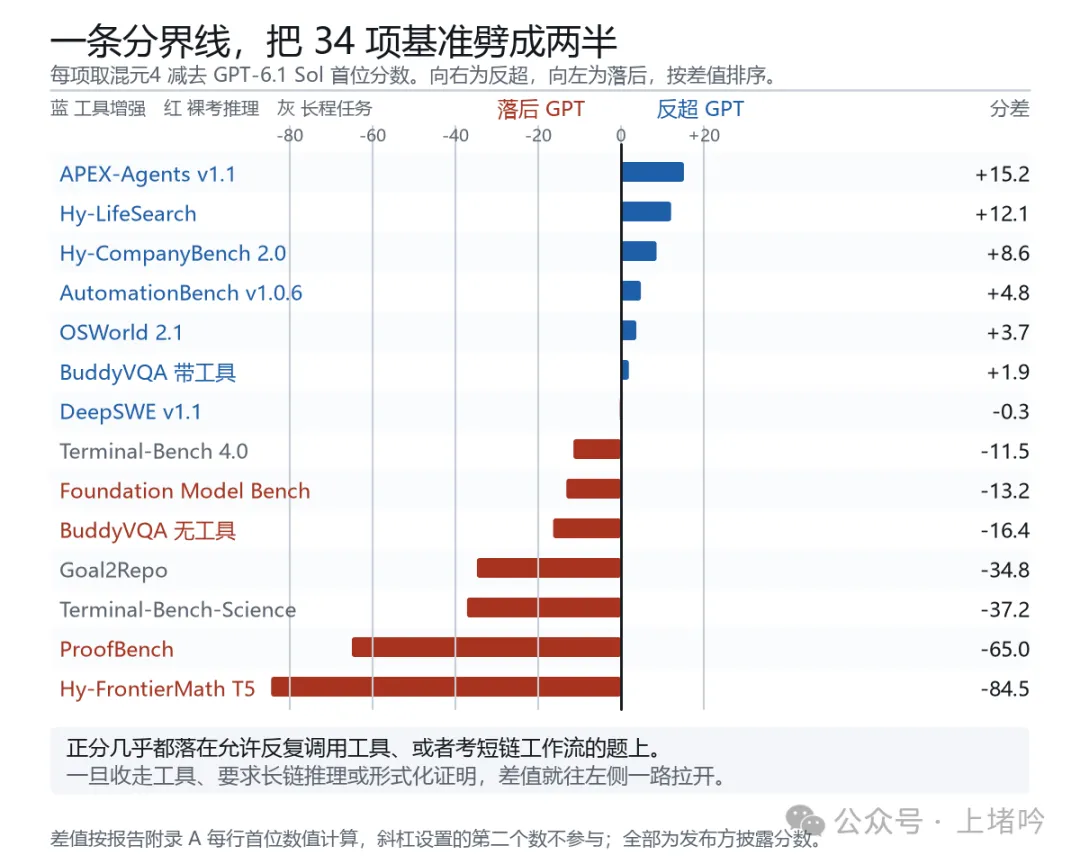
图注|把 14 项基准按混元4 减去 GPT 的分差排序。向右的多是允许反复调用工具或考短链工作流的题,向左的集中在裸考推理、形式化证明与长程科研。(来源|本文据报告附录 A 首位数值计算绘制)
事实层,凡是允许工具、允许多步调用外部能力的题,混元4 基本贴住闭源,个别反超。凡是把工具收走、要求凭自己想到底,或者要求几十步不迷路的题,差距成倍放大。报告自己在「展望」一节也是这么写的,它点名的四个落后维度是研究级数学、长程编码、模型自我改进、高级视觉问答,和上面这张表的下面四行几乎一一对应。
推断层,这条规律指向一个能力结构上的判断。混元4 这一代长出来的是「工具增强型」能力,感知不足可以由裁剪和 OCR 补,知识不足可以由检索补,执行不足可以由脚手架多跑几轮补。闭源前沿在工具增强之外,还叠了一层更厚的原生能力,包括不靠工具的长链推理、原生视觉细节保持、以及长程自我纠错。两层叠在一起和只有一层,在允许工具的题上看不出分别,一收工具就分家。
再往下拆,就可能是三个具体的真瓶颈所在(均为个人推断,报告没给训练细节)。
其一,可验证推理这条后训练路线。数学和代码有自动判分,适合大规模强化学习和长思考预算,谁把算力押在这里,谁的裸考分数就高。混元4 的后训练重心看得出在工具与场景侧。
其二,测试时算力。允许模型在回答前内部想很长一串,对证明题和构造题的收益特别大,对「打开终端改个文件」这类题收益很小。这正好解释了同一批模型在两类卷子上的分裂。
其三,长程状态。上下文窗口是「一次能装多少」,长程状态是「几十步之后还记得目标、记得改过什么、没把修好的东西改回去」。前者靠架构,后者靠训练和脚手架,不能互相替代。
但我也必须承认这些都是未解之处。三条都是从分数形态反推的,报告没有披露训练配比、后训练算力分配、思考预算或上下文长度。也可能存在我猜不到的原因,比如内部基准的难度设计就偏向闭源模型的训练分布,或者某些分数受到了脚手架差异的显著影响。后面讲这份卷子能不能算数时,会展开后一种可能。
这份卷子能不能算数
上一节的规律读起来很顺,但它的地基是附录分数,而附录的评测条件写在表格下方那几十行小字里。那些小字才是这份报告最该读的部分。下面我来逐条讲清楚。
一、考生换了考场,分数不能直接比
这是最重的一条。注脚在约十套考卷上重复同一句结构,GPT 系列模型用 Codex 某个版本评估,其他模型用 Claude Code 某个版本评估。涉及的卷子包括 Hy-CompanyBench 2.0、Hy-SWE Max Verified 2.0、Hy-Backend 3.0、WebCraftBench、GameFix Bench 2.0、3DArena-Modeling、Goal2Repo、AutoCatBench、PPTGen-Bench、TenureTrail。
回到开头那句,考生是模型,考场是脚手架。脚手架决定能开什么工具、能走多少步、超时多久、结果怎么收集。Terminal-Bench 4.0 的注脚把这套规则写得非常具体,用 Claude Code 脚手架,最多 500 轮,每次试验给 13 小时超时,资源封顶 16 个 CPU 和 32GB 内存,三个依赖 GPU 的任务另给一块 H100。把这段和「GPT 用 Codex」并排一读就明白,同一套题,两套考场规则,跑出来的分不是同一种量。
更麻烦的是版本自己也在漂。Claude Code 在表里从 2.1.117 一路变到 2.1.316,Codex 从 0.115.0 变到 0.166.0。也就是说,不同行之间的考场都不完全一致。
这不是说分数作废,是说跨模型比大小要打折,尤其是那些差三五分的格子。方向性的大差距,比如 13.0 对 97.5,不至于被脚手架翻过来,但「混元4 反超 GPT」这类结论,落在三五分的量级上,就不能当定论。
二、出题的、应考的、批卷的,经常是同一家
34 套卷子里约 19 套是腾讯自制,名字带 Hy 前缀,或者明确标着 internal,包括 WebCraftBench、GameFix、3DArena、Goal2Repo、AutoCatBench、E-Bench、Agents' First Exam-IF、Tag-bench、PPTGen、Hy-FrontierMath T5、ProofBench、Foundation Model Bench、TenureTrail、BuddyVQA Atlas。混元4 在这些卷子上多次拿开源第一。
自己出题自己考自己批,问题不在是不是作弊,而在于出题人天然知道什么样的题对自己胃口。题库的难度分布、任务形态、判分细则,都会不自觉往自家模型擅长的方向靠。这类名次当参考可以,当定论不行。
裁判身份另说。多套卷子用 LLM-as-judge,注脚写「内部搜索脚手架,由 LLM 裁判按逐题评分细则打分」「分数合并最终数据库状态检查与 LLM 裁判」。PPTGen-Bench 的注脚还写了一句,我们的智能体裁判也采用 Claude Code 2.1.117。按字面读,裁判智能体跑在和一部分被测模型相同的脚手架上。这句有两种解释,一是裁判用的只是脚手架,而非被测模型,二是裁判底层模型与被测模型之一同源。注脚没讲透,两种可能都留着(推断)。
三、报的是最好的那一次,不是平均
总注脚写,对每个模型在最高可用推理设置下评估并报告结果,并说明报告的是最高评分采样中的最佳值,星号表示我方自测,剑号表示 HLE 的纯文本子集。另一句更直接,某些 Hy4 preview 的分数可能与此前报道不同,因为评测脚手架、裁判模型和反作弊机制更新过。
把这两句翻成大白话。第一句,同一道题做若干次,挑成绩最好的那次报出来。第二句,作为对照组的上一代模型,分数会随工具链改动而变。
于是一个具体后果出现了。报告里大量「较 Preview 提升 X%」的说法,里面混了两样东西,模型真的进步,以及基准线被重新量过。SWE-Marathon 的注脚给了活例子,为了降方差,每题反复评估直到凑够八个有效分数。凑够八个有效分再取最好,和跑一次记一次,这个本质上是两套口径。
顺带说明,报最优不违规,各家发布报告常这么干。问题是同一张表里,有的用 avg@3,有的估 pass@5,有的报最优,读者直接横比大小就会误读。
四、有一格分数被评测环境压过
ProgramBench 的注脚写,Claude Opus 5.5 在我们的评测里有 41 个实例撞上内容过滤拦截。这属于评测环境的产物,不是模型做不出题。它会把 Claude 在这一行的分数往下压。看到 Claude 在某项突然偏低,先查数据表格的注脚,别急着下能力判断的结论。
五、样本小,又没有误差的可信性
Agents' First Exam-IF 是 101 道题,TenureTrail 123 项,GameFix 100 项,3DArena 120 项,AutomationBench 用的是 Zapier 公开的 600 道任务,ZeroBench 每题十次独立运行,Goal2Repo 取三次平均。全表没有任何置信区间、没有重复试验的标准差、没有显著性检验。
一百道题上差三分,可能就是把其中一两道题做对了。DeepSWE 那行 74.9 对 74.2 对 75.2,这种差距在统计上什么都不说明。报告却把「跻身第一梯队」这类判断建立在这一量级的分数上。
六、一半卷子是第一次考
带星号的卷子注脚定义为「发布时才首次评测」。首次评测意味着没有历史标定、没有往年跨模型对照、没有第三方复现过,工具链或判分细则的小毛病也还没被别人挑出来。表里约一半行带星号,包括用来论证最大差距的那几行。
七、闭源锚点只有两个,Gemini 不在表里
用户常问的 GPT、Claude、Gemini 三家,这份报告只比了 GPT-6.1 Sol 和 Claude Opus 5.5。Gemini 只在 PostTrainBench 的注脚里出现过一次,说 Gemini 模型用 OpenCode 评估,其余模型用 Claude Code 2.1.198,表里没有任何 Gemini 得分。此外,OpenAI 的推理专用版本、DeepSeek 的推理版本、Qwen、Llama、Mistral 都不在对比集合里。
所以「与国际主流模型的差距」,在这份报告里准确的写法是「与 GPT-6.1 Sol 和 Claude Opus 5.5 这两个特定版本的差距」。换一批锚点,结论的幅度很可能突变。
八、报告自己的数字有几处对不上
正文说 GameDev 提升 19.1%、GameLogic 提升 9.8%,附录里对应的那行叫 GameFix Bench 2.0,Hy4 preview 65.5、Hy4 68.4,只涨 4.4%。宣传数字在附录里找不到对应。
英文报告写幻觉率从 15.76% 降到 5.45%,中文发布稿写 12.95% 降到 7.2%。同一个指标,两个官方版本两套数。猜测错误率倒是两边一致,都是 23.1% 降到 5.6%。哪一套是准的,发布方没交代——难道特指是中文和英文推理的差异?
正文宣称长上下文理解大幅提升,附录没有一套专门测上下文长度的卷子。
九、它终究还是作为一份发布稿比较合适
主体是能力宣发加产品证言。「产品反馈」整节是 Manus、RabyteTech、WorkBuddy、元宝四家给的评语,其中 WorkBuddy 和元宝是腾讯自家产品,RabyteTech 是合作方。这些是商业伙伴的使用反馈,不是独立第三方评测。架构和训练细节又推给了还没发的系统卡片。
怎么读这张表,有个实用的办法
看到星号,可信度降一档。看到斜杠(比如 57.0/60.9),先问是哪两种设置,别只取大的那个。看到差三五分,当作打平。看到内部基准上的第一名,当作参考。看到差三十分以上、且方向和多套卷子一致,当作可信的方向。看到「反超」,回去查那一行的注脚,多半能找到脚手架、采样或者内容过滤的解释。
一份自利的发布稿,却还是量出了自己最疼的伤口
这一层比任何单个分数都有意思。
这份报告是腾讯自己出的题、自己跑的评测、自己写的稿,目的很明确,把 Hy4 送进「最强开源模型之一」这个位置。它完全有权只放对自己有利的那 19 套内部基准,把 FrontierMath、ProofBench、Goal2Repo、BuddyVQA 无工具版这几行从附录里拿掉,读者根本不会知道有这些卷子存在。
但它放了。而且放的是 13.0 对 97.5、5.5 对 70.5、23.2 对 74.0 这种难看到没法修饰的分数。更直接的是,「展望」一节主动写了,尽管 Hy4 已是当前最强开源权重模型之一,与顶尖闭源模型之间仍有明显差距,特别是在研究级数学、长程编码、模型自我改进、高级视觉问答这几类有挑战性的内部基准上。
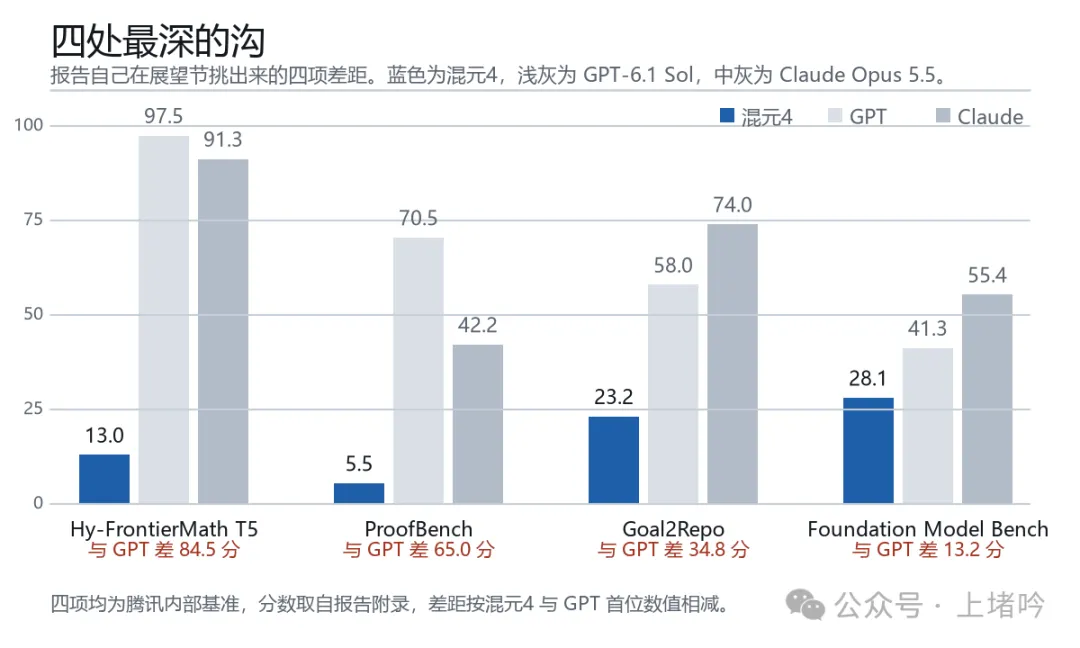
图注|报告附录里差距最扎眼的四项内部基准,混元4 与 GPT 的分差从 84.5 分到 13.2 分。四项全部由腾讯自制。(来源|本文据报告附录数据绘制)
我对这件事有两个判断,都属于我个人的推断,如有失误也非常欢迎混元后面的报告打脸。
第一个判断,这份「承认」的可信度应该比一般发布稿高。因为它承认的四个维度恰好是附录里差距最大的四行,文字和数字对得上,不是含糊地说「仍有提升空间」。一个愿意把自家最难看的分数印出来的团队,至少在这件事上没有遮掩的心思。
第二个判断,它也框定了讨论的范围。差距被精确地圈在四个维度、而且全部落在腾讯自制的内部基准上。读者的注意力于是停在「这四项还要追」,不太会去问另外一些问题,比如这 34 套卷子的选择是不是偏向了智能体和工具类,为什么没有纯语言推理的独立横评,为什么没有长上下文的专项卷,为什么闭源只放两家。用自己出的题划定自己落后的边界,是一种很讲究的叙事。
两种读法可能是同时成立。我倾向于认为,报告在数字上是诚实的,但同时在题目的选择上是讲究的。这也是我们读所有大模型厂商发布报告的通用姿势,先假定相信它给了什么,再想它可能没给什么。
给不读英文的读者,把整件事捋一遍
如果前面几节太技术,这一节用报告里的两件具体的活把整份报告讲完。
第一件活,整理三天的菜单。你拍一张冰箱照片,说清楚预算和禁忌。模型放大照片、认食材、把没认准的标出来、排菜单、算钱,中途你又加两位客人,它重新算一遍。这件事它做得不错,因为每一步都有外部帮手,看不清可以放大,算不清可以列表,忘了可以回头翻自己写过的内容。
第二件活,证明一道没人做过的数学题。没有图可放大,没有资料可查,没有工具可点,也不能问别人。你得自己想一个入口,往下走几十步,每一步都不能错,最后交出一个别人能逐步核对的证明。
腾讯这份报告说的其实是同一台机器在这两件活上的两种成绩。第一件,混元4 已经和世界上最贵的两个模型差不多,有的地方还赢一点。第二件,它拿 13 分,人家拿 97.5 分。中间还夹着一类,题目不难但要做很久,比如给一份规格说明书,自己写代码、跑测试、看反馈、反复改,直到全过,这类它拿 23.2 分,人家拿 74 分。
为什么会这样?打个不完全贴切但好懂的比方。这台机器被练成一个特别会使工具的人,给他电脑、给他搜索、给他能反复试的机会,他能干得很漂亮。可一旦把工具全收走,让他坐在空屋子里凭脑子想一件很难的事,或者让他一口气干几十步不许走神,他就吃力了。人家的模型两样都练过,既会使工具,也能裸着想。
再说几个具体数字,记住这五个就够。
研究级数学 Hy-FrontierMath T5,混元4 十三分,GPT 九十七点五,Claude 九十一。
写形式化证明 ProofBench,混元4 五点五,GPT 七十点五。
长程代码 Goal2Repo,混元4 二十三点二,Claude 七十四。
让 AI 自己训模型 Foundation Model Bench,混元4 二十八点一,Claude 五十五点四。
看图不许用工具 BuddyVQA Atlas,混元4 从八十一分掉到五十五点六,而 GPT 和 Claude 只从七十九、八十一掉到七十二、七十五。
最后这个落差最说明问题,能用工具时大家一样,工具一收走,差距立刻现形。
所以,我在最后提醒一句别把分数太当真。这些考卷有一半是腾讯自己出的,批卷的有时也是自家模型;更关键的是,有十套卷子上,GPT 是在 OpenAI 自家的 Codex 环境里考,混元4 和其他模型都在 Anthropic 的 Claude Code 环境里考,考场规则不一样,分数就不是一把尺子量出来的。而且报告里没有 Gemini,所谓「和国际比」,其实只比了 GPT 和 Claude 两家。所以结论的方向可以信,国产开源在高难度数学、长程编码、AI 造 AI、裸眼看图这四块确实落后;但具体差多少分,可能还得打折看。
附录 A 34 项基准全量表(中文对照)
数据取自报告附录。列依次为 Hy4 preview / Hy4 / GLM-5.3 / DeepSeek-V4.1-Flash-1017 / Kimi K3.1 Pro / GPT-6.1 Sol / Claude Opus 5.5。斜杠表示两种采样设置,多为带或不带代码检索、或两种脚手架;星号表示首次评测或发布方自测;剑号表示 HLE 纯文本子集。
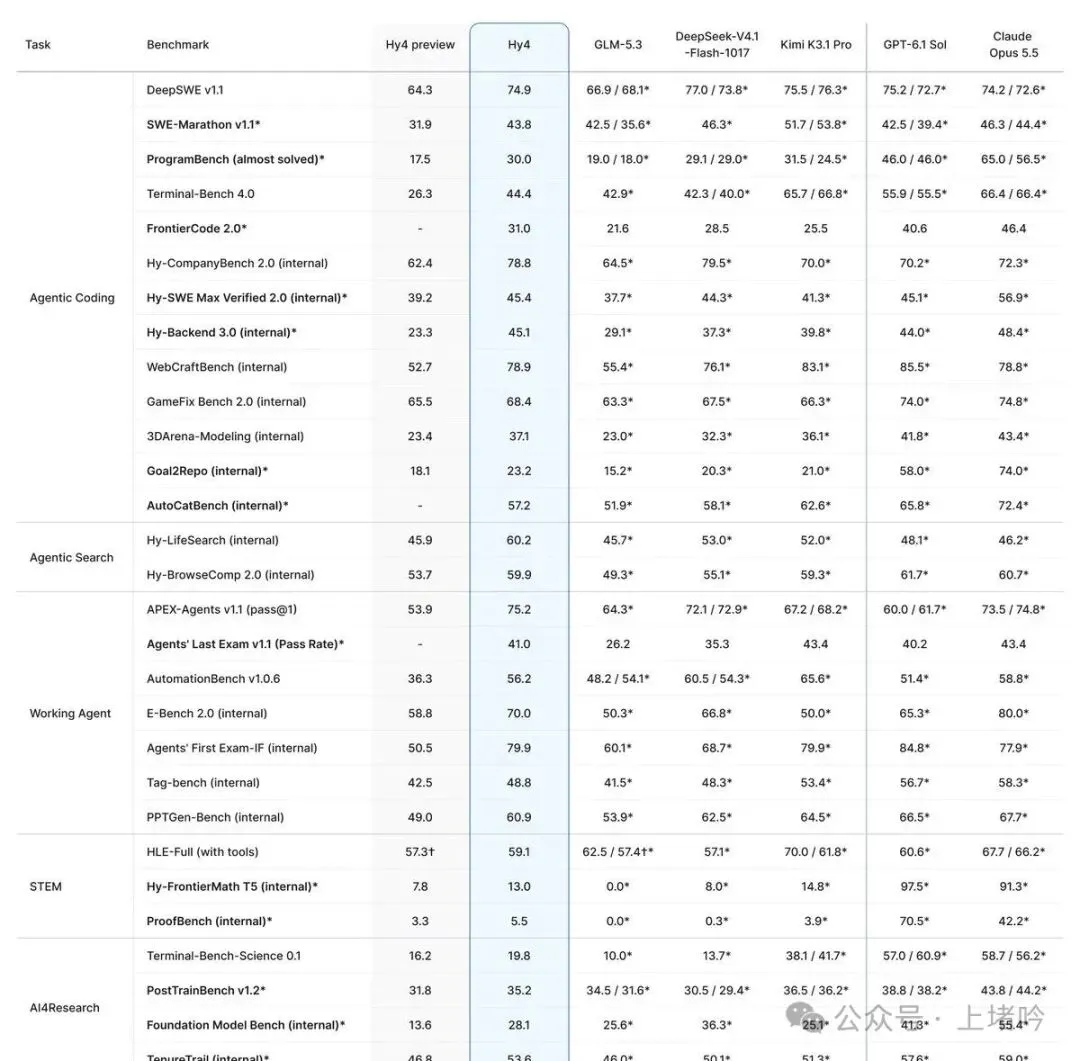
图注|原报告附录完整基准表上半,自智能体编码到 AI4Research 各类,可与上方中译表逐行对照。(来源|腾讯混元 Introducing Hy4 原报告配图)
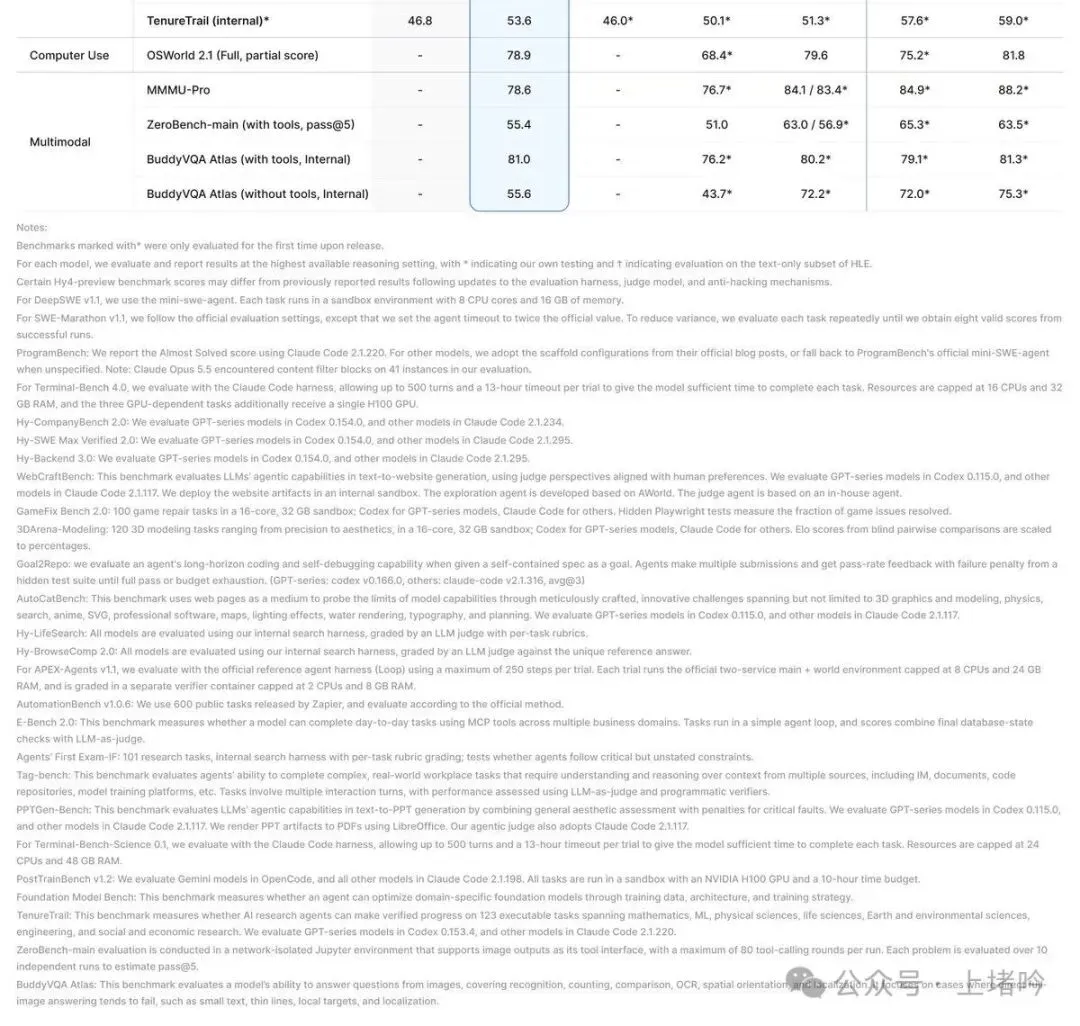
图注|同一张表的下半,自电脑操作到多模态,表格下方是方法注脚全文,附录 B 逐条中译。(来源|腾讯混元 Introducing Hy4 原报告配图)
附录 B 报告方法注脚逐条中译
原文为英文,以下我按照按原顺序译出,保留全部条件与数字。这部分是我给中文读者判断评测是否公允的一手依据。
带星号的基准,是在本次发布时才首次评测。 对每个模型,我们在其最高可用推理设置下评估并报告结果;星号表示我方自测,剑号表示在 HLE 的纯文本子集上评估。 由于评测脚手架、裁判模型与反作弊机制的更新,某些 Hy4 preview 的分数可能与此前公布的结果不同。 DeepSWE v1.1,我们使用 mini-swe-agent;每个任务在 8 核 CPU、16GB 内存的沙箱里运行。 SWE-Marathon v1.1,沿用官方评测设置,但把智能体超时设为官方值的两倍;为降低方差,每题反复评估直到拿到八个来自成功运行的有效分数。 ProgramBench,我们用 Claude Code 2.1.220 报告「接近解决」分数;其他模型采用其官方博客给出的脚手架配置,未说明的则回退到 ProgramBench 官方的 mini-SWE-agent。注意,Claude Opus 5.5 在我们的评测中有 41 个实例撞上内容过滤拦截。 Terminal-Bench 4.0,用 Claude Code 脚手架评测,最多 500 轮,每次试验 13 小时超时,给模型足够时间完成每题;资源封顶 16 核 CPU 与 32GB 内存,三个依赖 GPU 的任务另给一块 H100。 Hy-CompanyBench 2.0,GPT 系列模型在 Codex 0.154.0 中评测,其他模型在 Claude Code 2.1.234 中评测。 Hy-SWE Max Verified 2.0,GPT 系列在 Codex 0.154.0,其他模型在 Claude Code 2.1.295。 Hy-Backend 3.0,GPT 系列在 Codex 0.154.0,其他模型在 Claude Code 2.1.295。 WebCraftBench,考的是大模型的文本生成网站能力,用贴合人类偏好的评审视角判分;GPT 系列在 Codex 0.115.0,其他模型在 Claude Code 2.1.117;网站产物部署在内部沙箱,探索智能体基于 AWorld 开发,评审智能体为自研。 GameFix Bench 2.0,100 个游戏修复任务,16 核 CPU、32GB 内存沙箱;GPT 系列用 Codex,其他模型用 Claude Code;隐藏的 Playwright 测试测量游戏问题被解决的比例。 3DArena-Modeling,120 个 3D 建模任务,从精度到美感,16 核 CPU、32GB 内存沙箱;GPT 系列用 Codex,其他模型用 Claude Code;盲评两两比较得出的 Elo 分换算成百分比。 Goal2Repo,给一份自包含规格作为目标,考智能体的长程编码与自我调试;智能体可多次提交,隐藏测试集给出带失败惩罚的通过率反馈,直到全部通过或预算耗尽;GPT 系列用 codex v0.166.0,其他模型用 claude-code v2.1.316,取三次平均。 AutoCatBench,用网页作载体,通过精心设计的创新挑战探模型能力边界,覆盖 3D 图形与建模、物理、场景、动漫、SVG、专业软件、地图、光照效果、水体渲染、字体排印与规划等;GPT 系列在 Codex 0.115.0,其他模型在 Claude Code 2.1.117。 Hy-LifeSearch,所有模型用我们的内部搜索脚手架评测,由 LLM 裁判按逐题评分细则打分。 Hy-BrowseComp 2.0,所有模型用我们的内部搜索脚手架评测,由 LLM 裁判对照唯一参考答案打分。 APEX-Agents v1.1,用官方参考智能体脚手架 Loop,每次试验最多 250 步;每次跑官方的「主服务加世界」双服务环境,封顶 8 核 CPU、24GB 内存,判分在另一个封顶 2 核 CPU、8GB 内存的独立验证容器里完成。 AutomationBench v1.0.6,用 Zapier 公开的 600 个任务,按官方方法评测。 E-Bench 2.0,考模型能否用 MCP 工具跨多个业务域完成日常任务;任务跑在简单智能体循环里,分数合并最终数据库状态检查与 LLM 裁判。 Agents' First Exam-IF,101 个研究任务,内部搜索脚手架加逐题评分细则打分;测智能体是否遵守关键但未明说的约束。 Tag-bench,考智能体完成复杂真实办公任务的能力,需要理解并推理来自即时通讯、文档、代码仓库、模型训练平台等多源的上下文;任务含多轮交互,用 LLM 裁判加程序化验证器评估。 PPTGen-Bench,考文本生成 PPT 的智能体能力,把整体美感评估与关键缺陷惩罚结合;GPT 系列在 Codex 0.115.0,其他模型在 Claude Code 2.1.117;PPT 产物用 LibreOffice 渲染成 PDF;我们的智能体裁判同样采用 Claude Code 2.1.117。 Terminal-Bench-Science 0.1,用 Claude Code 脚手架,最多 500 轮,每次试验 13 小时超时,资源封顶 24 核 CPU、48GB 内存。 PostTrainBench v1.2,Gemini 模型在 OpenCode 中评测,其他所有模型在 Claude Code 2.1.198 中评测;所有任务跑在配一块 NVIDIA H100、10 小时预算的沙箱里。 Foundation Model Bench,测智能体能否通过训练数据、架构与训练策略去优化领域专用基础模型。 TenureTrail,测 AI 研究智能体能否在 123 个可执行任务上取得可验证进展,覆盖数学、机器学习、物理科学、生命科学、地球与环境科学、工程、社会与经济研究;GPT 系列在 Codex 0.153.4,其他模型在 Claude Code 2.1.220。 ZeroBench-main,在支持图像输出作为工具接口的网络隔离 Jupyter 环境里进行,每次最多 80 轮工具调用;每题跑 10 次独立运行来估计 pass@5。 BuddyVQA Atlas,考模型从图片中回答问题的能力,覆盖识别、计数、比较、OCR、空间方位与定位;重点放在整图直答容易失败的情形,例如小字、细线、局部小目标与定位。
附录 C 报告披露的其他事实
金融众测,213 位专家(153 位来自外部头部机构、七成从业五年以上),579 个真实任务,Hy4 得 3.04 分列开源第一,DeepSeek-V4.1-Flash-1017 得 2.97,Kimi K3.1 Pro 与 GLM-5.3 各 2.68。讯兔科技 IRAB 内部评测 Hy4 得 61.63,较 Preview 高 12.03 分,用 101 个投研任务。 检索专项,英文报告写幻觉率 15.76% 降到 5.45%,猜测错误率 23.1% 降到 5.6%;中文发布稿写幻觉率 12.95% 降到 7.2%。两版不一致,发布方未说明。 游戏方向正文称 GameDev 提升 19.1%、GameLogic 提升 9.8%,附录 GameFix Bench 2.0 只从 65.5 升到 68.4。 WorkBuddy 办公评测,平均 83.18 分、任务通过率 96.15%,12 个场景中 9 个国内第一;Manus 的文档创建编辑任务完成率近 97%。 元宝内部评测 72.53 分(Preview 65.25),多轮记忆 +6.67、写作质量 +10.89;对比自家上一代视觉模型,多模态智能体任务完成率 +36.8%、多模态问答 +15.8%。 生物安全 Hy-BioExperimentBench 30.4/100,低于高危阈值;网络安全由玄武、科恩实验室审计,结论是加密逆向、对抗二进制混淆、漏洞利用等进攻性能力未见突出风险。 定价每百万 token 输入 6 元、输出 18 元、缓存命中 0.3 元,英文站写作 $0.834 / $2.501 / $0.042。 已上腾讯云与 OpenRouter,接入 CodeBuddy、WorkBuddy、元宝、ima;权重将开源,vLLM(Inferact)与 SGLang 社区提供生态支持;系统卡片随权重发布;Hy4 flash 即将推出。
参考链接
腾讯混元《Introducing Hy4》英文报告及附录基准表与方法注脚 https://hy.tencent.ai/research/hy4 腾讯混元中文站 Hy4 发布页 https://hy.tencent.com/research/hy4 腾讯公司新闻稿《腾讯混元发布 Hy4,跻身最强开源模型之列》 https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/ 腾讯技术工程公众号《腾讯混元发布 Hy4,首次成为最强开源模型之一》(2026 年 11 月 4 日,含基准柱状图与冰箱照片实测案例) 腾讯技术工程相关报道《腾讯混元 Hy4 发布,实测四大实用场景》(2026 年 11 月 4 日) 报告附录基准表、正文柱状图组、展望节差距图与各节示例配图,分数与方法注脚的原始出处,本文件已将全部 13 张配图以 base64 内嵌,无需外部图片目录 Humanity's Last Exam 官方站与题目设计说明 https://lastexam.ai/ Scale AI《Humanity's Last Exam》榜单与方法、私有保留集及高分边界说明 https://scale.com/leaderboard/humanitys_last_exam Epoch AI FrontierMath 官方说明(原创未公开题、四档难度、闭式可验证答案,2026 年 6 月发布修正版 v2) MMMU-Pro 论文 https://arxiv.org/abs/2409.02813 与数据集 https://huggingface.co/datasets/MMMU/MMMU_Pro OSWorld 官方页(369 任务、人类 72.36%、早期最佳 12.24%、Verified 修订说明) https://os-world.github.io/ Epoch AI 对 OSWorld 的结构性限制分析(终端命令替代、判分函数错误、跨版本不可比) OpenAI《Introducing SWE-bench Verified》(500 人工验证样本、FAIL_TO_PASS 与 PASS_TO_PASS、原版三类缺陷) https://openai.com/index/introducing-swe-bench-verified/ Terminal-Bench 与 Harbor 框架公开文档(容器化终端任务与隐藏状态检查) OpenAI BrowseComp 官方说明(1266 题、反向出题、canary 唯一标记) ZeroBench 官方页与 ICML 2026 版本说明(100 主问题、334 子问题、pass@1 与 pass@5 与 pass^5) Zapier AutomationBench 官方榜与评测说明 https://zapier.com/benchmarks AutomationBench 论文 https://arxiv.org/abs/2604.18934 (47 个模拟应用、657 道保留任务、确定性断言、无 LLM 裁判) Berkeley RDI《Agents' Last Exam》 https://rdi.berkeley.edu/blog/agents-last-exam Cognition FrontierCode 官方说明(可合并 PR 的六项评分维度) CALM《Justice or Prejudice? Quantifying Biases in LLM-as-a-Judge》 https://llm-judge-bias.github.io/ 及论文 https://arxiv.org/abs/2410.02736 LLM-as-a-Judge 综述 https://arxiv.org/abs/2411.15594 与安全综述 https://arxiv.org/abs/2603.29403 Codex 与 HumanEval 论文(pass@k 无偏估计、164 道手写题) https://arxiv.org/abs/2107.03374 《Stop Comparing LLM Agents Without Disclosing the Harness》及 Holistic Agent Leaderboard 的脚手架方差证据 https://lacuna.tiptreesystems.com/work/stop-comparing-llm-agents-without-disclosing-the-harness Epoch AI《Why benchmarking is hard》、LiveCodeBench 时间切分、GSM1k 同分布重造、canary GUID 与成员推断相关方法文献 Chatbot Arena 的 Bradley-Terry 换算与 style-controlled leaderboard 方法说明