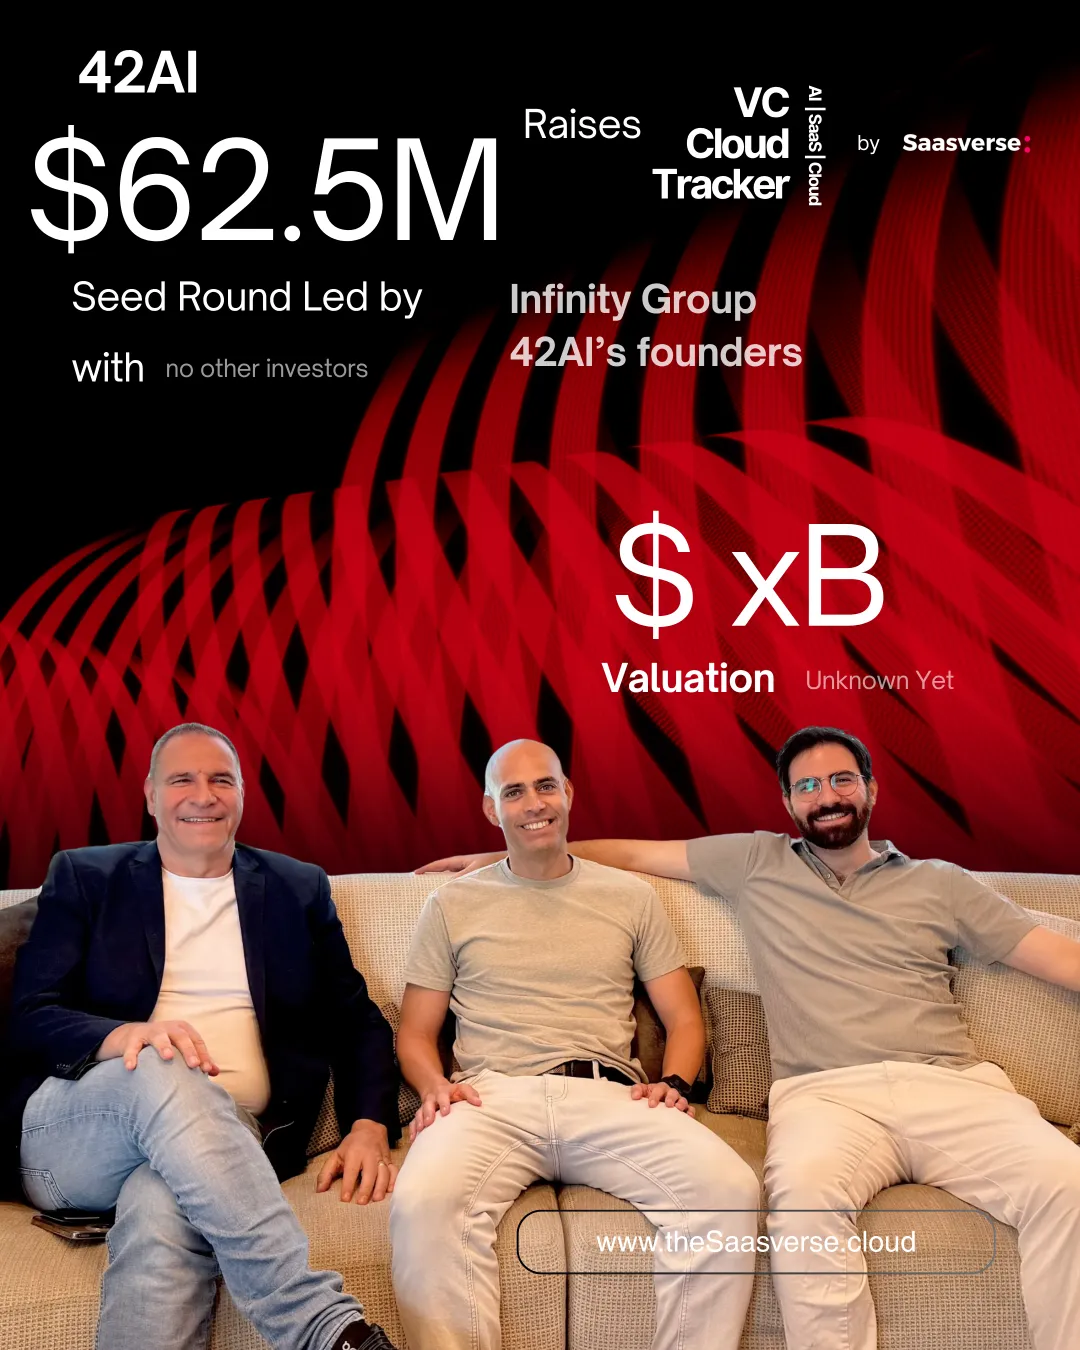
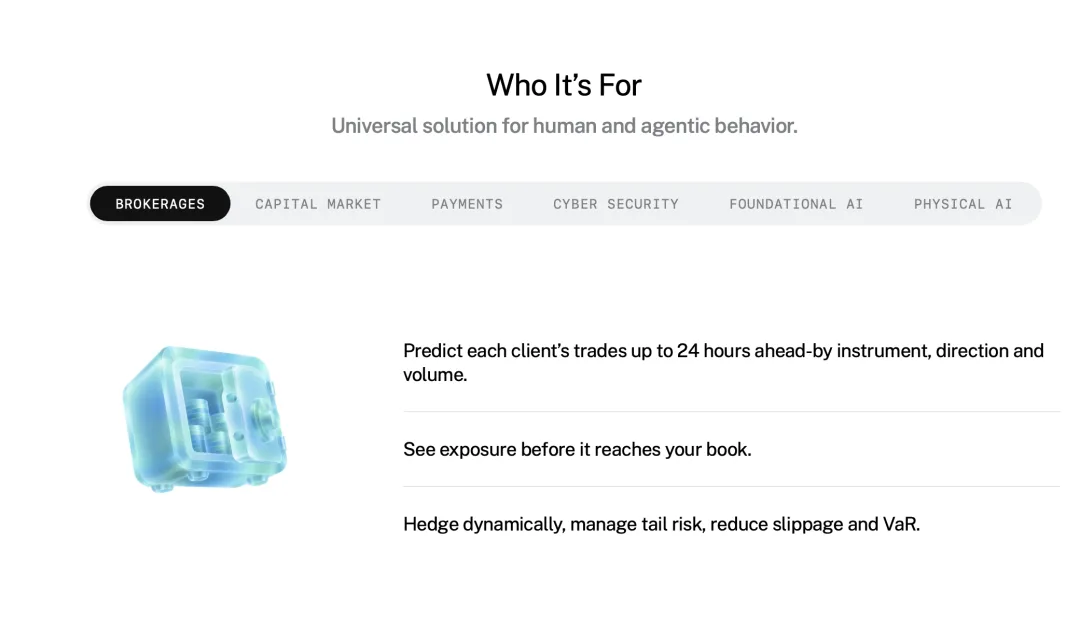
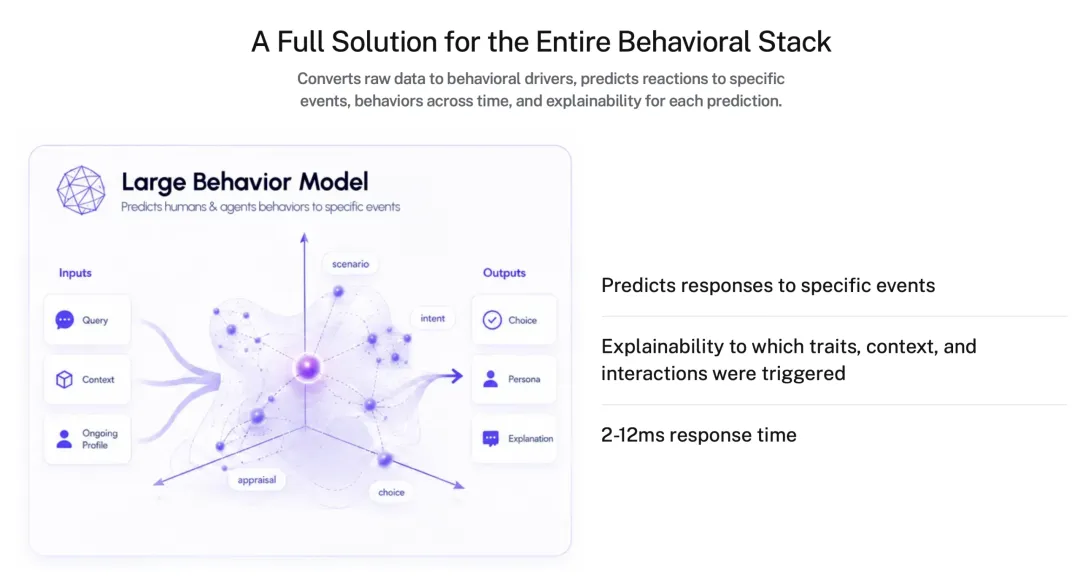
【行为世界模型 | 券商金融交易】42AI 天使轮定价为6250万美元,家族创始团队自有资金,同赛道有20亿美元估值的 Simile今日,行为世界模型公司 42AI 宣布累计获得6250万美元种子资金, 由创始人和英飞尼迪集团(Infinity Group)三年时间里陆续投入,没有外部机构投资者参与,估值没有披露,公司接下来计划再做一轮正式融资。42AI做的产品叫行为世界模型(Behavioral World Model, 可叫做Large Behavioral Model) 。输入一个人在业务系统里留下的行为记录,模型输出他在接下来一段时间里可能采取的行动和概率。第一个落地场景是金融交易:预测券商的客户在波动行情下会买什么、卖什么、量有多大,供券商提前安排流动性、保证金和对冲。目前有10家大型券商在用,更多客户在接入,收入已经超过百万美元。收费方式是固定费用,或者按平台帮客户创造的价值抽成。公司CEO是联创Amit Gal-Or,CTO是联创Ehud Ezra,董事长Amir Gal-Or是Amit的父亲,也是英飞尼迪集团(Infinitey Group, 中以跨境私募股权集团)的创始人。团队里有在Millennium、WorldQuant做过五年量化的成员,有专人在美国负责金融服务客户,建模分成行为世界模型和大行为模型两组。它也是目前这个品类里唯一一家先把产品装进客户生产系统、再出来讲故事的公司,其他几家都还在卖模拟和洞察。42AI卖的到底是什么42AI把自己的产品定义为行为风险智能。系统分两层:一层做跨时间的行为预测,响应在1到10毫秒;一层处理事件冲击下的行为变化并给出解释,响应在2到12毫秒。毫秒级的响应时间说明了部署形态,它是嵌在券商实时风控链路里运行的系统,输出直接进入对冲决策。喂给模型的数据,是一个人在开户和交易全程留下的痕迹:KYC和开户流程里的操作、和客服通话时的情绪、语调和拨打频次、转账记录、交易记录。这些观察先被转成一组特质的数学表示,再进入一个基于Transformer的世界模型,输出不同情境下各种决策的概率,另有一个语言模型负责把预测的理由写成人话。公司对人的建模拆成三部分:相对稳定的基础特质、所处的个人情境、正在发生的世界事件。这套方法有论文支撑。今年2月,42AI团队以OMGene AI Lab的名义发表工作,正式提出Large Behavioral Model(大行为模型,LBM)的提法:用约20个成熟心理量表聚合出74个特质维度,对Llama 3.1的8B模型做微调,再让模型在55个行为场景里做选择题。数据从哪来理解42AI,要先看OMGene。42AI的研究主体是OMGene AI Lab,论文里用的数据,通过OMGene的应用在2024年到2025年间收集。OMGene做的是消费级基因检测:用户做全基因组检测,同时完成心理量表和行为场景测试,行为数据、心理数据和基因数据在同一个人身上对齐。这条线还有一段医疗背景:OMGene与以色列国防军合作,给PTSD患者做"优势地图"研究,研究负责人Eyal Fruchter是以色列国防军心理健康部门的前负责人,后来负责42AI的行为研究,论文里用的PCL-5等临床量表就来自这条线。数据规模按公司披露的顺序是:先是数千人的心理测评和行为场景研究,再加入覆盖200多万人的政府与生物库数据集,接入客户数据后,覆盖接近3000万人。OMGene是英飞尼迪体系内的项目。早在2025年初,它还只是一个12人的研究项目,由集团先投入300万美元,以非营利研究机构的形态运行,Amir Gal-Or当时公开把这条路径类比成OpenAI的起步方式。Amit Gal-Or在家族的Infinity Medical里负责基因业务,OMGene正是在他手上孵化的,42AI是这条研究线找到的第一个商业出口:研究阶段积累的行为与基因数据,变成了券商风控产品的原料。Gal-Or家族和中国渊源很深。英飞尼迪是中以跨境投资的开山私募股权投资机构,2004年拿到中国第一张中外合作非法人制创投基金执照,在华先后设了23支基金和孵化器,代表性项目是把以色列ShellCase的封装技术带到苏州落地的晶方科技,2014年在上交所上市。Amir Gal-Or本人当过空军飞行员,在香港和北京生活工作过约十年,2017年获中国政府友谊奖。Amit Gal-Or在中国生活受教育12年,上海纽约大学经济学2018届,北京大学燕京学堂2018级学者,19岁时与父亲、兄长共同创办了跨境创新平台INNONATION。券商为什么肯付钱零售经纪商的账簿结构,决定了客户行为预测的价值。客户下单之后,经纪商可以选择把订单抛向市场对冲,也可以留在自己的账上。按欧洲证券及市场管理局的统计,零售差价合约账户有74%到89%是亏损的,留在账上的客户流因此是利润来源。但这本账有尾部风险:行情剧烈波动时,客户的行为会突然变得一致,账簿可能在一天里亏掉平时几个月的利润。这门生意的核心决策只有一个,留多少客户流在账上、什么时点开始对冲。这个决策的价值可以从上市公司财报里量出来。CMC Markets年报披露过客户收入留存率,2021财年是104%,2022财年降到80%,24个百分点的摆动,对应数千万英镑的收入差异,CMC自己就用自动化系统调整内部化与对冲的比例。Plus500的账更直观:一个活跃客户单季贡献约1700美元收入,新客户的获取成本约1150美元,它的"客户交易表现"科目单季上下浮动就是千万美元量级。42AI卖的正是这个决策的前置信息:提前24小时给出每个客户可能交易的品种、方向和量,让经纪商在波动到来之前调好账簿。公司称,一家券商用它的动态对冲多赚了约3000万美元。这个数字没有第三方验证,但量级可以测算:以CMC 3.35亿英镑的客户总收入为基数,对冲决策挽回5到10个百分点,就是1500万美元到5000万美元,3000万美元落在这个区间里。它按价值抽成的定价方式能成立,前提也在这里,省下的钱在客户的损益表上看得见。一个品类正在成型42AI之外,这个品类已经有了一批公司。过去两年,"训练一个模型来预测人会怎么做"从论文走成了品类,业内现在叫它大行为模型。几家头部公司选了不同的数据路线,差异比模型本身大。Simile走深访路线。创始团队出自斯坦福的生成式智能体研究,CEO Joon Sung Park是2023年那篇小镇模拟论文的一作,联创包括Percy Liang和Michael Bernstein。它的做法是先对1000个人做每人两小时的深度访谈,建成个人档案,再与Gallup合作,把样本池扩到4000多万人。企业客户拿它模拟消费者对新品、定价和传播的反应,客户包括CVS Health、德勤、Wealthfront,年费从15万美元到数百万美元不等。资本给它的定价最高:2026年2月完成1亿美元A轮,7月再融2亿美元B轮,估值20亿美元,累计融资超过3亿美元。Aaru走群体模拟路线。2024年成立,生成成千上万个带人口属性和行为属性的智能体,预测一个群体对产品、价格或事件的反应,客户有埃森哲、安永。它累计融资约8800万美元,2025年12月A轮时对外讲的是10亿美元估值,实际成交是分层定价的混合结果,它的ARR还不到1000万美元。42AI走的是第三条路,用真实业务系统里的行为记录训练,不靠问卷也不靠访谈。问卷测的是人说自己会怎么做,交易记录是人实际做了什么,而且金融场景的结果可以逐笔对账,这也是它能比同行更早进入生产环境的原因。还有几家大方向类似的公司也值得关注。Humans&在今年1月以4.8亿美元种子轮、约44.8亿美元估值亮相,9月发布了用户模型Persimmon,只是那目前是给它自家协作产品做训练和评估的内部工具,还没有作为商品出售,不能算作这个品类的买方验证。Mirror Particle主张从零训练行为模型而不靠大语言模型微调,还在早期。Cairo Labs做组织内部的个体反应预测,买方是企业的人力与管理层,规模也还小。科学验证还跟不上资本这个品类现在最需要冷静看的,是验证问题。被引用最多的斯坦福千人实验,结论是访谈建档的智能体复现问卷答案的水平,达到真人两周后重答一致性的85%。这个实验测的是复现已经测过的回答。预见还没发生的行为是另一回事,两者之间隔着这个品类全部的商业风险。同行评议的批评更具体。Bisbee等人2024年发表在《Political Analysis》的研究发现,大语言模型生成的合成样本,均值看起来像真人,但离散程度只有真人的约31%,情感极化被明显放大,回归系数有近半数和真人样本显著不同,约三成变了符号。方差被压缩,意味着模拟人群比真实人群整齐得多,拿它做决策,结论会显得比实际更确定。42AI自家的论文同样克制。在大五人格条件下,它的模型准确率是0.48,Claude 4.5 Sonnet是0.463,两者在统计上分不出高下。特质维度从5个加到20个,准确率升到0.62,再加到74个,几乎不再提升。论文证明的是微调能吃下比提示法更复杂的画像,没有证明行为可以被高精度预测。至于券商系统里的两个数字,98%指的是交易流落在预测区间内的比例。方向和量的预测另有分数,F1是0.8到0.85。论文的场景选择题成绩和生产系统的交易预测成绩,是两个任务,互相不能作证。所以这个品类现在的定价,买的主要是数据资产和先发位置,预测科学本身还没有跟上。这个判断对买方和投资方同样成立。今天谁在真正付费按公开证据的扎实程度排,今天为行为预测付费的场景是这样一个顺序。市场调研和消费者洞察排第一,具名客户、年费区间、续约故事都出在这里,Simile的收入主要来自这一块。医疗行为干预排第二,CVS用40万人的模拟样本给真实测试排优先级,是这个方向上最实的案例,只是公开的只有定性结论,没有依从性提升的量化数据,而且CVS的创投部门本身就是Simile的股东。金融交易行为排第三,目前只有42AI一家真正楔进了交易环节,但它的单点价值密度是几个场景里最高的。政策和政治模拟声量最大、付费最弱,Aaru的选举预测更接近品牌资产,还算不上一门稳定的生意。市场的总盘子可以借ESOMAR的数据锚定:全球洞察行业2025年规模约1660亿美元。传统巨头的应对方式值得创业者注意,Qualtrics、YouGov、NIQ不约而同把合成样本定位成真人样本的补充,YouGov收购AI调研公司Yabble之后仍保留真人复核环节。巨头手里有存量客户和真人样本池,独立公司只有在速度和成本上拉开足够大的差距,才有自己的位置。在中国可以做哪些落地这门生意搬到中国,先要换场景,再谈模型。有几个方向的预算和需求是现成的。品牌消费决策模拟是最接近收入的一个。中国消费品上新速度快,品牌在新品概念、价格带、包装和广告素材上的调研支出很大,传统调研一轮要两三周、几十万元起步。用付费样本池和深度访谈建起的合成消费者,把一轮测试压到天级,上市之前先跑一遍概念和定价,失败成本从真实铺货降成一次模拟。付费方是消费品集团、汽车、美妆和食品饮料品牌,以及为它们服务的咨询和调研机构。数据来源在这条路上走得通:样本池、访谈、品牌自己的一方数据,包括会员记录、电商评价和客服记录,不需要碰平台手里的个人数据。广告和内容预测试是第二个。短视频和直播的投放预算巨大,素材上线前用模拟受众测点击和转化的倾向,按项目或年费卖给品牌和代理公司。平台自己有更全的数据,独立公司的机会在品牌侧,品牌要在多个平台之间做同一套决策,需要一个站在自己这边的测试工具。游戏和互动产品排第三。中腰部游戏公司没有大厂那样的数据团队,玩家流失预测、付费倾向判断、版本改动前的行为模拟,都是现成需求。再往后,陪伴类和智能体产品要调用"理解人"的能力,会成为这类模型的下游买家。金融领域要换一个切口。预测客户交易再据此对冲,在中国没有合法的业务场景,但银行、保险和券商的客户经营里有同构的需求:投保人的续保和理赔倾向、信用卡客户的流失与激活、财富客户的风险偏好变化。做法是把行为预测做成客户经营系统,卖进金融机构的科技采购。边界要守住,做群体和画像层面的预测与经营辅助,不做针对个人的自动化决策,这是个人信息保护法的明确要求。医疗健康行为是第五个方向。用药依从、体检续约、慢病管理的参与度,都可以用行为模型提前识别和干预,付费方是药企、保险和健康管理公司,对应的正是CVS案例在中国市场的同类买家。在中国做这个赛道,顺序要和美国反过来。美国公司可以先融一大笔钱建基础模型,再找场景,中国的创业公司拿不到那么长的钱,行为数据也不在自己手里。可行的路径是先选一个能算清回报的场景收钱,在交付过程中积累行为数据和真实场景的验证记录,模型的故事随后再讲。Saasverse Insights这个品类已经走完了从论文到公司、再到第一笔生产环境收入的一段路,但Simile 20亿美元的估值和42AI七位数的收入,说的是两件不同的事:前者是资本对品类的定价,后者是买方对单点价值的定价,中间的距离要靠后续几年的收入来填。真正会沉淀下来的资产是行为数据和验证记录。基座模型会持续降价,独家场景里积累的行为数据不会,真实业务里逐笔对过账的预测记录更不会。42AI的样本意义也在这里,它最值钱的部分,是OMGene几年攒下的数据和券商账簿里跑出来的结果,模型本身排在这两者之后。接下来有三个观察点。一是42AI的第一轮外部机构融资,家族钱之后,市场愿意给它什么价格。二是Simile什么时候披露收入,它的定价能不能被收入接住,是整个品类的风向标。三是这个品类在中国出现第一家拿到机构融资的公司时,它选择从哪个场景切入,那个选择会比它的模型更能说明问题。End

 研报速递