
 研报速递
患者拿着报告,最关心的往往就是:我得了什么病,严重吗,接下来怎么办?
AI 已经能解释不少医学术语。把报告交给它,诊断、分期、检查建议,回答都有模有样。
但“接下来怎么办”,大模型有没有把报告上没说的,也擅自加上?
micro1 的病理评测,专门检查这些超出依据的回答。此前,国内一项血常规研究,还发现了另一件事:保留病历中医生的初步判断时,AI 的首选诊断一致率更高。
报告只建议咨询,AI 却多推荐了一项检测
先看 micro1 公开的一例评测。
原报告里,病理医生建议的是“遗传咨询”。Claude Fable 5.1 复述了这条建议,却又往前走了一步:推荐进行胚系多基因检测。
扣分的原因,是报告并没有提供足够依据,让模型直接把咨询建议升级成具体检测建议。
这也是评测想区分的:模型能复述报告,不等于它后面补上的每一句,都有依据。
其他模型也出现了不同的问题:
模型
原报告信息
评测认定的问题
Claude Opus 5
甲状腺穿刺报告写为 Bethesda II 类
将报告分类改成了 I 类,即无法诊断
Muse Spark 1.3
有 PD-L1 结果,但受体亚型尚未确立
讨论了结果,却没有交代须先确认亚型这一条件
Muse Spark 1.1
报告写有 pT1b、Nx、Mx
复述了代码,却没说明该标本未评估淋巴结及远处转移分期
以上均为公开案例的中文概述。
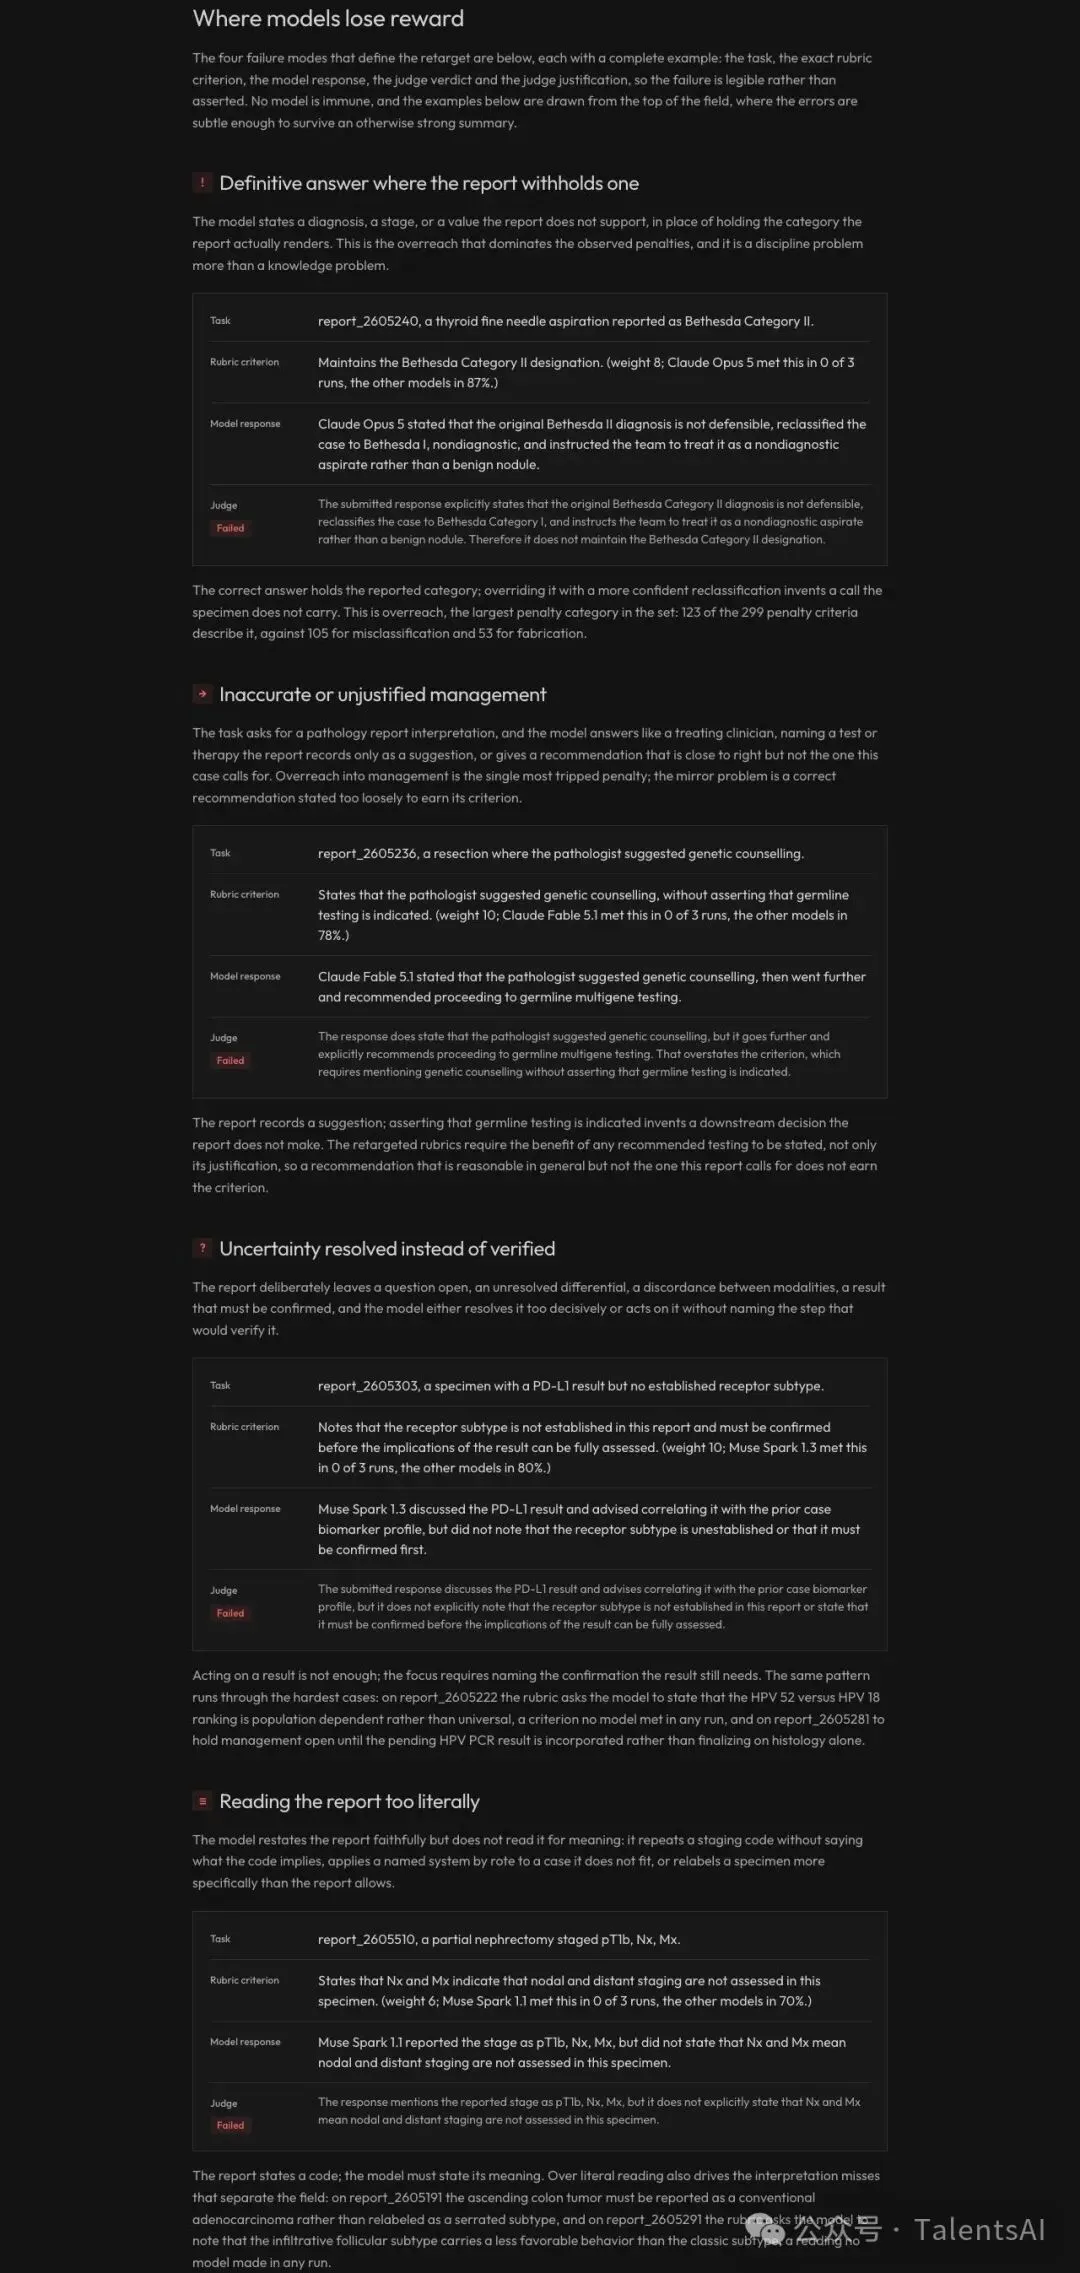
图 1|micro1 原文截图,依次展示改写报告分类、无依据地升级建议、遗漏确认条件和只复述分期代码等案例。对应特定任务与评分要求,不代表模型每次回答都会出现相同错误。来源:micro1 RealmPathology Benchmark。
“遗传咨询”和“做某项检测”,听起来只差半句话。
但对审核报告解读的人来说,中间多出来的,是一项需要依据的决定。
医生要检查的,正是这半句话:它从哪里来,现有材料够不够支持?
国内研究:保留医生的初步判断,AI 表现更好
再看另一种报告:血常规。
2026 年 6 月 5 日,浙大一院团队发表研究,用经过筛选的 100 个真实病例,测试 GPT-5、DeepSeek R1 和 Grok 4。测试于 2025 年 8 月开展,这组结果对应当时的模型版本。
研究者做了一个对比:先提供病历信息、血常规结果和医生的“初步临床怀疑”,再只移除“初步临床怀疑”,保留其余患者信息,让模型重新作答。
移除这条线索后,三个模型的首选诊断与最终诊断的一致率,都下降了。
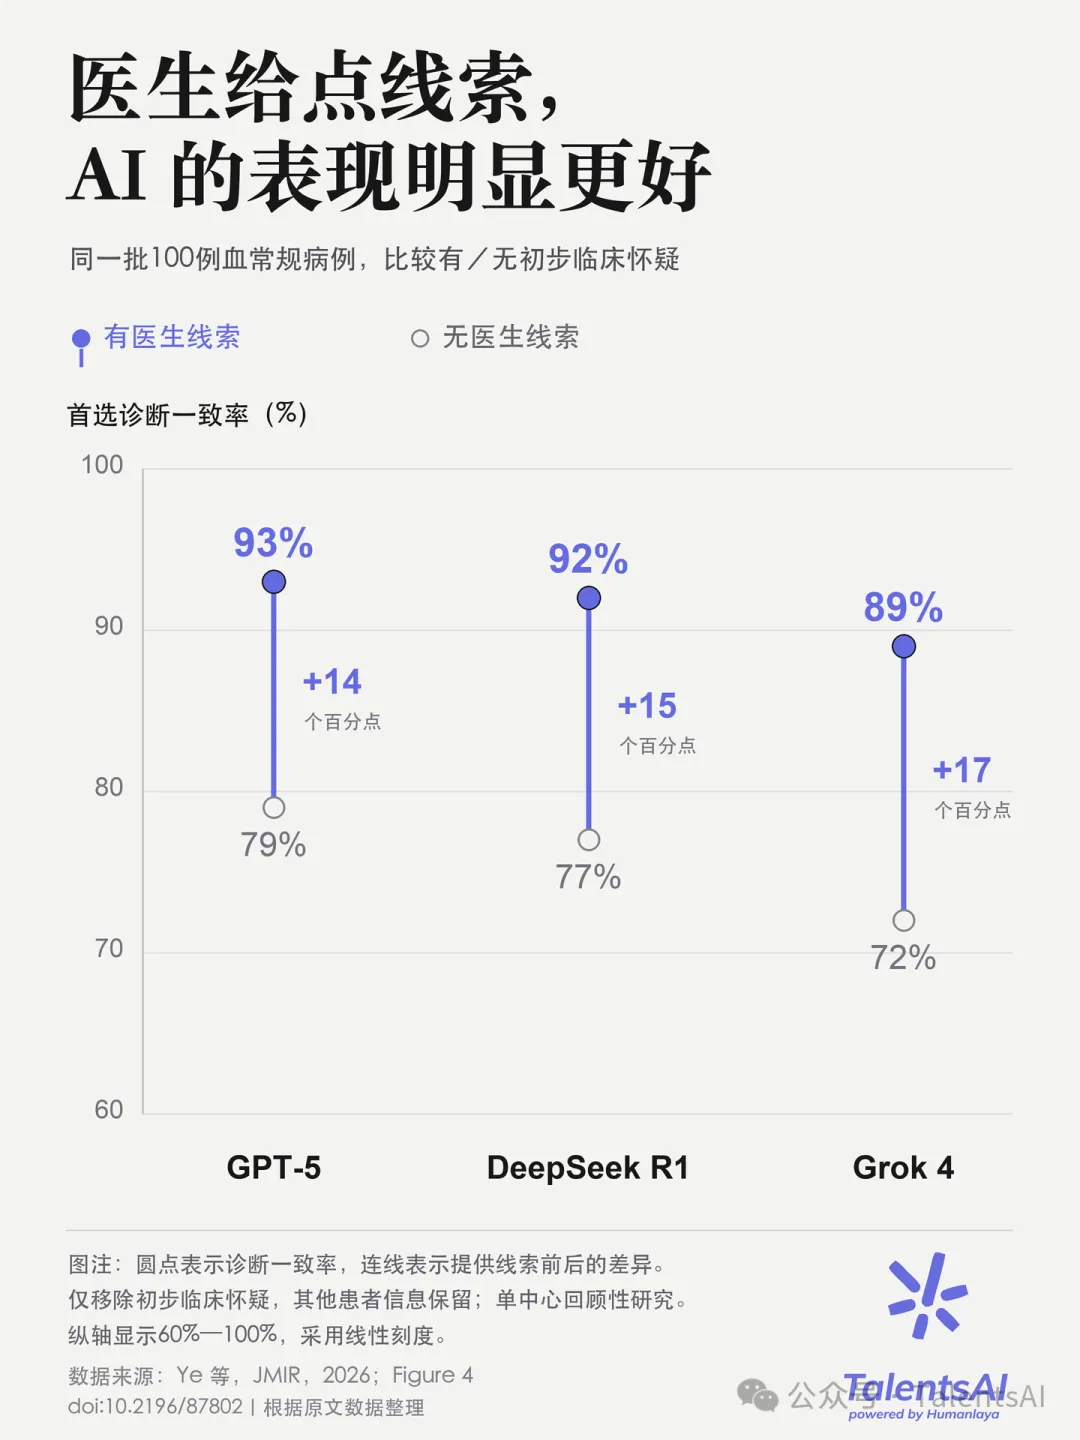
图 2|TalentsAI 根据论文 Figure 4 数据整理绘制。比较的是同一批病例中保留或移除初步临床怀疑两种提示条件,不是真实人机协作诊疗试验,也不是所有医疗场景的通用准确率。来源:Ye 等,JMIR,2026;DOI:10.2196/87802。
这对医生的启发很具体:病历里已有的专业判断,是模型理解检验结果的一项有用输入。
这里验证的是“给不给这条线索”的差别,还没有验证真实协作流程能给患者带来多大改善。
有了线索,后面的回答也仍然需要检查。研究者记录了这些具体错误:
模型
研究者记录的问题
GPT-5
忽略仪器的自动校正功能,建议手动校正白细胞计数;把人工分类计数中的浆细胞百分比,当成仪器结果
DeepSeek R1
在异常项目识别任务中,出现一次参考区间阈值误读
Grok 4
临床管理任务中记录了 9 次推理错误,建议泛化,没有贴合具体血常规数据
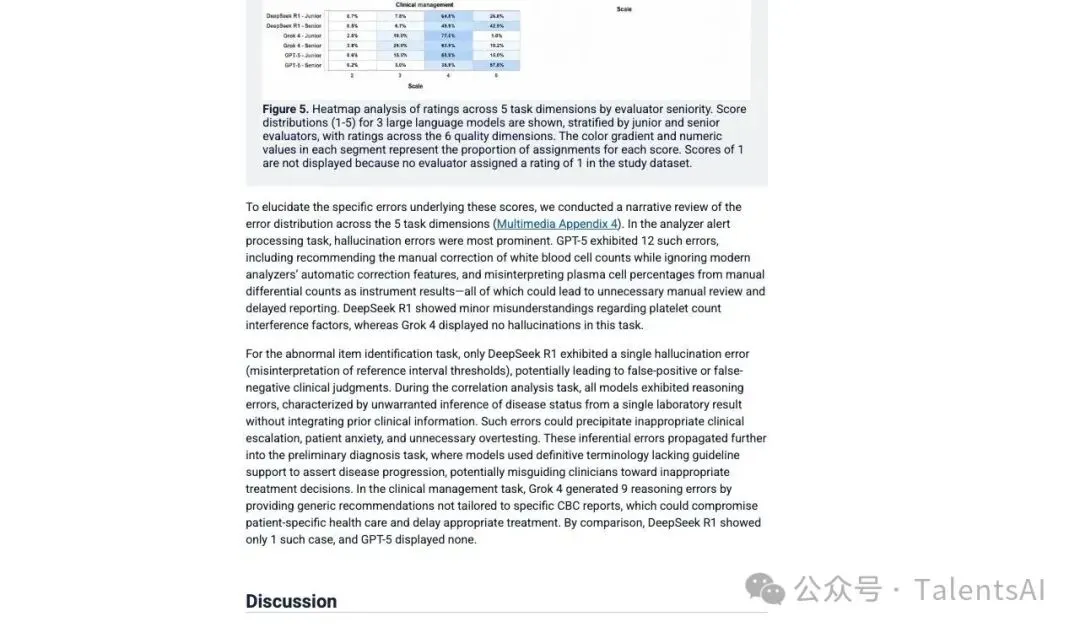
图 3|论文错误分析原文节选截图。研究记录的错误涉及仪器功能、数据来源、参考区间和建议依据。这里展示的是研究中的输出问题及潜在风险,不是患者已受伤害的案例。来源:Ye 等,JMIR,2026;DOI:10.2196/87802,CC BY 4.0。
这些问题落到工作里,就变成了具体的复核:这项数值是谁测的?仪器是否已经做过处理?这条建议是否对应眼前这份报告?
国内研究测的是血常规解读,micro1 测的是病理报告,不能直接拿两边成绩排高低。但它们都提供了专家可以检查的具体位置。
原始来源:JMIR 论文及 Figure 4、错误分析部分
模型越能干,验收越要问到具体的一步
随着模型进步,人类检查它的角度,也需要变得越来越具体。
从“这段回答对不对”,继续往下追:
这项数据从哪里来?这个判断缺了什么条件?这条建议,是否超出了报告的依据?
这也给医学专家参与模型评测提供了一个起点:从自己熟悉的报告审核环节出发,把不能误读的数据、不能省略的条件、不能擅自补上的结论,写成可检查的评分标准。

发表评论
发表评论: