
 研报速递
中信证券发了一份研报,标题很直白:看好国产大模型持续崛起。
但报告里真正值得注意的不是「看好」这两个字,而是它把 DeepSeek 的下一阶段战略讲清楚了:从模型供给走向平台生态。
券商怎么看 DeepSeek
报告的核心判断是:DeepSeek Harness 有望成为 DeepSeek 从模型供给走向平台生态的关键一环。
翻译一下:DeepSeek 不满足于只当「开源模型供应商」。它想做一个完整的 Agent 运行时平台,让开发者不仅用它的模型,还用它的一整套工具链。
这跟 OpenAI 的策略很像。OpenAI 不只有 GPT 模型,还有 ChatGPT、API、Dots(Agent 产品)、GPT Store。模型是入口,平台才是护城河。
DeepSeek 走的是同一条路,但用的是开源的方式。
DeepSeek Harness 是什么
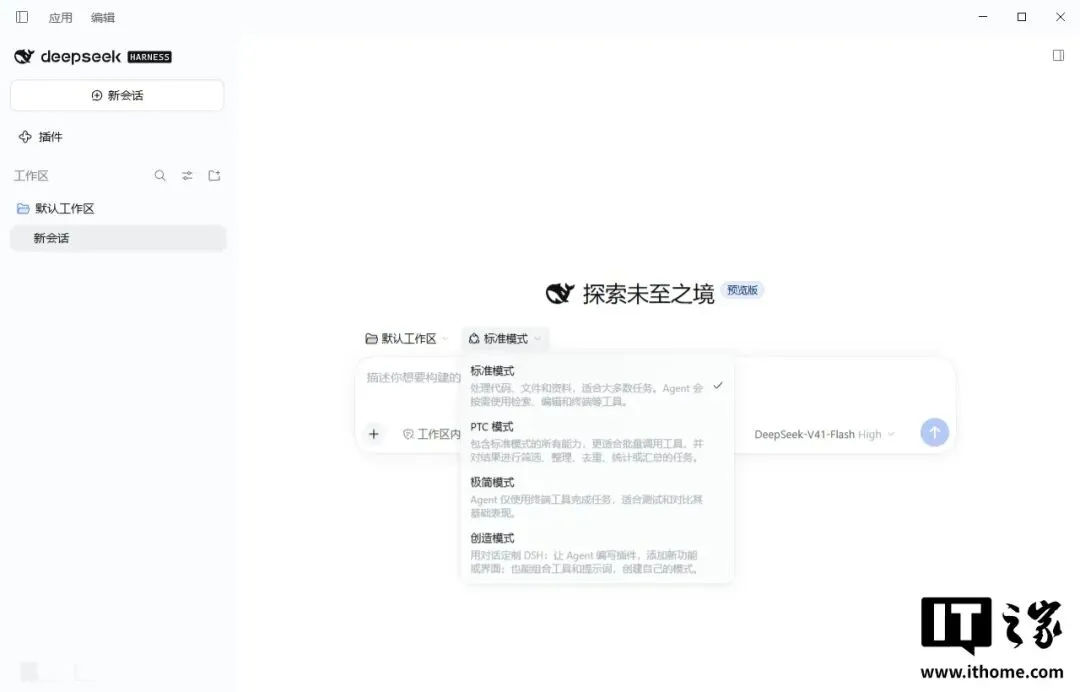
DeepSeek Harness(简称 dsh)是 DeepSeek 在 2026 年 8 月开源的智能体运行时框架,MIT 协议,TypeScript 编写。
它最大的特点是「一切皆插件」。模型、工具、技能、会话、沙箱、存储、智能体循环、调度、UI,所有 Agent 能力都通过底层插件系统 Cordis 以插件形式提供。
你可以把它理解成「Agent 世界的 Kubernetes」。Kubernetes 把容器调度做成了平台,你不需要关心底层服务器怎么管理。DeepSeek Harness 把 Agent 运行时做成了平台,你不需要关心模型怎么调用、工具怎么注册、会话怎么管理。
中信证券报告里提到三个关键能力:
插件化与场景预设:开发者可以快速搭建面向特定场景的 Agent,不用从零开始。
跨 Agent 协作:不同 Agent 之间可以互相调用、共享上下文,形成多 Agent 协作网络。
Infra 优势延伸:DeepSeek 在软硬件协同上的优势,从模型推理延伸到完整任务执行。
DeepSeek 的三步走
回看 DeepSeek 这两年的动作,能看出一条清晰的路线。
第一步:证明模型能力。V3、V4 系列发布,跑分追上闭源模型,价格砍到对手的十分之一。这一步的目的是让开发者愿意试。
第二步:开源生态。权重 MIT 协议开源,Hugging Face 直接下载。DeepSeek Harness 也是 MIT 开源。这一步的目的是让开发者能深度定制,不被锁定。
第三步:平台化。通过 Harness 把模型、工具、会话、调度打包成完整运行时,让开发者不仅用模型,还用整套基础设施。这一步的目的是建立护城河。
中信证券的报告就是在确认第三步已经开始。券商研报不会随便写「平台生态」这几个字,这背后是对商业化路径的判断。
国产大模型的下一步
报告认为国产模型能力持续提升,叠加成本效率与开源生态优势,有望推动 AI 应用向更广泛的知识工作与企业场景渗透。
这个判断跟最近一两个月的趋势吻合。DeepSeek V4.1 Flash 1017 的 DeepSWE 77 分超过 Claude Opus 5,MiniMax Code CLI 开源后任务通过率 76.7%,智谱的法律模型在法律评测中表现突出。
国产模型在「能力」上已经追上来了。接下来的竞争不在跑分,在生态。
谁能让开发者更容易用、更容易部署、更容易赚钱,谁就赢了。DeepSeek Harness 就是冲着这个目标去的。
跟国外平台的对比
目前做 Agent 运行时的主要玩家:
LangChain / LangGraph:最成熟的 Agent 框架,插件生态最丰富,但架构比较重,学习曲线陡。
CrewAI:多 Agent 协作框架,上手快,但功能相对简单,不适合复杂场景。
OpenAI Agents SDK:跟 OpenAI 生态绑定紧密,用 GPT 模型效果最好,但换模型就受限。
DeepSeek Harness:开源、插件化、模型无关。最大的差异化是「一切皆插件」的架构设计,理论上任何组件都可以替换。
DeepSeek Harness 的优势在于:开源协议宽松(MIT),架构灵活(插件化),成本可控(可以配 DeepSeek 的便宜模型,也可以配其他模型)。劣势是生态还太小,社区还在建设中。
对开发者意味着什么
如果你在做 Agent 相关的开发,DeepSeek Harness 值得关注。
好处:MIT 开源,没有厂商锁定。插件化架构意味着你可以替换任何一个组件——模型换成 Qwen,工具换成自己的 API,存储换成自己的数据库。整个框架还是能跑。
风险:生态还在早期。插件数量、社区活跃度、文档质量都跟 LangChain、CrewAI 这些成熟框架有差距。现在入局是早期用户,不是成熟用户。
建议:如果你的项目对成本敏感、需要深度定制、不想被云服务商锁定,可以试试 DeepSeek Harness。如果你的项目需要快速上线、需要大量现成集成,还是用成熟框架。
还有一个现实问题:DeepSeek Harness 的文档和教程目前主要是英文的,中文资料还很少。国内开发者如果想上手,可能需要等社区翻译或者自己踩坑。这也是生态建设的一部分——不只是代码开源了,文档、教程、最佳实践都需要时间沉淀。
从投资角度看,中信证券这份报告还有一个隐含判断:国产大模型板块在资本市场被低估了。报告发布的时间点(10月19日)恰逢 DeepSeek V4.1 Flash 1017 刚发布、跑分超过 Claude Opus 5 的热度期。券商选择在这个时候发声,有引导资金关注国产 AI 板块的意图。
不过对开发者来说,券商的观点不影响技术选型。你选 DeepSeek Harness 不是因为券商看好它,是因为它的架构设计适合你的场景。研报是给投资人看的,不是给程序员看的。但研报里提到的趋势值得程序员关注:当资本市场开始关注「平台生态」而不是「模型跑分」时,意味着行业评价标准在变,你选择技术栈的参考标准也应该跟着变。
最后说一句:国产大模型从「追跑分」到「建生态」,这个转变对整个行业都是好事。跑分竞赛只会让模型越来越贵,生态竞赛才能让工具越来越好用、越来越便宜。DeepSeek 选了后者,值得跟踪。其他国产模型厂商会不会跟进平台化策略,是接下来半年值得观察的方向。如果 Qwen、Kimi、MiniMax 也推出自己的 Agent 运行时平台,那国产大模型的竞争就从「谁的模型更强」变成「谁的平台更好用」。这对开发者来说是个好消息:选择多了,成本就降了,议价权就回到开发者手里了。这才是「国产崛起」真正的意义,不是跑分赢了,是开发者有了更多选择,也有了更多议价权和自主权。
你觉得国产大模型的下一个战场是生态吗?评论区聊聊。
中信证券这份报告还有一个信号值得注意:券商开始认真研究 AI 公司的「平台化战略」了。以前券商看 AI 公司看的是模型跑分和融资轮次,现在开始看生态、看商业化闭环、看用户黏性。这说明 AI 行业正在从「技术驱动」进入「商业驱动」阶段。
对普通开发者来说,这个阶段意味着一件事:选择技术栈的时候,不能只看模型能力强不强,还要看生态能不能支撑你的项目走到生产环境。跑分第一但生态为零的框架,跟跑分第三但插件丰富的框架,实际开发中后者往往更好用。
你在用国产大模型做开发吗?你觉得 DeepSeek Harness 能跟 LangChain 竞争吗?
觉得有用就点赞收藏,转发给还在观望的朋友。



发表评论
发表评论: