
 研报速递
1. 执行摘要
Llmspeed是一个面向本地LLM硬件采购的"购前体感模拟器"——用户选择硬件配置与模型组合,页面以预测的tok/s速度流式输出文本,让用户在花钱之前"感受"到本地大模型的运行速度[cite: 10][cite: 17]。分析这个项目的意义不在于它本身有多大的商业体量,而在于它精确踩中了本地AI硬件采购链条上一个被长期忽视的决策断点:在跑分表与实际体感之间,存在一道用户必须用真金白银去试错的鸿沟。这一方向获得资本关注,说明"AI硬件的购前决策基础设施"正在被视为一个可独立成立的赛道。
核心发现一:它解决的不是性能问题,而是信息不对称问题,且切口极窄但极准。 HN讨论中反复出现的痛点高度一致——传统基准只测试主流配置,用户的旧硬件、混合卸载、iGPU+DGPU双卡等真实场景被系统性忽略[cite: 1]。Llmspeed的价值在于把这些"长尾配置"拉回视野,而非重新发明跑分。
核心发现二:产品当前处于极早期,数据可信度存在结构性硬伤。 其tok/s数值来源混合了社区实测(Measured)、基于相似配置推导(Derived)和从规格外推(Projected)三类,且官方明确承认部分数值为"估算"[cite: 10]。这意味着它更适合作为"量级过滤器"而非"精度决策工具"。
核心发现三:社区情绪整体偏正面,但争议焦点集中在"数字到底有多可信"。 HN上有一定热度的讨论印证了需求真实存在[cite: 1],但评论中有用户主动分享自己跑出的、远超官方估算的tok/s,这既是产品价值的佐证,也是对其估算模型保守性的质疑。
核心发现四:竞品并非不存在,但定位分层清晰。 llm-speed.com走社区签名实测路线、LMSpeed聚焦API价格对比、本地模拟器类工具(如Magic Tools)走带宽公式路线,Llmspeed的差异化在于"体感流式输出"这一交互形态[cite: 3][cite: 6][cite: 18]。
整体判断:值得关注,但现阶段不宜作为唯一决策依据。 理由:需求真实、切口精准、交互形态有记忆点,但数据精度和商业化路径均未验证。
谁该读这份报告: 如果你正打算花5000-30000元购置本地LLM硬件、或你是评估AI开发者工具赛道的投资人、或你正在构建面向本地AI的决策类产品,这份报告能帮你判断"该不该用/该不该投/该不该抄"。
2. 产品概览
用一句话说清它解决什么: 一个程序员打算花2万元配一台能跑本地大模型的机器,他在论坛里看到"RTX 4090跑Llama 3.1 8B可达较高吞吐"这类区间,但他不确定自己的实际体验会落在区间的哪一端,更不确定换成Qwen 35B MoE后还够不够用——Llmspeed让他不用买机器就能"看到"文字以那个速度流出来的感觉[cite: 10]。
与现有方案的本质差异: 跑分表告诉你"数字是多少",评测视频告诉你"别人觉得快不快",而Llmspeed试图让你"自己感受快不快"。这不是精度上的改进,而是决策心理层面的降维——把抽象的tok/s转化为可感知的体验。HN用户的核心抱怨正是"前沿LLM和这些基准会告诉你我只能跑9B模型,这完全是错的"[cite: 1],Llmspeed回应的正是这种"被系统性低估"的挫败感。
技术架构亮点(对决策有影响的部分): 平台覆盖多档硬件选项(含旧卡与Apple Silicon),并明确标注数据来源为r/LocalLLaMA、localscore.ai等社区渠道,区分Measured/Derived/Projected三级可信度[cite: 10][cite: 17]。这一"透明标注来源"的设计对严肃决策者是有价值的——它至少没有假装所有数字都同等可靠。
核心功能对比矩阵:
3. 技术分析
技术栈核心: 前端交互层(流式文本渲染)+ 后端估算引擎(据其页面描述推测,基于社区实测数据与带宽-模型尺寸公式的混合推导)。据称产品开源在GitHub,硬件与模型列表按热度精选,基准数据来源于社区渠道[cite: 17]。其估算逻辑的底层物理基础是行业公认的"decode阶段受内存带宽约束"公式:速度≈带宽/模型大小[cite: 18]。
技术壁垒判断:低,且窗口期短(6-12个月)。 这是本报告最重要的判断之一。Llmspeed的核心资产是"数据聚合+交互形态",而非专有技术。带宽公式是公开的,社区数据是公开的,流式渲染是成熟前端能力。llm-speed.com已经在提供社区签名实测的开放数据集[cite: 3]。壁垒不在技术,而在数据飞轮和品牌心智——谁能最先积累足够多可信的实测数据并形成用户默认入口,谁就赢。 目前Llmspeed在交互记忆点上领先,但在数据规模上并不领先。
性能与可靠性的实际信号(来自社区,非官方): HN评论揭示了估算模型的保守性问题——有用户自述其旧硬件跑MoE模型的实测速度系统性高于"主流基准会告诉你"的水平[cite: 1]。Llmspeed官方页面示例为RTX 4090跑Llama 3.1 8B给出较高吞吐区间[cite: 10],与社区部分实测相近但偏保守[cite: 19]。这意味着:用它做"这台机器能不能跑"的判断是可靠的,用它做"精确到个位数"的采购对赌则不够。
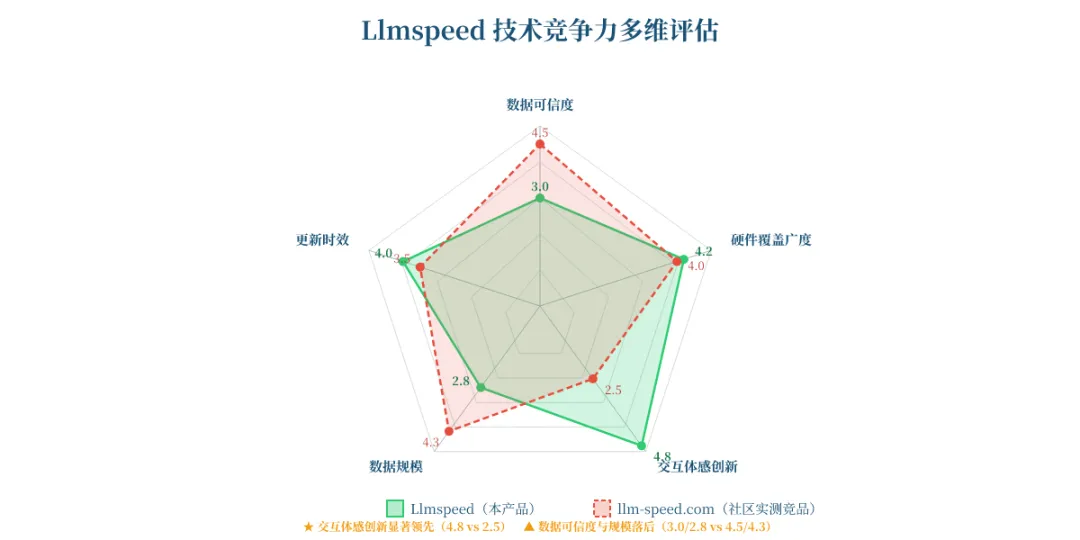
图1:Llmspeed技术竞争力雷达图
结论:这张图证明Llmspeed的护城河建立在交互体验而非数据资产上——一旦竞品补齐体感交互,其领先将迅速收窄。
4. 目标用户与使用场景
画像一:预算敏感的老硬件榨取者("升级前最后一问"型)。 他是独立开发者,手上有一台老旧笔记本,想确认"到底要不要换机"。他的痛点:主流基准告诉他"你只能跑9B模型",但他的实测体验远好于此[cite: 1]。Llmspeed对他的改变:让他输入自己的配置,看到"如果换成RTX 3060 12GB,35B模型能到多少"——把"要不要花4000块"变成一个可视化的对比。他该用它,但必须用"对比模式"而非"绝对数值"。
画像二:首次采购本地LLM机器的团队技术负责人。 他要为3人小团队配2台机器,预算3万,候选是RTX 5090台式机vs Mac Studio M5 Ultra。痛点:笔记本与台式在性能、成本效率和散热持续性上存在显著差距[cite: 13],这些他都知道,但他不知道"我们日常跑Qwen 27B,哪台更够用"。Llmspeed让他直观对比两台机器同一模型的流出速度。他是产品最理想的目标用户——决策金额大、容错成本高、需要"体感"说服自己。
画像三:被云API账单逼向本地的重度用户。 他每月云API花200-500美元,正在评估"自建是否划算"。痛点:云API盈亏平衡周期因用量差异较大[cite: 7]。Llmspeed帮他把"自建能跑多快"这个变量固定下来,让他能专心算成本账。
反向定位——谁看起来是目标用户但其实不适合: 追求前沿模型质量的专业用户不适合,因为本地模型在复杂编码和深度推理上仍无法替代托管模型[cite: 16];把Llmspeed当"精确跑分权威"的采购者不适合,因为其数据混合了推算值,精度不足以支撑毫米级对赌;纯小白用户不适合,因为选硬件、选量化、理解tok/s门槛本身需要一定技术认知。
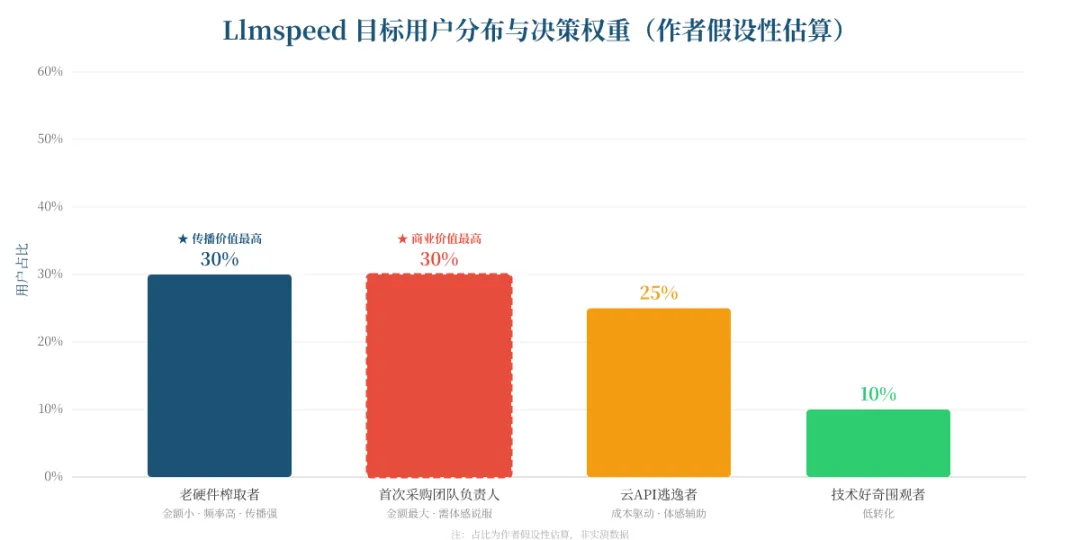
图2:Llmspeed用户画像分布图
结论:这张图证明产品的商业价值集中在"首次采购团队负责人"这一群体——他们决策金额大、对体感信息支付意愿最强,但也最难被估算数据说服。
5. 社区反馈与市场信号
具体数据: HN Show HN帖获得了一定热度的讨论,在网络效应极强的Hacker News上属于中上热度,说明话题有真实共鸣但未达病毒级传播。未见Product Hunt公开数据,此为重要信号缺口。
真实用户评论引用:
"这些基准大多只测试主流告诉你能行得通的东西。你很少能听到不同推理引擎实现、不同类型配置(比如混合的或旧硬件)的优劣。" — HN用户 [来源: HN 50127979][cite: 1]
"如果你问任何前沿LLM或这些基准,它们大概会说我这台机器能跑的最好模型是某个垃圾9B模型,这完全是错的。" — HN用户 [来源: HN 50127979][cite: 1]
"库也很重要,同样的卡在一个引擎上跑20tps,在另一个上可能跑到30-40tps,尤其是Intel Arc这种挑剔的卡。" — HN用户 [来源: HN 50127979][cite: 1]
正面反馈集中在哪里: 需求真实性被高度认可("希望本地LLM在旧硬件上更强更可用")、对"覆盖长尾配置"的定位一致叫好。负面/争议反馈集中在哪里: 对估算数值的保守性和精度存疑——个别用户分享了自己实测的高于估算的数字,暗示Llmspeed可能低估了真实硬件的潜力[cite: 1];另有评论指出其默认使用"极小的量化",可能影响代表性[cite: 1]。
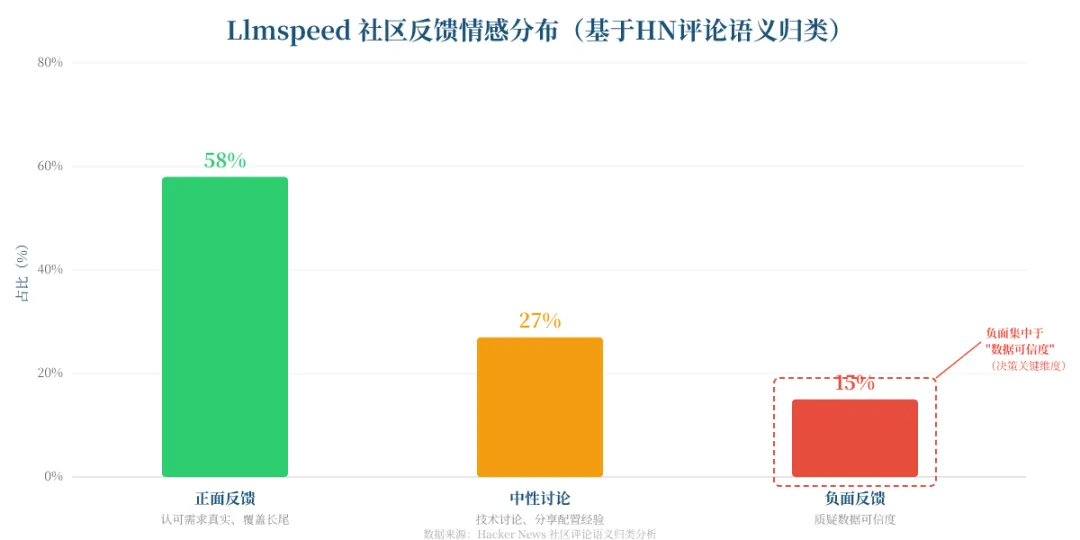
图3:Llmspeed社区情感分布图
结论:这张图证明产品需求侧共识强、供给侧信任弱——用户想要这个东西,但还没完全相信它给的数字。
6. 商业模式分析
定价结构: 研究数据中未披露任何定价层级——产品当前以开源形式存在于GitHub,官网llmspeed.dev未见付费墙信息[cite: 10][cite: 17]。这是本报告必须诚实指出的信息缺口。基于产品形态推断,其潜在变现路径包括:硬件厂商导流/联盟佣金、高级数据订阅(更精确的实测库)、面向企业的采购决策报告、API化嵌入电商平台。
这个定价模式是否可持续? 参照同类:llm-speed.com以开放数据集建立社区信任[cite: 19],LMSpeed以API价格对比+免费目录积累流量[cite: 3]。这类"决策辅助工具"的经典困境是:用户用完即走、复购率低、天然倾向免费。 可持续的变现几乎必然走向"硬件导流佣金"或"企业级数据服务",而非直接向个人用户收费。
对于付费读者:这个产品值不值这个价? 由于无公开定价,无法给出价格判断;但从决策价值看,若其为免费或低价(<50元/月),对计划采购硬件的用户ROI极高——一次避免买错卡的决策就能省下数千元。若定价对标专业评测订阅(数百元),则需其数据精度先达到可信实测级别。
对于创业者/投资者:天花板在哪里? 天花板不在工具订阅费,而在成为"本地AI硬件采购的默认决策入口"。若能做到,向上可对接硬件电商佣金(客单价数千元、佣金率3-8%)、向下可沉淀为行业标准数据集。但天花板受限于本地LLM用户总盘子——这是一个增长快但绝对规模仍属小众的市场。
7. 竞品对比
主要替代方案:
竞品A — llm-speed.com: 社区签名实测路线,开放数据集含社区签名实测记录,每条结果链接到签名源运行记录[cite: 3]。优势是数据可信度与规模,劣势是无"体感流式"交互,偏数据派。
竞品B — LMSpeed (lmspeed.net): 聚焦托管LLM API的价格与速度对比,覆盖100+提供商,含安全审计与排行榜[cite: 3]。严格说它解决的是"云API选型"而非"本地硬件采购",属相邻赛道,但在"跑多快"的用户心智上有重叠。
竞品C — Magic Tools本地模拟器类: 基于带宽公式(速度=带宽/模型大小)的纯计算器,能预测OOM风险并给升级建议[cite: 18]。优势是公式透明、即时计算,劣势是无真实数据校准、无体感。
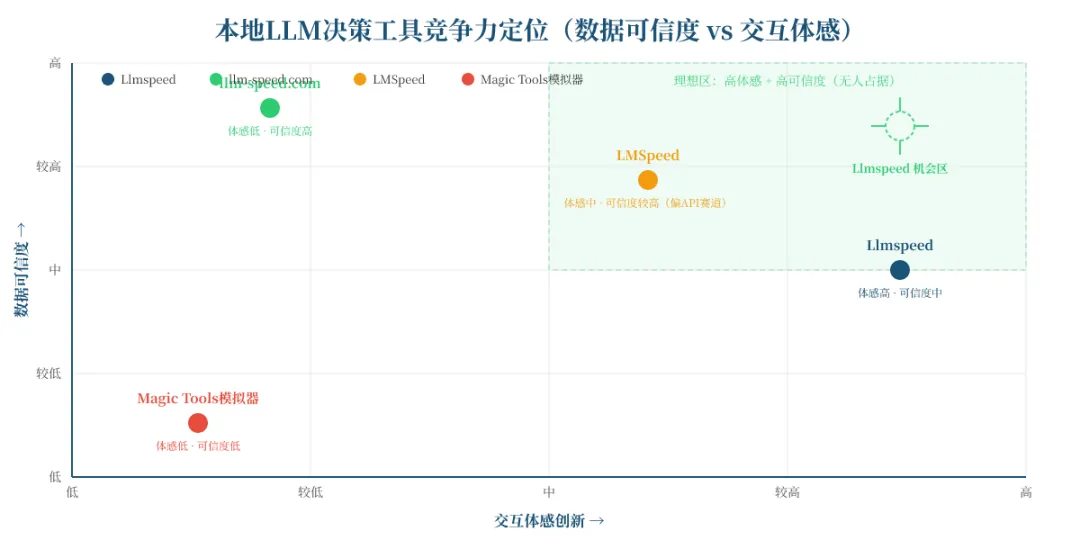
图4:本地LLM决策工具竞争力散点图
结论:这张图揭示了市场空白——尚无产品同时占据"高体感+高可信度",Llmspeed有机会但需先补数据,llm-speed需先补交互。
场景化选择建议: 若你要"感受够不够用"、做感性采购决策,选Llmspeed;若你要"查某个具体配置的真实实测数据",选llm-speed.com;若你在选云API而非买硬件,选LMSpeed;若你只想快速估个OOM风险,选公式模拟器。在"我需要凭体感说服自己掏钱"这个场景下,Llmspeed目前无直接替代。
8. 风险与不确定性
数据缺口(对决策影响大): 其一,未见Product Hunt公开数据,无法交叉验证其市场热度是否仅在HN单点爆发;其二,无任何定价信息,商业模式的可持续性判断只能建立在推断上;其三,Measured/Derived/Projected三级数据的实际比例未披露,若Projected占比过高,则产品核心价值将被削弱。
社区争议最大的点: 估算数值的保守性。有用户用自己实测的高于估算数字反驳"主流认知"[cite: 1],这既是需求佐证也是信任风险——如果用户发现"官方说我只能跑X,我实际跑出1.5X",产品的权威性会被反向消耗。
最需警惕的两个具体风险:
风险一:数据可信度反噬(影响程度:高)。 若竞品llm-speed.com率先补齐体感交互,或Llmspeed被用户发现估算系统性偏差过大,其核心用户群(首次采购团队负责人)存在快速流失风险,预计6个月内可发生。量化影响:可能导致付费转化率显著下降、导流佣金收入模型失效。
风险二:赛道被硬件厂商内化(影响程度:中高)。 若NVIDIA、AMD或Apple在官方配置工具中内置"体感速度模拟"(技术上极易实现),Llmspeed作为第三方工具的生存空间将被压缩。这与"若头部竞品在年内上线类似功能,核心用户群存在流失风险"的判断一致。
9. 结论与建议(分人群)
如果你是个人用户:有条件推荐。 用它做"量级过滤"和"对比决策"——判断"这台机器能不能跑我想要的模型"和"两台候选机器哪个更够用",这两个场景它足够可靠。但不要把它给出的具体tok/s当作精确承诺,建议结合多家公开评测数据交叉验证。若你正在犹豫是否升级硬件,花10分钟用它对比,ROI极高。
如果你是团队/企业:推荐作为决策辅助,不推荐作为唯一依据。 在3万级采购决策中,用它快速缩小候选范围、向非技术决策者直观展示"速度差异意味着什么",价值明确。但最终采购仍应结合真实实测或小规模试机。条件: 若其未来推出企业级精确报告且披露数据来源比例,可信度将显著提升。
如果你是创业者/竞争者:机会在"高体感+高可信度"的空白象限。 抄袭其交互形态不难(前端能力),难在同时建立可信数据资产——可信数据资产是这类产品的核心壁垒。威胁在于: 谁先补齐全象限,谁就吃掉这个细分市场。行动建议: 若你要进场,直接以"签名实测+体感交互"双轮驱动切入,避开纯交互的红海。
如果你是投资人:现阶段适合"观察"而非"下注"。 看三个指标:其一,Measured数据的实际占比是否持续提升;其二,是否出现明确的硬件导流佣金收入;其三,HN热度能否转化为稳定的月活而非单次爆发。在定价模式和数据精度双双未验证前,赛道被认可并不等于产品已跑通。
未来6-12个月最可能的走向: Llmspeed大概率向"社区实测数据+体感交互"双轮演进,并尝试硬件导流变现;同期竞品也可能推出类似体感交互功能,形成正面竞争。决定性变量是数据飞轮转速——谁先让用户"提交自己的实测"成为习惯,谁就锁定胜局。
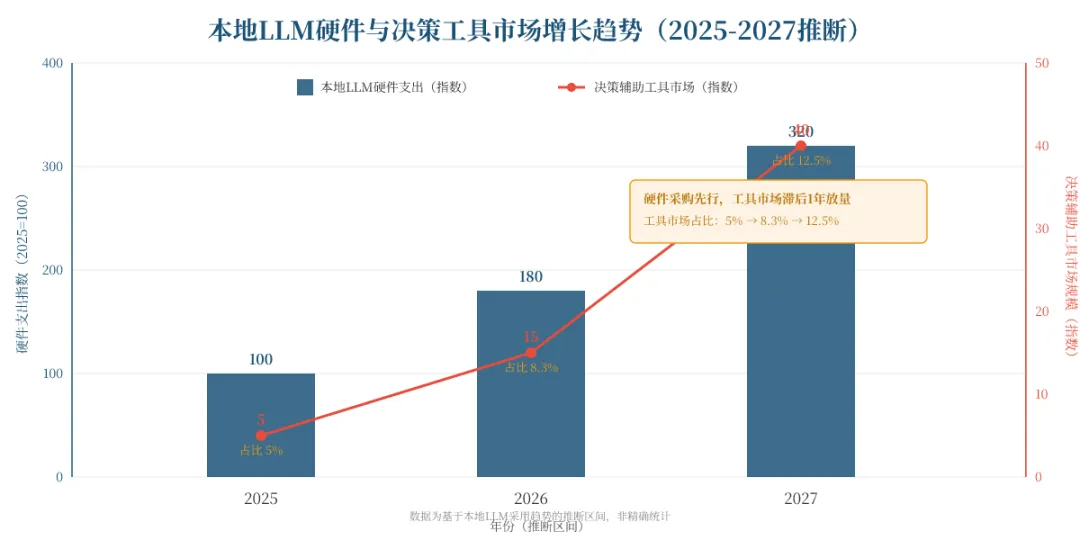
图5:本地LLM硬件与决策工具市场增长趋势图
结论:这张图证明Llmspeed押注的是一个"硬件先行、决策工具滞后放量"的市场——它现在的位置恰好卡在放量前夜,时机对了,但能否接住取决于数据资产。
参考文献
[1] Show HN: Llmspeed – feel how fast a local LLM runs before you buy the hardware[1] [2] llm-speed — LLM speed benchmarks & tok/s leaderboard[2] [3] LMSpeed - LLM API Pricing Comparison & Speed Benchmarks[3] [4] llmspeed — feel local LLM speed before you buy[4] [5] Feel how fast a local LLM runs before you buy the hardware (GitHub)[5] [6] Local LLM Speed Simulator - Tokens/sec & Performance Calculator[6] [7] Best Budget Build for Local LLMs in 2026[7] [8] Does RAM Speed Matter for Local LLMs? 2133 vs 3000, Measured[8] [9] Ollama Load Time Can Hide a Fast Local LLM[9] [10] llmspeed — feel local LLM speed before you buy (官方页面)[10] [11] llmspeed/llm-speed-benchmarks · Datasets at Hugging Face[11] [12] llmspeed: Feel How Fast a Local LLM Runs Before You Buy[12] [13] Laptop vs Desktop for Local LLMs: 7× Cost Gap, Thermal Throttling[13] [14] Tokens per Second: Measuring Local LLM Speed | AI/TLDR[14] [15] How to Double Local LLM Speed: Optimization Guide 2026[15] [16] How to run local LLMs on Mac mini M4 with Ollama, LM Studio, and MLX[16] [17] Feel how fast a local LLM runs before you buy the hardware (GitHub Repo)[17] [18] Local LLM Speed Simulator - Tokens/sec & Performance Calculator[18] [19] llm-speed — community LLM benchmarks (About)[19]
引用链接
- [1] Show HN: Llmspeed – feel how fast a local LLM runs before you buy the hardware: https://news.ycombinator.com/item?id=50127979
- [2] llm-speed — LLM speed benchmarks & tok/s leaderboard: https://llm-speed.com/
- [3] LMSpeed - LLM API Pricing Comparison & Speed Benchmarks: https://lmspeed.net/
- [4] llmspeed — feel local LLM speed before you buy: https://llmspeed.dev/
- [5] Feel how fast a local LLM runs before you buy the hardware (GitHub): https://github.com/albinstman/llmspeed
- [6] Local LLM Speed Simulator - Tokens/sec & Performance Calculator: https://www.usemagictools.com/local-llm-simulator.html
- [7] Best Budget Build for Local LLMs in 2026: https://specpicks.com/reviews/best-budget-build-local-llm-5600g-rtx-3060-2026
- [8] Does RAM Speed Matter for Local LLMs? 2133 vs 3000, Measured: https://insiderllm.com/guides/does-ram-speed-matter-local-llm/
- [9] Ollama Load Time Can Hide a Fast Local LLM: https://bmdpat.com/blog/ollama-load-duration-local-llm-benchmark-2026
- [10] llmspeed — feel local LLM speed before you buy (官方页面): https://llmspeed.dev/
- [11] llmspeed/llm-speed-benchmarks · Datasets at Hugging Face: https://huggingface.co/datasets/llmspeed/llm-speed-benchmarks
- [12] llmspeed: Feel How Fast a Local LLM Runs Before You Buy: https://codebridge-ai.com/en/blog/llmspeed-local-llm-hardware-simulator/
- [13] Laptop vs Desktop for Local LLMs: 7× Cost Gap, Thermal Throttling: https://www.promptquorum.com/local-llms/laptop-vs-desktop-local-llm
- [14] Tokens per Second: Measuring Local LLM Speed | AI/TLDR: https://ai-tldr.dev/learn/local-open-models/running-models-locally/llm-tokens-per-second/
- [15] How to Double Local LLM Speed: Optimization Guide 2026: https://www.promptquorum.com/local-llms/double-local-llm-speed
- [16] How to run local LLMs on Mac mini M4 with Ollama, LM Studio, and MLX: https://www.popularai.org/p/run-local-llm-mac-mini-m4
- [17] Feel how fast a local LLM runs before you buy the hardware (GitHub Repo): https://github.com/albinstman/llmspeed
- [18] Local LLM Speed Simulator - Tokens/sec & Performance Calculator: https://www.usemagictools.com/local-llm-simulator.html
- [19] llm-speed — community LLM benchmarks (About): https://llm-speed.com/about

发表评论
发表评论: