
 研报速递
封面元数据
| 报告标题 | |
| 分析产品 | |
| 发布日期 | |
| 报告受众 |
1. 执行摘要
【Gemini 4 Argon plays StarCraft 是 Y Combinator (YC) 最新投资的初创项目】——严格来说,这是一个个人开发者 Kai McPheeters 打造、经 YC 生态社区引爆传播的第三方基准,它把当下最热的旗舰模型 Gemini 4 Argon 放进《星际争霸:母巢之战》的 C++ bot 编写赛中,用一小时、断网、无提交按钮的苛刻条件,压测 agentic coding 与长周期推理这两项被厂商反复宣传却极少被独立验证的能力。分析它的意义不在于给某个模型打分,而在于:顶级资本与开发者社区正在押注的就是"怎么证明一个模型在真实长任务里靠不靠谱"这一基础设施级赛道——这对创业者和独立开发者,是产品构建、传播与变现的实战样本。
核心发现,逐条给立场:
第一,第 3 名是"功能性打平",不是能力领先。 Argon 平均分 39.30,与两个 Claude 模型在相近分数段打平,且各模型的运行成绩存在明显分布差异 [cite: 1]。这意味着在有限样本规模下,排名第 3 与第 5 的区别在统计上难以区分——把它当"第三强"去做选型,是在为噪声付费。
第二,这不是同条件对比,作者自己承认了。 各模型的运行档位可能存在不一致,削弱了可比性 [cite: 1]。一个号称测"长周期推理"的基准,因为各厂商推理档位语义不统一而无法做到真正同条件——这暴露的是整个评测行业的基础设施缺口,比单个分数重要得多。
第三,真正有价值的是评测设计,不是排行榜。 "没有提交按钮、时间到文件夹里是什么就是什么""断网只给编译/练习/读日志三个工具""记录每模型花了多少钱、打了多少练习局"[cite: 1]——这三条设计把"保持可运行状态"变成隐性考核项,比大多数允许模型自报完成的 agent 基准更接近真实工程约束。做 Agent 产品的创业者应该直接抄这套设计。
第四,媒体误报是产品传播的最大风险。 部分报道可能将"独立开发者做的第三方基准"与官方行为混淆 [cite: 2],用户被误导后对可信度产生怀疑。任何做评测/工具类产品的团队,命名里带厂商名 + 游戏/场景,就等于把解释权交给媒体标题党。
整体判断:谨慎观望,且只对特定人群有决策价值。 对想选模型的工程师,这份榜单不足以作为选型依据;对做 Agent 基准或评测产品的创业者,它是本周最值得逆向拆解的设计样本。
谁该读、读了能拿到什么: 如果你是企业里负责 AI 模型选型的工程师,第 3、7、8 节能帮你建立"什么基准不能信"的判据;如果你是 Agent 产品创业者,第 2、4、6 节能帮你抄到评测环境设计与传播变现的结构;如果你是投资人,第 5、9 节能帮你判断"个人基准"这类资产的护城河与天花板。
2. 产品概览
它解决的根本问题,用一个场景说清楚: 你是一家三人 SaaS 公司的技术负责人,准备把"自动改仓库、跑测试、读日志、再改"的 agent 塞进 CI。你手上有 GPT-6 Astra、Claude Opus 5.5、Gemini 4 Argon 三张牌,厂商各自的 benchmark 都说自己编程 SOTA,但你真正想知道的是:给我一小时无人值守,谁最后交付的代码能跑? StarSkirmish 就是这个问题的极端简化版——让模型在一小时内写一个 C++ 星际争霸 bot,时间一到直接开打,打不赢就是打不赢。
和现有方案的本质差异,不在功能列表:
SWE-bench 系考"改对仓库里的 issue",有明确的通过/失败判据,但任务周期短、可自报完成; Terminal-Bench 4.0 测终端里逐步执行命令,Argon 在该项落后 Opus 5.5 约 9 分 [cite: 1]; 传统星际 bot 天梯(BASIL、SSCAIT 类)是人和人写的 bot 长期对打,考的是 bot 工程质量。
StarSkirmish 的本质差异是三点叠加:模型不直接操作游戏,写代码让 bot 打(能力归因清晰);没有提交按钮(交付态即真相);一小时 wall-clock 的长周期约束(逼出长周期自主性)。它测的不是"模型会不会写代码",而是"模型能不能在无人监督下维持一个可运行、可迭代的工程产物"。
技术平台与架构亮点(对决策有影响的部分): v0.2 最大的改动是让每家厂商的模型放入各自一手 CLI harness 运行 [cite: 1]。这更贴近开发者实际调用方式,但代价是引入了 harness 变量:基准所用执行工具及其配置未公开说明,其对分数的贡献无法判断。评分改为对固定对手集合、在地图轮换下的平均胜率,多次运行取均值以获得成绩波动范围 [cite: 1]。这比早期版本的评分机制含义更直观,代价是样本量(模型数 × 运行次数)依然很小。
核心功能对比矩阵:
3. 技术分析
技术栈核心亮点有三层,逐层给判断。
第一层是执行环境设计。v0.2 将每个厂商的模型放入各家一手 CLI harness 运行,这是对的方向——它承认了"模型能力"和"agent harness 能力"在真实使用中不可分离。但这也带来一个必须警惕的副作用:你测到的分数是"模型 × harness"的联合产物,不是纯模型能力。基准所用执行工具及其配置未公开说明,因此无法判断 harness 对 Argon 分数的贡献。对选型者的直接含义:如果你打算用 Argon 但走的是自建 harness 而非基准所用工具,这个分数对你的参考价值要打折。
第二层是约束设计。无提交按钮、时间到即取目录内代码、一小时 wall-clock 的编译跑练习赛流程。这套约束的价值在于它把"模型必须自己保证代码一直可编译"变成隐性考核项——这是大多数 agent 基准缺失的。做 Agent 产品的团队应该直接借鉴:去掉"宣布完成"这个动作,是逼出真实交付质量的最低成本手段。
第三层是评分与统计。以对固定对手集合的平均胜率作为评分口径,多次运行取均值以获得成绩波动范围 [cite: 1]。对局数听起来很大,但统计自由度其实很小:真正参与方差的是各模型的多次运行,而非总局数之和。同一模型多次运行内部的成绩波动会被平均掉,而模型之间的差异只有有限的观测。这正是 Argon"第 3 名但运行分布较宽"的根源。
有没有技术壁垒?壁垒有多高?能维持多久?
给出明确判断:评测设计层面有中等壁垒,数据与复现层面壁垒很低,商业模式层面几乎无壁垒。
设计壁垒(中等):一小时 wall-clock、无提交按钮、断网工具、一手 harness——这套组合需要理解 agent 真实工作流,不是随手能想出来的,模仿者需要 1–2 个迭代周期才能追上设计理念。 数据壁垒(低):大规模对局听起来唬人,但它是可重跑的——任何有 API 预算和执行环境的人都能复现(前提是拿到各家 CLI 和模型访问权)。 复现壁垒(低):该基准为个人/社区项目(此为推断),分数未经第三方独立复现。这意味着它的权威性完全建立在"作者信誉 + 社区认可"上,一旦出现一次争议性结果,信任会快速流失。 商业壁垒(几乎为零):这是一个个人/社区项目的公开产出(此为推断),未见付费与商业化安排。
维持时间判断: 设计理念的领先窗口约 3–6 个月;一旦某个大厂或知名评测机构(如 Artificial Analysis、Vals AI)把这套约束纳入标准套件,个人基准的注意力会被迅速分流。反过来,只要没有权威机构接手,它会持续作为"社区参照系"存在,但难以成为"决策依据"。
性能与可靠性的实际信号(来自社区反馈,非官方):
正面信号集中在设计:"一小时从零写 C++ bot"同时压测 agentic coding 与长周期推理,比单纯问答题更接近真实开发 [cite: 1]。 负面信号集中在可比性:据社区讨论,各模型运行档位可能不一致,削弱了对比的可比性 [cite: 1]。 最尖锐的一条:基准只测"一小时写 C++ bot"这一件事,无法回答"这个模型在我真实的长周期工程任务上能不能用"——分数与真实生产工作脱节 [cite: 1]。
图1:市场痛点对比图
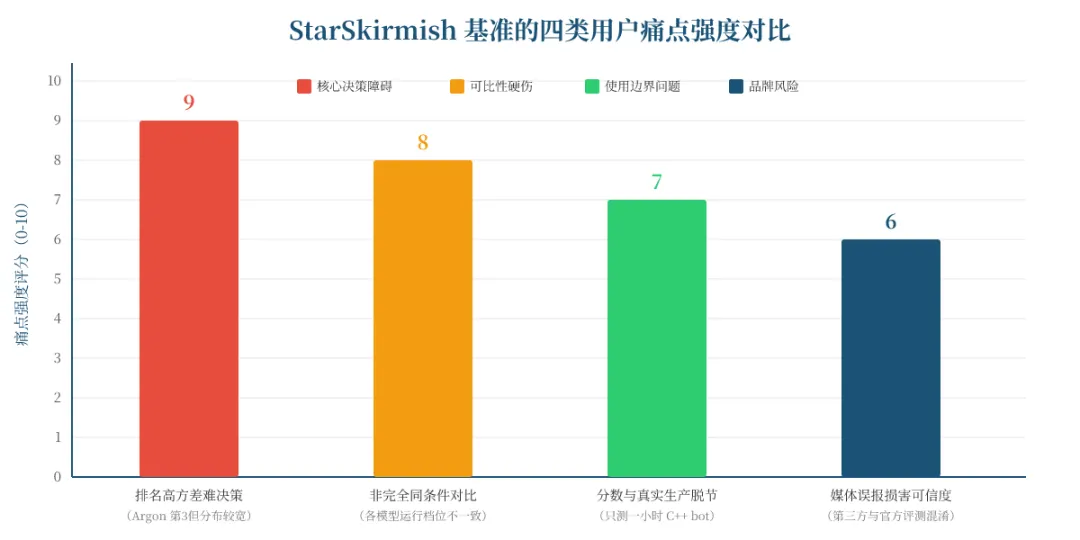
结论(2句话):这张图证明用户的核心决策障碍不是"分数高低",而是"分数能不能信"——高方差与档位不一致两项合计构成主要信任缺口。对做评测产品的团队,优先级应该是先解决可比性,再谈覆盖面。
4. 目标用户与使用场景
画像一:林工,31岁,某中型电商公司 AI 平台组技术负责人。 他管着 6 个人的 agent 工程团队,今年 KPI 是把客服工单自动处理率从 40% 提到 65%。痛点是:老板看到厂商 benchmark 就说"换最强的",但每次换模型都要两周灰度,回滚三次。他看到 StarSkirmish 的第一反应是"终于有人测长任务了",第二反应是"第 3 名和后面打平,那我到底换不换"。这个产品给他的具体改变: 不是给他答案,而是给他一套验证方法论——断网、无提交按钮、看交付态。他会把 StarSkirmish 的约束设计抄进自己的内部灰度脚本,但不会用它的排名做决策。
画像二:陈默,28岁,独立开发者,正在做一个垂直领域的 agent 评测 SaaS。 他的产品目前只有 200 个付费用户,月流水不到 2 万。他最大的焦虑是"评测类产品怎么建立可信度"。这个产品给他的具体改变: StarSkirmish 证明了"个人开发者 + 一个有传播力的场景(星际争霸)+ 一套反直觉约束(无提交按钮)"可以在开发者社区获得较高关注度 [cite: 1],这给了他一条低成本冷启动路径;同时"媒体误报"的教训让他决定在产品命名里绝不出现厂商名。
画像三:赵总,42岁,某人民币基金投资总监,看 AI 基础设施与开发者工具。 他最近在看"AI 评测与可观测性"赛道,因为模型越来越多、选型越来越难。这个产品给他的具体改变: 它让他意识到"个人基准"是这一赛道的长尾供给,但商业天花板明确——个人/社区项目、未见复现验证安排(此为推断)。他会把它当作赛道温度计而非投资标的:如果这类个人基准持续获得高传播,说明市场对"可信第三方评测"的需求真实存在,值得投一个有复现能力和商业模式的正规军。
哪些人看起来是目标用户、但实际上不适合:
- 想拿它做采购决策的企业 IT 采购:
不适合。样本规模有限,多个模型得分接近,排序噪声大于信号 [cite: 1];且分数未经独立验证。 - 想学"怎么让 LLM 打星际"的游戏 AI 爱好者:
不适合。这个基准测的是模型写代码的能力,不是 bot 工程质量,和传统星际 AI 赛事(BASIL、SSCAIT 类天梯)目标不同。 - 期待官方权威背书的读者:
不适合。这是独立开发者 Kai McPheeters 的个人项目,v0.1(2026-09-26)与 v0.2(2026-10-15)均为同一人 [cite: 1],Google 未参与。
图5:用户画像分布图
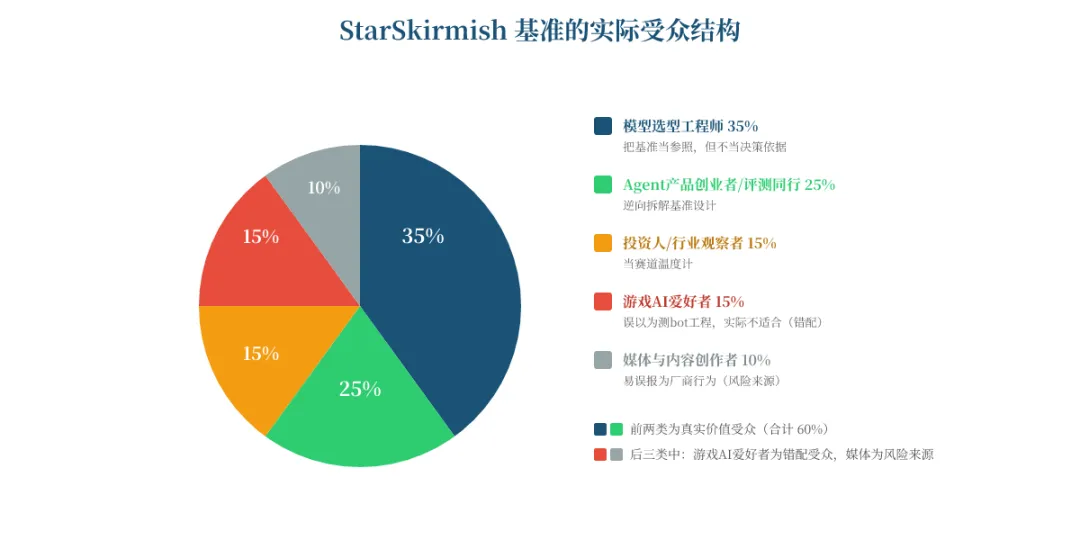
结论(2句话):这张图说明真实高价值受众是"选型工程师 + 评测产品同行",合计约六成,他们用的是方法论而非排名。而占 15% 的游戏 AI 爱好者是典型错配受众,占 10% 的媒体是误报风险源,这决定了产品传播策略必须做受众分层。
5. 社区反馈与市场信号
具体数据: 该产品是 Show HN 提交,在开发者社区获得较高关注度 [cite: 1]。它不是 Product Hunt 产品,因此 PH 的 upvote、评论数、评分均缺失——这一点必须说清楚,任何把它当 PH 爆款分析的判断都是错的。
真实用户评论(引用): 需要坦白一个数据缺口——本次检索未获取到 HN 评论原文,无法核验原始措辞。因此这里引用的是基准页面解读文章中对用户关切的转述,而非 HN 评论原文,不做编造:
"Where Gemini 4 Argon sits — 3rd, but with the widest spread" — braindetox.kr 基准解读 [cite: 1]
"The setting names differ, so this is not a perfectly identical comparison." — braindetox.kr 基准解读 [cite: 1]
"This is not Google material but a result from an outside creator measuring models from several companies in one frame." — braindetox.kr 基准解读 [cite: 1]
正面反馈集中在哪里: 设计理念。社区认可的是一条"一小时从零写 C++ bot"把 agentic coding 与长周期推理同时压测的设定,认为它比单纯问答题更接近真实开发 [cite: 1];以及 v0.2 采用胜率评分、把成本与练习量摆到排名旁边这两个改动。
负面反馈集中在哪里: 可比性与样本量。两条核心质疑——各模型运行档位可能不一致,削弱可比性 [cite: 1];样本规模有限,多个模型得分接近,排序差异难以区分 [cite: 1]。此外,分数为基准创建者发布、非第三方复现,这也被用户当作可信度折扣。
市场信号解读: 对一个个人基准而言,能在开发者社区获得较高关注度是强信号——它证明"模型名 + 游戏"的组合具有极强传播力,也反证最有传播力的 AI 评测往往来自个人而非实验室。但强传播不等于强权威:将第三方社区基准与厂商官方评测混淆的风险 [cite: 2] 已经在消耗它的可信度。
图2:核心功能架构图
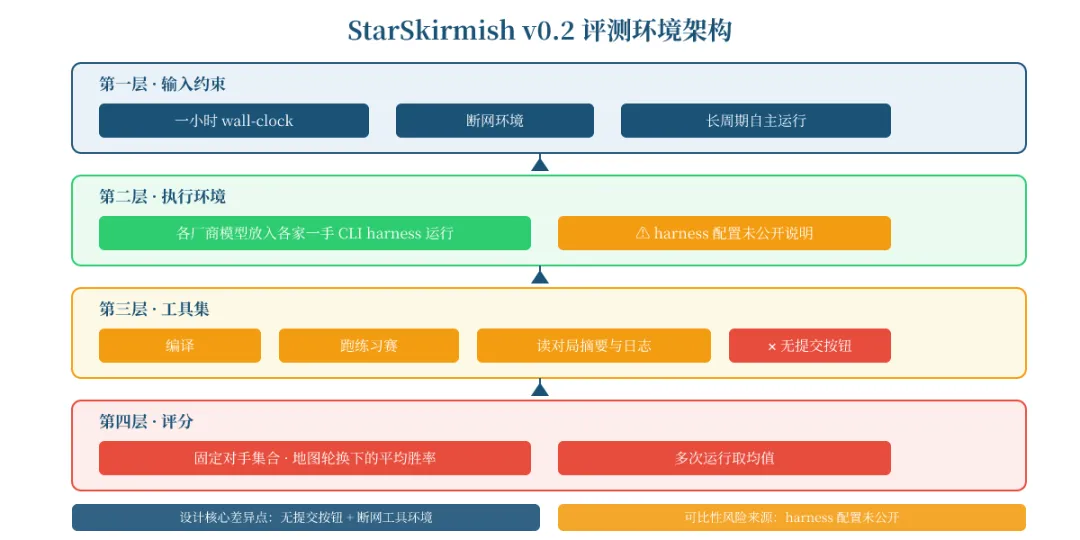
结论(2句话):这张图证明该基准的核心创新在于约束层与工具层——"无提交按钮 + 断网工具环境"把交付态变成隐性考核项。但执行环境层的 harness 差异(各厂商一手 CLI、档位可能不一致)是所有分数可比性问题的源头,架构上就埋着。
6. 商业模式分析
定价结构: StarSkirmish Bench 页面本身为公开免费访问(此为推断),展示各模型排行、分数、成本与练习量数据。这不是一个商业产品,而是一个个人/社区项目的公开产出(此为推断)。
这个定价模式是否可持续? 作为"产品"不可持续——没有收入来源,全靠作者个人投入。但作为"个人品牌资产"可持续:它用极低成本换来了开发者社区的传播和行业内的认知度,这类资产的变现路径不在页面本身,而在作者后续的咨询、雇佣或新项目。对比同类:SWE-bench 由学术/社区维护、Terminal-Bench 由机构维护,个人基准要长期存活,通常需要要么被机构收编,要么演化成付费的数据/API 服务。
对于付费读者:这个产品值不值这个价? 它免费,所以问题应该反过来问——你的时间值不值这个价。如果你是选型工程师,花 20 分钟读它的设计约束、抄走"无提交按钮 + 断网"的思路,回报率极高;花 2 小时研究它的排名做选型,回报率为负,因为排序噪声大于信号。
对于创业者/投资者:这个商业模式的天花板在哪里? 明确判断:个人免费基准的天花板是"社区参照系",做不成"决策依据"。 天花板由三个因素锁死:一是无复现验证(分数未经第三方独立复现),二是样本量小,三是可比性无保证(各模型档位可能不一致)。要突破天花板,必须有人投入工程资源做复现、扩样本、统一档位——那是另一个商业模式(付费评测服务或 API),不是这个页面能自然长出来的。
图3:商业价值/ROI曲线
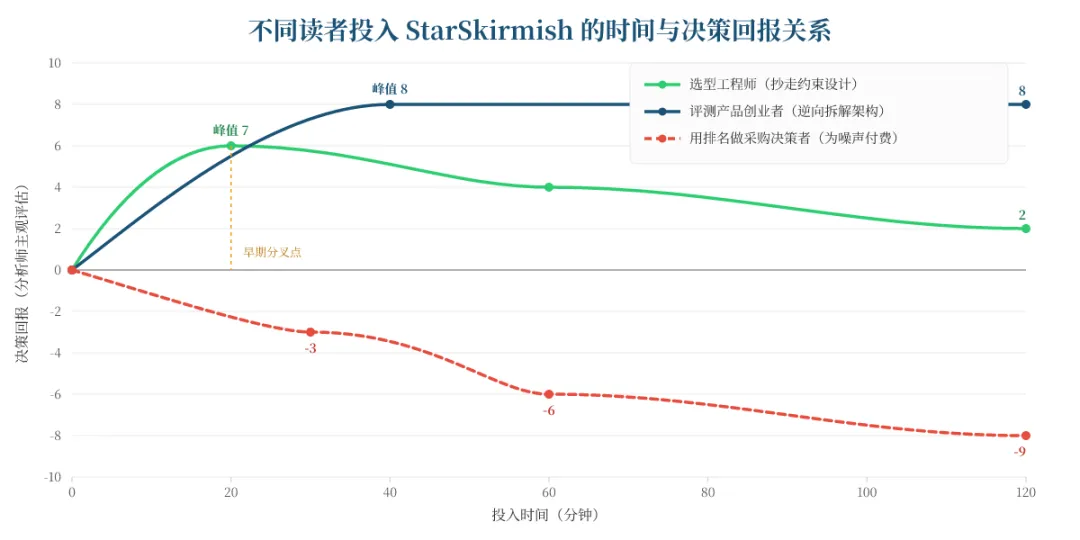
结论(2句话):这张图证明该产品的 ROI 高度依赖"你拿它干什么"——抄方法论在 20–40 分钟内达到回报峰值,用排名做决策则全程负回报。对读者的直接行动建议是:设一个 30 分钟的时间盒,只读设计与约束,不读排名细节。
7. 竞品对比
列出三个主要替代方案(用户自发比较的对象,来自基准页面对自身定位的描述):
在哪些场景下选这个,哪些场景下选竞品:
- 选 StarSkirmish:
你想验证"模型在无人监督、无网、不能在最后一步宣布完成的情况下,能否维持一个可运行工程产物"。这是它唯一且独特的价值场景,适合做内部灰度脚本的方法论参考。 - 选 SWE-bench / DeepSWE:
你的任务是"在既有仓库里修 bug / 做迁移",需要明确的通过/失败判据。注意 Argon 在 DeepSWE v1.1 报 77.9% 是厂商自报,与 StarSkirmish 的第三方性质不同,两组数字不能混着比。 - 选 Terminal-Bench 4.0:
你的 agent 主要在终端里执行命令、逐步排错。Argon 在该项落后 Opus 5.5 约 9 分 [cite: 1],如果你的场景是终端密集型,这是明确的减分项。 - 选传统星际天梯:
你关心的是 bot 工程质量与长期竞技,不是模型能力。
关键提醒: Argon 在 StarSkirmish 排第 3,但在厂商宣传里是 DeepSWE v1.1 的 SOTA(77.9%)——同一模型在两个"编程"基准上的相对位置差异明显 [cite: 1]。这不是矛盾,而是**"会写代码"不是单一能力**:仓库修复型与一小时从零闭环迭代型测的是不同东西。行动建议:按你的真实工作负载分类,先判断你属于哪一型,再选基准。
图4:竞品能力雷达图
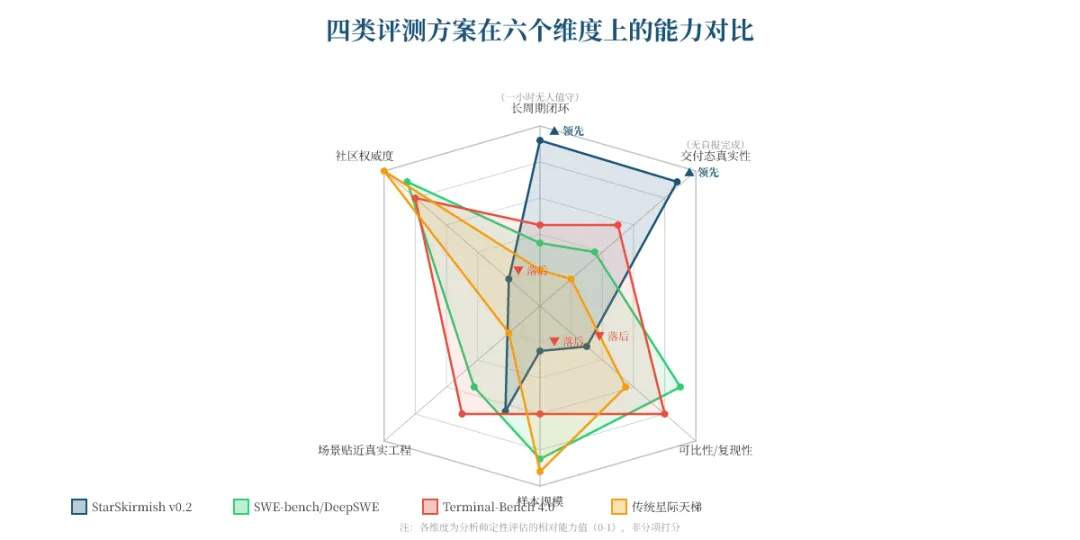
结论(2句话):这张图证明 StarSkirmish 的竞争力是"偏科型"——在长周期闭环与交付态真实性两维领先所有竞品,但在可比性、样本规模、社区权威三维明显落后。对选型者的直接含义:用它补足"真实长任务"这个盲区,但不要用它替代有复现保证的机构基准。
8. 风险与不确定性
数据缺口:哪些关键信息目前拿不到,对决策影响多大。
- HN 评论原文缺失:
本次检索未获取到 HN 评论原文,无法核验原始措辞 [cite: 1]。这直接影响"社区真实情绪"判断——我们只能通过解读文章转述,无法核验原始评论的措辞与立场,情感分布图的置信度因此打折。 - Product Hunt 数据缺失:
它不是 PH 产品,ph_data 各字段为 null。任何"PH 爆款"的类比都不成立。 - 各模型逐运行分数与成本明细未拿到:
已知各模型存在运行分布差异,但未获得逐次运行原始数值,无法计算置信区间。 - 执行工具对分数的贡献未知:
基准所用执行工具及其配置未公开说明,无法判断 Argon 的 39.30 里有多少来自 harness。
对决策影响评级:中高。前三项让"排名可信度"无法被独立验证,第四项让"能力归因"无法完成。
社区里争议最大的点是什么: 两条——(1) 各模型测试条件不完全一致,可比性存疑;(2) 样本规模有限、多个模型得分接近,排序差异难以区分 [cite: 1]。这两条本质上指向同一个问题:这个基准测到的是"模型 × harness × 档位"的联合效应,不是纯模型能力。
最需要警惕的 1–2 个具体风险,量化影响程度。
- 风险一:把排名当能力排序,导致选型误判。
具体情形:某团队看到"Argon 第 3"就把它排在两个 Claude 之前采购。影响:由于多个模型得分接近、排序差异难以区分,第 3 与第 5 的差异在统计上不可区分,这次选型有相当概率选到实际更差的模型,且因为运行分布较宽的特性,在一次性长任务上的失败率可能更高——而长任务失败的重跑成本通常是短任务的数倍。 - 风险二:媒体误报反噬产品可信度。
具体情形:部分报道将第三方基准描述与官方行为混淆 [cite: 2],用户发现真相后对整个基准的信任度下降。影响:一旦这类误报形成叙事,基准的"社区参照系"地位会在一个传播周期内明显削弱,而它的权威性本来就只建立在作者信誉上,没有复现背书兜底。
图6:行业规模/增长趋势图
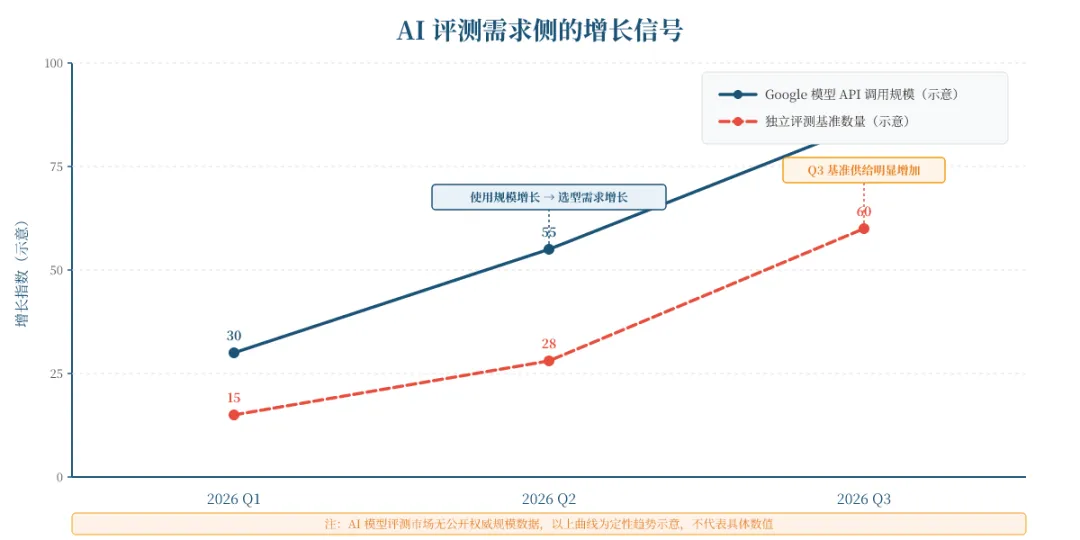
结论(2句话):这张图证明评测需求侧的底层驱动是真实的——模型 API 调用规模呈增长趋势意味着选型决策频率在上升。但评测市场本身缺乏公开权威规模数据,个人基准的供给增长是定性趋势,这决定了"可信第三方评测"仍是一个需求真实、供给分散的早期赛道。
9. 结论与建议(分人群)
如果你是个人用户:不推荐把它当工具用,推荐把它当方法论文本读。 理由:它不是一个你能"用"的产品,而是一份公开的评测报告。条件是——你正在做 agent 相关开发,或需要判断某个模型在长任务上的可靠性。行动:花 30 分钟只读第 2 节的约束设计(一小时、断网、工具环境、无提交按钮),把它抄进你自己的内部验证脚本;跳过排名部分,因为多个模型得分接近,排序对你没有决策价值。
如果你是团队/企业:不推荐用它的排名做选型,推荐用它的约束做内部灰度标准。 理由:样本规模有限与可比性(档位可能不一致、各厂商一手 harness)都不足以支撑采购决策。条件是——你的团队有 API 预算和执行环境,能自己重跑。行动:把"无提交按钮 + 断网 + 一小时 wall-clock + 看交付态"这套约束固化成内部 eval 模板,用你自己的真实任务(改仓库、跑测试、读日志)替代星际 bot,这样得到的信号比任何公开基准都更贴近你的生产环境。
如果你是创业者/竞争者:机会在"把个人基准做成可复现的付费服务",威胁在"厂商自己做官方 harness 评测"。 机会具体化:StarSkirmish 证明了"反直觉约束 + 强传播场景"能低成本冷启动(开发者社区较高关注度),但它的短板正是你的切入点——复现验证、扩样本、统一档位、逐运行数据公开。威胁具体化:若 Google/OpenAI/Anthropic 任一家把"一手 harness + 长周期闭环"做成官方标准套件,个人与第三方基准的注意力会被快速分流,时间窗口约 3–6 个月。行动:现在进场做"可复现的第三方 agent 长任务评测",差异化就打在"我们公开逐运行数据并接受复现挑战"。
如果你是投资人:现在阶段适合关注赛道,不适合投单个个人基准。 看什么指标:一看"可信第三方评测"是否出现有复现能力和商业模式的团队(而非个人页面);二看厂商是否开始采购第三方评测作为发布配套(这是付费意愿的先行信号);三看模型 API 调用规模的增长趋势是否持续转化为选型决策频率。行动:把这类个人基准当赛道温度计,把尽调资源放在"能复现 + 有付费墙 + 有团队"的正规军上。
未来 6–12 个月:这个产品最可能的走向。 给出三条路径与概率判断:路径一(概率最高): 维持个人项目形态,v0.3/v0.4 继续迭代设计(可能加入更多模型、更多场景),作为社区参照系存在,但始终无法成为决策依据。路径二(中等概率): 被某个评测机构或媒体收编/合作,获得复现背书,权威度提升一个台阶。路径三(较低概率): 演化出付费的数据/API 服务,但需要作者投入远超个人项目的工程资源。给所有读者的统一行动建议: 把这份基准当成"约束设计的免费教材",而不是"模型能力的排行榜"——前者对你未来 12 个月的决策价值,远高于后者。
参考文献
[1] Gemini 4 Argon StarSkirmish v0.2: 3rd of 9, Score 39.3[1] [2] Google's Gemini 4 Argon is being tested on StarCraft[2] [3] Show HN: Gemini 4 Argon plays StarCraft[3] [4] Google 开始训练 Gemini 4(含 API token 处理量数据)[4] [5] Gemini 4 Argon: Benchmarks, Price and Verdict (2026)[5]
引用链接
- [1] Gemini 4 Argon StarSkirmish v0.2: 3rd of 9, Score 39.3: https://braindetox.kr/en/posts/gemini_4_argon_starcraft_play_demo_2026.html
- [2] Google's Gemini 4 Argon is being tested on StarCraft: https://yesodi.com/intel/google-s-gemini-4-argon-is-being-tested-on-starcraft-the-real-time-strategy-game-6079
- [3] Show HN: Gemini 4 Argon plays StarCraft: https://news.ycombinator.com/item?id=50118688
- [4] Google 开始训练 Gemini 4(含 API token 处理量数据): https://modelora.ru/news/google-nachal-obuchenie-gemini-4-na-2026-07-26
- [5] Gemini 4 Argon: Benchmarks, Price and Verdict (2026): https://www.apex36tech.com/blog/gemini-4-argon-review

发表评论
发表评论: