
 研报速递
比如一款面粉,我们习惯讲原料、工艺和品质。买家在搜索框里输入的,可能是“能不能做馒头”“空气炸锅怎么做”“和另一种粉有什么区别”。
这些问题不难理解,但只盯着自己的商品资料,很容易漏掉。
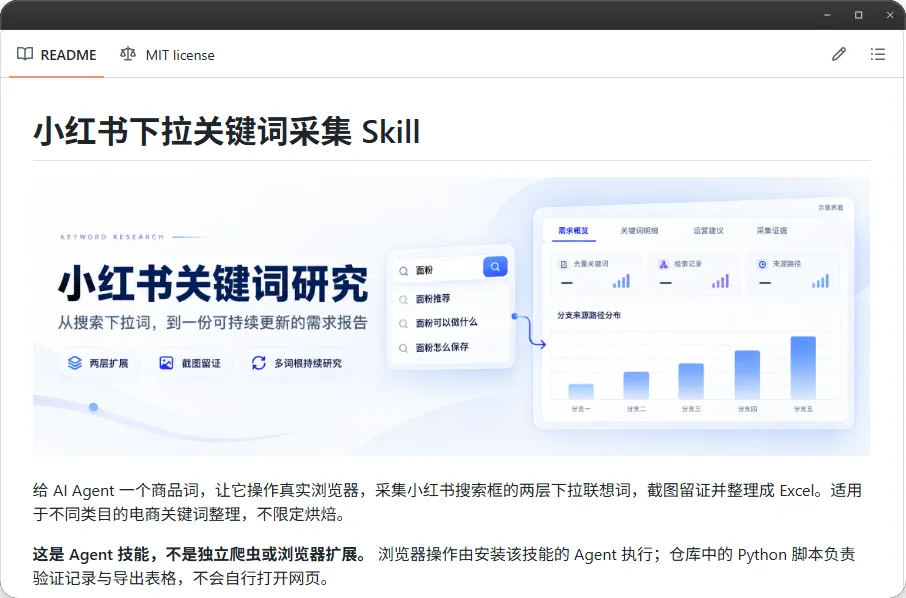
于是,这个自动采集小红书下拉词、整理表格和研究报告的 Skill,它来了。
01让 AI 去搜索框里采一遍
]这次我拿“高筋粉”和“低筋粉”做实操,让 AI 操作浏览器,在小红书顶部搜索框输入商品词,读取下拉列表,并把每次结果截图保存。
先采词根触发的第一层联想词,再把这些词逐个输入,继续采第二层。相同检索词不重复操作,采到第二层就停。
下面这张就是采集过程,AI 正在输入“高筋粉”,读取它的下拉联想词。
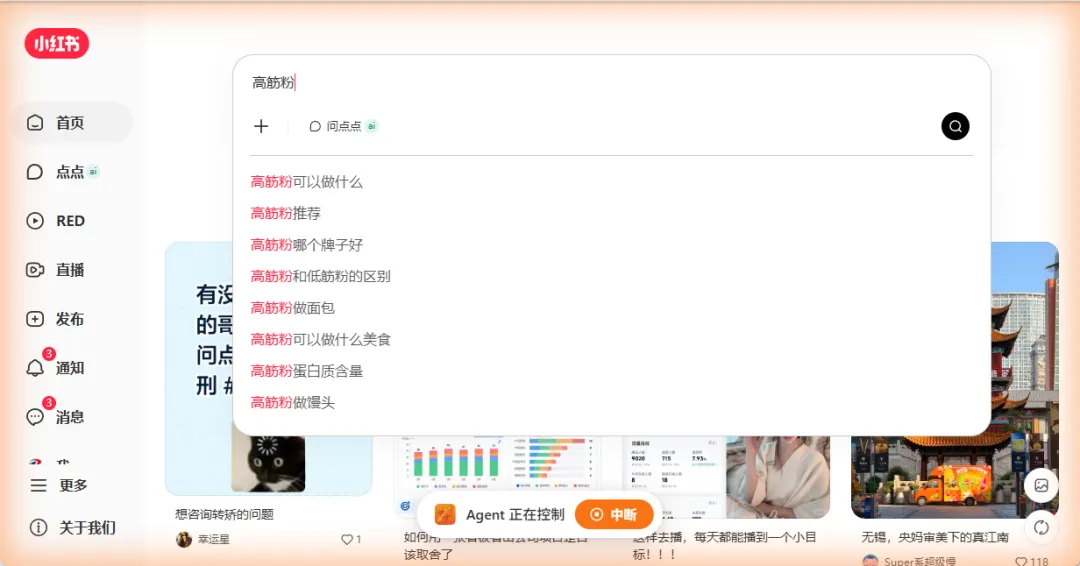
在高筋粉的第一层下拉里,就能看到“高筋粉做面包”“高筋粉做馒头”“高筋粉蛋白质含量”。低筋粉里则有“低筋粉是什么粉”“低筋粉怎么做蛋糕”“低筋粉可以做馒头吗”。
同样是面粉,买家关心的选择条件已经有区别了。
我看这些词时,先想的是:自己的商品介绍,有没有把粉种、用途和选择条件讲清楚?
但它确实提醒了我:可能有人正拿着这个问题挑产品,而我的商品页还没回答。
内容选题也一样。“低筋粉怎么做蛋糕”可以继续往具体条件里找。把“高筋粉可以做什么”再输入搜索框,第二层里还能看到美食、烘焙、空气炸锅、包子、饼、面包等相关词。
可以从这里挑一个自己熟悉的用途,讲清选粉条件和实际做法,比泛泛介绍“这款面粉品质好”更具体。
02采集结束,先看原始表格
]这次两个词根做了18次查询,记录144条来源路径,按原词完全一致去重后是138个词。
同一个词可能在不同查询里出现,所以来源路径数和去重词数分开统计,原始来源都保留。
Excel 里有关键词表、采集记录、截图索引、去重词库和待采集五张表。下面这张能看到词根、层级、检索词、下拉位置、时间和页面地址,后面分析时可以顺着来源核对。
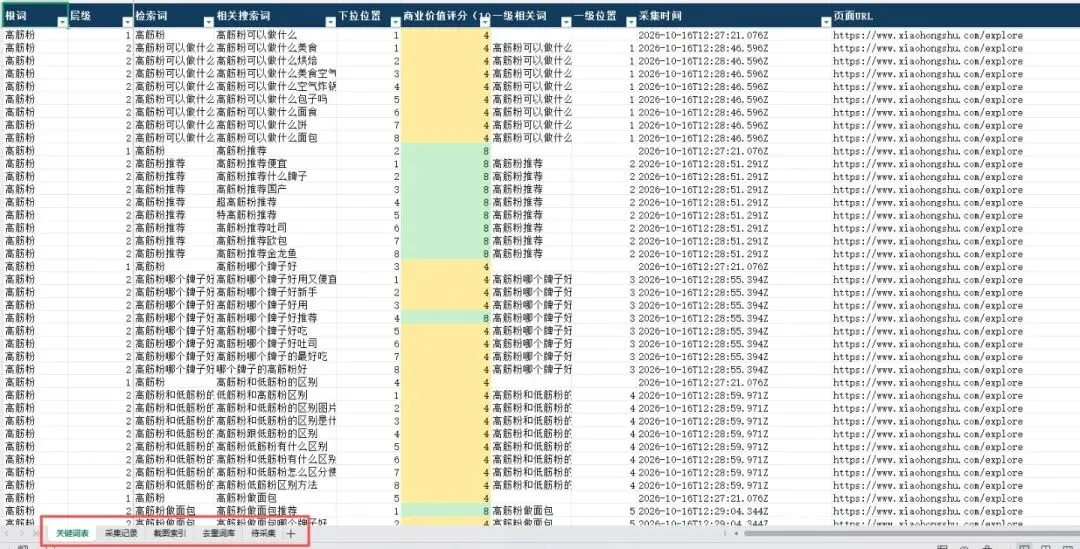
评分列也做了颜色区分,方便快速筛选。不过分数是规则对商业意图的估计,不是小红书给出的搜索热度。使用方法类的词,未必离下单最近,也可能很适合做答疑内容。
03采来的词,不用挤在一张长表里看
]表格方便筛选、导出,或者继续交给 AI 分析。
想先浏览这批词、再往具体问题里找,可以打开一起生成的 HTML 研究报告。
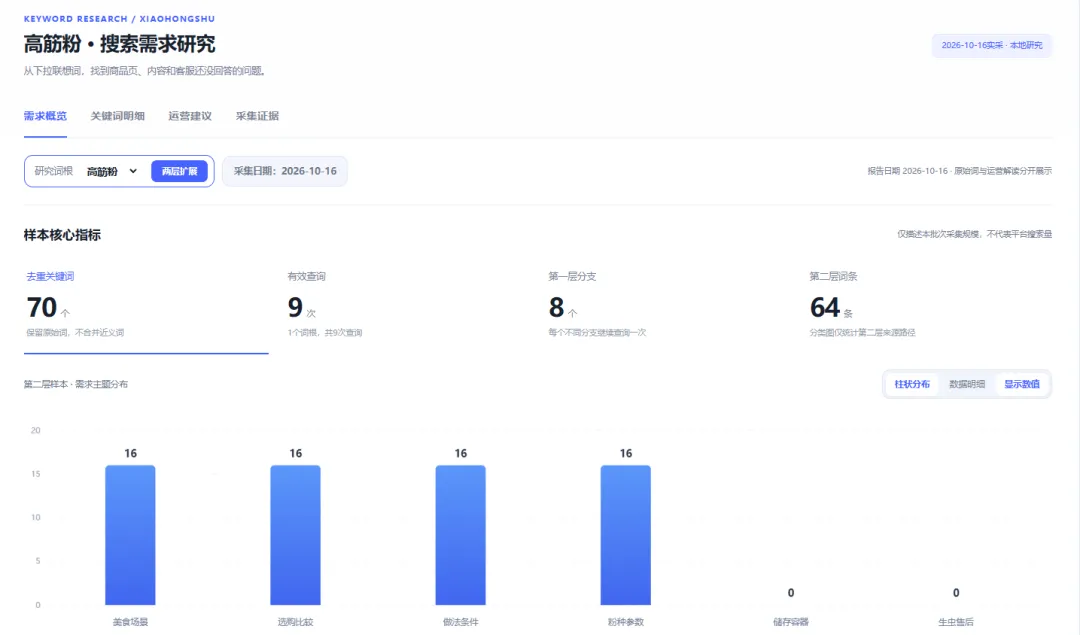
打开“需求概览”,先看这轮有多少去重词、查询记录和来源路径,再查看分支分布。想看原文,就切到“关键词明细”,输入一个词进行筛选。
有疑问的词,可以沿着来源查询找到截图,回头核对当时搜索框里到底显示了什么。
这一步我觉得有必要保留。AI 后面怎么归类、怎么解释,都应该能回到原始词,而不是只剩一段听起来很有道理的总结。
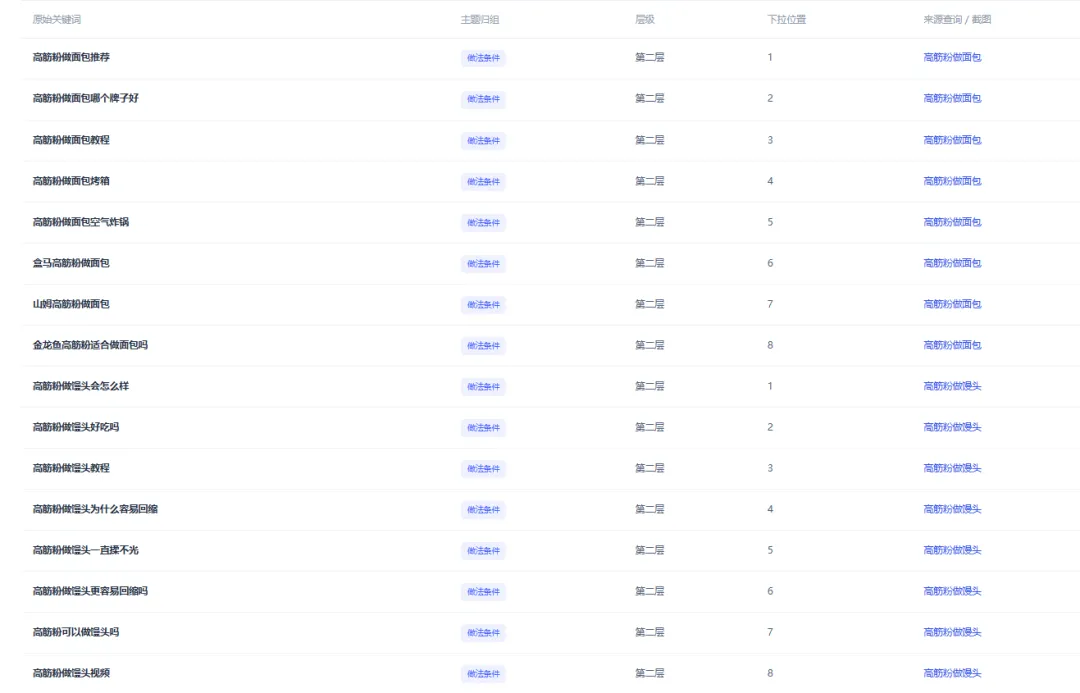
拿到报告后,我会先从词里挑问题,再结合自己的商品分析。
结合商品资料继续分析后,可以把关键词整理成商品页、内容选题和客服答疑的检查建议。新采的词如果还没分析,就先标为“待解读”。
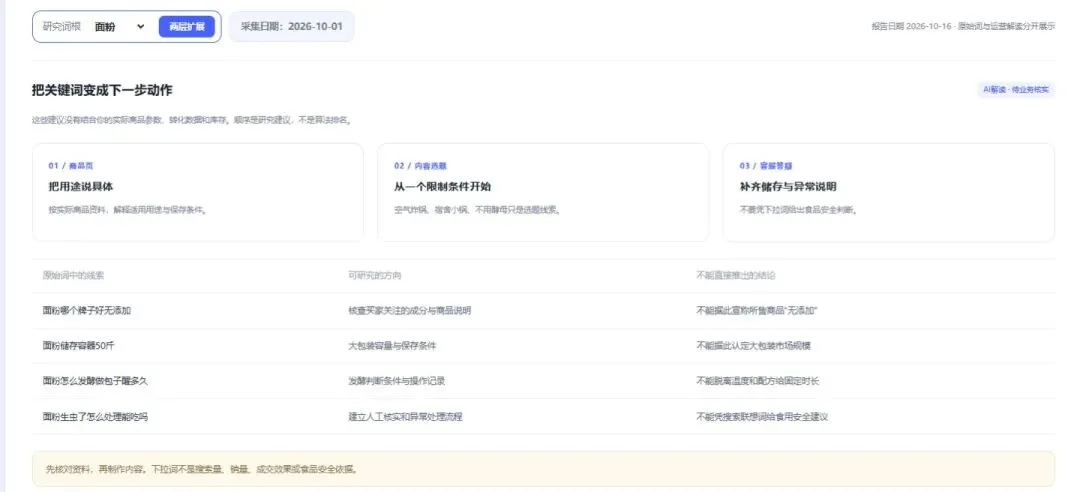
比如想检查详情页,可以把实际商品资料一起交给 AI:
●●●CODE
结合这次采集的关键词和我提供的商品资料,找出商品介绍还没回答清楚的问题。分别给出可补充的用途说明、值得验证的内容选题,以及客服需要准备的答疑。每条建议注明对应原词;资料不足的地方列出来,不要替我编造商品卖点。04继续采其他词,接着更新同一份报告
]如果后面还要研究其他商品词,我不希望每次都多出一个文件。
比如先采“高筋粉”,接着补“低筋粉”,再往下研究其他粉类。每次单独生成一个 HTML,过段时间自己也分不清该打开哪份。
所以现在默认沿用同一个研究项目。
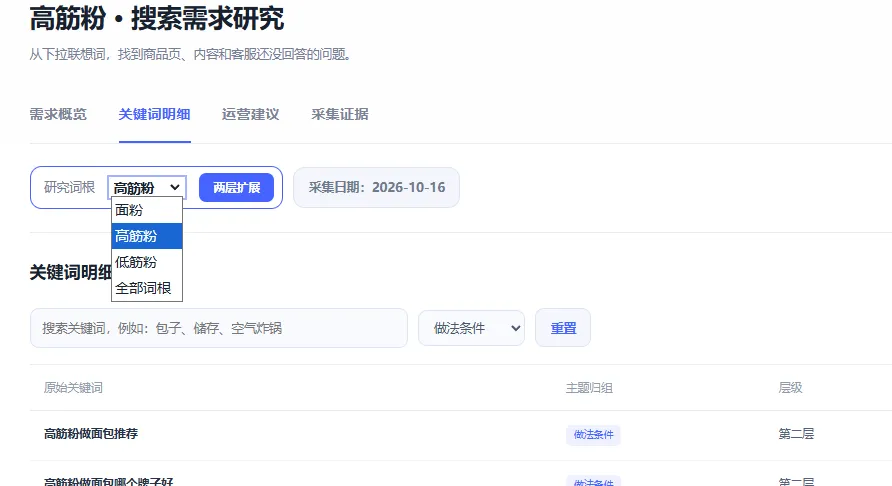
新增词根后,可以在“研究词根”里切换,也可以查看全部词根。对于同一个词根,后面重新采集会保留历史批次,不把之前的记录直接抹掉。
05第一次用,把项目地址交给 AI
]这是一套给 AI Agent 使用的技能,需要它能下载文件、执行本机命令,并操作浏览器。只有普通聊天能力的工具,不能直接替你完成采集。
项目地址:
小红书下拉关键词采集 Skill :https://github.com/dstmg/xiaohongshu-keyword-skill
可以把下面这段话交给你正在用的 AI:
●●●CODE
请读取这个项目的 README 和 SKILL.md,帮我安装小红书下拉关键词采集技能:https://github.com/dstmg/xiaohongshu-keyword-skill先检查当前工具是否有本机执行和浏览器操作能力。下载到独立目录,不覆盖已有同名技能;有冲突先告诉我。按项目说明检查 Python 和导出依赖。浏览器默认参考 BrowserSkill 官方安装指南,检查 CLI、扩展连接及 Agent 技能;需要我安装扩展或登录时叫我,不要假定已经配好。准备完成后先等我提供商品词,不要自行开始采集。需要修改系统设置时先问我。BrowserSkill 负责连接真实浏览器,这个 Skill 负责规定采哪些词、扩到哪一层,以及如何留证和整理报告。两者分工不同,下载关键词项目不会自动装好浏览器工具。
如果还不了解 BrowserSkill,可以先看我之前的介绍,再按项目 README 里的官方指南完成安装和连接。
06从一个熟悉的商品词开始跑
]第一次不建议铺太大,先选一个自己熟悉的商品词,把采集、留证和生成报告这条流程跑顺。
比如:
●●●CODE
帮我采集小红书“高筋粉”的下拉联想词,做两层扩展,保留截图并导出 Excel,同时生成 HTML 研究报告。把项目保存在我指定的文件夹。已有研究项目就追加并更新原 HTML;没有才新建。原始关键词和后续分析分开,没有依据的解读先留空或标待解读。遇到登录、验证码或频率限制先停下来叫我。结束后告诉我报告位置、采集完成情况和没有采完的部分。后面补词时,再告诉它:
●●●CODE
继续在刚才的研究项目里,补采“低筋粉”的两层下拉联想词。保留已有记录,更新同一个 HTML,不另建报告;完成后核对词根切换和截图链接。我更希望它帮我省掉的,是反复输入、抄词、整理来源这些动作。
拿到报告之后,先挑一个和自己商品有关的问题,检查详情页有没有回答;再挑一个能实际验证的条件,做成内容。
我是电商腿毛哥,既然看到这里了, 如果觉得有用,顺手点个赞吧~

发表评论
发表评论: