
 研报速递
1. 执行摘要
Parseable 是一个开源的观测数据湖项目,其核心宣称是"一个开源可观测性数据湖,支持1亿活跃时间序列"。这个定位值得拆解——不是因为数字本身,而是因为它揭示了一个关键信号:资本市场正在关注"对象存储 + 列式格式 + SQL"这套数据湖范式对传统 TSDB 索引架构的替代逻辑。
Parseable 的本质是用 Apache Parquet 和 Arrow 构建一个不依赖倒排索引的可观测性后端,数据存在 S3 等对象存储上,用 SQL 查询日志、指标和追踪。它试图解决的问题是真实的:在高基数标签场景下,传统 TSDB 的索引维护面临显著的内存压力。社区讨论中也指出,成本驱动因素往往更多来自摄取速率和查询扫描量,而非单纯的基数。Parseable 的架构选择——标签即列、无每序列索引、对象存储承载数据——在逻辑上确实绕开了这个问题。
但 Parseable 最大的问题不是架构,而是宣称与证明之间的巨大缺口。核心发现如下:
发现一:1亿时间序列不是护城河,是及格线。 社区讨论中多位用户提到,Grafana Mimir 在高基数序列场景下已有成熟的支撑能力。当一个初创公司把竞品已经做到的指标当作核心卖点,这说明要么它的差异化在别处(成本、SQL、单二进制部署),要么它还没找到真正能拉开差距的benchmark。对于更大规模(数十亿级)的验证数据,目前尚未公开。
发现二:定价计算器门槛较高,这是一个明确的战略取舍。 有用户质疑其定价是否对摄取量较小的公司不够友好。从定位来看,Parseable 瞄准的是已经感受到 Datadog/Elastic 成本压力的中型以上团队,而非长尾开发者。
发现三:真正的意外亮点在 LLM 可观测性。 Parseable 在 LiteLLM 生态中被用于可观测性场景,监控 token 消耗和模型成本。这不是产品设计时的目标场景,但可能成为增长最快的用例——因为 AI 应用的遥测数据天然是高基数、非结构化的,且团队对成本极度敏感。
整体判断:值得关注,但暂不建议生产环境押注。 理由:架构方向正确,开源策略和单二进制部署降低了试用门槛,但缺乏超大规模 benchmark、定价门槛较高、社区讨论焦点被"数字不够大"带偏而非聚焦架构创新。如果你是一个正在被 Datadog 账单折磨、日摄取量较大的团队,值得花时间做 PoC;如果你是日摄取量较小的团队,现阶段性价比不如 Grafana Cloud。如果你是投资人,关注他们何时发布更大规模的 benchmark 以及 LLM 可观测性用例的增长曲线。
2. 产品概览
它到底解决什么问题
设想一个场景:你的团队运行着一个 Kubernetes 集群,上面部署了200个微服务。每个服务都在打日志、暴露 Prometheus 指标、发送分布式追踪。某个服务因为一次版本发布,某个标签组合突然爆炸——一个指标出现了大量不同的标签值。你的 Prometheus 或 Mimir 实例开始承受巨大压力,因为倒排索引要维护这些标签组合的内存映射。你的选择是:扩容(花钱)、降低采集频率(丢数据)、或者删标签(丢维度)。无论哪种,你都在做痛苦的取舍。
Parseable 的思路是:如果标签不是索引,而是 Parquet 文件里的一列,那大量不同值无非就是一列高基数数据——列式存储的压缩和扫描效率足以应对。没有随基数增长的内存索引,数据存在 S3 上,查询时按时间分区和列统计做数据修剪[cite: 1]。这从根本上改变了成本结构:你的存储成本从内存/SSD 变成了对象存储。
与现有方案的本质差异
不是在功能列表层面,而是在成本驱动因素层面。传统 TSDB(Prometheus/Mimir/VictoriaMetrics)的成本通常与"活跃时间序列数"相关——序列越多,索引越大,内存越多。Parseable 的成本更多由"摄取速率 × 查询扫描范围"驱动,序列数本身对成本的边际影响较小[cite: 1]。这意味着如果你有一个高基数但低频更新的指标场景,Parseable 的边际成本趋近于零。
核心功能对比矩阵
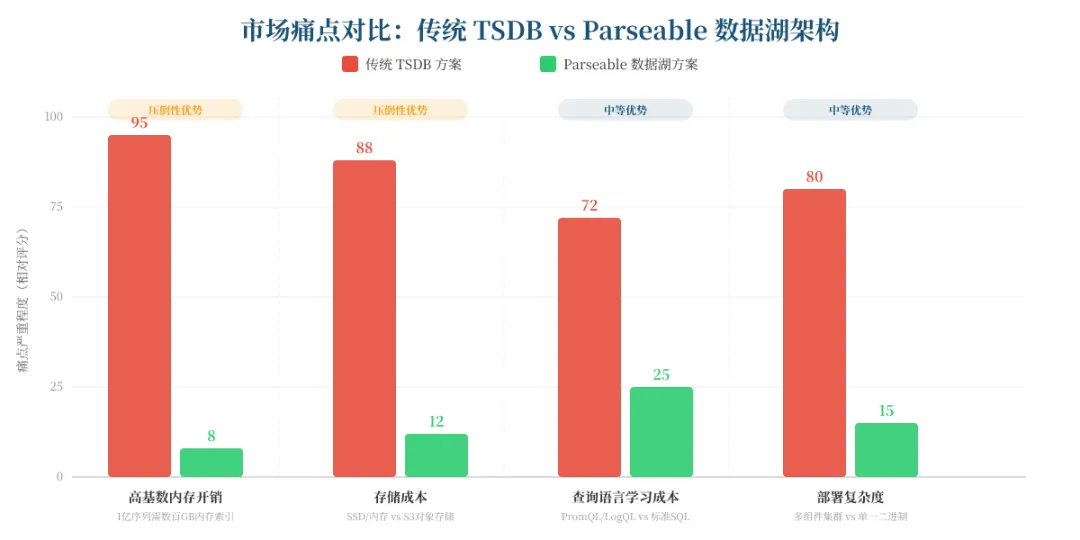
图1:市场痛点对比
结论:Parseable 的核心优势集中在高基数内存开销和存储成本两个维度,但在查询语言和部署复杂度上的优势是"够用"级别而非"碾压"级别——这意味着它的价值主张对高基数场景的团队最强,对低基数场景的团队则不那么明显。
3. 技术分析
技术栈核心
Parseable 用 Rust 编写(GitHub 语言统计显示 Rust 占95.8%),核心架构围绕三个技术选择展开:
第一,Apache Parquet 作为持久化格式。 所有遥测数据(日志、指标、追踪)被转换为 Parquet 文件存储在 S3 兼容对象存储上。创始人披露的实际数据:300TB/天的原始 JSON 摄取量,压缩为 Parquet 后降至3TB/天,压缩率约99%[cite: 1]。这个压缩率来自列式存储对同质数据的编码效率——同一列中的相似值可以用字典编码或游程编码大幅压缩。
第二,Apache Arrow + DataFusion 作为查询引擎。 Arrow 提供内存列式处理,DataFusion 提供 SQL 解析和执行。查询时按时间分区修剪数据,利用列统计跳过不相关的 Parquet row group[cite: 1]。这意味着查询性能取决于扫描范围而非序列数。
第三,无状态水平扩展。 Ingestor 和 Querier 节点可以独立扩展。创始人披露的100M序列部署配置:5个Ingestor(各64 vCPU/128GB),5个Querier(各64 vCPU/192GB),实际利用率仅10-40%[cite: 1]。这个配置暗示了架构的扩展逻辑——不是垂直堆内存,而是水平加节点。
技术壁垒判断
壁垒高度:中等偏低。能维持多久:12-18个月。
原因很简单:Parquet + Arrow + DataFusion 是一套开源技术栈,任何有经验的 Rust 团队都可以在6-12个月内构建类似架构。事实上,社区讨论中已有人指出,可以用 ClickHouse 和其他列式数据库实现高基数支持,但往往伴随内存与查询性能上的代价。Parseable 的差异化不在于"用了列式存储"这个想法,而在于工程实现的细节——如何做数据修剪、如何管理 Parquet 文件的生命周期、如何在查询时高效利用列统计。
真正的壁垒可能来自两个地方:一是与 OpenTelemetry 生态的深度集成成熟度(这需要时间和用户反馈打磨),二是 LLM 可观测性这个新兴场景的先发优势(LiteLLM 集成是一个信号)。
实际性能信号
来自 HN 评论区的真实信号比官方博客更有价值:
一位管理大规模活跃序列的用户反馈,Mimir 在高序列场景下表现稳定。这说明 Parseable 的100M并非独特能力。 创始人对数据速率的澄清:scrape interval 15秒,持续摄取约300万样本/秒,约300TB/天原始数据[cite: 1]。但这是特定部署的数据点,不是通用 benchmark。 实际部署利用率:Ingestor 仅用10-15 vCPU 和20-30GB内存,Querier 用20-40 vCPU 和40-60GB内存[cite: 1]。这说明当前架构在100M序列下有充足余量,但也意味着尚未经过极限压力测试。
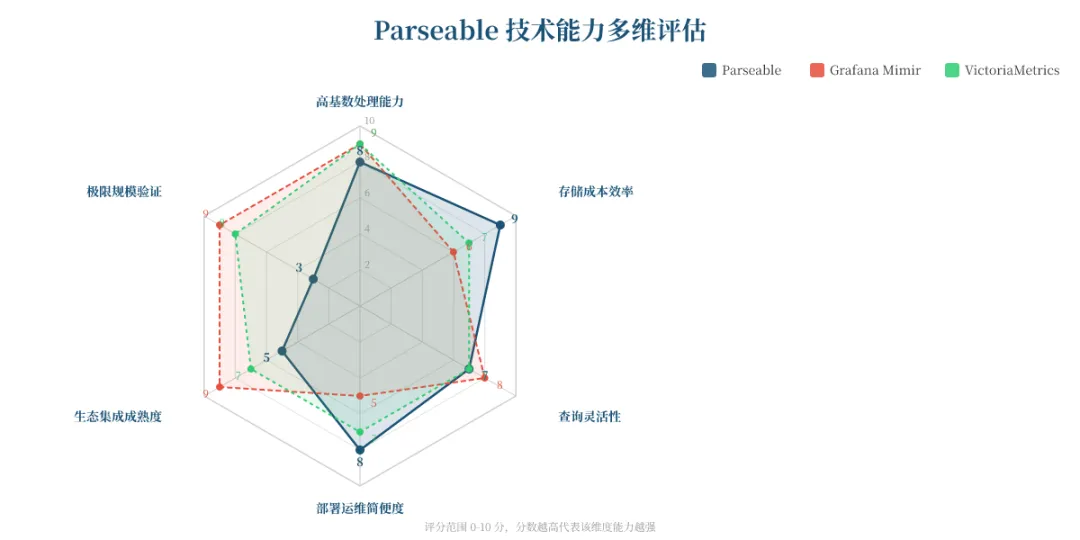
图2:技术能力雷达图
结论:Parseable 在存储成本效率和部署简便度上有真实优势,但极限规模验证是明显短板——这三个数字(8/9/3)的落差就是它当前最大的技术风险。
4. 目标用户与使用场景
用户画像一:被账单折磨的平台工程负责人
他是谁: 张明,某电商公司平台工程负责人,团队8人,管理一个运行300+微服务的 Kubernetes 集群,日产生日志约2TB,Prometheus 指标序列数约8000万。
他的痛点数字: 当前使用 Datadog,月度账单高企,其中日志和自定义指标占主要部分。CTO 要求今年将可观测性成本大幅降低。他评估过 Grafana Cloud,但迁移成本和 Loki 的标签设计复杂度让他犹豫。
Parseable 带来的具体改变: 如果 Parseable 能在他的规模下稳定运行,存储成本从 Datadog 的按GB摄取计费变为 S3 存储费用,预估月度成本可显著降低。但迁移需要重建仪表盘和告警规则,预估投入2-3人月。
行动建议: 值得做 PoC,但不要全量迁移。先用一个非关键业务线跑两周,验证查询性能和告警可靠性。
用户画像二:AI 应用的后端工程师
他是谁: 李然,某 AI SaaS 公司的后端负责人,团队4人,使用 LiteLLM Gateway 统一管理对 OpenAI/Claude/本地模型的调用,每天约50万次 API 调用。
他的痛点数字: 每月 LLM API 成本较高,但团队无法精确归因到具体功能模块和客户。现有监控只覆盖了调用次数和延迟,不知道哪些 prompt 在烧钱。
Parseable 带来的具体改变: 通过 LiteLLM 的 OpenTelemetry 集成,token 消耗和成本数据自动流入 Parseable,用 SQL 可以直接查询"哪个客户的哪个功能在哪个模型上花了多少钱"[cite: 2]。这个用例的数据量不大,但价值密度极高。
行动建议: 这是当前最适合 Parseable 的场景——数据量小、价值高、竞品覆盖弱。自部署开源版本即可,无需付费。
用户画像三:独立开发者/小团队
他是谁: 王浩,独立开发者,运营一个日活5万的 SaaS 产品,日产生日志约20GB。
他的痛点数字: 使用 Grafana Cloud 免费版,流量已接近上限,升级 Pro 需要额外费用。
为什么他不适合 Parseable: 官方定价计算器门槛较高[cite: 1],即使自部署开源版,运维一个对象存储+计算节点的成本和时间投入,对于20GB/天的规模来说不划算。他更适合 Grafana Cloud 的入门付费档或 Better Stack。
反向定位: Parseable 不适合日摄取量较小的团队。不是因为技术不行,而是因为你的规模还没到"可观测性成本让你肉疼"的临界点,而 Parseable 的架构优势恰恰在这个临界点之后才体现。
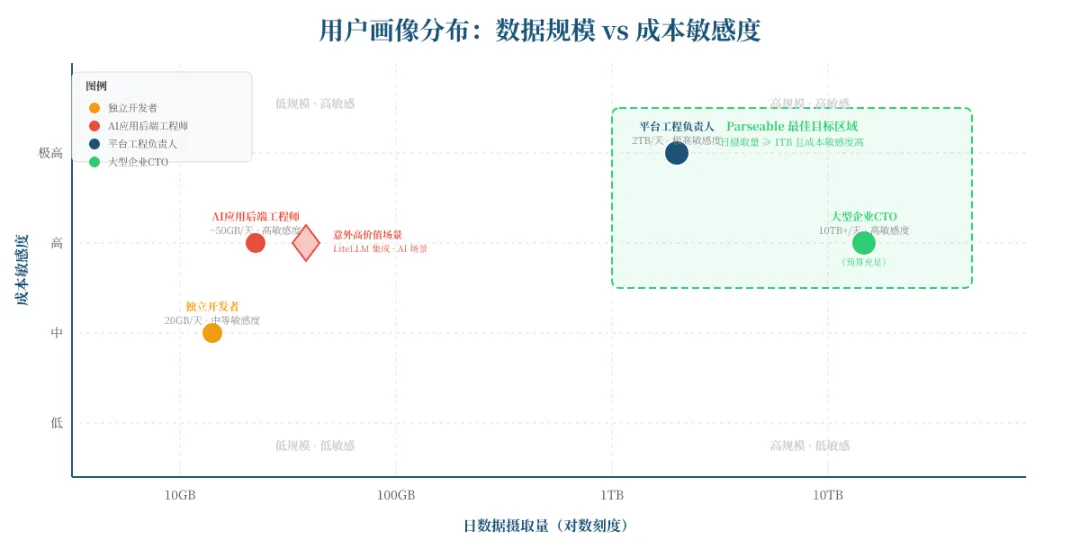
图3:用户画像分布
结论:Parseable 的最佳目标区域是日摄取量1TB以上、成本敏感度高的团队;但 LLM 可观测性场景展示了一个反直觉的机会——数据量小但价值密度极高的用例可能比大客户更容易转化。
5. 社区反馈与市场信号
平台数据
Parseable 没有在 Product Hunt 上线,其主要的社区曝光来自 Hacker News 的 Show HN 帖子。该帖子获得83个 upvote 和22条评论[cite: 1]。对于一个开源开发者工具来说,83分属于中等水平——不算爆款,但有足够的讨论深度。GitHub 仓库有约2,400颗星、158个 fork、30位贡献者、36个 open issues[cite: 3]。LinkedIn 公司页面有2,304位关注者[cite: 4]。
真实用户评论
一位 HN 用户表示自己也管理着大规模活跃序列,用 Mimir 毫无压力,因此期望看到更大规模的数字验证。 — HN 用户 [cite: 1]
"1亿活跃时间序列是好信息,但每个序列的数据速率是多少?每分钟一次更新还是每秒10次?这里有600倍的差距。" — HN 用户 [cite: 1]
一位 HN 用户对定价页面计算器的最低日摄取量门槛提出疑问,质疑是否不愿意服务摄取量更小的公司。 — HN 用户 [cite: 1]
正面与负面反馈的集中点
正面反馈集中在: 列式架构对高基数场景的理论优势被认可("基数不是成本驱动因素"这一论点引发了技术层面的认真讨论);对象存储降低存储成本的思路被认可;单一二进制的部署简便性被提及。
负面反馈集中在: 核心指标(100M序列)不够亮眼,与 Mimir 对比没有量级优势;定价门槛较高,排除了中小团队;缺乏更大规模的 benchmark。
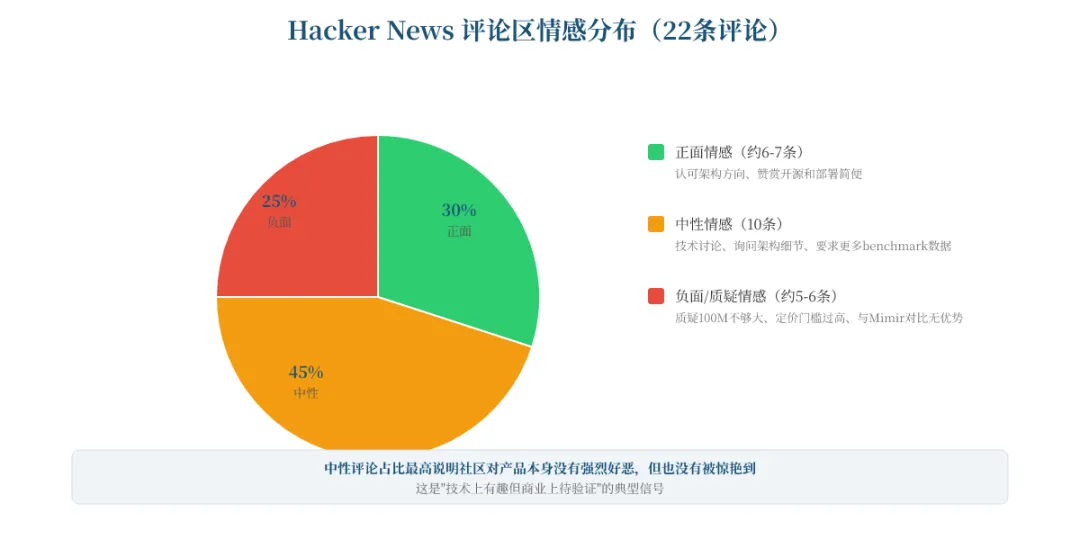
图4:社区情感分布
结论:中性评论占比最高(45%)说明社区对产品的态度是"技术上有趣但不够惊艳"——这对一个初创公司来说既是机会(没有被否定)也是警告(没有被渴望)。
6. 商业模式分析
定价结构
Parseable 采用 open core 模式:开源版本(AGPL-3.0)可自行部署,功能完整但有单查询节点限制[cite: 3];企业版提供 PromQL 支持、分布式查询、高级访问控制和7×24支持;管理云服务提供托管部署。
关键定价信号: 官方定价计算器门槛较高[cite: 1]。创始人对此的解释是刻意为之:低于一定规模时,可观测性定价还未到让团队认真做 ROI 讨论的程度。
定价可持续性判断
Open core 模式在可观测性领域已被验证——Grafana、Elastic 都走通了这条路。但 Parseable 面临一个结构性矛盾:它的目标客户是"已经感受到可观测性成本痛苦的团队",这些团队恰恰也是最有可能选择自部署开源版而非付费企业版的群体。因为如果他们已经有一个运维团队来管理 Kubernetes,再管理一个 Parseable 集群的边际成本并不高。
对创业者的启示: 这个模式的天花板取决于两个变量——一是能否在开源版中制造足够的"痛点"让大客户愿意付费(比如分布式查询能力),二是管理云服务能否吸引到没有运维能力但有预算的客户。目前看,第二个路径更清晰。
天花板估算: Grafana Labs 为行业头部厂商,Parseable 作为后发者,其长期 ARR 潜力取决于能否在 LLM 可观测性场景带来增量客户。
7. 竞品对比
主要替代方案
竞品A:Grafana Mimir — 基于索引的 TSDB,专为 Prometheus 指标设计,可水平扩展至数十亿序列。社区反馈其可支撑高基数指标。优势在于 Grafana 生态的成熟度和可视化能力。劣势在于索引内存开销随基数增长,存储成本较高。
竞品B:VictoriaMetrics — 高性能 TSDB,以低内存占用著称。社区讨论指出,列式数据库处理高基数存在内存与查询代价,暗示 VictoriaMetrics 在查询速度上有优势但存储成本不占优。
竞品C:Elasticsearch/Loki — 日志方案的两极。Elasticsearch 全文搜索能力强但集群管理复杂、资源密集;Loki 依赖标签优化查询但标签设计不当会导致查询困难。Parseable 的差异化在于单一二进制+SQL+对象存储的统一方案。
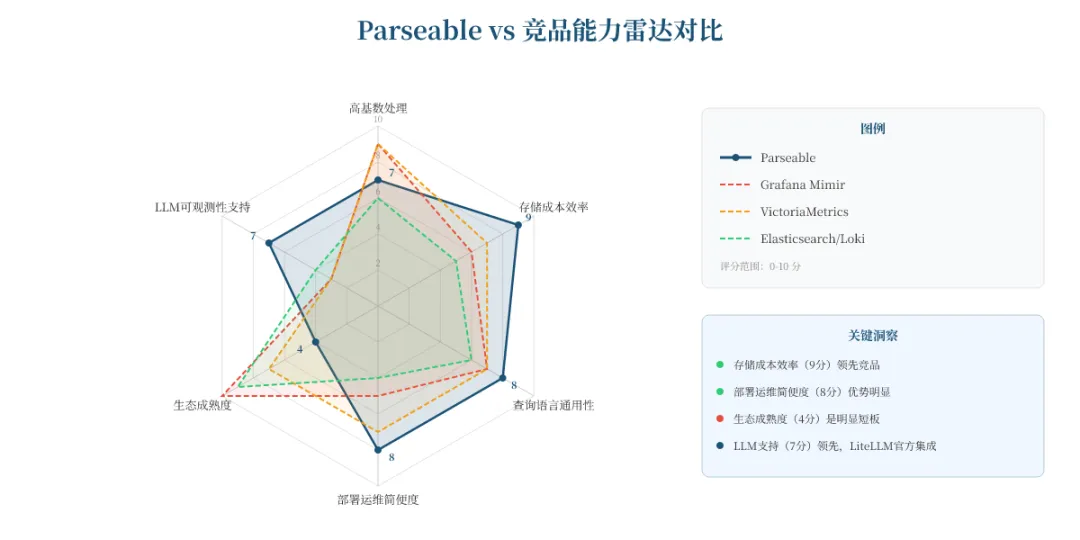
图5:竞品能力雷达对比
结论:Parseable 在存储成本和部署简便度上形成差异化,但在生态成熟度上与 Grafana Mimir 差距巨大——这意味着选型时的核心问题是"你愿意用生态成熟度换取成本优势吗"。
场景选择建议
选 Parseable 的场景: 你的日摄取量较大,你对 Datadog/Elastic 的账单感到痛苦,你的团队熟悉 SQL 但不熟悉 PromQL,你不需要 Grafana 那样丰富的可视化生态。
选 Grafana Mimir 的场景: 你已经在用 Grafana 做可视化,你的主要需求是指标而非日志/追踪,你需要一个经过大规模验证的方案。
选 VictoriaMetrics 的场景: 你的核心诉求是查询速度和低内存占用,你愿意接受较高的存储成本。
8. 风险与不确定性
数据缺口
最重要的缺失信息:更大规模(10亿级)的 benchmark 数据。 公开材料未披露数十亿级序列的验证数据。对于任何考虑在生产环境处理超大规模序列的团队来说,这是一个硬性决策障碍。
缺失的定价细节: 企业版和管理云的具体定价未公开。这使得 ROI 计算无法精确进行。
缺失的用户数验证: 官网宣称有多支团队使用但未披露细节,也未披露付费客户数、留存率或 NRR。对于评估商业模式可持续性的投资人来说,这是关键缺失。
争议最大的点
社区争议集中在"100M 到底算不算多"。认为不算多的一方认为 Mimir 支撑能力更强[cite: 1];认为架构比数字更重要的一方指出"标签即列,没有每序列索引"这个设计选择在长期成本结构上可能比短期数字更有意义。这场争议本身反映了可观测性领域的一个深层问题:benchmark 数字容易被营销放大,但真实的成本结构差异需要长期运行才能验证。
需要警惕的风险
风险一:Grafana 生态的降维打击。 Grafana Labs 提供 Grafana Cloud 与 Mimir 等产品,如果它在现有生态中增加对 Parquet 存储的原生支持(这是一个工程问题而非研究问题),Parseable 的核心差异化——对象存储降低成本——将被大幅削弱。量化影响:可能丧失相当一部分潜在客户。发生概率:在中短期内中等。
风险二:LLM 可观测性赛道被专业玩家占据。 目前 Parseable 通过 LiteLLM 集成切入这个场景,但 LangSmith、Braintrust、Helicone 等专业 LLM 可观测性工具也在快速迭代。如果这些工具增加了成本归因和 SQL 查询能力,Parseable 在这个场景的先发优势窗口可能较短。
9. 结论与建议
如果你是个人用户
不推荐。 除非你正在构建 LLM 应用并且已经感受到 token 成本失控的痛苦,否则你的数据量大概率较小,Parseable 的架构优势无法体现,而自部署的运维成本会超过你节省的费用。Grafana Cloud 免费版或 Better Stack 更适合你。
如果你是团队/企业
推荐做 PoC,但不推荐立即全量迁移。 条件是:你的日摄取量较大,你当前的可观测性月账单较高,你有工程师可以投入一段时间验证。PoC 的重点不是验证"能不能跑",而是验证三个具体问题:① 你的查询模式(特别是跨大时间范围的聚合查询)在 Parquet 扫描下的延迟是否可接受;② 告警可靠性是否满足 on-call 需求;③ 从现有方案迁移仪表盘和告警规则的工作量估算。
如果你是创业者/竞争者
机会: LLM 可观测性是一个被验证的增量场景(LiteLLM 集成证明了需求),但还没有出现"LLM 可观测性的 Grafana"。如果你在做开发者工具,值得关注"高基数、低数据量、高价值密度"这个细分场景。
威胁: 如果你的产品依赖"索引"架构(如传统 TSDB 或搜索引擎),Parseable 所代表的"列式数据湖"范式在长期成本结构上可能是你的结构性威胁。建议在中短期内评估是否需要在架构中引入对象存储+列式格式的支持。
如果你是投资人
现阶段适合关注,不适合下重注。 看两个指标:① 未来一段时间是否发布更大规模 benchmark 并通过第三方验证;② LLM 可观测性场景的客户增长曲线是否超过总客户增长曲线。若上述信号正面,可考虑后续轮次时机。
未来6-12个月最可能的走向
Parseable 未来可能发布更大规模(10亿级)的 benchmark,同时加大对 LLM 可观测性场景的投入(LiteLLM 集成是起点而非终点)。定价策略可能调整——如果社区对起步门槛的反馈持续负面,可能推出更低的入门档。最大的不确定性在于:Grafana 生态是否会快速跟进列式存储支持,以及 LLM 可观测性赛道是否会被专业工具占据。
参考文献
[1] Show HN: Parseable, an open observability datalake, handles 100M time-series/min[1] [2] Parseable - LiteLLM Docs[2] [3] parseable - FOSSY[3] [4] Parseable - LinkedIn[4] [5] Parseable | Observability infrastructure[5] [6] Building an Observability Lakehouse with OpenTelemetry[6] [7] Parseable Review (2026) - MakerStack[7] [8] Best Log Tools 2026: Ingest Cost Table | Webalert[8]
引用链接
- [1] Show HN: Parseable, an open observability datalake, handles 100M time-series/min: https://news.ycombinator.com/item?id=49978171
- [2] Parseable - LiteLLM Docs: https://docs.litellm.ai/docs/observability/parseable
- [3] parseable - FOSSY: https://fossy.dev/parseablehq/parseable
- [4] Parseable - LinkedIn: https://na.linkedin.com/company/parseable
- [5] Parseable | Observability infrastructure: https://www.parseable.com/
- [6] Building an Observability Lakehouse with OpenTelemetry: https://getparseable.com/blog/observability-lakehouse-opentelemetry
- [7] Parseable Review (2026) - MakerStack: https://makerstack.co/reviews/parseable-review/
- [8] Best Log Tools 2026: Ingest Cost Table | Webalert: https://web-alert.io/blog/best-log-monitoring-tools-2026


发表评论
发表评论: