
 研报速递
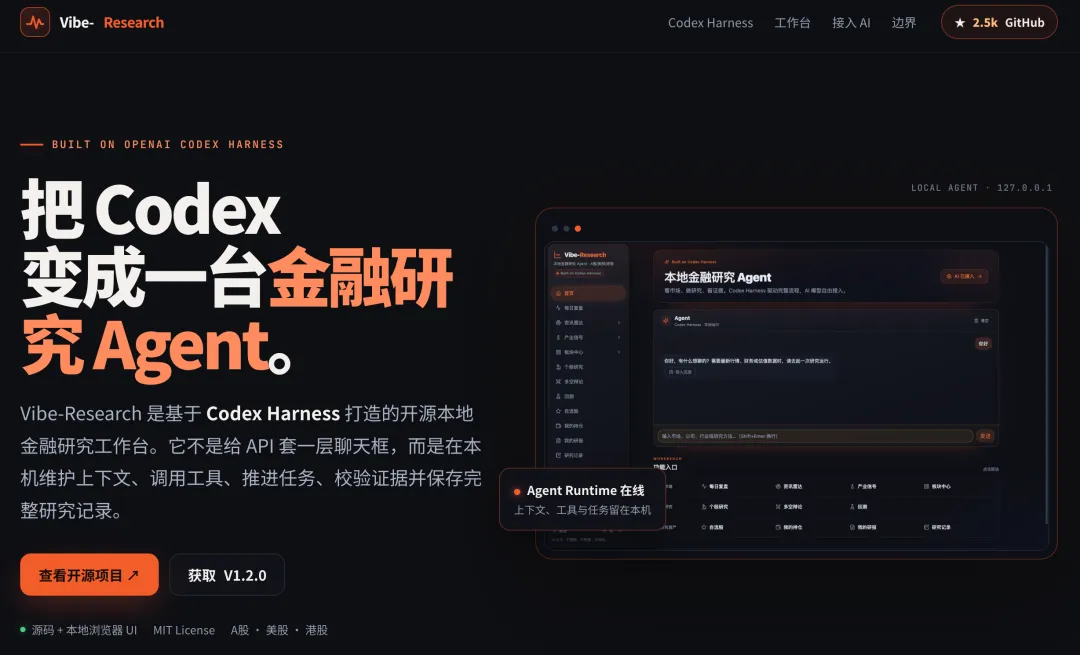
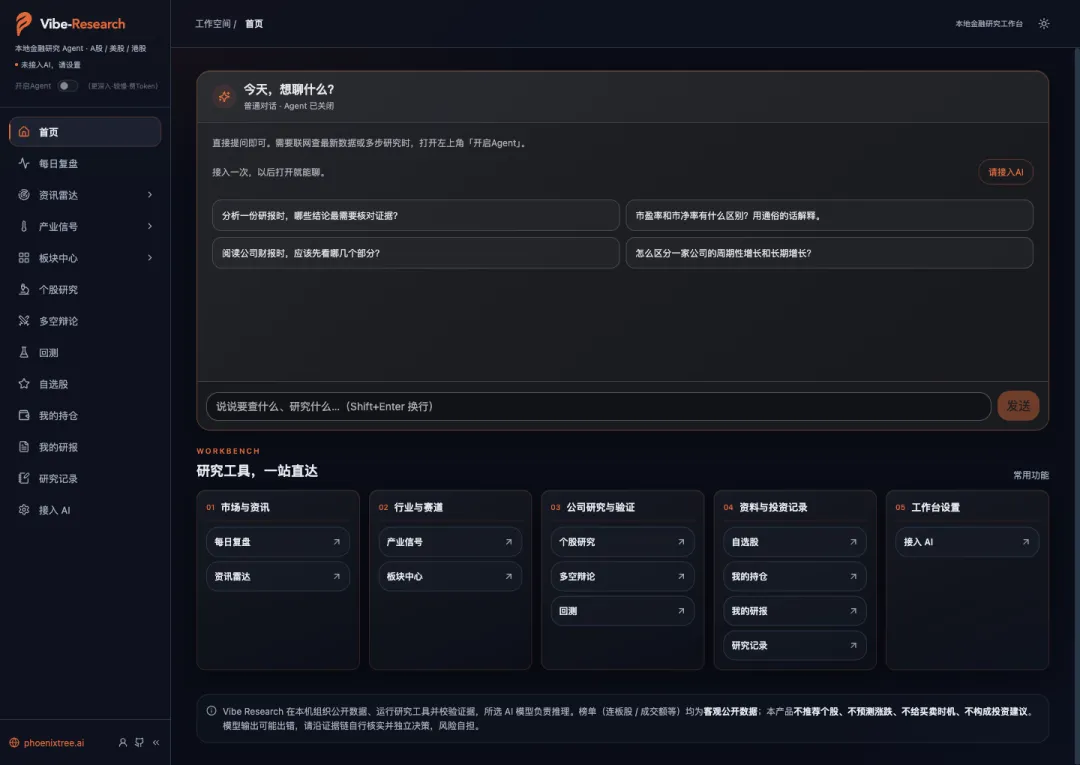
Vibe-Research 是一个开源的投研工作台,装在自己电脑上,把 A 股、美股、港股的数据管道打通,做成 13 个栏目,再把你自己已有的 AI 接进来,在这些数据上做研究。
它跟别的东西的区别就一句话:不替你选股票。 取数算数它干,判断留给你。
官方给自己的定位是「接入自己的 AI,日常直接聊,需要研究时开启 Agent」。底子用的是开源的 Codex Harness,一套让 AI 能调用工具、能跑长任务的运行框架,作者没有自己造这套轮子。
要解决什么痛点
个人投资者想认真研究一家公司,实际流程是这样的:
想知道一家公司怎么样→ 开东财看行情,开巨潮找公告,开同花顺看一致预期→ 财务三表去新浪,估值历史去 baostock,研报去东财→ 十个标签页,数据格式各不相同→ 想认真点,把这些抄进 Excel,第二周数据过期,白干→ 全程没有一个地方能沉淀下结论Vibe-Research 的思路是:把取数这一步标准化,把结论这一步做成本地文件。
它解决的不是「帮你判断」,是「你想判断的时候,数据已经齐了,而且上次的结论还在」。
背景:为什么是现在
三个条件刚好凑齐:
1. 中文金融数据接口成熟——腾讯行情、东财、新浪、巨潮、baostock 这些公开接口覆盖基础面已经够用,而且大多不用鉴权 2. Codex Harness 开源——让 AI 能调工具、能跑长任务的框架不用自己写 3. AI 订阅普及——用户手上已经有 Codex 或 Claude 订阅,接上就能用,项目不用自己养模型服务
作者把这些拼起来,力气花在编排和约束上,而不是重造轮子。
要点:13 个栏目的实际内容
官方说明 把 13 个一级栏目分成四组:
| 资讯雷达 | ||
| 个股研究 | ||
这里要校正一句常见说法:不少人把「资讯雷达」理解成 AI 自动整理重点。项目主页的原话是「集中查看新闻、公司公告与事件线索,找到需要进一步核对的信息」——它是把散在各处的资讯聚到一起,重点还得你自己找,官方没有承诺自动提炼。
「产业信号」这个栏目在散户工具里少见,盯的是 GPU 租金、招聘数据这类另类数据,一般看盘软件不做。
概念:数据层的真实样子
这是整个项目最有信息量的部分,也是作者做得最扎实的地方。
项目主页「数据与市场」一节给了官方分类,共 14 类:
行情、K 线、财务、一致预期、公告、研报、资金、筹码、期权、SEC/FINRA/CBOE、新闻、宏观、产业温度计、招聘、管制与数据日历
117 个端点,30 层,合规分级
datasources/CATALOG.md 是自动生成的端点目录(从 registry.json 生成,勿手改)。当前规模:
• 117 个数据端点,30 层 • 覆盖 CN / US / HK • 每个端点标注:市场、源、合规等级、标的类型、所属研究阶段、鉴权要求
「端点」在这里就是「一个能取到某项数据的入口」。
合规分级是这个项目少见的亮点,级别定义原文:
cn-public | |
S | |
B | |
C | |
rss-public |
也就是说,每个数据来源能不能商用,表里就标着。国内同类项目里这么做的极少。想拿它做商业用途的人,这张表比什么都重要。
底层用的是哪些源(不是 akshare/tushare)
实际调用的数据源,从 CATALOG 里摘:
tencent | |
baostock | |
sina | |
eastmoney | |
ths | |
cninfo | |
szse | |
mootdx | |
iwencai | |
swsresearch | |
baidu |
注意不是 akshare 或 tushare(这两个是国内最常用的开源金融数据包)。作者是自己按源逐个对接的。好处是可控、不带第三方库的坑;代价是维护全落在他一个人身上。
几个设计细节值得记
• 同一项数据它会换个源再取一遍对账。 em_stock_info(东财)的备注就写着「与 fetch_profile(腾讯 + baostock)交叉核对用」,财务也一样,新浪摘要与新浪三表互相验证。• 申万行业分类带「变迁史」,注释明确写「消除前视偏差」。前视偏差的意思是,回测时用了当时还不知道的信息——比如拿一家公司今天的行业归属去算它三年前的数据,结果会虚高。这个坑自建回测的人几乎都踩过。 • 行情端点带僵尸报价判定,避免拿到停牌股的假报价。 • 问财那两个端点要 key: iwencai_search与iwencai_query需要环境变量IWENCAI_API_KEY,属于少数要鉴权的端点。
使用方法 / 步骤
从源码跑
环境要求:
Node 那一条有个坑,项目主页专门写了验证命令:
node -p process.features.typescript应输出strip或transform
部分 Linux 发行版仓库打包的 Node 不满足这个条件,会报 ERR_UNKNOWN_FILE_EXTENSION。装之前先跑一下这句,能省半小时。
步骤:
# 1. 克隆git clone <repo>cd Vibe-Research# 2. 初始化(Windows 用 scripts\setup-windows.cmd)./scripts/setup# 3. 启动(Windows 用 scripts\start.cmd)./scripts/start脚本会创建 .venv、装依赖、初始化私有目录,然后启动本地 API 加界面,浏览器打开:
http://127.0.0.1:5930接入 AI
三条路,任选其一:
selfhosted |
内置 provider 模板:OpenAI、DeepSeek、Qwen、GLM、Kimi、MiMo。
注意:产品不附赠任何订阅或额度。Key 存浏览器 localStorage,或后端走环境变量。Codex Harness 的 API 通道只支持 Responses API。
Agent 默认关闭,需要时手动开。普通对话不调用工具,开启 Agent 后对话才能用联网和研究工具。
功能要点
个股研究(六阶段):画像 → 财务 → 盈利预期 → 估值 → 风险 → 报告。研究过程中可以看进度、请求中止,刷新页面后继续看状态。项目主页特别说明:「发出中止请求不代表已经停止,页面会区分请求与确认状态」——这种细节说明作者对 AI 的异步行为做过认真处理。
六阶段跑完会落六个文件(项目主页「研究运行产物」一节实证):
report.md | |
evidence.json | |
calculations.json | |
conflicts.json | 跨来源冲突,不静默取舍 |
manifest.json | |
viewer.html |
conflicts.json 这条值得单独说:不同数据源对不上时,它把冲突原样记下来,不替你挑一个。这跟「AI 直接给你一个答案」是相反的取向。
项目主页也写明了耗时不承诺:「完整研究耗时取决于取数范围、模型响应与校验重试,可能需要数十分钟或更久」。别指望点一下就出报告。
三层约束体系,这是架构上最值得看的部分:
关键设计:计算与判断分离。calc/ 是 Python 确定性计算库,backtest/ 是确定性回测引擎。指标计算不走 AI,是纯代码算的,AI 只负责调度和解释。
这个设计对投研工具很关键。数字算错和解释得不好,是两个严重程度完全不同的问题,前者会让你直接亏钱。
回测:用自然语言说明规则,结合历史数据检查。
我的研报:导入 PDF、DOCX 检索,并核对原文。扫描版 PDF 要先 OCR,文本型会保留页码引用。
持仓与自选股(v1.2.0 新增):支持截图或表格转写成草稿,人工核对后确认保存。
真正解决的问题
把「取数」这个重复劳动消灭掉,并且让研究结论留得下来。
三层价值:
1. 一个入口对比十个标签页——117 个端点统一在册,不用记哪个数据去哪找 2. 结论落在本地文件里——研究记录、研报、持仓都在本机,不是云端账号,数据是你的 3. 计算与 AI 分离——数字由确定性代码算,AI 只管解释,避开了大模型算错数的老问题
第三点是它跟「直接问 ChatGPT 一只股票怎么样」的根本差别。
跟同类的区别
最值得说的两条差异:
① 跟自己写脚本比,它省的是端点对接和维护的功夫。117 个端点、30 层,还带合规分级和交叉核对,这部分工作量是真实的,自己写要按月算。
② 跟商业 App 比,差别在数据归属和可改造性。数据落在你自己机器上,而且 MIT 许可,界面想改什么样改什么样。代价是商业 App 装完就用,它得先配环境。
跟作者自己的其他项目比:TradingAgents-astock(3347 star)是 A 股多 Agent 投研框架,7 位分析师辩论决策;vibe-astock(384 star)是短线复盘看板。Vibe-Research 是这三个里最像「成品」的一个——有界面、有 13 个栏目、面向不想写代码的人。

发表评论
发表评论: