
 研报速递
AI科普馆部分垂类内容转移至👆
【长三角人工智能联盟】公众号,快点进去瞧瞧!
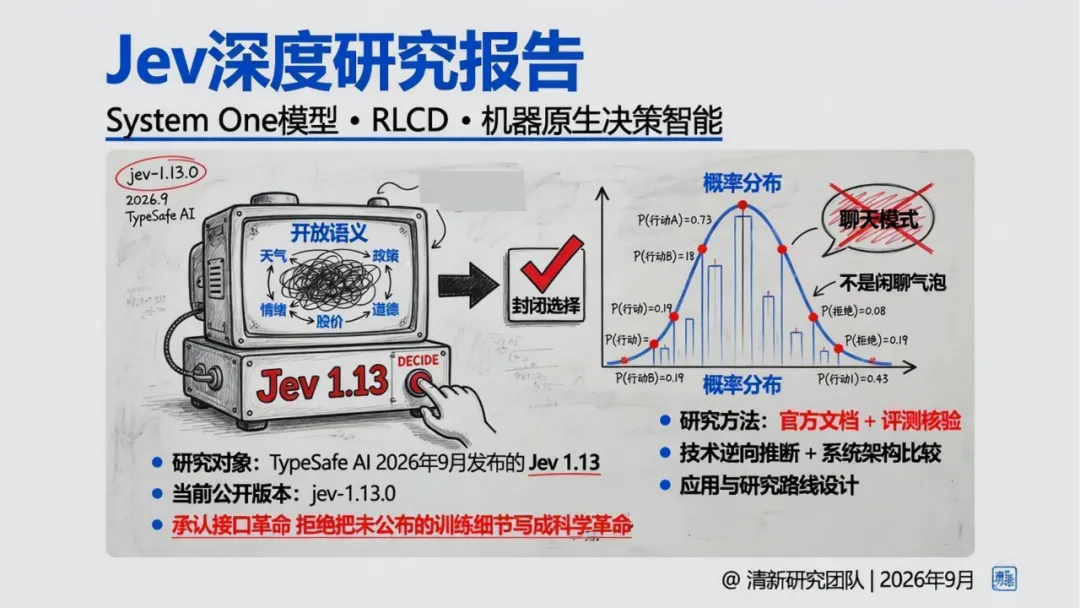
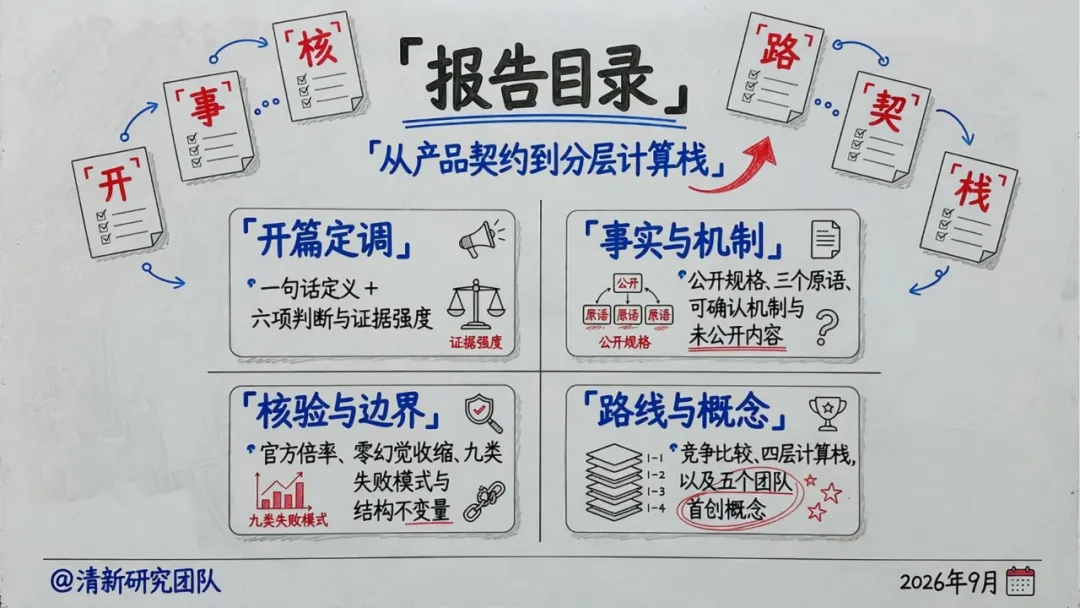
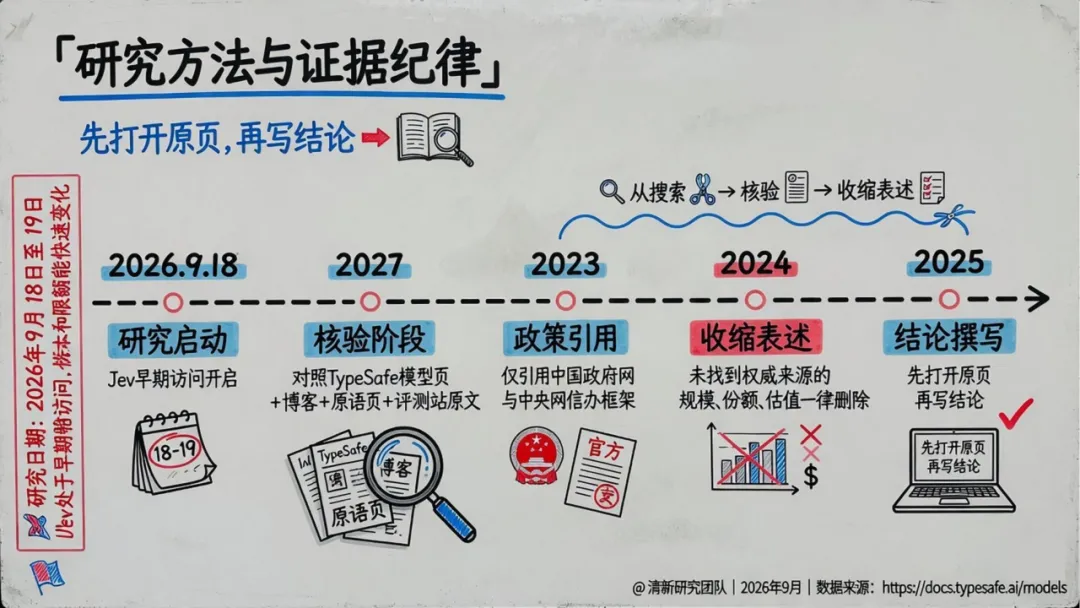
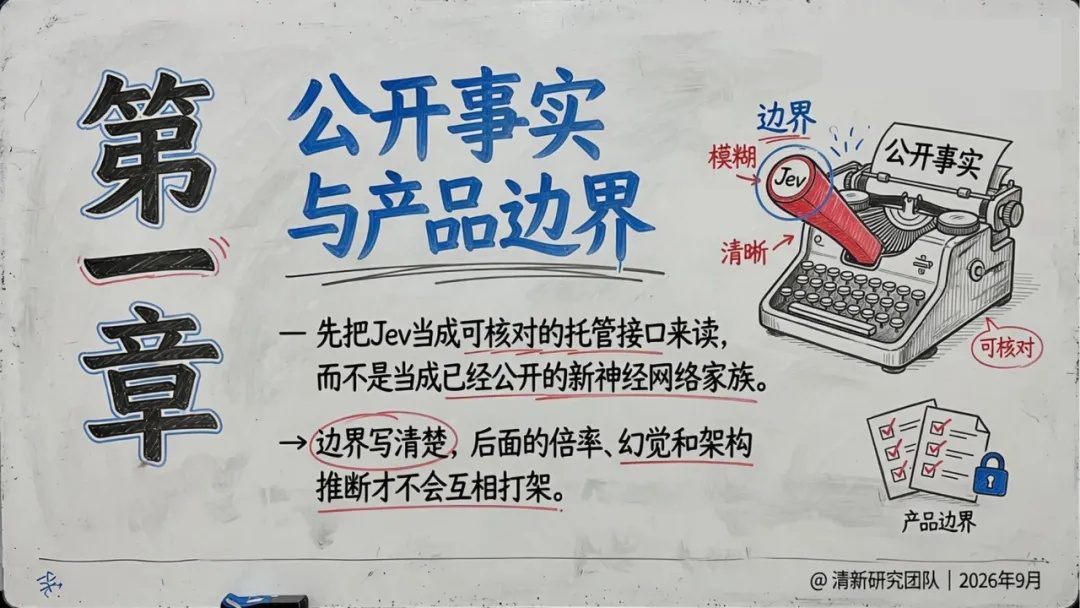
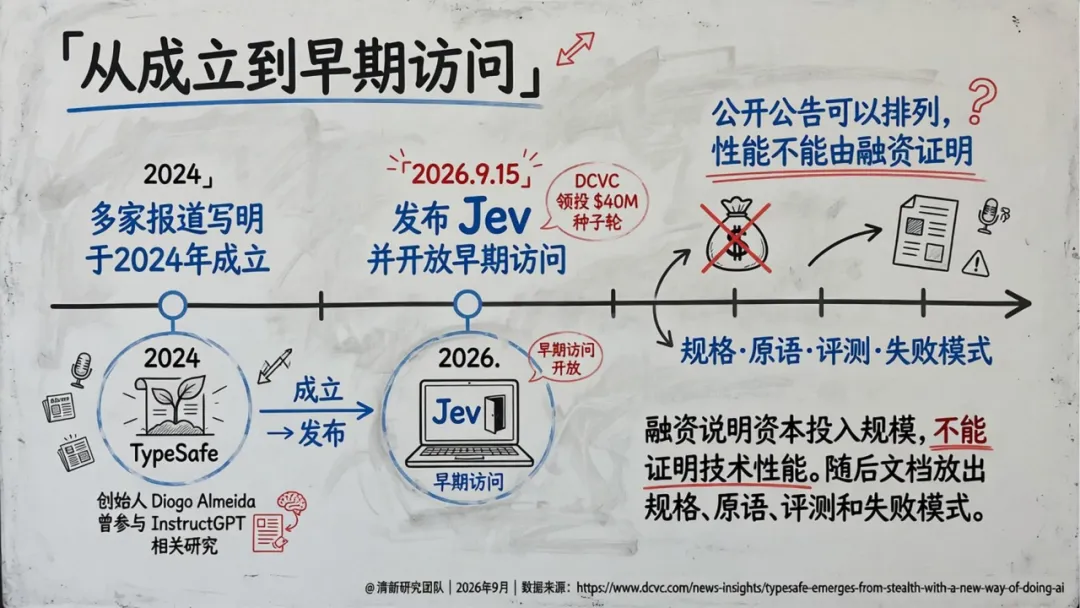
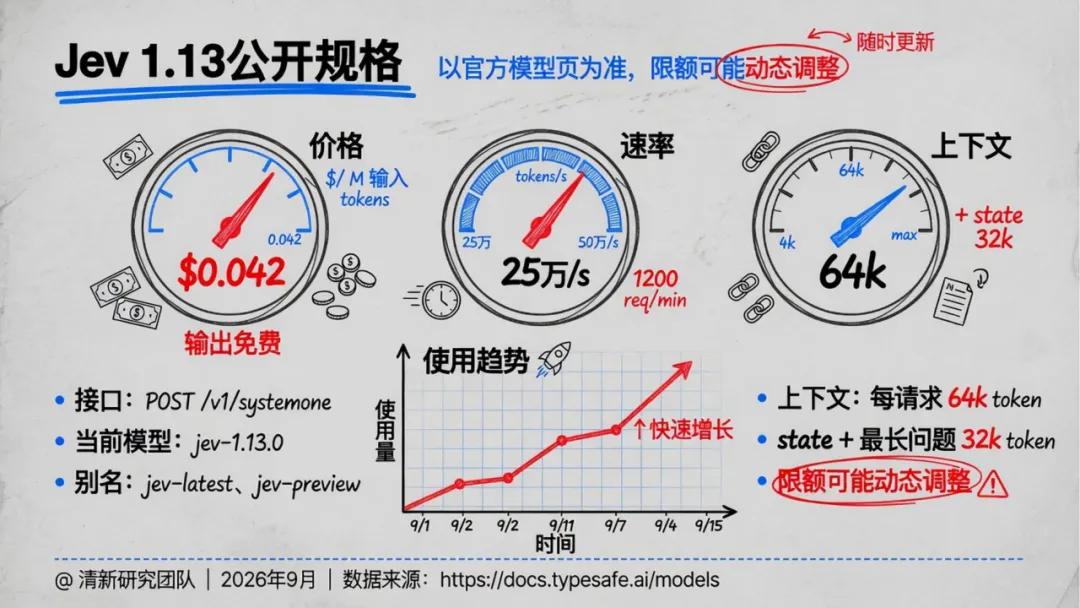
2026年9月,TypeSafe AI发布了旗舰模型Jev 1.13。伴随这份54页的深度研究报告,清新研究团队给出了一个极具分寸感的结论:“承认接口革命,拒绝把未公布的训练细节写成科学革命。”这篇解读将带你穿透营销词汇,看懂Jev在System One模型和机器原生决策智能上的真实突破与边界。
一、 核心定位:不聊天的“快思考”决策算子
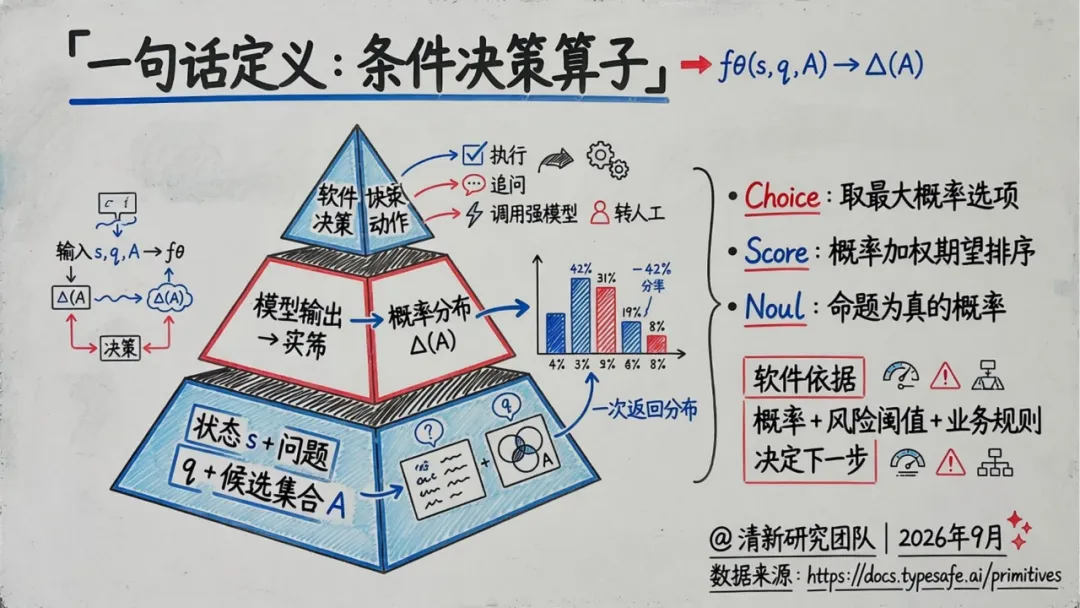
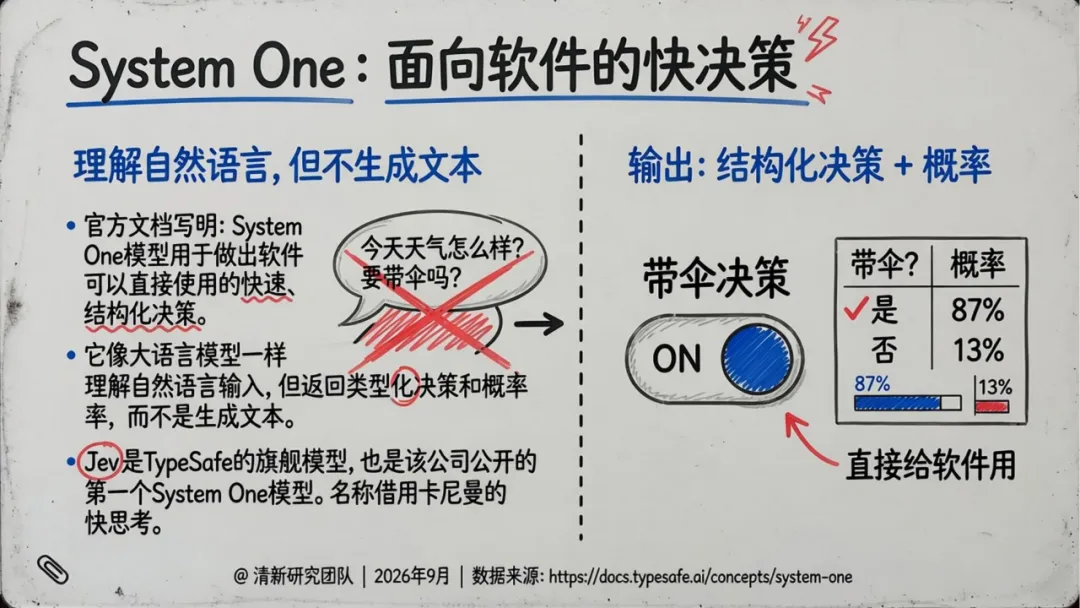
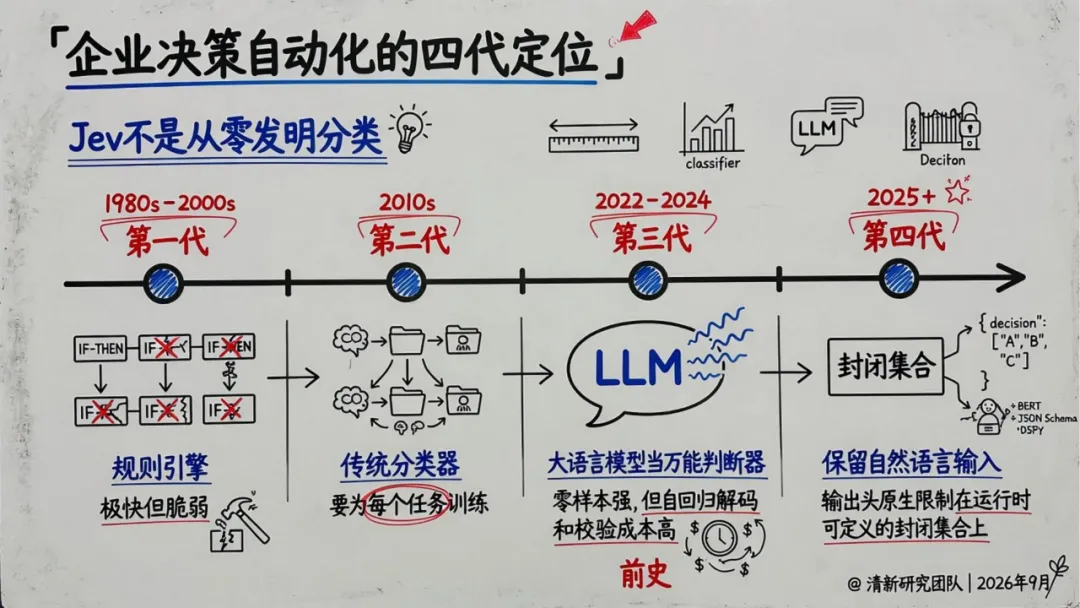
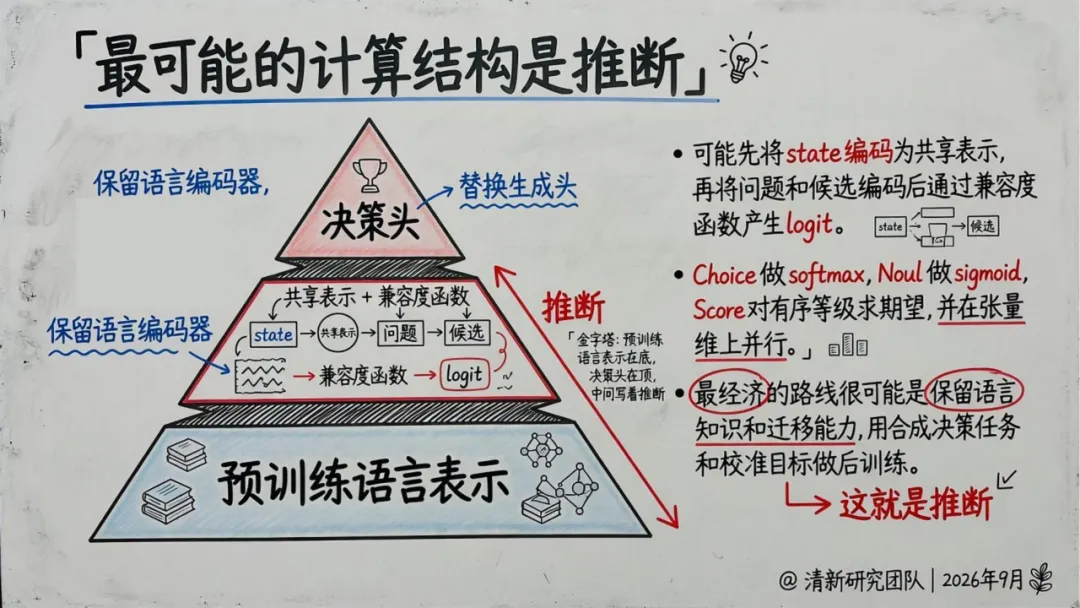
在ChatGPT等大语言模型(LLM)竞相追求“像人一样聊天”时,Jev选择了一条截然不同的路。报告用一句话定义了它的本质:条件决策算子 fθ(s,q,A)→Δ(A)。即输入状态(state)、问题(q)和候选集合(A),直接返回一个概率分布(Δ(A))。
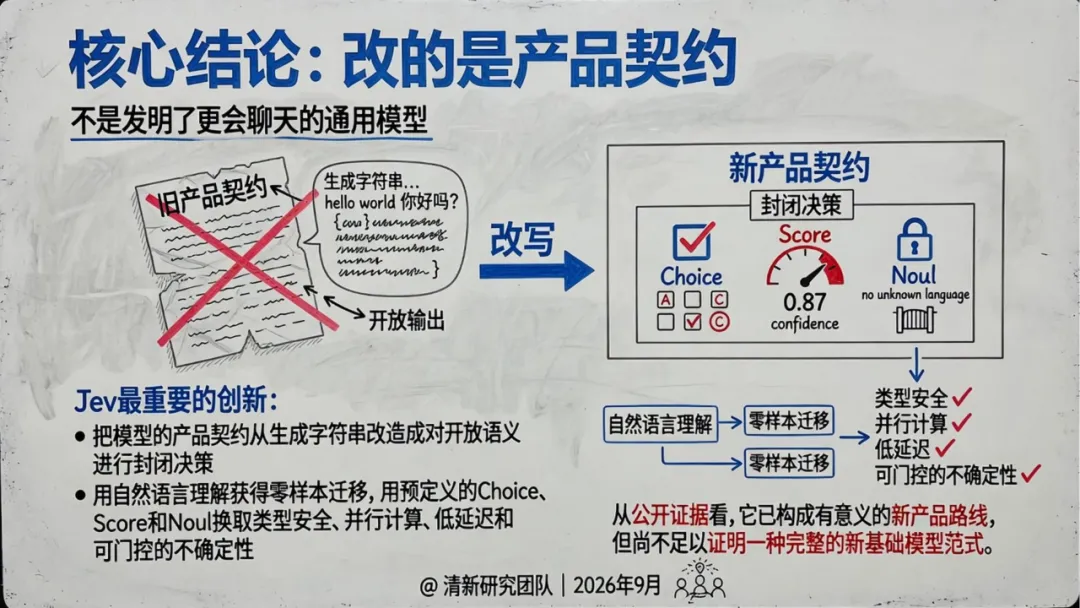
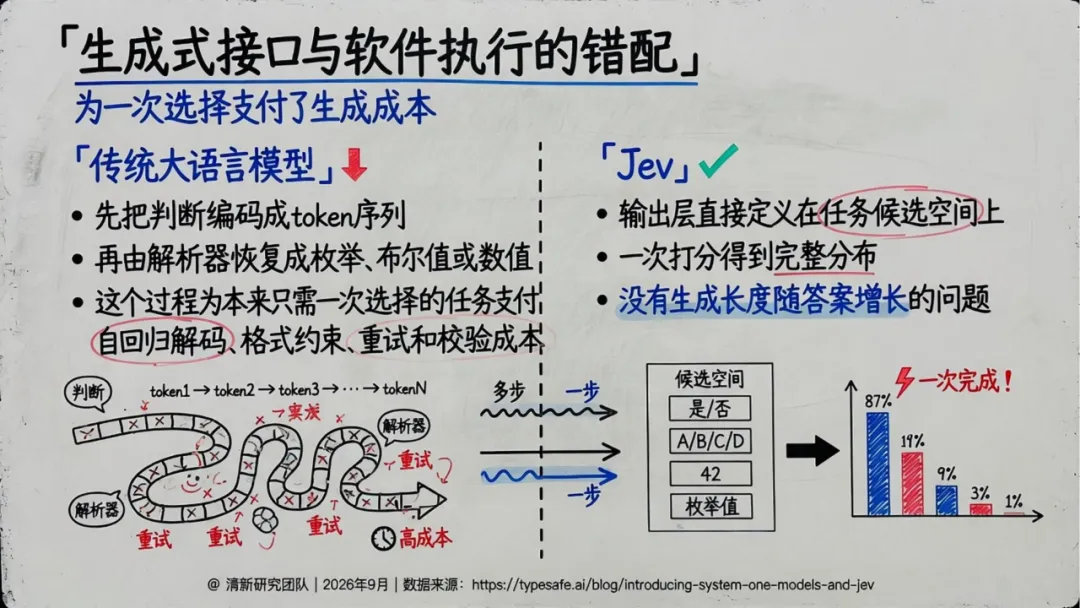
它保留了大语言模型理解自然语言的能力,但彻底抛弃了“自回归生成文本”的产品契约。Jev不生成“hello world”,它只输出结构化的决策和概率。官方将其命名为“System One”,意在对应卡尼曼的“快思考”——在软件需要极速做出高频判断时,它是一把无需生成token的利器。
二、 技术机制:三大原语与并行求值
Jev 1.13的接口词汇表极其精简,只有三个原语:
Choice:从最多255个预定义候选中选一个,返回选项和全分布。
Score:在有序等级上评分(如1-10级),返回概率加权期望。
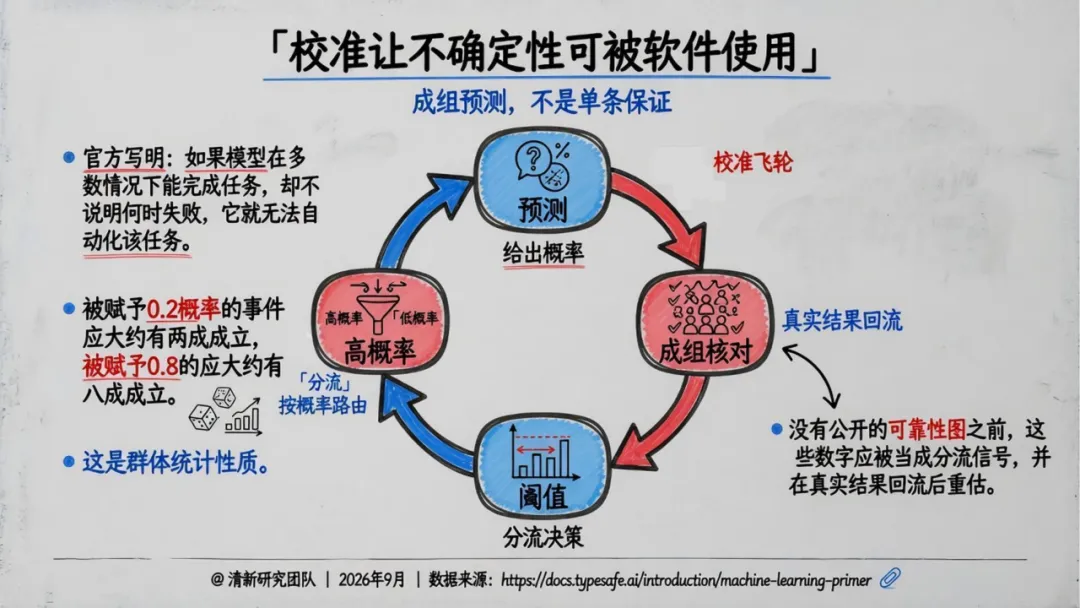
Noul:判断命题是否为真,返回0到1的“真概率”。
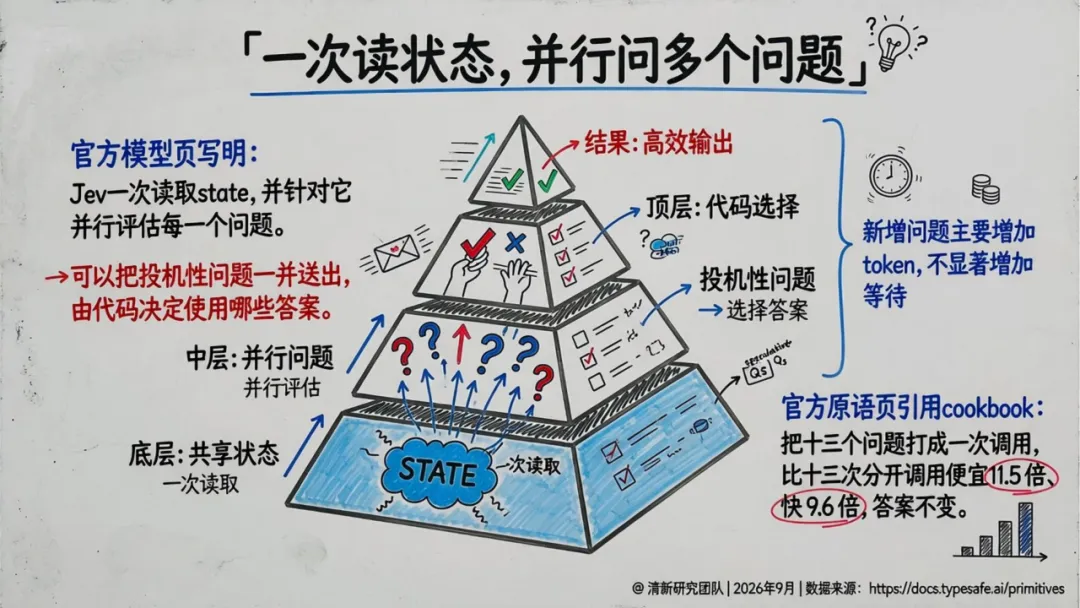
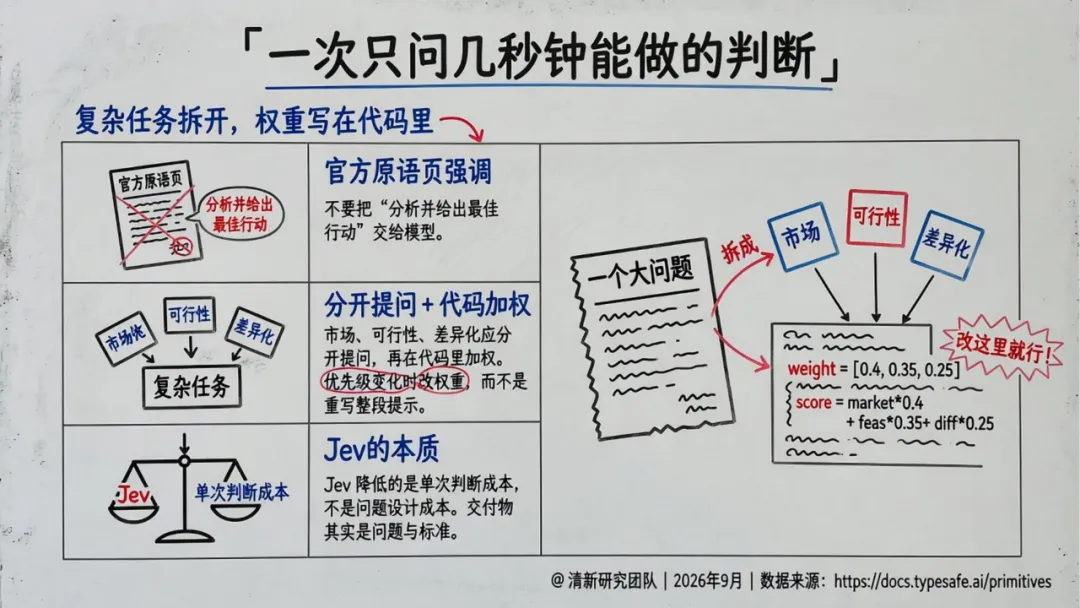
基于这三个原语,Jev实现了五条可确认的技术机制。最令人瞩目的是“共享状态编码”与“并行问题求值”。官方原语页引用cookbook显示,将13个问题打包成一次调用,比分开调用便宜11.5倍、快9.6倍。这种“一次读取状态,并行评估多个问题”的架构,彻底解决了传统LLM需要为每个问题支付自回归解码成本、重试成本和解析器恢复成本的问题。
三、 性能真相:倍率背后的严谨约束
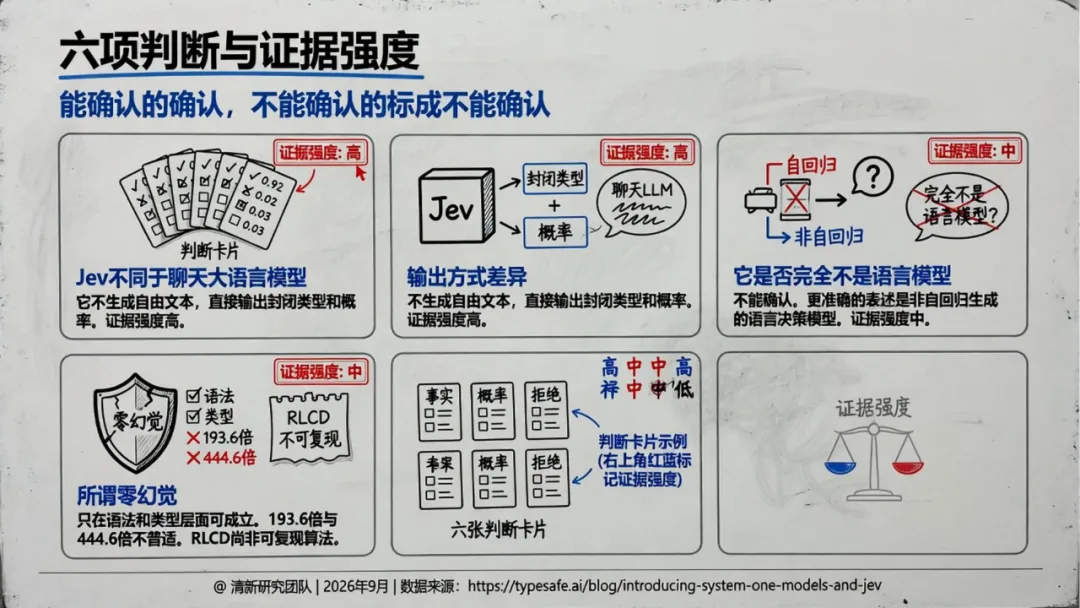
报告中最吸引眼球的数字是“193.6倍更快”和“444.6倍更便宜”。但报告展现了极高的证据纪律:这并非普适定律。官方博客明确写明,这些数字处于真实收益的高端区间,且依赖于“短而密输入”和“西海岸测量”的位置优势。更关键的是,公司承认“无法证明当前价格未被补贴”。因此,严谨的结论是:接口形态具有速度和成本潜力,但倍率不能跨行业直接复现。
四、 边界与失败:零非法输出 ≠ 零幻觉
Jev最大胆的创新在于“将概率变为接口”。它用封闭的输出空间换取类型安全,实现了“零非法输出”——模型无法生成不存在的字段或非法枚举。然而,报告立即指出:“零非法输出”不等于“零幻觉”。Jev依然可能将错误的合法选项给出很高的概率。
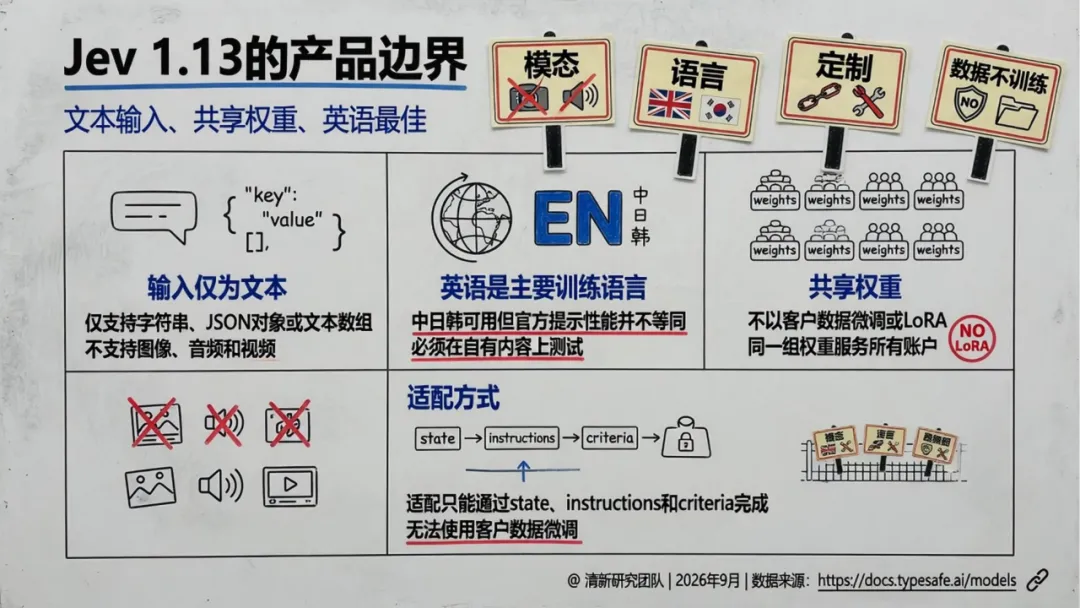
官方极度坦诚地列出了九类失败模式:字面理解、数学计数、日期比较、多跳间接、长状态干扰、指令与标准冲突、对抗内容等。这意味着,Jev不是一个全能求解器。它最适合的任务形态是:输入为文本、答案空间可预先列举、追求低延迟和高吞吐的高频判断(如客服路由、安全预筛、发票分流)。对于开放写作、代码生成、复杂数学规划,它并不适合。
五、 四层计算栈:机器原生决策的演进路线
为了说明Jev在系统架构中的位置,报告提出了“四层计算栈”的概念框架(团队首创概念):
发现层:由强生成模型提出新问题和新流程。
判断层:即Jev,做高频语义判断,是系统的“高速反射层”。
执行层:由程序做算数、约束和动作。
验证层:通过真实结果测量残差并回流。
这一架构的启示是,企业不需要用昂贵的生成模型去处理所有事。按信息形态分配模型,把稳定能力编译到更便宜的判断层,是更经济的自进化基础设施。
六、 结论:接受接口革命,等待科学公开
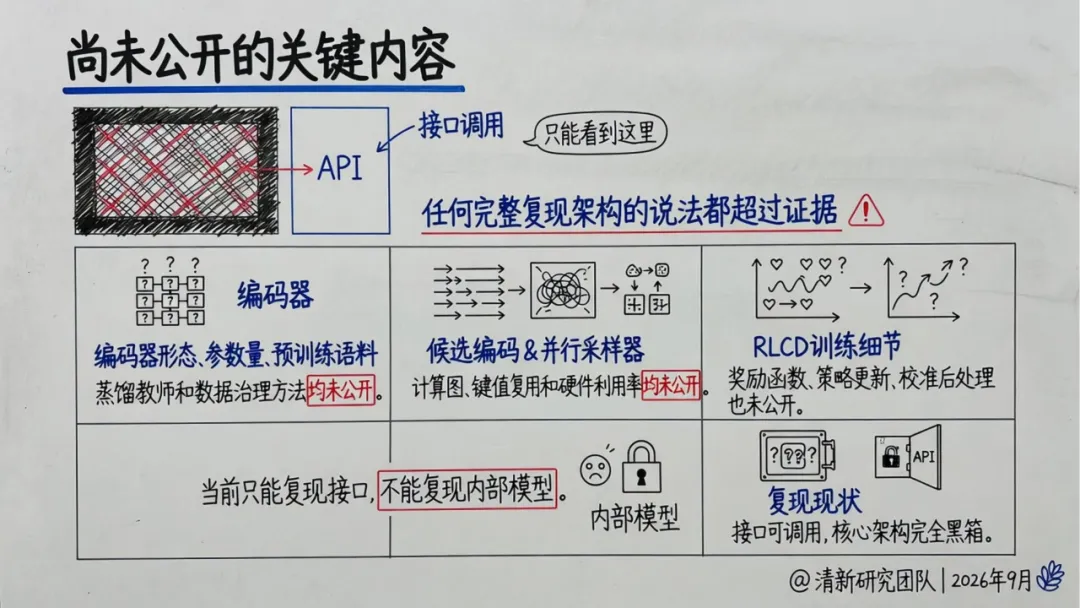
Jev 1.13在接口成熟度上表现极高,但在模型成熟度和证据成熟度上仍处于早期。它背后的RLCD(强化学习校准决策)目前只有名字和目标,缺乏论文、数据集和训练配方,尚非可复现算法。
总而言之,Jev真正值得复制的是其产品契约的变革:把模型从“生成字符串”重新定义为“条件分支和概率接口”。它可能包含重要的模型创新,但公开证据目前只足以确认这是一次极具价值的“系统创新”。对于软件开发者和AI落地团队而言,Jev提供了一种把概率当成接口、把复杂计算交给代码的全新范式。这不仅是工程实践的优化,更是通往机器原生决策智能的重要一步。
本文基于清新研究团队《Jev深度研究报告:System One模型·RLCD·机器原生决策智能》撰写,详细内容请查阅原文。
以下是内容节选↓↓↓ 文末点击链接免费下载pdf,扫二维码加入交流群
AI科普馆:打开AI世界之窗


发表评论
发表评论: