研报速递
AI科普馆部分垂类内容转移至👆
【长三角人工智能联盟】公众号,快点进去瞧瞧!
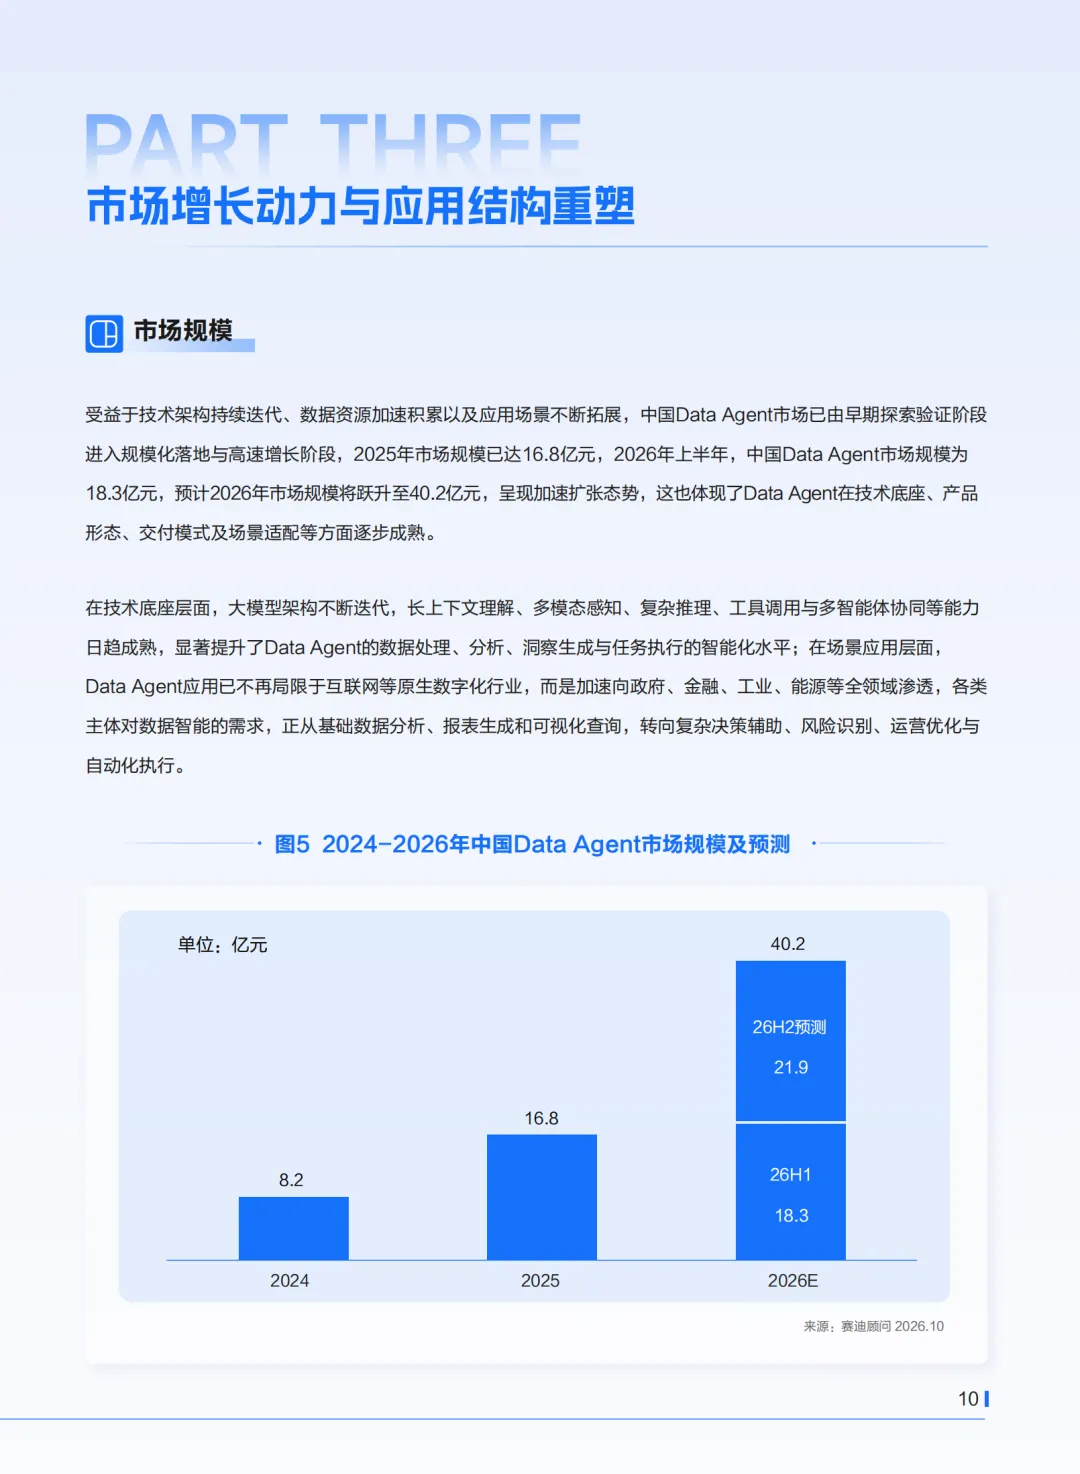
2026年上半年,中国Data Agent市场规模18.3亿元,赛迪顾问预计全年40.2亿元。这个数字在大模型任何细分赛道里都不算大。比数字更该看的是报告的一句定性:Data Agent属于传统数据软件、数据平台及数据应用的"AI 增强增量市场","而非完全独立的新赛道"。
这句话拆掉了不少厂商的叙事:它没另起炉灶,是给建了十几年的数据系统换一种交付方式。
过半的钱花在打扫上,不在分析上
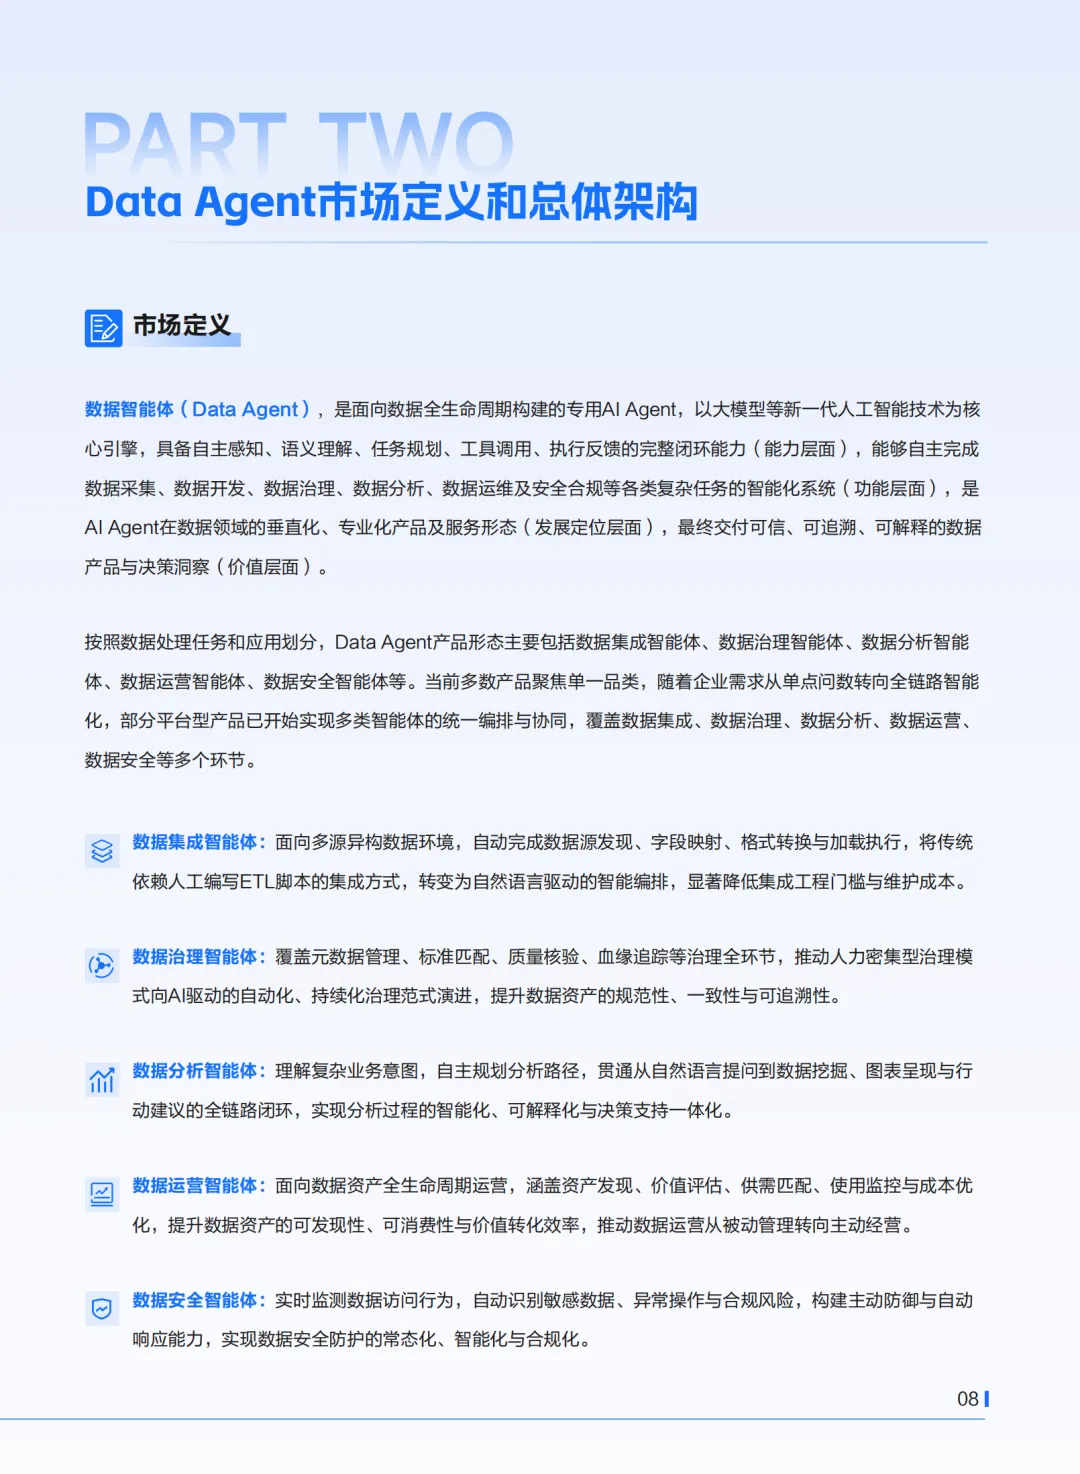
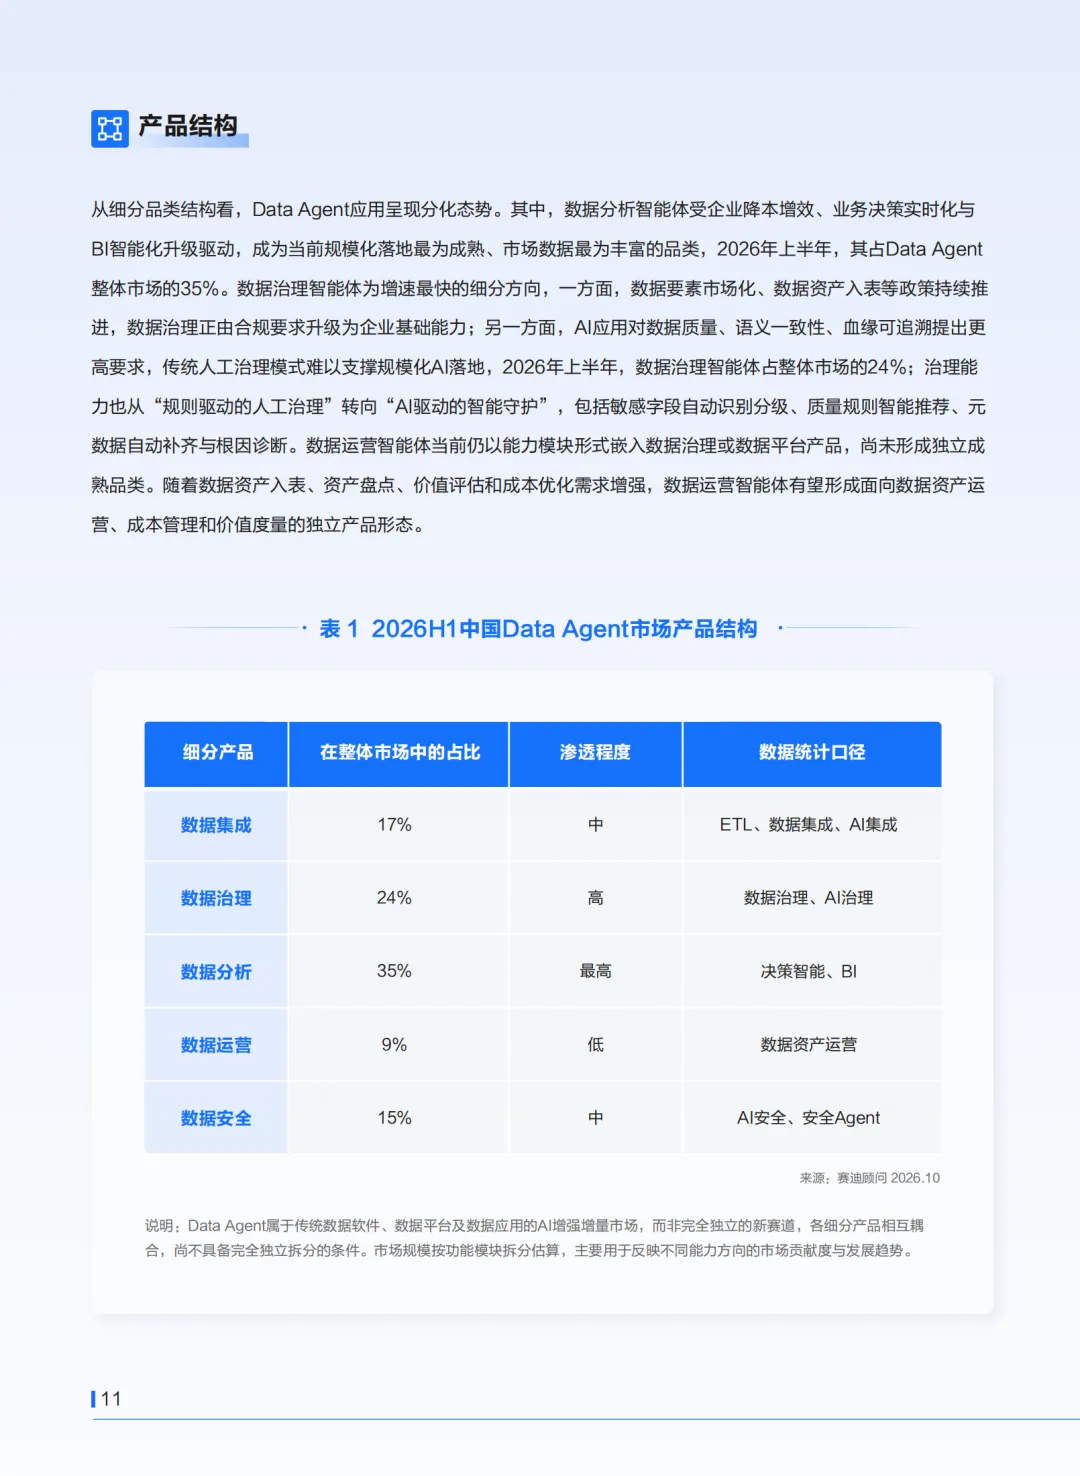
2026年上半年产品结构:数据分析智能体占35%,数据治理24%,数据集成17%,数据安全15%,数据运营9%。
分析是最大单一品类,符合直觉。但治理、集成、安全三项加起来占56%,全是"把数据弄通、弄干净"的前置工序——而报告点明,治理是增速最快的一类。
原因不复杂。人对脏数据有容忍度,会绕开、会凭经验补;Agent没有。AI一旦接进数据链路,语义是否一致、血缘是否可追溯、口径是否唯一,直接决定输出能不能用。于是企业花钱的顺序被倒过来了——不是先买最聪明的分析,而是先把地面扫干净。报告的说法是,治理正从"合规要求"升为企业"基础能力",从人工规则转向AI智能守护。
数据运营智能体只占9%,报告直言它尚未形成独立品类,仍以能力模块嵌在治理或平台产品里——数据资产入表喊了几年,这桩生意还停在概念上。
赚钱的场景都在"说",不在"干"
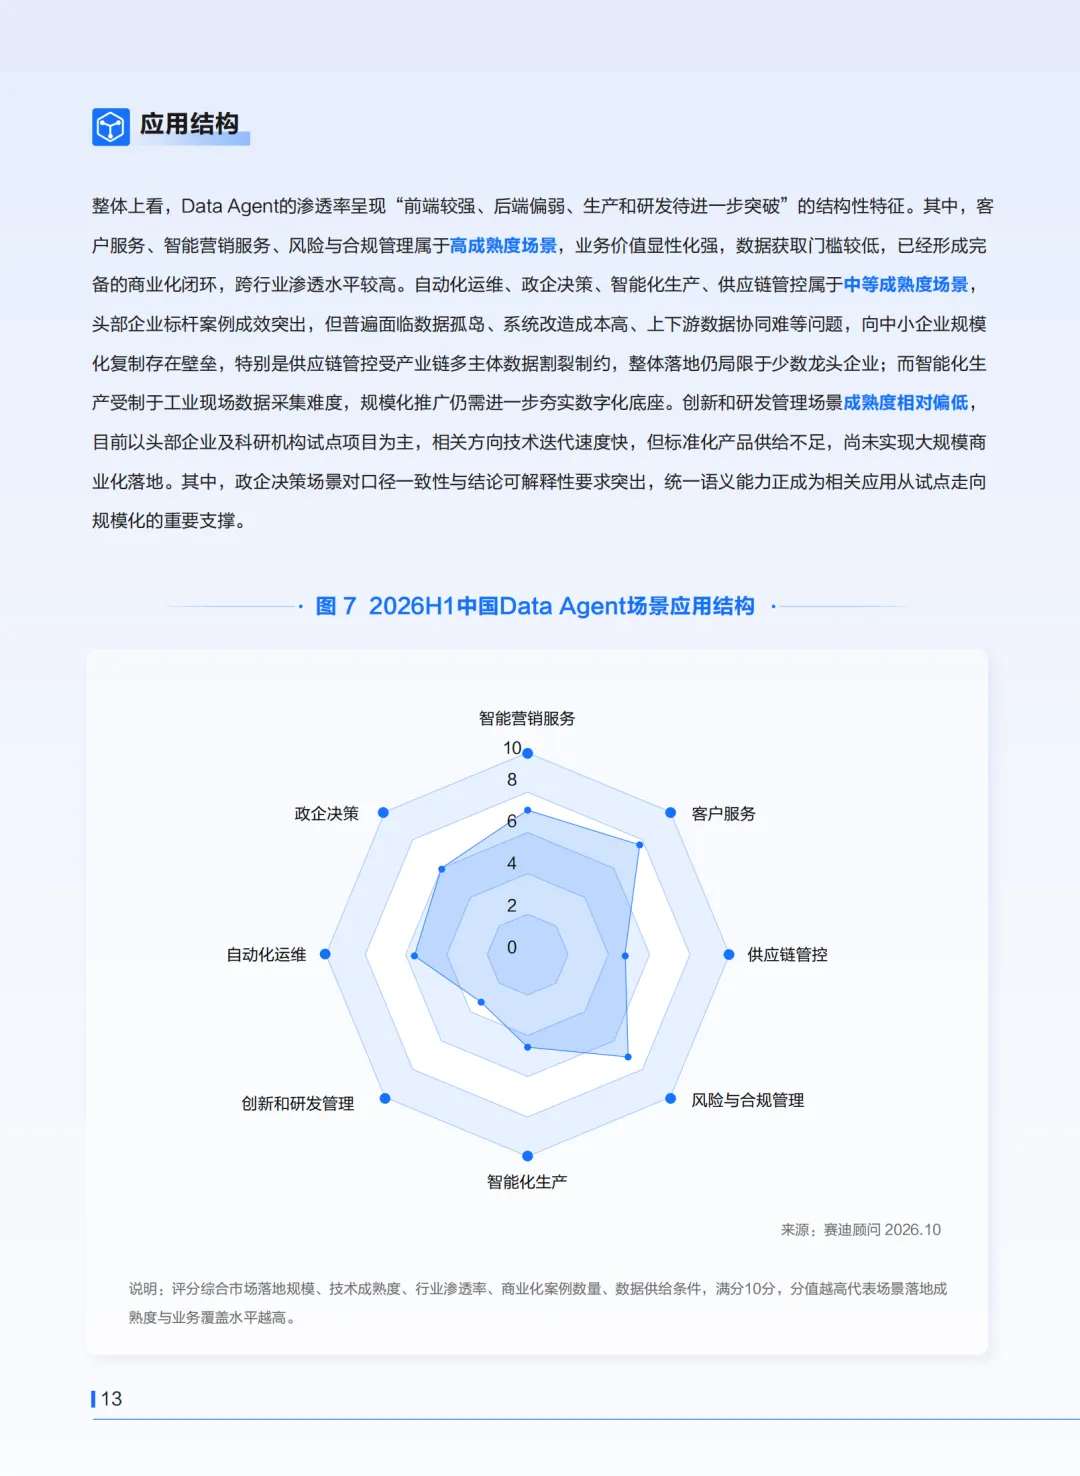
场景成熟度排出来是一张很清晰的图:前端强、后端弱。
客户服务、智能营销、风险与合规管理属于高成熟度;自动化运维、政企决策、智能化生产、供应链管控居中;创新和研发管理垫底。
跑得动的都是"输出一段话、给个建议、出一份报告"的场景,错了还能改。真正要动手的场景——排产、质检、调度、供应链协同——要么卡在工业现场数据采集,要么卡在产业链多主体数据割裂,只在少数龙头有标杆。
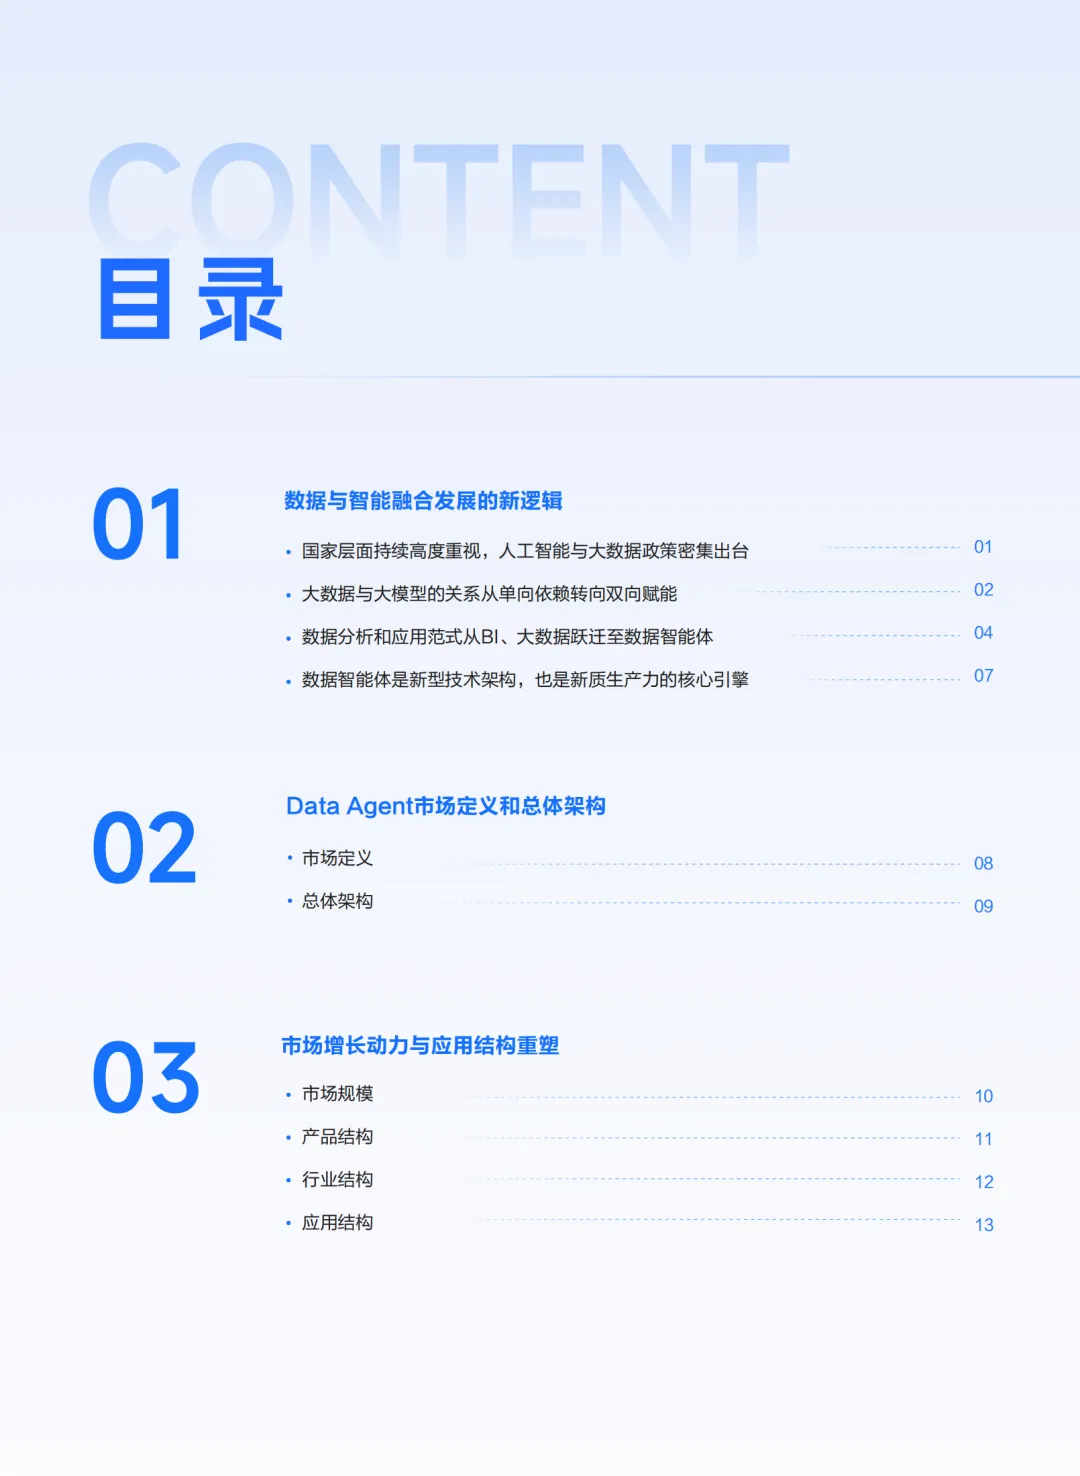
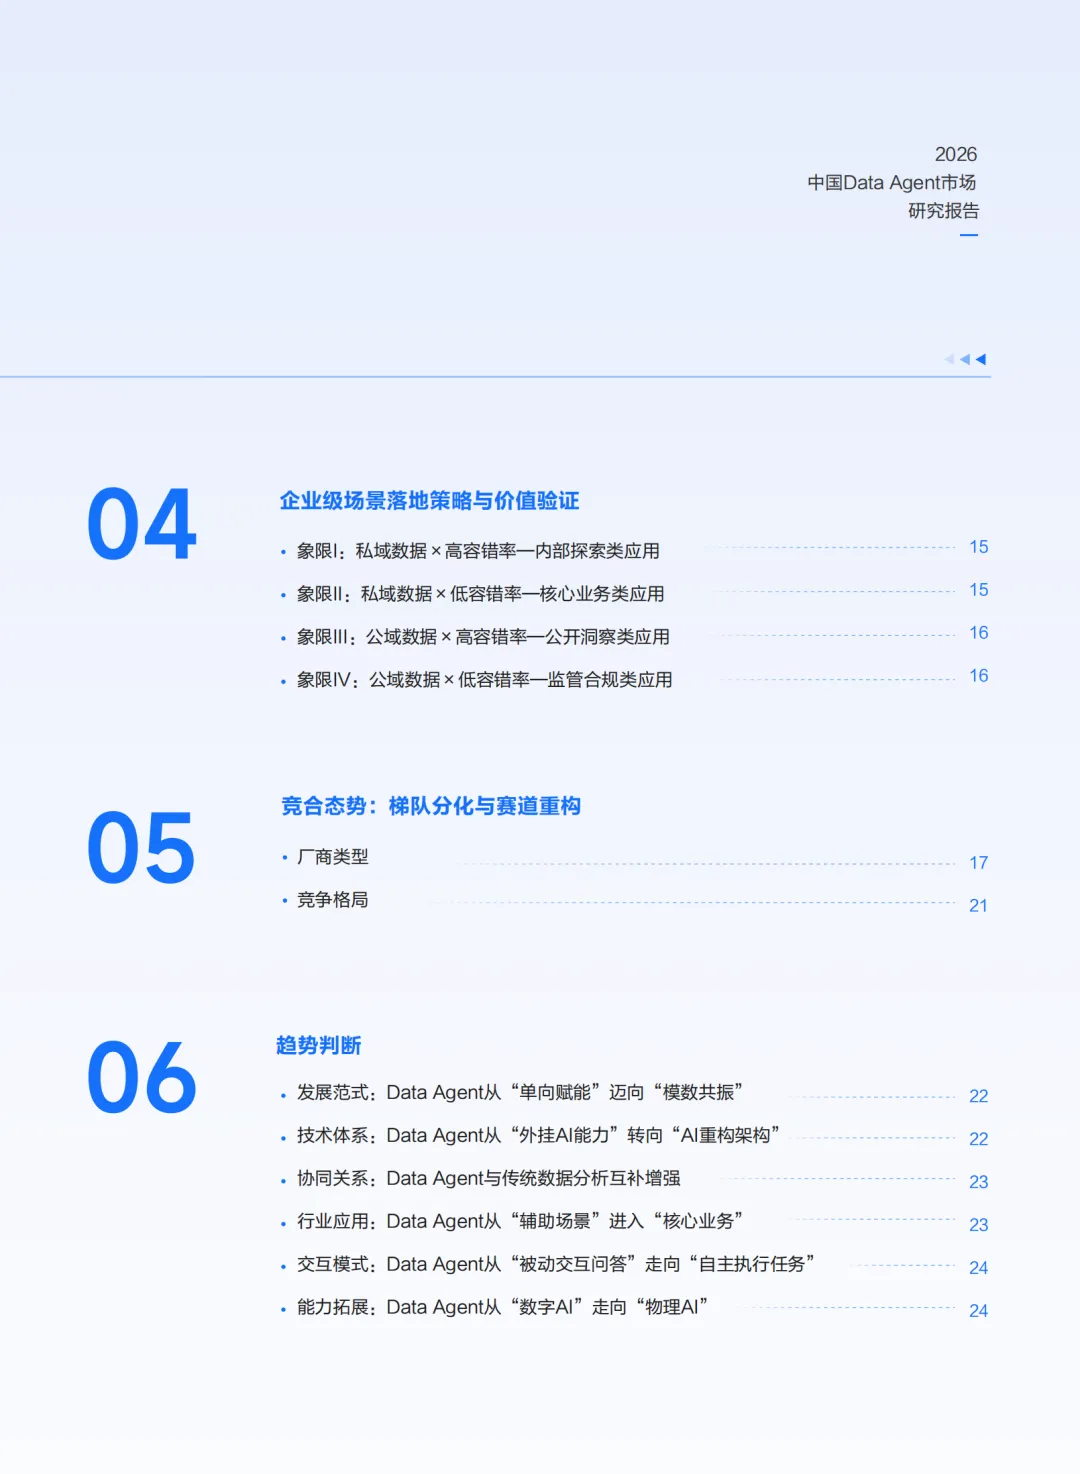
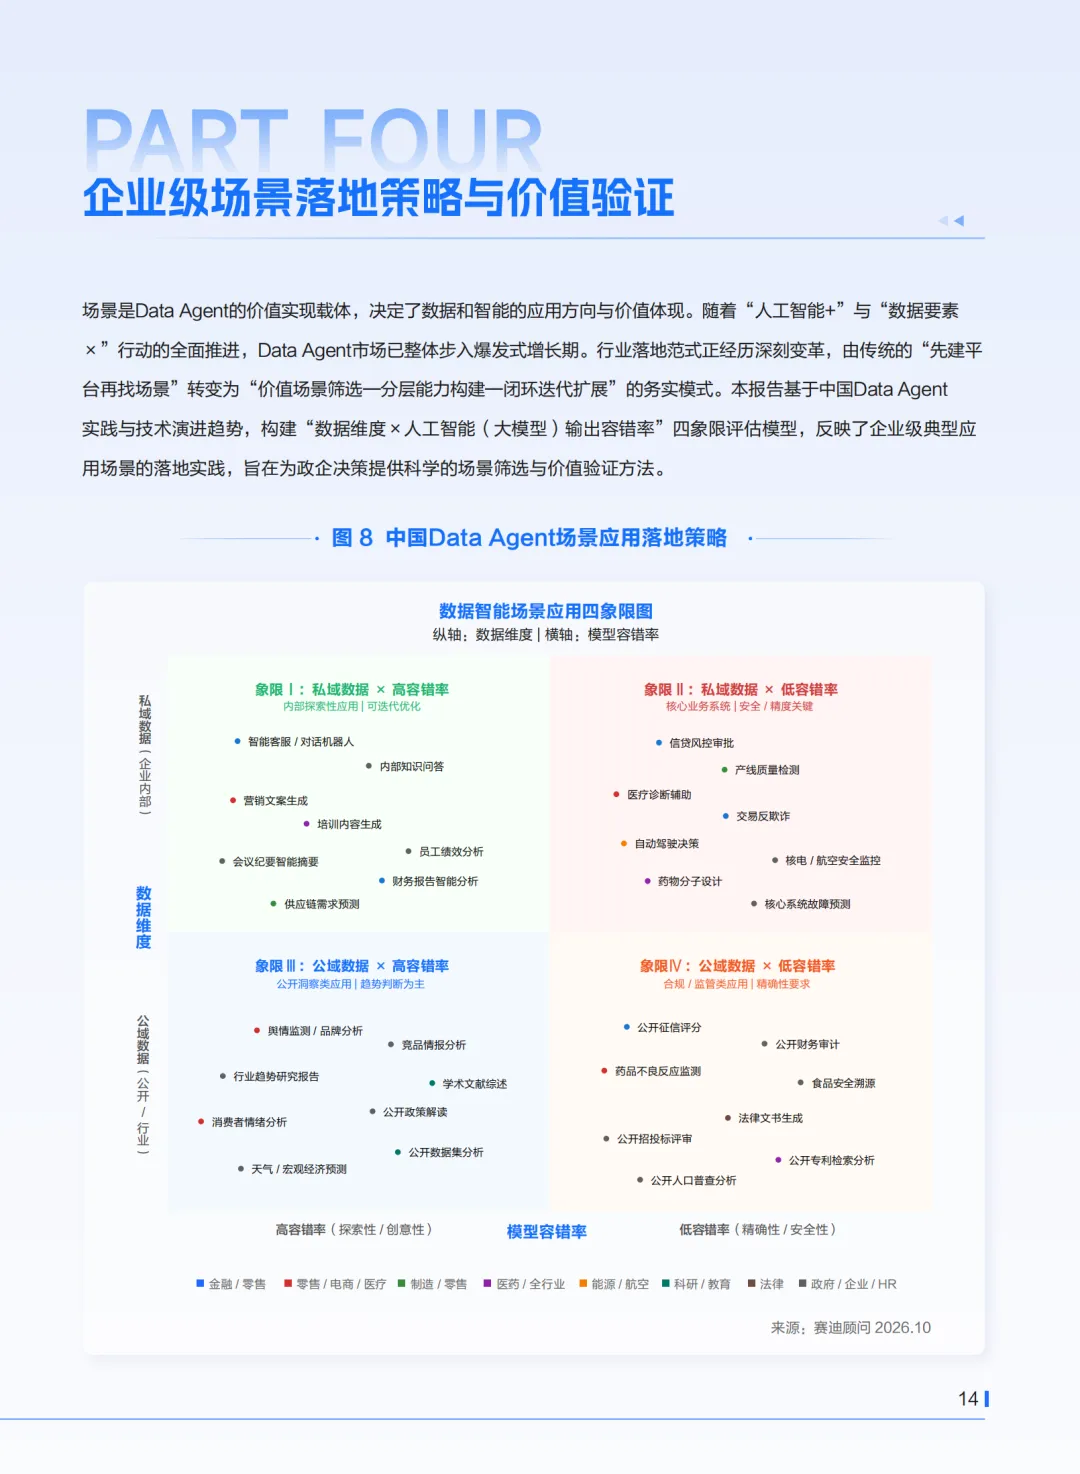
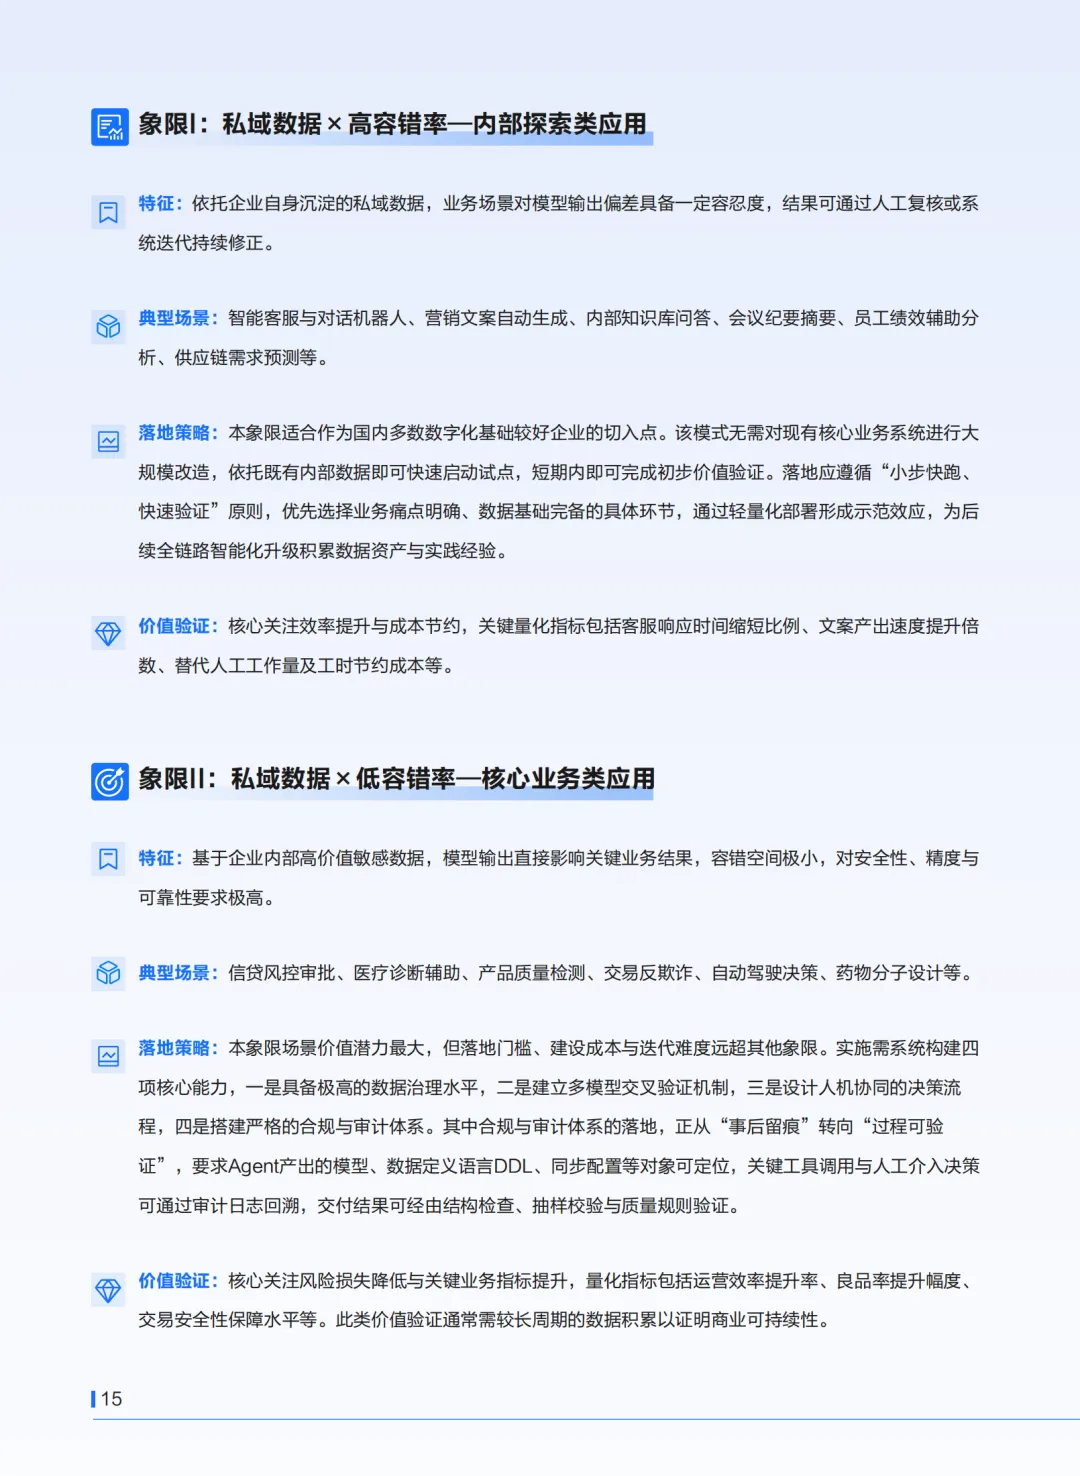
报告搭了个四象限:数据维度×模型容错率。私域数据×低容错率那一格价值最大,门槛也最高:极高的治理水平、多模型交叉验证、人机协同流程、可审计的合规体系。合规审计也从"事后留痕"变成"过程可验证"——Agent产出的模型、DDL、同步配置要能定位,工具调用和人工介入要能从日志回溯。
真正的变化在合同上
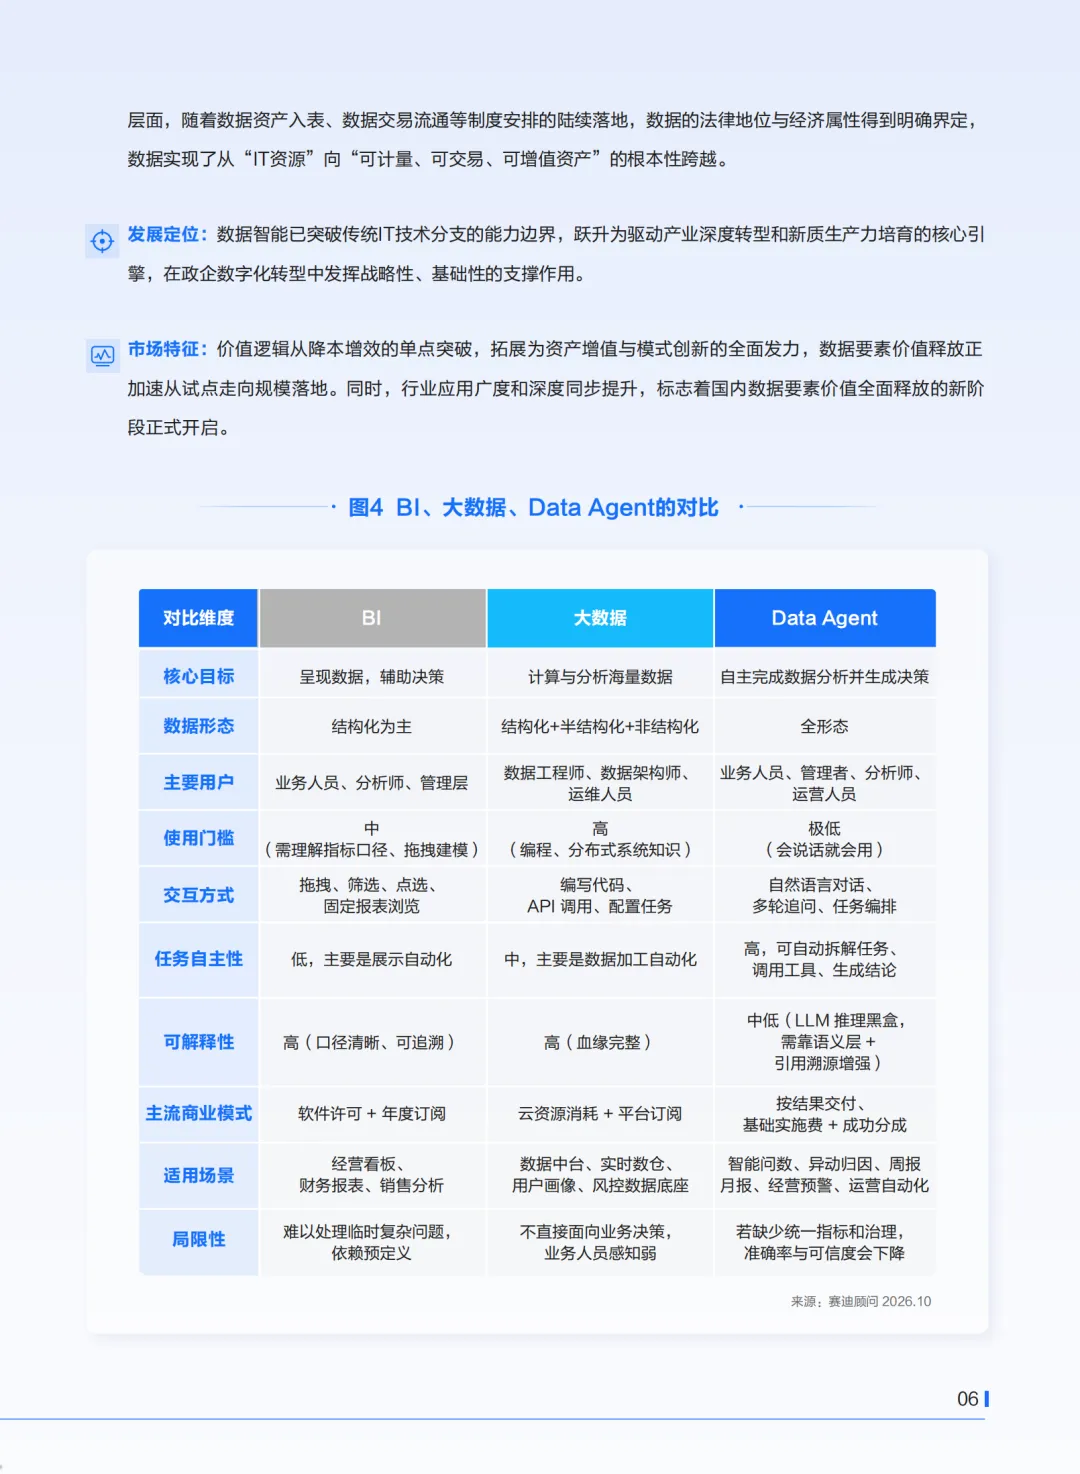
报告的商业模式一栏写着:按结果交付、基础实施费+成功分成。对比上一阶段——软件许可+年度订阅、云资源消耗+平台订阅,这是两种完全不同的生意。
这个改动踩着教训来的。报告自己承认,大数据平台时代"重建设、轻应用"的矛盾普遍存在,大量平台建成后没转化成可量化的业务价值。落地范式随之改了:从"先建平台再找场景",变成"价值场景筛选—分层能力构建—闭环迭代扩展"。
按结果分成,本质是把上一轮的教训写进了合同。客户不为能力买单,只为结果买单。
壁垒不在模型,在语义层
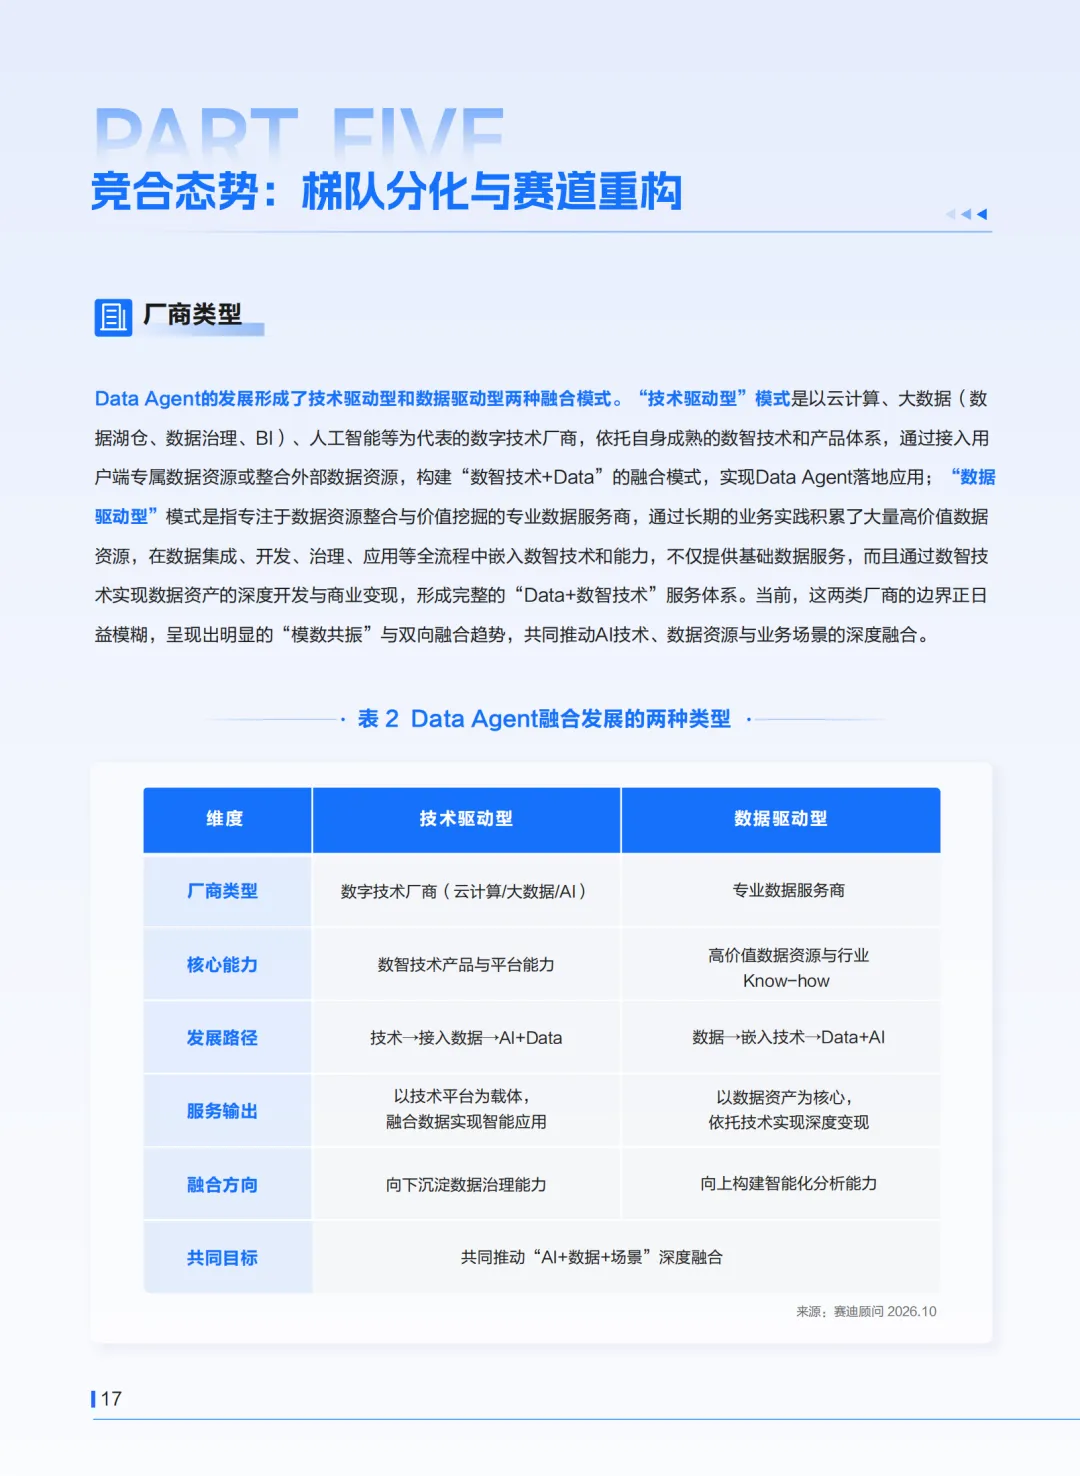
竞争格局里,腾讯云、阿里云、百度智能云在领导者象限,靠全栈能力和客户规模;帆软这类BI厂商靠继承多年攒下的指标口径、权限体系、报表看板,把存量资产重新激活;百望、合合这类数据要素服务商靠别人没有的数据——2850万家企业的真实交易数据、上亿家企业机构的商业数据。
三条路的共同点是报告反复提的那个词:统一语义层。谁的语义层被企业认下来,谁就握着入口。
报告对Agent与BI的关系也很克制:不是替代,是互补,"不能简单以'更智能'替代'更稳定'"。推理成本高、时延不稳、输出不确定,在口径和权限边界上更易出偏差。
40.2亿,用"爆发"形容太早。这个市场真正在发生的事,是数据软件从卖工具改成卖结果。
往后盯两个数就够了:数据运营智能体什么时候不再是9%,智能化生产与供应链管控的成熟度什么时候追上来。这两件事发生之前,Data Agent赚的还是"打扫房间"和"出报告"的钱。
本文基于赛迪顾问《2026 中国 Data Agent 市场研究报告》撰写,详细内容请查阅原文。
以下是内容节选↓↓↓ 文末点击链接免费下载pdf,扫二维码加入交流群
AI科普馆:打开AI世界之窗