研报速递
甲子光年智库出了一篇《2026 Agent商业化与竞争研究报告》,47 页,主笔翟惠宇。它没教怎么搭一个 Agent,而是把从「能干活」到「能收钱」之间那笔账摊开算了一遍。最扎眼的一条落在银行场景的测算里:Agent 的变动成本有七成花在人工监督上,模型调用只占两成。
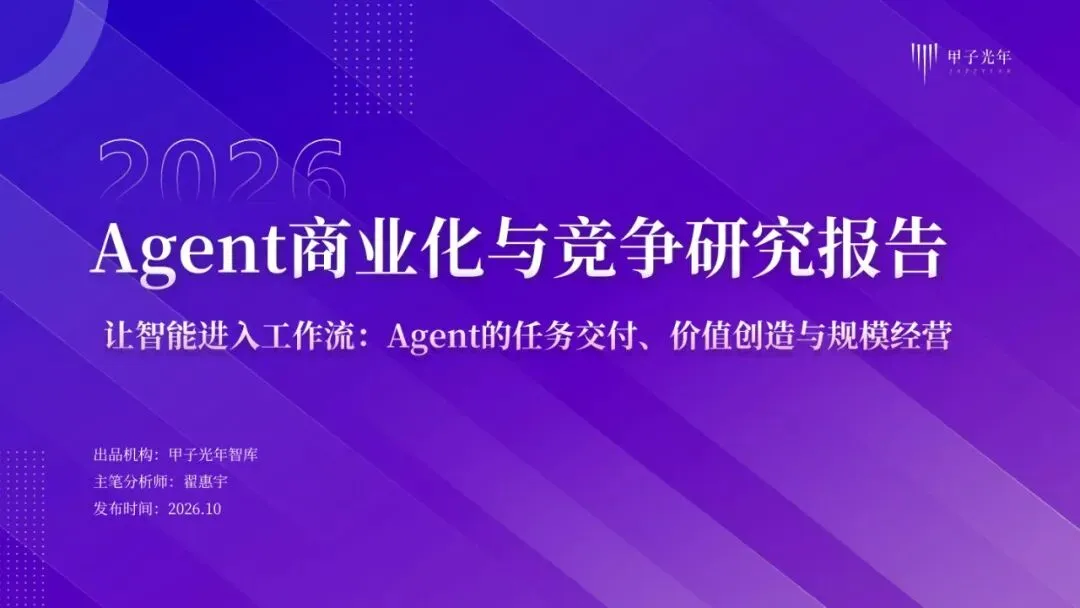
报告分五块:任务交付形态怎么变、价值从哪来、生态与部署怎么走、行业里落成了什么样、规模经营怎么兑现。
今天我们就讲清楚一条线:AI的交付物变了,瓶颈就挪到上下文与执行层;瓶颈一挪,成本结构才露出真对手;这笔账还能自己反算一遍;反算完,竞争分几层就有答案了。
01 Agent的交付物从问答结果变成了任务状态
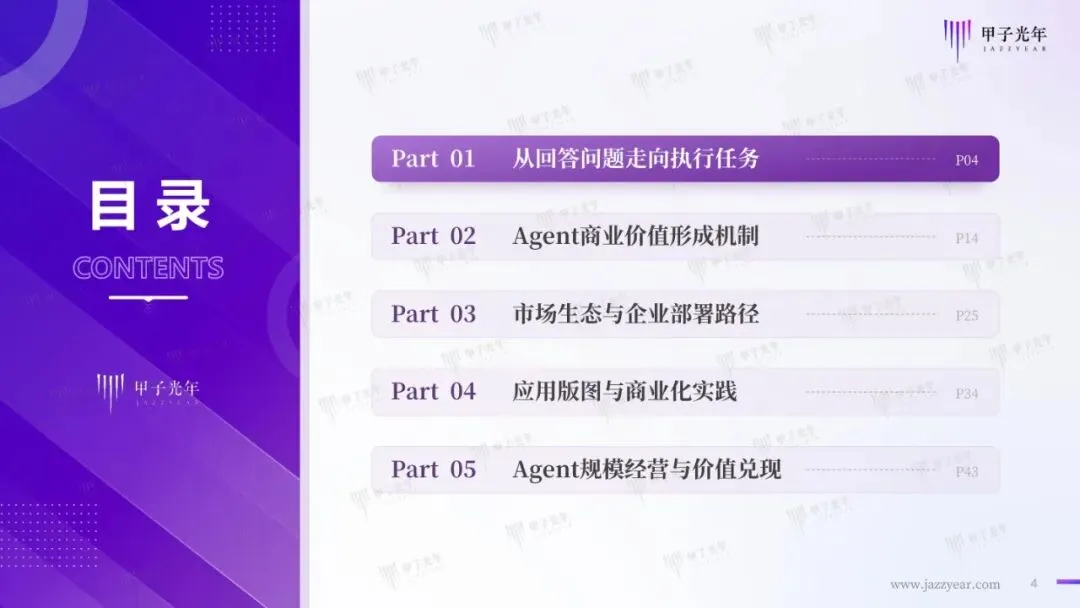
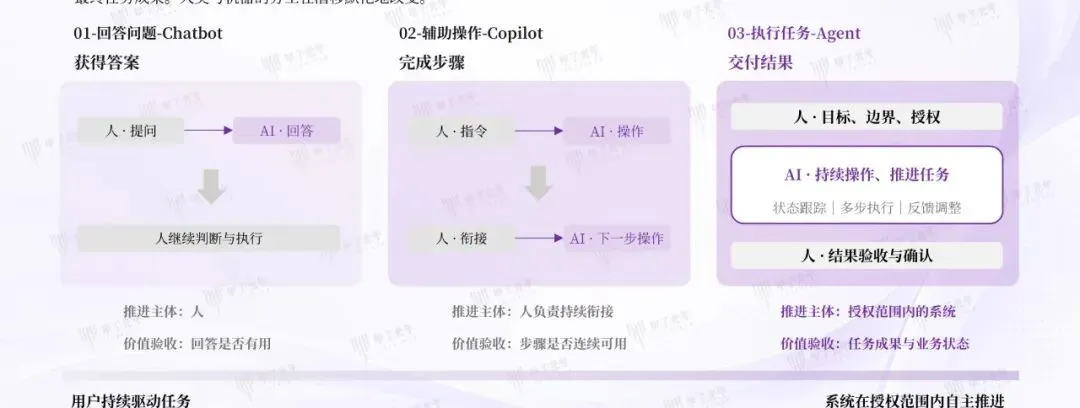
报告切出三段:Chatbot 给答案,Copilot 完成步骤,Agent 交付结果。分水岭不在能力,在谁在推进:前两段靠人一句一句衔接,第三段交给授权范围内的系统。验收对象随之从「回答有没有用」变成「业务状态对不对」,人也从操作者退成把关者。尺子一换,能被卡住的地方就换了。
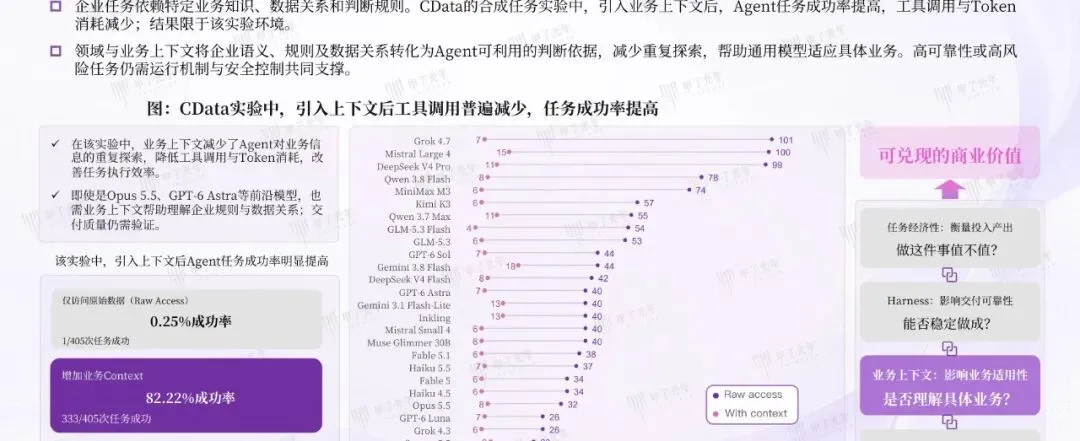
02 补上合适的业务上下文,同一个模型成功率从 0.25% 到 82%
CData 用 27 个模型跑了 810 次实验:只给原始数据,405 次任务里只有 1 次达标;喂进业务上下文,成功率升到 82.22%,工具调用次数反而少了。另一组实验里,同一个模型换一层 Harness,性能和成本一起改写。能力是入场券,不是差距,差距既然落在执行层,就得看它折算成什么账。
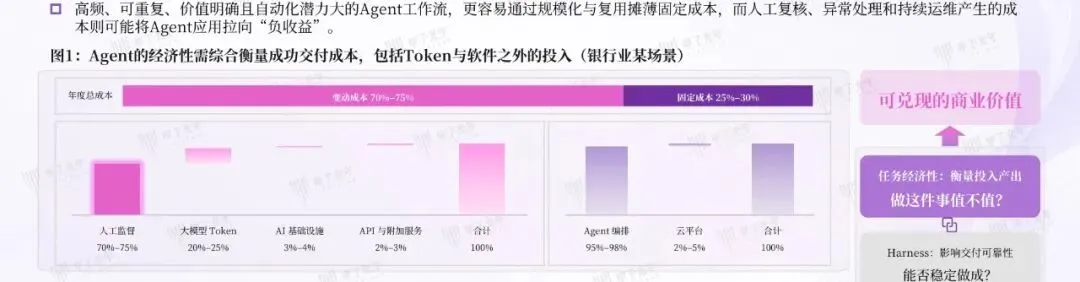
03 变动成本七成在人工监督,Token 只占两成
银行业一个开户场景测算:变动成本占年度总成本 70%-75%,其内部构成是人工监督 70%-75%、模型 Token 20%-25%、基础设施 3%-4%。规模效应其实存在,100 次运行时单次 78-79 美元,1000 次摊到 2-3 美元。但人工复核不随规模下降。
04 按它的数字反算一次,单次只够 5 到 10 分钟人工
这一步报告没写,是我自己推的。1000 次运行时单次 2-3 美元,变动成本取七成,人工监督再占其中七成,落在 1.0-1.7 美元,折人民币 7 到 12 元。熟练审核员的月成本按一万二算,每分钟约一块钱,于是单次任务能分给复核的预算只有 5 到 10 分钟。复核超过这个长度,跑得越多亏得越快。报告也承认,人工复核和异常处理会把应用拉向负收益。
05 Agent竞争分三层,企业该做的第一件事是先看任务值不值得用Agent做
模型是基础能力,上下文与 Harness 构成执行差异化,客户触达、信任与任务经济性决定钱能不能回来。对企业来说顺序要倒过来:先看这件事值不值得做、有没有条件做,再决定买谁的。报告给的那张筛选清单,四问定生死。
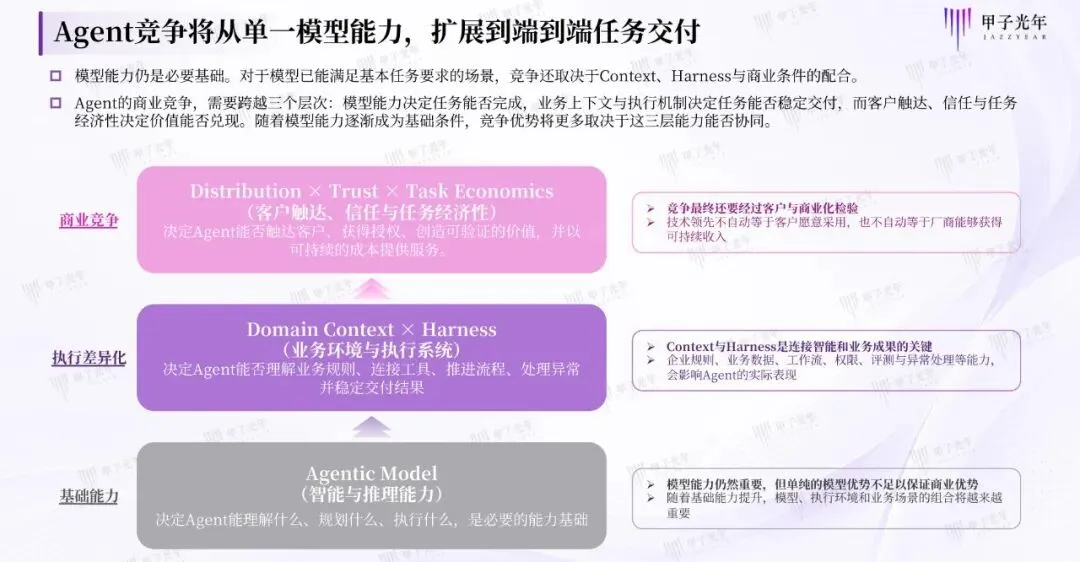
四问过完还有三个出口:先小范围试部署,问题明确、条件具备就先验证效果;先补基础,补齐数据、系统和人员准备;暂缓或换种做法,收益不大、投入太多就先不动。
写在最后:账算清了,但没替你选供应商
没展开的还有:3 个完整客户案例(洞隐的仓储平台、博云的制造业全栈、一家物业集团的审批流程)、14 个企业职能与 14 个垂直行业两张全景图、7 类常被漏算的成本、五种采购方式与四条合同边界。
要提醒一句,那份商业价值四因子模型是报告作者自绘的,未经第三方验证,当框架用可以,当结论引用不行。但主线站得住:模型每代都在变便宜,监督成本是组织问题,降得慢。
接下来该盯的不是模型的榜单分数,是单次任务的人工复核时长有没有缩到十分钟以内。
点击获取报告原文PDF👇
更多访问👇