研报速递
从实验包到短论文:写出一份可审查的研究报告——300 条 SciFact 查询的冻结确认评测
系列:从最小复现到可检验的科研问题 日期:2026-10-27 适合读者:研究生、科研新人和工程型研究者 实际范围:完整 5183 篇文献、300 条确认查询、每条 50 个候选;冻结检索与重排,没有训练。
摘要:让结论接受一次真正的检验
一份实验包变成短论文,并不是把日志换成更正式的措辞。关键变化是:读者能够沿着一个明确问题,追查选择发生在什么时候、结果由哪些输入产生,以及什么证据会让作者收回结论。本项目的问题很小:交叉编码器重新排序时,保留原检索排名的信息,能否在相同候选和模型计分预算下改善检索质量?
此前,100 条已观察开发查询上的等权排名融合比纯重排提高了约 0.03339 的平均 nDCG@10。但开发结果已经参与形成研究直觉,不能再用同一批数据证明直觉可靠。本文按事先登记的方案,首次完成 300 条保留查询的确认评测。融合相对纯重排的均值增益为 0.01754,达到预设的 0.01,但配对分组区间跨零,且融合没有超过更便宜的原始 RRF。 这份报告交付的是可核查的证据边界,不预先承诺新方法或论文录用。
一、复现价值:把研究问题写到可以失败
初学者可以把检索理解成“为一个科学主张寻找相关文献”。词项检索 BM25 看词语匹配,稠密检索把文本映射成向量,交叉编码器则把查询和候选文献一起输入模型、输出一个分数。它们解决的都只是检索环节;找到相关论文,并不等于判断主张受到支持还是反驳。
Wadden 等人的 SciFact 原论文研究科学主张核验,包含证据文献、标签与理由;Thakur 等人的 BEIR 将不同任务整理为检索评测接口。这是论文报告的任务背景。本次使用的是 BEIR 的文献相关性映射,不复现完整事实核验系统。原始 SciFact 的开发划分在 BEIR 中称为 test:名称不同不意味着数据新增,也不意味着它从未被任何模型或其他研究者见过。
我们登记的主假设是:在同样 50 个候选、同一次模型计分下,等权融合比纯交叉编码器的平均 nDCG@10 至少高 0.01,同时报告与原始混合检索的差值。这里的 0.01 是预设实用增益门槛,不是看到结果后挑出的显著性界线。一次完整检验要允许均值不达标、区间跨零,甚至融合不如更便宜的基线。
二、相关工作与已有证据:不把失败从故事里删掉
Cormack、Clarke 与 Büttcher 在 2009 年提出倒数排名融合,简称 RRF:按名次的倒数贡献合并多个系统。本项目只是将这一已有思想用于“原始检索排名与重排排名”的组合,不声称发明融合方法。交叉编码器来自公开的 MS MARCO 排序模型;模型卡描述其训练任务,不代表它在科学文献上必然更好。
开发阶段有两种竞争解释。第一种认为相关文本被截断,导致重排出错;第二种认为重排覆盖了原排名中的有用信息。诊断发现,18 条重排退步查询中有 17 条的相关候选没有发生截断,削弱了“都怪截断”的简单说法,但没有证明另一种解释为真。四条经审核的证据移位探针也没有给出一致改善;上下文前移与排名融合的四格实验中,前移的平均效果在两个背景下都为负。
这些是此前实际验证的开发证据,不是确认结果。证据移位使用相关性与理由信息构造,属于知道答案后的诊断探针,不能成为可部署方法的成绩。最终候选方案只保留无需标签参与推理的原文排名融合。原始负结果、审核记录与各篇固定版本均保留在实验台账里,读者不必相信一段被重新整理得过于顺畅的成功叙事。
三、核心思想与公式:只改变排序规则
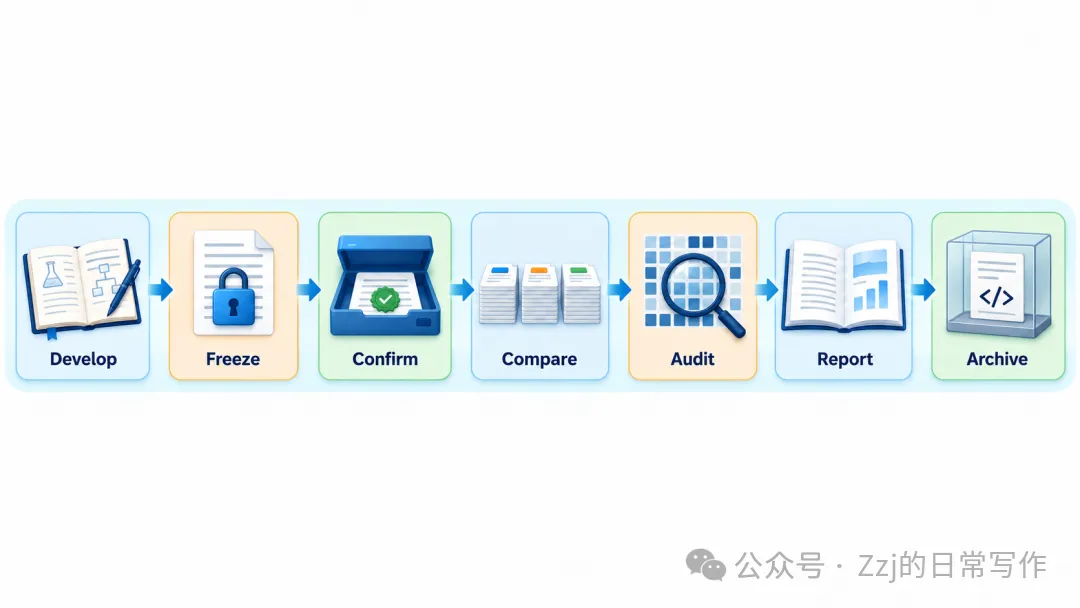
先在同一全文献库上分别运行 BM25 与稠密检索,各保留前 100 名,通过固定常数为 60 的 RRF 形成先验排名,再选出前 50 个候选。交叉编码器对这 50 篇原始标题和摘要计分。第二次融合使用:
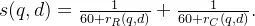
其中  是查询,
 是同一候选集中的文献;
 是先验 RRF 排名,
 是交叉编码器排名,均从 1 开始。两个权重固定为 1;分数相同时按字符串文献编号降序处理。公式只读取名次,不再调用模型,也不把不同模型原始分数直接相加。
主要比较量为:
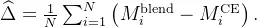
 是确认查询数,
 是第
 条查询的 nDCG@10。该指标对前十名的相关文献按位置折扣,再用该查询的理想排序归一化;取值越大越好。先逐查询做差再平均,确保两方法比较的是同一批问题。候选集合固定,所以 Recall@50 应当相同;它是协议检查,不是融合带来的新收益。
四、评测协议:冻结的不只是模型名字
与上一篇相比,本篇新增变量是数据划分:从已反复观察的 100 条开发查询转向全部 300 条保留查询。模型、文本处理、候选预算、融合常数和统计规则保持冻结。使用全部 5183 篇文献,不缩小语料制造更容易的成绩;不按照查询长度、正负结果或候选命中情况筛选确认样本。
稠密模型 all-MiniLM-L6-v2 的固定 revision 为 1110a243fdf4706b3f48f1d95db1a4f5529b4d41,最多 256 token,输出 384 维向量。重排模型 ms-marco-MiniLM-L6-v2 固定为 233902d25c440f23af6f7d6e94d2946bac0bee0a,查询与文献合计最多 512 token,使用原始标量分数。两者的 tokenizer 与各自模型版本一致;数据没有可用 Git revision 的部分以下载地址和文件哈希标识。
查询共享证据文献,不能轻易当作相互独立的三百次抛硬币。我们在看到任何确认分数之前,按共享正相关文献连边并取连通分量,得到 247 个组;包括未进入候选集的相关文献。按组有放回抽样 10000 次,种子固定 111,每次将抽中组的查询差值总和除以查询总数,仍估计查询加权均值,而非让大小不同的组等权。
报告使用百分位法的 95% 区间,并额外给出逐查询抽样敏感性。分组只能代理部分依赖,主题关联和训练污染仍可能存在,不能把区间当作保证。实用门槛是否达到、区间是否覆盖零、区间是否覆盖 0.01 是三个分别回答的问题。确认结果不再用于修改权重或挑选新模型。
五、官方代码阅读路线与最小实验
阅读源码可以从数据流入手。先看 BEIR 的 BM25Search.search 与 ElasticSearch.lexical_multisearch:检查英文分析器、标题和摘要字段、单分片以及批量返回的文献编号。再看 DenseRetrievalExactSearch.search:确认全文献库编码、余弦相似度和候选深度,而不是只看模型加载是否成功。
随后读 Pyserini 的 reciprocal_rank_fusion、TrecRun.rescore 和 merge,追踪每个倒数贡献如何按文献编号相加。最后沿着 BEIR 的 Rerank.rerank 到 Sentence Transformers 的配对分词与 CrossEncoder.predict:检查标题与摘要拼接、联合截断、输出分数如何回到原查询和文献。SOURCE_MAP.md 给出已核验固定提交、函数行号、许可证及本地对应路径,区分原样上游文件与独立教学实现。
资源试跑只用了五条已观察开发查询。新的环境最初缺少检索依赖,随后又遇到 PyArrow 与 NumPy 版本不兼容;这些失败发生在确认推理前,修复与日志均保留。兼容检查中,BM25 分数与旧记录完全相同;稠密分数最大误差约  ,候选集合和排序不变。最终全库检索约 51.58 秒,交叉编码器正式计分约 391.04 秒,保留 5323656 个非填充 token;该进程峰值常驻内存约 1.08 GB。单批形状检查为输入
 、末层表示
 、输出
 ,分别对应两对文本、序列长度、隐藏维度和单一排序分数;这四个辅助前向输入对不计入正式 15000 对。模型不训练;下载时间和 Elasticsearch 服务峰值内存未测量,不能混入已实测成本。
六、主结果:先给完整比较,再解释差值
本次实际验证:融合减纯重排的均值为 0.017540,逐查询胜/平/负为 65/197/38;分组百分位区间为 [-0.002345, 0.038275],同时覆盖零和 0.01。逐查询抽样敏感性区间为 [-0.001477, 0.036632],也没有排除零。因而可以说观察均值达到登记门槛,却不能说本次证据已经确立稳定正收益,更不能说总体增益至少为 0.01。
融合减原始 RRF 的均值为 -0.001033,胜/平/负为 46/213/41,分组区间为 [-0.019943, 0.016832]。纯重排减 RRF 为 -0.018573,区间为 [-0.052325, 0.013459]。完整比较表明,融合修复了一部分重排损失,但没有在这批确认数据上超过最便宜的参考方法。开发增益向确认增益收缩,也不能单独归因于选择偏差,因为查询构成同时改变。
这里的公平性有明确范围:纯重排与融合共享同一轮交叉编码器输出,后者只增加排名算术。原始 RRF 不需要这轮重排,因此三者并非总成本相同。读者应同时看效果差值和模型调用量,避免把“同候选”误读为“所有方法等计算成本”。
七、失败分析与排查:报告不能只剩一个均值
候选阶段有 17 条查询完全没有相关文献,三种重排序都无法挽救;即使使用知道相关标签的理想排序,上限也只有约 0.941169。它是候选诊断上限,不是实际方法成绩。
按预定规则自动列出的三个最大融合退步查询为 690、1368、1024。以 690 为例,首篇相关文献在 RRF 中第 33、纯重排中第 1,融合后降到第 9,nDCG@10 从 1 降至约 0.30103。这是对“保留先验总能减少损失”的直接反例:先验也会拉低一次正确的重排。它只支持排名层面的描述,不构成未经审核的语义错误归因。
排查顺序应先处理协议,再解释语义:查候选缺失、查询与文献编号错配、截断长度、并列分数处理和缓存身份;再检查差值是否确由同一查询配对产生。独立脚本从逐对原始分数重建排名、正确相关映射和全部指标,并用另一套图遍历与分位数实现复算抽样结果。故意损坏分数、候选、预算或分组后,审计必须拒绝通过;仅仅让原脚本自报成功不够。
八、研究问题、限制与总结
一个可审查的短报告可以只作有限贡献:在固定的任务、模型和预算内,提供一个能被重复检查的比较。本文没有新增训练,没有证明两种错误机制的因果关系,也没有把四条探针推广成全数据规律。开发与确认共享文献库,查询留出不等于文献或主题留出;一次科学文献评测也不等于跨领域有效。
后续值得检验的是:融合收益是否主要来自特定的先验与重排分歧,或者只在某些候选质量区间出现?这些分层规则必须在新开发材料上定义,再用新的确认材料验证。现在的 300 条查询已经消耗,不能换一个叙述后重新称为未见数据。作者推断可以提出这些方向,本次实际验证只支持表中冻结比较及其限制。
从实验包到短论文,真正需要收紧的是主张与证据的距离。问题、协议、结果、失败和运行入口放在一起,即使某个预设门槛没有达到,工作也能留下下一项研究可以检验的起点。
源码与复现入口
本篇已公开的固定提交源码目录、README 与完整运行说明、SOURCE_MAP 官方源码地图共同构成复现入口。
安装锁定依赖并按 README 获取哈希校验缓存后,一条最小真实运行命令为:
python run.py --cache ./cache --out fresh-smoke --smoke它执行五条开发查询、每条十个候选,生成逐对分数、排名、汇总、形状、耗时及审计输入。本文正式执行范围则是全部 300 条确认查询的 15000 对计分,以及此前的全库双路检索;最小试跑不是完整成绩。完整运行、独立复算、重建检索和版本获取步骤见 README。所有必要自写模块随源码提供;大模型权重与完整语料单独按固定身份获取。公开固定版本、归档清单和验证记录共同确定读者复现的对象。
参考资料
检索与访问日期:2026-10-27。论文结论、模型说明与本次测量分别标识,推广链接不属于科研来源。
David Wadden、Shanchuan Lin、Kyle Lo、Lucy Lu Wang、Madeleine van Zuylen、Arman Cohan、Hannaneh Hajishirzi,2020:Fact or Fiction: Verifying Scientific Claims,EMNLP,任务与数据来源。 Nandan Thakur、Nils Reimers、Andreas Rücklé、Abhishek Srivastava、Iryna Gurevych,2021:BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models,v4;固定版本重排实现。 G. V. Cormack、C. L. A. Clarke、Stefan Büttcher,2009:Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods,SIGIR,倒数排名融合公式。 Sentence Transformers:all-MiniLM-L6-v2 固定模型卡、ms-marco-MiniLM-L6-v2 固定模型卡,分别对应编码与重排实现。 SciPy 开发者:1.13.1 bootstrap 文档,配对与百分位区间背景;本文分组算法为独立实现,不将其归为 SciPy 官方方案。
作者作品
以下是作者自有产品。除了科研写作,我也独立开发一些日常小工具,欢迎按自己的需要了解:
- 日常收支小记
:记录个人收支,安排预算和储蓄目标,让日常账目更有条理。在 App Store 了解。 - 一事微光
:根据当下的时间、精力选择小行动,记录完成后的感受,为日常行动和复盘留下一点线索。在 App Store 了解。