
 研报速递
本文用 Claude Code 复现摩根士丹利《MSASI 2.0:A股市场情绪与技术信号的全新解读》,研报讲的是怎样衡量 A 股的市场情绪。
使用模型:opus5.5. effort level: High
放在过去,要把它复现出来,怎么也得折腾一个多星期。这次我直接把它交给了 Claude 大人:读研报、写代码、查 bug、做检验,最后输出成一个网页——这么一大堆流程,几十分钟就做完了。
那人是不是就可以当甩手掌柜了?
也不完全是。这篇文章就用这个实操案例,讲讲人应该怎样参与进来,和 agent 一起把一份研报的策略复现出来。
一、研报说了什么
大摩挑了 12 个指标:成交额、两融余额、涨停家数等等。
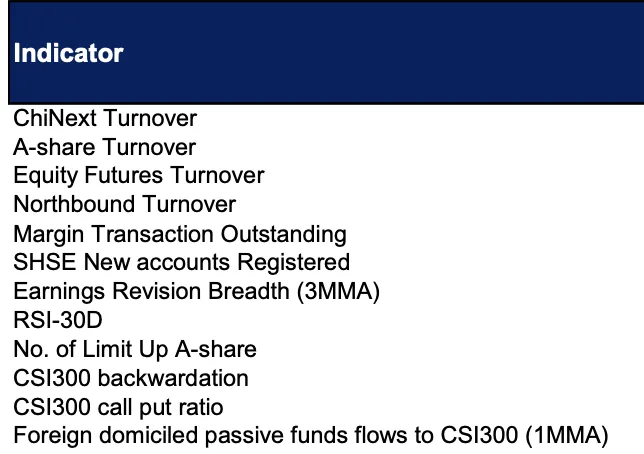
每个指标先做 100 天滚动的最大最小归一化; 再把这个分数与沪深 300 的价格回归,得到一个权重; 加权得出一个分数,再取一个月的均线,作为最终的情绪指数。
交易规则也很简单:
指数低于 22%:市场太悲观,反向做多,持有 70 天; 指数高于 78%:市场太乐观,反向做空。
研报说,单看做多,累计赚了 91%,胜率三分之二。看起来很不错,值得复现一下。
二、第一版
Agent 很快给出了 11 个文件,第一个版本就完成了。
这一步唯一需要提前和 agent 沟通的,是数据。
第一是数据源。Agent 喜欢调用 akshare 这类集成接口,写起来非常快。可是这类接口是从网页上直接抓数据,非常不稳定。所以要给它一个要求:尽量使用官方的接口。
第二是有些数据根本拿不到。比如北向资金净流入,2024 年 8 月就停止披露了;研报里的外资被动资金流,也没有免费的数据源。Agent 一般会给出一个替代方案,我们接受就可以了。
但这时候要做好一个心理准备:数据替代,就意味着复现结果和研报会有差异。
先看结果:复现出来的一个月均线,历史区间落在 7.5 到 87 之间;研报是 8 到 87。非常像样。
三、看起来像,不等于数据没问题
虽然看起来复现得很好,还是需要让 agent 再仔细检查一遍数据的细节。
很快就发现了问题:有一段时间,成交额连续 17 天记为 0。
这是免费数据源的缺陷。可这期间程序运行没有任何报错。
这类问题往往不会主动暴露,需要人提醒 agent 再去检查细节。
四、回测结果:和研报对不上
数据修好以后,看回测:
注:研报只给了累计收益,没有说明累计口径。按复利折算每笔约 4.4%,按简单平均约 6.1%。
相差太多了。
这种情况在研报复现里其实非常常见,原因一般有四个:
数据替代——前面说过的; 研报只给方法框架——实现细节需要自己推断; 回测的样本区间不同——换一段行情,结果就不同; 发表偏差——卖方公开出来的,往往是大量尝试当中效果最好的那一个。
所以我们来改进一下,看能不能更接近研报的结果。
五、改进之前,先给自己立一个原则:避免过度进化
Agent 每次回复,结尾几乎都会提出下一步的建议。它总能找到一个可以继续优化的方向,而且它不会拒绝你的要求。
如果我们把改进的目标定成"逼近研报的结果",或者"让回测更好看",那么每迭代一轮,策略就会更贴合这一段历史——本质上就是过拟合。
以现在 agent 的能力,只要你不停地试下去,总能找到一条非常漂亮的回测曲线。
所以事先要给自己定好规矩:
改动必须有逻辑依据; 迭代最好只控制在一到两轮; 如果最后结果仍然不理想,就接受这个结果,把策略放弃掉。
否则很容易得到一个回测看起来很好、实盘一塌糊涂的策略。
六、进化第一轮:确定指标的权重
研报里的权重,是按照历史数据回归算出来的。这里面有一个未来数据泄露的风险:相当于回测的时候,不自觉地先偷看了未来的行情。
为了避免这种风险,我们改用动态权重:以月为单位,只使用当时已知的数据,向前滚动计算。然后让 agent 去寻找更合理的、没有前视风险的定权方法。
又震惊瘫坐了。3 分 35 秒,它完成了 7 个步骤:加载回测规范、写公共模块、计算各个指标的预测能力、实现 8 种定权方案、做稳健性检查,最后给出结论。
先按研报的方法重做一遍,这次不偷看未来
结果:IC 是 −0.025,t 值 −0.88。
t 值衡量的是:这个相关性和随机噪音相比,有多明显。绝对值越大,越不是随机的运气。一般来说,绝对值超过 2,才有统计学上的意义。
0.88 的 t 值说明,这个指标和噪音分不开。也就是说,在不偷看未来的前提下,研报使用的 R² 定权方法,算出来的指标基本没有预测能力。
让 agent 诊断原因
它很快给出反馈:问题在 R² 的设计。
R² 相当于相关系数的平方。+0.6 和 −0.6,平方之后都是 0.36——方向的信息被丢掉了。
这个诊断非常有逻辑,不是单纯为了让回测更好看,可以采纳。
换一个更好的办法
在 agent 给出的 8 种方案对比里,表现最好的是主成分方法(PCA):IC −0.29,t 值达到 −3。
这个方法提取的是所有指标共同变动的方向,可以理解为"市场的热度"。它的优势在于完全不使用未来收益,所以过拟合的空间最小;这也是学术界构建情绪指数的常用做法。
虽然 PCA 是从 8 个方案里挑出来表现最好的一个,但它有理论依据,方法本身过拟合的风险最小,所以不能算作选择性偏差,可以接受。
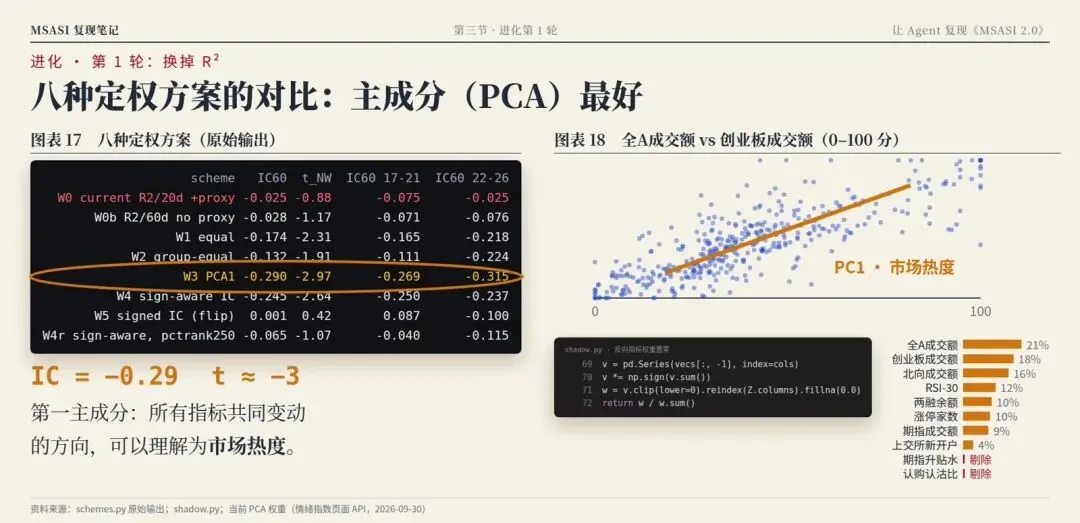
我们就以 PCA 的方法做动态权重。
七、进化第二轮:参数的调整
研报的规则是:低于 22% 做多,高于 78% 做空,都持有 70 天。
22、78、70,这三个参数是怎么得到的,研报里并没有具体说。尤其是 22、78 这种不是整数的数字,很可能是在历史数据上测出来的,让回测更好看。所以这三个参数值得检验一下。
阈值
交给 Claude 大人测试,它很快给出结果:阈值在 10 到 25、持有 40 到 120 天,这 12 种组合里有11 种,信号之后的收益都好过平均水平。
说明这个信号并不太依赖具体参数。那就直接让 agent 定一个参数。
它给出的做法是:找一片结果都差不多的平坦区间,取最小的改动,而不是挑分数最高的那个点。最后的结果:低位阈值 20,高位阈值 85。
OK, 接受。
持有时间
接下来 agent 测试了持有时间:固定持有 40 天、70 天、120 天,或者动态持有——等情绪值回到 50 的时候退出。
为了选出真正有效的方法,agent 还设计了一个安慰剂检验:把信号在时间上随机打乱 1000 次,按同样的规则交易,看真实的信号能不能好过这些靠运气的结果。
结果:
固定持有 70 天:和运气差不多(p = 0.24); 动态持有、回到 50 再退出:明显好于运气(p = 0.035),而且在不同的阈值设计、前后两段样本里都更好。
所以 agent 推荐用动态持有。但它自己也提醒:
"I tried about 7 rules, so p = 0.035 is suggestive rather than proof."一共试了好几条规则,这个结果只是看起来还不错,并不是实证。
"…but I wouldn't start tuning them. That's how you overfit one time series."阈值也不要再调了,否则就是过拟合。
Agent 自己已经有了规避过拟合的意识,还能设计出很好的随机性检验。人在这个过程中要做的,就是管住自己,不要强行加戏。Agent 说测到这里不要再继续了,我们就停止。
最终的规则与回测
情绪值低于 20:恐慌期,满仓; 情绪值高于 85:行情过热,空仓; 情绪值回到 50:恢复半仓。
回测一下,从 2017 年到今年 9 月,按这个仓位规则操作全 A 指数:
比一直满仓,收益更高,回撤更小一些。
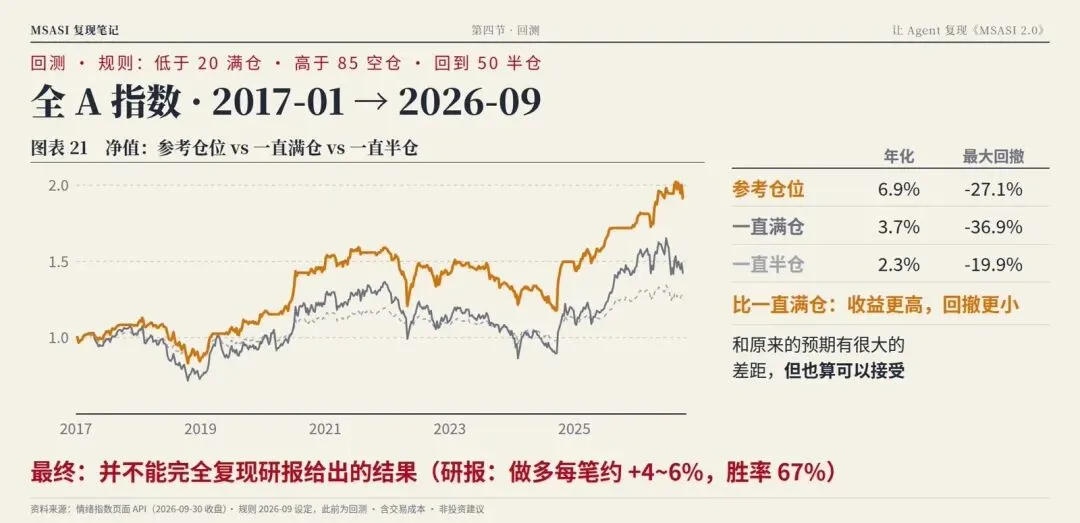
总体上当然和原来的预期有很大的差距,但也只能做到这样了。
最终,我们并不能完全复现研报给出的结果。
八、回顾:agent无敌以后,人做什么
Claude 大人完成了几乎所有的工作:读研报、接数据、写代码、排 bug、运行几十组对比检验、生成输出页面,而且每一轮都准备好了下一步。
人在这个过程中需要做的是:
控制住自己想要不断迭代下去、追求一个完美回测结果的欲望; 关注一些细节; 接受这个策略的不足,按它的特点来使用。
比如我们得到的这个情绪值,他的特点是:
它比较擅长识别市场恐慌低迷的状态,适合在这个期间分批加仓; 它的优势是降低回撤,而不是取得超额收益; 它在慢熊市场什么也做不了,无能为力。
所以它只能作为一个仓位参考,配合其他风险控制手段使用,而不能单独当作择时买卖点的独立策略使用。
总结一下,给 Claude 大人打工,人只需要做好:
准备好数据源; 理解统计量的真实含义; 提出有意义的敏感性分析; 避免过多的迭代。
当执行的成本趋近于零,人的价值就集中在三件事上:
提出问题,做出决策,知道何时停下来。
这个情绪指数每天更新,可以免费查看:a.owlpha.app("情绪"页)。
本文为研究记录与方法讨论,不构成投资建议。文中回测为历史模拟,含交易成本;规则于 2026 年 9 月设定,此前部分为回测。本文与摩根士丹利无关联。
下一期
现在复现一份大摩的研报,只需要 Claude 大人的一个下午。量化和投研的门槛,已经接近于零。
那么,普通人应该怎样用 agent 帮自己做投资?
下篇写这个,欢迎关注。

发表评论
发表评论: