
 研报速递
《WorkBuddy 实战全书》· 卷二 提效篇 · 第 5 章 文档与写作 · 第 2 节 字数:约 2200 字 | 阅读时间:7 分钟 事实基线:WorkBuddy V5.7.6(2026-10-04)
写研报、写标书,最怕的不是"写不出来",而是——写到第三章,发现第一章的术语和第二章的数据对不上。
前面的章节已经改了,后面的章节还在用旧口径;这一章叫"客户留存率",那一章又写成了"复购率"。改到怀疑人生。
问题从来不是"写得不够长",而是"写得乱"。
长文档的正确打法,不是硬着头皮往前写,而是——先拆成块,再让 AI 分头写,最后你来做汇合。 这就是下面要讲的"拆解—并行—汇编"三步法。
这套方法的底层逻辑只有一句:长文档的"乱",源于"一次处理的范围太大"。 把范围缩小到"一章""一节",质量和效率都会立刻回升。所以三步法的本质,是"分而治之"——把一个大到失控的任务,拆成一串小到可控的任务。
一、长文档难的不是"写长",是"写不乱"
短文档你可以一口气写完,长文档不行——它的体量远超你一次能顾得上的范围。
一旦硬写,必然出现三个毛病:
- 术语飘
:同一个概念,前后用了三个不同的叫法; - 数据错
:同一组数字,前后章引用的版本不一致; - 口径散
:开头定的结论,到了结尾自己都推翻了。
三步法就是冲着这三个毛病去的:
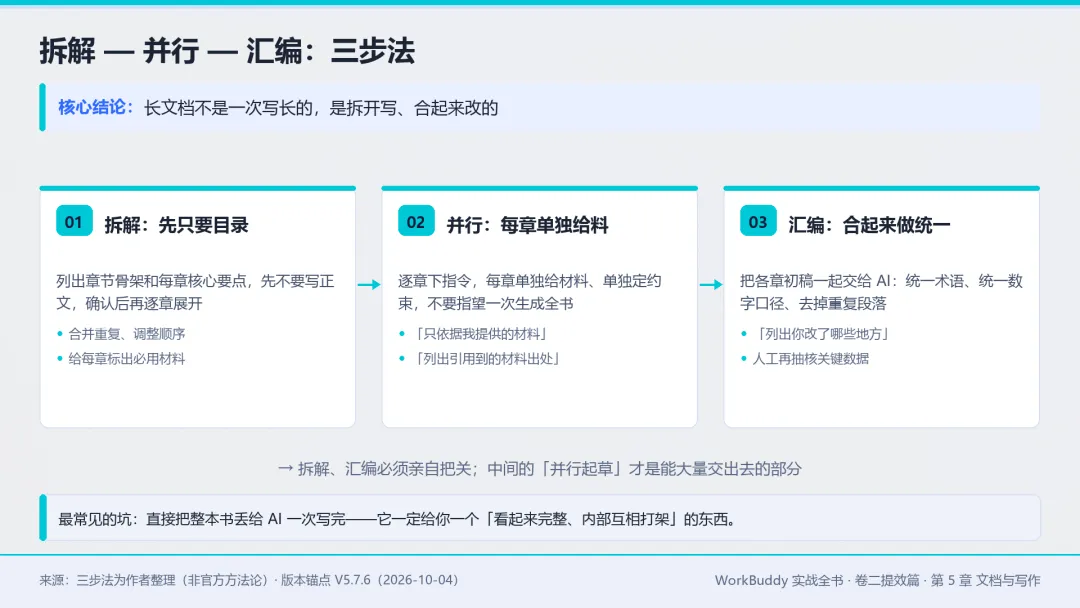
第一步 拆解——把长文档拆成章节骨架,先定好每章要写什么;第二步 并行——多章分头起草,每章单独给材料、单独定约束;第三步 汇编——把各章合到一起,统一口径、接好衔接、去掉重复。
记住一个判断:拆解和汇编这两步,一定要你亲自把关;中间的"并行起草",才是可以大量交出去的部分。
为什么会这样?因为拆解定的是"骨架对不对",汇编定的是"整体通不通"——这两件事都依赖你对全局的判断;而"并行起草"是把定好的骨架填上血肉,规则明确、边界清楚,正好是 AI 最擅长的部分。把"判断"留给自己的,"填充"交出去,这就是三步法最省力的分工。
二、第一步 拆解:先只要目录,别急着写正文
长文档最容易翻车的地方,就是一上来就让它写正文。
原因很简单:正文一动手,方向和结构就被"定死"了。等你发现第三章该合并、第五章该提前,前面全白写。
所以第一步,只要骨架,不要血肉。
一句话指令「我要写一份【文档名称】。先只给目录:列出章节骨架和每章的核心要点,先不要写正文,我确认后再逐章展开。」
变量怎么改:把"文档名称"换成你的实际文档——行业研报、投标文件、项目方案、毕业论文都行;"每章的核心要点"可以更具体,比如"每章列出 3 条必写内容"。
为什么一定要"先只要目录"? 因为确认一个目录,比确认十几页正文便宜得多。 骨架改一处,成本就是一行;正文改一处,成本可能是一整章。
拿到骨架后,你要做三件事:合并重复的章节、调整顺序、给每章标出必须用到的材料。 这一步做扎实,后面才有得省。
很多人的长文档之所以写崩,就是因为跳过了拆解,直接让 AI 写正文——写出来的东西结构混乱,改起来比重写还累。舍得在目录上花十分钟,是对后面几小时最大的保护。
三、第二步 并行 + 第三步 汇编:分头写,你来合
第二步 · 并行起草:每章单独下指令,单独给料。
不要指望"一次把全书生成完"。正确做法是逐章下指令,每章都给足材料:
一句话指令「现在写第【X】章,只依据我提供的材料,控制在【字数】以内,写完后列出你引用到的材料出处。」
变量怎么改:把 X 换成具体章号,字数按你的配比定(比如总 2 万字,十章,每章约 2000 字)。
两个关键约束别省:
- "只依据我提供的材料"
——防止它用通用知识填空,把研报写成通稿; - "列出引用到的材料出处"
——这是留给第三步做"数据一致性检查"的抓手。
第三步 · 汇编:把各章合起来,做三件事。
各章初稿写完,不要直接拼在一起。把结果一起交给 AI,让它做一次"统一":
一句话指令「下面是各章初稿,请做三件事:统一全文术语、统一数字口径、把重复的段落去掉,并列出你修改了哪些地方。」
变量怎么改:这一步可以更具体——如果你已经在第一步定好了术语表,可以直接写"统一到《术语表》里的叫法"。
"列出你修改了哪些地方"这半句很重要:它让汇编这一步也可核对,而不是"它说统一了,你只能信"。
第二步"并行"最大的好处,是"互不干扰"。 你处理第三章时,不必担心它顺手改坏了第一章——每章是独立生成的。等各章都到了同一水准,第三步"汇编"再把它们拉齐,就比"从头到尾一口气写"稳得多。 一句话:先把每章写对,再把整体写顺。
四、避坑:一致性检查,最容易败在"术语与数据"
长文档的最后一道关,是一致性检查。这关过了,文档才敢交。
要盯的,主要就两样:
一、术语要对齐。 同一个概念,全文只能有一个叫法。建议在第一步拆解时,就先定一份《术语表》(比如全篇统一用"客户留存率",不再出现"复购率""续费率"当同义词)。
二、数据要对齐。 同一个数字,全文只能有一个版本。并行起草时要求它"列出材料出处",就是为了这里能逐条核对——哪一章的数字和你手里的原始数据对不上,一眼就能查出来。
那这三步里,一致性分别在哪几个节点对齐?
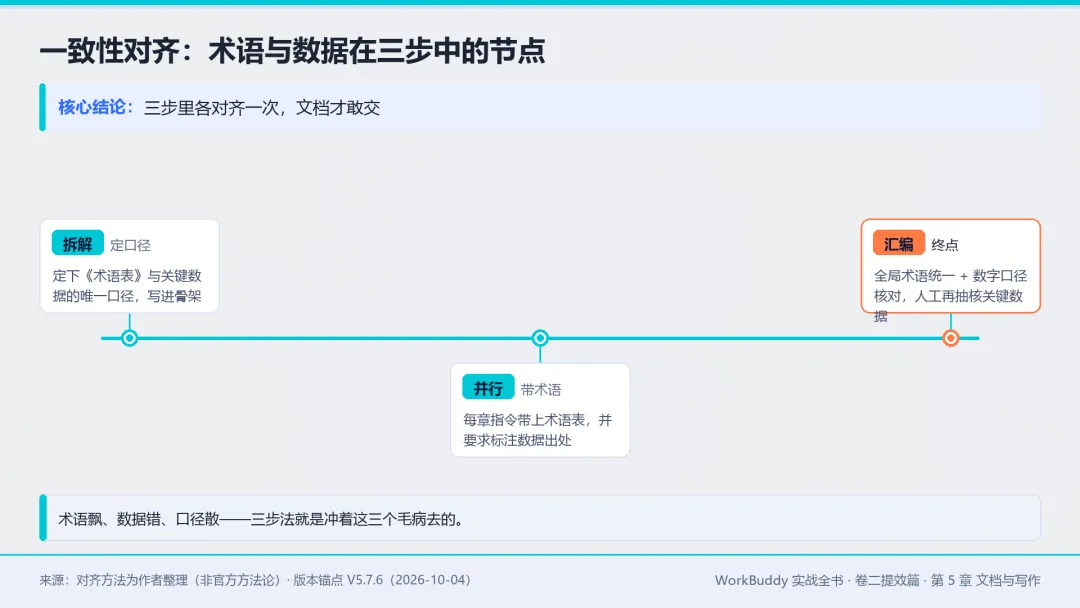
- 拆解时
:定下《术语表》和关键数据的"唯一口径",写进骨架; - 并行时
:每章指令里带上术语表,并要求标注数据出处; - 汇编时
:用一条指令做全局术语统一与数字口径核对,人工再抽核关键数据。
把这三步串起来看,你会发现:一致性不是"最后检查一遍"就能保证的,而是"从一开始就设计进去"的。 术语表在第一步定,第二步每章带入,第三步全局核对;数据同理。等写完了才想起"对一对",往往已经晚了。
最后一个坑,也是最常见的:直接把整本书丢给 AI 一次写完。 它一定会给你一个"看起来完整、内部互相打架"的东西。长文档不是"一次写长的",是"拆开写、合起来改的"。 记住这句话,你就已经避开了一半的返工。
写在最后
拆解、并行、汇编——三步法中,只有中间那步能大量交出去,前后两步得你把关。
今天不用挑几十页的大项目。找一份你正在写的中等长度的文档(十几页的都可以),按三步法跑一遍:先要目录、确认后逐章写、最后做一次汇编统一。跑完你会对"长文档也能拆着写"这件事,彻底改观。
短文档靠"快",长文档靠"稳"。下一节,我们把镜头拉回到"改"这个动作上——文档写完之后,怎么改,才不来回折腾。
📌 本节导航:上一节:行政运营必备:一句话起草纪要·方案·制度 | 下一节:「人机双写」怎么用:框选即改的操作法
🔖 配套附件:关注我,回复「workbuddy」领取本节附件《WB-5.2-长文档三步法SOP》
💬 点个「在看」,转给正在被研报、标书折磨的同事。
事实属性:官方事实 + 作者观点。("拆解—并行—汇编"三步法为作者整理,非官方方法论)

发表评论
发表评论: