
 研报速递
——当Token价格持续坍塌,GPU为何越来越贵?
一、引言:一个持续扩大的价格裂口
2026年的AI产业正在上演一场前所未有的价格分化。一方面,Token推理价格以惊人的速度坍塌——Silicon Data编制的LLM Token支出指数在9月初首次跌破每百万Token 1美元关口,报0.97美元,较5月底的2.04美元高点累计跌幅超过50%。另一方面,GPU租赁价格却在持续攀升。Silicon Data的B300指数截至9月23日已升至每小时6.95美元,较4月设立时上涨43.9%。与此同时,OpenRouter平台的周Token消耗量在9月底达到146万亿,较年初增长超过22倍。
“AI越用越便宜”与“算力越来越贵”这两个看似矛盾的趋势同时出现,正在重塑AI产业的底层经济逻辑。本报告基于OpenRouter的Token消耗数据和Silicon Data的GPU价格指数,对这一结构性矛盾进行系统分析。
二、OpenRouter Token数据深度解析
2.1 需求端:Token消耗的指数级扩张
OpenRouter平台的数据记录了AI推理需求的爆发式增长轨迹。2026年1月初,平台周Token消耗量仅为6.4万亿。到8月30日,这一数字达到113万亿,增长超过17倍;到9月27日进一步攀升至146万亿,环比增长13.2%。
这一增长并非线性扩张,而是呈现显著的加速特征。8月中下旬,平台消耗量连续三周创历史新高,单周增幅一度达到24%。增长的驱动力已从早期的聊天机器人对话转向Agent工作流、编程助手等高频、高Token消耗的应用场景。Hermes Agent以超过10万亿Token的周消耗量持续位居应用榜首,Claude Code以4.87万亿位列第二,编程和Agent工具占据了应用端的绝对主导地位。
2.2 供给端:中国模型的规模性主导
中国AI模型在OpenRouter上已形成压倒性的规模优势。截至9月27日当周,中国模型在Top20中占据10席,合计消耗71.87万亿Token,占比63.0%;美国模型占8席,合计26.61万亿,占比23.3%。中国模型在周使用量上超越美国同行已持续22周。
这一格局的形成并非依靠单一爆款模型。DeepSeek的V4.1 Flash以19.6万亿Token连续第二周位居第一,环比增长24%;智谱的GLM 5.3 Flash以16.3万亿位列第二,增长16%。中国厂商的竞争已从“单模型对单模型”升级为“厂商矩阵对厂商矩阵”——智谱旗下四款模型合计消耗26.18万亿Token,DeepSeek四款模型合计约30万亿,形成了以多价位、多版本覆盖不同需求层次的系统性竞争格局。
值得注意的是,中国模型的优势不仅体现在规模上,更体现在工程速度上。正如中国电子信息产业发展研究院专家所指出的,中国开发者在模型从测试到正式发布、用户迁移和多平台分发方面的速度优势,使得技术改进能够迅速转化为实际使用量。
2.3 价格竞争:从“性价比赛”到“价格战”
OpenRouter数据折射出的另一个关键趋势是模型层面价格竞争的急剧升级。腾讯将Hy3的输入单价从0.126美元下调至0.07美元/百万Token,降幅约44.4%;DeepSeek将主力V4 Flash 0731的单价进一步下调至输入0.0352美元/百万Token。OpenAI在9月发布GPT-6 Luna时,API价格较上一代促销价再降50%,并披露Luna在代码基准上的任务成本约为GPT-5.6 Sol的十分之一。
Meta推出的“数据共享版”Muse Spark 1.3 Contributor更是将定价策略推向极致——同一模型,输入输出价格约为标准版的1/12和1/21,代价是用户数据被用于训练Meta的模型。这种“以数据换价格”的模式,标志着模型层竞争已从单纯的技术比拼延伸至数据资产的争夺。
Anthropic的遭遇则提供了反面案例。Claude系列在OpenRouter Top20中的席位从一个月前的4席缩减至仅剩2席,合计份额不足3%。其排名滑落的时间点与8月海外价格战的爆发高度重合,凸显了在模型性能差距缩小的情况下,价格因素对开发者选择的影响力正在显著增强。
三、Silicon Data GPU价格指数解读
3.1 算力供给端的价格走势:全面上涨
与Token价格的持续下行形成鲜明对照,GPU租赁价格在2026年呈现全面上涨态势。Silicon Data的Neocloud H100指数从2.20美元升至2.64美元,涨幅20%;Neocloud B200指数从4.40美元跃升至5.35美元,涨幅22%;即便是Hyperscaler H100指数也上涨了3%,达到7.46美元。
最新一代的B300表现更为突出。B300指数自4月设立以来持续攀升,截至9月23日达到每小时6.95美元,累计涨幅43.9%。这一涨幅在GPU产品生命周期中并不寻常——按照传统规律,新芯片上市后价格通常会随供应改善而逐步回落,但B300的价格却在持续走高,反映出前沿算力容量的供给约束仍然严峻。
Silicon Data CEO Carmen Li对此的描述直截了当:“价格涨得相当离谱。”她指出,需求-供给失衡的压力贯穿整个AI技术栈——芯片、内存、电力和数据中心空间。
3.2 分层定价:Hyperscaler溢价与Neocloud波动
Silicon Data的指数体系揭示了一个重要的市场结构特征:同一款GPU在不同类型提供商之间存在显著的价格分层。
Hyperscaler(超大规模云厂商)环境中的H100租赁价格几乎是Neocloud(专业AI云服务商)的三倍。这种溢价对应的是客户为便利性、现有集成和容量保障所支付的费用。更重要的是,两个层级的价格行为模式截然不同:Hyperscaler的H100费率在一个十二美分的区间内保持了五十个交易日的稳定,变异系数仅为0.47%;而Neocloud层级的同款芯片则表现出更高的波动性,4月初从2.63美元跌至2.47美元的低点,一周内跌幅约6%,随后又恢复至2.59美元。
这种“同芯不同价、同芯不同波动”的现象,意味着企业在选择算力供应商时面临的不只是价格差异,更是风险特征的根本性差异。
3.3 远期曲线:算力正在成为可交易商品
2026年4月,Silicon Data推出了全球首个GPU远期曲线,覆盖36个月的时间跨度,为算力市场引入了期限结构和隐含远期利率的概念。这一金融工具的出现标志着算力市场正在经历从“技术采购”到“资产管理”的范式转变。
早期数据揭示了一个反直觉的发现:长期GPU合同相对于按需定价并没有显著折扣,在某些情况下甚至以溢价交易,表明买方正在将容量确定性置于成本节约之上。在传统商品市场中,远期曲线通常用于套利和风险管理;GPU远期曲线的出现,意味着算力正沿着能源和大宗商品的路径,逐步演变为一种可交易、可对冲的金融资产类别。
CME Group已宣布将于2026年10月在NYMEX上线以Silicon Data的H100和B200租赁指数为基准的算力期货合约,这将是算力资产金融化进程中的里程碑事件。
四、算力市场的结构性矛盾:三重“剪刀差”
4.1 第一重剪刀差:Token价格与GPU价格的背离
Token价格与GPU租赁价格的背离是2026年AI经济中最引人注目的现象。Silicon Data的LLM Token指数从5月28日的2.07美元峰值降至9月21日的1.00美元,而同期其计算租赁系列数据显示H200、B200和B300等稀缺GPU的租赁价格持续攀升。
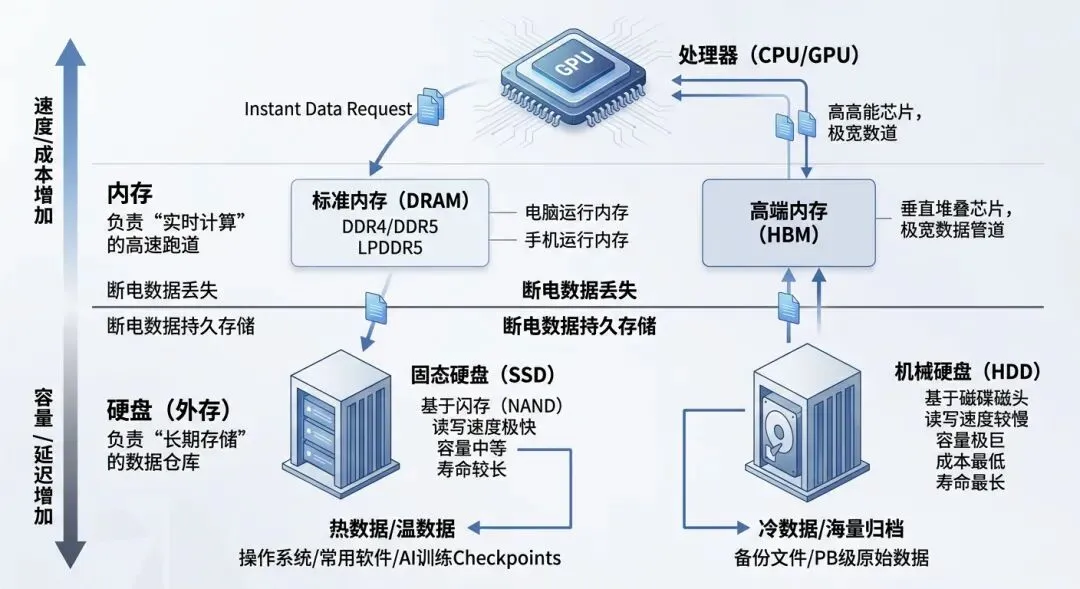
这一背离的成因在于两个市场运行在不同的竞争逻辑之下。Token市场受益于模型架构效率的持续提升——混合专家架构、注意力机制优化、低精度训练等技术的普及,使得同等智能水平的推理成本被大幅压缩。而GPU市场则受制于物理基础设施的刚性约束——先进制程芯片的产能、HBM内存的供应、数据中心的电力和冷却容量,这些要素的扩张速度远慢于模型效率的提升速度。
4.2 第二重剪刀差:用量增长与单位价值下降
OpenRouter数据显示,平台Token消耗量在8个月内增长近14倍,但单位Token的价格却在持续走低。这意味着API提供商的收入增长必须追赶一个不断缩小的单位经济模型。
对于模型层公司而言,这一剪刀差的含义是严峻的。Syz Group首席投资官Charles-Henry Monchau的分析切中要害:基础模型实验室受到直接冲击最大,“Token价格通缩会压缩营收,但运算资源的承诺成本却维持固定”。收入端通缩与成本端刚性的组合,正在系统性侵蚀模型层公司的利润空间。对于正在冲刺IPO的OpenAI和Anthropic而言,这构成了招股说明书中最难向投资者解释的部分。
4.3 第三重剪刀差:中国供给效率与美国成本结构
中美AI产业在算力经济上正形成两种截然不同的模式。中国模型厂商通过架构创新、开源策略和极致的工程效率,将推理成本压缩至全球最低水平。DeepSeek采用因果编码器-解码器架构,总参数552B但激活仅8B/16B,配合100万Token上下文,实现了极低的推理成本。中国头部模型几乎全部开放权重,开发者可以免费私有化部署,API定价由此失去溢价空间。
美国厂商则面临不同的约束条件。OpenAI和Anthropic的收入高度依赖API调用和订阅费用,成本端却锁定了长期的算力采购承诺。在模型性能差距缩小的情况下,美国厂商的定价空间被中国开源模型的系统性成本优势持续压缩。两者的对策也呈现分化:美国厂商试图“向上走”,依靠订阅制和企业级服务对冲API降价;中国厂商则“向下扎根”,以规模和效率构建壁垒。
五、深度分析:算力金融化与产业权力结构的重塑
5.1 算力从“成本项”到“资产类别”的跃迁
GPU远期曲线和算力期货的推出,标志着算力正在经历一场根本性的身份转变。在传统AI产业中,GPU是资本支出中的折旧项,其价值随时间递减。但在金融化框架下,算力成为具有期限结构、可对冲、可交易的资产类别。
这一转变对产业参与者具有深远影响。对于算力买方而言,远期曲线提供了评估“自建还是租赁”决策的量化框架——CTO和CFO可以基于同一张图表来讨论资本配置。对于金融机构而言,算力期货为AI基础设施投资提供了风险管理工具,使得养老金、保险资金等长期资本能够更安全地进入AI基础设施领域。对于GPU持有者而言,算力资产的金融化意味着其资产负债表的透明度和流动性都将提升。
但金融化也带来了新的风险。远期曲线显示,长期合同相对于按需定价没有显著折扣甚至存在溢价,这暗示市场对算力供给的长期预期仍然偏紧。如果AI需求增速出现超预期放缓,算力价格的调整可能通过金融杠杆被放大,形成类似能源市场的波动性传导。
5.2 Token经济学中的“虚假信号”
一个需要警惕的认知陷阱是:Token平均价格的下降不应被简单解读为AI服务正在变得“便宜”。Silicon Data的Token指数是按使用量加权的实际支付价格,而非总支出或总消耗量。该指数下降的一个重要驱动因素是使用结构的迁移——更多的日常工作任务被路由到中低端模型,而高价值工作负载仍然依赖前沿模型。
这意味着Token平均价格的下降在某种程度上是一个“合成指标”:它是低价模型用量占比提升的结果,而非所有模型同步降价的反映。对于企业用户而言,真正重要的指标不是平均Token价格,而是特定任务在特定模型上的总拥有成本。随着Agent工作流的普及,单次任务的Token消耗量可能达到传统对话的数倍甚至数十倍,总成本反而可能上升。
5.3 中国模型的规模优势能否持续?
中国模型在OpenRouter上的主导地位建立在三个支柱之上:极低的推理成本、快速的产品迭代节奏、以及多价位模型矩阵的覆盖能力。但这三重优势都面临潜在挑战。
推理成本优势的可持续性取决于架构创新能否持续领先,以及开源生态的“公地悲剧”是否会出现——当所有厂商都依赖开源模型时,谁来进行下一代基础架构的研发投入?快速迭代优势则取决于工程人才储备和迭代文化的延续,以及监管环境的变化。多价位矩阵的优势可能被“自相蚕食”所削弱——当同一厂商的多款模型在同一价格带竞争时,增量消耗可能来自内部转移而非净增长。
更深层的问题在于,Token消耗量本身并不等同于商业价值。正如行业专家所指出的,下一阶段的挑战是将成本优势转化为可靠的服务、更强的开发者生态和更高价值的企业应用。在这方面,Anthropic的路径提供了参照:尽管其模型在OpenRouter的Token消耗排名中持续下滑,但Claude Code在编程和Agent等高价值场景中仍保持强劲竞争力,说明“规模”和“价值”可以是两个独立的竞争维度。
六、结论与展望
2026年AI算力市场的核心矛盾可以概括为:模型层的效率革命正在以快于基础设施扩张的速度压低Token价格,而物理世界的供给约束却使得算力资产的稀缺性持续上升。这两个趋势短期内难以收敛,将共同塑造未来12-18个月的产业格局。
对于模型公司而言,关键课题是在Token价格通缩的环境中建立可持续的利润模型。纯粹依赖API调用量的规模逻辑将越来越难以为继,差异化必须来自特定场景的深度优化和垂直整合能力。对于算力提供商而言,金融化工具的引入使得算力资产的定价效率将提升,但同时也要求更精细的风险管理能力。Hyperscaler与Neocloud之间的定价分层可能进一步扩大——前者凭借集成便利性和容量保障获取溢价,后者则以价格和灵活性竞争。
对于投资者和企业决策者而言,最重要的认知转变或许是:在AI时代,Token价格不是衡量AI成本的有效指标,算力资产的获取成本和风险结构才是。当算力期货合约在CME上线后,算力市场将拥有第一个公开的价格发现机制,这将为整个产业的资本配置提供远比Token消耗量更可靠的信号。

发表评论
发表评论: