
 研报速递
(完整版.pdf ) 以下仅展示部分内容 下载方式见文末
【福利力荐】人工智能产业链联盟推荐副业,创始人实测有效:零成本分享网盘,在家就能赚收益,长期有效!
从“烧钱训练”到“省钱推理”,AI产业正在经历一场静悄悄的革命。
如果说2023年是“百模大战”的元年,那么2026年则是大模型真正走进各行各业、接受商业检验的关键年份。过去,大家的目光都聚焦在如何训练出一个更强的模型;而现在,真正的挑战变成了:如何让这个“庞然大物”在实际业务中跑得起来、跑得快、还花得起?
近日,中国信息通信研究院与中国人工智能产业发展联盟联合发布了《大模型推理优化关键技术及应用实践研究报告(2026年)》。这份报告不仅是一份技术指南,更像是一份大模型时代的“省钱攻略”和“落地地图”。
今天,我们就来深入解读这份报告,看看AI产业链上的玩家们,是如何通过“花式”优化,把大模型的推理成本打下来的。
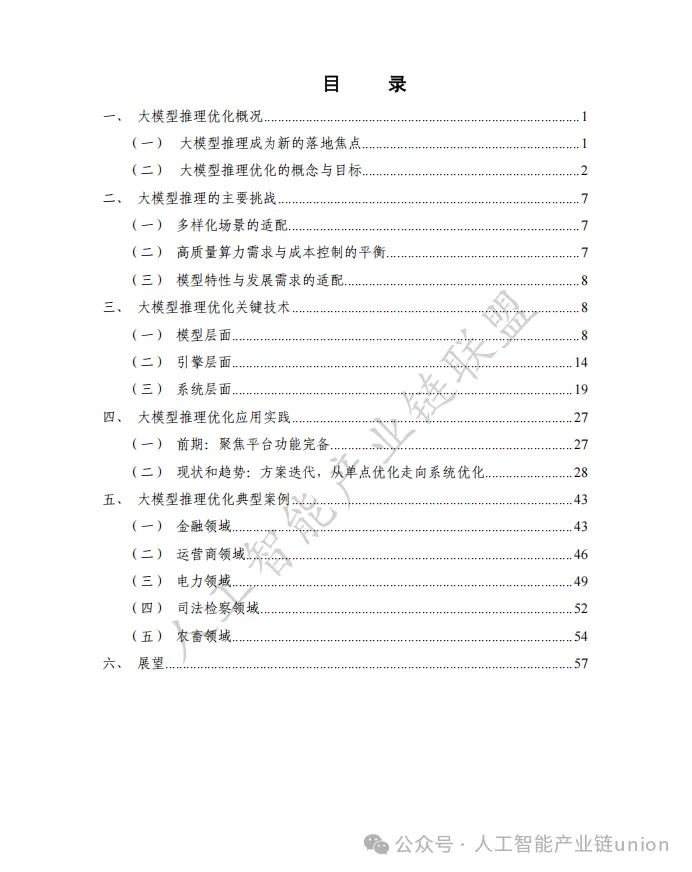
一、推理:大模型商业化的“最后一公里”
报告开篇就点明了一个趋势:AI的焦点正在从“训练”转向“推理”。
训练大模型是一次性的“烧钱”投入,比如训练GPT-4可能花费上亿美元。但推理是持续的“花钱”——每一次用户提问、每一次AI回复,都在产生计算成本。
• 需求爆了: OpenAI的报告显示,过去一年企业版API的Token消耗量暴增了320倍。 • 上下文长了: 从最早的4K(千字)上下文,到现在主流的128K,甚至更长,这意味着模型要处理的信息量呈指数级上升。 • 成本转移: OpenAI在2024年的推理预算高达23亿美元,是训练成本的15倍之多。
专业解读: 如果说训练是“造车”,推理就是“开车上路”。车造得再好,如果油耗太高(推理成本高)、速度太慢(推理延迟大),也没法跑长途运输(大规模商业化)。因此,“省油”(优化推理)就成了产业界的头等大事。
二、破解“不可能三角”:效果、性能与成本的博弈
大模型推理最难的地方在于要平衡三个互相制约的目标:效果(准不准)、性能(快不快)、成本(省不省)。
报告将其总结为三大核心挑战:
1. 场景多样化: 智能客服要低延迟(秒回),内容工厂要高吞吐(量大),长文档分析要显存大。一套方案很难打天下。 2. 算力鸿沟: 高性能的GPU(如H100)太贵,且一卡难求。如何利用好现有的存量GPU、甚至CPU,是门大学问。 3. 模型进化快: 从Dense(稠密)模型到MoE(混合专家)模型,模型架构在变,推理系统也得跟着变。
三、黑科技拆解:如何让大模型“跑”得更快?
报告详细梳理了从模型层 -> 引擎层 -> 系统层的三级优化体系。我们可以把它们理解为:让模型本身更轻便、让计算过程更高效、让整个系统配合更默契。
1. 模型层:给大模型“瘦身”
• 量化(Quantization): 把模型参数的精度从“高精度浮点数”降为“低精度整数”。好比把一张超高清的4K图片压缩成720P,画质损失一点点,但文件大小和加载速度快了好几倍。 • MoE(混合专家)架构: 这是目前最火的架构(DeepSeek、Grok均采用)。它不再让整个模型处理所有问题,而是派一个“门卫”(门控网络)看情况,只激活最相关的几个“专家”模块来处理。结果是:模型总参数很大,但每次推理的计算量很小。
报告金句: “专家细粒度分割与动态负载均衡是MoE模型的主要优化趋势。”
2. 引擎层:让计算“滴水不漏”
引擎层是连接模型和硬件的“司机”,负责把计算指令高效地下发给GPU。
• PagedAttention: 这是vLLM框架的核心技术。它借鉴了操作系统的虚拟内存机制,把KV Cache(可以理解为模型的“工作记忆”)分成小块,不再需要连续的大块显存。这就像内存管理一样,有效解决了显存碎片化问题,显存利用率提升3倍以上。 • Continuous Batching(连续批处理): 传统批处理要等所有请求都算完才统一返回,慢请求会拖死大家。连续批处理是“来一个算一个,算完就走”,动态插队,极大提升了GPU的忙碌程度。
3. 系统层:架构重构的“降维打击”
这是报告认为的未来决胜点,引入了解耦架构。
• PD分离(Prefill-Decode Disaggregation): 大模型推理分两步:先“阅读理解”(Prefill,计算密集型),再“逐字回复”(Decode,访存密集型)。以前这两步绑在一起,互相抢资源。PD分离就是把它们拆开,用高算力卡做Prefill,用高显存卡做Decode,各司其职,效率翻倍。 • AF分离(Attention-FFN Disaggregation): 针对MoE模型的进阶玩法。把“注意力”(访存密集)和“前馈网络”(计算密集)也拆到不同机器上跑。报告提到,字节跳动的MegaScale-Infer和阶跃星辰的Step-3都在实践这一思路,单位成本吞吐量最高提升224%。
四、实战出真知:四大行业案例盘点
报告选取了金融、运营商、电力、司法四个领域,展示了推理优化带来的实实在在的价值。
1. 金融领域:从“推不动”到“推得快”
• 痛点: 处理长文档(会议纪要、研报)时,经常超过32K上下文限制,或者响应时间超过30秒。 • 方案: 引入KV Cache持久化技术,把常用的金融知识库提前“预热”存好,避免重复计算。 • 效果: 推理时延从15分钟缩短至90%(即缩短到1.5分钟左右),智能助手从“答非所问”变成了“精准连贯”。
2. 运营商领域:九天平台的“训推一体”
• 痛点: 训练和推理链路不通,模型部署周期长;PD混部导致资源利用率低。 • 方案: 中国移动的九天平台采用“训推一体”架构,白天推理、晚上训练,把GPU榨干。 • 效果:部署周期缩短至天级,单卡吞吐量提升1倍以上。
3. 电力领域:中压配网的“场景感知”
• 痛点: 检修计划推理耗时过长,错过作业窗口期。 • 方案: 针对常规检修、故障抢修等不同场景,动态调整批处理大小和并行策略。 • 效果: 解决了长上下文处理难题,实现了设备全生命周期数据的推理,故障预判更准,漏检率大幅下降。
4. 司法检察:“以存助算”破解卷宗难题
• 痛点: 海量卷宗分析,信息孤岛严重。 • 方案: 利用高性能存储作为缓存池,将预处理的KV Cache存入高速存储池,推理时直接调用。 • 效果:TTFT(首字延迟)降低40%,吞吐量提升5倍,法律文书生成质量大幅提升。
五、未来展望:AI进入“协同优化”时代
报告最后指出,未来的推理优化不再是某个单点技术的突破,而是**“模型-架构-场景”的协同进化**。
• 硬件层面: 不再只靠GPU硬抗,CPU、DRAM、SSD将组成多级存储体系,用便宜的存储空间换取昂贵的显存(以存换算)。 • 技术层面:PD分离和AF分离将成为标准架构,适配MoE和多模态模型是刚需。 • 成本层面: 报告提到DeepSeek的理论成本利润率可达545%。虽然这是理论值,但足以说明推理优化能直接变成利润。
结语
《大模型推理优化关键技术及应用实践研究报告(2026年)》清晰地告诉我们:大模型的竞争,已经从“有没有”进入到“好不好用、贵不贵”的阶段。
对于企业和开发者而言,现在不仅要选好模型,更要学好如何部署和优化推理。谁能把Token的成本打下来,谁就能在AI应用的普及浪潮中占据先机。
互动话题: 你在使用AI应用时,遇到过因响应太慢或收费太高而放弃的场景吗?欢迎在评论区留言讨论!
本文数据与观点来源:中国信息通信研究院、中国人工智能产业发展联盟《大模型推理优化关键技术及应用实践研究报告(2026年)》。
☟☟☟
☞人工智能产业链联盟筹备组征集公告☜
☝
篇幅有限,部分展示 加入会员,任意下载 资料下载方式
Download method of report materials
关注公众号后回复:YH260828 即可领取完整版资料 
荐: 【中国风动漫】《姜子牙》刷屏背后,藏着中国动画100年内幕! 【中国风动漫】除了《哪吒》,这些良心国产动画也应该被更多人知道!
【中国风动漫】《雾山五行》大火,却很少人知道它的前身《岁城璃心》一个拿着十米大刀的男主夭折!

如需获取更多报告
报告部分截图
编辑:Zero

文末福利
1.赠送800G人工智能资源。
获取方式:关注本公众号,回复“人工智能”。
2.「超级公开课NVIDIA专场」免费下载
获取方式:关注本公众号,回复“公开课”。
3.免费微信交流群:
人工智能行业研究报告分享群、
人工智能知识分享群、
智能机器人交流论坛、
人工智能厂家交流群、
AI产业链服务交流群、
STEAM创客教育交流群、
人工智能技术论坛、
人工智能未来发展论坛、
AI企业家交流俱乐部
雄安企业家交流俱乐部
细分领域交流群:
【智能家居系统论坛】【智慧城市系统论坛】【智能医疗养老论坛】【自动驾驶产业论坛】【智慧金融交流论坛】【智慧农业交流论坛】【无人飞行器产业论坛】【人工智能大数据论坛】【人工智能※区块链论坛】【人工智能&物联网论坛】【青少年教育机器人论坛】【人工智能智能制造论坛】【AI/AR/VR/MR畅享畅聊】【机械自动化交流论坛】【工业互联网交流论坛】
入群方式:关注本公众号,回复“入群”
戳“阅读原文”下载报告。

发表评论
发表评论: