
 研报速递
选数据库常被当成软件偏好题。有人偏爱某一款,有人跟着团队走,有人看招聘需求。
但如果把主流开源数据库的存储层拆开,会看到一个不太一样的图景:它们回答的是同一组物理问题,只是答案不同。磁盘一次随机寻道要几毫秒、一页能装多少行、索引能占多少内存——这些量级不因软件品味而变。
本文按五条物理约束切分,每章只问一个问题,然后把行存、列存、LSM、文档、图、搜索、时序各类数据库拉到同一张桌上对照。
读法说明:本文的数据分两类。一类能回原文核实——论文原文引述、官方文档参数、项目 LICENSE 原文,均标注来源与年份。另一类是作者归纳的定性判断(例如「某类结构在 RUM 三角中大致偏哪一角」),会在正文与图注里明确标出「推断」,不与事实混写。
01 · 写入要落在哪里:顺序写与随机写
数据库最基础的物理事实是:磁盘顺序写远快于随机写。这不是软件优化出来的差异,而是存储介质本身的特性——顺序写不需要移动磁头,也能被操作系统与 SSD 的预读机制放大成更大的 I/O。
这条约束直接催生了两个设计。
先写日志,再改数据
几乎所有事务型数据库都用同一个手法:把变更先顺序追加到一份日志里,再慢慢把数据页改到目标位置。这样即使中途断电,也能靠日志重放出未完成的部分。
PostgreSQL 官方文档描述了它对应的文件布局:每个表和索引各存为一个独立文件,表超过 1 GB 会切成多个 GB 级 segment;每张表还带两个附属文件——空闲空间映射(后缀 _fsm)和可见性映射(后缀 _vm),后者记录哪些页已经确认没有死元组。[1]
超长字段另外处理。官方文档的原话是「拥有潜在超大字段的表会带一张关联的 TOAST 表,用于把大到无法留在表行内的字段值做行外存储(out-of-line storage)」。[1]
把随机写攒成顺序写
另一条路是彻底改变写入形态。1996 年 O'Neil 等四人在《The Log-Structured Merge-Tree》里给出了后来被广泛沿用的方案,论文的动机写得很直白:
论文原文(LSM-Tree,1996)
「像 B-tree 这样的标准磁盘索引结构,实际上会让这笔事务的 I/O 成本翻倍,把系统总成本推高最多百分之五十。」[2]
论文提出的机制是「延迟并批量处理索引变更,把变更从内存组件向一个或多个磁盘组件级联(cascading),方式类似归并排序」。[2] 具体动作叫 rolling merge:内存组件里的条目攒到接近阈值时,就把其中一段连续条目删下来、合并进磁盘上的组件。[2]
这套设计的代价论文自己写明了:「需要立即响应的索引查找,在某些情况下会损失 I/O 效率」。[2] 换句话说,写入路径的优化,是用读取路径的确定性换来的。
时序场景里更极端的取舍
如果把「写入极快」推到极致,就得放弃一部分读取精度。Facebook 的 Gorilla 系统面向监控场景,它的设计假设是:
论文原文(Gorilla,VLDB 2015)
「监控系统的用户并不太在意单个数据点,而在意聚合分析;同时新数据点的价值远高于旧数据点。」[3]
基于这个假设,Gorilla 用两种编码压缩时序数据:时间戳用 delta-of-delta,浮点值用 XOR。实测效果是把每个数据点压到平均 1.37 字节,体积降到原来的十二分之一;存储降到十分之一后数据能全部放进内存,官方报告查询延迟降低 73 倍。[3]
本章的代价清单
这张表已经露出了后文的线索:每种写入优化,都在别处记了一笔账。这笔账的严格形式要到最后一章的 RUM 猜想才讲完。
02 · 索引要占多少内存:稠密与稀疏
第二条约束是内存。索引的目的是避免全表扫描,但如果索引本身大到放不进内存,每次查询都要先把索引从磁盘读进来——索引反而成了负担。
这把选择逼成了一个纯粹的数量问题:每行记一个索引项,还是一批行记一个?
ClickHouse 的答案:8192
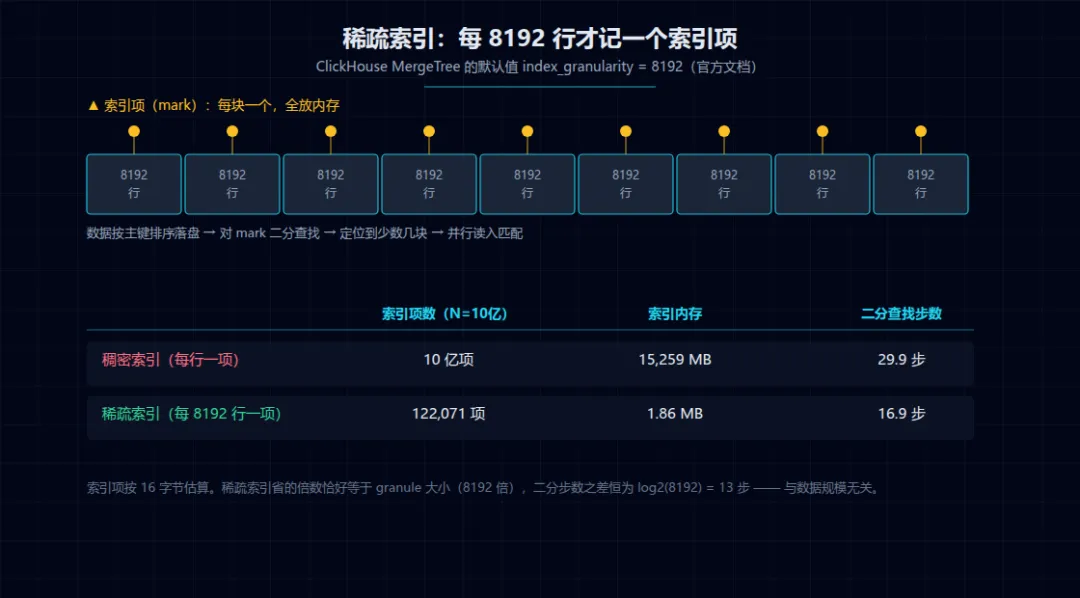
ClickHouse 的 MergeTree 引擎选了后者。官方文档的原话:
官方文档(ClickHouse MergeTree)
「主键并不引用单行,而是引用被称作 granule 的 8192 行组成的块。这使超大数据集的主键依然小到足以常驻内存,同时仍能快速访问磁盘数据。」[5]
官方把它叫稀疏索引(sparse index)。查找路径是对索引项做二分查找,定位到少数几个可能匹配的 granule,再把这些 granule 并行流式读入做匹配。[6]
按下这个数字,可以算清它换来了什么。
稀疏索引省下的恰好是 granule 倍
设表有 行,granule 大小为 ,则稀疏索引的项数与稠密索引的项数之比为:
代入 ClickHouse 的默认 ,稀疏索引的项数约是稠密索引的 1/8192。更值得注意的是这个倍数与数据规模无关——只要 granule 不变,省下的比例恒为 。
用具体数字看更直观。按每项 16 字节(8 字节 key + 8 字节偏移)估算:
10 亿行时,稠密索引要 15 GB 内存,稀疏索引只要 1.86 MB。这个差距解释了为什么 ClickHouse 敢在十亿行级表上把主键常驻内存。
二分查找步数只差恒定的一截
索引项少了,查找会慢多少?二分查找的步数是项数的对数,两者之差为:
代入 ,差值是 步。这个差值同样是常数:数据从 100 万行涨到 100 亿行,稠密与稀疏的二分步数差距始终是 13 步。
两表合起来是一个相当干净的结果:稀疏索引用「多 13 步二分」换掉了「8192 倍的内存」。而这 13 步是在内存里做的,代价远低于把 15 GB 索引换出内存。
代价并没有消失,只是转移了
这不是缺陷,而是稀疏索引的必然后果:索引只告诉你「目标大概在哪一块」,没法告诉你「块内第几行」。多读的那些行,就是定位精度的价格。
本章的代价清单
官方文档里还有一个对照值得一提:B-tree 的分支因子通常在几百到几千,在 887 万行、分支因子 1000 的例子中,平均需要 2.3 次磁盘寻道。[6] 把 、 代入 ,得 2.316——与官方给出的 2.3 吻合。这个公式会在第五章展开。
03 · 扫描要读多少字节:行存与列存
第三条约束是扫描。分析型查询常常只碰少数几列——算一个均值、看一个分布、按两列分组——但表可能有几十上百列。
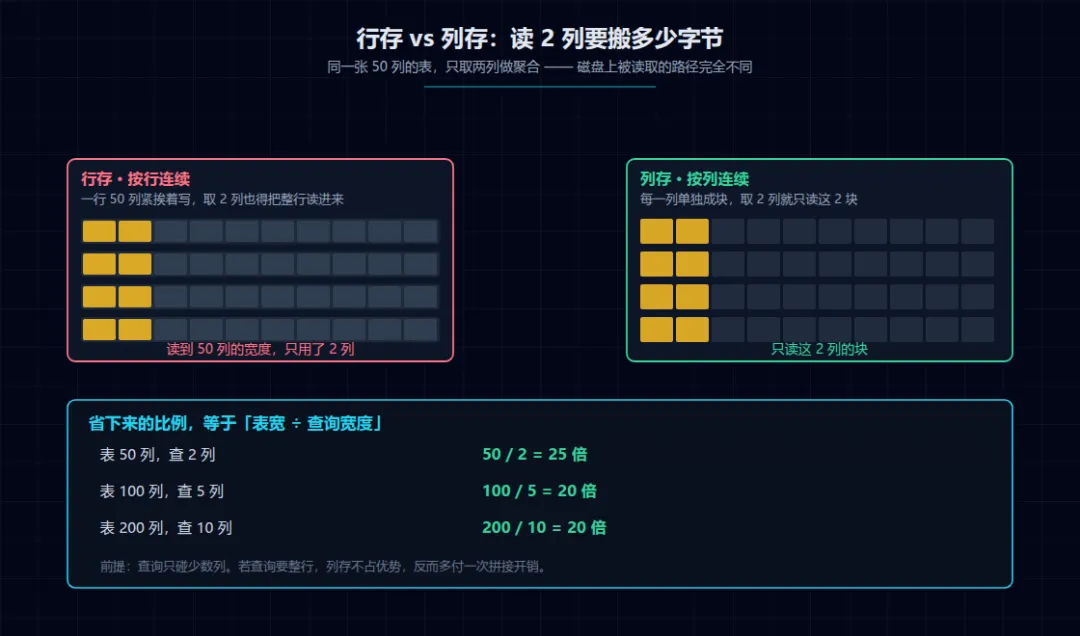
行存的问题在这里暴露:一行里的所有列紧挨着写在一起,要读第 3 列和第 7 列,就得把整行(含其余 98 列)都从磁盘搬进来。列存把同一列的数据连续存放,读两列就只读两块。
省下来的比例可以写成一行公式
设表有 列,每列平均宽 字节,查询涉及其中 列,表有 行。
行存需要读取的字节数是全部列的宽度:
列存只读被涉及的列:
两者之比即节省倍数:
表宽除以查询宽度。代入几组常见参数:
这个公式也说明了列存不总是赢:如果查询要取回整行(
列式为什么还能压得更小
连续的同类数据比混杂的行数据更好压。DuckDB 的轻量压缩文档描述了它在列上按块(最多 1024 个值)判断编码方式,可选方案包括常量编码(Constant)、游程编码(RLE)、字典编码、帧参照(Frame of Reference)以及 bit packing。[7]
这些编码各自针对一种数据形态。以「字典编码」为例:如果一列只有几十个不同取值(如贷款状态、产品类型),就把这些取值编号后按整数存储,列的实际宽度从字符串长度降到几比特。RLE 则对连续重复值直接记「值 + 重复次数」。
格式层面的规范化
列存要跨系统使用,就得有统一的字节布局。Apache Arrow 的格式规范给出了几项关键约定:用有效位图(validity bitmap)标记空值,用偏移量(offsets)表示变长数据,各列独立成缓冲。[8]
规范明确把「零拷贝」与「O(1) 随机访问」作为设计目标。[8] 这两条目标解释了它为什么按列独立缓冲:切换到下一行时,每列的偏移位置可以各自独立推进,不需要把整行数据搬来搬去。
表格格式解决的是另一层问题
文件格式(Parquet/Arrow)管「一个文件内部怎么排」,表格式管「一堆文件怎么组织成一个表」。Apache Iceberg 的规范把隐藏分区、快照(snapshot)、清单(manifest)、乐观并发列为核心特性,并在清单中记录内容统计(content stats)、字段统计与边界值(bounds)用于查询裁剪。[9]
规范按版本演进:v2 支持行级删除(row-level deletes),v3 扩展类型能力,v4 涉及元数据结构与表示。[9] 「行级删除」这个演进方向值得注意——它是列存文件不可变这一特性的补丁:文件写完不改,那要删一行怎么办?答案是另外记一份删除标记。
本章的代价清单
表 6 的最后两行指向下一章:列存的强项在扫描和压缩,弱点在更新——而这恰好是行存与 LSM 系的强项。
04 · 更新要付什么:原地与差分
第四条约束是更新。数据写完不是结束,真实系统里数据一直在改:账户状态变了、订单撤销了、客户信息更新了。
问题在于,绝大多数存储结构的优化都建立在「数据不可变」或「顺序追加」之上。要支持更新,就得额外付出代价,而代价的形式取决于你选了哪条路。
路径一:原地改,用可见性映射收拾残局
PostgreSQL 的做法是保留旧版本的行,用可见性映射(_vm 文件)记录「哪些页已经确认没有死元组」。[1] 这带来一个持续的后台负担:死元组会累积,需要清理,而清理本身要读页、要写页。
这是对「事务可见性」这个需求的直接付款方式:为了让并发事务各自看到一致的历史快照,旧版本必须保留一段时间。
路径二:不改,只追加新段
Elasticsearch 的选择更彻底。官方文档的原话是:「在一个 shard 内部,数据被组织为不可变段(immutable segments),它们随文档被索引而写出。」[4]
不可变带来两个直接好处:段一旦写完就可以被并发读取而无须加锁,段内容也天然适合压缩。代价同样明确——文档「更新」其实是旧版本标记删除 + 新版本写入新段,段数量会持续增长,必须靠后台合并收拾。
官方文档还给出另一层结构:每个索引切成多个 shard 分布到集群节点,每个 shard 是一个自包含的 Apache Lucene 索引;副本 shard 提供容错,在某个节点响应失败时仍能提供数据。[4]
路径三:差分结构,把更新攒起来
回到 LSM。RUM 论文在解释「为最小化更新代价该怎么做」时,给出的正是这条路:
论文原文(RUM Conjecture,EDBT 2016)
「为了最小化更新数据的成本,人们会采用基于差分结构(differential structures)的设计,让许多查询能够合并更新,避免重组数据的开销。」[10]
LSM 的 rolling merge 就是差分结构的具体实现:更新先落在内存组件,攒到阈值再批量合并到磁盘。[2]
三种更新路径的对照
三条路径的代价落点不同,但都指向同一个事实:没有哪种结构能同时把读、写、空间都做优。这个观察在 2016 年被形式化成一条猜想。
05 · 查询要几次寻道:树深与 granule
第五条约束是查找的物理代价。内存里的二分查找按步数算,磁盘上的查找按寻道次数算——后者贵好几个数量级。
B-tree 的寻道次数是对数级
设树的分支因子为 (每个内部节点指向 个子节点),叶层有 个条目,则树高为:
从根到叶要走 层,每层通常一次随机 I/O。所以寻道次数随数据量对数增长,而增长的速度由分支因子决定。
ClickHouse 官方文档给了一组可直接验证的数字:分支因子通常几百到几千,在 887 万行、分支因子 1000 的情况下,平均需要 2.3 次磁盘寻道。[6] 代入公式:,与官方数值吻合。
数据量涨 1000 倍(100 万 → 10 亿),b = 1000 时树高只从 2.00 涨到 3.00——多一次寻道。这就是 B-tree 至今仍是默认索引的原因:它的查找代价几乎不随数据增长。
稀疏索引把「寻道」换成了「多读数行」
第二章讲过 ClickHouse 的 granule = 8192。这个设计在寻道层面的意义是:定位到 granule 之后,块内的匹配不再需要额外寻道,因为数据按主键排序连续存放。[6]
代价是块内必须扫完(或多读最多
近似检索:用召回率换复杂度
向量检索面对的是另一类查找:在高维空间里找最近邻。精确算法在数据量大时代价不可接受,所以主流方案是近似最近邻(ANN)。
HNSW 是其中的代表。论文的核心贡献是把 NSW(Navigable Small World)结构做成「带可控层级」的多层图:搜索从上层开始,利用层级之间的尺度分离提升性能,论文明确报告其复杂度为对数级。[11]
论文原文(HNSW)
「从上层开始搜索,结合尺度分离,相比 NSW 提升了性能,并允许对数级复杂度伸缩。」[11]
论文还指出一项重要细节:「额外采用一种选择近邻图邻居的启发式方法,在高召回率和高聚类数据的情况下显著提升了性能。」[11] 换句话说,图的构建策略比单纯的参数调整更能决定最终效果。
本章的代价清单
06 · 不是表的数据怎么存:文档、键值与图
前五章默认了一个前提:数据是「行 × 列」的表格。但主流开源数据库里,有相当一部分不这么存——文档、键值、图各自有完全不同的物理布局。
换个角度问:如果不按行存也不按列存,那么「一次查询要读多少数据」这件事由什么决定?
文档型:一个文档就是一次读取单位
文档型数据库把「一整条记录」当作读取的原子单位。MongoDB 官方文档给出的默认引擎是 WiredTiger,它提供的是文档级并发、检查点(checkpointing)与压缩。[12]
「文档级并发」这个措辞值得停下来看:并发控制的最小单位是文档,不是行也不是页。这意味着两个事务改同一个文档会冲突,改不同文档则不冲突——一个文档内的多个字段天然是一起读、一起写的。
官方文档还提到企业版另有一种「内存存储引擎」,不把数据落盘。[12] 这是文档型结构的一个额外自由度:既然读取单位是文档,把整个工作集放内存就足以应对多数场景。
键值型:结构最简,代价最明确
键值存储把「按 key 取 value」这一件事做到极致。RUM 论文的判断是:点查复杂度最低的是哈希索引。[10] 键值存储正是建立在这个前提上。
它的代价在 RUM 三角里最清楚:优化了读(点查)与内存(结构极简),更新与范围查就得付账。论文也提到,哈希索引不支持范围查询。[10]
值得注意的现象是键值存储近年的演化方向。Redis 官方发行说明显示,其代码来自多个仓库:主库之外还有查询引擎(RediSearch)、JSON 类型(RedisJSON)、时序类型(RedisTimeSeries)等。[13] 一个原本只做键值的内存存储,正在通过外挂模块不断扩展数据模型——这本身就是「单一结构无法覆盖所有负载」的实证。
图:把「关系」本身当成一等公民
图数据库的核心主张是:当查询的主体是「关系」时,把关系直接存成物理连接,比在表上做多表连接更快。
需要如实说明:本文尝试抓取 Neo4j 官方《Database internals》文档,取到的页面是文档导航结构,没有取到存储层细节;Kuzu 官方文档站点连接失败,Milvus 文档路径返回 302 重定向。[14] 因此本章不对图存储的物理布局做具体陈述。
能说的是它在 RUM 框架里的位置:图结构为了优化「遍历」这一种读,需要把邻接关系物化成物理指针或边记录,这本身就是明知代价的选择——用存储空间与写入时的维护成本,换遍历时的跳数。这一判断属作者推断,无原文出处。
同一份数据,两种存法
TiDB 的做法把这个问题摆得很直白:同一套数据同时维护两种物理形态。官方架构文档显示,TiKV 承担分布式事务型键值存储,TiFlash 承担列存;数据存储的基本单元是 Region,每个 Region 负责一段 key 范围,且是左闭右开区间
表 10 最后一行给出了一个值得琢磨的答案:如果 RUM 三角里没有同时优化三项的方案,那就同时维护两套物理存储,让每种负载各走自己的路径。代价从「结构本身」转移到了「两套结构之间的一致性维护」上——代价还是没消失,只是换了个地方付。
07 · 数据放在哪台机器:分区与副本
前面几章都在讨论「一份数据在单机上怎么摆」。但开源数据库的多数生产部署是分布式的,于是多出一条约束:数据要切开放在多台机器上,同时还得能被完整查出来。
切开:分区单位决定裁剪能力
切分方式是第一个决策。TiDB 选择按 key 范围切:Region 是数据存储的基本单元,负责一段左闭右开的 key 区间,并由多副本共同承担。[15]
按范围切的直接好处是范围查询可以只碰少数几个 Region——因为相邻的 key 落在同一个区间里。这与第二章的稀疏索引、第三章的分区裁剪是同一个思路在不同层级上的重复:先把数据按查询常用的维度排好序,再用「砍掉不需要的部分」来省 I/O。
Elasticsearch 的切分单位是 shard:每个索引切成多个 shard 分布到集群节点,每个 shard 是一个自包含的 Apache Lucene 索引。[4] 官方文档还指出,单个 shard 能高效管理的数据量有实际上限,所以把数据分散到多个 shard 才能让每个 shard 保持性能。[4]
这句话暴露了切分的一个反直觉之处:shard 不是越多越好,也不是越少越好。切得太粗,单个 shard 超出容量上限;切得太细,跨 shard 的查询与合并开销上升。切分粒度和第二章的 granule 大小是同一类参数——都是「用定位精度、换管理开销」的旋钮。
复制:容错要付的账
切分之后必须复制,否则任何一台机器挂掉都会丢数据。Elasticsearch 的副本 shard 提供容错,「在某个节点响应失败时仍能让数据可用」。[4]
复制引入的代价是写入路径的额外成本:一次逻辑写入要在多个副本上落盘并达成一致,才算完成。这与第四章讲的「写放大」是同一个账本——只不过这里的放大倍数由副本数决定,与合并策略无关。
副本也带来一项额外收益:副本可以对外提供读服务。[4] 于是「多花钱做的容错」顺带提高了读吞吐——这是少数几处代价与收益方向一致的设计,代价(额外的写入成本)换来的是两项收益(容错 + 读扩展)。
本章的代价清单
到这里,七章的账本已经记满。它们各自记在不同科目里——写放大、读放大、空间放大、同步成本——但都是同一条约束的不同侧面。
08 · 把各类数据库放进 RUM 三角
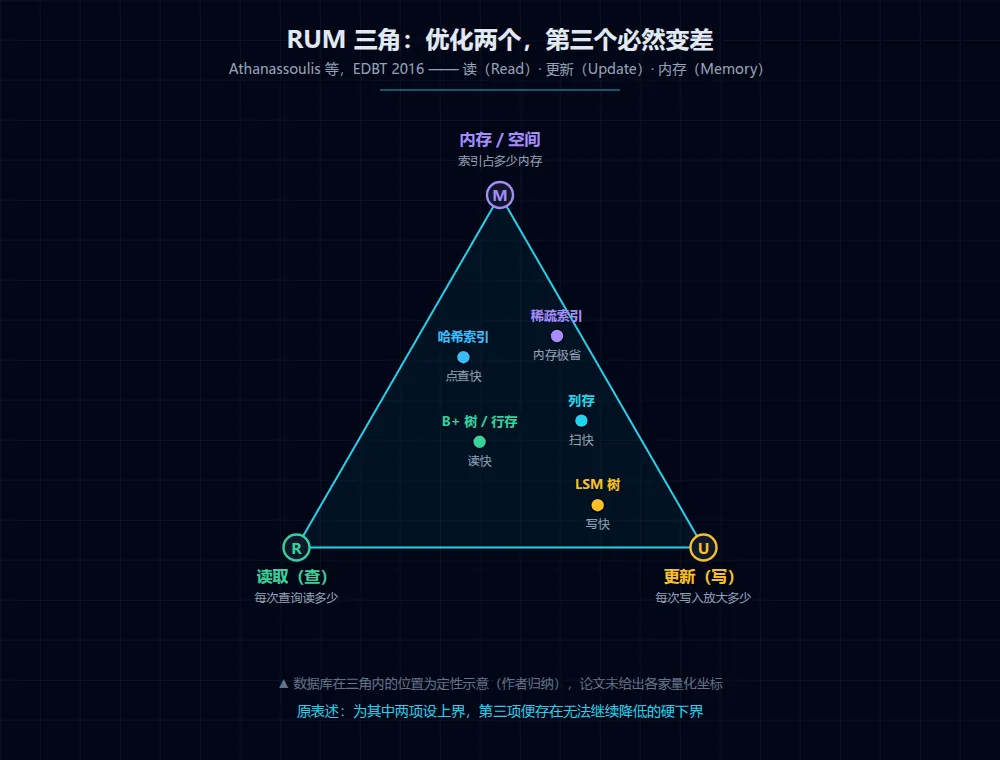
前五章各自看到一笔代价。2016 年,Athanassoulis 等六人(作者机构含哈佛、IBM 苏黎世研究院、EPFL、Facebook)把这些代价形式化成一条猜想。[10]
猜想的完整表述
论文原文(RUM Conjecture,EDBT 2016)
「RUM 猜想:读、更新、内存——优化其中两项,代价是第三项。」[10]
「为 RUM 三项开销中的两项设定上界,会导致第三项开销存在无法继续降低的硬下界。」[10]
论文给的理想方案是:「一种总是提供最低读成本、最低更新成本,且不额外占用内存或存储空间的访问方法」——然后指出这不可能。[10]
论文还指出,点查复杂度最低的是哈希索引,范围查复杂度最低的是 B+-Tree;而像 ZoneMaps 这类稀疏索引访问方法体积最小,但点查与范围查都不是最优。[10] 这与第二章算出的「稀疏索引以定位精度换内存」是同一件事的两种说法。
RUM 视角下看各家结构
需要先说明:RUM 是一套解释框架,论文并未给出各家数据库的量化坐标。下表的位置判断属作者归纳,用于理解取舍方向,不能当作实测排名。
三条放大概念
工程界常用三个词描述这些代价,它们与 RUM 三项一一对应:
- 写放大
:一次逻辑写入引发多少次物理写入。LSM 的 rolling merge 会反复重写同一份数据,这是它换取写入吞吐的方式。[2] - 读放大
:一次逻辑读取引发多少次物理读取。稀疏索引多读 2 g - 空间放大
:为支持更新而保留的额外版本占了多少空间。PostgreSQL 的死元组、ES 的已删除段、Iceberg 的删除标记都属于这一类。[1][4][9]
三个放大项与 RUM 三项的对应关系是:写放大对应更新代价、读放大对应读取代价、空间放大对应内存代价。它们的共同点是——只能转移,不能同时消除。
工程上怎么用这个框架
- 先量化自己的负载比例
。读写比、查询涉及的列数、点查与范围查的比例。这三组数字决定了 RUM 三角里你能接受牺牲哪一角。 - 不要指望「全都优化」的选型
。RUM 猜想给出的正是这个否定结论:任何宣称三项都最优的方案,需要有可核实的解释来说明它如何绕过硬下界。[10] - 把代价显性写进设计文档
。选了 LSM 就承认点查成本,选了列存就承认更新要写删除标记,选了稀疏索引就承认定位精度是块级的。 MongoDB 官方文档《Storage Engines》,mongodb.com/docs/manual/core/storage-engines/ Redis 官方仓库 00-RELEASENOTES(Redis Open Source 8.10 release notes),github.com/redis/redis 图数据库存储层细节:抓取 Neo4j 官方《Database internals》仅得导航页;Kuzu 官方站点连接失败、Milvus 文档 302 重定向 —— 未核到原文,故正文不陈述其物理布局 PingCAP 官方《TiDB Architecture》,docs.pingcap.com/tidb/stable/tidb-architecture
写在最后
回到开头的问题:选型为什么常被当成偏好题?
因为软件品味容易被讨论,而物理约束不容易——它需要算一遍。本文把五条约束各自算了一遍,结果都落在同一句话上:读写空间三者不可兼得,你只是在选择放弃哪一项。
这个结论不新,2016 年就已经有人把它写成猜想。[10] 但它的实用价值在于可操作:一旦你能量化自己的读写比、查询宽度与精度要求,「该选哪个」就不再是偏好问题,而是一道有明确约束的取舍题。
数据说明:本文引用的论文与官方文档均标注来源编号,可在文末对应。文中所有按公式计算得出的数字(表 2、表 3、表 5、表 8)为本机实算结果,非引用。表 10 的结构位置判断属作者归纳的定性说明,论文原文未给出量化坐标。
论文与官方文档的原文核实工作、以及本文涉及的「未核到原文」条目,见留档 data/facts.md。
参考来源
PostgreSQL 官方文档《Database File Layout》《A Brief History of PostgreSQL》《TOAST》,postgresql.org/docs/current/ O'Neil, Cheng, Gawlick, O'Neil, The Log-Structured Merge-Tree (LSM-Tree), Acta Informatica(预印本),1996 Pelkonen 等,Gorilla: A Fast, Scalable, In-Memory Time Series Database, VLDB 2015 Elasticsearch 官方文档《Documents and indices》,elastic.co/guide/ ClickHouse 官方文档《MergeTree》,clickhouse.com/docs/en/engines/table-engines/mergetree-family/mergetree ClickHouse 官方《A Beginner's Guide to ClickHouse Primary Indexes》,clickhouse.com/docs/en/guides/best-practices/sparse-primary-indexes DuckDB 官方博客《Lightweight Compression in DuckDB》,duckdb.org/2022/10/28/lightweight-compression Apache Arrow 官方《Columnar Format》规范,arrow.apache.org/docs/format/Columnar.html Apache Iceberg 官方《Table Spec》,iceberg.apache.org/spec/ Athanassoulis 等,Designing Access Methods: The RUM Conjecture, EDBT 2016 Malkov & Yashunin, Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs, arXiv:1603.09320 MongoDB 官方文档《Storage Engines》,mongodb.com/docs/manual/core/storage-engines/ Redis 官方仓库 00-RELEASENOTES(Redis Open Source 8.10 release notes),github.com/redis/redis 图数据库存储层细节:抓取 Neo4j 官方《Database internals》仅得导航页;Kuzu 官方站点连接失败、Milvus 文档 302 重定向 —— 未核到原文,故正文不陈述其物理布局 PingCAP 官方《TiDB Architecture》,docs.pingcap.com/tidb/stable/tidb-architecture

发表评论
发表评论: