
 研报速递
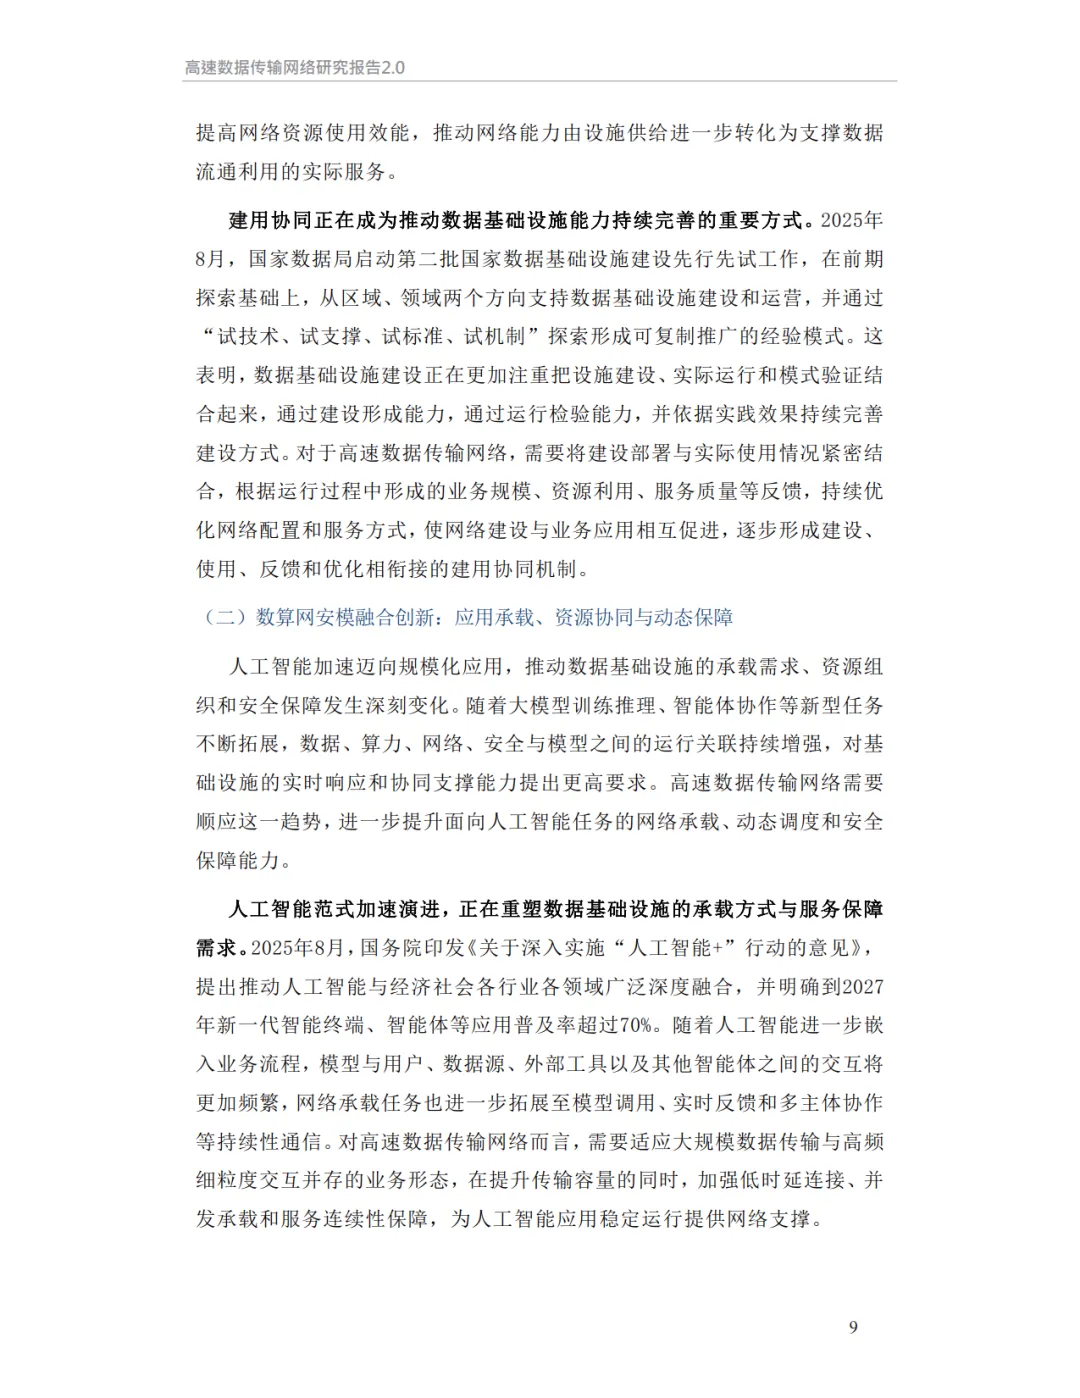
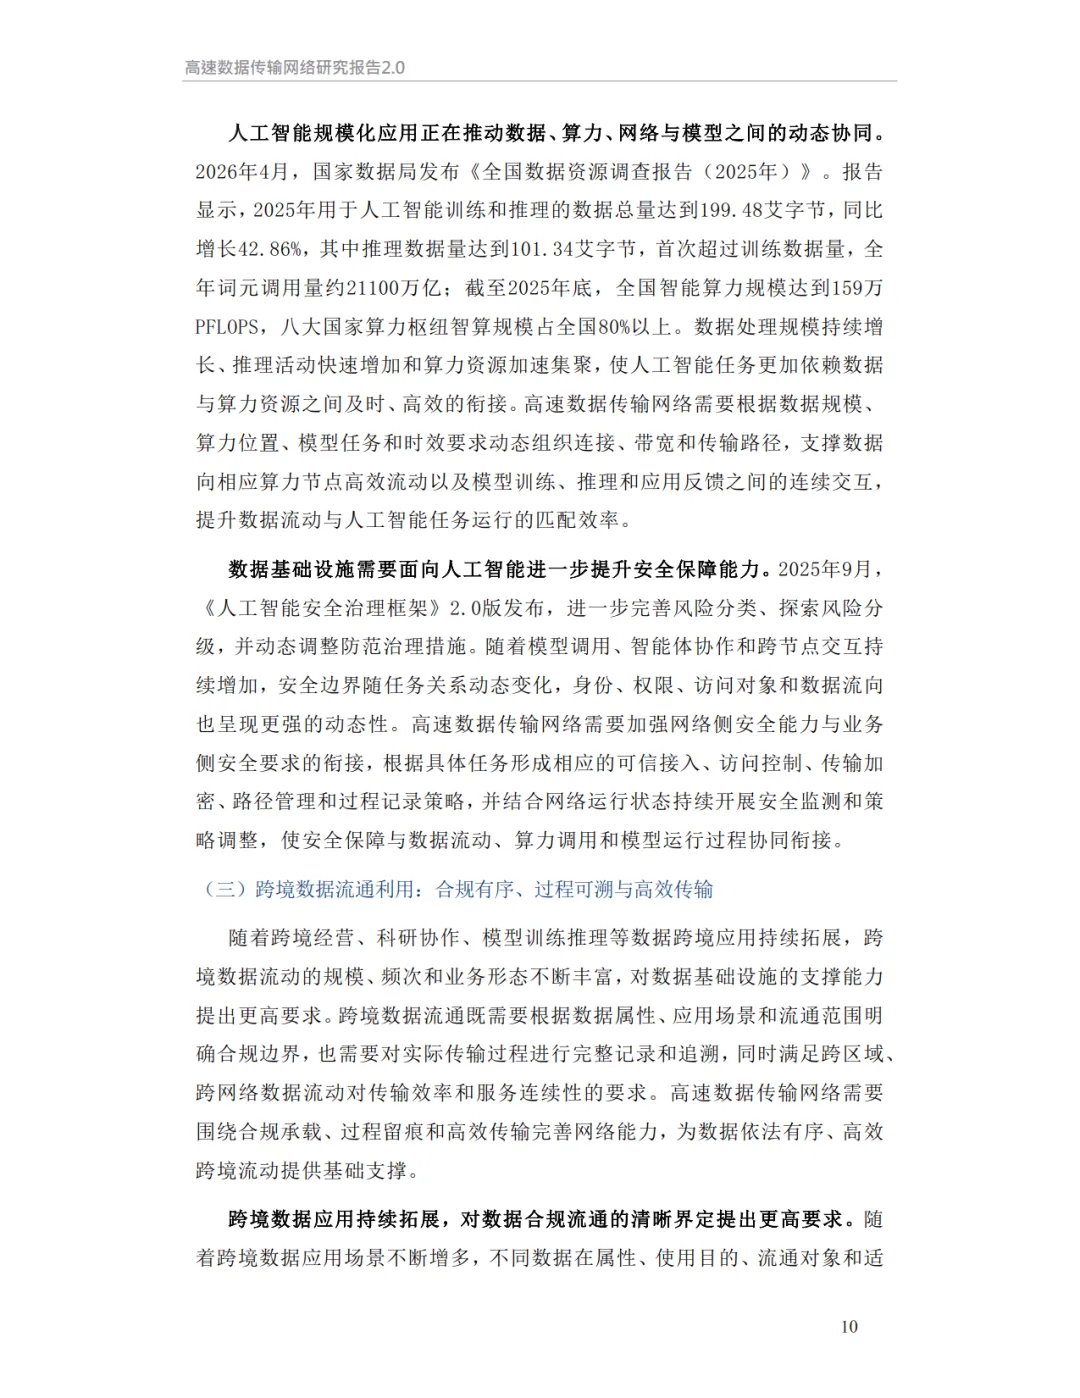
一个数字,可能比任何模型发布都更值得琢磨:2025 年,中国用于 AI 训练和推理的数据总量达到 199.48 艾字节,同比增长 42.86%。更关键的是,其中推理数据量 101.34 艾字节,第一次超过了训练数据。
这个交叉点意味着什么?意味着 AI 已经不是偶尔"练一次"就完事,而是每天都在被海量调用、持续交互。数据要流动,算力要调度,模型要联网——压力,一下子压到了网络身上。
国家数据发展研究院今年 8 月发布了《高速数据传输网络研究报告 2.0》,中国工程院院士邬贺铨写的序。报告给这个网络起了个说法——数字中国建设的"大动脉"。
从"修路"到"按需派车"
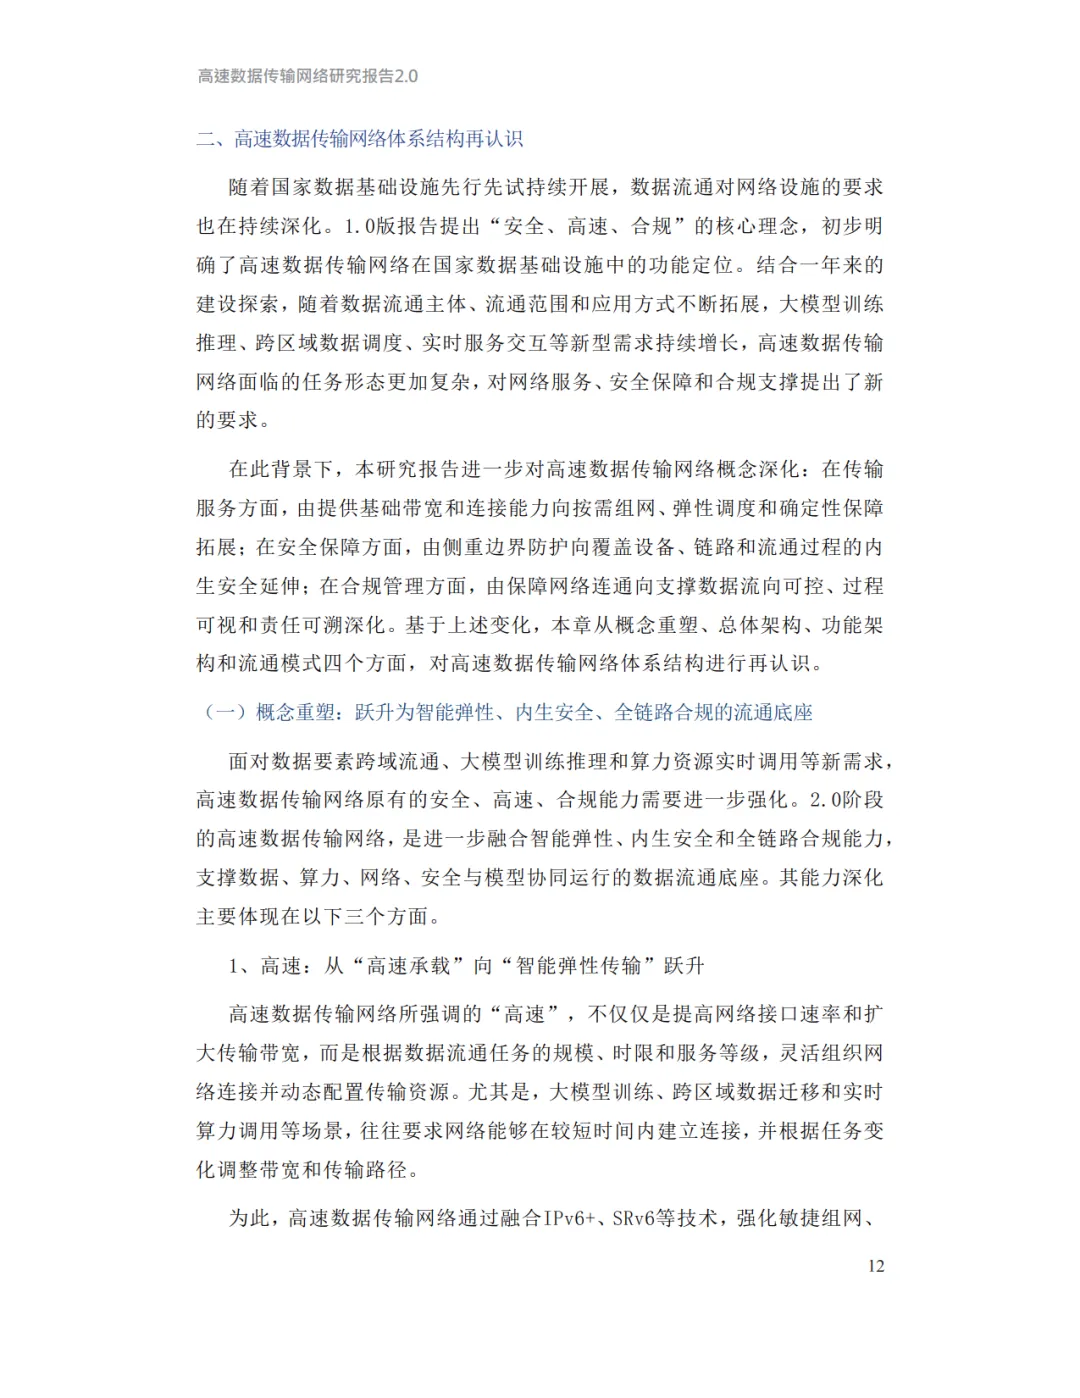
1.0 版报告的核心理念是"安全、高速、合规"。到了 2.0,这三个词被重新拆解了一遍:
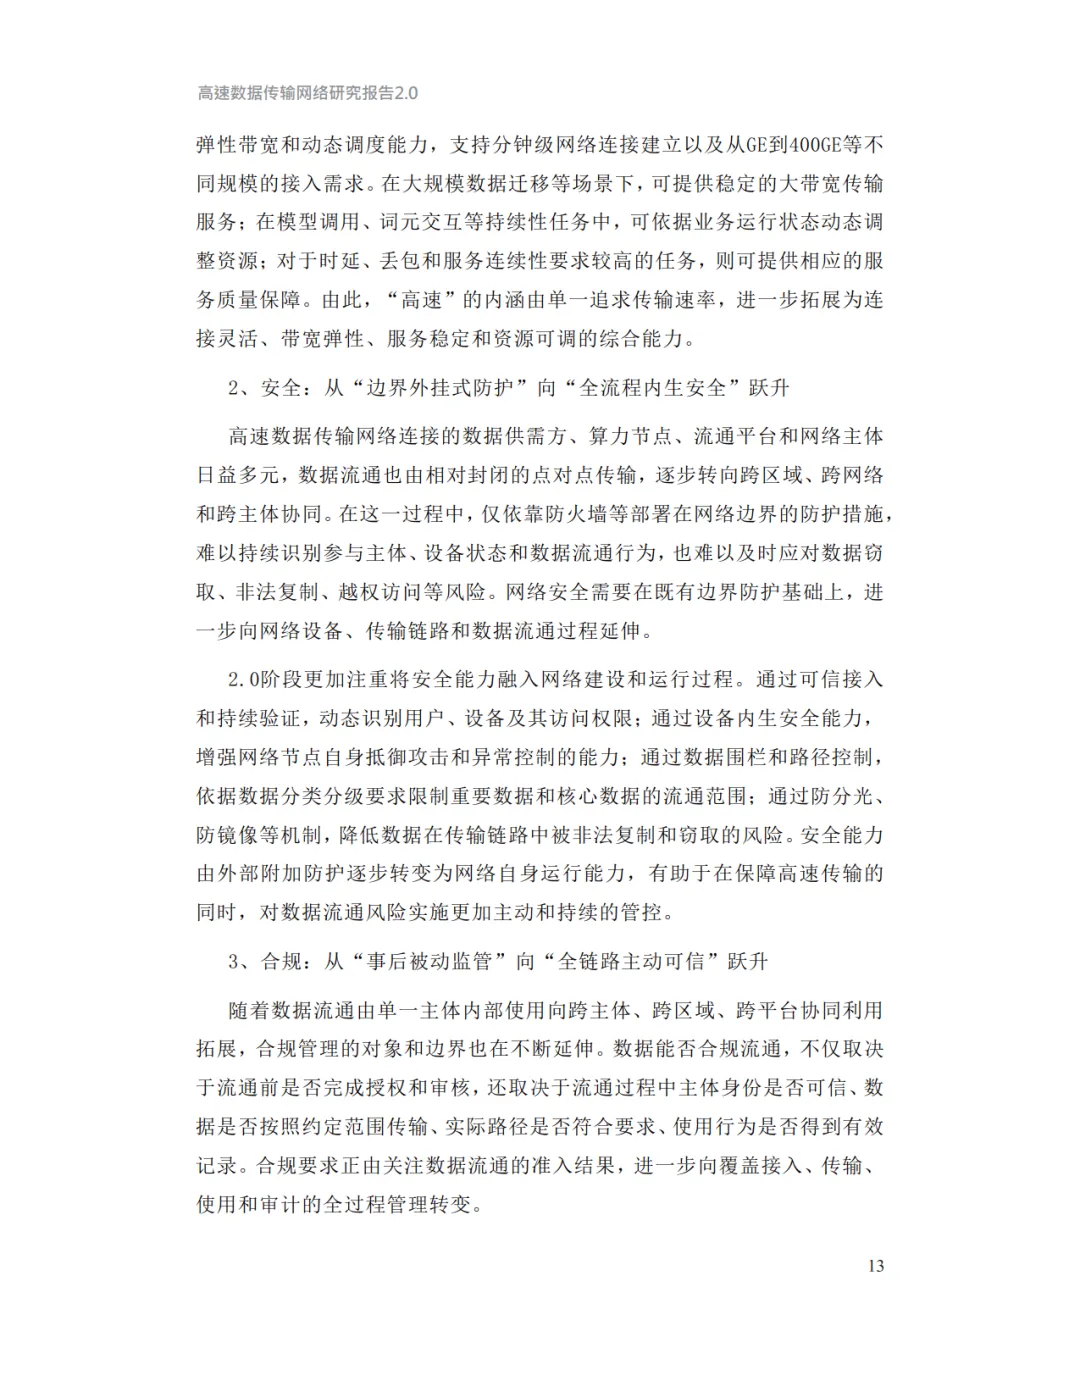
- 高速,不再只是堆带宽和接口速率,而是根据任务的规模、时限、服务等级,动态组织连接、按需分配资源;
- 安全,从过去守边界,变成覆盖设备、链路、流通过程的内生安全;
- 合规,也要从"连得上"走向"流得可控、过程可追溯、责任可溯源"。
换句话说,这条路不仅要修得宽,还得会自己判断:哪辆车该优先走,哪辆车得拦下来查。
三个区,把数据关进"有规矩的通道"
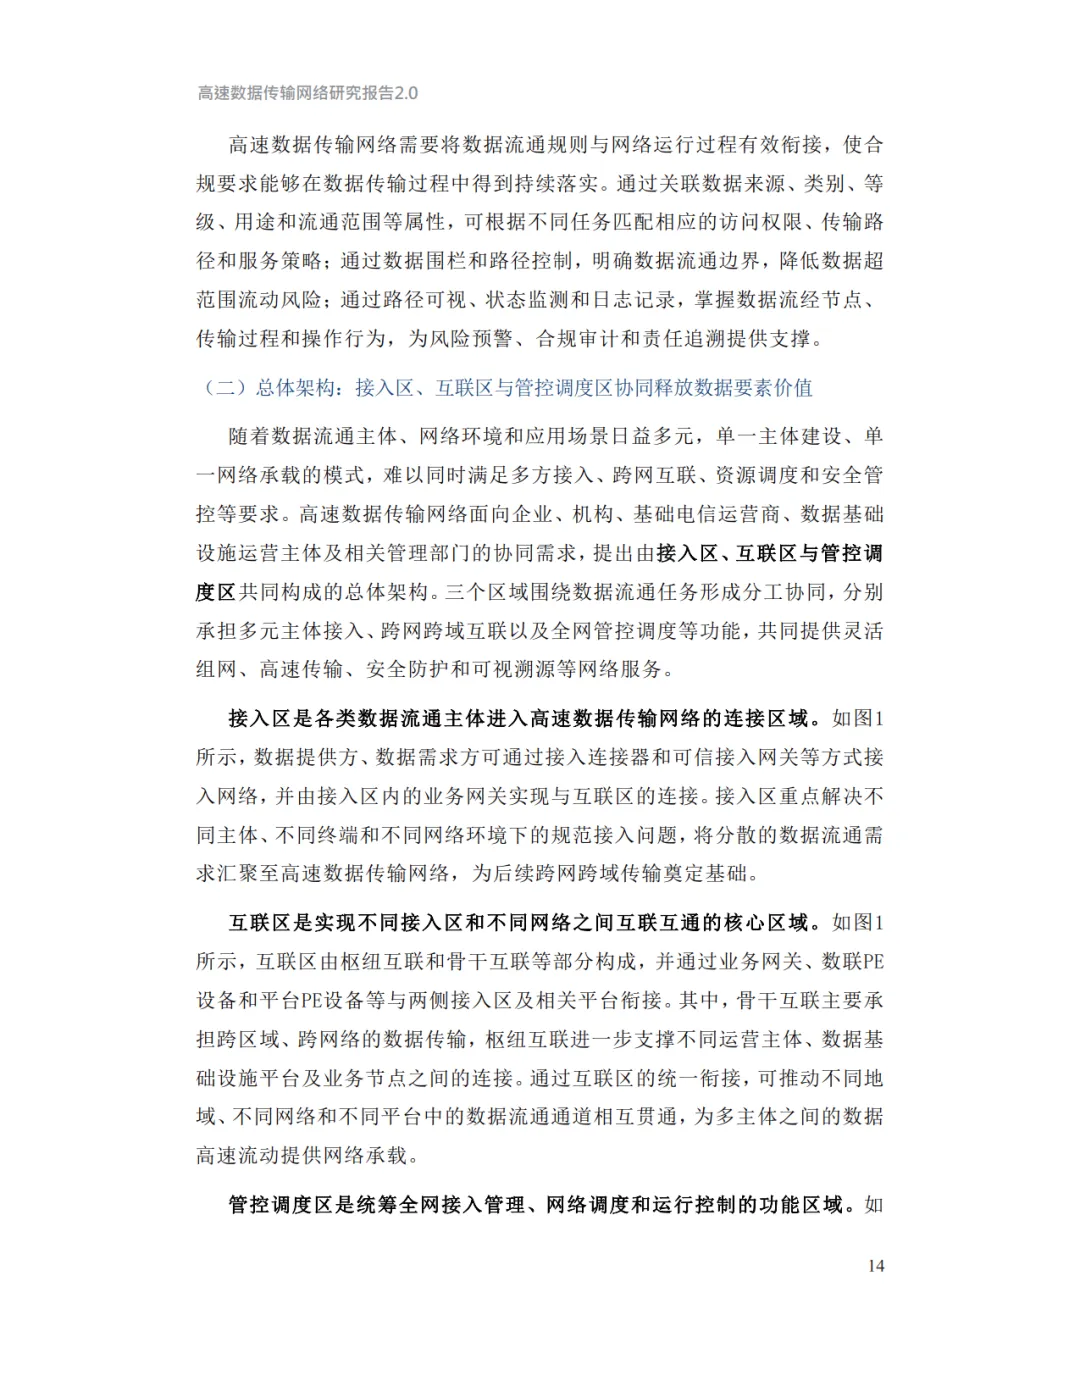
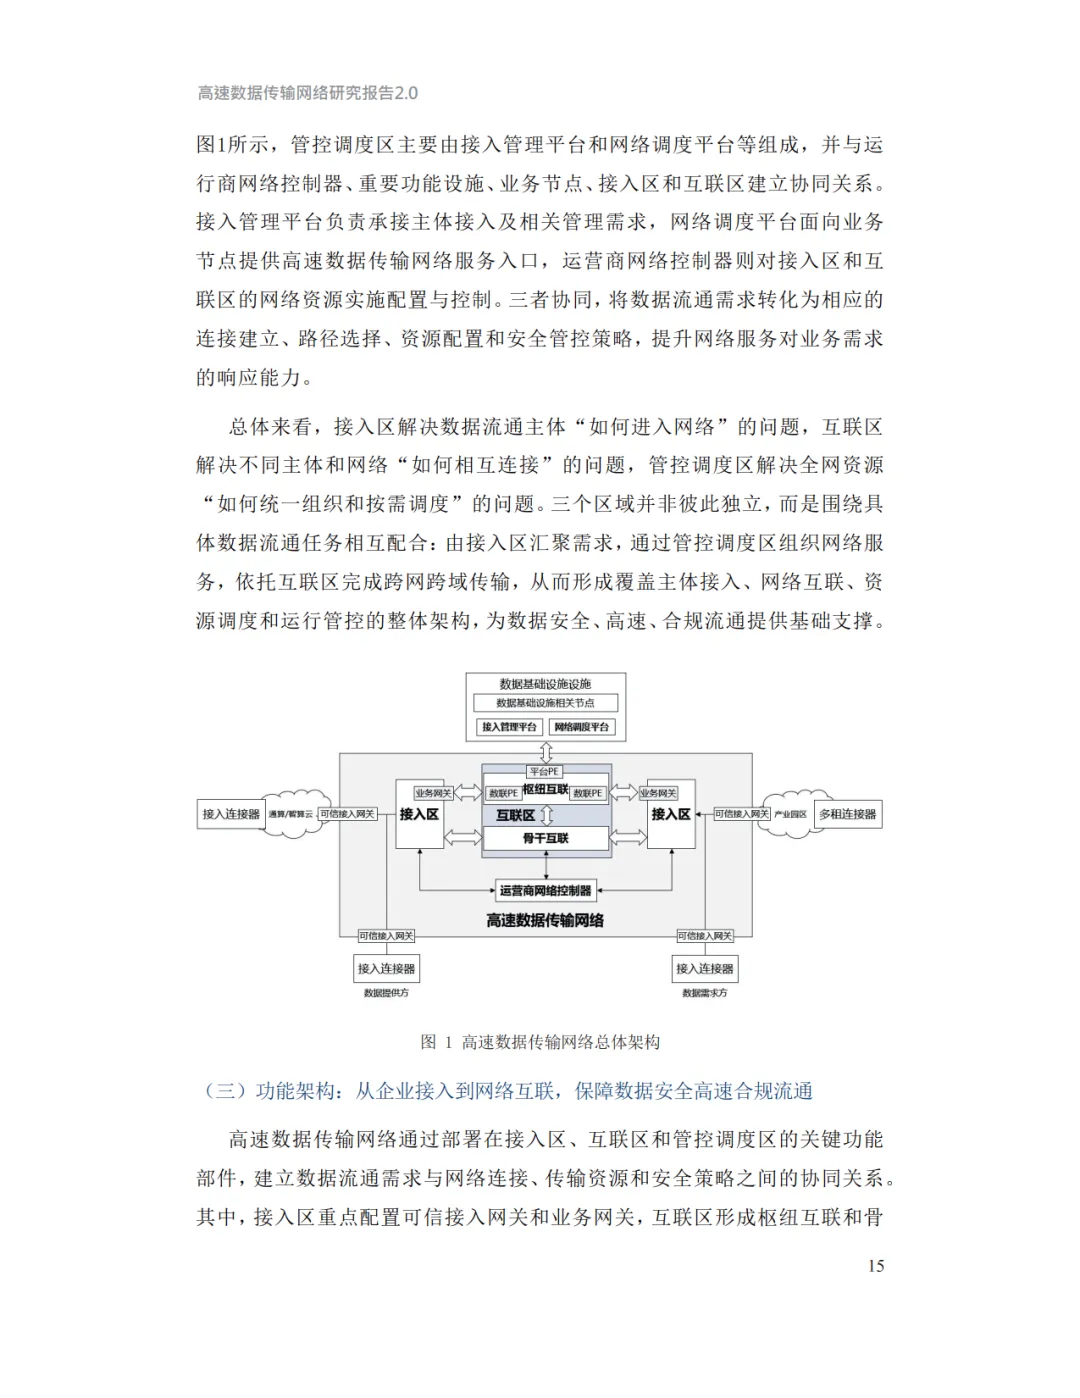
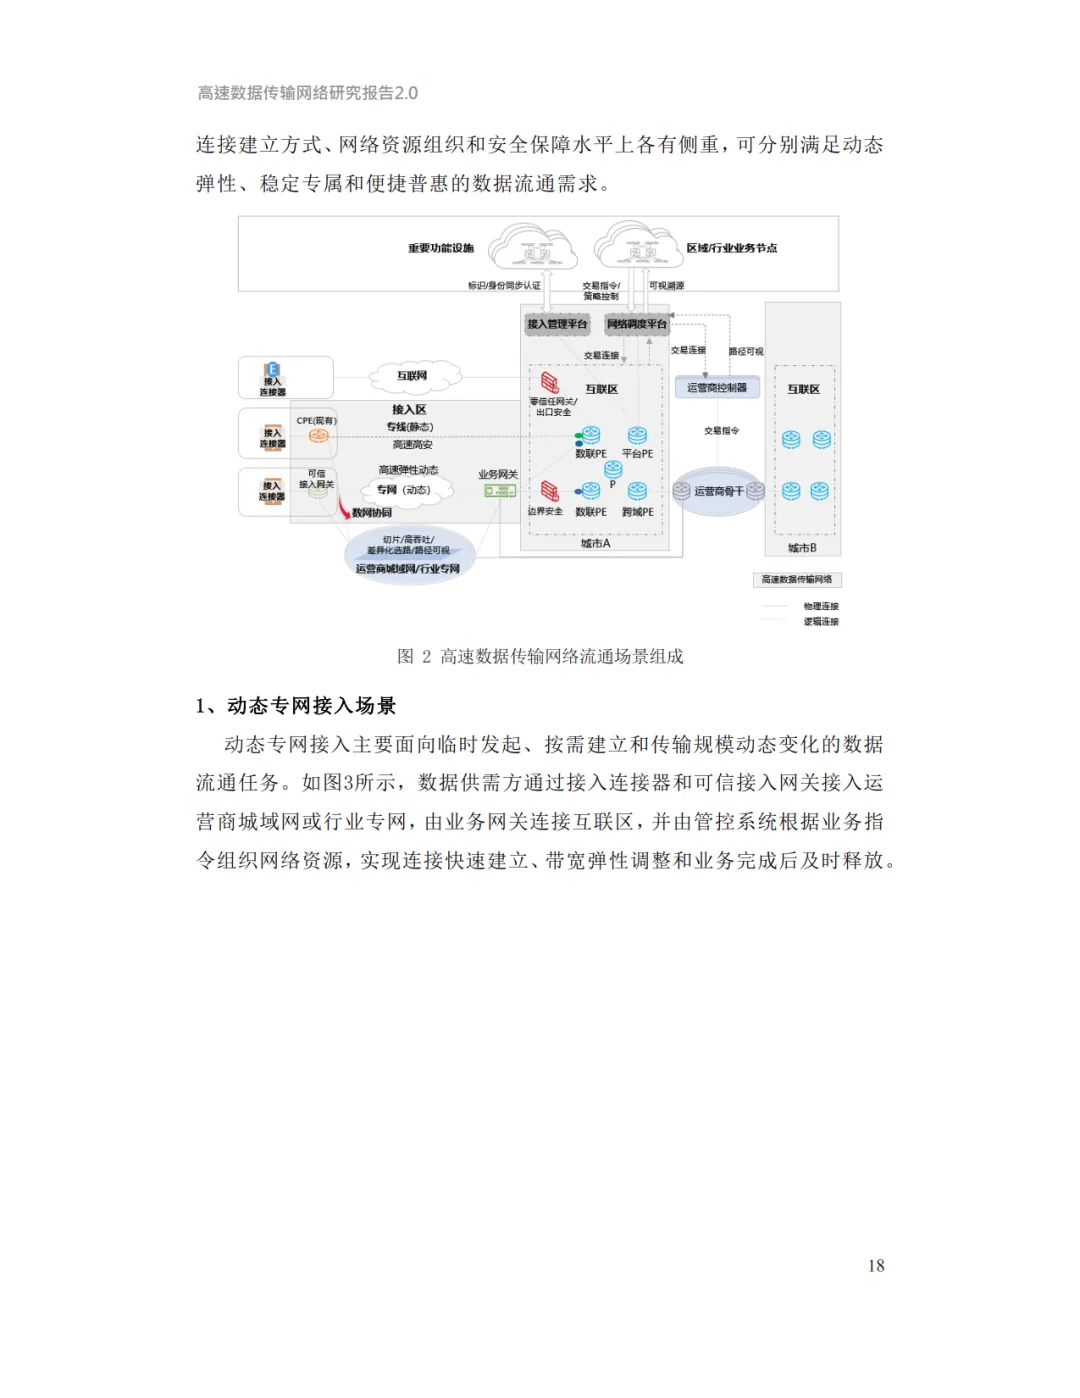
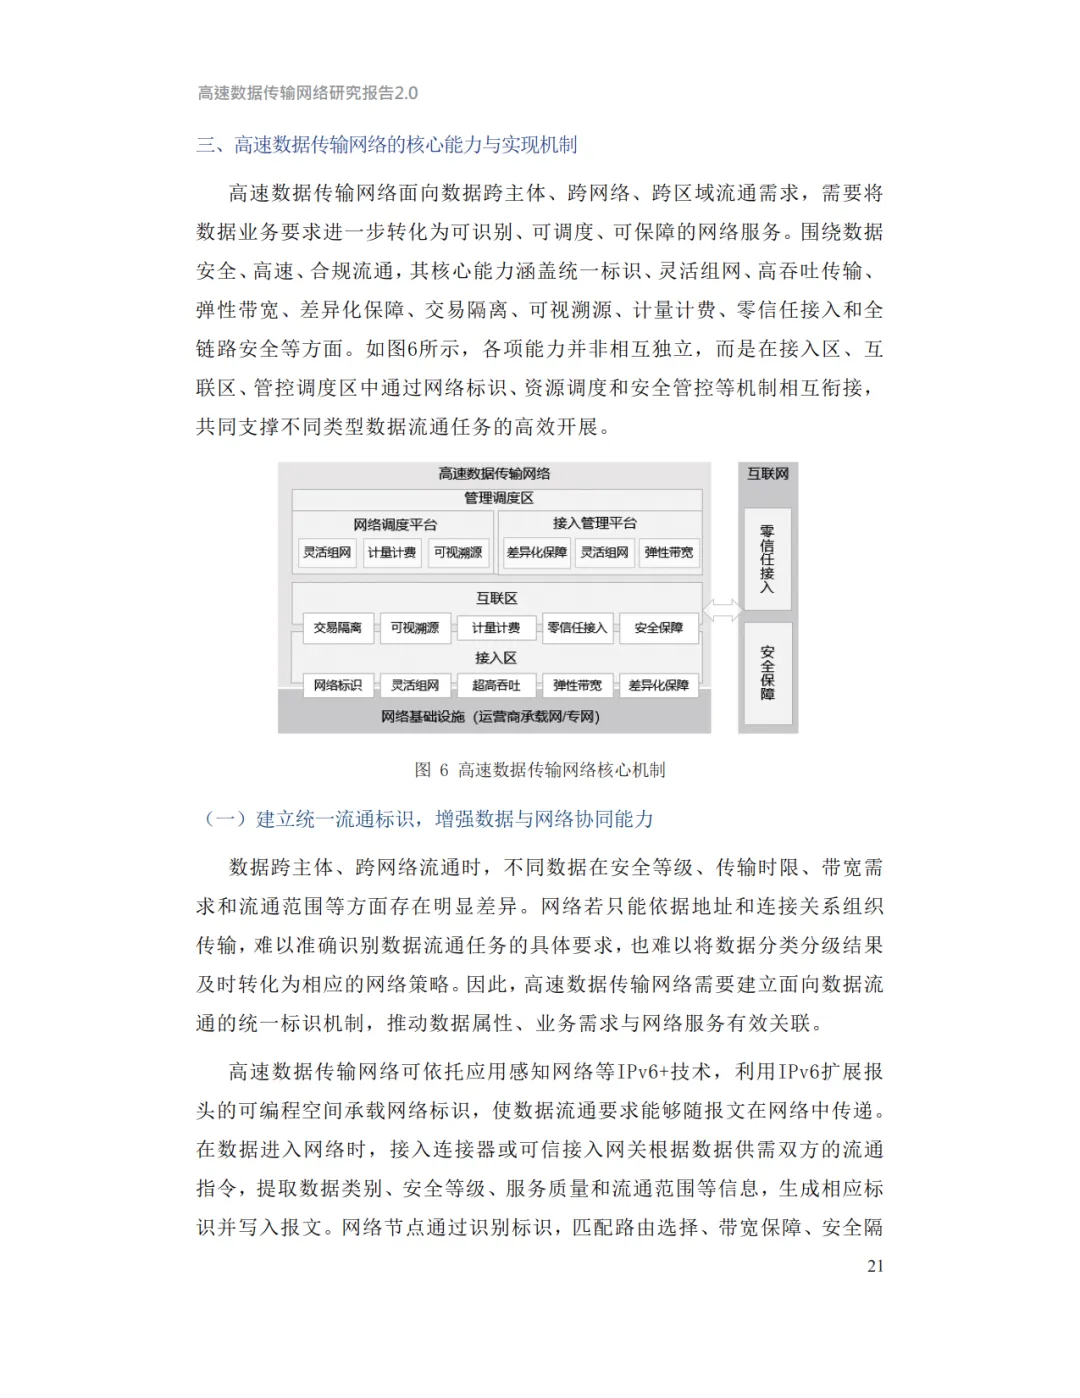
报告给出的总体架构,由三个功能区构成:接入区、互联区、管控调度区。
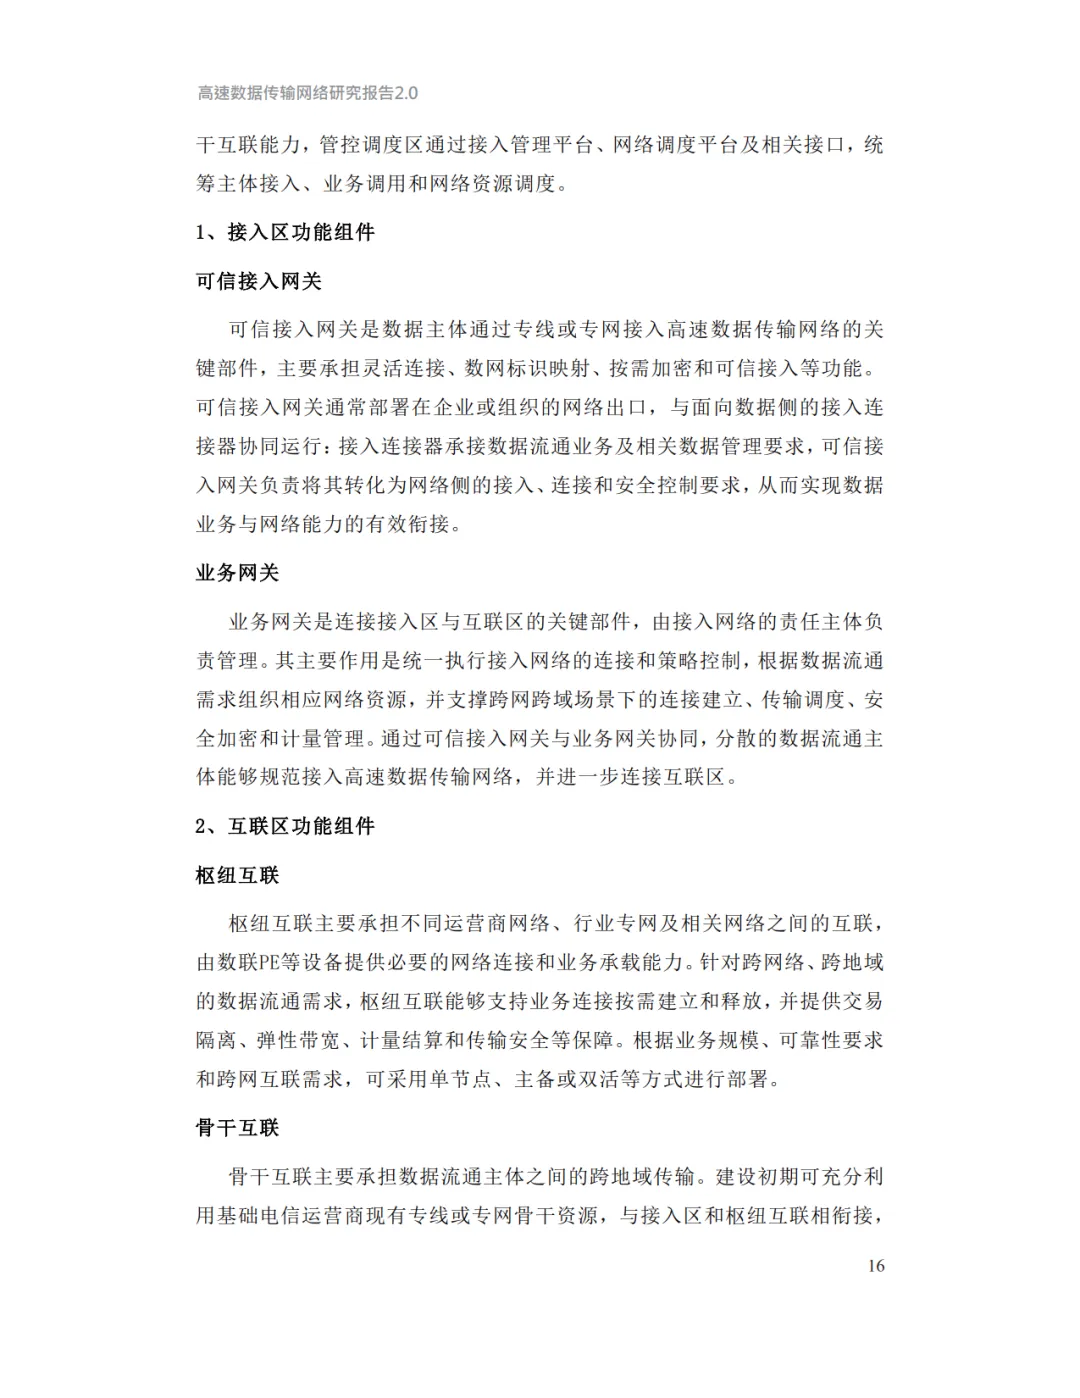
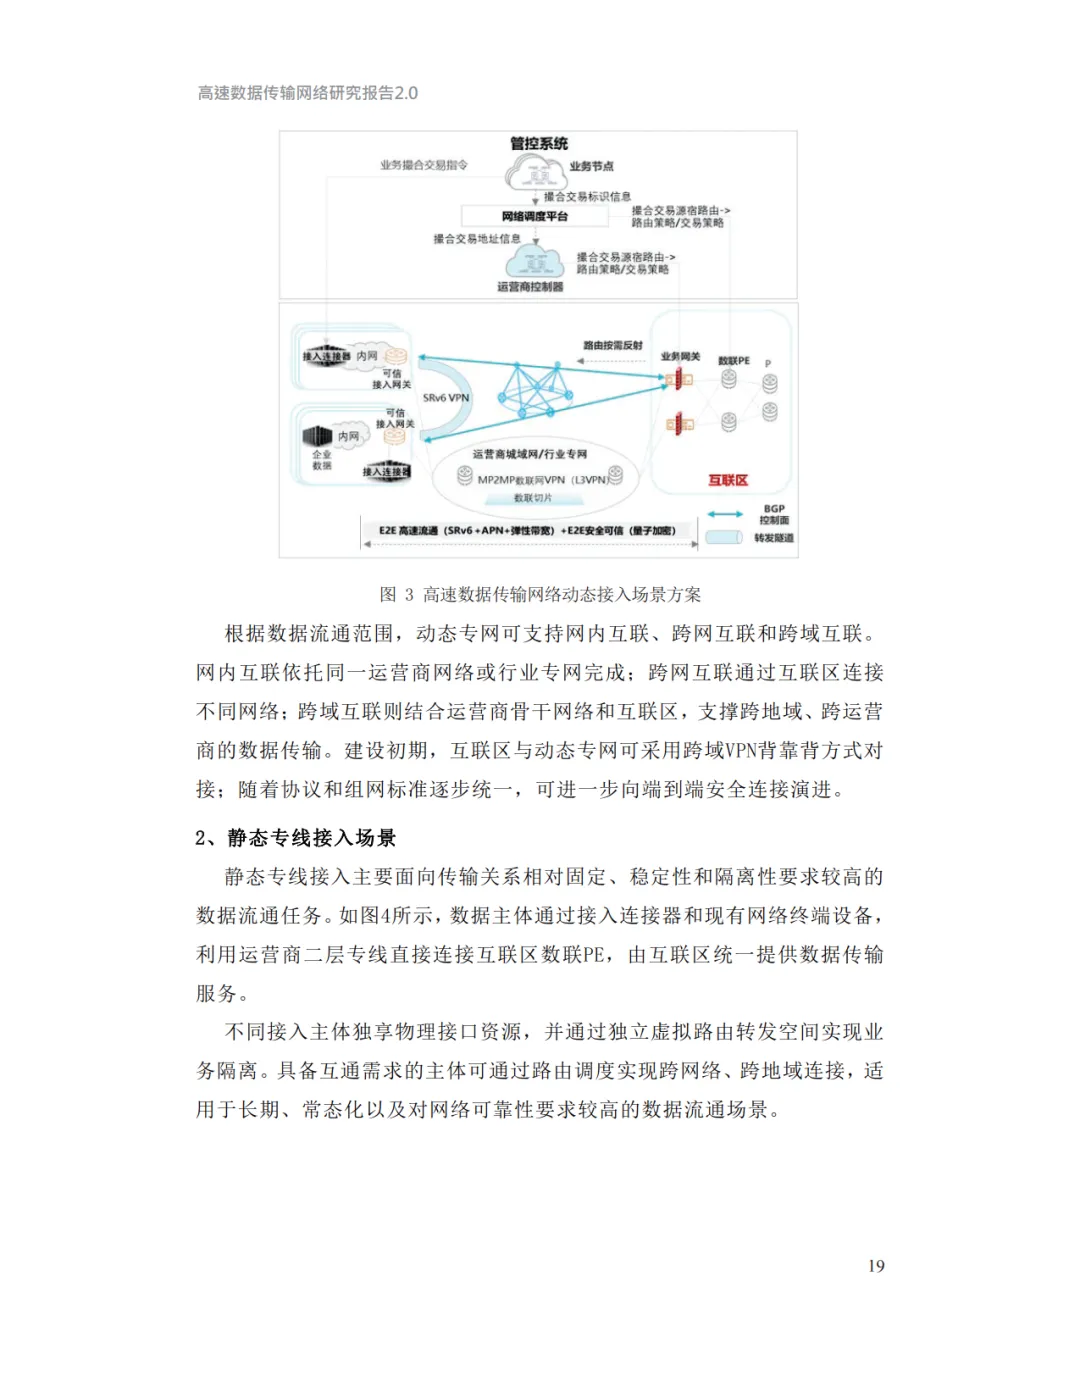
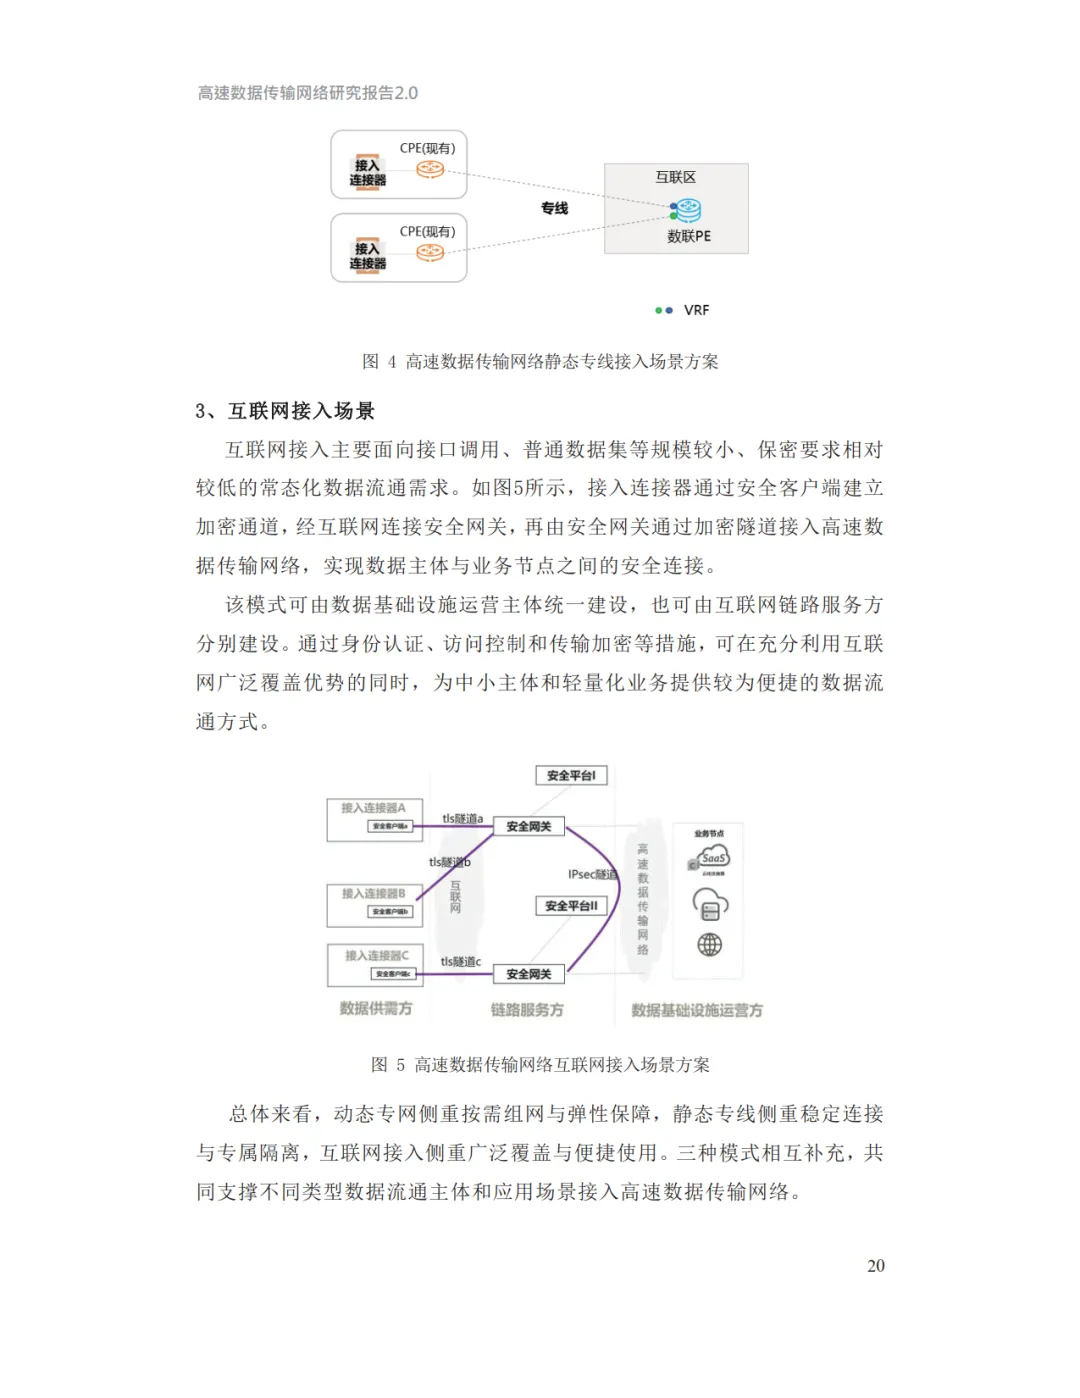
接入区负责"怎么进来"——报告给了三种模式:动态专网讲按需组网和弹性保障,静态专线讲稳定连接和专属隔离,互联网接入讲广泛覆盖和便捷使用。三种各干各的活,谁也别想一套方案打天下。
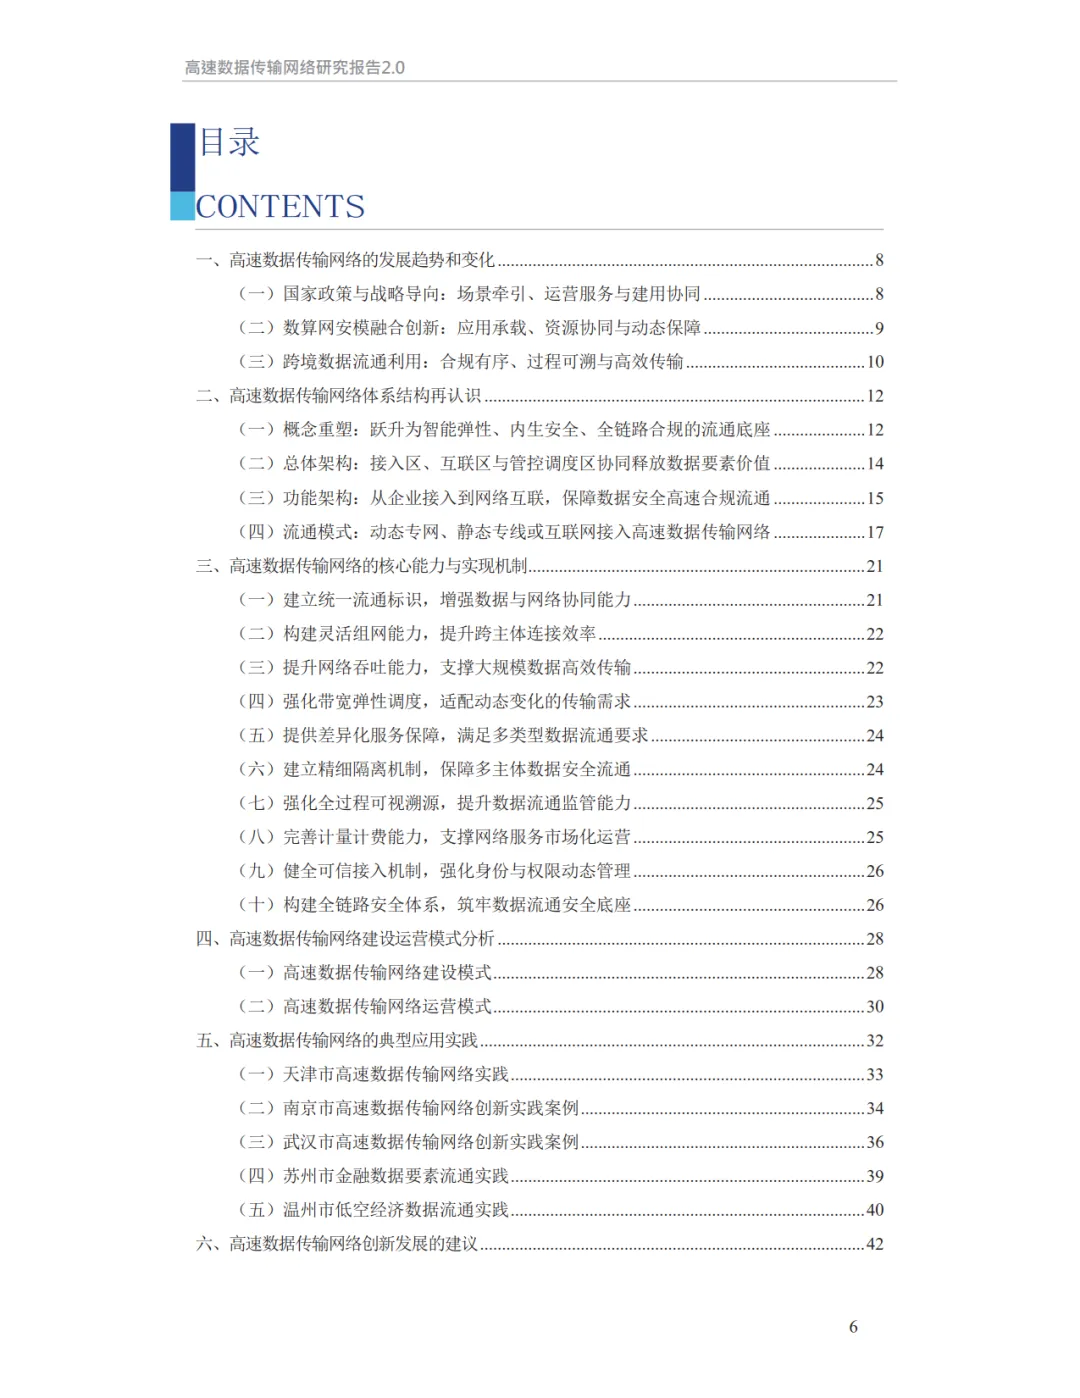
互联区负责"怎么互通",管控调度区则负责全局的"什么时候给谁多少资源"。围着这套架构,报告列了十项核心能力,从统一流通标识、灵活组网、高吞吐传输,一直到弹性带宽、交易隔离、可视溯源、计量计费、零信任接入和全链路安全。
真正有意思的是那几个落地案例
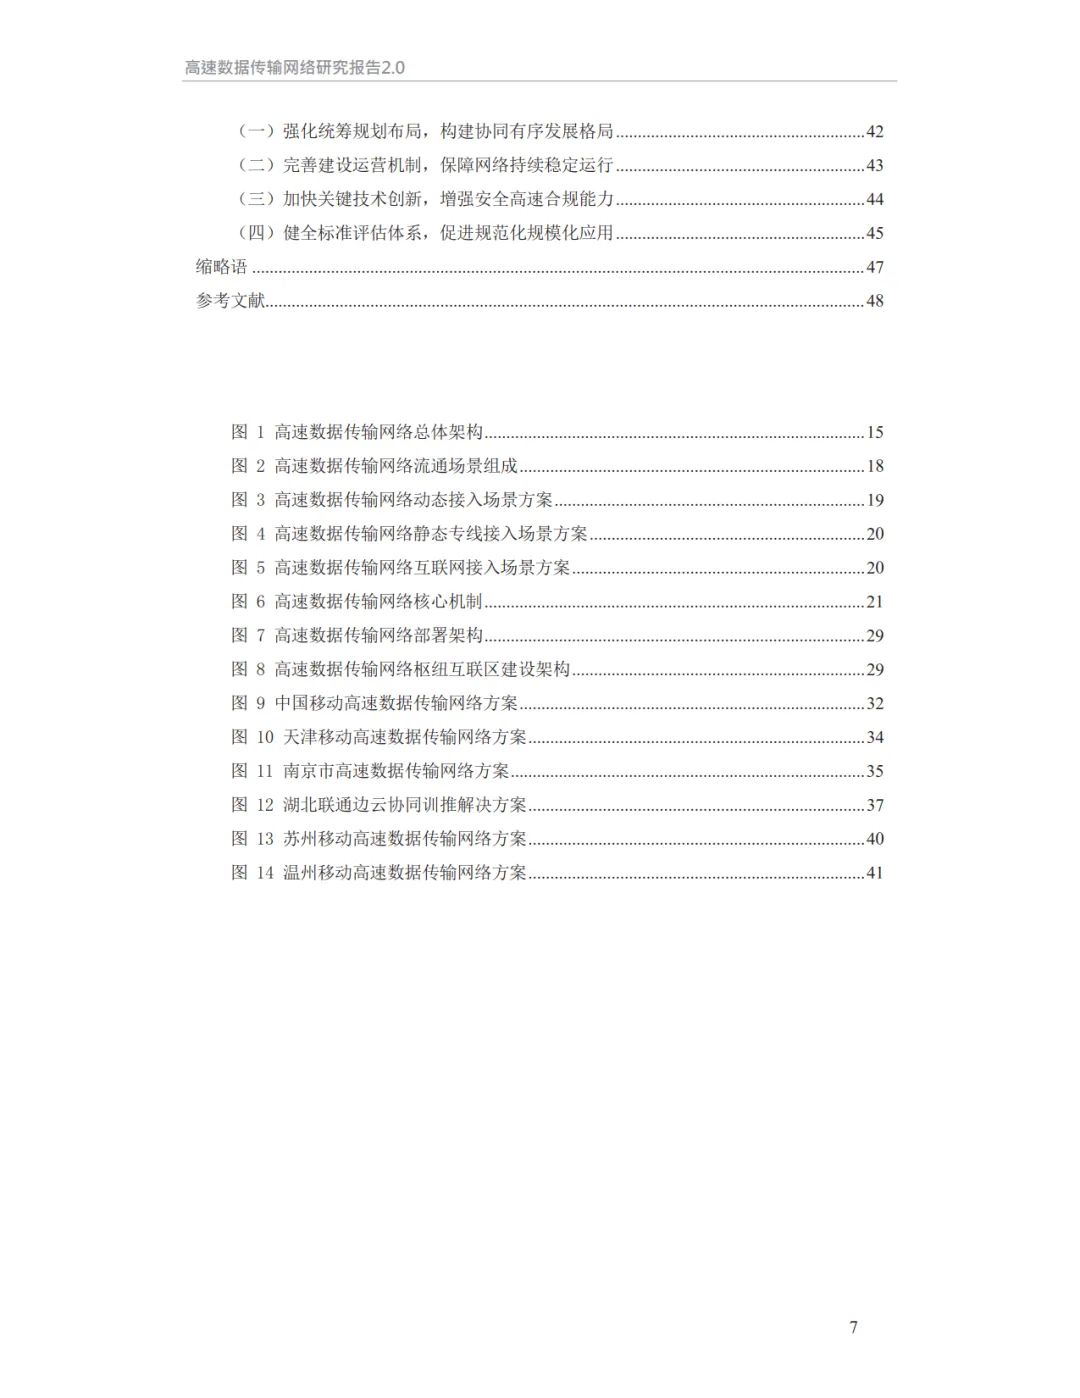
政策写得再好,也得看有没有人真在用。报告挑了天津、南京、武汉、苏州、温州五个城市的实践。
最让我意外的是武汉那个案子。湖北联通联合华为,给亚心医院做了一套"边云协同"的训推方案:模型的首尾层放在医院自己的算力上,中间层放到运营商智算中心,原始数据不出园区。用的是 Qwen3-32B,跨 200 公里拉远推理,能效损失只有 2.21%。
苏州银行的案子更直白:接入高速数据传输网络后,风控模型的特征维度从百余维增加到 500 余维,贷款审批周期从 7 天缩短到 1 天,高价值客群拓展比例提升 20%,风险评估命中率达到 72%。
温州则把它用在了低空经济上——浙江移动部署了超过 37 公里的低空智控网络,支撑 12 条常态化飞行航线,累计无人机日常巡航 6000 余次。
一个值得记住的转向
把这份报告读完,最大的感受是:数据的流通形态变了。
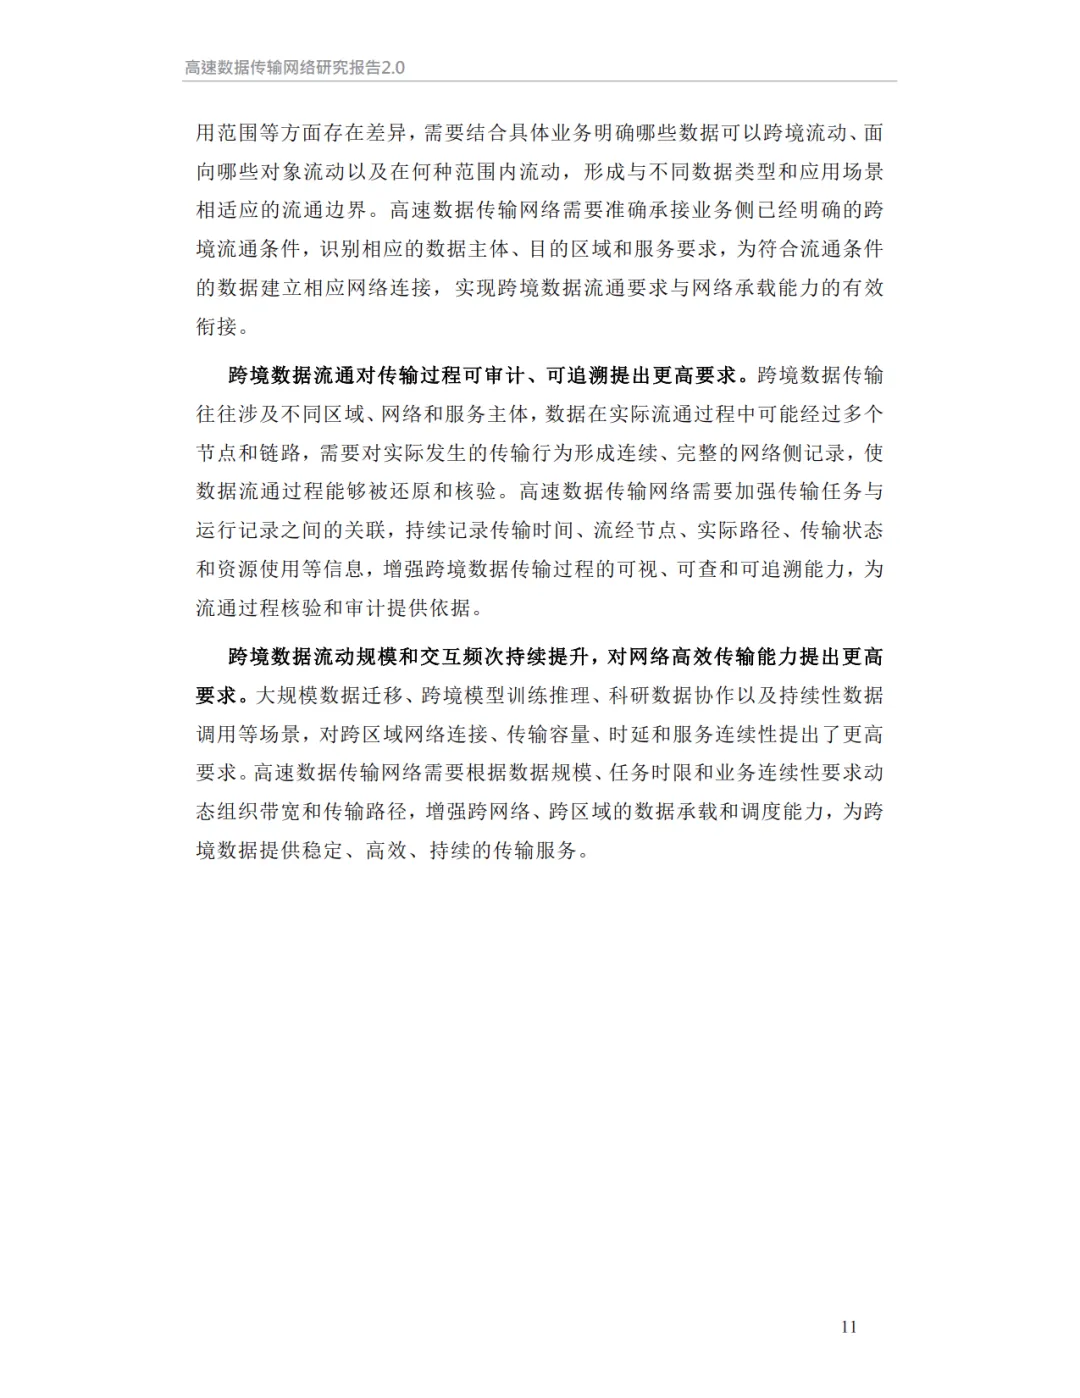
过去流通的是原始数据和标准化文件,现在流通的是高质量数据集、接口服务、模型能力,甚至词元(token)。流通方式从阶段性的点对点传输,变成高频调用、持续交互、跨域协同。
当"数据"本身变成了要按次计费、要追溯来源、要分级管控的服务,网络就不再是背景板,而是主角之一。
英伟达的股价涨了这么久,会不会有一天,真正卡住 AI 脖子的是运营商?这个问题,可能比我们想的来得更早。
以上为节选,关注本公众号,文章结尾“阅读原文”、"留言区"获得下载完整文档网址。
来源:国家数据发展研究院
【推荐阅读】
2026年TokenFactory词元工厂技术与产业发展白皮书

发表评论
发表评论: