研报速递
【报告导读】前几章从概念、架构和运行机制层面解析了动态本体“是什么”和“如何运转”。但一套完整的技术架构,最终需要落地到具体的产品平台之上才能被使用、被运营。本章的问题随之而来:动态本体在Palantir的产品线中由谁来构建?由谁承载行业应用?AI能力通过什么平台接入?跨环境部署和持续运维又由哪个组件保障?
从行业实践看,不少技术方案停留在架构图纸层面,缺乏配套的工程工具链和交付体系;有的平台只解决了数据整合,却不支撑业务执行;有的具备AI能力,却脱离业务语义独立运行。架构思想能否转化为可交付、可运维、可扩展的产品能力,往往取决于平台体系的完整程度。动态本体并非一项孤立的技术能力,而是贯穿Palantir全线产品的底层架构;经过二十余年迭代,各产品平台在本体工程中各自承担差异化角色,共同构成一套从基础设施到行业应用再到智能决策的完整支撑体系。
本章沿产品体系自上而下展开,考察五个平台组件在本体工程中各自承担的分工与相互协同关系。
其一,Foundry(铸造厂)——本体的构建与编排平台。作为面向企业客户的核心平台,Foundry承担动态本体的构建、编排与运营管理职能:通过两百余种连接器完成多源异构数据接入,以Pipeline Builder实现声明式数据管道构建,由Ontology Manager作为对象类型的权威管理来源,并通过应用层将本体转化为业务人员可直接使用的工作流和专属应用。它既是本体的“制造工厂”,提供从原始数据到语义对象的完整工具链,也是本体的运行平台,使本体能够在企业运营中持续发挥作用并不断进化。
其二,Gotham(哥谭)——本体在国防与情报领域的应用载体。作为Palantir历史最久的平台产品,Gotham面向国防、情报与执法场景,在共享本体架构的基础上,以读取时定义(schema-on-read)方式整合异构情报数据,依托通用作战图(COP)与通用情报图(CIP)实现多源情报的实时融合呈现,并提供Graph链接分析、Gaia地理空间分析、全动态视频分析、Dossier协同编辑等本体驱动的分析应用。
其三,AIP(人工智能平台)——本体与AI的深度融合层。AIP并非独立于Foundry和Gotham之外的附加层,而是将AI能力“锚定”在动态本体之上:模型推理以本体中的对象、属性和链接关系为上下文,AI输出受本体类型系统和操作边界约束,推理过程与决策谱系被结构化记录。本体在这里承担AI语义锚点、执行边界和可审计基础三重作用。
其四,Apollo(阿波罗)——本体的持续交付与运维平台。无论本体模型还是业务应用,都需要在物理数据中心、公有云、保密气隙环境和边缘设备之间实现标准化部署与持续更新。Apollo以声明式拉取模型和中心辐射式架构,解决复杂系统在多云、混合云、断连和战术边缘环境下的交付与运维难题,保障本体能力在各类受限环境中安全、自主地部署和在轨升级。
其五,Meta-Constellation(元星座)——本体的天基延伸。元星座将本体架构应用于卫星星座场景:在本体层统一多源卫星数据的语义定义,通过EdgeAI引擎编排星上微模型,由地面控制中心的本体驱动任务分配,形成星上处理、地面统筹的协同闭环,是本体架构在天基情报领域的工程延伸。
五个平台并非彼此孤立:Foundry与Gotham共享同一本体架构并实现跨应用的数据对象互通,AIP在本体之上提供智能决策能力,Apollo为各平台提供底层交付与运维保障,元星座则将本体能力扩展至天基场景。理解这套产品体系的分工与协同,才能完整把握动态本体从架构设计走向工程落地的支撑路径。
(本文为报告第五章,报告第一章、第二章、第三章、第四章和第五章内容已上传至知识星球,后续将连载更新部分内容,可加入知识星球了解相关资料)
第五章 Palantir产品体系对动态本体的支撑
动态本体并非一项孤立的技术能力,而是贯穿Palantir全线产品的底层架构。经过二十余年的迭代,Palantir已经形成“阿波罗”(Apollo)、“哥谭”(Gotham)、“铸造厂”(Foundry)和“人工智能平台”(AIP)四大产品平台。这四款产品在本体工程中各自承担着差异化的角色,共同构成了一套从基础设施到行业应用到智能决策的完整支撑体系。Palantir真正的核心资产,正是贯穿所有产品的一套被称为“本体论”的技术架构。
一、“铸造厂”(Foundry)——本体的构建与编排平台
在Palantir的产品体系中,Foundry是面向企业客户的核心平台,承担着动态本体的构建、编排与运营管理职能。如果将Palantir的整体架构比作一个从数据到决策的操作系统,Foundry便是其中负责“数据→语义→行动”转换的关键环节。
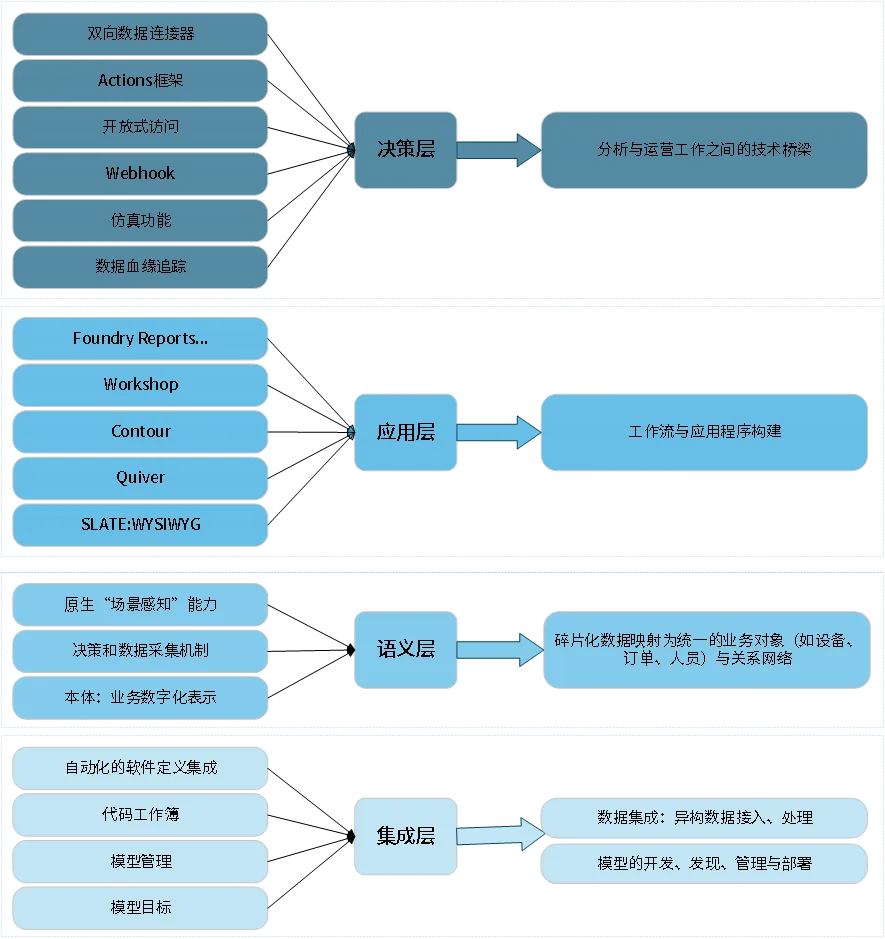
图 1 “铸造厂”系统构成示意
(一)平台定位
1. 企业级数据操作系统
Foundry被官方定义为“现代企业的操作系统”(The Operating System for the Modern Enterprise)。这一定义的核心含义在于,Foundry不仅是一个数据仓库或商业智能工具,而是一个协调企业内数据、模型与决策之间相互作用的运营层。它将分散在ERP、CRM、IoT传感器、数据库和文档中的数据统一接入、清洗和建模,形成一个企业可以在其上进行分析和决策的共同数据层。
与传统的数据平台不同,Foundry的设计目标不是从数据接入到可视化呈现这样的线性处理信息,而是构建一个闭环系统,包括运营活动产生数据,数据驱动决策,决策反过来影响运营。Foundry通过开放架构连接数据、分析和业务团队,实现从数据集成到运营应用的端到端解决方案。
2. 本体的“制造工厂”
Foundry的核心功能是为组织构建和运营动态本体。Palantir官方指出,Foundry的本体超越了传统的数据模型,是一个“组织的运营层”(an operating layer for the organization)。本体将底层数据和模型连接到其对应的,如工厂、配送中心或设备现实世界业务对象,使分析团队、数据科学家和业务决策者能够在动态知识资产上进行实时协作。
Foundry为组织提供了一套“共同业务词汇”(common lexicon of business Objects),使用户能够直观地与企业的数字孪生体进行交互,以加速的方式构建定制化工作流和团队专属应用。随着更多工作流被构建并贡献运营知识,共享的本体不断积累和演化,变得更加健壮。在这个意义上,Foundry既是本体的“制造工厂”,亦即提供从原始数据到语义对象的完整构建工具链,也是本体的“运行平台”,使本体能够在企业运营中持续发挥作用并不断进化。
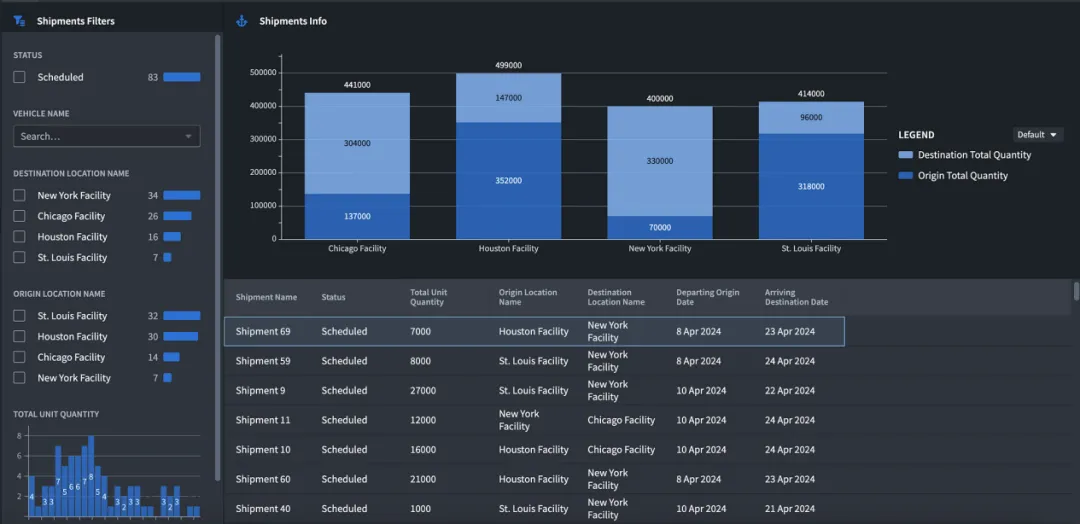
图 2 “铸造厂”系统界面(图片来源于网络,如有侵权请联系删除)
(二)多源异构数据集成
1.超过200连接器的数据接入能力
Foundry具备强大的数据接入能力,提供超过200种数据连接器和一个可扩展的插件式框架。这些连接器使Foundry能够与各类数据源建立双向连接,包括运营系统和事务系统(如SAP、Salesforce等商用平台),支持将查询“下推”到源系统执行。
在技术实现层面,Foundry采用Magritte框架实现与外部系统的对接,支持推拉两种模式,也支持自定义连接器开发。通过连接器框架,数据集成不再是周期性的抽取和注入,而是实时的双向连接,包括用户的集成操作、数据转换和决策结果被捕获并反馈回原始系统,同时保留完整的来源和血缘信息。
2. 结构化、非结构化、流式、物联网、地理空间等多模态数据支持
Foundry能够无缝同步企业内的多模态数据,涵盖结构化数据(如关系数据库表)、非结构化数据(如文本和文档)、流式数据(如实时传感器数据流)、物联网数据(如设备遥测)、事务数据和地理空间数据等多种类型。
在多模态数据支持方面,Foundry的多模态数据平面(Multimodal Data Plane, MMDP)发挥了关键作用。MMDP是Palantir的开放数据和计算架构,使Foundry和AIP能够与位于Palantir环境之外的计算资源进行编排。MMDP还包括虚拟表(Virtual Tables)框架,允许在Databricks、Snowflake或BigQuery等通用数据平台中利用现有数据资产,无需不必要的数据复制。此外,MMDP支持完全编排的下推计算,使Pipeline Builder等应用能够与现有的计算投资无缝协同。
(三)Pipeline Builder数据管道定义工具
1. 可视化与代码结合的管道构建方式
Pipeline Builder是Foundry的主要数据集成应用,用于构建将原始数据源转换为可供进一步分析的清洁输出的数据集成管道。其核心理念是“声明式”管道构建,依靠用户描述想要构建的管道,而非手工编写大量ETL代码。
Pipeline Builder采用下一代数据转换后端,专门设计为逻辑创建与执行之间的中间层。用户通过图形化和表单化的界面应用数据转换,无需专门的编程语言知识。后端在用户描述管道时自动编写转换代码并执行完整性检查,识别重构错误并提供解决方案。这种设计使有代码编写能力的用户和无代码编写能力的用户能够在同一管道工作流中协作。
Pipeline Builder支持批处理、微批处理和流式工作流,覆盖全系列目标输出类型。它集成了数百种常用函数,并支持轻松添加新函数。后端可扩展,能够使用不同的执行引擎,其中小规模数据使用内存引擎,经典批处理管道使用Spark,低延迟流式管道使用Flink。
Pipeline Builder的管道分支(pipeline branches)实现了版本控制,类似于Git中的代码分支。用户可以在分支上迭代修改,预览、保存和构建,满意后可提议合并回主分支。管道是数据集、数据期望和目标数据输出的链接,通过转换(transforms)相互连接。
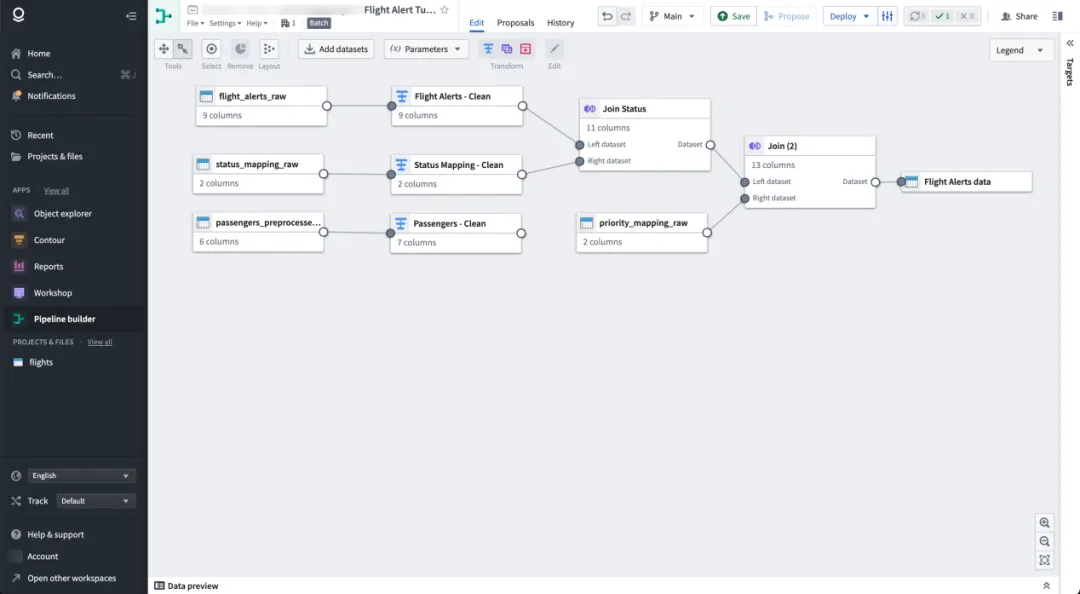
图 3 “铸造厂”系统Pipeline Builder
(图片来源于网络,如有侵权请联系删除)
2. 大语言模型集成的数据转换能力
Pipeline Builder集成了大语言模型(LLMs)和AIP的能力,用于数据转换。用户可以利用大语言模型的力量在管道内部进行数据转换,这为处理非结构化文本、语义搜索和基于自然语言的转换逻辑提供了新的可能性。Pipeline Builder还支持导入机器学习模型以在管道内生成预测。此外,Pipeline Builder提供了地理空间转换能力,用于加载、转换和输出不同形式的地理空间数据。
3. 端到端管道的版本控制与调度
Pipeline Builder支持端到端管道的创建和管理。其工作流包括以下步骤:添加数据源或额外数据集作为输入;通过转换、连接或合并数据向目标输出推进;预览转换后的输出;完成管道后构建管道输出;添加对象类型、链接类型或数据集作为输出。
在调度方面,Pipeline Builder支持在特定时间、按特定频率或基于上游资源状态触发构建。例如,可以设置在 upstream 数据集更新时触发构建。数据期望(data expectations)功能允许在输出和中间转换上设置单元测试,定义对数据集输出的要求。目前支持主键和行计数两种数据期望类型,如果任何期望失败,构建将被标记为失败。
(四)本体管理器(Ontology Manager)
1.对象类型、链接类型、行动类型的定义
本体管理器(Ontology Manager)是Foundry中用于定义和管理本体的核心工具。在本体管理器中,用户可以创建三种核心本体元素:
⚫ 对象类型(Object Types) :定义组织中的业务实体类型,如员工、航班、客户等。对象类型定义有时简称为“对象类型”,指本体实体的类型级信息。创建对象类型时,用户需要为其选择支撑数据集(backing datasource)。
⚫ 链接类型(Link Types) :定义两个对象类型之间的关系。链接类型是关系的模式定义,链接是同一本体中两个对象之间该关系的单一实例。例如,可以在Employee对象类型和Company对象类型之间创建链接类型,定义Employee与Employer之间的关系。链接可以存在于不同类型的对象之间,也可以存在于同一类型的两个对象之间——如Direct Report ↔ Manager链接类型可定义在Employee对象类型自身。链接类型支持一对一、一对多和多对多等多种基数。
⚫ 行动类型(Action Types) :定义可以对对象执行的操作。行动类型是受治理的事务(governed transactions),确保只有经过授权的用户才能在符合组织控制的前提下执行变更。
在数据层面,本体概念与数据集结构存在类比关系:对象类型类比于数据集中的表,对象类比于表中的行,属性类比于表中的列,链接类型类比于表之间的连接。
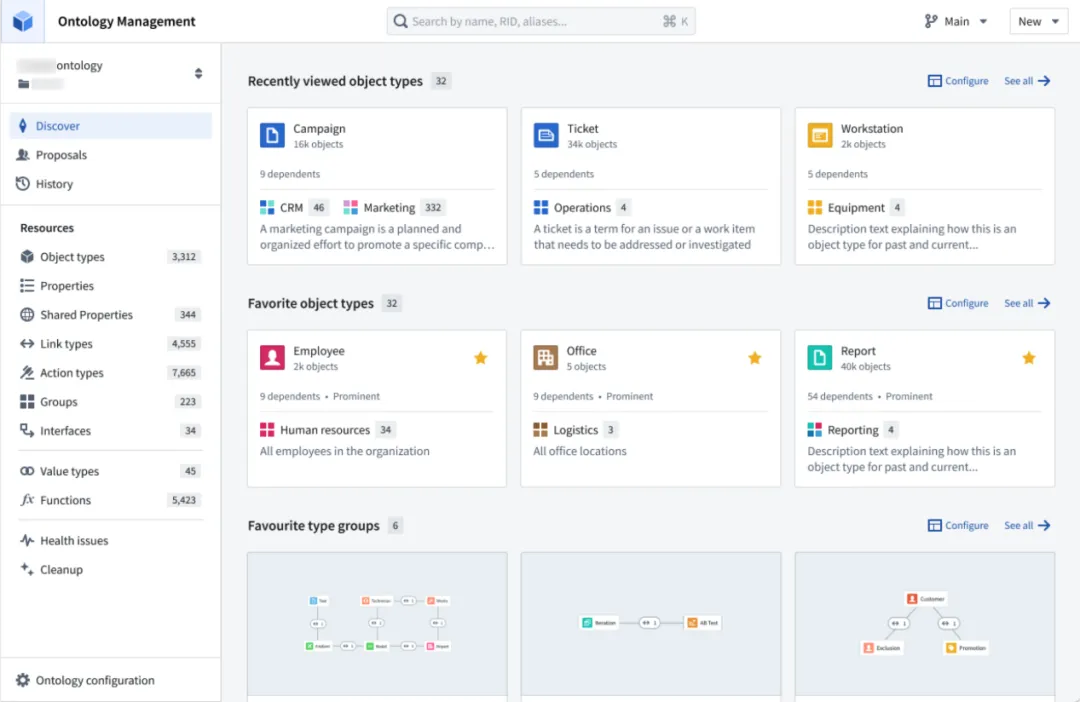
图 4 “铸造厂”系统本体管理器
(图片来源于网络,如有侵权请联系删除)
2. 本体资源的统一管理与版本控制
本体管理器提供了本体资源的统一管理界面。用户可以在其中查看、编辑和删除对象类型、链接类型和行动类型。本体管理器还提供了对象存储V1(Phonograph)到对象存储V2(OSv2)的迁移框架,用于迁移对象类型和具有连接表的多对多链接类型。
本体元素的API名称可以通过本体管理器查找,供开发者在API调用和代码中引用。本体管理器还支持不同Foundry分支之间的本体管理,允许在不同环境中维护和同步本体定义。
(五)动态对象映射
1. 实时将数据投影为本体对象
动态对象映射(Dynamic Object Mapping)是Foundry将底层异构数据源中的原始记录实时或近实时地投影为本体层对象的核心机制。这一过程将数据从静态的表格记录转化为具有唯一标识符、属性和关系的数字化对象。
动态对象映射代表了从单纯的数据存储向操作型智能的根本性跨越。与传统ETL的一次性批处理不同,Foundry的对象映射是一个持续的、状态感知的同步机制。通过引入对象数据漏斗(Object Data Funnel)服务,Foundry实现了数据流与语义层的解耦。
动态对象映射具备以下关键特征:
⚫ 元数据驱动:对象的定义与其物理存储分离,通过API名称进行逻辑绑定。
⚫ 多源融合:单个对象实例可由多个物理数据源共同“供养”。
⚫ 版本感知:系统能够处理数据源的模式变更(Schema Drift)。
在处理多源数据实体解析时,平台采用多数据源对象(Multi-Datasource Objects, MDOs)和接口类型(Interface Types)相结合的策略,支持属性级拼接和多态查询。
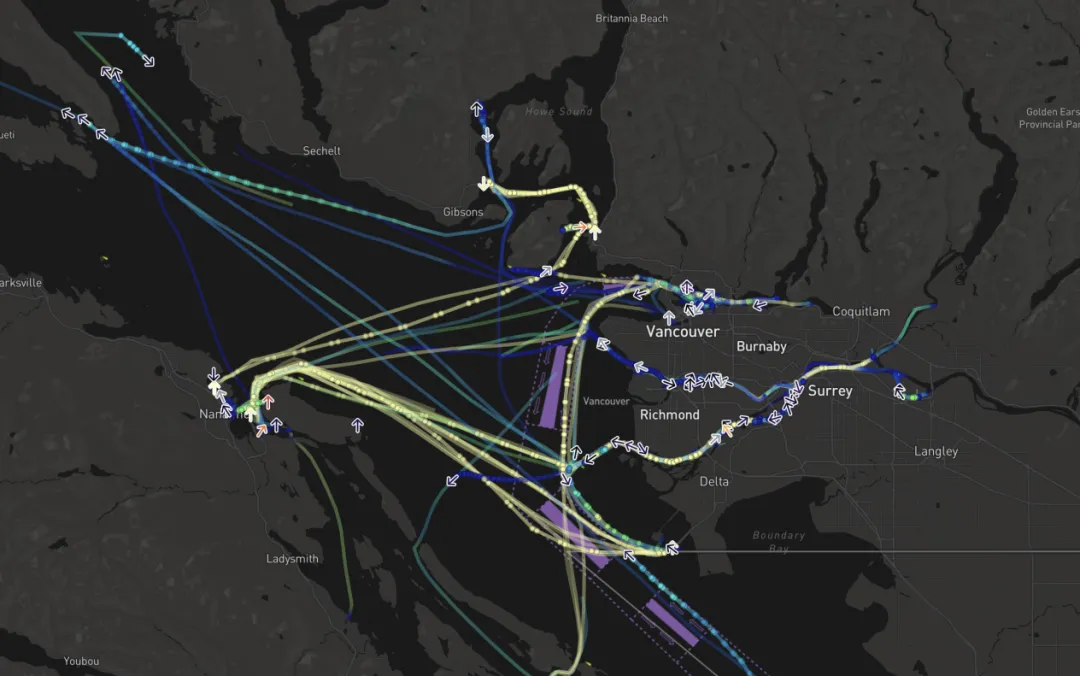
图 5 动态对象映射
(图片来源于网络,如有侵权请联系删除)
2. 映射规则的配置与动态调整
动态对象映射的规则可以通过本体管理器进行配置和调整。用户可以为对象类型选择支撑数据集,并通过API名称进行逻辑绑定。映射规则支持动态调整——当底层数据源的结构发生变化时,系统可以通过模式迁移框架(Schema Migration Framework)进行处理。OSv2引入了严格的模式迁移框架,通过元数据抽象和显式迁移指令,避免了传统数据库因模式不匹配而导致的系统崩溃,确保了本体层的韧性与连续性。
动态对象映射还支持对象数据在应用层(Workshop等)的读取,以及通过行动(Actions)将变更回写到底层数据源,形成完整的“读取—处理—写入”闭环。
(六)HyperAuto(SDDI)——软件定义数据集成
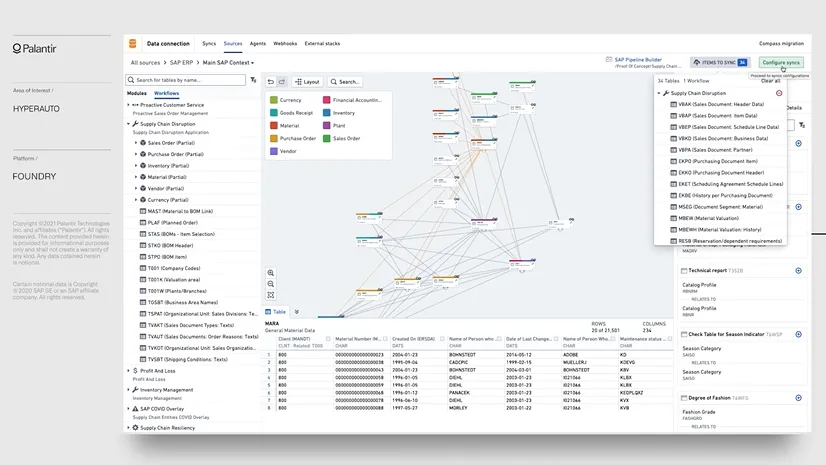
图 6 Palantir HyperAuto界面展示(图片来源于网络,如有侵权请联系删除)
1. 自动化数据管道生成
HyperAuto是Palantir基于软件定义数据集成(Software-Defined Data Integration, SDDI)技术的产品实现。SDDI是一种架构模式——通过程序化生成的管道来连接、清洗、规范化和协调ERP/CRM数据,使其成为可用于本体的数据资产。HyperAuto则是这一概念在Foundry中的具体实现。
HyperAuto的核心价值在于自动化数据接入、转换和建模的全过程。它从源系统构建数据管道,无需工程师编写一行新代码。在SDDI仓库中,用户可以通过配置文件定义数据同步的参数,包括可选过滤器和调度计划。SDDI仓库产生数据集,这些数据集可以直接用于后续的本体构建。
2. 从企业资源规划/客户关系管理系统到本体的快速构建
HyperAuto特别针对ERP和CRM系统的数据集成进行了优化。它能够连接并自动集成来自ERP和CRM系统的数据,在数小时内产生洞察,而非数月。一个常见的应用场景是大型组织中因并购而运行在不同版本上的多个ERP系统。
HyperAuto提供关键业务主题的即时360度视图:销货成本、库存、工厂、仓库、产品和客户等。它支持动态的“what-if”场景测试,以识别增加销售、优化产品组合和降低成本的机会。集成完成后,Foundry可以将结果写回源系统,实现持续学习。
HyperAuto使组织能够从企业系统生成本体,无需手动开发管道。它代表了从“人力定义”到“软件定义”的数据集成范式转变,将数据集成从需要深厚技术知识和大量时间投入的工程任务,转变为可配置、可自动化、可重复的标准化流程。
(七)本体构建工具链
1. 对象视图(Object Views)与对象资源管理器(Object Explorer)
对象视图(Object Views)是Foundry中围绕特定对象集中展示所有相关信息和工作的界面。Foundry默认为所有对象类型生成标准的对象视图。对象视图包含对象的核心概要数据、关联对象、关键指标以及指向相关应用或分析的链接。
用户可以通过对象视图环境中的原生组件集来创建和编辑对象视图。对象视图支持跨选项卡的组件和过滤器交互,以及基于组成员身份的安全配置文件来显示或隐藏选项卡。在Palantir应用(如Gaia或Vertex)中渲染的对象视图中,用户可以在标准视图和配置视图之间切换。
对象资源管理器(Object Explorer)提供了对本体的浏览和探索能力,使用户能够查看对象类型、属性和关系的完整结构,并支持搜索和过滤。
2. Vertex——流程可视化与场景测试
Vertex是Palantir面向流程可视化和场景测试的工具。它提供了将本体的对象、关系和行动可视化为业务流程的能力。在Vertex中,用户可以通过图形化界面设计端到端的业务流程,将语义层中定义的对象和动力层中定义的行动串联为可执行的工作流。
Vertex还支持场景测试——用户可以在隔离的环境中模拟业务流程的执行,验证业务逻辑的正确性,评估不同参数设置下的流程表现。这种场景测试能力与动态层的场景推演(Scenario Simulation)机制相互配合,共同支撑业务流程的验证和优化。
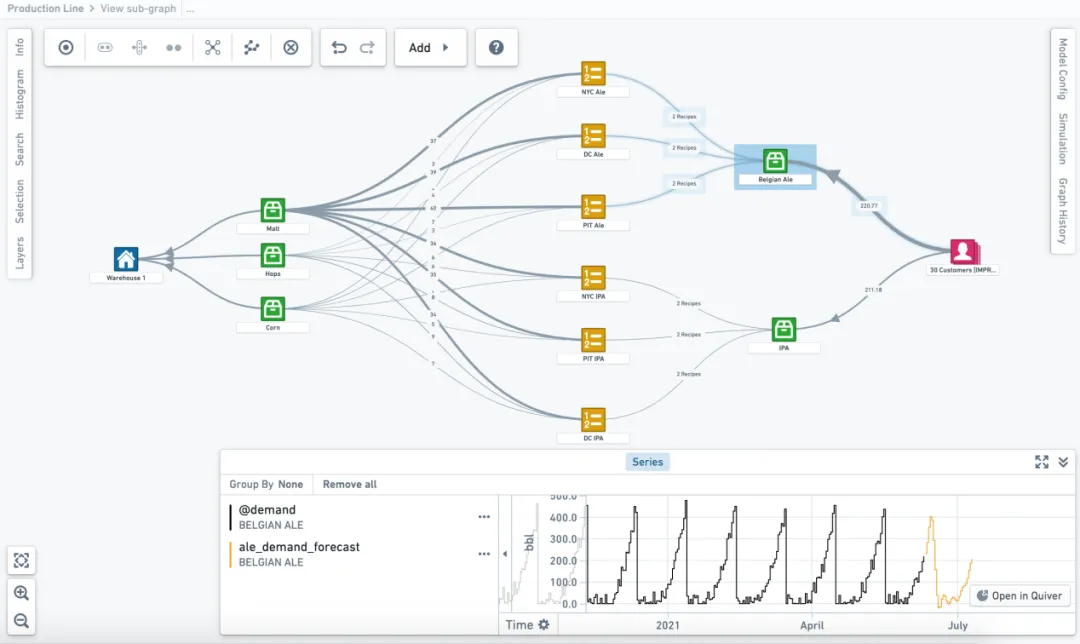
图 7 Palantir Vertex界面展示
(图片来源于网络,如有侵权请联系删除)
3. Foundry Rules——业务规则的定义与应用
Foundry Rules是Foundry中用于定义和管理业务规则的工具。业务规则在本体架构中扮演着关键角色——它们定义了对象状态变更的条件、行动的触发条件和权限边界。
在技术实现上,业务规则可以通过多种方式在本体中应用:可以通过对象视图中的定制逻辑来实现规则的展示和应用;可以通过函数(Functions)封装规则的判断逻辑;可以通过行动类型(Action Types)将规则嵌入到可执行的操作中。业务规则的定义与应用使组织能够将合规要求、业务策略和运营标准系统化地编码到本体中,实现业务治理的自动化和可审计性。
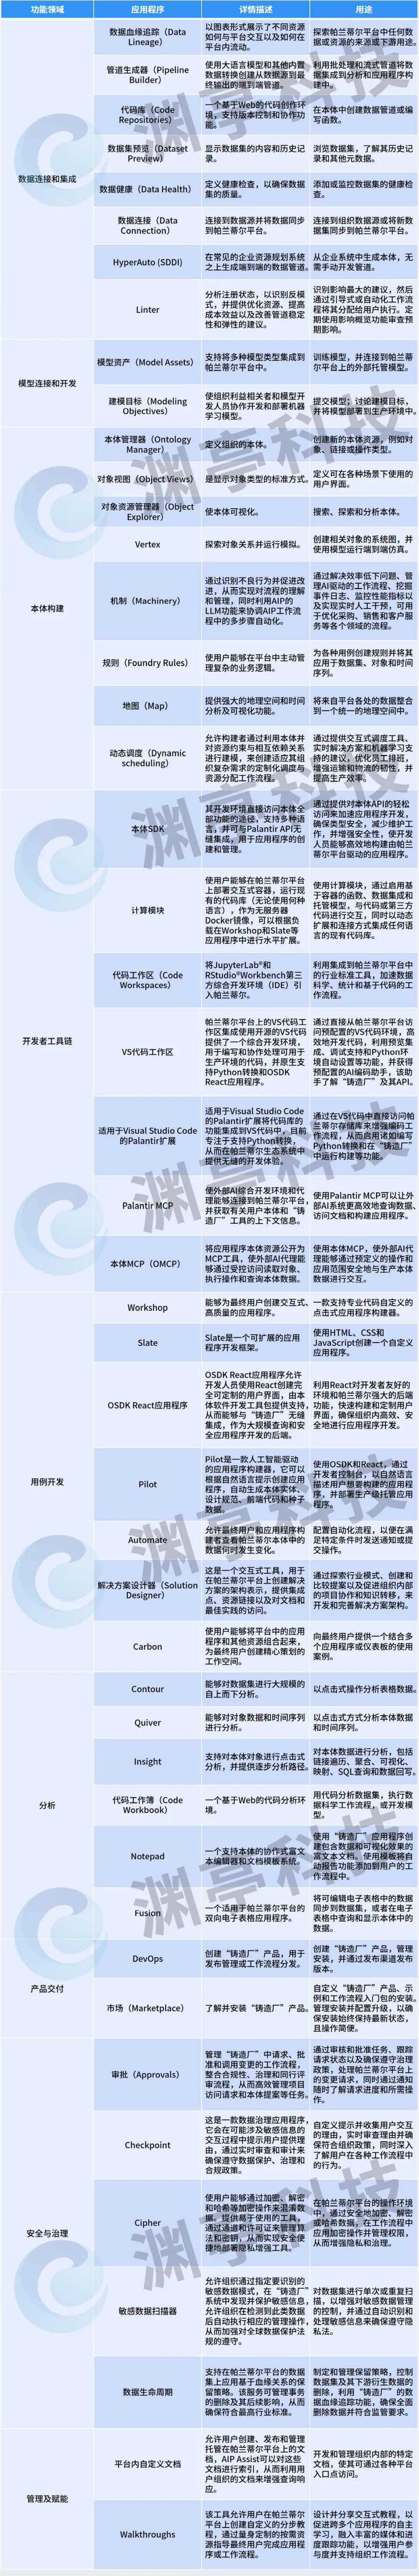
表 3 “铸造厂”应用程序
二、“哥谭”(Gotham)——本体在国防与情报领域的应用
在Palantir的产品体系中,Gotham是历史最悠久、与国家安全使命绑定最深的平台。如果说Foundry是面向企业客户的“数据操作系统”,Gotham则是面向国防、情报与执法领域的“作战决策系统”。两者共享同一套动态本体架构,但Gotham在应用场景、数据治理和安全协作方面具有更强的领域针对性。
(一)平台定位
1. 面向国防、情报与执法的端到端平台
Gotham是Palantir于2008年正式发布的首个平台产品。其研发动因可追溯至“9·11”事件后美国情报界对跨部门“数据孤岛”问题的系统性反思,核心设计目标为构建支持多源异构情报数据的语义化整合框架。Gotham主要面向政府和国防部门,提供军事和情报分析服务。它通过将各类物理世界信息整合到一个应用中,使分析师能够从看似无关的数据中发现联系——无论是金融欺诈、恐怖袭击预警还是军事行动规划。
经过十余年的迭代,Gotham已从最初的反恐情报分析平台,演化为覆盖情报分析、态势感知、目标识别、任务规划和作战评估等全链条的端到端平台。Gotham的核心功能是整合来自多个数据源的信息,特别是看似无关的数据,以发现金融欺诈、预防恐怖袭击或用于军事行动。
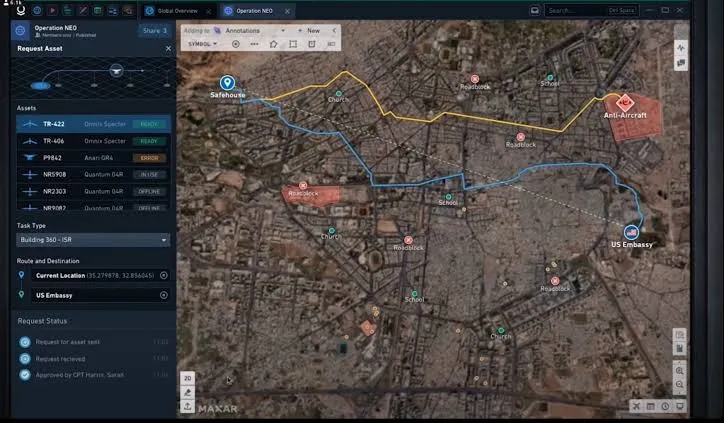
图 8 Palantir Gotham界面展示
(图片来源于网络,如有侵权请联系删除)
2. 安全协作、情报分析及调查活动的支撑
Gotham的设计目标是为国防、情报和执法机构提供一个安全协作的环境。平台实施严格的细粒度访问控制列表(Access Control Lists),权限可精准到对象的各个属性层面。结合防篡改的审计日志,Gotham能够在机密和多层安全环境下保障安全协作。
Gotham支持跨团队、跨组织的情报共享与协同调查。用户可以在受分类控制的混合网络环境中安全地交换信息。平台通过一系列技术框架实现这一目标:强制执行细粒度的访问控制和数据发现原则以落实“需要知道”原则;严格控制和审计分析工作产品的开发与共享;对特定类型的敏感数据查询实施目的说明和案件编号录入要求;生成详细的审计日志以支持对信息和情报使用的监督。Gotham还支持将调查结果和分析产品在平台内外安全共享。
(二)统一数据资产
1. 全组织单一数据源的构建
Gotham的核心能力之一是将分散在各机构、以不同格式存储的碎片化数据转化为统一的、可搜索的语义网络。它打破了传统数据仓库死板的行列限制,将数据转换为代表真实概念(如人员、地点、事件)的对象、属性和关系,形成组织的唯一真相源。
Gotham能够以任意格式集成来自异构数据源的数据——无论结构化还是非结构化。从可疑活动报告到犯罪记录、车牌识别数据、报警记录、现场访谈报告和车辆管理局记录等——所有数据都被纳入统一的语义框架。在这种统一的环境中,用户可以同时搜索地方、州、区域和联邦数据源,发现那些在数据碎片化于多个系统时无法被检测到的细微关联。
Gotham在数据层面的核心突破在于“在阅读数据时再确定数据结构”的设计理念。传统数据仓库要求预先定义固定的表结构,而Gotham采用“schema-on-read”(读取时定义模式)的方式,在本体层动态定义对象、属性和关系,从而适应不断变化的数据源和分析需求。
2. 跨系统、跨部门的数据共享与协同
Gotham通过本体驱动的语义层,实现了跨系统、跨部门的数据共享与协同。平台提供开放的REST API和行业标准格式,支持与第三方应用程序、模型及联邦系统进行互操作与扩展。
Gotham与Foundry共享同一本体架构,通过“类型映射”(type mapping)机制实现本体在两大平台之间的统一表示。完成类型映射后,Gotham能够通过对象集服务(Object Set Service)查询Foundry对象类型及其元数据。用户可以在Foundry和Gotham之间拖放数据对象,实现跨应用的数据共享与协同。
(三)通用作战图(COP)与通用情报图(CIP)
1. 本体驱动的战场态势统一视图
Gotham的核心能力之一是生成通用作战图(Common Operating Picture, COP)与通用情报图(Common Intelligence Picture, CIP)。通用作战图是指“统一展示多个指挥部门共享的相关信息,以促进协同规划并协助各级单位实现态势感知”。
在Gotham中,本体模型中的实体、事件和关系被自动渲染为军标、热力图、历史轨迹及三维地形等图层。系统将卫星图像、高光谱地图、社交媒体、人工情报及无人机视频等异构数据在统一坐标系下对齐,生成“数字孪生战场”。指挥官面对的不再是枯燥的报告,而是一个实时的数字化战场孪生体。
这种本体驱动的通用作战图与传统指挥信息系统存在本质差异:它不仅是数据的可视化呈现,更是本体语义层在空间维度的投影——地图上的每一个图标都对应本体中的一个对象,每一次点击都能追溯该对象的所有属性、关系和历史状态。
2. 多源情报的实时融合与呈现
Gotham的通用作战图支持多源情报的实时融合与呈现。平台集成MSS(Maven Smart System)边缘推理能力,能够自动识别数十类装备并回写坐标。系统将来自ERP系统、传感器、卫星和网络监控的数据整合到通用作战图中,以秒级更新的频率呈现战场态势。
Gotham还支持边缘离线模式——前线终端可以离线缓存特定区域地图,在恢复连接时自动同步,确保在网络不稳定环境下的持续作战能力。内置的大语言模型聊天机器人支持指挥官使用自然语言“问图”——例如查找打击目标、计算移动距离——并一键推送带火控参数的任务包。
(四)本体驱动的核心分析能力
Gotham在统一数据资产和通用作战图的基础上,提供了一套本体驱动的核心分析应用套件。这些应用共享同一本体语义层,使分析师能够在不同分析维度之间无缝切换。
1. Graph——链接分析与网络可视化
Graph是Gotham中最核心的分析应用之一。它提供一个可视化画布,用于展示实体及其关系网络。分析师在图上创建实体节点,拖拽连线建立关系,系统自动布局——这不是仪表盘或报表,而是一张可以无限展开的关系网络。
Graph的核心功能是进行链接分析(link analysis),被Palantir官方认为是“传达分析结论最关键的应用之一”。它内置“Search Around”(周边搜索)、直方图、时间轴等助手工具,帮助分析师挖掘隐藏的联系并进行推断。分析师可以通过Graph探索数据对象之间的语义关系,将实体及其关系可视化为节点和边的网络。结合时间轴、直方图和演示能力,用户可以可视化事件序列、按相似特征筛选对象、分析信息在网络中的流动。
Graph的革命性在于它将分散的情报碎片编织为可追溯、可验证的情报图谱,使分析师能够“看到联系”——原本隐藏在数十个独立数据库中的关联,在Graph中一目了然。
2. Gaia——地理空间分析与热力图
Gaia是Gotham的地理空间分析应用,提供统一的地图场景。用户可以通过Gaia进行地理标记、多边形搜索和路线追踪。Gaia支持直接集成实时数据流,帮助用户获得快速演变行动的实时态势感知。
Gaia与Foundry本体深度集成。用户可以通过六种方法将Foundry本体中的地理空间数据添加到Gaia中。这些方法包括拖放单个对象或对象集、对象搜索、搜索模板、地理时间序列同步、函数支持的企业地图层和版本化对象集支持的企业地图层。不同方法支持不同的数据规模和刷新延迟——从静态的单个对象到支持500万个对象实时更新的高规模数据集。
Gaia支持热力图模式,按地点显示实体的分布密度。用户可以将其他Gotham应用中的对象直接拖放到Gaia中,使规划和情报收集与地理空间分析同步进行。
3. Video——全动态视频分析与增强现实叠加
Video是Gotham中专门用于全动态视频(Full-Motion Video, FMV)分析的应用。它支持实时查看和分析全动态视频,用户可以在视频上叠加增强现实图层。
Video的核心功能是将来自Gotham的现有情报与对全动态视频的AI检测结果分层叠加。通过增强现实技术,用户能够快速理解不断演变的地理空间态势。Video支持集成第三方AI/ML模型进行自动检测,用户可以即时标记关键事件。
在军事应用场景中,Video使分析师能够将无人机或卫星的全动态视频与本体中的情报对象(人员、设施、装备)实时叠加,将“看到什么”与“知道什么”在同一个界面中融合。
4. Dossier——情报报告与协同编辑
Dossier是Gotham的协同文本编辑应用,用于编写情报报告。它支持实时协作——多个用户可以同时编辑同一份文档。Dossier文档可以长达数百页,包含复杂的格式、表格和实时的协同编辑。
Dossier的核心价值在于它超越了静态文档的范畴。Dossier捕获人类分析的过程和上下文,将其呈现在一个活态的、交互式的、持续更新的文档中。用户可以嵌入动态更新的实体和图表,使情报报告不再是分析完成时的“快照”,而是与本体数据实时同步的“活文档”。
Dossier支持跨团队、跨组织的协作。在国防和情报场景中,Dossier还支持多语言翻译模式——对于经常在多语言和高度受限环境中运作的国防和情报客户尤为重要。所有翻译都在安全的内部语言模型服务中运行,不会离开安全网络。
三、人工智能平台(AIP)——本体与AI的深度融合
Foundry与Gotham解决了数据的整合、语义化建模和业务执行问题,但在大语言模型时代,组织面临的挑战已从“如何组织数据”演进为“如何让AI理解并操作业务世界”。Palantir于2023年推出人工智能平台(Artificial Intelligence Platform, AIP),其核心设计理念是将AI能力“锚定”在动态本体之上,使大语言模型能够在业务语义的边界内进行推理和行动。AIP并非独立于Foundry和Gotham的附加层,而是构建在两者之上的AI能力层,通过两种方式叠加——新开发的AI模块和在已有模块上叠加AI能力。
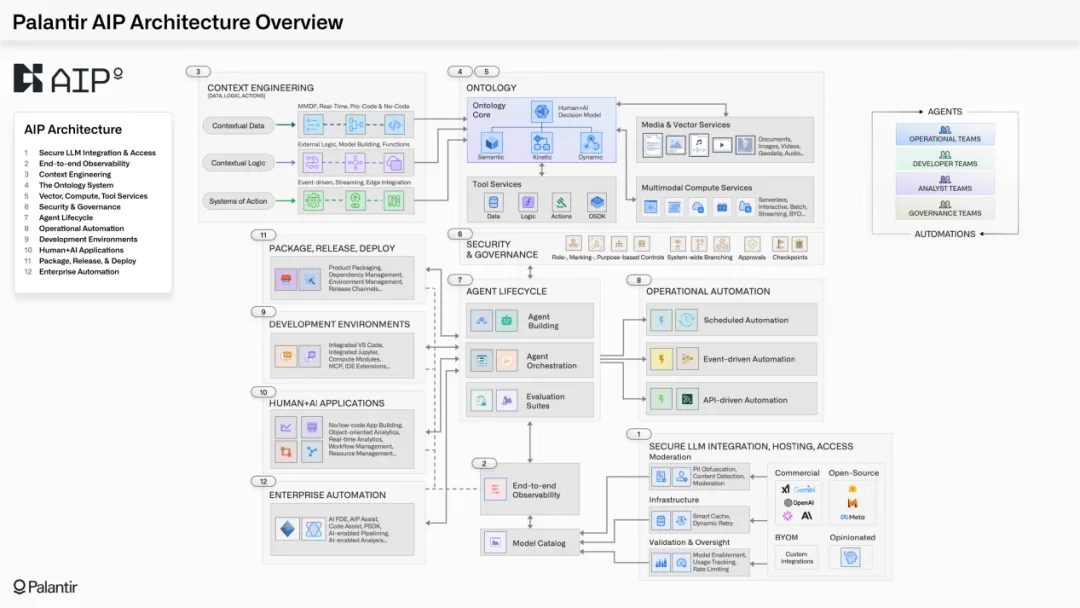
图 9 帕兰蒂尔AIP架构(图片来源于网络,如有侵权请联系删除)
(一)平台定位
1. 将AI与数据及运营流程深度融合
AIP的定位不是提供独立的AI工具,而是将AI能力深度嵌入到组织的整个数据与运营体系中。Palantir首席架构师Akshay Krishnaswamy指出,Palantir的软件为全球许多关键商业和政府环境中的实时AI驱动决策提供支撑。AIP的核心差异化优势在于其围绕本体构建的软件架构——本体被设计用来表示企业中的决策,而非仅仅是数据。
AIP的设计理念是,AI不应是独立于业务系统之外的“外挂”,而应成为组织决策与运营流程中原生的组成部分。AIP通过将数据、逻辑和行动整合到一个统一的、可扩展的、动态的协作基础中,使AI能够在业务语义的边界内进行推理和行动。这一架构使AI从“对话工具”升级为“执行引擎”——AI不仅能回答问题,还能通过本体中定义的行动和函数直接执行业务操作。
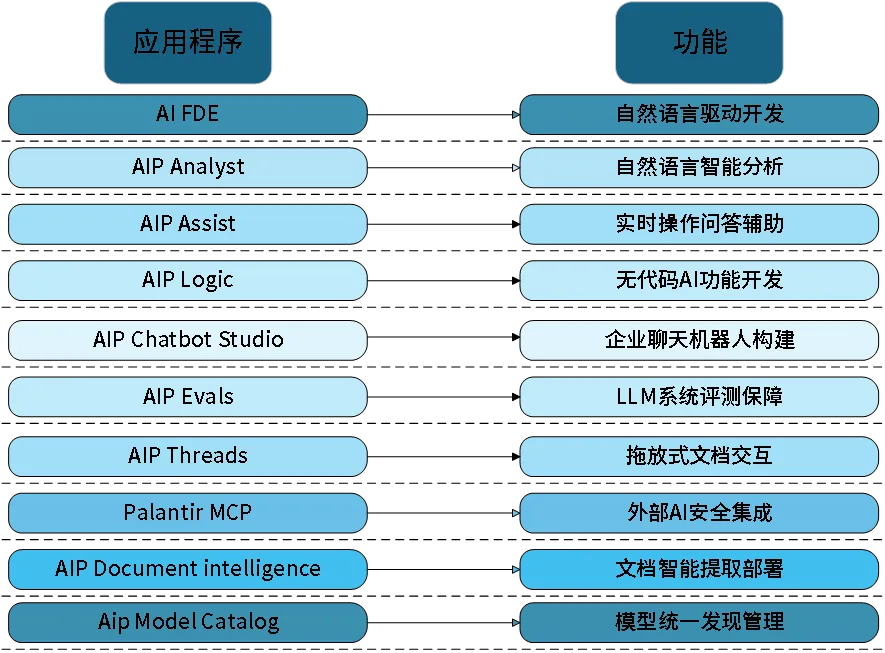
图 10 AIP包含的应用程序及功能
2. 覆盖从开发者到一线用户的AI工具链
AIP提供了一套覆盖从开发者到一线用户的完整AI工具链。开发者可以使用AIP Logic构建无代码的AI功能;数据分析师可以通过AIP Analyst用自然语言进行本体探索和即席分析;业务用户可以通过AIP Chatbot Studio与基于本体的智能助手交互;而AI工程师则可以使用AIP Evals对AI工作流进行系统化的测试与评估。这种从开发到部署到评估的全链条覆盖,使组织能够将AI能力系统性地嵌入到各个层级的工作流中。
(二)本体作为AI的“锚点”
1. 为AI提供业务世界的结构化理解
在大语言模型的应用中,一个核心挑战是模型缺乏对特定业务领域“事物是什么、事物之间如何关联”的结构化理解。传统RAG(检索增强生成)通过向量检索将相关文档片段注入模型上下文,但文档本身是非结构化的,模型仍需从文本中“推断”业务语义,这一过程容易产生偏差。
Palantir的解决方案是将本体定位为整个AI平台的“语言”。AIP将本体构筑为统一的语义环境:大模型在本体中映射业务术语,再结合实体属性生成具体方案。本体为AI提供了业务世界的结构化理解——AI知道“客户”是什么、“订单”是什么、两者之间如何关联,以及可以执行哪些操作。这些知识不是通过文本推断得出的,而是通过本体中明确定义的对象类型、链接类型和操作类型直接注入模型的。
在技术实现上,AIP通过“本体增强生成”(Ontology Augmented Generation, OAG)将RAG提升到新的层次。OAG将大语言模型锚定在给定企业的运营现实中——本体将决策的三个构成要素——数据、逻辑和行动——整合到一个统一的系统中。本体使AI的输出与业务语义对齐,而非仅仅处理抽象的文本或数据表。
2. 降低大模型在企业场景中的适配成本
在没有本体的情况下,将大语言模型适配到企业特定场景需要大量工程工作:编写提示词模板、定义API调用、处理数据格式差异、构建上下文窗口等。每个新场景都需要重复这一过程,成本高且难以规模化。
AIP通过本体作为统一的语义层大幅降低了这一适配成本。AI开发者只需在本体中定义一次业务实体和关系,所有基于本体的AI应用——无论是AIP Logic函数、AIP Analyst查询还是AIP Chatbot——都共享同一套语义定义。新场景的AI能力开发不再需要从零构建业务语义理解,而只需在本体定义的框架内配置新的逻辑和行动。AIP使组织能够将AI能力从“一次性项目”升级为“可复用的平台能力”。
(三)AIP核心组件
AIP的四个核心组件,即AIP Logic、AIP Analyst、AIP Chatbot Studio和AIP Evals,都直接构建在Ontology之上。它们共同构成了一套从AI功能开发到业务分析到智能交互到质量保障的完整工具链。
1. AIP Logic
AIP Logic是一个无代码开发环境,用于构建、测试和发布由大语言模型驱动的函数。其核心特征在于:所有Logic函数都直接构建在本体之上,能够利用本体中的对象、属性和链接类型作为输入和输出。
AIP Logic的运作方式如下:开发者通过直观的界面设计提示词(Prompt),配置工具(Tools)使大语言模型能够访问本体中的对象和函数,定义输入参数(可以是本体对象或文本字符串)和输出格式。函数可以返回对象、字符串或直接对本体进行编辑。例如,一个基于AIP Logic构建的投诉处理函数可以接收一个投诉对象作为输入,让大语言模型查找类似的历史投诉记录,推荐解决方案,并将结果写回本体。
AIP Logic的关键价值在于它将大语言模型的能力“封装”为本体中的可复用函数。这些函数可以被Workshop应用调用、被Automate工作流触发、或被其他AIP Logic函数组合使用。业务逻辑从分散的代码中被集中到本体层进行管理和治理。AIP Logic还支持自动化执行——本体编辑可以自动应用或暂存供人工审核。
2. AIP Analyst
AIP Analyst是一个面向智能体工作流的界面,允许用户使用自然语言在本体上执行即席分析。用户可以向AIP Analyst提问,智能体通过自主搜索本体、创建对象集和转换数据来回答问题,并生成摘要和可视化。
AIP Analyst的典型工作流程如下:用户提出一个问题(如“哪些咖啡店在10公里范围内?哪些连锁店最为突出?”),AIP Analyst使用多个搜索词在本体中搜索相关数据,找到相关对象类型后,应用地理空间过滤器和聚合操作,最终生成摘要和可视化。在整个过程中,AIP Analyst“展示其工作”——生成交互式依赖图显示从问题到答案的推理流程,用户可以查看每个步骤、验证逻辑、手动调整。
AIP Analyst的核心价值在于降低了本体探索的技术门槛。非技术用户无需学习查询语言或理解底层数据结构,即可通过自然语言与本体交互。同时,AIP Analyst支持执行Foundry行动和函数,使分析可以直接转化为业务操作。AIP Analyst还可以揭示数据质量问题(如过时记录),帮助团队在等待数据完美之前就开始工作。
3. AIP Chatbot Studio
AIP Chatbot Studio(原名AIP Agent Studio)允许用户构建交互式智能助手——AIP Chatbots。这些聊天机器人由大语言模型驱动,并配备了企业特定的信息(本体、文档)和工具(行动、函数)。
AIP Chatbots的核心特征在于它们与本体深度集成。聊天机器人的检索上下文(Retrieval Context)第一类即为“本体上下文”(Ontology context),可以静态指定一组对象,也可以基于向量做语义搜索来拉取最相关的对象。这意味着AI助手对业务世界的理解不是来自零散的文档,而是来自本体所定义的结构化语义网络——它知道“客户”是什么、“订单”是什么、两者之间如何关联,以及可以执行哪些操作。
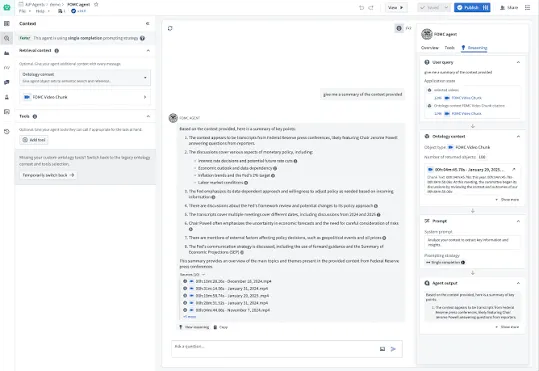
图 11 AIP Chatbot Studio(图片来源于网络,如有侵权请联系删除)
AIP Chatbot Studio支持将聊天机器人嵌入到Workshop应用或通过Ontology SDK和平台API对外暴露。聊天机器人可以执行读写操作——读取本体对象作为上下文,通过绑定本体行动(Ontology Actions)或函数来修改本体状态。这种“可读可写”的智能助手使AI能够从“回答问题”升级为“执行业务操作”。
4. AIP Evals
AIP Evals是一个测试环境,用于评估AIP Logic函数、AIP Chatbot函数或代码编写函数的性能。它专门针对大语言模型的非确定性特征而设计,允许用户创建测试用例、定义评估函数来衡量性能,并将结果与函数的历史版本进行对比。
AIP Evals与本体之间的依赖关系体现在测试数据的组织和评估基准的构建上。用户可以将测试数据集构建为本体中的对象,然后通过“基于对象集的评估套件”(Object set-backed evaluation suite)将其引入AIP Evals。这意味着评估场景本身是以业务对象的形式存在于本体中的——测试用例不再是抽象的输入输出对,而是带有业务语义的实体和关系。
AIP Evals支持的功能包括:创建测试用例并定义评估标准、调试和迭代改进函数与提示词、比较不同模型在同一函数上的表现、检查多次运行的方差。通过AIP Evals,组织可以建立将大语言模型支撑的函数投入生产所需的信心。与传统的抽象基准测试不同,AIP Evals允许使用专家验证的“金标准”场景构建评估套件——这些场景编码了领域规则(如某个替换在上下文中是否真的允许)。
(四)本体约束AI的三重机制
本体约束AI的三重机制共同构成了Palantir AIP区别于通用AI平台的核心特征。这一机制使AI从“可能出错的黑箱”转变为“在业务规则边界内可审计、可追溯的执行者”。
1. 本体增强理解
本体增强理解是第一重机制。在没有本体的情况下,大语言模型对企业特定术语和概念的理解依赖于训练数据中的文本模式——这既不可靠(训练数据可能不包含企业特定术语),也不精确(同一概念在不同上下文中可能被不同地理解)。
本体通过将业务术语及其定义、关系和约束显式地编码为结构化知识,解决了这一问题。当AI通过AIP与本体交互时,业务术语不是作为文本被“推测”,而是作为本体中定义的对象类型、属性和链接类型被“理解”。例如,当用户问“哪些订单需要紧急处理”时,AIP Analyst首先在本体中定位“订单”对象类型、“紧急”属性的定义(可能基于交货日期、客户优先级等多个因素的综合判断),以及“处理”这一行动的含义。本体为AI提供了精确的、可执行的业务语义理解,而非模糊的、基于文本推断的近似理解。
2. 本体约束输出
第二重机制是本体对AI输出的约束。大语言模型的“幻觉”问题源于其本质——模型被训练来预测最可能的下一词元,而非返回真实或准确的答案。在没有外部约束的情况下,模型可能生成表面上合理但事实上错误的输出。
本体通过在三个层面约束AI输出,降低了幻觉风险:
⚫ 数据层面的约束:AI只能基于本体中实际存在的对象和属性进行推理,不能“发明”不存在的实体或属性。如果问“HS302航班的当前状态”,AI必须查询本体中是否存在“HS302”这一航班对象及其“状态”属性——如果不存在,AI无法虚构。
⚫ 逻辑层面的约束:AI的推理必须遵循本体中定义的业务规则和关系。如果本体定义“航班延误4小时以上需自动通知乘客”,AI在推理时必须遵循这一规则,而非自行判断。
⚫ 行动层面的约束:AI只能调用本体中已定义并赋予其权限的行动,不能自行创造新的操作。行动内部封装了权限检查、变更窗口检查、影响评估等治理逻辑。
通过这三重约束,AI的输出被限定在“基于真实数据、符合业务规则、可执行”的边界内。AI的“想象空间”被业务规则所约束,从根源上消除了幻觉问题。
3. 本体支持推理
第三重机制是本体对AI推理过程的支持与记录。在传统AI应用中,决策往往是一个黑箱,用户看到输出,但无法追溯AI是如何得出这一结论的。这在业务场景中尤其成问题。如果AI建议取消一个订单,业务负责人需要知道“为什么”,是基于供应商延迟、库存不足,还是其他原因。
本体通过将推理过程记录为本体中的结构化数据来解决这一问题。AIP Analyst在每次分析中生成交互式依赖图,显示从问题到答案的推理流程。用户可以看到智能体如何推理请求、检查中间结果、手动调整步骤。最终摘要包含内联引用,链接到支撑响应的具体工具结果。
AIP Logic函数同样支持推理过程的记录与追溯。函数的输入、输出和中间步骤都可以被记录和审计。这种“可解释的AI”不仅满足了合规和审计要求,更重要的是帮助用户建立对AI决策的信任。当用户能够看到AI“如何思考”时,他们更可能接受AI的建议,也更可能在AI出错时发现并纠正问题。
通过本体增强理解、本体约束输出和本体支持推理这三重机制,AIP将大语言模型从“可能产生幻觉的文本生成器”转变为“在业务规则边界内可审计、可追溯的决策辅助工具”。这是Palantir AIP区别于通用AI平台的核心特征,也是其能够在国防、医疗、金融等高合规要求场景中得到应用的关键原因。
四、“阿波罗”(Apollo)——本体的持续交付与运维
Foundry构建了本体,Gotham将本体应用于国防与情报领域,AIP将本体与AI深度融合。然而,这些平台要真正在各类异构环境中持续运行并保持更新,还需要一套统一的交付与运维体系。Apollo正是承担这一职能的平台。它负责协调Gotham和Foundry两大平台的配置管理与软件更新,确保本体能够在物理数据中心、公有云及边缘计算等异构环境中实现标准化部署。Apollo是Palantir的持续交付与持续运维平台。Palantir最初构建Apollo是为了让其软件能够在客户所在的任何环境中持续交付——无论是在云端、本地数据中心,还是在断网的气隙环境中。在Palantir的通用架构中,Apollo负责跨环境的部署、更新与安全协调,解决了复杂解决方案在多云或边缘环境下的“孤岛化部署”难题。
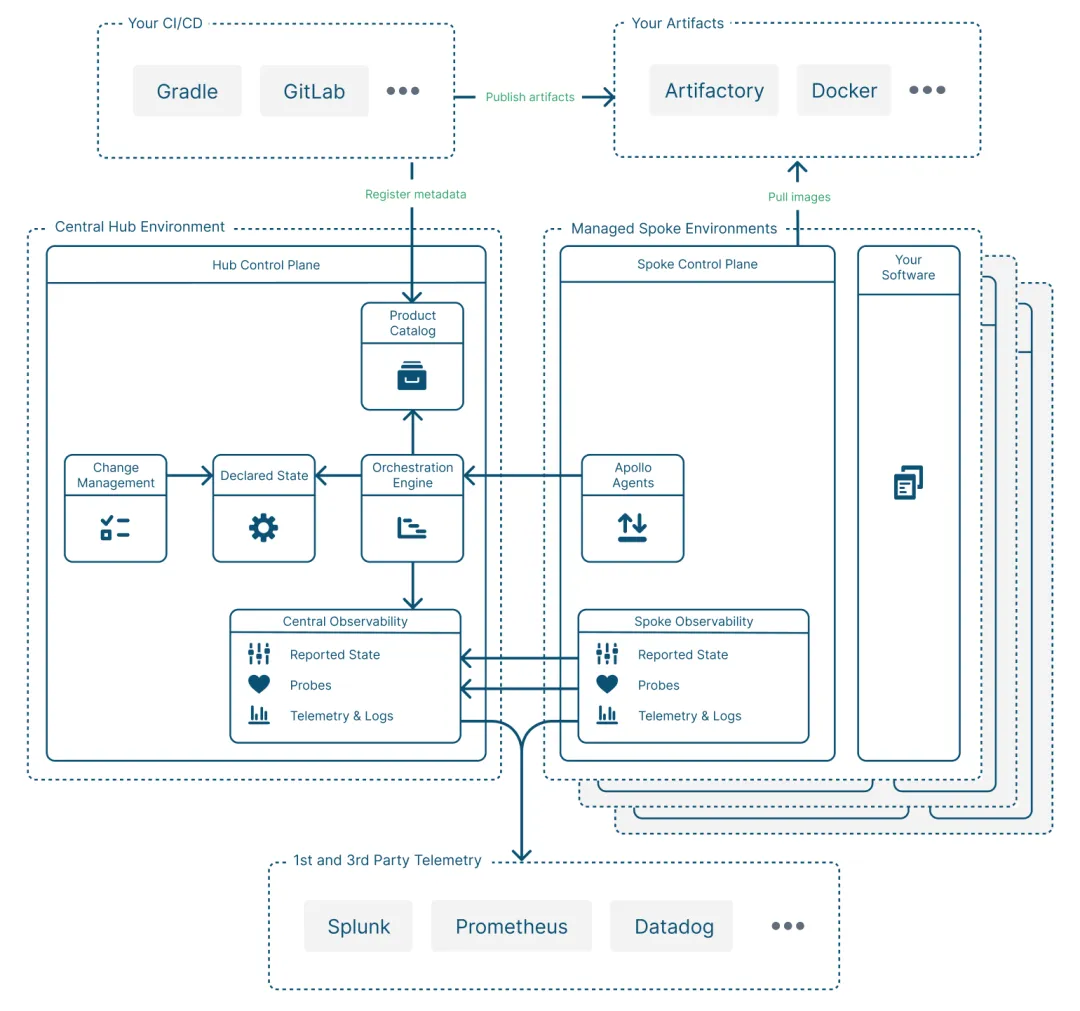
图 12 “阿波罗”平台架构(图片来源于网络,如有侵权请联系删除)
(一)平台定位
1. 可扩展的软件管理与部署平台
Apollo是一个可扩展的软件管理与部署平台。Apollo被用于升级、监控和管理Palantir产品在云端及全球最严格管控环境中的每一个实例。Apollo提供单一控制层来协调新功能、安全更新和平台配置的持续交付。在Palantir的通用架构中,Apollo是管理Foundry和AIP服务底层基础设施的持续交付平台,能够每天协调数千次零停机升级。
Palantir将Apollo定位为“软件部署的任务控制中心”。它使客户能够将软件部署到任何设备、任何地点,并实现规模化部署。Apollo将经过数十年运行关键任务软件平台所锤炼的运维最佳实践编码为可重复执行的流程。Apollo的核心设计理念是“声明式状态”——用户描述应该运行什么(哪些产品版本、在哪些环境中、使用哪些配置和依赖关系),Apollo负责将现实状态与该描述进行调和。
2. 关键任务软件系统的持续交付
Apollo的设计目标是为关键任务软件系统提供持续交付能力。传统企业软件的部署面临一个根本性挑战:部署环境正在呈指数级扩张。到2016年,云计算兴起改变了部署范式,但随后六年内,组织面对的已不再是单一的云,而是由公有云、私有云和混合云构成的“满天云朵”。主权云、数据驻留限制、本地部署需求以及边缘计算和物联网的兴起,共同推动了部署环境的扩张。
Apollo通过“声明式拉取”模型解决了这一挑战。与传统CI/CD的线性“推送”模型不同,Apollo采用声明式拉取模型:开发者定义带依赖的软件工件,由运行在各环境中的代理拉取、验证并按策略应用。这种架构使Apollo能够将软件部署到供应商无法登录的环境——客户云、本地数据中心、气隙网络、保密区域、舰船和边缘设备。Apollo还利用发布通道、浸泡时间、蓝绿部署和自动回滚来确保平台保持最新状态并全天候运行。
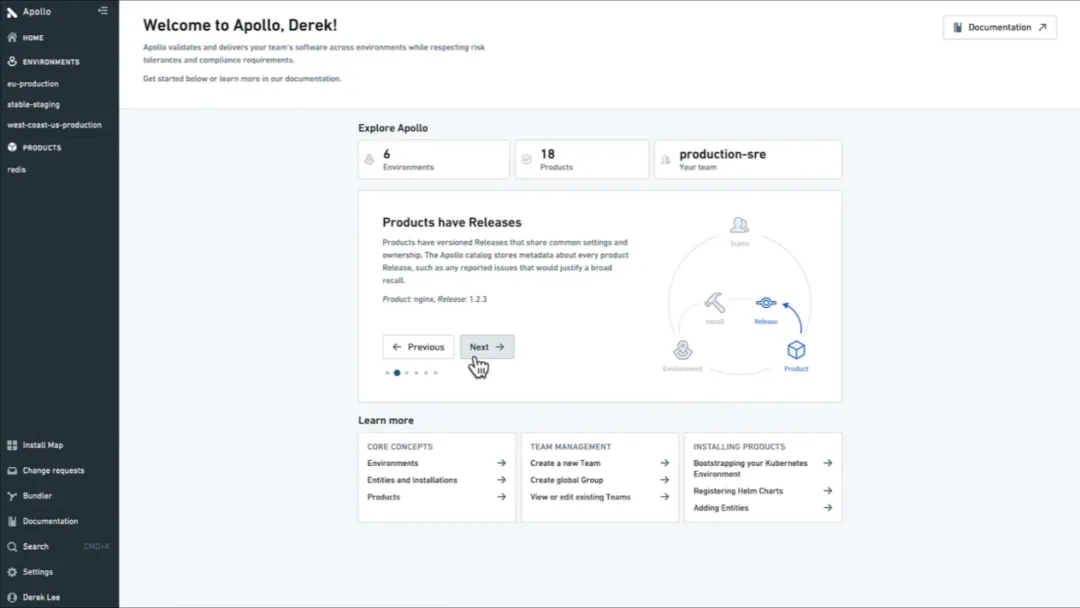
图 13 “阿波罗”平台界面
(图片来源于网络,如有侵权请联系删除)
(二)跨环境的本体配置同步
1. 云端、断连环境、低带宽环境下的本体定义与配置管理
Apollo支持所有主流云环境、本地部署和断网(气隙)环境。从本地数据中心到边缘硬件,再到跨云环境,Apollo能够将软件安全、自主地交付到地球上的任何环境。Apollo使多云、混合云、私有SaaS乃至气隙和边缘环境都能使用相同的先进工具进行部署和运维。
在断连环境中,Apollo解决了传统持续交付模型在“DIL环境”(断连、间歇、受限)中完全失效的问题。边缘设备可能经历间歇性或不可靠的网络连接,Apollo被设计用来减轻这些下游影响。Apollo能够处理连接性和规模方面的挑战、节点丢失或网络重新分区等情况。
Apollo通过Palantir二进制传输服务(Binary Transfer Service, BTS)实现了跨安全域的软件交付。BTS自主协调产品和产品元数据在不同域之间的传递,解决了传统“人力传输”(将软件刻录到DVD、步行穿过隔离网络、手动扫描漏洞)的低效问题。这一机制使本体定义和配置能够在云端、战术边缘和断连环境之间保持同步。
2. 中心环境与分支环境的协同架构
Apollo采用中心辐射式架构。一个中心化的Apollo Hub维护每个部署环境的状态和独特需求,并向每个被管理环境中的Apollo部署平台下发执行计划。环境模型定义了环境的分层、分级和分组方式,这一结构决定了发布如何流动。
在具体运作中,用户使用带有Apollo Hub的SaaS配置,将Spoke环境连接到Apollo Hub,从Apollo产品目录将软件安装到Spoke环境中,并可召回“错误”的软件版本并定义回退策略。Apollo还提供单一控制面板来理解和跨所有服务及环境管理软件部署。
这种中心辐射式架构支持大规模部署。Apollo在2017至2022年间的测试中实现了每天数千次升级(每周约90,000次),软件变更的准备时间少于四分钟。Apollo还采用自动扩缩容基础设施,适应突发工作负载并无缝处理大规模数据。
(三)边缘-战术-战略三层部署模型
Palantir的技术栈可以部署到从企业数据中心到战术边缘的任何环境,使用客户选择的任意硬件。这种硬件无关的方法为美国政府客户提供了一个单一、可重复的认证包,适应任何架构——从大规模本地数据中心部署到设计用于在车辆后部移动和生存的小型化设备。国防信息系统局(DISA)已授权Palantir联邦云服务(PFCS)Forward,将现有影响级别5和影响级别6的临时授权扩展到涵盖本地部署和边缘部署。这一授权使“一次授权,多次使用”的模式成为可能。
在具体的部署层次上,Apollo支撑着边缘、战术和战略三个层面的协同:
战略云是后端大规模模型训练与全局版本控制的场所。战略云部署在集中式数据中心或公有云中,承载完整的Palantir平台栈(Foundry、Gotham和AIP),负责大规模数据处理、模型训练和全局本体的版本管理。战略云中的本体定义和配置通过Apollo向下分发至较低层级。
战术云是战区级中继计算节点。战术云部署在战区级的数据中心或前沿基地,作为战略云与边缘节点之间的中继层。在战术云中,Gotham和Foundry平台以较小的实例规模运行,接收来自战略云的软件更新和本体配置,并将经过本地处理的情报和决策信息向上回传。战术云还负责管理其辖区内的多个边缘节点的软件分发和状态监控。
边缘层是轻量级AI代理部署于前端节点的层级。边缘设备部署在传感器、摄像头、物联网设备或空中无人机等最前端。这些设备是专用设备,与传统服务器或云环境相比,可能具有有限的处理能力、内存和存储。Apollo控制每个独特设备上安装和卸载的内容,提供无缝的升级编排和模型与应用替换,同时持续优化边缘设备有限的资源。在边缘层,ISR无人机可以本地运行量化后的AI模型,查询边缘部署的微型本体以进行战术决策,实现零互联网连接。
三层模型的核心价值在于:使软件能够在从战略数据中心到战术前沿的完整频谱上一致运行,同时保持统一的运维控制和本体语义一致性。
(四)在轨升级能力
1.在轨软件与AI模型的差异化升级 Apollo的在轨升级能力在元星座(MetaConstellation)系统中得到了集中体现。元星座是Palantir将AI能力拓展至太空领域的核心系统,与现有卫星网络集成,优化数百个轨道、地面和飞机传感器以及AI模型。元星座系统目前已对接了超过400颗商业卫星。元星座系统创造性地利用Apollo作为在轨升级的基础设施,实现AI模型的上注与更新。
在轨升级面临的核心约束是星地链路通信带宽有限。传统方式下,向在轨卫星传输完整的AI模型文件受限于带宽瓶颈而难以实现。Apollo通过在轨升级机制解决了这一问题:系统计算新旧版本模型之间的差异,生成一个模型优化包(即差分更新包),对两个版本的差异进行校验,通过地面站上注优化包后,在实例化边缘AI引擎之前重建软件新版本。这一机制使AI模型在轨升级成为可能——AI模型更新后,仅将差分权重通过安全同步机制回传地面。
在带宽利用方面,差分更新算法能够在2.7MB/s的有限上行链路带宽下,在3分14秒内完成500MB规模的模型更新。这种高效的差分更新机制使在轨AI模型能够以48小时的周期持续迭代。系统通过持续接收战场数据,自动优化AI模型(如提升伪装目标识别率),并在轨完成模型更新。
2.低带宽环境下的增量更新与差异校验
Apollo的在轨升级能力建立在更通用的低带宽环境增量更新技术之上。在星地链路等低带宽环境中,Apollo会计算并发送一个优化包,对新旧版本的差异进行校验。
增量更新机制解决了边缘计算中的核心挑战:在带宽受限的环境中,传输完整软件包或模型文件往往不可行。Apollo通过仅传输变化部分(差分更新),大幅降低了数据传输量。这一机制不仅适用于在轨卫星,也适用于其他低带宽边缘环境——如舰船、潜艇、偏远前哨站等。
差异校验机制确保了增量更新的可靠性。Apollo在发送优化包之前,会计算新旧版本之间的差异并校验其正确性。地面站上注优化包后,边缘节点在实例化新版本之前重建完整软件,确保更新后的系统状态与预期一致。这种“校验—传输—重建”的流程在保障更新效率的同时,也维护了系统的安全性和完整性。Apollo通过其基于约束的求解引擎、适应极低带宽的智能差分更新技术和跨安全域的二进制传输服务,为边缘环境中的关键任务提供了可靠的数字化底座。
五、“元星座”(Meta-Constellation)
元星座(Meta-Constellation)将本体架构进一步延伸至太空领域,实现了本体从地面到在轨卫星的跨越。元星座是Palantir于2021年发布的卫星信息系统,其核心定位是将AI模型部署到在轨卫星,在全球范围进行实时监控和数据收集,提供行星级的时敏信息支持。该系统已接入超过400颗商业卫星,提供系统级智能调度与近实时在轨分析能力。
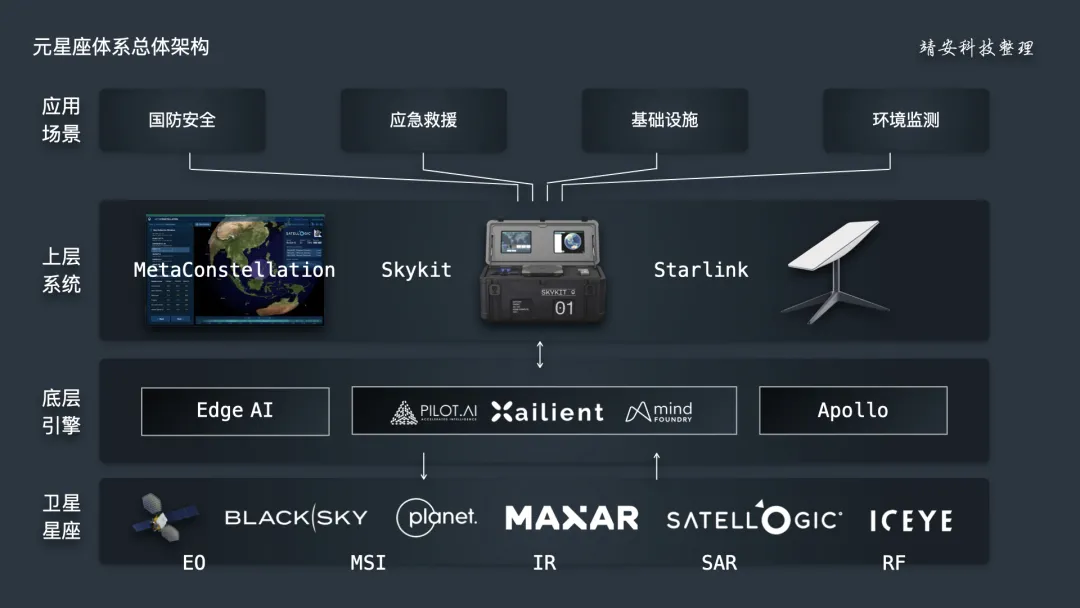
图 14 元星座总体架构
(一)平台定位
1. 全球领先的太空AI决策支持平台
元星座是当前全球最先进的太空AI决策支持平台之一。其本质是太空边缘智能体网络,让天基资源成为一台可实时发现和调取地球数据的“活体计算机”。元星座将“卫星数据处理的AI模型、多域协同的工作流”进行模块化封装,并在军事、政务、商业等不同场景中快速迁移,形成“感知—分析—决策”的闭环。
元星座的提出反映了Palantir对太空战略价值的前瞻判断。近年来,美国日益关注太空战略力量的建设,Palantir自2020年以来一直与美国太空部队合作,元星座正是为此而生的太空情报系统。元星座与现有卫星网络集成,优化数百个轨道、地面和飞机传感器以及AI模型,协调数百颗卫星解决复杂问题。其目标是通过将AI部署到轨道上,用卫星星座的力量赋能地面决策者。
2. 多源卫星数据与人工智能技术的融合
元星座是一个数据集成平台,将来自多种传感器的信息汇聚在一起。这些传感器包括卫星、雷达、声学探测器、海上自动识别系统,甚至社交媒体帖子。平台利用机器学习模型从这些数据中提取可用信号:计算机视觉模型分析视觉输入以检测和跟踪物体(车辆、建筑物、地形变化);自然语言处理系统解析文本信息,获取有关敌对行为者、位置和意图的可操作情报。
元星座的核心价值在于将分散的卫星数据源,包括光学影像、合成孔径雷达(SAR)影像、红外影像和射频信号等,整合为一个统一的认知视图。截至2024年初,元星座已集成超过300颗商业卫星(亦有报道称已达438颗),涵盖BlackSky、PlanetLab、Maxar、Satellogic、ICEYE、HawkEye360和Capella Space等多家商业卫星运营商。卫星传感器类型涵盖光学、SAR(合成孔径雷达)、红外和射频等多种模态,可以实现对全球地表动态的近实时监测。
(二)多源卫星数据的语义统一
1. 光学、合成孔径雷达(SAR)、红外、射频等多类传感器数据的本体映射
元星座的核心技术架构建立在Palantir的统一本体之上。不同来源、不同格式的卫星数据,如光学影像的光谱信息、SAR影像的后向散射系数、红外影像的热辐射数据、射频信号的频谱特征,在本体层被统一建模为具有语义含义的对象、属性和关系。光学影像中的建筑物被映射为“设施”对象,SAR影像中的移动目标被映射为“车辆”或“舰船”对象,射频信号中的通信特征被映射为“信号事件”对象。
这种本体驱动的语义统一解决了传统卫星数据处理中的核心问题,即不同传感器产生的数据在格式、分辨率和物理含义上存在根本差异,传统方法需要针对每种传感器开发独立的处理管道。元星座通过在本体层定义统一的卫星数据模型,使不同来源的数据能够在同一语义框架内被查询、关联和分析。
2. 跨星座的数据关联与融合分析
元星座的另一个核心能力是跨星座的数据关联与融合分析。系统不仅接入单一卫星运营商的数据,而是整合了来自全球多个商业卫星星座的观测数据。当用户提出一个地理空间查询时,元星座的“星座引擎”会动态确定哪些卫星可用,协调卫星和地面站等资源,智能分配观测任务。
在数据融合层面,元星座将来自不同卫星的观测结果在本体层进行关联。光学影像识别出的目标位置可以与SAR影像检测到的同一目标进行交叉验证,红外影像的热特征可以补充对目标状态(如发动机是否运转)的判断。这种跨星座、跨模态的数据融合大幅提高了情报的可靠性和完整性。系统还可以将卫星数据与无人机数据、地面传感器数据、社交媒体数据进行关联分析,构建全方位的态势感知图景。
(三)星上Edge AI引擎的微模型编排
元星座的软件体系以两套核心引擎为基础:EdgeAI和Apollo。
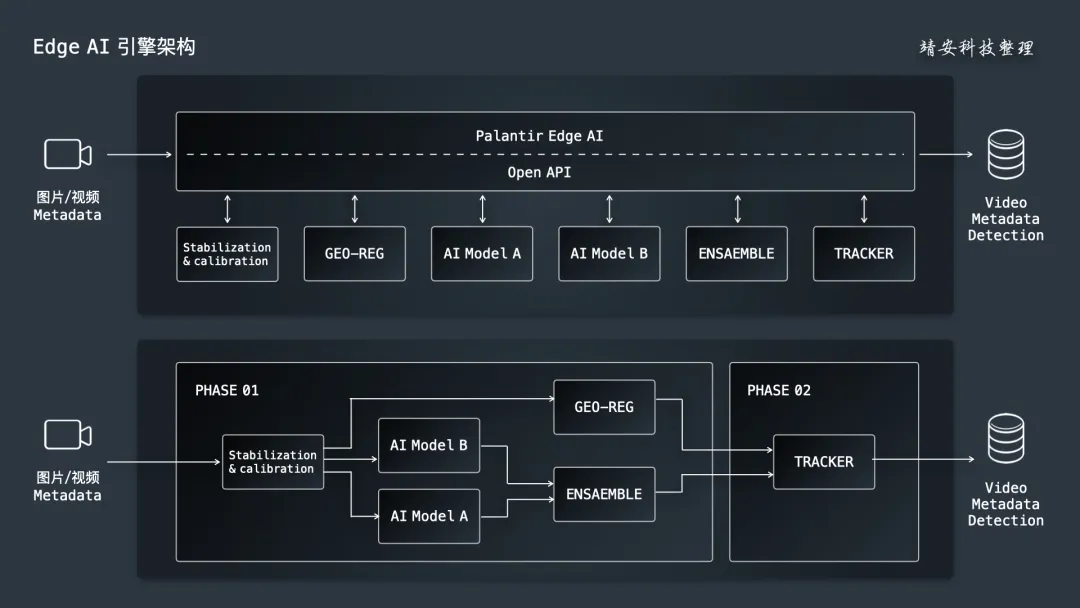
图 15 Edge AI引擎架构
1. 边缘端的实时推理与模型动态编
EdgeAI是元星座系统的在轨智能核心,承担着多源数据接入、微模型编排与实时推理的关键功能。EdgeAI支持卫星传感器、无线电信号、声学探测、地理配准数据及时序数据等多模态数据的实时接入与低延迟处理。
与传统的地面处理模式不同,EdgeAI在卫星端直接对原始数据进行预处理(如去噪、压缩及特征提取),仅将包含目标坐标、类型及状态的元数据下传至地面。这一机制可将数据量降至原来的二十分之一以下。在轨测试中,EdgeAI运行Palantir自研的Omni模型,从叙利亚塔尔图斯港上空拍摄的44帧多光谱原始图像中识别出210个建筑物目标,计算其地理坐标后将结果安全下传。
微模型(MicroModels™)是EdgeAI的核心技术。这是一种模块化、面向特定任务的小型AI模型,包含自研、开源或第三方算法,能够跨设备和环境进行链式编排,使部署在太空的模型能够与部署在陆地或水下的模型协同工作。微模型之间可动态编排调度,模型支持实时热插拔,无需中断传感器数据流即可切换算法。即使某个模型崩溃,也不会影响依赖该传感器输出的下游任务。这种微模型对在轨算力的需求远低于大模型,NVIDIA Jetson TX-2i嵌入式GPU模组(算力1.3 TFLOPS)即可支持其运行。
2. 微模型与运行环境的解耦
微模型的设计遵循“与运行环境解耦”的原则。传统卫星软件与硬件深度绑定,更换算法需要重新编译和部署整个系统。微模型通过标准化的接口与底层硬件和传感器进行交互,使算法可以在不同的卫星平台和边缘设备之间迁移和复用。基于EdgeAI平台,元星座系统已接入Pilot.ai、Xailient、MindFoundry三家算法供应商的AI模型,系统根据情报任务类型匹配对应算法,将AI模型上注到任务卫星。
Apollo引擎为微模型的在轨管理提供了持续交付能力。Apollo能够在资源受限的边缘设备等极端环境中无缝运行,使开发者无需将时间投入到编写和维护管道、脚本及手动流程上。通过Apollo的持续集成与持续交付管道,微模型可以定期更新和优化,使在轨AI能力能够持续进化。
(四)地面控制中心的本体驱动任务分配
1. 星座引擎与操作引擎的协同
元星座的地面控制中心由两套核心引擎协同驱动:星座引擎(Constellation Engine)负责卫星资源的统筹调度,操作引擎(Operations Engine)负责任务执行与数据分发的全过程管理。
元星座的核心和大脑是位于地面的中心控制系统。当收到观测请求时,系统会动态确定哪些卫星可用,并进行卫星、地面站等资源的协调,智能分配任务。用户可以通过自然语言界面指定时间和地面位置,例如,最近一次对俄军坦克连发动海马斯(HIMARS)打击的位置,系统随即对过境卫星收集的所有相关数据(包括无线电信号等)进行AI辅助搜索。系统同时负责数据处理分析、生成情报及决策,管理整个星座的运行情况。
操作引擎则负责将星座引擎分配的任务转化为可执行的指令序列,包括卫星姿态调整、传感器参数配置、数据采集计划编排和数据下行链路调度。两套引擎通过共享的本体语义层进行协同,星座引擎中定义的“观测任务”对象与操作引擎中定义的“传感器指令”对象在本体中建立了链接关系,确保任务分配与执行之间的语义一致性。
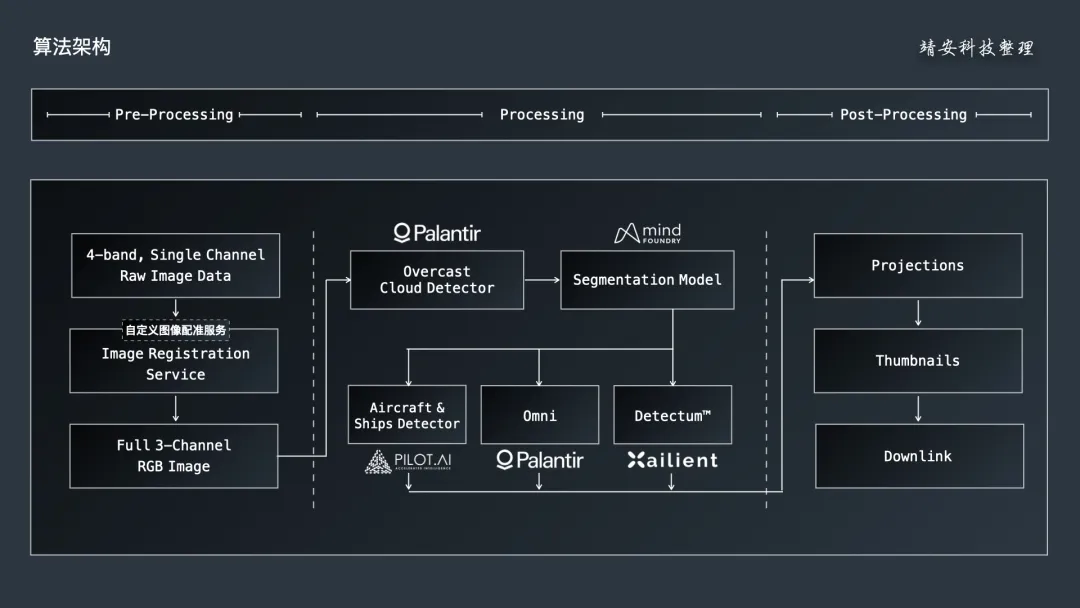
图 16 “元星座”算法架构
2. 用户请求到卫星任务的本体驱动分解与分配
元星座的任务分配过程由本体全程驱动。用户提出的自然语言请求(如“监测某港口在过去72小时内的船舶活动”)首先被解析为本体中的查询对象——包括目标区域的地理范围、时间窗口、感兴趣的实体类型(船舶)和情报需求(活动模式)。
系统根据本体中定义的卫星能力模型(每颗卫星的传感器类型、轨道参数、覆盖范围和当前状态),自动将用户请求分解为一系列可执行的子任务。每个子任务对应一个或多个卫星的观测计划,包括最佳的传感器配置、采集角度和时间窗口。任务分配完成后,系统通过Apollo引擎将更新后的模型和配置上注到在轨卫星。
星上处理过程不到一秒,用户即可实时收到目标的动态信息。通过Skykit地面终端(包含一台装有元星座系统的笔记本电脑、一架预装AI算法的无人机和一台星链终端),前线用户可以直接接收来自卫星的实时情报,打通了“情报收集—通信—行动指挥”的完整链路。
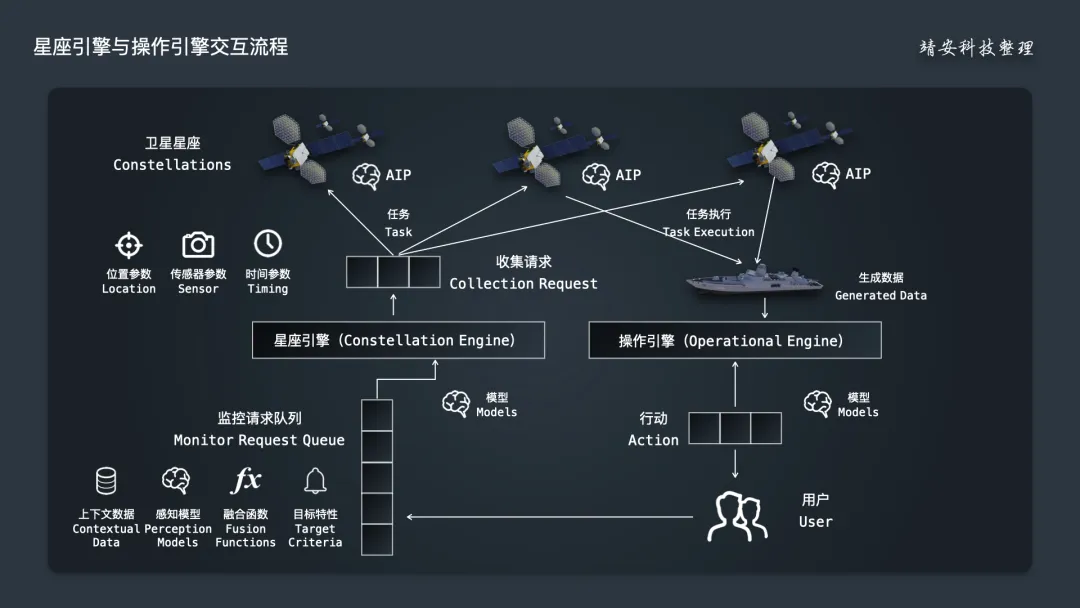
图 17 “元星座”星座引擎与操作引擎交互流程
扫码加入知识星球,获取更多上述Palantir研究报告的相关资料