研报速递
高质量医学数据三维坐标
广度|深度|持续
AI科研协作篇 · 从病理文本到研究材料
研究肿瘤的病理特征,第一步常常不是分析,而是读报告:找到诊断、整理检测结果,再把它们填进表格。
一份报告可能涉及多个标本、蜡块和补充检查。几千份报告摆在面前,逐份整理会占用大量专业时间。问题不只在于文字多,还在于每个结果究竟属于哪个标本。大模型能否把这段繁重的准备工作向前推进?
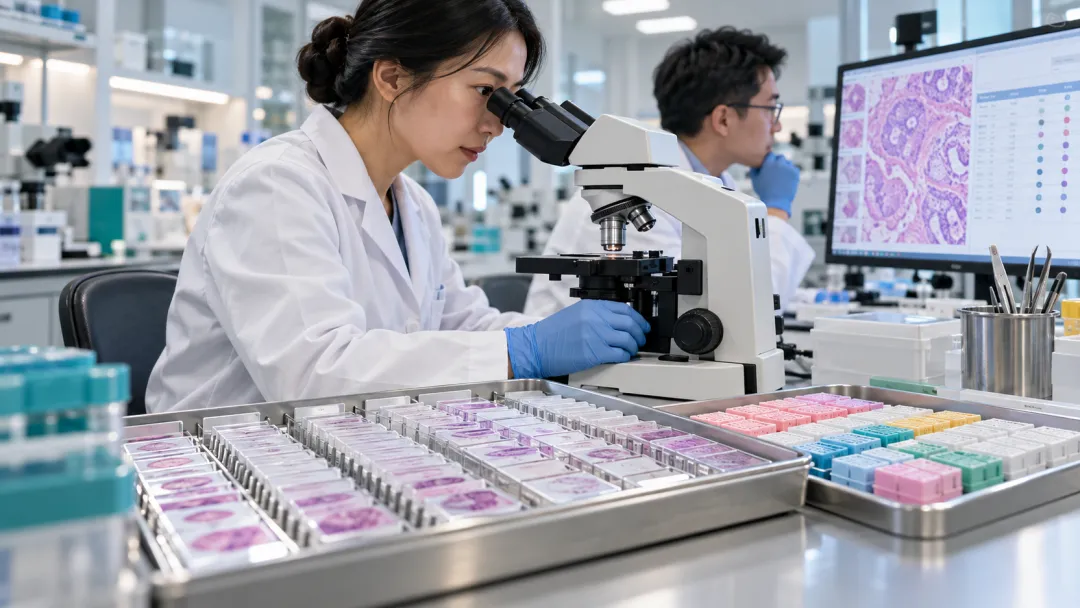
场景示意:病理人员从标本、切片与报告出发,为后续研究核对信息及其对应关系。
从抽出词语,到交付一张研究表
2025年《npj Digital Medicine》的一项研究,围绕肾肿瘤病理报告建立了信息抽取管线。任务覆盖实体识别、诊断相关推断、术语规范化、关系匹配和结构化输出。[1]
这几步连接起来,才有机会交付可分析的材料。模型需要回答的不是“报告中有没有阳性”,而是“什么检查、在哪个标本上、得到什么结果”。语言模型的作用,在于处理跨句表达和上下文关系,再按研究需要输出。
用一个假设报告说明:A标本的检测阳性,B标本未做该项检测。若只给整份报告贴上“阳性”,后续研究就可能把两个标本混为一谈。关系读对了,抽出的结果才知道该放进哪一格。 广度让诊断与多项检测共同进入研究,深度则把它们组织为有归属的证据。
专家的纠正,可以变成下一轮指令
这项研究没有把首次输出当终点。团队先明确每类任务要什么,再检查差错、修订提示与流程;涉及医学歧义时,由病理专家参与裁定。最终管线应用于3520份内部报告,其中2297份带有可供交叉核对的结构化字段。[1]
对研究团队,这提供了一种具体协作方式:先选一批代表性报告,约定诊断、标本和检测结果的对应关系。模型批量处理,专家集中解释错在何处,再将这些解释写进下一版任务说明。
例如,纠正“某个字段填错”只解决一份报告;说明“补充报告更新了原结论,应怎样保留新旧关系”,才可能帮助后续一批报告。专家反馈的价值,在于把一次判断转成可以反复使用的任务定义。
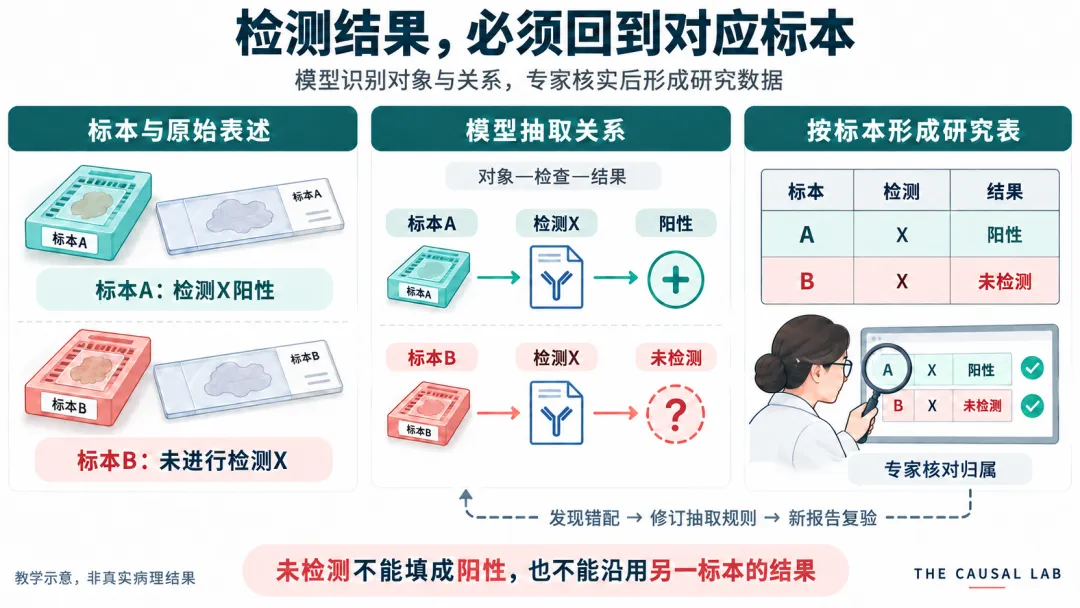
教学示意:模型将标本与检测结果对应,专家核实后形成研究表;未检测不能填为阴性,也不能沿用另一标本的结果。
新发现也可能来自核对过程
研究中的差异复核还找到了27处既有结构化数据需要更新或更正的情况,包括补充结果和术语更新,随后均经病理专家确认。[1] 这提醒我们,原来那张表也可能需要回到报告重新理解。
持续在这里有了实际含义:复核产生的新证据,既能修正抽取流程,也可能修正已有数据。更新之后,再用未参与调试的报告检查表现,才能知道改进是否适用于更多材料。这是团队采用类似流程时应保留的验证环节。
这篇研究并没有证明所有医院和病种都能直接照搬。它展示的是一条可实践的路径:把专家从逐条搬运文字中释放一部分出来,让他们的时间更多用于解释困难关系和处理新问题。
当报告能成批转成可复核的研究表,原本因整理成本过高而搁置的分析才有机会启动。下一步的问题是:记录越来越多,怎样让专家优先看到值得复核的疑点?
本期参考
1. Hein D, Christie A, Holcomb M, et al. Iterative refinement and goal articulation to optimize large language models for clinical information extraction. npj Digital Medicine. 2025;8:301. DOI: 10.1038/s41746-025-01686-z.
本期技术关键词
病理信息抽取|标本关系匹配|结构化输出|任务定义|专家反馈
更多阅读