研报速递
范式界定与护城河迁移:从记录系统向行动系统的代际跃迁
架构内生性与复合智能系统演进
软件工程正经历自云原生(Cloud-Native)确立以来最深刻的底层架构变迁1。传统软件与外挂式AI应用(Bolted-on AI)将生成式模型视为既有确定性代码分支上的辅助插件,仅在局部界面叠加自然语言对话窗口或文本润色工具;而AI原生应用(AI-Native Applications)则以生成式与多模态大模型作为驱动系统运转的核心引擎,围绕概率性推理彻底重构底层数据结构、中间件调度、交互界面与商业交付逻辑1。针对106份行业文献与开源架构的系统性综述表明,当前超过60%的AI原生工程规范直接源于一线开源项目文档,工程实践显著领先于学术理论建模1。
在系统拓扑层面,AI原生应用已摆脱早期依赖单一提示词工程(Prompt Engineering)构建的“薄封装”(Wrapper)形态,演进为深度耦合的复合人工智能系统(Compound AI Systems)3。成熟的认知架构不再依赖单一基础模型处理全量请求,而是将多模型动态路由、向量与图数据库检索增强生成(RAG)、合规护栏(Guardrails)以及模拟人类工作流推理的应用控制流整合为有机整体1。这种双层工程蓝图要求系统在继承可维护性、可扩展性等传统软件质量属性(Quality Attributes)的同时,将自适应性(Adaptability)与全链路可观测性(Observability)确立为核心架构指标,以消解概率性输出带来的系统不确定性1。
企业软件价值锚点的三阶跃迁:记录、智能与行动
企业级软件的核心价值锚点正沿着“记录系统(System of Record)—智能系统(System of Intelligence)—行动系统(System of Action)”的轨迹发生代际迁移6。过去二十年间,以客户关系管理(CRM)、企业资源计划(ERP)及财务账务平台为代表的传统SaaS软件,本质上是结构化数据的存储容器与事务登记簿8。人类员工充当了不同数据库之间的操作中介,通过繁复的表单录入、页面跳转与跨系统核对推动业务流转10。
AI原生架构通过引入上下文感知层(System of Context)与推理连接组织,将静态数据仓库转化为智能系统,并进一步接管业务执行权,演进为自主触发闭环操作的行动系统7。在行动系统范式下,底层数据库、计费引擎与ERP并未消失,但其战略地位已退化为受控的后台基础设施,高溢价商业价值向顶层的意图理解、跨系统编排与自主执行层集中8。随着后台持续循环智能体(Persistent Looping Agents)的成熟,软件的直接调用者正从人类操作员转变为自主智能体10。这一结构性转变催生了面向智能体的人体工程学接口设计原则(Agent-Ergonomic Interface Design, AXI),要求软件接口针对机器推理与工具调用的稳定性进行专门优化10。基于915次基准测试的实证研究显示,工具接口的语义清晰度与反馈结构对智能体任务成功率的决定作用甚至超越了底层通信协议的选择10。
演进阶段 | 核心架构定位 | 交互与执行主体 | 底层数据形态 | 商业价值捕获机制 |
记录系统 (System of Record) | 静态事务存储与状态登记容器6 | 人类员工手动检索、录入与更新10 | 孤立的关系型数据库表与预定义表单8 | 按人类使用席位(Per-Seat)收取固定订阅费14 |
智能系统 (System of Intelligence) | 跨源数据聚合、语义检索与辅助决策层7 | 人类主导决策,Copilot提供建议与摘要17 | 向量嵌入索引与跨系统知识图谱连接3 | 分层订阅溢价或基础功能增购包14 |
行动系统 (System of Action) | 具备读写权限的端到端工作流自主编排引擎6 | 自主智能体(Agent)跨API闭环执行,人类仅介入异常审批10 | 动态演进的时序上下文与实时状态图谱13 | 按算力消耗或业务交付结果(Outcome-based)计费15 |
竞争壁垒解构与防御性护城河重塑
从记录系统向行动系统的跃迁直接削弱了传统软件赖以生存的转换成本(Switching Costs)护城河10。在传统SaaS时代,复杂的数据表结构迁移、定制化工作流配置以及漫长的员工操作培训构成了极高的替换壁垒。而在AI原生时代,代码生成与克隆的边际成本趋近于零,智能体能够自动解析异构数据结构并自动化执行数据管道迁移,导致单纯依靠数据锁定(Data Lock-in)的防御体系迅速失效10。与此同时,行业专业知识正经历“单向棘轮式”扩散(Expertise Diffusion),原本由资深专家垄断的隐性业务经验被系统性地提取为标准操作程序(SOP)、微调数据集与上下文规则,静态知识储备的准入门槛大幅降低10。
在此背景下,AI原生应用的竞争护城河重构为三大核心支点。首要支点是深层工作流所有权(Workflow Ownership)与行业隐性逻辑内化,即软件能否深度嵌入企业核心审批流、合规校验与跨部门协同节点;在软件从记录走向行动的过程中,内嵌的工作流先验知识不仅没有贬值,反而因智能体的直接调用而释放出乘数效应9。第二大支点是闭环演化速率(Learning Rate),护城河不再取决于初始模型参数量或静态数据集规模,而取决于系统从高频人机交互反馈中捕获隐性偏好、自动更新权重并迭代推理管线的速度10。第三大支点则是企业级分发网络与品牌信任度,在底层技术同质化加剧的环境中,既有客户触达渠道、安全合规背书与生态集成能力依然是难以复制的稀缺资产10。
这种护城河重构正在引发软件行业的深度分化(Software Bifurcation)24。成熟软件企业面临严峻的“增长10%或盈利40%(Grow 10 or Earn 40)”二元生存法则:要么彻底重构产品认知架构以实现10个百分点以上的增长提速,要么收缩战线将真实营业利润率重建至40%以上,处于中间地带的平庸软件厂商将被市场加速出清10。风险投资与私募股权市场的估值溢价已明确反映这一分化趋势:在2025年全球云计算百强(Cloud 100)总估值历史性突破1万亿美元的进程中,AI领军企业占比已从2024年的21%翻倍至42%,并享有平均24倍的年度经常性收入(ARR)估值倍数,显著高于非AI同行19倍的估值水平27。顶尖AI原生企业从1亿美元ARR跨越至10亿美元ARR的速度已创下科技史最高纪录,垂直领域AI原生软件的远期总市值预计将达到传统垂直SaaS规模的10倍以上18。
认知架构与全栈工程体系:模型路由、图谱检索与时序记忆
成本、质量与延迟帕累托前沿的动态模型路由
AI原生应用在生产环境中面临的首要工程矛盾,是前沿基础模型的高昂推理成本、高延迟与实时业务服务等级目标(SLO)之间的剧烈冲突4。不同参数规模的模型在推理耗时与单价上存在数量级差异:在两块NVIDIA H100 GPU构成的推理节点上,Llama 3.2 Instruct (1B)生成100个Token仅需0.2秒,而70B版本则需要3.0秒,延迟相差15倍4;在商业API定价上,2026年主流模型矩阵(如DeepSeek V4与GPT-5.5-pro之间,或Claude Haiku与Opus、GPT-4之间)的输入输出Token价差高达50倍至100倍29。若将全量用户查询无差别发送至旗舰模型,不仅会导致毛利率严重受损,还会引发计算队列阻塞4。
为在成本、质量与延迟构成的帕累托前沿(Pareto Frontier)上寻得最优解,动态模型路由(Model Routing)已成为AI原生技术栈的标准中枢3。早期方案如LLM-Blender采用推理期多模型集成投票,FrugalGPT与AutoMix则采用串行级联(Cascading)策略,先调用小模型生成并自我校验,失败后再向上回退至大模型33。然而,多模型并发或串行重试会在无形中叠加多次首字延迟(TTFT),无法满足低延迟实时交互需求30。以RouteLLM为代表的预测型单次分发架构(Predictive Single-Dispatch Routing)则将路由建模为生成前的分类决策问题,结合人类偏好数据(Chatbot Arena 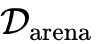 )与大模型裁判增强数据(
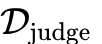 ),训练出相似度加权排序(SW Ranking)、矩阵分解(Matrix Factorization)、BERT分类器及因果大模型分类器四类轻量级路由器,在生成前将每次请求直接分发至单一最优模型29。
在GPT-4(强模型 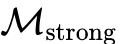 )与Mixtral 8x7B(弱模型
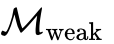 )构成的基准测试中,仅使用原始人类偏好数据训练的路由器容易因分布外(Out-of-Distribution)问题表现受限,而引入裁判增强数据(
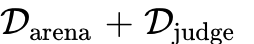 )后,各类路由器的性能均实现跃升29。以达成GPT-4性能50%与80%阈值所需调用的强模型比例(CPT)以及平均性能增益率(APGR)衡量,矩阵分解路由器展现出最优的生产环境权衡:仅需调用13.40%的GPT-4请求即可达成50%性能阈值,调用31.31%即可达成80%性能阈值,APGR高达0.802(较随机基线提升60.4%)29。
训练数据集配置 | 路由算法模型 | CPT (50%) 强模型调用占比 | CPT (80%) 强模型调用占比 | 平均性能增益率 (APGR) | 相对随机基线增益 |
随机基线 (Random 95% CI) | 随机路由 (Random) | 49.03% (±4%)29 | 78.08% (±3%)29 | 0.500 (±0.02)29 | +0.0%29 |
仅人类偏好 ( | BERT 分类器 | 78.09%29 | 87.64%29 | 0.39129 | -21.8%29 |
仅人类偏好 ( | 因果大模型 (Causal LLM) | 28.82%29 | 77.53%29 | 0.57329 | +14.6%29 |
仅人类偏好 ( | 矩阵分解 (Matrix Factorization) | 25.32%29 | 74.26%29 | 0.58029 | +16.0%29 |
仅人类偏好 ( | 相似度加权排序 (SW Ranking) | 37.85%29 | 58.99%29 | 0.61029 | +22.1%29 |
偏好+裁判增强 ( | 因果大模型 (Causal LLM) | 31.50%29 | 48.75%29 | 0.67929 | +35.8%29 |
偏好+裁判增强 ( | 相似度加权排序 (SW Ranking) | 23.21%29 | 36.04%29 | 0.75929 | +51.8%29 |
偏好+裁判增强 ( | BERT 分类器 | 19.58%29 | 34.02%29 | 0.75129 | +50.2%29 |
偏好+裁判增强 ( | 矩阵分解 (Matrix Factorization) | 13.40%29 | 31.31%29 | 0.80229 | +60.4%29 |
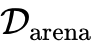
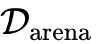
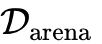
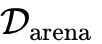
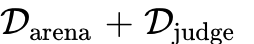
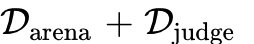
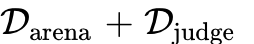
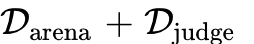
实证测试表明,经过数据增强训练的矩阵分解路由器在MT Bench基准上仅需将14%的高复杂度请求分发至旗舰模型,即可在保留95% GPT-4 Turbo回答质量的前提下削减85%的推理成本31。在MMLU基准上,BERT分类路由可在同等质量下节省45%成本;在8-shot GSM8K数学推理测试中,处于CPT(50%)配置下的路由系统得分达75分,恢复了GPT-4满分表现(86分)的87%29。尤为关键的是,偏好路由器展现出卓越的跨模型泛化能力:在GPT-4与Mixtral 8x7B上训练的路由权重,无需重新训练即可直接迁移至Claude 3 Opus与Claude 3 Sonnet组合(矩阵分解与SW排序分别实现0.762与0.772的APGR,较随机基线提升54.6%与56.6%)或Llama 3.1 70B与8B组合(矩阵分解APGR达0.738,提升44.1%)31。在工程开销方面,相较于大模型500至2,000毫秒的中位推理耗时,基于规则匹配(Regex/Keyword)的路由开销低于1毫秒,基于向量嵌入(Embedding)的路由耗时约5毫秒,即便是最复杂的语义与机器学习分类器路由也仅增加50至100毫秒延迟,仅占端到端总耗时的个位数百分比31。在实际生产流量切分中,若将70%的基础分类、信息抽取与简短摘要流量导向轻量级模型(如Haiku),仅保留30%的多步模糊推理流量调用旗舰模型(如Opus),输入Token账单即可缩减约三分之二;若将80%流量导向高性价比开源模型(如DeepSeek V4)并保留20%调用Opus,总成本降幅可逼近79%31。
然而,当AI原生应用进入高并发生产集群时,单纯依据提示词难度进行孤立路由会诱发严峻的次生工程瓶颈:大量请求被集中导向同一款高性价比模型,导致该模型所在的GPU实例队列饱和,触发尾延迟(Tail Latency)急剧恶化30。基于RouterBench数据集(36,000条提示词)与vLLM推理引擎的实验证实,在同一GPU集群与相同服务等级目标(SLO)约束下,不同部署配置导致的路由可达质量差异高达87%30。RouterWise架构通过将系统部署配置 与路由权重策略 构建为联合优化问题:
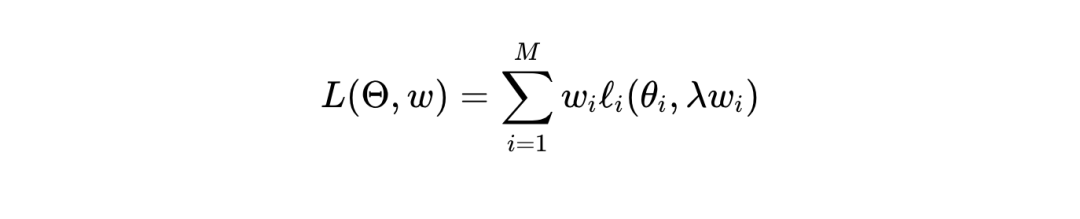
其中 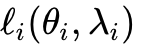 表示第 个模型在配置
 与实际分配负载
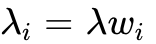 下的平均延迟,系统利用二分查找动态调节质量-延迟权衡系数 以锚定目标延迟阈值 30。
集群请求负载 λ\lambdaλ (QPS) | 目标延迟约束 τ\tauτ (ms) | RouterWise (质量得分 / 平均TTFT) | RouteLLM (质量得分 / 平均TTFT) | FrugalGPT (质量得分 / 平均TTFT) |
| 800 ms30 | 0.59 / 860 ms30 | 0.58 / 820 ms30 | 0.59 / 1,500 ms30 |
| 500 ms30 | 0.57 / 550 ms30 | 0.57 / 1,100 ms30 | 0.57 / 2,700 ms30 |
| 500 ms30 | 0.56 / 565 ms30 | 0.54 / 2,500 ms30 | 0.56 / 12,300 ms30 |
| 500 ms30 | 0.51 / 600 ms30 | 0.51 / 7,800 ms30 | 0.51 / 24,200 ms30 |
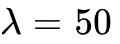
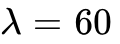
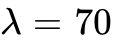
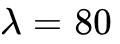
如上表所示,当集群请求负载 从50攀升至80时,采用串行级联架构的FrugalGPT因多次调用叠加队列等待,平均首字延迟(TTFT)从1,500毫秒失控飙升至24,200毫秒;孤立路由的RouteLLM因主力模型过载,平均TTFT从820毫秒恶化至7,800毫秒;而协同感知集群负载的RouterWise则将平均TTFT稳定控制在600毫秒,同时维持0.51的同等输出质量得分30。此外,面向严格预算约束的SCORE系统通过集成轻量级质量与输出长度预测器动态平衡负载,而RoBatch框架则将模型路由与批量提示词(Batch Prompting)整合为NP难的组合优化问题,在控制批大小 (从1扩展至64)引发的上下文质量衰减的同时,实现了单次调用算力分摊的全局最优4。针对复杂多步智能体任务,新一代评估基准RouterWorld(涵盖5.3万条核心实例与1.7万条智能体轨迹)进一步引入端到端轨迹延迟公式:
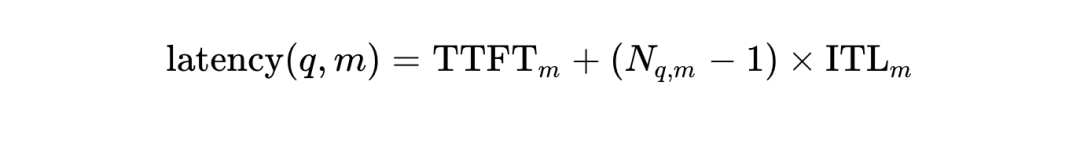
其中  为Token间生成延迟,系统将多步生成耗时累加,并定义延迟感知折损累计增益(
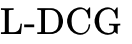 ):
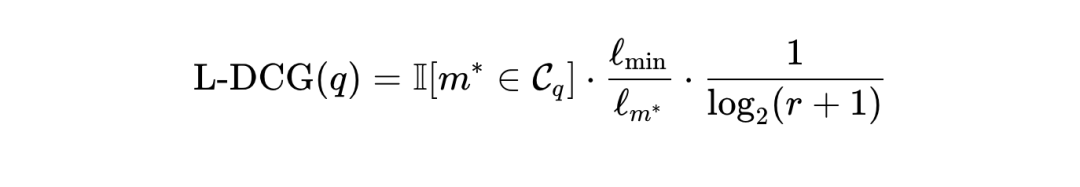
通过效率比值 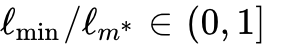 对回答正确但延迟次优的路由选择施加连续惩罚,推动路由技术从静态单轮问答正式跨入动态多步自主代理时代34。
知识图谱增强检索与智能体长程记忆机制
在数据与上下文层,AI原生数据管理栈正从静态存储向“智能体就绪(Agent-Ready)”的实时语义基础设施演进13。传统数据架构旨在辅助人类组织报表,而AI原生数据栈则围绕持续可用性、实时语义富化、上下文连接以及AI数据信任层(涵盖数据质量、可观测性与合规治理)四大核心层级重构,以支撑智能体对企业数据的动态读写操作13。
在知识检索维度,标准向量检索(Naive RAG)通过计算文本切片的嵌入余弦相似度回答“哪些段落语义相近”,在处理局部事实查询时具备低成本与低延迟优势,但在面对跨文档多跳推理(Multi-hop Reasoning)与全局主题归纳时极易因上下文碎片化而失效19。图谱检索增强生成(GraphRAG,如微软GraphRAG架构)在原始文档与生成模型之间嵌入知识图谱层,将检索范式转化为“哪些实体存在结构化关联”19。生产级GraphRAG系统通过融合知识图谱拓扑遍历、BM25稀疏关键词混合检索、Leiden社区发现算法(用于生成多层级全局摘要)以及智能体动态检索策略,显著突破了复杂企业知识库的跨跳推理瓶颈36。
在状态持久化维度,无状态的大模型本身不具备跨会话演进能力,长程记忆(Long-Term Memory)架构因此成为区分简单问答工具与AI原生智能体的关键技术分水岭40。当前主流独立记忆层呈现出鲜明的技术路线分化:
记忆框架 | 核心底层架构与检索机制 | 记忆作用域与管理特性 | 生产环境适用场景与工程局限 |
Mem0 | 融合语义向量检索、BM25关键词匹配与实体图谱匹配的多路信号混合引擎23 | 原生划分用户记忆(User)、会话记忆(Session)与智能体记忆(Agent)多级作用域;采用Provider设计模式解耦外部存储依赖42 | 适用于需精细权限隔离的跨会话个性化应用;在多源矛盾事实的自动消解上仍需人工规则介入43 |
Zep | 基于Graphiti构建的时序知识图谱(Temporal Knowledge Graph),精准追踪事实随时间的演变轨迹23 | 专为长周期对话历史与动态业务状态设计,自动提取实体关系并维护时间戳有效性23 | 高度契合客户状态频繁更迭的企业级对话系统;但其缓存全量抽象摘要的设计容易引发Token与存储开销膨胀40 |
Letta (原MemGPT) | 借鉴操作系统虚拟内存分页机制,将上下文划分为核心内存(In-context)与归档存储(Archival)41 | 智能体通过自身工具调用主动执行记忆的写入、换入与换出,拥有极高的状态控制权41 | 适合长周期自主运行的复杂任务代理;多步记忆操作会增加额外的推理轮次与端到端延迟41 |
Cognee | 基于认知图谱与结构化数据管道的语义存储架构45 | 强调将非结构化文档与对话流转化为可推理的模块化知识网络40 | 适合企业内部知识沉淀与跨团队智能体记忆共享45 |
尽管上述框架在事实存储与召回率上已大幅超越原生上下文窗口,但一线工程实践揭示出当前记忆层的共性瓶颈在于“强于检索召回而弱于矛盾消解”44。当用户的偏好、账户权限或业务规则在数月跨度内发生多次变更甚至前后冲突时,现有记忆工具往往将历史旧事实与最新状态并列召回,缺乏可靠的时序状态覆盖与逻辑一致性校验机制,这要求架构师在记忆检索层之上额外构建确定性的状态合并与数据治理逻辑22。
云智一体运行时、协议网关与内生安全治理
将具备长程记忆与多模型路由的认知架构推向规模化生产,必须依托“云智一体”的全栈基础设施支撑,涵盖模型、开发框架、上下文工程、工具生态、AI网关、弹性运行时、全链路可观测、自动化评估与内生安全九大核心要素5。与传统微服务不同,AI原生运行时面临全新智能体开发技能栈的快速验证、存量核心业务系统的异构打通,以及规模化运行时延迟峰值与不可控风险防范三大落地难题47。
在网络与计算网关层,传统无状态HTTP网关无法适应流式生成与多步异步交互需求。新一代云原生AI网关针对服务器发送事件(SSE)与WebSocket等长连接协议进行了深度内核优化,支持WebSocket长连接的无损配置变更与优雅上下线,并通过硬件加速提升TLS加密与Gzip压缩吞吐量,辅以丰富的插件生态实现热加载更新、消费者鉴权、Token流控与灰度发布47。在存量资产融合方面,模型上下文协议(Model Context Protocol, MCP)已成为连接智能体与企业遗留数据库、内部Wiki及第三方API的通用标准47。通过结合函数计算(Serverless)与面向AI优化的消息队列(如RocketMQ for AI),企业能够快速创建并管理MCP Server,在避免推倒重建核心系统的前提下实现存量业务与智能体的异步融合47。同时,全链路AI可观测性系统通过将所有组件的数据关联整合,追踪多步骤推理流程中的每一个环节,使工程师能够在长链路延迟峰值出现时,精准定位瓶颈究竟源于大模型自身推理、外部API调用还是数据库慢查询47。
在安全治理维度,企业首席信息安全官(CISO)面临着防御范式的根本性转换50。AI智能体绝非普通的Web应用表层接口,而是具备自主推理能力、拥有跨系统读写特权并能动态串联工作流的高权限行为体(High-Privilege Actors)50。当前多数企业常见的部署误区,是直接套用传统应用安全剧本,在权限边界模糊、缺乏行动约束的智能体之上事后叠加监控工具50。稳健的企业级智能体安全治理必须严格遵循“权责归属(Ownership)—边界约束(Constraints)—持续监控(Monitoring)”的递进次序:首先在业务层明确界定组织对智能体的风险承受姿态并落实每个智能体的直接责任人;其次将智能体视为生产级基础设施而非普通应用,遵循最小权限原则从极窄的输入输出范围起步,经充分验证后再渐进扩展,严防智能体在长周期运行中发生特权累积(Privilege Accumulation);最后在每一个外部动作执行节点部署详尽的行动级护栏(Action-level Guardrails),明确划定禁止执行的操作红线,用事前边界约束取代单纯的事后行为监控,从而将智能体的自主权控制在可信边界之内50。
交互范式革新:动词中心主义与生成式用户界面
从静态屏幕导航到运行时意图合成
图形用户界面(GUI)自诞生以来一直遵循“名词中心主义(Noun-Centric)”的静态设计哲学:前端工程师在编译期利用React或Next.js等框架预先硬编码每一个页面、菜单、按钮与表单,假设所有UI需求在开发前均已明确,用户必须主动学习软件的信息架构,通过层层点击导航至特定功能模块才能完成任务51。然而,当后端的AI引擎具备了跨领域推理与动态工具调用能力时,僵化的预定义前端反而成为了限制系统智能释放的交互瓶颈48。
AI原生应用将人机交互范式彻底翻转为“动词中心主义(Verb-Centric)”53。用户无需在多级菜单中寻路,只需直接以自然语言或上下文信号表达操作意图(动词),系统即可在运行时(Runtime)动态理解需求、调取关联数据,并实时合成最契合当前任务状态的专属交互界面——即生成式用户界面(Generative UI, 简称GenUI)51。在这种“提示词到界面(Prompt-to-UI)”的流水线中,前端不再是固定不变的像素模具,而是随用户角色、历史偏好、实时数据流及对话上下文动态重组的自适应媒介51。例如,当用户在分析工具中查询特定业务指标时,GenUI并非返回纯文本回答,而是通过后端API(如Thesys C1流式UI接口)直接向前端推送结构化界面规范,实时渲染出可交互的动态图表与关联输入表单,实现了免部署周期的实时界面自适应更新51。
生成式界面的六大工程模式与结果导向设计
生成式UI绝非放弃设计规范任由大模型自由生成无序代码,其实质是将设计的基本单元从“静态屏幕(Screen)”上移至“规则集与原子组件库(Rule Set & Component Vocabulary)”54。在工程落地上,业界严格区分了“设计期生成式UI(Design-time GenUI,由AI辅助生成页面或代码并经人类审核后发布)”与“运行期生成式UI(Runtime GenUI,每次请求由模型实时决定界面渲染且提示词到像素之间无人工介入)”54。围绕模型在运行期介入界面构建的深度,当前生产环境已演化出六大标准设计模式:
模式名称 | 核心运行机制与模型控制权边界 | 典型技术栈与标杆产品实现 | 商业与交互工程价值 |
提示词驱动组件生成 (Prompt-to-Component) | 设计师预先构建受控的原子UI组件库;模型通过工具调用(Tool Calls)选择组件并填充实时数据52 | Vercel AI SDK(连接模型工具调用与React Server Components);金融研究平台Accern (Rhea)54 | 兼顾视觉一致性与动态灵活性,是目前生产环境最成熟、最可控的GenUI形态;Accern借此构建分屏研究流并促成超4,000万美元融资及八位数美元并购54 |
意图匹配微件 (Intent-Matched Widgets) | 系统解析查询意图背后的最佳信息呈现格式,动态唤醒对应的交互式微件容器54 | Google Gemini动态视图(Dynamic View);Pika AI查询转微件系统54 | 消除纯文本对话的信息过载,支持用户直接在生成卡片上进行参数调节与二次交互51 |
全体验实时代码生成 (Full-Experience Generation) | 模型针对特定复杂请求,在运行期实时生成并渲染包含完整交互逻辑的整个页面或专用工具代码54 | Google Generative UI (Gemini 3);VTnews.ai动态合成新闻视图54 | 打破预设组件边界,为长尾、非标分析需求提供即时定制的专用软件视图51 |
智能体工具状态界面 (Agentic Tool-State UI) | 界面实时映射后台智能体的实时动作、工具调用进度、中间状态与协作工作区54 | CopilotKit与LangGraph协同栈;Suits.ai智能体工作区;Elva语音代理54 | 将后台推理与执行过程透明化,支持人机协同操作与实时状态追踪54 |
上下文自适应界面 (Context-Adaptive Interfaces) | 根据当前用户的类型、权限角色与操作历史,动态重塑表单字段与页面布局51 | EllipX动态表单;Dollet个性化微件54 | 实现高度个性化的软件体验,针对不同用户状态呈现最匹配的交互结构51 |
设计期生成式界面 (Design-Time Generation) | 在研发阶段利用AI快速生成组件结构与界面变体,经人工校验后编译上线51 | 各类AI原生前端原型与代码生成工具51 | 显著缩短初创团队MVP验证周期并降低跨浏览器维护开销,赋予产品快速业务转向(Pivot)的架构韧性52 |
这一架构变迁深刻重塑了产品设计师与前端工程师的职能边界,推动软件设计步入尼尔森诺曼集团(Nielsen Norman Group)所定义的“结果导向设计(Outcome-Oriented Design)”阶段54。人类专家的工作重心不再是手动绘制每一块静态画布,而是打造具备高度可组合性的自适应设计系统(Adaptive Component-based Design Systems),并专注于定义系统目标、边缘情况(Edge Cases)以及模型不可逾越的质量护栏52。
智能体接管交互层与无头化应用趋势
当生成式UI与后台持续循环智能体进一步融合时,独立应用软件的表层边界开始消融10。在安德烈·卡帕西(Andrej Karpathy)主导的“Claws”架构实验中,一个常驻后台的单一自然语言智能体界面成功将六款独立的消费级应用程序折叠整合:底层应用依然作为提供数据存储与逻辑处理的底座在后台运行,但人类用户全程无需直接触碰任何一款底层App的原生界面10。
这种“智能体替代独立App表层”的演进趋势表明,未来大量软件系统将退化为提供API与MCP接口的“无头服务(Headless Services)”,软件的直接客户正从人类转变为智能体10。直接占领用户终端屏幕的,将是能够跨系统拉取上下文、按需动态渲染微件卡片并自主闭环执行任务的智能体工作空间10。对于软件企业而言,唯有在前端构建高度自适应的生成式交互体验,或在后端成为智能体不可或缺的行动与上下文基座,方能避免在价值链迁移中被边缘化10。
标杆工程架构深度解构:实时人机协同与长程自主执行
为具象化呈现AI原生应用如何通过底层工程创新突破大模型固有的延迟、幻觉与上下文限制,以下选取开发者工具领域的标杆Cursor(代表毫秒级高频人机协同范式)与企业级客户服务领域的标杆Sierra AI(代表长周期多模型自主代理范式)进行全栈技术解构22。
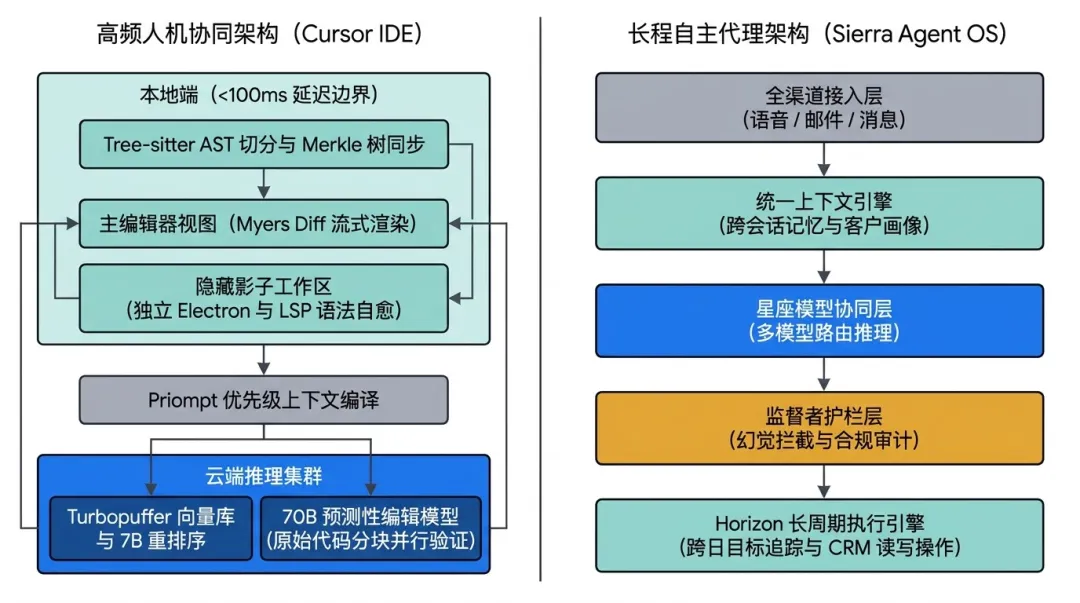
毫秒级人机协同架构:Cursor的预测编辑与影子工作区
在AI辅助编程领域,核心工程矛盾在于如何在用户两次敲击键盘的极短间隙内(严苛的100毫秒端到端延迟预算),结合数百万行企业级代码库的全局上下文,交付零语法错误的精准多行代码修改25。为突破传统IDE插件的权限瓶颈,Cursor放弃了作为VS Code扩展插件的轻量化路线,选择直接深度分叉(Fork)VS Code底层源码,从而完全接管了编辑器的渲染管线、文件系统钩子、扩展宿主进程(Extension Host)以及内联差异(Inline Diff)图层控制权,并支持后台智能体在隔离虚拟机中运行25。
在上下文构建与编排层,Cursor确立了严格的端云延迟边界:所有要求100毫秒以内响应的操作——包括基于Tree-sitter的抽象语法树(AST)函数与类边界切分、BM25关键词索引、敏感密钥脱敏及LanceDB本地向量存储——全部保留在本地客户端执行25。客户端通过维护文件哈希的默克尔树(Merkle Tree),每5分钟向云端增量同步变更文件,在不存储原始明文代码以保障隐私的前提下,将超过1,000亿规模的语义向量嵌入存入基于S3构建的无服务器向量数据库Turbopuffer25。当触发查询时,云端调用经专门微调的7B CodeLlama交叉编码重排序器(Reranker),借助块存储KV缓存(Blob-storage KV Caching)技术将计算成本降低20倍,单次查询可高效处理高达50万Token的上下文25。在提示词组装阶段,其开源的Priompt(内部亦称Preempt)框架采用类似React的JSX组件化语法声明上下文元素,依据代码行距光标的远近及重排序得分赋予动态优先级;一旦总上下文超出模型的Token预算,渲染器立即通过二分查找(Binary Search)自动裁剪低优先级节点,系统性解决了生产环境下的上下文窗口溢出难题25。
在实时代码生成与流式应用层,由于大模型在预训练阶段接触了海量完整代码文件,却较少处理标准Diff补丁且缺乏精准的行号计数能力,直接要求模型输出行号Diff极易引发错位与语法损毁25。为此,Cursor在代码应用阶段(Fast Apply)结合了“搜索/替换块(Search/Replace Blocks)”与“全文件重写”机制25。为攻克全文件重写耗时长达数十秒的瓶颈,Cursor研发了专为代码编辑定制的投机解码变体——预测性编辑(Speculative Edits)25。不同于传统投机解码需要额外部署小型草稿模型(Draft Model)猜测后续Token,代码修改具有极强的先验特征,即重写后的绝大部分代码与原文件完全一致25。系统直接将原文件切分为代码块作为推测草稿并行喂入70B规模的定制Apply模型进行批量验证;模型在未发生修改的代码段上并行批量放行,仅在检测到逻辑变更点时切回逐Token生成,修改完毕后立即恢复对剩余原代码的投机跳跃25。这一算法创新使70B大模型实现了每秒约1,000 Token的生成速度,较原生Llama-3-70B推理提速约13倍25。在客户端渲染时,为克服模型输出缩进或字符的细微非确定性偏差,IDE在内存文件克隆中运行Myers差分算法(Myers Diff Algorithm)执行模糊锚点匹配(Fuzzy Anchor Finding),在模型尚未生成完毕时即实时锁定目标位置,将红绿增删标记以流式画面直接渲染至主编辑器视图55。
在高频交互反馈与后台静默校验层,Cursor针对Tab自动补全训练了专用的长输入、短输出混合专家模型(MoE),每次并发生成约100个候选编辑项,不仅预测下一处多行代码变更,还能预测光标在文件内乃至跨文件的下一跳位置56。为消除低质量弹窗对开发者的视觉干扰,其在线强化学习系统(Tab RL)设计了严密的奖励函数:建议被采纳得 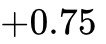 分,被显式拒绝得
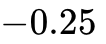 分,保持静默不弹窗得 分25。该数学期望决定了模型仅在预估采纳概率超过
 时才会触发显示,从而在减少21%弹窗频次的同时将采纳率提升28%,并依托每日4亿次请求构成的90分钟反馈闭环,实现每日多次模型检查点(Checkpoint)的迭代部署25。更进一步,针对复杂重构任务,Cursor在本地后台运行了一个隐藏的Electron窗口——影子工作区(Shadow Workspace)56。当AI提出代码修改时,主窗口渲染进程通过扩展宿主将变更转发至影子窗口的渲染进程,在独立于用户的隐藏内存中应用修改,并调用语言服务器协议(LSP,如tsc、gopls或rust-analyzer)执行毫秒级语法检查(Lints)与跳转定义验证56。若发现语法或类型错误,AI在后台自动迭代修复直至校验通过,随后才将修正后的代码呈现给开发者;同时Composer功能会创建虚拟影子分支(Shadow Branch),确保跨十余个文件的重构可被一键整体审阅或回滚55。为缓解双窗口运行带来的内存翻倍开销,系统采取按需启动与空闲销毁策略,并正探索通过内核级代理或自动推断Docker容器实现磁盘与网络级隔离,以规避编译构建缓存(如Cargo在NFSv3下的文件锁冲突)带来的磁盘副作用49。
企业级自主代理架构:Sierra的星座模型编排与长周期目标引擎
与Cursor聚焦于赋能个体开发者的毫秒级协同不同,由Salesforce前联席CEO布雷特·泰勒(Bret Taylor)与Google Labs前负责人克雷·巴沃尔(Clay Bavor)于2023年创立、2024年2月公开推出的Sierra AI,代表了直接面向终端消费者、具备后台系统真实写权限(Write Actions)的企业级全自主代理(Autonomous Agents)架构范式20。该平台在公开上线后仅用9个季度即实现2亿美元ARR,并于2026年5月完成由Tiger Global与GV领投的9.5亿美元融资,估值突破150亿至158亿美元;其客户涵盖ADT、SiriusXM、Sonos、Rocket Mortgage、Chime、Airtable、Wayfair、Vanguard以及在欧洲拥有约8,000万固网与移动连接的Liberty Global等大型企业,服务触达超过95%的美国购物者与50%的医疗保健家庭22。
在认知推理与安全护栏层,面对直接代表企业品牌与消费者交互并执行退换货处理、账户更新、挽留取消及套餐升级等后台数据库写操作的严苛场景,单一基础模型的幻觉与合规失控风险是大型企业无法承受的20。Sierra在底层Agent OS与Agent SDK之上构建了多模型“星座架构(Constellation of Models)”,根据意图理解、业务推理与工具调用的不同需求,协同调度多个大语言模型21。在主模型集群之上,Sierra部署了独立的监督者智能体(Supervisor Agent),充当实时行为质量控制与审计层22。监督者模型在主智能体输出回复或触发CRM及订单管理系统API调用前,强制执行事实核查、品牌语调对齐与合规边界校验;一旦判定请求超出授权范围或存在风险,系统立即阻断自主执行并平滑移交人工坐席(Handoff),配合SOC 2 Type II、ISO 27001、ISO 42001、AIUC-1及PCI DSS Level 1等全套安全认证,构建起企业级信任基座21。
在上下文延续与长周期执行层,传统客服技术(包括早期AI聊天机器人)均以“单次对话(Conversation)”为基本工作单元,会话结束即意味着状态终结22。Sierra通过构建跨渠道上下文引擎(Context Engine)并收购长周期代理运行时公司Takeoff,推出了Horizon平台,将智能体的工作单元从“响应单次会话”升级为“跨越多日、数周乃至数月追求确定性业务目标(Objective)”22。依托统一的数据平台,单一智能体可同时部署于电话语音、短信(SMS)、WhatsApp、电子邮件、网页聊天及ChatGPT端,在跨渠道流转中完整保留客户历史记忆,根据业务信号主动唤醒跟进动作,直至达成抵押贷款发放、流失挽回、医疗转诊闭环或试用期转化等复杂商业结果22。
这种从“被动对话分流”向“主动长周期工作执行”的架构演进,直接将企业联络中心从成本消耗部门转化为营收创造引擎63。在标杆客户落地中,Sierra在Airtable与Chime分别实现了80%与70%以上的端到端独立解决率,并在Rocket Mortgage实现了4倍的转化率提升22。在金融科技企业Figure Technology的房屋净值贷款(Home-Equity Loan)应用中,Horizon智能体负责在多日周期内跨语音和短信主动重连申请流程停滞的借款人,协助其逐步跨越征信授权、身份验证与银行账户绑定等高摩擦节点,随后将合格客户精准移交人类信贷专员63。实证数据显示,与智能体互动的停滞申请人跨越各摩擦环节的转化率提升了30%至52%,最终放款规模增长67%;而将AI智能体前置培育与人类信贷专员相结合的混编模式,相比纯人工独立跟进实现了高达143%的放款转化率跃升63。
两种工程范式的架构权衡与技术边界对比
深入对比Cursor与Sierra AI可以发现,AI原生架构不存在单一的万能模板,工程设计的取舍高度收敛于业务场景的容错机制与延迟敏感度25。
架构维度 | 高频人机协同范式 (以 Cursor 为代表) | 企业级长程自主代理范式 (以 Sierra AI 为代表) |
核心业务目标与容错机制 | 消除低熵编码操作,放大开发者生产力;由人类程序员充当最终防线(通过统一Diff审阅一键采纳或回滚)25 | 端到端替代或协同人工坐席完成业务闭环;直接面向终端消费者执行后台写操作,要求极高的零幻觉与合规确定性20 |
延迟预算与算力权衡 | 极度严苛(本地操作 | 聊天与异步渠道容忍度较高,但在实时语音(Voice)场景面临挑战:多模型星座路由与监督者校验易引入700ms以上延迟,在电话沟通中产生可感知的停顿60 |
状态管理与长上下文挑战 | 依托本地AST语法树切分、Merkle树增量同步与Priompt动态裁剪策略,精准锚定当前编辑窗口周边的局部高优上下文25 | 依赖Context Engine跨渠道维护长周期状态;但在超长复杂分支咨询中仍可能出现上下文衰减与回复泛化,且长周期跨系统记录一致性治理要求极高22 |
交付模式与定制化摩擦 | 标准化客户端软件自服务扩散,支持工程团队通过 .cursor-rules 目录按文件模式维护一致性AI行为规则49 | 高度依赖重度专业服务(Services-led),全面部署周期达4周至7个月,日常逻辑与提示词调整高度依赖原厂工程团队介入,总拥有成本(TCO)较高20 |
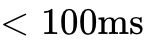
Sierra在实时语音延迟(700毫秒以上)与重度交付周期(长达3至7个月)上显现的工程摩擦表明,多模型级联监督虽然有效压制了输出幻觉,却付出了端到端延迟叠加的物理代价;而在大型企业核心记录系统缺乏标准化语义接口的现状下,要让长周期智能体安全可靠地修改生产数据库,依然需要投入可观的前置定制化集成工程21。
商业经济学重塑:毛利压缩机制、损益表重构与定价演进
算力可变成本化与毛利率结构性压缩
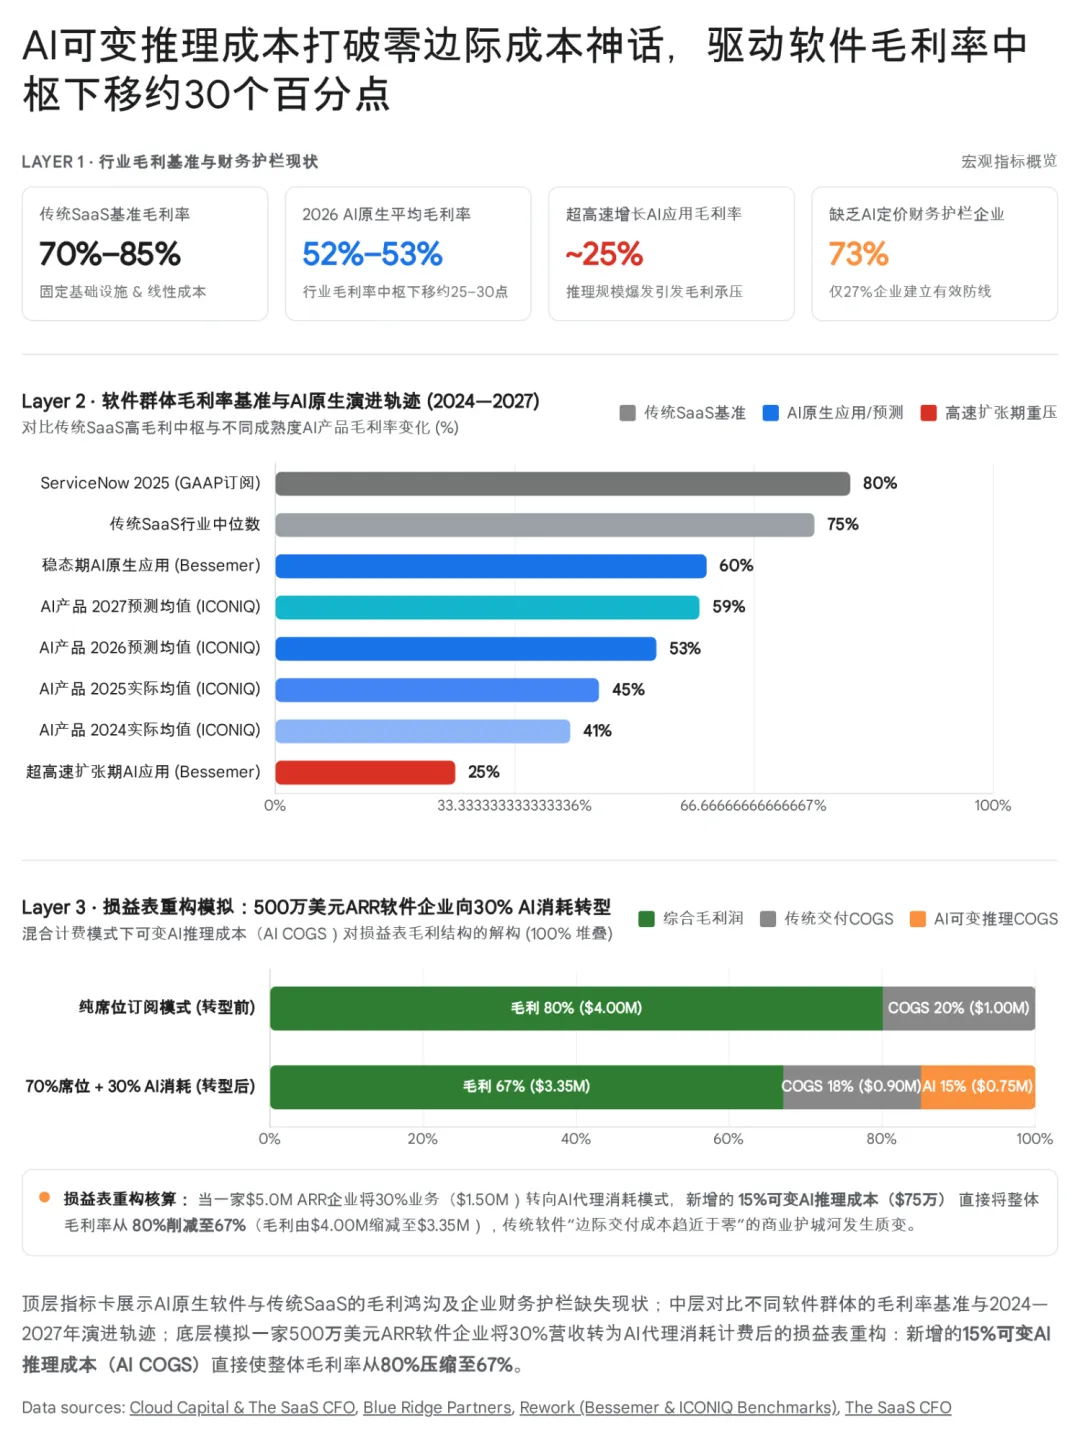
AI原生应用不仅重塑了软件工程架构,更从底层改变了延续二十年的SaaS财务模型15。传统SaaS经济学建立在“高固定研发投入、近乎为零的边际交付成本”之上:软件一旦编写完成,服务新增用户的增量算力消耗仅相当于几分之一美分的服务器开销,主营业务成本(COGS,含云托管、基础运维与客户支持)通常仅占营收的10%至20%,从而支撑起70%至85%(成熟期上市标杆如ServiceNow在2025年实现80%的GAAP订阅毛利率与83.5%的Non-GAAP毛利率)的高毛利基准14。
在AI原生架构下,每一次用户查询、每一个后台智能体推理步骤都会实时触发GPU算力消耗与第三方模型API调用费,使得算力从固定分摊的后台费用转变为随使用量同步增长的纯粹可变成本(Variable COGS)15。Bessemer与ICONIQ等机构的行业基准调研清晰揭示了这一毛利压缩现实:纯AI原生软件的平均毛利率普遍处于50%至60%区间(ICONIQ针对300余家AI软件企业高管的调研显示,AI产品平均毛利率在2024年为41%,2025年为45%,2026年预计升至52%至53%,2027年预计达到59%),较传统SaaS中位数出现20至30个百分点以上的结构性下移;而处于高速扩张期、优先争夺市场份额的AI原生应用,其毛利率甚至低至25%左右15。
剖析AI原生企业的成本结构,造成毛利率承压的核心动因来自三个方面。其一是云基础设施与实时推理算力支出,通常直接占据营业收入的25%至50%以上;尤其在编程助手等对推理质量要求严苛的场景中,应用层被迫高频调用顶尖基础模型,导致企业自身的COGS直接受制于上游模型供应商的API定价策略66。其二是人工介入校验(Human-in-the-Loop)与模型维护成本,为确保输出可靠性,许多AI企业需将10%至15%的营收投入实时人工审核、数据标注与模型微调更新66。其三是“重度用户陷阱(Heavy-User Trap)”与复合使用量传导效应65。单用户的AI成本传导遵循严格的乘法复合关系:
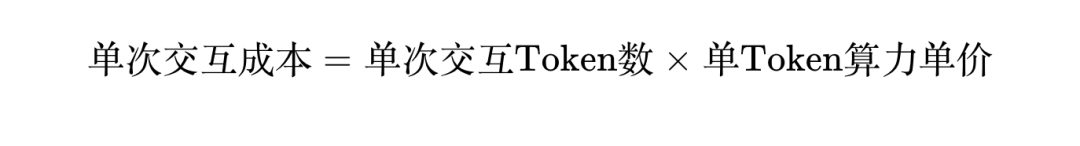
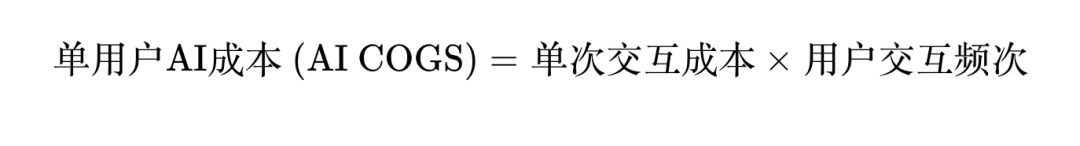
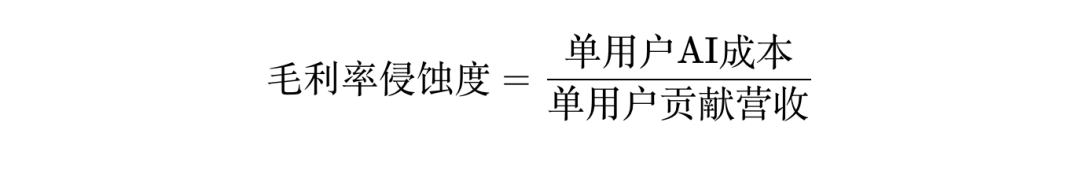
在固定费率(Flat-fee)或传统按席位计费模式下,上述传导机制会产生显著的财务反噬:当AI产品能力越强、客户留存周期越长、历史沉淀数据集越深厚时,用户的交互频次与单次携带的上下文Token消耗便会同步激增,部分生产环境客户的月度AI推理支出复合增长率甚至超过50%65。若产品因质量要求从轻量级模型切换至旗舰推理模型,毛利率可能直接滑落21个百分点(如从95%骤降至74%)65。在极端案例中,一家金融科技AI聊天机器人企业发现单个企业客户每日消耗的云端推理算力高达400美元,在固定月费合同下,高活跃度重度用户直接将该账户推入严重亏损状态66。
损益表科目重分类与新型财务治理指标
面对可变成本的复合增长,软件企业财务团队必须依据通用会计准则(GAAP)与国际财务报告准则(IFRS)的功能性测试原则,对损益表(P&L)进行严密的重分类与核算改造15。核心核算边界在于判定算力负载是否直接服务于向付费客户交付产品价值:基础模型预训练(例如OpenAI耗资超5亿美元训练GPT-4)、领域微调实验、内部开发测试工具以及面向内部员工的AI应用,其算力与高薪AI研发人员支出属于营业费用中的研发费用(R&D OpEx);而所有面向外部客户的实时模型推理、多模型路由调度、向量检索以及多步智能体工作流计算,则必须严格计入主营业务成本(COGS)15。
以一家500万美元ARR的软件企业为例,在纯席位订阅模式下,其营收平滑且可预测,传统COGS固定为100万美元,毛利润达400万美元(毛利率80%);当该企业嵌入AI智能体并将30%的营收(150万美元)转为按消耗或结果计费的AI收入后,即便传统COGS微降至90万美元,新增的75万美元可变AI推理成本(AI业务毛利率50%)仍会使整体毛利润降至335万美元,综合毛利率瞬间压缩13个百分点至67%15。当前大量企业的财务核算仍将AI推理支出混同于未分类的普通云托管费用,导致综合毛利率(Blended Margin)掩盖了AI产品线的真实损益结构65。行业调研显示,尽管96%的高管预计将调整AI定价模型,且90%的企业已在董事会或融资并购尽调中面临AI毛利压缩问询,但目前仅有27%的企业设立了强制执行的AI定价财务护栏,仅23%的企业将AI功能成本精准关联至单个客户账户交付层级,高达72%的企业仅凭非正式调研甚至在毫无调研的情况下制定AI价格,仅8%的企业真正以支付意愿(WTP)研究驱动定价决策14。
在可变成本主导的商业环境中,传统的净收入留存率(NRR)与基于综合订阅毛利率计算的客户生命周期价值(LTV)已出现严重失真——单一账户的NRR可能表现优异,但后台激增的推理Token消耗正在静默侵蚀该账户的实际毛利14。现代AI原生财务治理必须建立按营收流(By Revenue Stream)、按客户及按功能维度的独立成本中心,并全面转向三项核心财务指标:首先是AI成本率(AI COGS Ratio),即推理与算力成本占AI直接驱动营收的比重,用于实时监测可变成本水位;其次是推理效率比(Inference Efficiency Ratio),即每投入1美元推理算力所创造的AI营业收入,直接反映模型路由、提示词压缩与缓存工程的商业效能;最后是算力调整后生命周期价值(Compute-Adjusted LTV),即摒弃综合毛利率,强制采用扣除账户级AI可变成本后的边际贡献率(Contribution Margin)重算LTV与获客成本回收期(CAC Payback),为估值倍数校准与销售激励提供真实依据15。
席位制瓦解与混合结果导向定价体系构建
算力成本的刚性约束与软件向“行动系统”的定位跃迁,共同驱动传统按席位定价(Per-Seat Pricing)模式加速退场15。当AI智能体直接替代人工操作并缩减企业客户所需的人类坐席数量时,继续按登录账号数收费将直接导致软件厂商营收萎缩10。彭博(Bloomberg)预测数据显示,未来十年内,基于席位订阅的定价模式在SaaS行业中的占比将从60%降至30%,而基于业务交付结果(Outcome-Based Pricing)的定价占比将从10%跃升至60%,完成软件行业二十年计费逻辑的根本反转15。
在计费度量衡(Charge Metric)的演进中,AI原生企业正从“按软件访问权限收费”全面转向“按可量化的交付价值收费”2。仅提供辅助建议却无法闭环执行任务的Copilot类产品受困于“软性投资回报率(Soft ROI)”,在2025年试点项目进入2026年续约谈判时普遍面临客户的价值质疑;相反,能够独立完成端到端任务闭环的自主智能体则凭借清晰的硬性ROI实现了顺畅的价值捕获14。
定价模式 | 核心计费度量衡 | 标杆案例与商业条款细节 | 适用买方特征与财务风险权衡 |
纯结果导向定价 (Outcome-Based) | 按智能体成功闭环交付的业务成果(如解决工单数、生成合格线索数、完成文书起草数)计费17 | Intercom Fin:按每成功解决一个客服工单收取 | 高度契合业务部门买方,将销售、客成与产品团队目标统一对齐至最终交付结果;但厂商需自行吸收未达成结果时的推理算力成本,且客户初期难以精准预测结果总量17 |
纯用量/算力定价 (Usage / Token-Based) | 按实际消耗的Token数、API调用次数或推理计算量计费17 | 基础模型API、面向开发者的底层工具链17 | 严格保障厂商毛利率免受重度用户侵蚀;但仅适用于技术型买方,非技术企业采购方难以理解Token度量且排斥不可预测的月度账单波动17 |
混合分层定价 (Hybrid Pricing) | 基础平台订阅费(Base Subscription)+ 用量/结果阶梯包(Usage/Outcome Tiers)15 | Sierra AI 企业级合同:约$15万– | 当前商业落地最具可行性的均衡方案(Bain与Bessemer研究验证):既为企业采购提供基础预算可预测性,又通过用量上限(Usage Caps)与超额阶梯保护厂商毛利底线,同时随客户业务规模扩张自然捕获上行收入弹性14 |


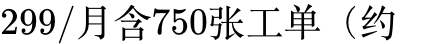
构建一套兼顾市场采纳率与毛利安全的AI货币化体系,软件企业需系统性落实五项定价准则。首先,必须在售前阶段量化可信的硬性ROI(如明确削减40%客服工单或90天内收回成本),以此确立价格天花板14;其次,坚持以账户级COGS成本底线为支撑的价值定价,既要避免限制盈利上行空间的简单成本加成(Cost-plus),也要杜绝无上限的固定费率以防补贴重度算力消耗账户14;再次,在产品打包(Packaging)上区分“嵌入式AI”与“显性高消耗AI”,将前者作为全产品线的普惠品质提升,将后者设为具备严格配额上限与超额计费阶梯的高阶付费模块14;此外,在混合计费结构中引入规模递减机制,随着客户交付结果总量扩大适度降低单次结果费率,从而在保持健康毛利的同时实现客户总合同额(ACV)的有机扩张17;最后,结合严谨的支付意愿(WTP)调研与销售实战价格测试,渐进上调报价直至触及买方“需要内部评估考量”的摩擦阈值,以此校准最优商业定价点14。
战略演进结论与产业落地路线
综合认知架构、交互范式与商业经济学的全局演进,AI原生应用已跨越概念验证(POC)与单点对话插件的初级阶段,全面迈入以复合智能系统为底座、以生成式界面为触角、以自主行动系统为价值核心、以混合结果定价为商业闭环的规模化落地期1。面向未来技术演进与市场竞争,软件研发机构与企业技术决策者需围绕以下四个维度推进系统性重构:
在战略定位与产品演进方向上,企业应果断摒弃浅层对话封装,向垂直领域“行动系统(System of Action)”纵深切入6。随着基础模型实验室持续向上游通用应用层延伸,单纯依赖信息检索与浅层问答的工具极易被底层模型原生能力覆盖12。持久的竞争壁垒在于深度接管高摩擦、跨系统的复杂行业工作流——例如医疗健康领域Ambience Healthcare通过整合患者全周期纵向病历,在17个专科与7种语言环境中实现90%的临床医生采用率,并在ICD-10医疗编码准确率上超越认证医师27%;或如金融信贷与企业客服领域跨日周期的自动化追单与后台账务核销8。通过打通底层记录系统的读写接口并沉淀多角色协同(Multiplayer)能力,AI原生软件方能从辅助工具跃升为直接创造业务结果的生产要素10。
在认知架构与运行时工程上,研发团队需全面构建“端云边界分明、多模型负载联合路由、后台监督自愈”的复合系统架构22。架构设计应将毫秒级延迟敏感操作(AST语法解析、轻量索引与隐私脱敏)下沉至本地客户端,在云端部署融合偏好学习(如RouteLLM矩阵分解)与GPU集群负载感知(如RouterWise联合优化)的路由网关,确保将80%以上的常规流量沉淀于高性价比轻量模型,仅将不足20%的复杂推理分发至旗舰模型30。同时,针对所有涉及生产数据库修改或外部客户触达的动作,必须参考Cursor影子工作区或Sierra监督者模型的架构范式,在主生成链路旁路部署确定性的验证环境(编译器LSP诊断、最小权限行动护栏或独立监督模型),在输出生效前完成毫秒级静默修正与越权拦截22。
在数据基座与人机交互层,企业需同步推进GraphRAG时序记忆改造与组件化生成式UI升级23。数据层应超越孤立的文本向量切片,融合知识图谱拓扑连接與时序状态追踪(如Graphiti/Zep与Mem0架构),并着力构建时序冲突事实的自动消解与状态覆盖机制,为长周期运行的智能体提供一致的上下文可信度22。前端与接口层则应从硬编码静态页面转向沉淀高内聚的原子UI组件库,借助流式生成式UI在运行时按用户意图动态组装交互视图,同时将核心业务功能全面封装为标准化的MCP接口与遵循AXI原则的智能体友好型工具,确保系统在多智能体协同生态中具备高效的被调用能力10。
在财务核算与商业化治理上,企业管理层必须在预算周期前建立账户级可变算力核算体系,并果断切换至混合结果导向定价模型14。财务与工程团队需利用全链路可观测性工具,将实时推理、模型路由与智能体工作流开销精准归集至客户与功能维度的COGS科目,并与研发阶段的训练测试OpEx严格剥离,全面导入AI成本率、推理效率比与算力调整后LTV三项治理指标15。在商业合同结构上,逐步淘汰无算力保护机制的固定席位包月制,全面确立“基础平台订阅费保底 + 明确配额封顶 + 按可验证业务结果阶梯计费”的混合商业模式,使底层模型路由与工程优化带来的每一次推理降本,都能直接沉淀为损益表上稳健的毛利率扩张与可持续的长期盈利壁垒14。
引用的著作
A Grey Literature Review of AI-Native Applications - arXiv, https://arxiv.org/html/2509.13144v2
AI-Native vs AI-Bolted-On: The 2026 Buyer Playbook - SaaS Mag, https://www.saasmag.com/ai-native-vs-ai-bolted-on/
Generative AI's Act o1: The Reasoning Era Begins | Sequoia Capital, https://sequoiacap.com/article/generative-ais-act-o1
COST- AND LATENCY-CONSTRAINED ROUTING FOR LLMS, https://openreview.net/pdf?id=pZFJLsIY2m
AI原生应用架构白皮书- 阿里云研究院, https://www.aliyun.com/reports/2025-ai-architecture
Vertical AI Explained: The Next Generation of Tech Titans, https://www.nea.com/blog/tomorrows-titans-vertical-ai
The Future of ERP - Apple Podcasts, https://podcasts.apple.com/us/podcast/the-future-of-erp/id1666476329
FinTech CEO Interview: Sequence - FT Partners, https://ftpartners.com/eecwih1bhiad/3KwXiW4xAF1JKPHJiOleyK/94c55fb36545d20a7cd48073ee70dfae/FT_Partners_Interview_-_Sequence.pdf
The New Moat Is Workflow Ownership | Momentum Nexus, https://www.momentumnexus.com/blog/workflow-ownership-new-moat
Future of Software | Sunil Venkataram, https://sunilvenkataram.com/garden/future-of-software/
What AI-Native Means for Your Product Roadmap - Beach, https://beach.io/blog/what-ai-native-means-for-your-product-roadmap/
Big Ideas 2026: Part 1 | Andreessen Horowitz, https://a16z.com/newsletter/big-ideas-2026-part-1/
The AI-Native Data Management Stack is Evolving in Real-Time, https://solutionsreview.com/data-management/the-ai-native-data-management-stack-how-data-infrastructure-is-evolving-in-real-time/
The Five Keys to AI Pricing | Blue Ridge Partners, https://www.blueridgepartners.com/insights/the-five-keys-to-ai-pricing/
The Death of Per-Seat Pricing: What It Means for Your SaaS P&L, https://www.thesaascfo.com/saas-per-seat-pricing/
The native agent inside your system of record is not the AI decision, https://www.nodes.inc/blog/waiting-for-native-agents-is-the-wrong-bet
The AI pricing and monetization playbook, https://www.bvp.com/atlas/the-ai-pricing-and-monetization-playbook
Bessemer's latest State of Cloud report predicts AI's world domination, https://siliconangle.com/2024/06/20/bessemers-latest-state-cloud-report-predicts-ais-world-domination-2/
Advanced RAG Techniques: From Naive RAG to Hybrid GraphRAG, https://www.tigergraph.com/blog/advanced-rag-techniques-naive-to-hybrid-graphrag/
Sierra AI Review 2026: Pricing, Ratings and Who It Suits, https://www.getmacha.com/blog/sierra-ai-complete-guide
Sierra AI Explained: Features, Use Cases & Enterprise Alternatives, https://www.pixiebrix.com/tool/sierra
Sierra AI Platform: Architecture, Pricing, Context Gaps [2026] - Atlan, https://atlan.com/know/ai-agent/ai-agent-applications/what-is-sierra-ai/
Zep vs Mem0: Which AI Memory Layer Fits Your Stack? - Atlan, https://atlan.com/know/zep-vs-mem0/
Good news: AI Will Eat Application Software | Andreessen Horowitz, https://a16z.com/good-news-ai-will-eat-application-software/
How Cursor Actually Works: Architecture and Engineering - Medium, https://medium.com/data-science-collective/how-cursor-actually-works-c0702d5d91a9
Bessemer's 2026 State of the Cloud Report, Decoded - Capitaly, https://www.capitaly.vc/blog/bessemer-2026-state-of-cloud-report-decoded
The Cloud 100 Benchmarks Report 2025 - Bessemer Venture Partners, https://www.bvp.com/atlas/the-cloud-100-benchmarks-report
State of the Cloud 2024 | Bessemer Venture Partners, https://www.bvp.com/atlas/state-of-the-cloud-2024
RouteLLM: Learning to Route LLMs with Preference Data - arXiv, https://arxiv.org/html/2406.18665v3
RouterWise: Deployment-Aware Prompt Routing for Multi-Model LLMs, https://arxiv.org/html/2604.10907
LLM Model Routing in 2026: Cost-Quality Optimization, https://www.digitalapplied.com/blog/llm-model-routing-2026-cost-quality-optimization-engineering-guide
Towards Cost-effective LLMs Routing with Batch Prompting - arXiv, https://arxiv.org/pdf/2605.28268
RouteLLM: Learning to Route LLMs with Preference Data - arXiv, https://arxiv.org/html/2406.18665v4
Scaling Conversational AI withLatency-Aware LLM Routing - arXiv, https://arxiv.org/html/2610.26511v1
GraphRAG Vs Standard RAG: Retrieval For Enterprise AI - Arivonix AI, https://www.arivonix.ai/blog/graphrag-vs-standard-rag-enterprise-ai/
When Does GraphRAG Outperform Traditional RAG?, https://www.persistent.com/blogs/when-does-graphrag-outperform-traditional-rag/
Naïve RAG vs Microsoft GraphRAG - Medium, https://medium.com/wpp-ai-research-labs/na%C3%AFve-rag-vs-microsoft-graphrag-aa085807ce0e
RAG vs. GraphRAG: A Systematic Evaluation and Key Insights - arXiv, https://arxiv.org/abs/2502.11371
GraphRAG vs Naive RAG 2026: Knowledge Graphs, Hybrid Search, https://www.mockexperts.com/blog/graphrag-vs-naive-rag-hybrid-search-ai-system-design-2026
From Documents to Knowledge: Why Your AI Still Doesn't ... - Medium, https://medium.com/@patriwala/from-documents-to-knowledge-why-your-ai-still-doesnt-remember-anything-f5ed768c0bc2
AI Memory Architectures Compared 2026 - Presenc AI, https://presenc.ai/research/ai-memory-architecture-comparison-2026
GitHub All-Stars #2: Mem0 - Creating memory for stateless AI minds, https://virtuslab.com/blog/ai/git-hub-all-stars-2
The 8 Best Tools for AI Agent Memory & Long-Term Recall (2026, https://www.shaped.ai/blog/the-8-best-tools-for-ai-agent-memory-long-term-recall-2026-guide
Mem0 and Chroma: How the Personal AI Memory Stack Works [2026], https://atlan.com/know/ai-agent/ai-agent-memory/personal-ai-memory-mem0-chroma/
Mem0 vs Zep vs Letta vs Cognee: Agent Memory Compared | NomadX, https://nomadx.ae/blog/mem0-vs-zep-vs-letta-vs-cognee-2026/
Mem0: Scalable Long-Term Memory for AI | PDF - Scribd, https://www.scribd.com/document/861622947/2504-19413v1
AI原生应用架构深度解析与智能体构建实践 - 阿里云开发者社区, https://developer.aliyun.com/article/1684452
Generative UI + MCP: The New Stack for AI-Native Applications, https://odsc.medium.com/generative-ui-mcp-the-new-stack-for-ai-native-applications-b62af183f2aa
How Cursor Works Internally? - Aditya Rohilla, https://adityarohilla.com/2025/05/08/how-cursor-works-internally/
Securing AI agents: the defining cybersecurity challenge of 2026, https://www.bvp.com/atlas/securing-ai-agents-the-defining-cybersecurity-challenge-of-2026
Generative UI: The Future of Dynamic, AI-Powered User Experiences, https://www.jogdigitalinnovations.com/blogs/generative-ui-the-future-of-dynamic-ai-powered-user-experiences
Generative UI vs Traditional Frontends: Why AI-Native Startups, https://www.thesys.dev/blogs/generative-ui-vs-traditional-frontends-why-ai-native-startups-should-embrace-the-shift
Designing AI-Native User Interfaces: Foundational Principles - Medium, https://medium.com/@neilpatel004/designing-ai-native-user-interfaces-foundational-principles-334bd54aa3c0
Generative UI design: a practical guide | Lazarev.agency, https://www.lazarev.agency/articles/generative-ui-design
Cursor AI System Design & Architecture Guide [2026] - Tech Interview, https://www.techinterview.net/blog/cursor-ai-ide-interview-guide
Cursor - openagent, https://openagenthub.io/real-world/cursor
Cursor: Building a Next-Generation AI-Enhanced Code Editor with, https://www.zenml.io/llmops-database/building-a-next-generation-ai-enhanced-code-editor-with-real-time-inference
Iterating with shadow workspaces - Cursor, https://cursor.com/blog/shadow-workspace
Cursor 3's 'Shadow Workspace' Tests AI Suggestions in a Hidden, https://tianpan.co/forum/t/cursor-3s-shadow-workspace-tests-ai-suggestions-in-a-hidden-kernel-level-proxy-before-you-see-them-is-this-the-ide-innovation-we-need-or-surveillance-architecture-in-your-dev-environment/4118
Sierra Review 2026: Honest Assessment for Revenue Teams, https://thoughtly.com/blog/sierra-review
"Sierra Just Crossed $15B Selling AI Customer Agents Into Half the, https://resources.rework.com/news/sales-tech/sierra-ai-15b-customer-agents-sales-ops
Sierra AI Revenue: How It Grew to $200M ARR in 9 Quarters - Okara, https://okara.ai/blog/sierra-ai-revenue-growth
Sierra Wants to Turn AI Customer Service Into a Revenue Engine, https://cxfoundation.com/news/sierra-ai-customer-service-revenue-engine
Sierra's Clay Bavor on Making Customer-Facing AI Agents Delightful, https://sequoiacap.com/podcast/training-data-clay-bavor
Gross Margin in the Age of AI | Cloud Capital, https://www.cloudcapital.co/learn/gross-margin-in-the-age-of-ai
Why AI Gross Margins Differ From SaaS - Rework, https://resources.rework.com/libraries/ai-startup-growth/ai-vs-saas-gross-margins
The Economics of AI-First B2B SaaS in 2026 - Monetizely, https://www.getmonetizely.com/blogs/the-economics-of-ai-first-b2b-saas-in-2026
The Intercom AI Transformation - The Metrics Brothers - Apple, https://podcasts.apple.com/us/podcast/the-intercom-ai-transformation/id1687214133?i=1000764230974
AI COGS: How AI Hits SaaS Gross Margin - Adlega, https://adlega.com/blog/ai-cogs-gross-margin/
Blog - Ambience Healthcare, https://www.ambiencehealthcare.com/blog-legacy