研报速递
这是《1000个金融+AI使用场景》系列文章的第 15 篇。
从去年开始,我们陆陆续续开发了不少金融 skill,做研究、写报告都在用。
我们团队做研究写研究报告,现在有个比较固定的习惯:
先在大模型里把一个行业从头到尾捋一遍,捋完了,再拿到专业的金融AI Agent里去核对。
大模型会比较快。几十分钟,能把一个陌生赛道的框架、产业链、主要玩家都展开。
但是信源的可靠程度,到目前为止还是全行业通病。
前几天问大模型:这轮持续一年多的存储芯片涨价,国内卖方最早是谁提出来的?它给了两篇 2025 年 2、3 月的研报,然后很老实地补了一句:只查了公开网页,路演和电话会没覆盖到。
可卖方最值钱的判断,常常是先在路演和电话会上讲出来的。
在这种事情上,要是真完全靠AI,黄花菜都凉了……
最近我们找到了一个邪修大法……团队还是很兴奋的,我们今天分享给各位。
这个邪修大法,能迅速把一个行业里真正跟得紧、判断准的卖方团队找出来,并且把那些爱贴标签的水货团队排除掉……
这个邪修,我们是在进门的AI进宝里跑出来的。
之所以特地强调了这个品牌名字,是因为我们觉得这个邪修大法有一个重要的前提:高质量、有连续性的行业研究语料库。
而进门做了十几年路演会议,卖方公开路演的纪要都沉淀在语料库里。
我们团队几个小伙儿现在也很常用进门家的Agent,AI进宝,核心原因我想还在于这些沉淀下来的信源。
邪修一:魔镜魔镜,哪个卖方团队跟得最好
格林童话里,王后天天问墙上的魔镜:魔镜魔镜,谁是世界上最美的女人?
放到二级市场,可以改成:
进门进门,谁是卖方跟踪存储芯片行业最牛X的团队?
但如果你真直接这么问,你是问不出有价值的答案的,因为它不会给你排名,就算给,你也不敢信,所以你得换个问法。
我们经过很多次摸索,最终找到这么一个方法:
把语料库限定在「纪要」之上,研报、公众号、联网都关掉。
然后再去跟它对话。
核心原因在于,现在AI污染其实蛮严重的,媒体转述和二手文章混进来,谁先谁后就说不清了。
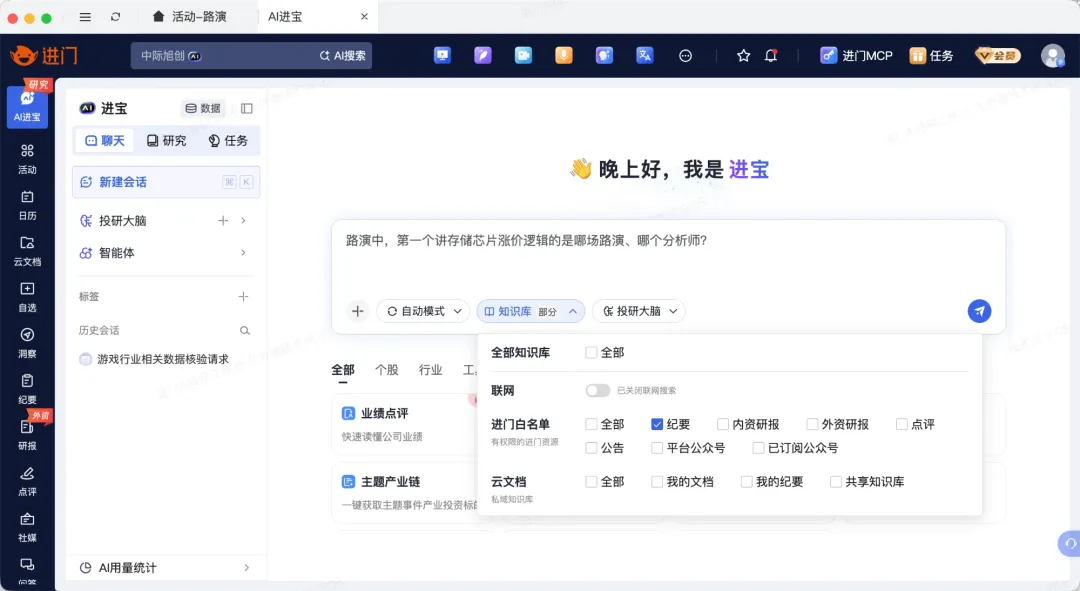
资料库只勾「纪要」,联网关闭 · 实测截图 2026-11-01
然后,别问“谁第一个讲涨价”(涨价每年都有人讲,问出来的多半是上一轮周期的路演),而是问拐点:
我的提问
只看 2024 年 9 月至 2025 年 6 月的路演纪要:按发布时间排序,列出最早判断「存储价格止跌、重新开始上涨」的 5 场路演,标明发布时间、机构、团队类型、标题和核心判断。
进门排出了最早的 5 场。前 3 场是同一个券商电子团队(国J证券),10 天里连讲 3 场:
· 2 月 24 日:高容量 DDR5、AI 服务器 SSD 已经结构性上涨,下半年会扩散到更多产品;
· 3 月 2 日:现货升温,二季度会再次进入上涨;
· 3 月 5 日:去年三季度开始的下跌要反转,NAND 二季度先涨,DRAM 三四季度跟上。
先说哪些产品已经在涨,再说哪个季度整体上涨,最后连 NAND 和 DRAM 谁先谁后都分开讲了。
第一个说的人可能是蒙的,10 天讲 3 场、一场比一场细的,才是真的在跟踪。
这个团队说得准不准,「邪修二」里我们还会拿价格数据核一遍。先说结论:3 月初,方向说对了。
再往前一步,把同一段时间里讲过存储价格的路演都排成一张表:
我的提问
只看 2024 年 7 月至 2025 年 3 月的路演纪要:按发布时间排序,列出前 10 场讲到存储芯片价格的路演,标明发布时间、机构、团队类型、标题,以及每场对存储价格的核心判断。
光 2024 年 7、8 两个月就有 10 场,判断五花八门:持续上涨、涨幅收窄、局部回升、品类分化、涨价放缓。
哪家观点的一致性强、跟踪的早,而哪家前后矛盾,能看得清清楚楚。
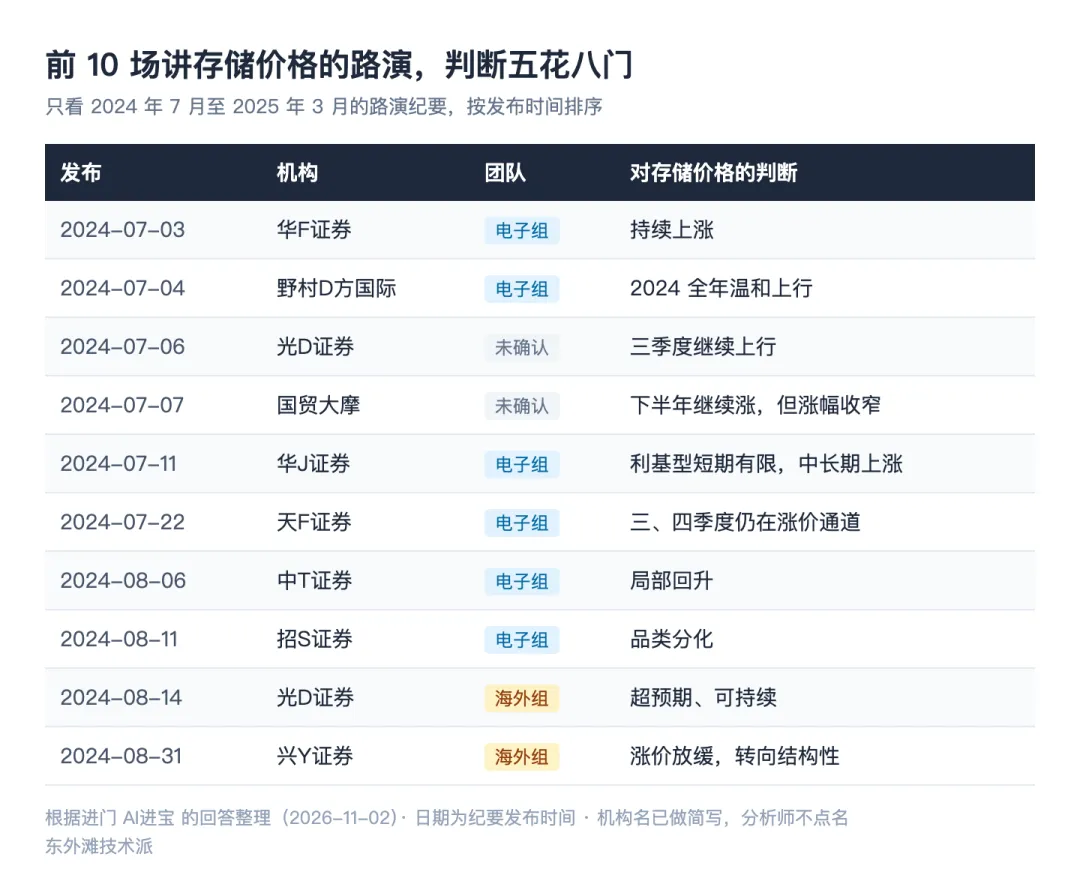
根据进门 AI进宝 的回答整理,机构名已做简写
众所周知,许多水货团队最爱贴的标签是“全市场首推”。
借助进门的语料库,就能找到真正踏实干活的卖方。关键是,它非常诚实。
我让它找最早讲这轮涨价的路演,它先给了一场 2024 年 8 月的;追问原文,它说库里只有纪要记录、没有能公开访问的原文,所以结论是“待原文核实的候选记录”。
其实,做买方的朋友们每天能听的路演就那么几场,以前听谁的,靠圈子里口口相传,或者靠XCF榜单。但榜单一年评一次,还掺着人情。现在大家可以自己查:
这个团队这几年讲过哪些判断,是一直在跟,还是行情来了才急着贴标签。
团队小伙光华楼套马汉说,还有一种隐藏用法……那就是……
卖方跳槽之前,拿同样的办法查查你要去的团队情况,也挺好使。
邪修二:自己当一个牛X的产业跟踪者
找到了值得跟的团队,自然要问一句:他们说得准不准?
要回答这个问题,就得自己拿数据去对。对完会发现,数据自己也会说话,有时候比分析师说得还早、还准。
前提是你知道怎么跟踪对的数据。
所以邪修二,是自己去盯产业数据。
切到研究模式,新建一个项目「存储涨价研究」,后面的数据、图、报告都存在这个文件夹里。
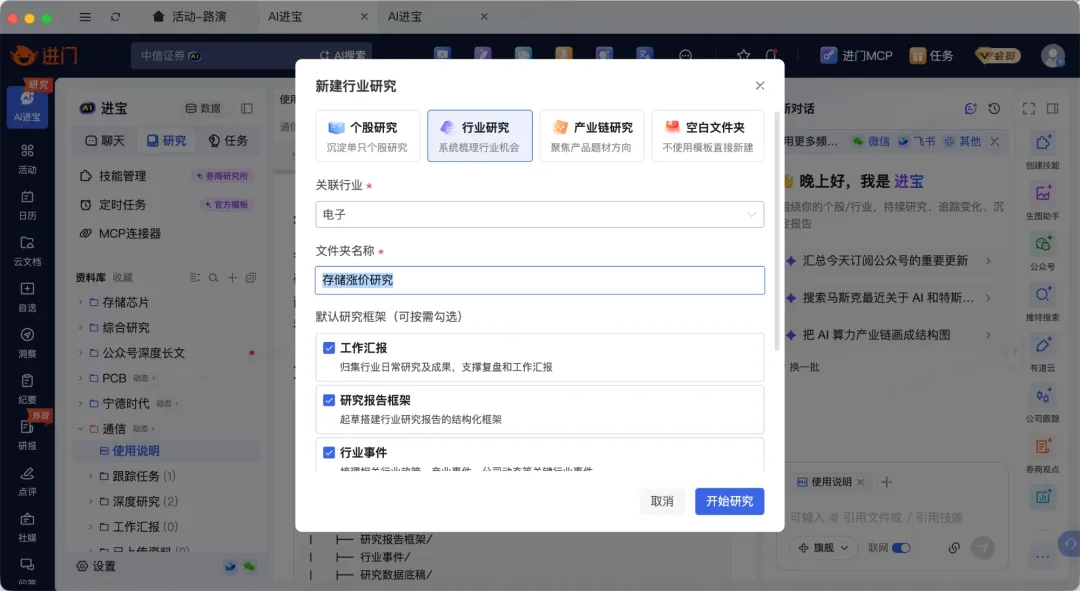
研究模式里新建项目,按行业建文件夹 · 实测截图 2026-11-02
我让它把 2024 年 9 月到 2025 年 12 月的存储价格做成月度 Excel,每个数标上来源。
它没有直接给出 Excel,而是先跟我说明了情况:现货价格只能往回找两个多月,表里 48 个格子只能填上 11 个;从头到尾都有数据的,只有合约价。合约价和现货价不是一回事,它不会自作主张替我换,而是问我用哪个。
选好之后,它做了很重要的一步:数据标注和回溯。表里每一个数,都用批注标了来源和观测日,哪个数从哪来,随时能点回去查。
接着,它还非常贴心的把上文提到的最早跟踪存储芯片涨价团队在 3 月 5 日的判断画进价格图里:
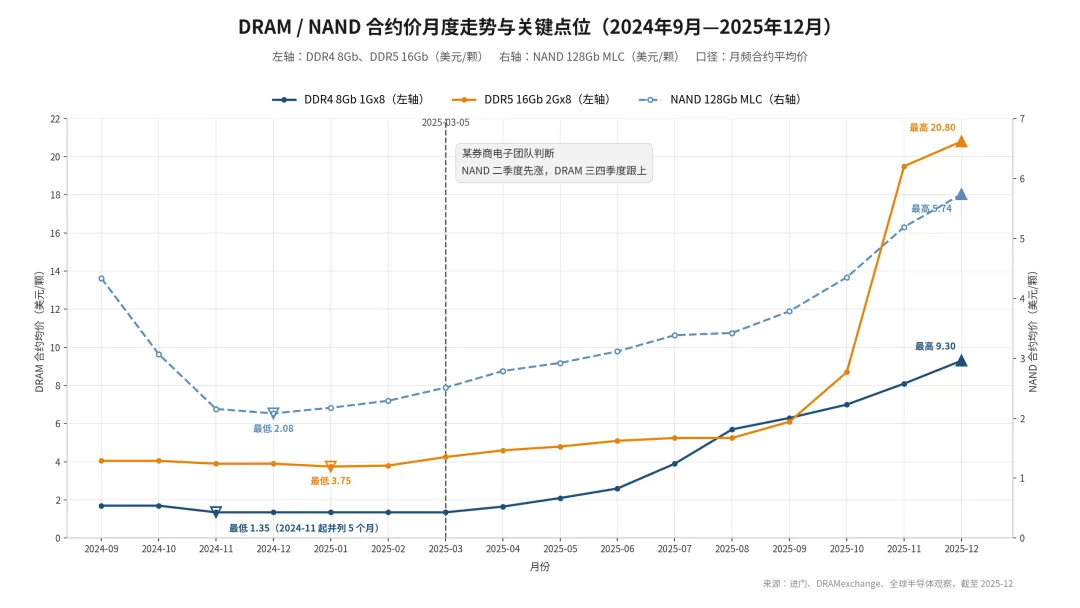
3 月 5 日那条竖线,就是那场路演 · 进门按 Excel 数值作图
国J证券电子团队的判断,方向说对了:DRAM 和 NAND 都在 2025 年反转向上,DRAM 涨得比 NAND 猛得多。节奏稍慢了一点,DDR4 二季度就涨了将近一倍,没等到三季度。那个卖方团队3 月初能把方向说对,已经很不容易。
检查到这儿还有个发现。
NAND 合约价 2024 年 12 月见底,2025 年 1 月均价已经回升了 4.6%,这个数 1 月底就能看到,比市场上最早的团队的第一场路演还早三周半左右。
所以,如果当时有像进门这样的金融AI Agent帮你持续跟踪数据,你看到拐点的时间会非常领先。
我让进门设了个定时任务:每天早上 8 点盯 DDR4、DDR5 和 512Gb TLC 晶圆三个现货价,任何一项变动超过 3%,就在报告开头标红。
第一天的报告,开头就标了红:512Gb TLC 晶圆现货一周跌了 9.19%,同期 DDR4、DDR5 基本没动。
定时任务一设,下一个拐点来的时候,你就遥遥领先了。
邪修三:在前两步的基础上,写一份有产业深度的报告
基于前面两步的一些成果(包括识别出值得关注的团队以及带出处的价格变化等等),我们还可以自己去尝试撰写一份给基金经理汇报的报告:
我的提问
基于这个项目里的资料,写一份存储行业深度报告,面向基金经理汇报用,结构参照券商行业深度报告,要有图表。
交出来的是一份 8 章的存储行业深度,8 张数据图,文末列了 18 家机构的报告名和日期,还导出了一份 Word。
挺震撼的,你们可以看一下第一版的效果……
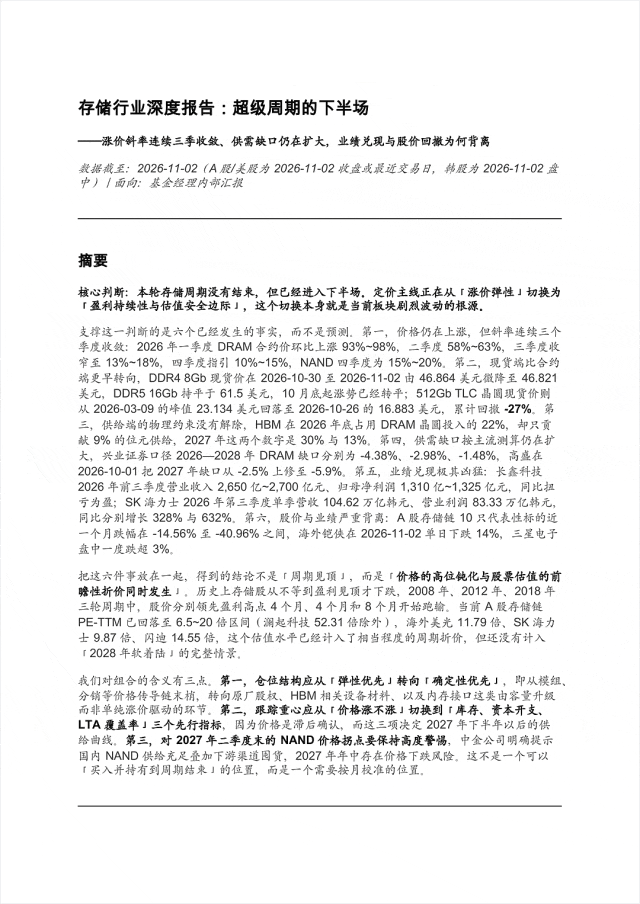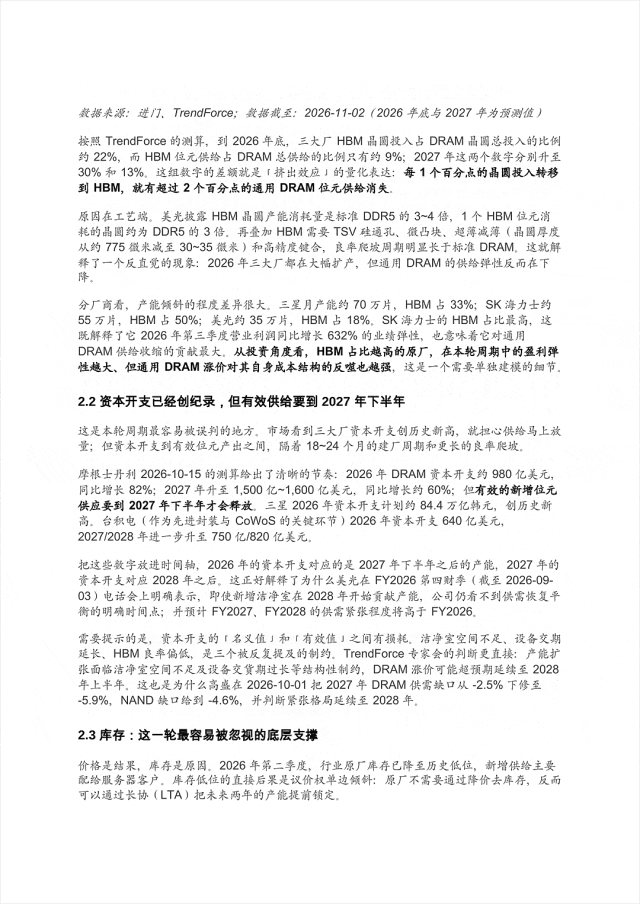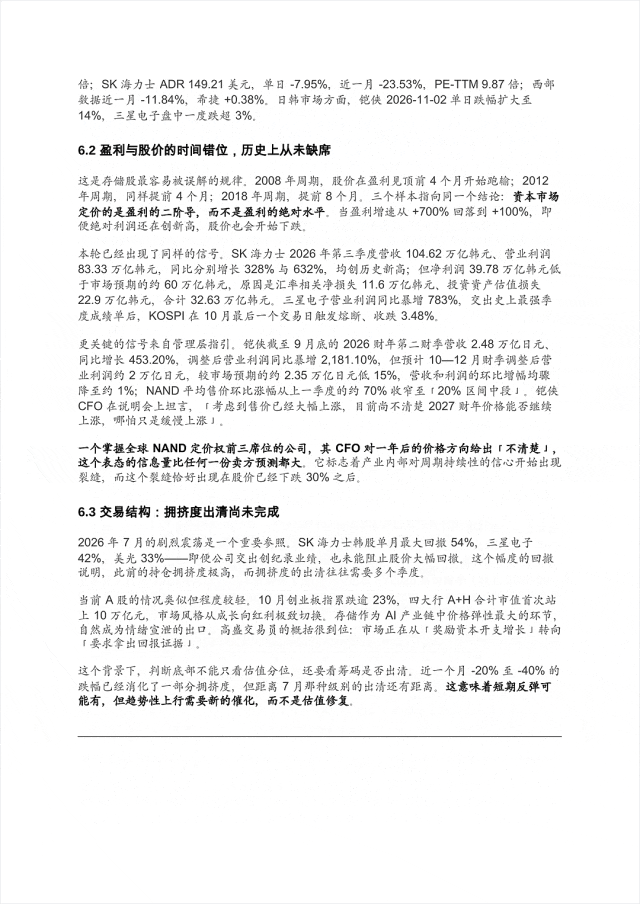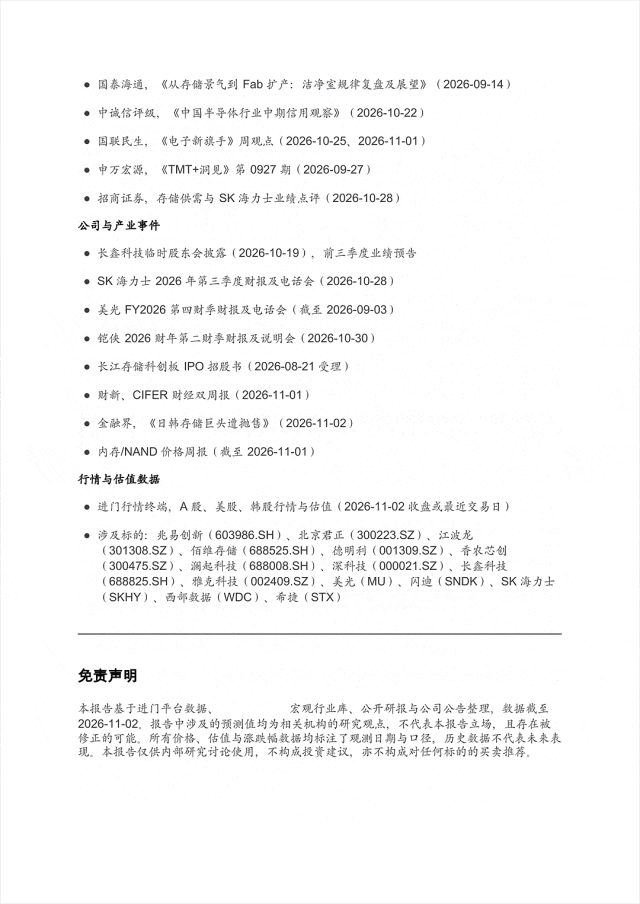
进门一句话生成的存储行业深度,Word 版共 17 页
前两步的东西它直接用上了:价格图用的是项目里那张 Excel,定时任务抓到的 -9.19%价格变动,被它放进了报告最后的跟踪清单。
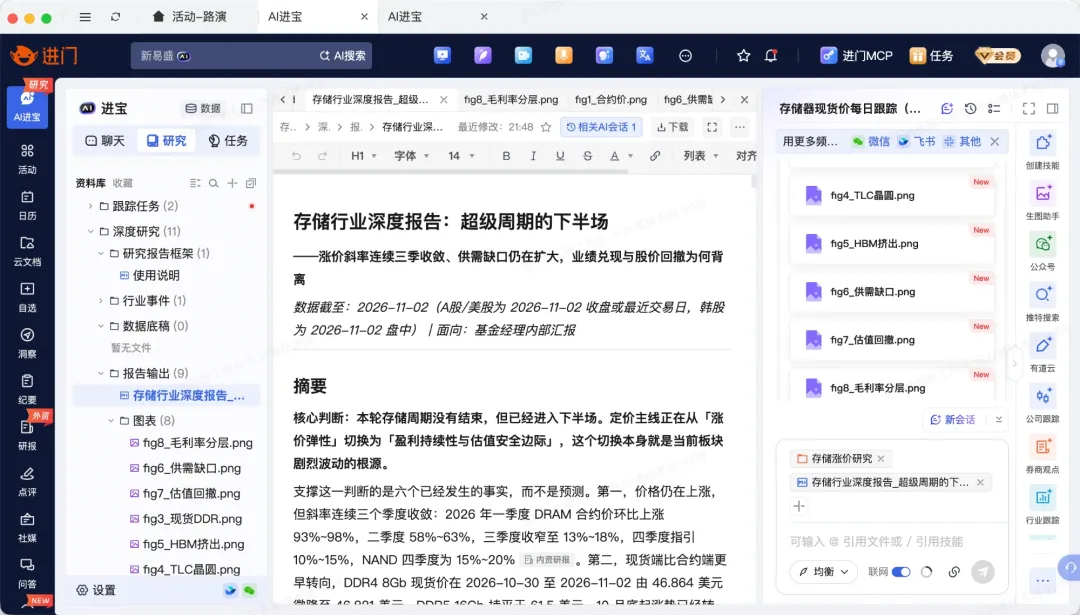
报告和 8 张图,都存在项目的「报告输出」文件夹 · 实测截图 2026-11-02
口径也交代得很清楚:哪些数在项目里有底稿,哪些来自外部研报、没法回溯,汇报前最该再核哪一个,都写明了。
作为对比,同一句话我也丢给了目前跑分最高的通用大模型。
框架很整齐,表格也多,但它自己写明估值没有用终端核对,A 股几只票的估值也是空着的,正如我们所说,还是语料库质量和可靠度的问题。
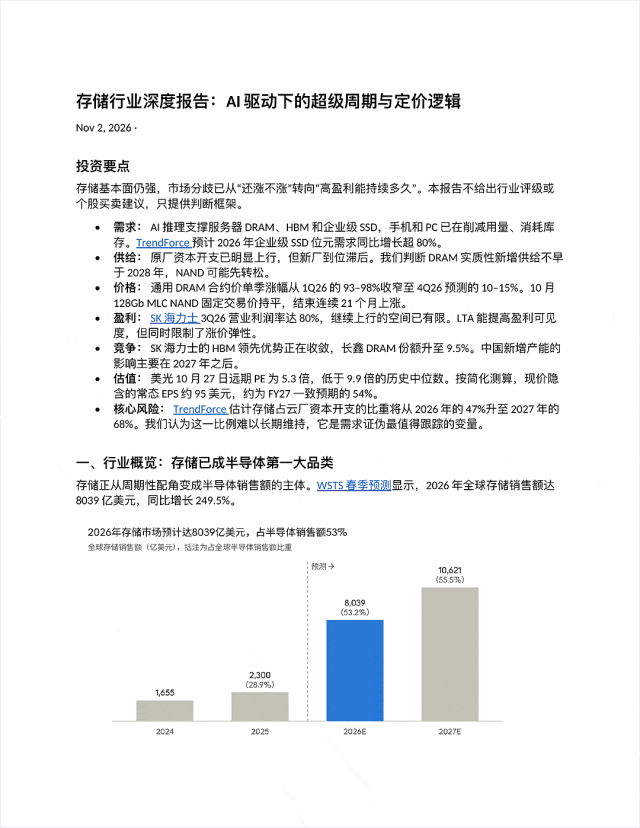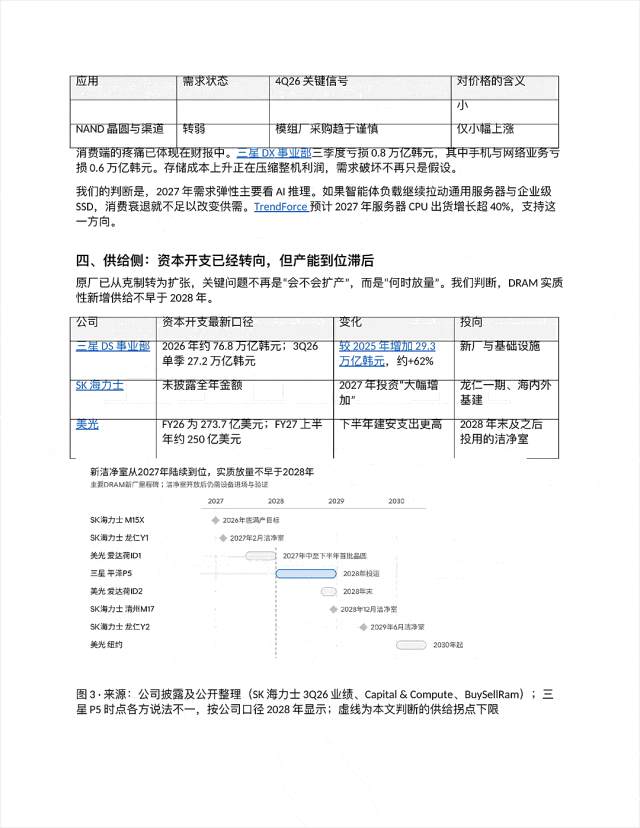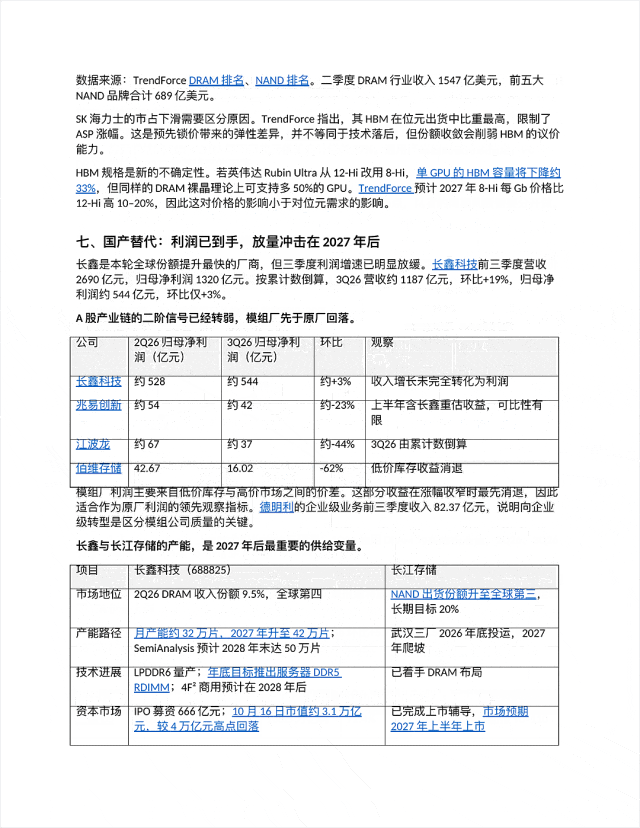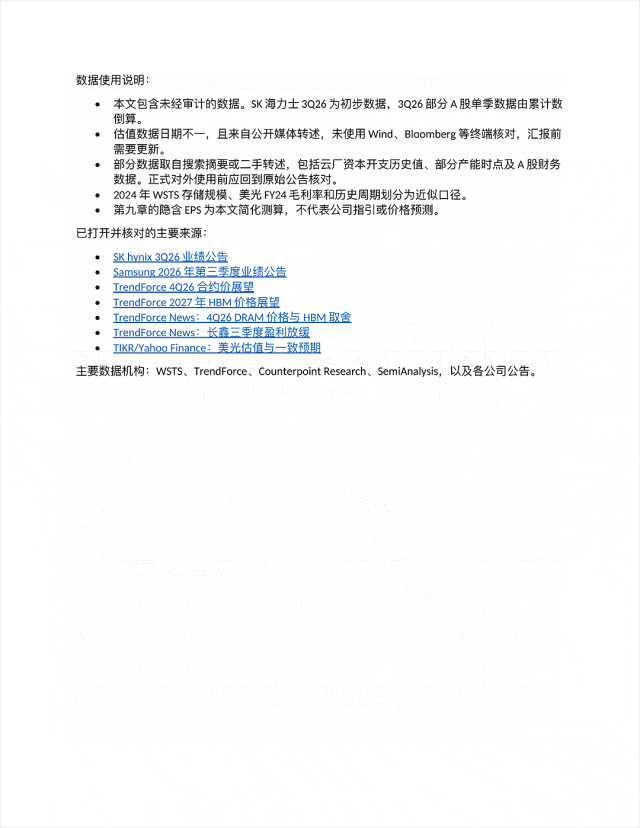
通用大模型用同一句话生成的报告,共 13 页
大模型搭框架,进门这样有高质量语料库的金融AI Agent填数、核数,可能还真的是当前的版本答案。
番外:一点省钱技巧
先说句实在的,token 烧起来还是挺贵的。拉数据、出图、写长报告,跑上几轮,账单就不太好看了。
以进门的AI进宝为例,有个很好的小tip,它的聊天模式不收费,研究模式按轮次计费。
邪修一全程是在聊天模式里跑的。日常核个数、查一下谁讲过什么,在聊天里问;要拉数据、出图、留底的,再开研究项目。
从业者现在用 AI 基本是自己掏钱,这个区别挺实在。
拿去玩儿吧。
最后贴一个免费的试用资格,众所周知,进门的会员资格是比较稀缺的。我们还是觉得需要给金融业的从业者们一个试用的机会。
名额并不多,大家随缘点击,先到先得了。
我多啰嗦一句,workbuddy还有豆包这几家通用Agent,也接入了它的MCP数据与工具了,所以你只是把进门当一个语料库来用,也有必要搞一个账号。
有需要但是公司还没给你们买账号的,别错过:
https://mobile.comein.cn/mobile/invite-activity-accept-page?ref=1db41109b50a48d7