研报速递
物理 AI 深度研究报告 · 上篇|物理 AI 的原理与平台
| ▍第 01 章 原理 |
「物理 AI」主要是 NVIDIA 从 2024 年起推起来的说法。2026 年 1 月 CES,黄仁勋补了一句更有传播力的话——物理 AI 的 ChatGPT 时刻已经到来。
| 是 | |||
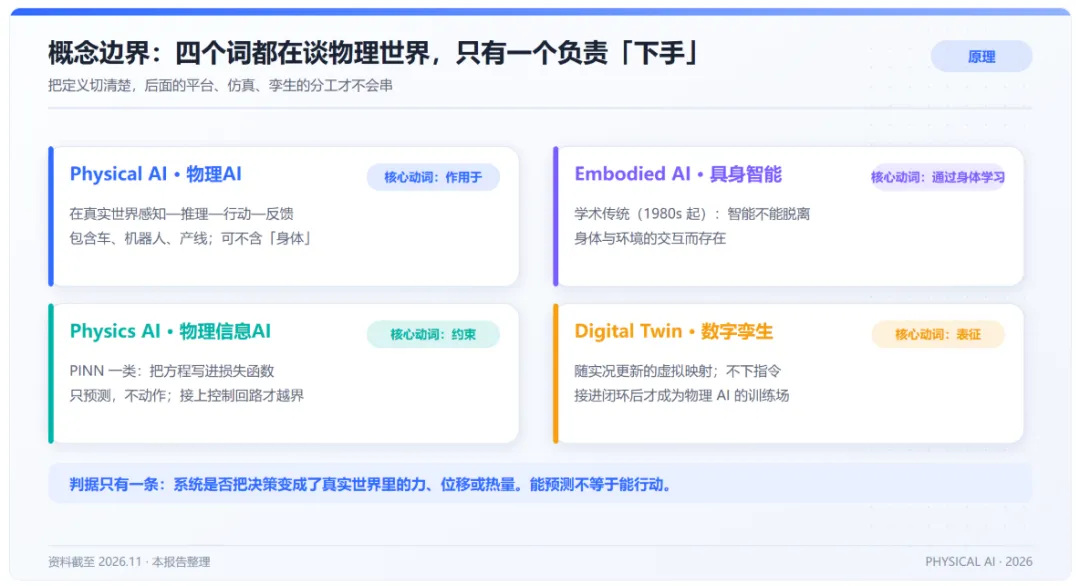
图 1-1 概念边界:四个词都在谈物理世界,只有一个负责「下手」
资料来源:本报告整理;参考 Towards Data Science《Physical AI: What It Is and What It Is Not》、NVIDIA 官方定义
▍1.2 这个词是谁造的,为什么偏偏是 2024 年
把时间轴拉长,这个词不新。1980 年代具身认知提出智能不能脱离身体与环境;1991 年 Brooks 写《Intelligence Without Representation》;1999 年 Pfeifer 与 Scheier 把形态算进智能;2018 年 Ha 与 Schmidhuber 让智能体在自己的梦境里学开车。学术侧一直叫 Embodied AI,没换过名字。
换名字发生在产业侧。2024 年起 NVIDIA 密集使用 Physical AI;2025 年 3 月 GTC 给出感知—生成—代理—物理四段论;下半年链博会补了系统定义。中国政策文本走另一条线:2023 年工信部《人形机器人创新发展指导意见》,2025、2026 年具身智能连续两年写入政府工作报告,「十五五」规划纲要列为未来产业。
造词的动机值得摆到台面上,CES 2026 那套「三台计算机」——训练、仿真、推理——正好对应三条产品线:DGX 集群、Omniverse/Isaac 软件栈、Jetson 边缘模块。一个能同时装下芯片、软件订阅和开发者平台的伞形概念,比谈「机器人」好用得多。说自己不造本体,200 万台存量工业机器人的虚拟调试、整车厂的仿真验证、人形机器人的训练,就都能进同一份叙事里。「每家工业公司都会成为机器人公司」这句话出现在新闻稿…
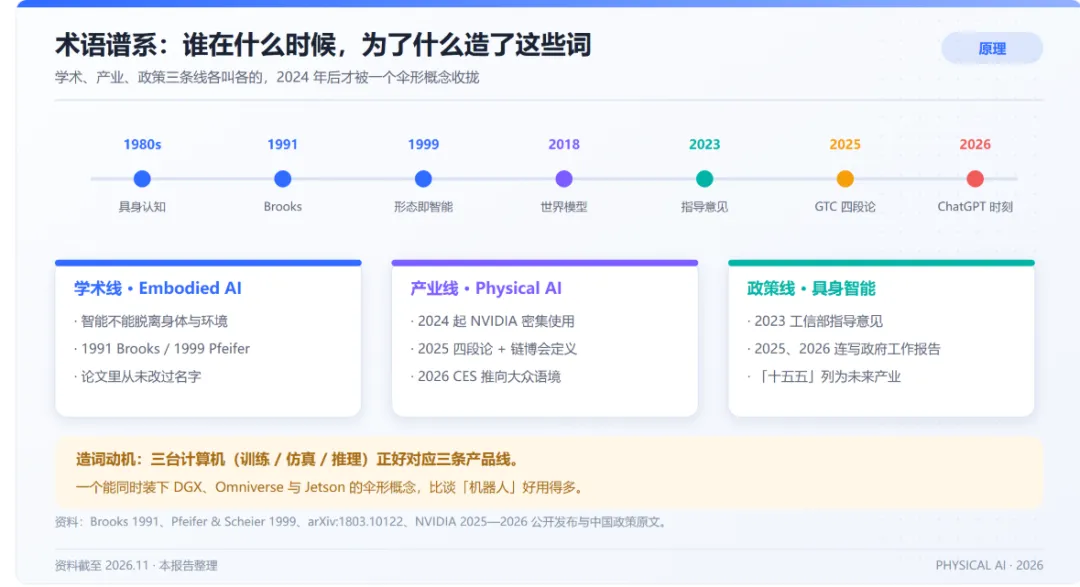
图 1-2 术语谱系:谁在什么时候,为了什么造了这些词
资料来源:本报告整理;依据 Brooks 1991、Pfeifer & Scheier 1999、arXiv:1803.10122、NVIDIA 2025—2026 公开发布与中国政策原文
▍1.3 第一性原理:闭环、三台计算机、一个评估难题
物理 AI 的最小单元是「感知—推理—行动—反馈」闭环。前两步生成式 AI 已经做过,难的是后两步:动作会改变环境,环境改变后下一次感知的输入就变了。开环预测断了这条因果链,静态数据集里学不到「我一脚油门下去,旁边那辆车会怎么躲」。
CES 2026 上黄仁勋给了一个挺实在的框架:需要三台计算机。一台训练,一台推理(车里、机器人里、边缘),还有一台专门做仿真。第三台不是为了画面好看,是为了回答「如果我这样做,世界会怎么反应」——没有它,就没法评估一个动作对不对。他举的例子很朴素:重卡滚下坡要更久才停,球会继续滚,这些常识小孩都懂,模型不懂。
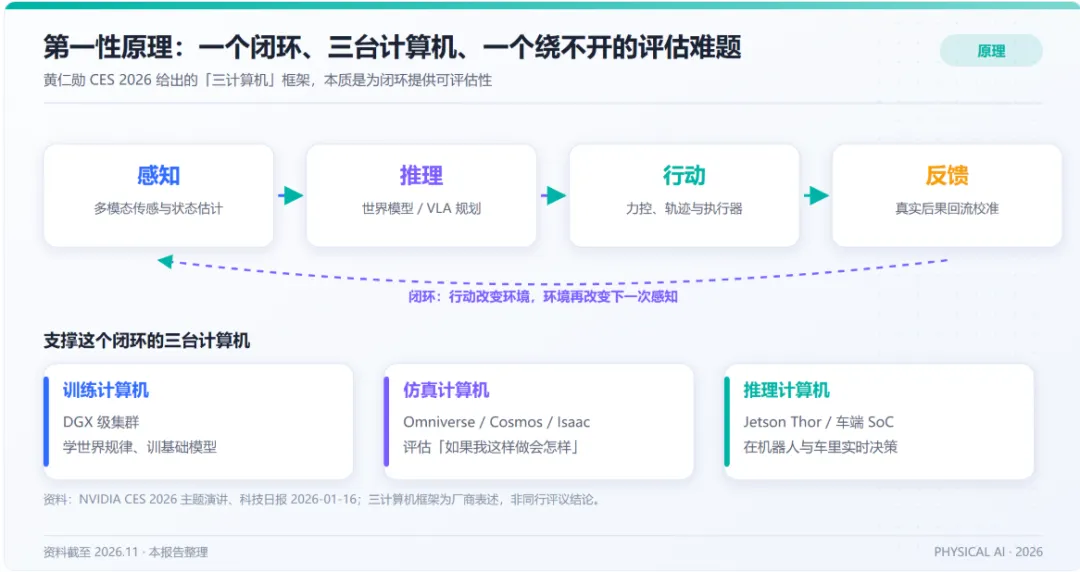
图 1-3 一个闭环、三台计算机,以及绕不开的评估难题
资料来源:资料:NVIDIA CES 2026 主题演讲、科技日报 2026-01-16;三计算机为厂商框架
把闭环写成方程,就是带接触的拉格朗日动力学:M(q)q̈ + C(q,q̇)q̇ + g(q) = τ + J_c(q)ᵀλ_c。左边是惯量、科氏力、重力,右边是关节力矩与接触反力。难点全在 λ_c:接触是 discontinuous 的,摩擦锥、柔性体、间隙、执行器死区,任何一项简化过头,策略一上真机就崩。可微仿真想做的,正是把 ∂L/∂(m, μ, b) 算出来,用真机遥测反解质量、摩擦、阻尼。
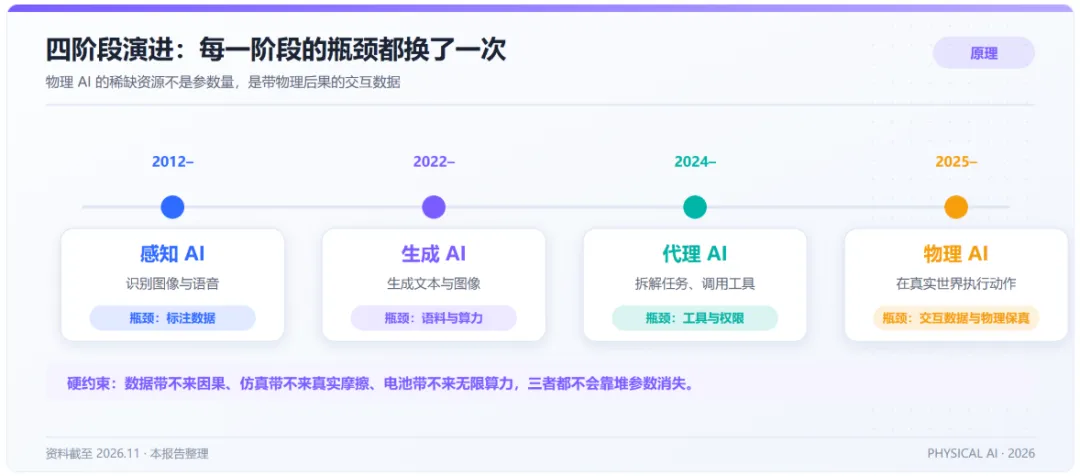
图 1-4 四阶段演进:每一阶段的瓶颈都换了一次
资料来源:本报告整理;阶段划分依据 NVIDIA GTC 2025 / CES 2026 公开表述
▍1.4 相邻范式各自负责什么
世界模型预测下一状态,VLA 把图像与指令翻成动作,数字孪生表征真实资产,PINN 给预测加物理约束。它们都是组件;把组件接进动作回路,才轮到物理 AI 这个整体。
| ▍第 02 章 平台 |
| 平台的终局不是谁的模型分数高,是谁定义了「什么算训练完成、什么算验证通过」。 定义了标准的人,连铲子和秤一起卖。 |
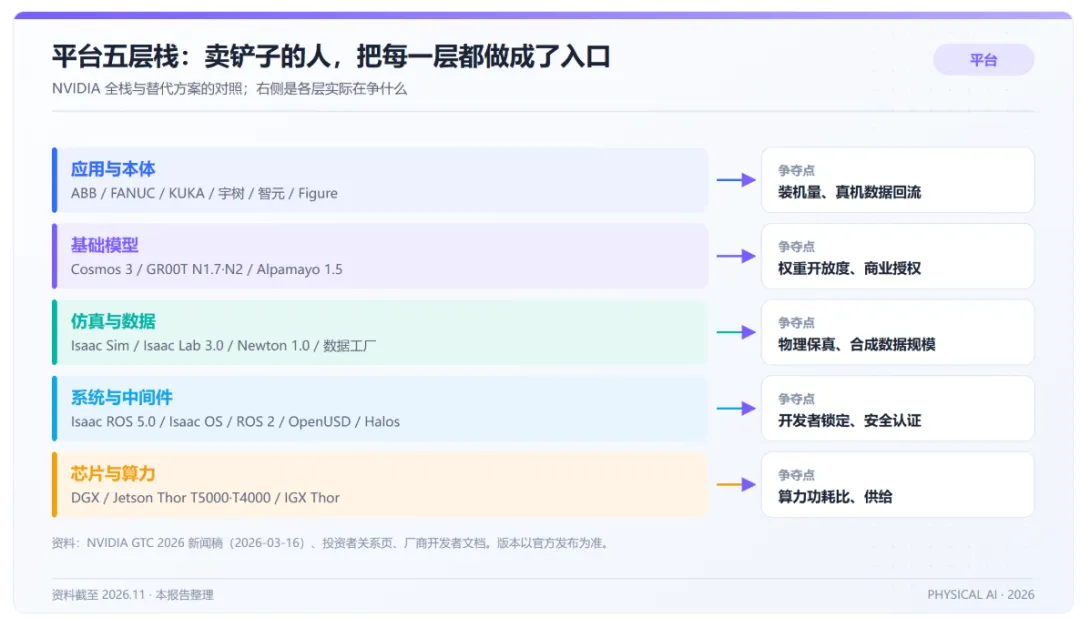
图 2-1 平台五层栈:卖铲子的人把每一层都做成了入口
资料来源:资料:NVIDIA GTC 2026 新闻稿、投资者关系页、开发者文档
▍2.1 GTC 2026 到底发了什么:把状态看清楚
2026 年 3 月 16 日 NVIDIA 投资者关系页那篇新闻稿,信息密度比所有二手解读都高。Cosmos 3 被称作首个把合成世界生成、视觉推理与动作模拟合在一起的世界基础模型;Isaac Lab 3.0 早期访问,建在 Newton 1.0 物理引擎与 PhysX SDK 上;GR00T N1.7 开放早期访问并带商业许可;GR00T N2 只是预告,基于 DreamZero 的世界动作模型架构,称在新任务新环境上的成功率是领先 VLA 的两倍以上,年底才可用,目前在 MolmoSpaces 与 RoboArena 排第一。
Cosmos 3 的「3 月发布」与「6 月开放权重」两处日期并存,本报告按两个事件分别记录,不替厂商调和。
▍2.2 两套「安卓剧本」,一条闭源路线
NVIDIA 不造机器人,靠开放基础模型 + 仿真平台聚开发者,再卖芯片与算力;Google 的打法更像当年的 Android——2026 年 ROSCon 上把 Intrinsic Core 以 Apache 2.0 开源,覆盖控制、运动规划、抓取、仿真、位姿估计与相机标定,而 Gemini Robotics 大脑保持闭源。开放基础软件层、闭源高价值组件,这个组合熟不熟悉?
另一头是垂直整合:Tesla 用 FSD 同源的视觉与决策架构做 Optimus,完全自用;Figure 靠 Figure 03 在 BMW 工厂里的部署拿真机数据,Helix 不对外授权,靠整机挣钱;1X 用遥操作采家庭数据,NEO 2 万美元起加订阅。国内又是第三种形态——本体厂自己建大模型团队,智元有 GO 系列和 AgiBot World 开源数据集,宇树开源 UnifoLM-VLA-0,银河通用做 GraspVLA 加百亿级合成数据基建。原因不复杂:整机卖得出去,数据就回得来。
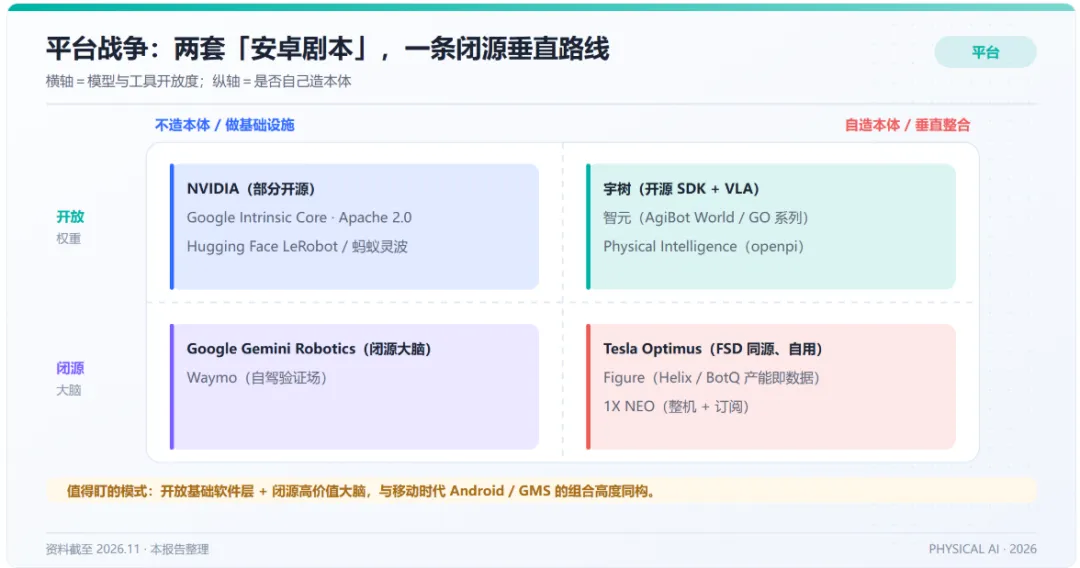
图 2-2 平台战争:两套安卓剧本,一条闭源垂直路线
资料来源:本报告整理;资料:NVIDIA/Google/各厂商公开发布与开源仓库
▍2.3 真瓶颈:数据按小时计价,仿真按 GPU 小时计价
2026 年上半年,国内 15 家独立数据服务商一年融资约 44.7 亿元,报价带大致是一般数据 200–500 元/小时、真机数据 500–1000 元/小时。智元给 2026 年定的累计目标是 1000 万小时,其中真机 200–300 万小时。这些数字放在一起看,就能理解为什么「物理 AI 数据工厂」成了 GTC 上最不起眼却最要紧的发布。
还有个容易被忽略的制度变量:YD/T 6770—2026《具身智能基准测试方法》2026 年 6 月实施;《人工智能 关键基础技术 具身智能数据集质量要求及评价方法》2026 年 7 月批准,2026 年 11 月 1 日实施。数据开始有质量标准了,报价方式也会跟着变。
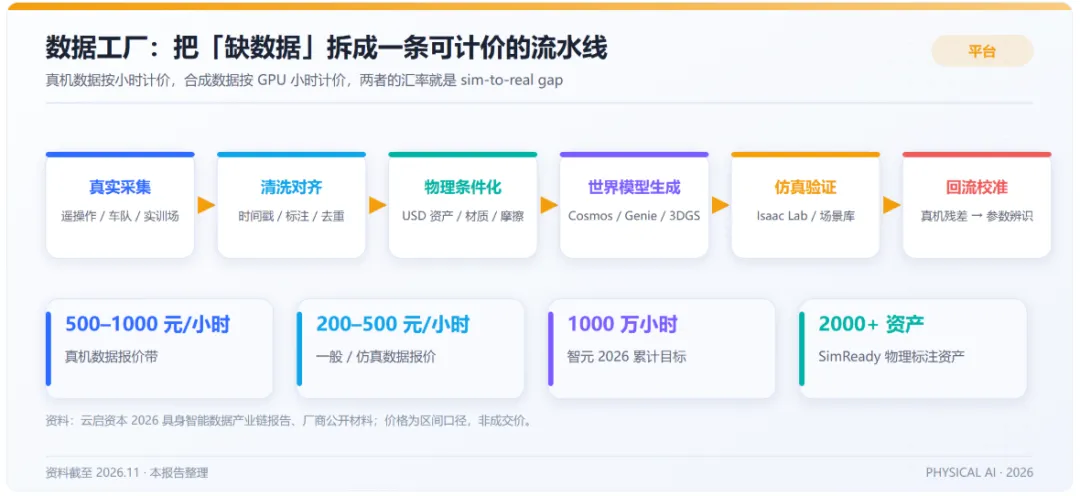
图 2-3 数据工厂:把「缺数据」拆成一条可计价的流水线
资料来源:资料:云启资本 2026 报告、NVIDIA 数据工厂蓝图、厂商公开材料;价格为区间口径
平台壁垒不在模型,在证据链。谁能把一次仿真跑动变成监管与保险都认的归档材料,谁就拿到了下一阶段的定价权。 |
风险 世界模型这类注意力密集的骨干,在 CUDA 与昇腾 NPU 之间的算子覆盖并不一致。做出口项目或国产化替代时,portability 风险要写进立项评估,别等迁移时才发现重训成本。 |
▍2.4 发布 ≠ 可用:把状态词当成工程参数读
一份 GTC 新闻稿里,预告、早期访问、商业授权、已出货四种状态常常挤在同几段话中。判断依据不是形容词,是能不能查到版本号、授权文本、发布说明和第三方可复现记录。
立项书里每写一个模型名,后面跟一个状态编号和核验日期。GR00T N2 在 2026 年 11 月仍属预告,写进今年的量产计划就是拿路线图当物料。
这类基础设施的迭代节奏已经比应用层快。Newton 每两三周一个版本,Isaac Lab 3.0 处在 0.3.x 系列。写进报告或合同的结论,都要能回答「当时用的是哪一版」;完整冻结清单见附录 F。
◆ ◆ ◆
▍补充:把发布会能力拆成五道可部署纬度
行业专家不会先问‘谁的模型最好’,而会先问:这项能力处于预告、可下载、可复现、可商用还是可维护状态?同一个产品名只要版本、许可证、硬件或运行时变了,结论就应重新评估。
因此,平台选型的核心指标应从‘模型分数’改为‘每个通过验证任务的综合成本’:数据采集、GPU 小时、工程集成、端侧能耗、失败返工、许可和长期维护全部入账。能跑通一次 Demo 只是技术事实;能被另一团队复现、能合法交付、能在故障后回滚,才是平台能力。
▍本篇结论
| 1 | |
| 2 | |
| 3 |
▍展望:平台护城河将从权重转向可验证的系统能力
未来一到两年,基础模型能力仍会快速靠拢,但平台差异会更多体现在数据闭环速度、仿真—真机一致性、跨硬件部署和安全证据生成。如果开放资产格式、日志格式和评测协议成熟,单一厂商锁定会减弱;如果接口继续碎片化,全栈平台会以更高迁移成本换取更快落地。真正应追踪的不是发布数量,而是第三方复现率、量产版本占比和单位验证任务成本。
预期差 · 下一篇预告 下一篇将进入物理 AI 最容易被‘画面真实’误导的部分:仿真、数字孪生与感知。重点解释 sim-to-real 缝如何拆成可测指标、孪生本身怎样接受 VVUQ,以及多模态系统为什么首先败在时间轴而不是模型结构。 |
▍本篇数据源与核验入口
以下只列本篇实际使用的原始论文、开放代码、标准/法规或官方入口。厂商规格属于来源自报,市场口径属于公开披露;链接可定位原文,不等于本报告已完成真机复现。标准适用性仍应由有资质机构依据正式文本判定。