研报速递
你有没有过这种时刻。花了一下午跟AI来回掰扯,它给出的答案漂亮、条理清楚、挑不出毛病,你却不敢直接拿去用。
因为它不知道这张单子要谁签字,不知道客户A的账期和别家不一样,不知道上个月那条规则刚刚改过。
最后你还是自己动手,把那些没写进对话框里的规矩,一条条补上。
换个更强的模型,好像也没好到哪去。
甲子光年智库10月发的《2026 Agent商业化与竞争研究报告》,副标题叫让智能进入工作流。
同一批任务,只让Agent直接访问原始数据,405次里成了1次。把业务上下文补进去,成了333次。
嗯。
中间差的那些,跟模型参数没什么关系。
所以根据这份报告,我梳理了5个变化。
模型决定Agent能不能做,业务上下文决定它做出来的东西算不算数。
01 从「回答得对」,到「活干完了」
验收标准换了,账本也跟着换
过去我们跟AI打交道,问一句,答一句,答案有没有用,扫一眼就知道。Copilot这一层往前挪了半步,人给指令,AI操作,中间的衔接还得人自己接着。
现在Agent接手的是一整段工作。人把目标、边界和授权交代清楚,系统在范围里持续推进,人最后验收结果。
报告把这条线画得很清楚。Chatbot那会儿看答案能不能用,任务型Agent看步骤做完没有,助理型Agent看后续那摊事有没有人管。
你看,主语变了。评价的对象从一句话,变成了一段时间的业务状态。
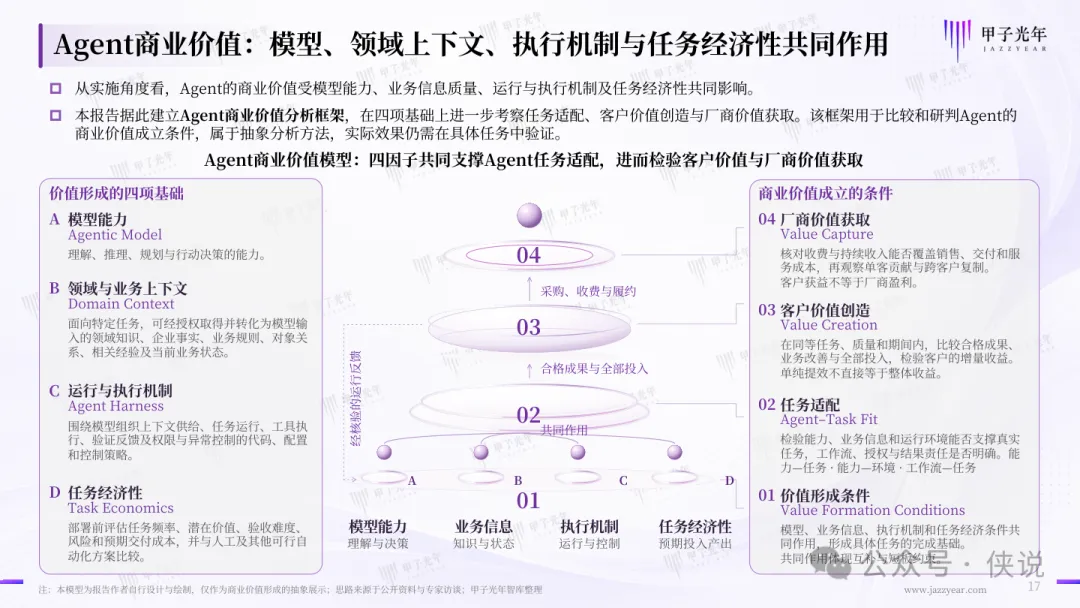
四因子共同支撑商业价值,模型能力只占最底下一层
这也解释了报告里那个有点反直觉的数据。微软的调研里,58% 的Agent使用者说,自己能产出一年前无法胜任的工作。微软另一份工作报告拆得更细,AI使用里 49% 是分析推理与决策,19% 是与人协作,17% 是工作产出,15% 是信息获取。
人并没有从流程里消失,只是站到了更靠后的位置。
还有一组值得停下来看的对照。麦肯锡调研里,年营收10亿美元以上的企业,40% 表示AI Agent应用至少进入了规模化阶段,比2025年提高 13个百分点。年营收低于10亿美元的企业,这个数字从21%挪到22%,几乎没动。
OpenAI的用户数据更直白,前沿企业和一般企业的Token输出量差距,从2026年2月的 2.6倍,拉到6月的 8.3倍。
当AI开始交付成果,评价标准就从「说得像不像」,变成了「做没做完」。
技术上大家都能试,能不能试出结果,开始拉开距离了。
02 0.25%到82.22%,隔着一套没写下来的规矩
四因子里,最容易被跳过的那一层
报告给了一个四因子的框架。模型能力、领域与业务上下文、运行与执行机制、任务经济性,四样一起决定Agent跟具体任务合不合得来。
模型能力管能不能做,执行机制管能不能稳定做成。业务上下文让Agent听懂具体业务,任务经济性回答这件事值不值。
第四样先按下不表,第二样最容易被忽略。因为它是唯一买不到的。
CData做过一组合成任务实验。让Agent只能访问原始数据,405次任务成功1次,成功率 0.25%。给同一批任务补上业务上下文,成功333次,82.22%。工具调用次数还普遍降下来了。
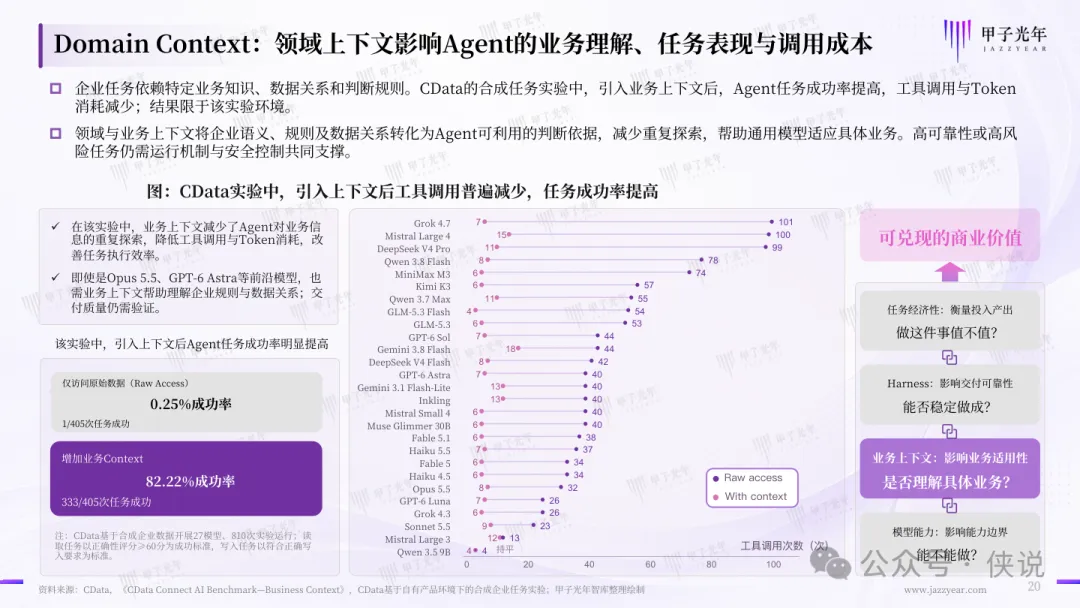
同一批任务,补进业务上下文后成功率从0.25%升到82.22%
有意思的地方在于,实验里连Opus 5.5、GPT-6 Astra这类前沿模型,也需要业务规则和数据关系来帮忙理解企业语义。
这份报告之外也能找到旁证。今年10月CSDI峰会的技术分享里,腾讯给过一组数,补入业务知识后,SQL准确率从50%提到95%。同一个模型,喂进去的东西变了,结果就变了。
为什么会这样?
模型学到的是通用世界的规律。你公司里那套「一直都是这么办的」,从来没进过训练集。哪个字段以哪个系统为准,什么情况必须人工复核,哪类客户不能自动放行,这些东西散在老员工的记忆里、历史单据里、几个互相对不上的表格里。Agent看不到,就只能猜。
AI把「做」变便宜了,却把「说清楚要做什么」变贵了。
报告反复提醒一件事,Demo里跑得再漂亮,也得在真实业务里重新验一遍。这句话我读了好几遍。
03 同一个模型,换一套执行机制,账单能差一半
Harness开始变成能单独采购的东西
模型之外,报告花了不少篇幅讲一个词,Harness。它管的是任务编排、工具调用、状态管理、失败恢复。
同一模型在不同Harness下,任务表现和平均调用成本能差出一大截。报告里的散点图铺了一整页,从40%到60%的平均分数,从0.2美元到10美元的单任务成本,同一个模型换一套编排,位置就挪了。
横轴是单任务平均调用成本,纵轴是平均分数,同模型换Harness位置就变
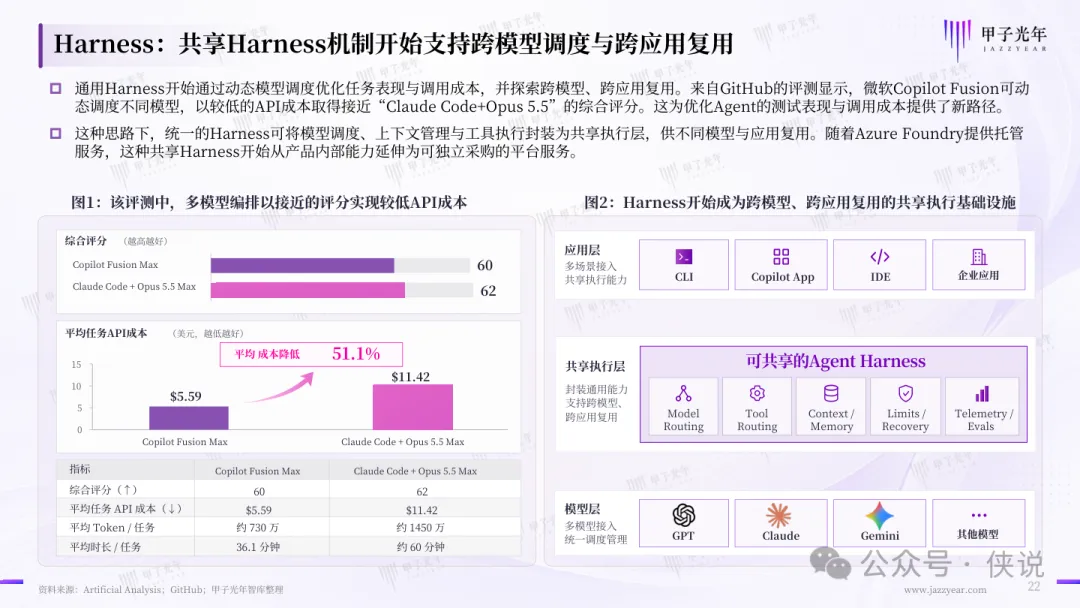
再看GitHub的一组评测。微软Copilot Fusion动态调度不同模型,综合评分 60,Claude Code加Opus 5.5是 62,差2分。平均任务API成本呢,5.59美元 对 11.42美元,降了 51.1%。平均Token用量约730万对约1450万,平均时长36.1分钟对约60分钟。
你别说,这个对比挺狠的。
两分的性能差,换来一半的账单和四成的时间。企业采购时真正该问的,慢慢从「用哪家模型」挪到「谁来编排、状态存在哪、断了怎么恢复、失败算谁的」。
报告把这个趋势说得更远了一点。共享Harness开始从产品内部能力,变成能独立采购的平台服务,应用层、执行层、模型层被拆开,模型成了可替换的组件。
跑分是模型的分数,账单是系统的分数。
模型可以换,系统得自己搭。这句话对做技术选型的人,可能比任何榜单都实用。
04 省下来的时间,未必能进利润表
水面下的成本,比Token大得多
聊Agent成本,大家第一反应都是Token单价。报告拆了一家银行场景的年度总成本,这条直觉就站不住了。
变动成本占 70%到75%,固定成本占 25%到30%。变动成本里,人工监督占 70%到75%,大模型Token只占 20%到25%,AI基础设施3%到4%,API与附加服务2%到3%。固定成本里,Agent编排一项就占 95%到98%。
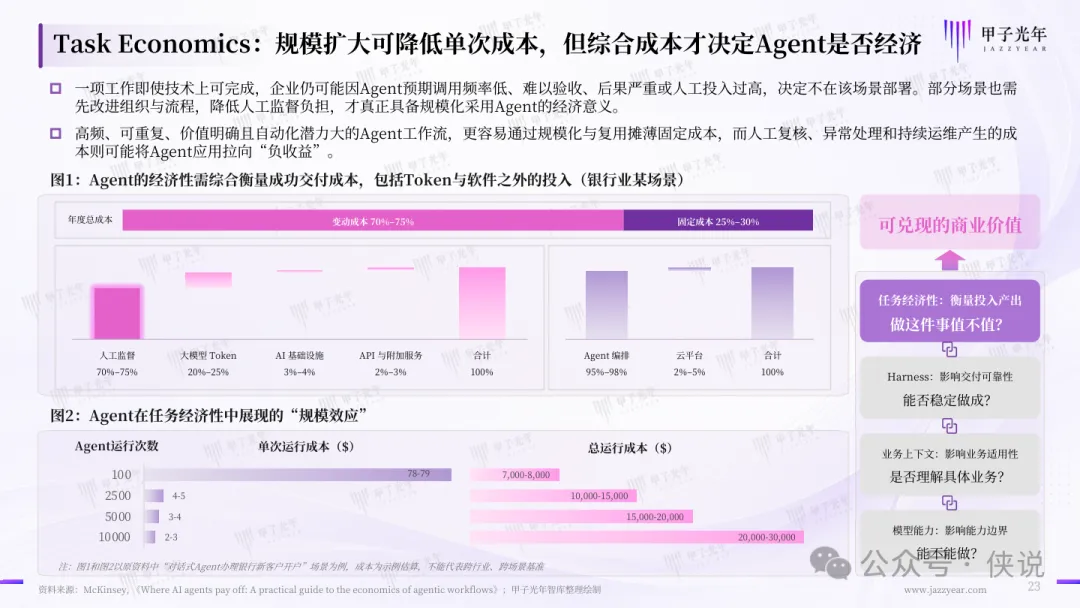
人工监督是最大一笔,Token只是水面上的部分
同一页还有一组规模效应的数字,我看了两遍。
单次成本降到了零头,总账单翻了几倍。
规模化从来不会自动变便宜,它只是把便宜摊到了更多次任务上。
人工复核、异常处理、持续运维还在那儿。报告第24页列了七类投入,水面上是Token与API、订阅许可、平台基础设施,水面下是治理合规、组织变革、失败恢复,甚至还有未来可能的AI税费。
BCG的调研补了另一个角度。企业AI总投入占3.3%,其中IT预算内只有 0.5%,IT预算外是 2.8%,后者是前者的 5.6倍。钱流向了内部运营、AI平台、产品、数据、人才和治理。
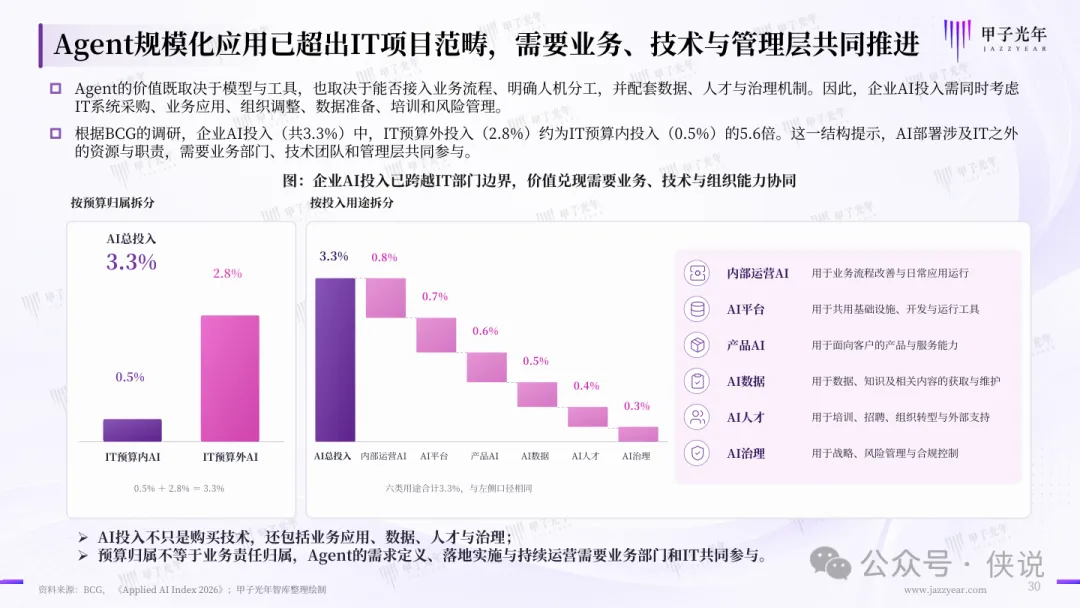
IT预算外投入是预算内的5.6倍,Agent早就不只是IT项目
案例也能对上。洞隐科技给物流企业做的POD回单审核Agent,自动通过率 +80%,误判率 ≤0.1‰,人均日审单量 5倍。它背后是14节点工作流和11个可插拔Skill,把识别、按客户规则核验、人工复核、结果回写拆开,异常或低置信度的单子转人工。
真正起作用的,是那套被整理出来的验收规则。
省下来的工时,只有在有人重新安排它的时候,才变成钱。
05 下半场比的是,能不能把经验复制到下一个客户
客户赚到钱,和厂商收到钱,是两笔账
报告的Part 05把竞争拆成三层。最底下是模型能力,中间是业务上下文与执行机制,最上面是客户触达、信任与任务经济性。
一句话,模型能力正在变成基础条件,优势更多来自上面两层能不能协同。
第46页给了个预期。Agentic AI在AI价值中的份额,2025年 17%,2026年 22%,2030年预期 39%。同一页又把预期往下压了压,先进企业组约 91% 已把试点投入实际运营或进入完全运营,落后企业组 64% 还停在建设基础能力或初步试点。
图纸上的增长,跟已经落袋的收益,是两码事。
供给端也在分岔。平台化、产品化、服务化三条路并行,前两条对应能标准化交付的任务,后一条留给业务规则复杂、需要贴身适配的现场。
博云的案例很有代表性。给一家消费电子制造企业做的BoAgent,需求预测与订单排程从 2小时以上压到8到10分钟,电子制程异常分析从 55分钟压到5分钟,采购配额优化从 3人30分钟压到5分钟。项目沉淀了 1000多个可调用Skill,落地数十个场景,覆盖上千岗位。
蓝凌智能给某物业集团做的更直观,营销环账审批节点从 15个压到2个,智能填单从20分钟到1分钟,累计处理工单超20万条,高风险申请漏检率归零。
你看,这几家公司卖出去的,都是能把一个项目的流程资产搬到下一个项目的能力。
能被复制的,是被整理成规则、权限和验收线的业务本身。模型谁都买得到。
报告里还有个挺冷静的区分,客户觉得值是一回事,厂商把这份值收成收入是另一回事。中间隔着采购预算、交付成本和复用能力。
最后的话
报告通篇在教企业怎么把Agent放进流程,有个前提一笔带过了。业务上下文得先存在。
可多数公司里,它并不存在。它散在几个人的脑子里,散在三个对不上的字段里,散在「一直都是这么办的」这句话里。
Agent填补不了组织记忆,它会把这个缺口按次计费。
模型和Harness都能从外面买,评测集也能外包,唯独业务口径得企业自己交代清楚。交代清楚这件事,恰恰是过去最没人愿意领的活,没预算、没负责人、没交付日期。BCG那组数字摆在那儿,IT预算内只占0.5%,剩下2.8%全在预算外,花在流程、数据、人才和治理上。
于是买Agent变成了一次被迫的组织盘点。盘得清的公司,把规则沉淀成Skill,越用越省。盘不清的公司,每上一个新场景都要重新问一遍我们到底是怎么干的,钱花在反复解释上,试点就一直停在演示里。
先进企业91%进了实际运营,落后企业64%还在起步,差的大概也不是选型眼光。
机器已经坐进工位了。那份说明书,还散在几个人的脑子里。
本篇侠说分享的是《2026 Agent商业化与竞争研究报告》
#AIAgent#智能体#前沿报告#商业洞察#AI落地#企业数字化#组织变革#职场成长
太侠搜集了全行业报告智库
丰富的营销运营资料库
AI报告、提示词和应用专栏
6.9万+报告,6200+付费会员
加入后任意下载,保持日更新
可开电子发票