人工智能背景下教育测量领域最新研究进展报告(2019—2026)
报告说明:本报告基于系统性文献检索撰写,共检索并研读中英文文献 93 篇(英文 52 篇、中文 41 篇),正文重点引用其中 65 篇(英文 36 篇、中文 29 篇)。英文文献来自国际期刊与会议(Journal of Educational Measurement、Behavior Research Methods、Assessing Writing、AAAI、WWW 等)及 arXiv 预印本;中文文献来自《心理科学》《外语教学与研究》《中国考试》《现代教育技术》《软件学报》等期刊。所有文献均来自真实检索记录,个别条目元数据存疑处已在文末参考文献中标注。
一、引言
以 ChatGPT 为代表的生成式人工智能(Generative AI)正在重塑教育测量的全链条:从命题、施测、评分到反馈与结果应用,几乎每个环节都出现了以大语言模型(LLM)、深度学习和多模态分析为核心的新方法。与此同时,教育测量学自身也在"反向赋能"AI——项目反应理论(IRT)、认知诊断模型(CDM)与效度理论被用于评估和校准 AI 模型本身,形成"AI 赋能测量、测量检验 AI"的双向格局(詹沛达等,2026;Vie & Kashima, 2023)。本报告围绕以下问题展开:(1)AI 在教育测量各环节的最新技术进展如何?(2)大模型时代出现了哪些新兴研究方向?(3)AI 测量的信度、效度、公平性与安全性证据现状如何?(4)中英文研究呈现怎样的差异与互补?(5)未来研究的突破口在哪里?二、研究演进脉络与总体态势
2.1 技术演进的三阶段
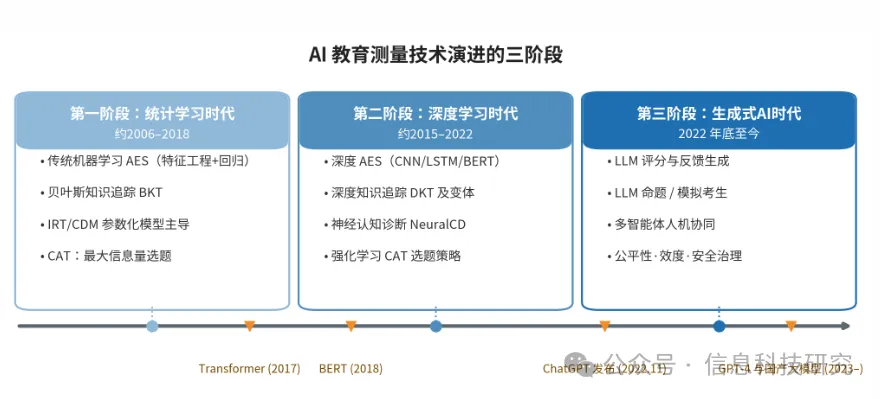
综合中英文文献,AI 教育测量的技术演进可划分为三个阶段(图 1):统计学习时代(约 2006—2018)以特征工程加传统机器学习的自动作文评分(AES)、贝叶斯知识追踪(BKT)和参数化 IRT/CDM 模型为标志;深度学习时代(约 2015—2022)以深度 AES、深度知识追踪(DKT)、神经认知诊断(NeuralCD)和强化学习 CAT 选题为代表;生成式 AI 时代(2022 年底至今)则以 LLM 评分与反馈生成、LLM 命题与"模拟考生"、多智能体人机协同以及公平性—效度—安全治理为前沿(Owan et al., 2023;Misgna et al., 2024;刘明等,2023)。中文研究的时间结构与此呼应:2021—2022 年以智能化测评、知识追踪、认知诊断的综述与理论建构为主(骆方等,2021;王志锋等,2021;黄昌勤等,2022);2023 年 ChatGPT 发布后出现第二波高潮,焦点转向大模型的测评能力实测、AI 命题与人机协同(申丽萍等,2024;魏顺平等,2025;周艳琼,2026)。2.2 中英文研究主题分布
对本报告样本文献按主题归类统计(图 2),可见明显的中英文差异:英文文献以自动评分与写作评价(13 篇)和命题与题目生成(10 篇)为最集中,反映出 LLM 对"评分—命题"两大劳动密集环节的直接冲击;中文文献则以认知诊断/知识追踪/测量模型(10 篇)和效度/公平性/测量理论(9 篇)居多,显示国内教育技术界与心理测量学界各自从建模与理论两端切入。中文在 CAT(1 篇)、模拟考生(4 篇)等方向的实证数量明显少于英文,提示差距与机会并存。三、AI 赋能教育测量的全流程进展
AI 对教育测量的改造已覆盖"命题—施测—评分—诊断反馈—评价应用"全流程,并由数据基础层、测量理论层与质量治理层共同支撑(图 3)。以下分环节综述代表性进展。3.1 智能命题:从"能生成"走向"可控、可校准"
自动题目生成(AIG/AQG)是生成式 AI 影响最直接的环节。Oliveira 等(2026)按 PRISMA 方法综述 2023—2025 年 132 篇 LLM 出题研究,指出研究重心已从"能否生成"转向质量可控与心理计量可校准:Huang & Chang(2026)将生成式 AI 与认知设计系统(CDS)结合,用结构化提示在编码、推理、反应三个认知成分上先验控制难度,36 题中 52.8% 完全达标,但 Gen-AI 自评偏宽松,宜作人工审题的补充而非替代;Wróblewska 等(2025)对 GPT-4o-mini 生成测验做 IRT 分析,发现题目区分度强、难度适宜、DIF 检验仅标记 2 题,心理计量性能可匹敌人工命题;Fu 等(2022)提出基于 DIF 的"子题目差异功能"框架检验同构题目的等价性。在量表编制方向,AI-GENIE 将 LLM 题目生成与网络心理计量学整合,自动生成并筛选低冗余题目,近 5000 人全国样本显示其结构效度可比肩专家量表(Russell-Lasalandra et al., 2026);Lee 等(2025)提出多智能体 LM-AIG 框架,由不同 agent 分别负责生成、内容审查、语言与偏差评估,并保留 human-in-the-loop。Gorgun & Bulut(2024)则提醒:缺乏标准化的题目质量评估框架仍是 AQG 融入正式测评流程的主要障碍。中文研究呈现"技术方法+学科落地"双轨:来雨轩等(2022)融合少样本语境学习与检索增强(RAG)生成学科试题,直接可用率达人类专家的 77.5%;徐扬等(2025)基于 DeepSeek、Kimi 等平台构建"四阶段"高中生物命题路径;朱金凤等(2025)以 30 道母题驱动 DeepSeek 生成 300 道数学子题并做效度分析,指出 AI 命题在科学性与素养性上的短板;陈娴和高翔(2026)提出素养导向情境化试题的人机协同命制模型,用 RAG 与思维链规避"推理幻觉"。值得注意的是周艳琼(2026)基于 IRT 的多维效度比较发现,"专家题干+AI 选项"的协同模式反而降低命题质量,进而提出"AI 初筛—专家优化"新范式——这是 AI 命题效度检验的稀缺实证,也提示人机协同的分工方式并非任意可行。3.2 自适应施测:CAT 的"深度化"
计算机化自适应测验(CAT)的选题策略正从信息论准则转向数据驱动的强化学习。Zhuang 等(2022, AAAI)提出 NCAT,将 CAT 形式化为强化学习问题并以双层优化直接从真实数据学习选题策略;Wang 等(2024)基于 DQN 的选题策略在多数模拟与真实题库条件下 RMSE/MAE 低于最大 Fisher 信息等五种传统策略;Li、Gibbons & Rockova(2025)面向多因子结构,以贝叶斯稀疏多元 IRT 结合 double deep Q-learning 学习非短视的最优选题。中文方面,高旭亮等(2026)提出加权最大后验(WMAP)估计,显著降低 CAT 中异常作答对能力估计的干扰——体现了国内在测量精度保障上的方法学贡献。3.3 智能评分:LLM"可用但不可替代"
自动评分是证据积累最丰富的方向。深度学习 AES 已趋成熟(Uto, 2021;Misgna et al., 2024),LLM 则带来两点质变:无需逐题训练即可评分、可同时生成反馈。但实证结论一致偏谨慎:一致性中等、依赖评分细则。Zhang 等(2024)发现免费版 LLM 在给出详细评分标准时也能达成较好的评分一致性,领域性标准理解比模型规模更重要;Seo 等(2025)发现 LLM 评价在部分标准下稳定,但模型间一致性不足,且人类评分一致性低时 LLM 可靠性同步下降;Villegas 等(2026)的 EduFairBench 基准(2000 份作答、1 万次推理)显示 LLM 与人工评分仅中等一致,且"预测稳定≠预测正确"。客观维度可靠、主观维度困难。Kim & Kim(2024)发现 LLM 对语法、流畅等较客观维度评价可靠,但对主观维度与文体类型评价困难;Fernández 等(2024)报告 ChatGPT-4 评分与人工显著相关但低于评分者间一致性。反馈质量人工仍占优,人机协同最优。Steiss 等(2024)对 200 份中学生作文的多维比较显示,除"基于标准"外人工反馈全面优于 ChatGPT;Ding 等(2025)的实验表明"教师+ChatGPT"联合反馈覆盖面最全。Caines 等(2023)总结:LLM 在文本生成上带来质变,但单独使用并未超越 SOTA 评分模型,传统语言特征仍不可或缺。中文实证与之一致且更审慎:魏顺平等(2025)以 500 篇小学作文实测国产 LLM,发现评分与原始分仅微弱相关、两次评分稳定性差但评级稳定性尚可;何莲珍(2024)系统梳理 LLM 在语言测评研发、实施、评分与反馈中的应用前景,提出"幻觉"、不可解释性、概化与伦理四大挑战;冯筠等(2024)综述了主观题自动评判的算法路线与公开数据集;张成尧(2026)构建"标准校准—数据转写—逐题诊断—画像反馈"的人机协同主观题诊断路径,推动评价由结果赋分转向证据诊断。3.4 认知诊断、知识追踪与过程性测量
深度模型已主导认知诊断与知识追踪,并出现与测量理论"回接"的统一趋势。Wang 等(2022, TKDE)的 NeuralCD 以单调性假设保证神经诊断的可解释性;Tao 等(2024)用 Q 矩阵约束神经网络连接结构,在小样本与高猜测条件下显著优于传统方法;Yin 等(2023, WWW)指出既有 DKT 学到的是行为模式而非知识状态,提出 DTransformer 显式诊断知识层;理论上,Vie & Kashima(2023)证明 DKT 等价于隐式动态多维 IRT,为知识追踪与 IRT 的统一架起桥梁。估计方法上,Sharpnack 等(2024)的 AutoIRT 将 AutoML 引入 IRT 校准并用于 Duolingo 高风险在线测验;Belov 等(2025)提出不依赖似然的监督式 IRT 估计,小样本下优于贝叶斯 MCMC,可用于在线题目预试。中文研究在该方向积累深厚:张所娟等(2023)以 Choquet 积分统一表达认知状态与知识交互;程艳等(2024)将速度—准确率权衡纳入深度认知诊断;知识追踪方面,王宇等(2023,《软件学报》)系统比较了 DKT 模型,闫秋艳等(2024)提出学生—问题异构图模型 SPKT,杨文阳和杨益慧(2024)聚焦"事前/事后可解释性"直指深度测评的黑箱痛点;卢宇等(2021)、王志锋等(2021)则提供了智能导学与智慧教育场景的知识追踪框架。过程性测量方面,隐身评估(stealth assessment)利用游戏与平台过程数据测量传统测验难以触及的构念:Rahimi & Shute(2023)系统阐述了基于证据中心设计(ECD)的隐身评估方法论;Beigman Klebanov & Hoang(2025)基于朗读特征实现阅读理解的连续无干扰评估,段落理解预测精确率超 80%;多模态投入度测量(Yan et al., 2025;Zou et al., 2026)整合视频、话语与日志数据,发现协作与学科投入正向预测小组成绩。3.5 结果应用:数智化增值评价
增值评价是中文文献的特色方向。李俊飞和谭顶良(2026)提出以智能辅助测评、多模态数据追踪与机器学习模型破解传统增值评价的统计局限;池芳(2025)分析了 AI 支撑研究生增值评价的逻辑与数据质量困境;张向众等(2024)的 CiteSpace 分析建议借助大数据与 AI 建立动态数据模型库。这与彭波等(2021)、郭梓楠等(2022)关于 AI 重塑教育评价目标、主体、方式、标准与结果运用的政策—理论讨论相呼应。四、前沿热点专题
4.1 LLM 作为"模拟考生":免现场试测的参数估计
用 LLM 模拟不同能力水平的考生作答、进而估计题目参数,是 2023 年以来兴起最快的方向。Zelikman 等(2023)用微调 LLM 模拟学生作答估计题目难度,234 名 2—8 年级学生实测显示生成测验与专家版分数相关达 r=0.93;Acquaye 等(2026)让 LLM 角色扮演 4/8/12 年级"班级",估计难度与 NAEP 真实难度相关达 0.75—0.82,且数学能力较弱的模型反而预测更好;Ormerod(2026)用 LoRA 微调模型重建合成题目特征曲线(ICC)。但系统性检验结论谨慎:Säuberli 等(2025)基于 CTT 与 IRT 评估 18 个 LLM 的作答"似人性",发现总体相关偏弱,零样本模拟不宜直接用于题目预试;He-Yueya 等(2024)提出"心理计量对齐"指标,发现现有 LLM 与人类知识分布显著错位,温度校准、persona 提示与人类作答数据微调是关键改进手段。4.2 "测 AI":大模型作为被测对象
教育测量方法被反向用于评测 AI 本身。申丽萍等(2024)构建 10 万条中学历史测评数据集实测 ChatGPT 与国产模型,发现其学科知识水平远低于适龄学生且存在可靠性差、偏见等问题;魏顺平等(2025)的作文评价能力实测、童国炜等(2026)的教育大模型评测综述均属此类;刘明等(2024)提出教育大语言模型六步构建流程并将"评价教育大模型"列为独立环节。这一方向实质是把测验编制、信效度检验的整套测量学范式迁移为 AI 评测方法论。4.3 考试安全:生成式 AI 时代的紧迫议题
Newton 等(2024)发现 ChatGPT-4o 在英国 MLA(94%)与美国 USMLE Step 1(89.9%)上高分通过,且对全新改编题性能下降有限,直言无监考在线考试作为基础知识测量手段"已经失效"。防御侧,Gopane & Kotecha(2021)提出 AI 持续身份验证与微表情、眼动检测方案;中文文献中骆祖莹和李玉顺(2022)设计智慧考场架构,马莉(2026)与万建超等(2026)总结"人防+技防"全流程智能监考实践,同时指出识别准确度、考生隐私与区域不均衡问题。总体上,监考研究多为工程实现,缺乏误报率与群体公平性(如面部识别偏差)的严格评估。五、测量学核心关切:信度、效度、公平与治理
效度论证框架先行。2022 年Journal of Educational Measurement专刊确立了基本立场:AI 分数必须接受与人工分数同样严格的效度论证,且需额外回应构念代表性、算法透明与被试解释权(Ferrara & Qunbar, 2022;Dorsey & Michaels, 2022);Aloisi(2023)以 ABI+ 信任模型论证效度与公众信任的关联,呼吁将原则性 AI 框架纳入考试政策。公平性检验方法论化。Johnson 等(2022)整合机器学习公平性定义与心理计量框架,阐明遗漏变量、代理变量与优化准则如何引入算法偏差;Chen 等(2026)提出以能力分层为前提的条件差异比率/差两个预测偏差度量,用 PERSUADE 2.0 语料检验四类模型(含 ChatGPT)的性别与种族偏差;Debelak & Ziegler(2026)给出 AI 作文分数信度、效度、公平性的系统检验标准与可复现工具包,发现跨题目话题比较时存在公平性违反。共识是"不看整体差异、要看条件于能力的偏差"。中文语境的伦理与制度讨论活跃。袁玉龙等(2023)揭示评价主体性让渡导致的功能扭曲与人文价值消解;任海涛和孔仲渊(2024)从法理上论证 AI 将动摇教师评价权的独享基础,主张品行评价与学业评价的效力二分;吕媛媛(2024)主张人机协同中以人为价值主导。王希常(2023)代表考试机构提出"智能模型测评"与心理测量、教育测量融合的使命定位。六、中英文研究比较
维度 | 英文研究 | 中文研究 |
|---|
重心环节 | 评分、命题两大环节的 LLM 化 | 认知诊断/知识追踪建模与评价理论 |
方法取向 | 心理计量检验(IRT/DIF/效度论证)严格 | 综述建构与路径探索多、严格实证少 |
模型生态 | GPT 系列等国际模型 | DeepSeek、文心、星火等国产模型实测 |
特色议题 | 模拟考生、隐身评估、公平性度量 | 增值评价、智慧考场、教师评价权法理 |
共同趋势 | 人机协同成为规范共识;信效度与公平性重回中心 | 同左 |
双方互补明显:英文研究提供了可迁移的检验工具(EduFairBench、AI 分数测试标准),中文研究提供了本土考试制度下的治理经验与国产模型证据;中文在 CAT 算法、模拟考生、AI 评分公平性实证上的数量差距,正是下一轮研究的切入点。七、挑战、研究空白与展望
严格测量学证据稀缺。多数 LLM 应用研究为可行性展示,像 IRT 效度比较(周艳琼,2026)、大规模基准实测(申丽萍等,2024)、公平性条件检验(Chen et al., 2026)这类严格检验仍属少数,且结论普遍偏谨慎甚至负面。缺乏公共基准与报告标准。跨模型、跨数据集的可复现评测刚起步(EduFairBench 是初步尝试),中文教育大模型评测尚无公认基准数据集(童国炜等,2026)。后果效度与长期影响未知。AI 评分与反馈对教学、学习动机的长期影响证据几乎空白;核心素养与高阶能力的 AI 测评多停留在框架层面。人机协同范式未定型。"AI 初筛—专家优化"与"专家题干—AI 选项"的效果可能截然相反(周艳琼,2026),责任归属与监管框架研究刚刚起步。安全与公平的系统性评估缺位。监考技术缺乏误报率与群体公平评估;LLM 高分通过高风险考试(Newton et al., 2024)倒逼考试形态改革(如口试化、过程化、监考化)。展望:①测量理论与深度模型的深度融合(如 DKT=动态多维 IRT 的理论统一)将催生可解释、可校准的新一代测量模型;②LLM 模拟考生若解决"心理计量对齐"问题,有望大幅降低题目预试成本;③多模态过程性数据的信效度检验体系亟待建立;④"测人"与"测 AI"的双向范式将使教育测量学从测验工具学科升级为智能时代教育治理的基础方法学科(詹沛达等,2026;王希常,2023)。八、结语
AI 背景下的教育测量正处在"能力跃升"与"证据追赶"并存的阶段:技术上,命题、施测、评分、诊断、反馈全流程已被深度改造;测量学上,"可用但不可替代"是对当前 LLM 评分与命题最准确的概括。未来竞争的关键不在模型规模,而在信效度证据、公平性保障与人机协同制度设计——这正是教育测量学不可替代的专业价值所在。
参考文献
英文文献(36 篇)
Acquaye, C., et al. (2026). Take Out Your Calculators: Estimating the Real Difficulty of Question Items with LLM Student Simulations. arXiv.https://doi.org/10.48550/arXiv.2601.09953Aloisi, C. (2023). The future of standardised assessment: Validity and trust in algorithms for assessment and scoring.European Journal of Education.https://doi.org/10.1111/ejed.12542Beigman Klebanov, B., & Hoang, A. (2025). Toward stealth assessment of reading comprehension.Journal of Research on Technology in Education.https://doi.org/10.1080/15391523.2025.2568522Belov, D. I., Lüdtke, O., & Ulitzsch, E. (2025). A supervised learning approach to estimating IRT models in small samples.British Journal of Mathematical and Statistical Psychology.https://doi.org/10.1111/bmsp.12396Caines, A., et al. (2023). On the application of Large Language Models for language teaching and assessment technology. arXiv.https://doi.org/10.48550/arXiv.2307.08393Chen, G., Wu, A. D., & Zhang, C. (2026). Assessing fairness in AI-assisted writing scoring: Developing fairness measures to detect predictive bias in automated essay scoring.Assessing Writing.https://doi.org/10.1016/j.asw.2026.101066Choi, S., et al. (2026). Generative artificial intelligence and automated scoring in curriculum-based measurement for elementary students with early writing needs.Assessing Writing.https://doi.org/10.1016/j.asw.2026.101134Debelak, R., & Ziegler, M. (2026). Testing standards for AI-based scores in automated essay scoring.PLoS ONE.https://doi.org/10.1371/journal.pone.0354680Ding, L., Zou, D., & Kohnke, L. (2025). ChatGPT as an automated writing evaluation tool: how students perceive it and how it affects their writing.Education and Information Technologies.https://doi.org/10.1007/s10639-025-13775-3Dorsey, D. W., & Michaels, H. R. (2022). Validity Arguments Meet Artificial Intelligence in Innovative Educational Assessment.Journal of Educational Measurement.https://doi.org/10.1111/jedm.12331Fernández, A. A., et al. (2024). ChatGPT as an Instructor's Assistant for Generating and Scoring Exams.Journal of Chemical Education.https://doi.org/10.1021/acs.jchemed.4c00231Ferrara, S., & Qunbar, S. (2022). Validity Arguments for AI-Based Automated Scores: Essay Scoring as an Illustration.Journal of Educational Measurement.https://doi.org/10.1111/jedm.12333Fu, Y., et al. (2022). An Evaluation of Automatic Item Generation: A Case Study of Weak Theory Approach.Educational Measurement: Issues and Practice.https://doi.org/10.1111/emip.12529Gopane, S., & Kotecha, R. (2021). Enhancing Monitoring in Online Exams Using Artificial Intelligence.Proc. Int. Conf. on Data Science and Applications(Springer LNNS).https://doi.org/10.1007/978-981-16-5348-3_14Gorgun, G., & Bulut, O. (2024). Exploring quality criteria and evaluation methods in automated question generation: A comprehensive survey.Education and Information Technologies.https://doi.org/10.1007/s10639-024-12771-3He-Yueya, J., et al. (2024). Psychometric Alignment: Capturing Human Knowledge Distributions via Language Models. arXiv.https://doi.org/10.48550/arXiv.2407.15645Huang, J., & Chang, H.-H. (2026). A Cognitive Design System Approach to Enhancing Cognitive Alignment and Difficulty Control in Gen-AI Item Generation.Applied Measurement in Education.https://doi.org/10.1080/08957347.2026.2740622Johnson, M. S., Liu, X., & McCaffrey, D. F. (2022). Psychometric Methods to Evaluate Measurement and Algorithmic Bias in Automated Scoring.Journal of Educational Measurement.https://doi.org/10.1111/jedm.12335Kim, S., & Kim, S. (2024). Can Language Models Evaluate Human Written Text? Case Study on Korean Student Writing for Education. arXiv.https://doi.org/10.48550/arXiv.2407.17022Lee, P., Son, M., & Jia, Z. (2025). AI-powered Automatic Item Generation for Psychological Tests: A Conceptual Framework for an LLM-based Multi-Agent AIG System.Journal of Business and Psychology.https://doi.org/10.1007/s10869-025-10067-yLi, F., et al. (2023). Automatic Essay Scoring Method Based on Multi-Scale Features.Applied Sciences.https://doi.org/10.3390/app13116775Li, J., Gibbons, R., & Rockova, V. (2025). Deep Computerized Adaptive Testing. arXiv.https://doi.org/10.48550/arXiv.2502.19275Misgna, H., et al. (2024). A survey on deep learning-based automated essay scoring and feedback generation.Artificial Intelligence Review.https://doi.org/10.1007/s10462-024-11017-5Newton, P. M., et al. (2024). Can ChatGPT-4o really pass medical science exams? A pragmatic analysis using novel questions. medRxiv.https://doi.org/10.1101/2024.06.29.24309595Oliveira, R., et al. (2026). Automatic Question Generation with Large Language Models: A Survey.ACM Computing Surveys.https://doi.org/10.1145/3832773Ormerod, C. (2026). Reconstructing Item Characteristic Curves using Fine-Tuned Large Language Models. arXiv.https://doi.org/10.48550/arXiv.2601.02580Owan, V. J., et al. (2023). Exploring the potential of artificial intelligence tools in educational measurement and assessment.Eurasia Journal of Mathematics, Science and Technology Education.https://doi.org/10.29333/ejmste/13428Rahimi, S., & Shute, V. J. (2023). Stealth assessment: a theoretically grounded and psychometrically sound method to assess, support, and investigate learning in technology-rich environments.Educational Technology Research and Development.https://doi.org/10.1007/s11423-023-10232-1Russell-Lasalandra, L. L., et al. (2026). Generative psychometrics via AI-GENIE: Automatic item generation and validation with network-integrated evaluation.Behavior Research Methods.https://doi.org/10.3758/s13428-026-03082-1Säuberli, A., Frassinelli, D., & Plank, B. (2025). Do LLMs Give Psychometrically Plausible Responses in Educational Assessments? arXiv.https://doi.org/10.48550/arXiv.2506.09796Seo, H., et al. (2025). Large Language Models as Evaluators in Education: Verification of Feedback Consistency and Accuracy.Applied Sciences.https://doi.org/10.3390/app15020671Sharpnack, J., et al. (2024). AutoIRT: Calibrating Item Response Theory Models with Automated Machine Learning. arXiv.https://doi.org/10.48550/arXiv.2409.08823Sommer, M., & Arendasy, M. (2025). Automatic- and Transformer-Based Automatic Item Generation: A Critical Review.Journal of Intelligence.https://doi.org/10.3390/jintelligence13080102Steiss, J., et al. (2024). Comparing the quality of human and ChatGPT feedback of students' writing.Learning and Instruction.https://doi.org/10.1016/j.learninstruc.2024.101894Tao, J., et al. (2024). Cognitive diagnostic assessment: A Q-matrix constraint-based neural network method.Behavior Research Methods.https://doi.org/10.3758/s13428-024-02404-5Uto, M. (2021). A review of deep-neural automated essay scoring models.Behaviormetrika.https://doi.org/10.1007/s41237-021-00142-yVie, J.-J., & Kashima, H. (2023). Deep Knowledge Tracing is an implicit dynamic multidimensional item response theory model. arXiv.https://doi.org/10.48550/arXiv.2309.12334Villegas, W., et al. (2026). EduFairBench: Reproducible Evaluation of Large Language Models for Educational Assessment.Frontiers in Artificial Intelligence.https://doi.org/10.3389/frai.2026.1933445Wang, F., et al. (2022). NeuralCD: A General Framework for Cognitive Diagnosis.IEEE Transactions on Knowledge and Data Engineering.https://doi.org/10.1109/TKDE.2022.3201037Wang, P., Liu, H., & Xu, M. (2024). An adaptive testing item selection strategy via a deep reinforcement learning approach.Behavior Research Methods.https://doi.org/10.3758/s13428-024-02498-xWróblewska, A., et al. (2025). Evaluating LLM-Generated Q&A Test: a Student-Centered Study. arXiv.https://doi.org/10.48550/arXiv.2505.06591Yan, L., Wu, X., & Wang, Y. (2025). Student engagement assessment using multimodal deep learning.PLoS ONE.https://doi.org/10.1371/journal.pone.0325377Yin, Y., et al. (2023). Tracing Knowledge Instead of Patterns: Stable Knowledge Tracing with Diagnostic Transformer.WWW 2023.https://doi.org/10.1145/3543507.3583255Zelikman, E., et al. (2023). Generating and Evaluating Tests for K-12 Students with Language Model Simulations: A Case Study on Sentence Reading Efficiency. arXiv.https://doi.org/10.48550/arXiv.2310.06837Zhang, D.-W., et al. (2024). Evaluating large language models for criterion-based grading from agreement to consistency.npj Science of Learning.https://doi.org/10.1038/s41539-024-00291-1Zhuang, Y., et al. (2022). Fully Adaptive Framework: Neural Computerized Adaptive Testing for Online Education.AAAI 2022.https://doi.org/10.1609/aaai.v36i4.20399中文文献(29 篇)
陈娴, 高翔. 人机协同赋能素养导向的小学科学情境化试题命制路径[J]. 中小学数字化教学, 2026.池芳. 人工智能赋能研究生增值评价的内在逻辑、现实困境及实践路径[J]. 成都工业学院学报, 2025. DOI: 10.13542/j.cnki.51-1747/tn.2025.06.011程艳, 周子为, 马明宇, 等. 基于速度与准确率权衡的深度认知诊断模型[J]. 计算机科学, 2024.冯筠, 栗凯旋, 高志泽樟, 等. 主观题自动评判算法研究综述[J]. 计算机科学, 2024.高旭亮, 赵影, 王芳. 一种针对计算机化自适应测验异常作答的稳健参数估计方法[J]. 心理科学, 2026. DOI: 10.16719/j.cnki.1671-6981.20260420郭梓楠, 王婉丁, 刘嘉. 人工智能助力教育评价改革[J]. 人工智能, 2022. DOI: 10.16453/j.cnki.ISSN2096-5036.2022.02.014何莲珍. 大语言模型在语言测评中的应用[J]. 外语教学与研究, 2024. DOI: 10.19923/j.cnki.fltr.2024.06.007黄昌勤, 涂雅欣, 韩中美. 智能技术赋能课堂测评:现状、挑战与趋势[J]. 人工智能, 2022. DOI: 10.16453/j.cnki.ISSN2096-5036.2022.02.013来雨轩, 王艺丹, 王立. 基于大语言模型与检索增强的学科试题生成方法[J]. 中文信息学报, 2022(年份以数据库记录为准).李俊飞, 谭顶良. 数智化增值评价:基于人工智能技术的实现机理与实践进路[J]. 中国考试, 2026. DOI: 10.19360/j.cnki.11-3303/g4.2026.10.003刘明, 吴忠明, 廖剑, 等. 大语言模型的教育应用:原理、现状与挑战——从轻量级 BERT 到对话式 ChatGPT[J]. 现代教育技术, 2023.刘明, 吴忠明, 杨箫, 等. 教育大语言模型的内涵、构建和挑战[J]. 现代远程教育研究, 2024.卢宇, 王德亮, 章志, 等. 智能导学系统中的知识追踪建模综述[J]. 现代教育技术, 2021.吕媛媛. ChatGPT 在高校教育评价中的应用前景:逻辑演变与发展向度[J]. 云南师范大学学报(哲学社会科学版), 2024.骆方, 田雪涛, 屠焯然, 姜力铭. 教育评价新趋向:智能化测评研究综述[J]. 现代远程教育研究, 2021.骆祖莹, 李玉顺. 智慧考场的设计架构、应用场景及关键技术[J]. 中国考试, 2022. DOI: 10.19360/j.cnki.11-3303/g4.2022.09.002马莉. 教育数字化转型背景下的智能监考模式与应用对策研究[J]. 智慧引航, 2026.彭波, 王伟清, 张进良, 等. 人工智能视域下教育评价改革何以可能[J]. 当代教育论坛, 2021. DOI: 10.13694/j.cnki.ddjylt.20211012.001任海涛, 孔仲渊. 教师评价权的智能革命:人工智能何以挑战教师评价权[J]. 苏州大学学报(教育科学版), 2024(数据库记录年份为 2020,据 DOI 判断应为 2024). DOI: 10.19563/j.cnki.sdjk.2024.03.002申丽萍, 何朝帆, 曹东旭, 等. 大语言模型在中学历史学科中的应用测评分析[J]. 现代教育技术, 2024.童国炜, 黄林轶, 杜海华, 等. 教育领域大模型测评现状与趋势研究[J]. 电子产品可靠性与环境试验, 2026.万建超, 王树祥, 张玺. 人工智能赋能教育考试监考模式转型研究——以 H 省为例[J]. 石家庄职业技术学院学报, 2026.王希常. 智能时代的教育测量新视野[J]. 中国考试, 2023. DOI: 10.19360/j.cnki.11-3303/g4.2023.11.001王宇, 朱梦霞, 杨尚辉, 等. 深度知识追踪模型综述和性能比较[J]. 软件学报, 2023. DOI: 10.13328/j.cnki.jos.006715王志锋, 熊莎莎, 左明章, 等. 智慧教育视域下的知识追踪:现状、框架及趋势[J]. 远程教育杂志, 2021. DOI: 10.15881/j.cnki.cn33-1304/g4.2021.05.005魏顺平, 张悦, 冉柔. 国产大语言模型的语文作文评价能力测试[J]. 现代教育技术, 2025.徐扬, 徐培培, 黄瑄, 徐峥. 基于生成式人工智能的高中生物学试题命制路径研究[J]. 北京教育学院学报, 2025. DOI: 10.16398/j.cnki.jbjieissn1008-228x.2025.03.010闫秋艳, 司雨晴, 袁冠, 王志晓. 基于学生-问题关联的异构图知识追踪模型[J]. 电子学报, 2024.杨文阳, 杨益慧. 聚焦可解释性:知识追踪模型综述与展望[J]. 现代教育技术, 2024.袁玉龙, 马艳阳, 庞茗月. 人工智能时代教育评价主体性让渡的风险规避[J]. 现代教育技术, 2023.詹沛达, 金舒悦, 丛艳章, 等. 心理测量和人工智能的相互促进与协同发展[J]. 心理科学, 2026. DOI: 10.16719/j.cnki.1671-6981.20260402张成尧. 人机协同赋能主观题学情诊断的四阶路径[J]. 中学政治教学参考, 2026.张所娟, 余晓晗, 陈恩红, 等. 融合知识交互关系的认知诊断深度模型[J]. 模式识别与人工智能, 2023. DOI: 10.16451/j.cnki.issn1003-6059.202301002张向众, 邓冬琳, 乔磊. 21 世纪以来我国增值评价研究的回溯与展望——基于 CiteSpace 的可视化分析[J]. 曲靖师范学院学报, 2024.周艳琼. 人机协同命题与英语选择题阅读测试效度——基于 IRT 的多维度比较[J]. 外语教学与研究, 2026. DOI: 10.19923/j.cnki.fltr.2026.03.008朱金凤, 储林林, 汪晓勤. 基于 DeepSeek 命制数学单选题的实践研究[J]. 中学数学杂志, 2025.注:正文按作者—年份引用;编号 1—46 为英文文献,47—82 为中文文献。部分 arXiv 2026 年记录为检索系统返回的最新条目,个别中文条目无 DOI,可经万方数据按题名检索获取。

 研报速递