研报速递
甲子光年2026年10月这份报告没谈「Agent元年」,只追问:技术能力要过几道关,才能变成客户认账的成果、厂商可持续的收入。五个部分落到一句——商业价值不由模型能力单独决定,而由「交付」定义。
一、从答得对,到交得出
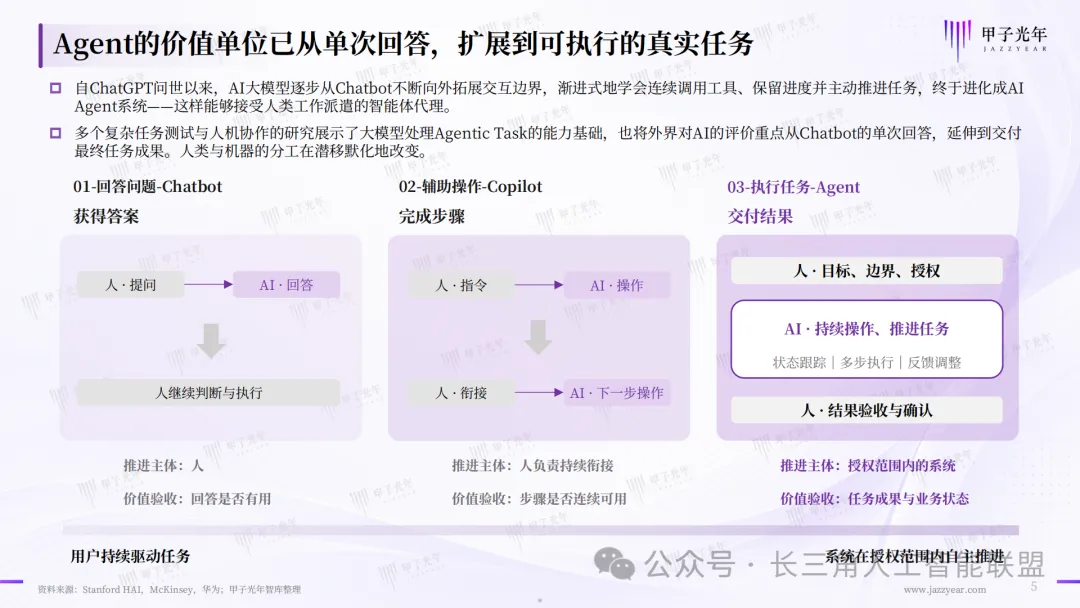
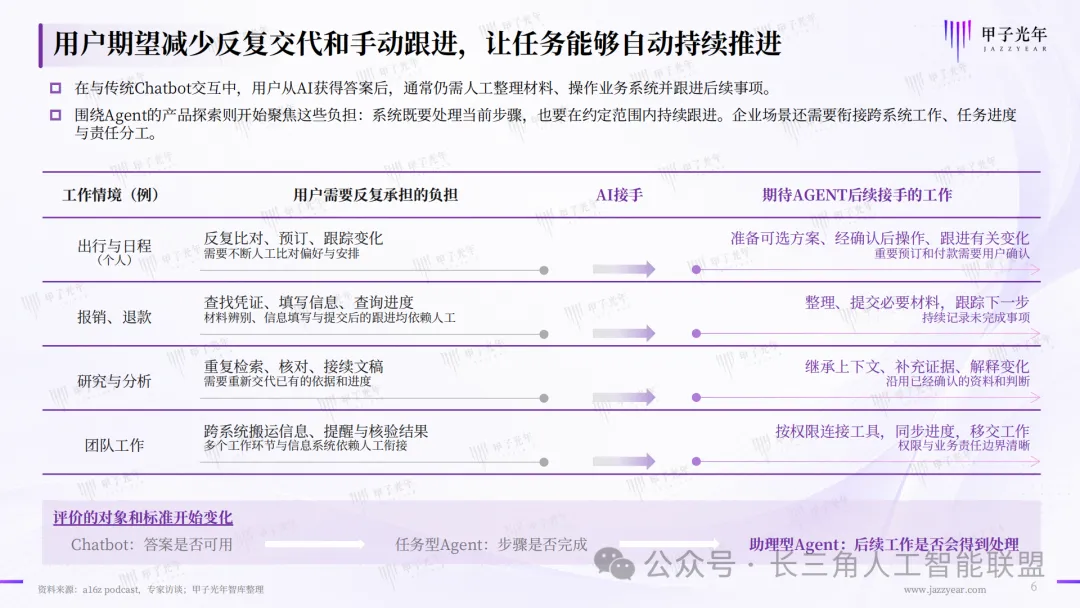
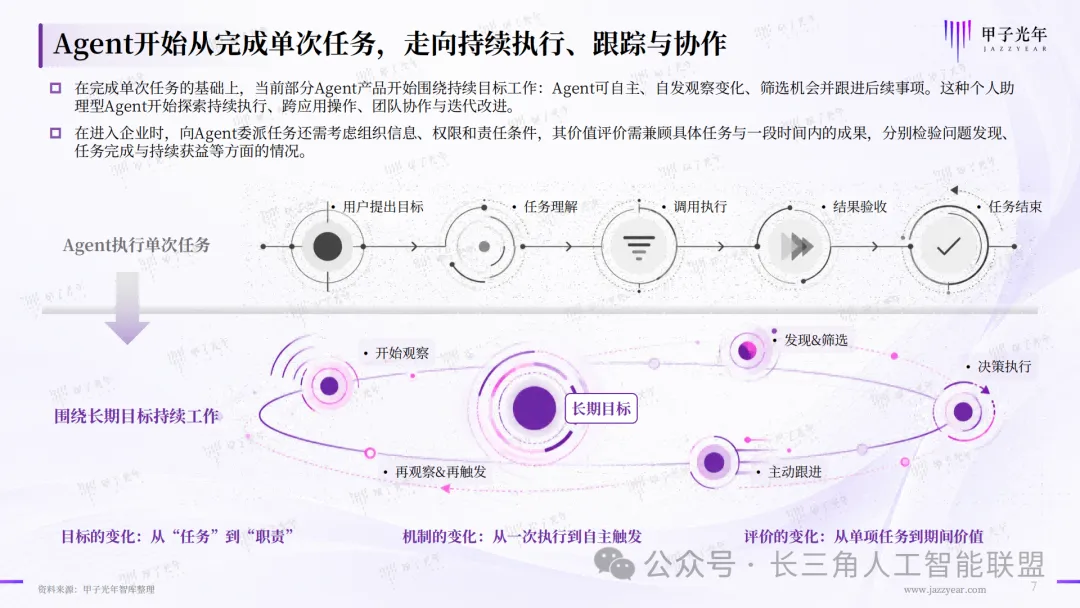
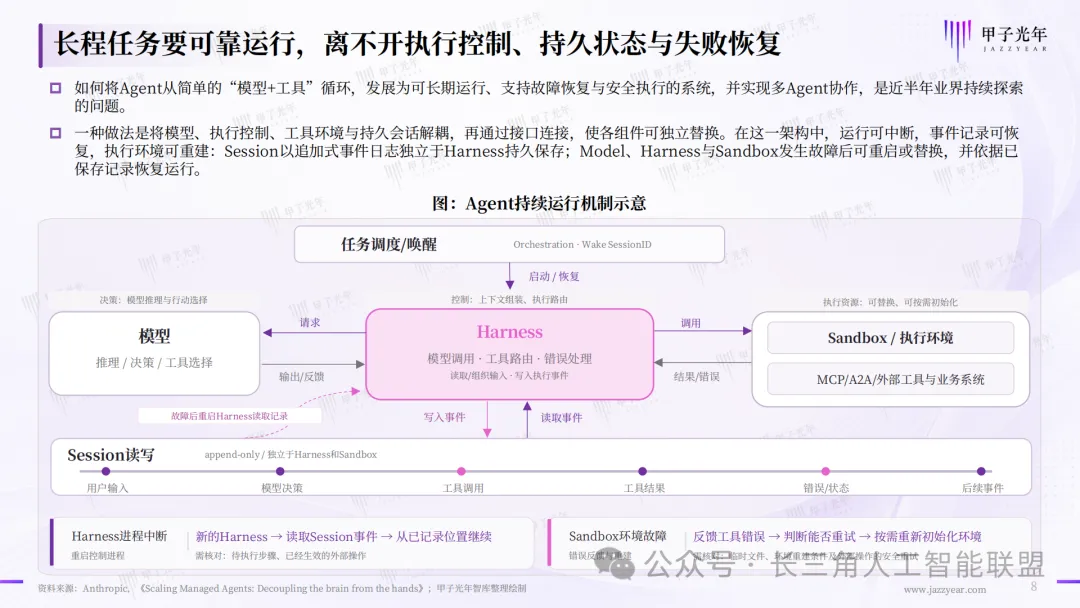
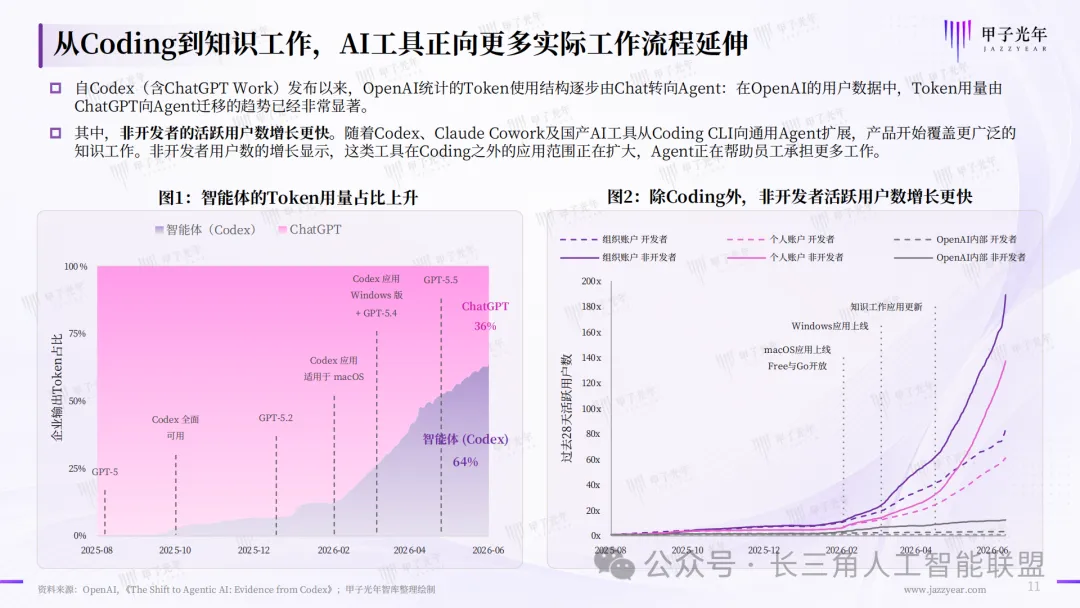
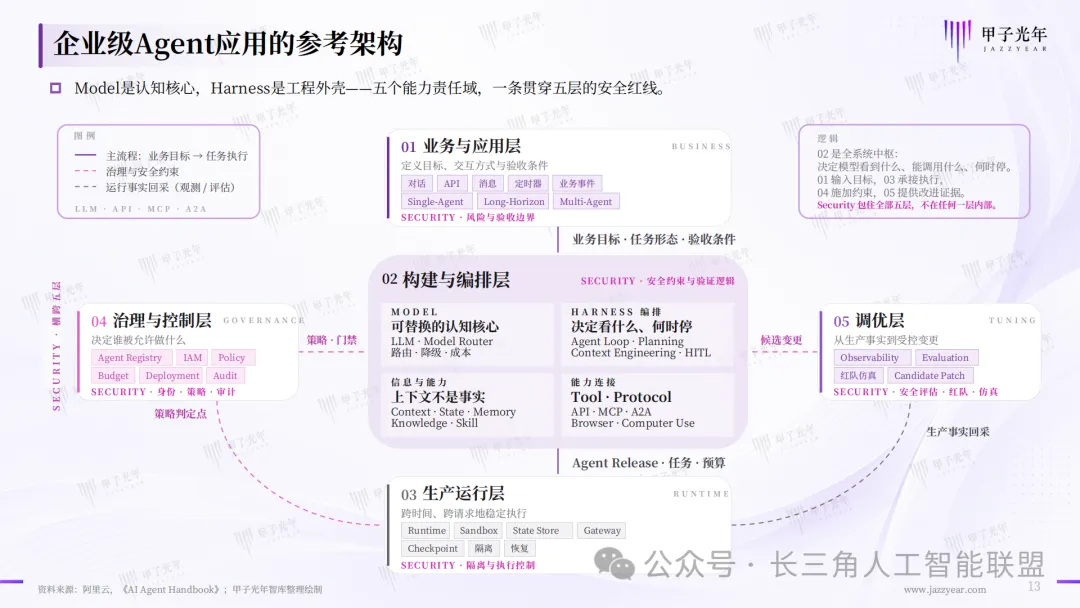
Chatbot交付答案,Copilot完成步骤,Agent交付任务成果与业务状态;再往前,目标从「任务」变「职责」,评价从单项任务变期间价值。长程运行与失败恢复靠的是Model、Harness、Sandbox与持久会话解耦、事件日志可重建的工程外壳,而非「模型+工具」循环。竞争重心已从「选哪个模型」转向「谁能把模型稳稳嵌进工作流」。
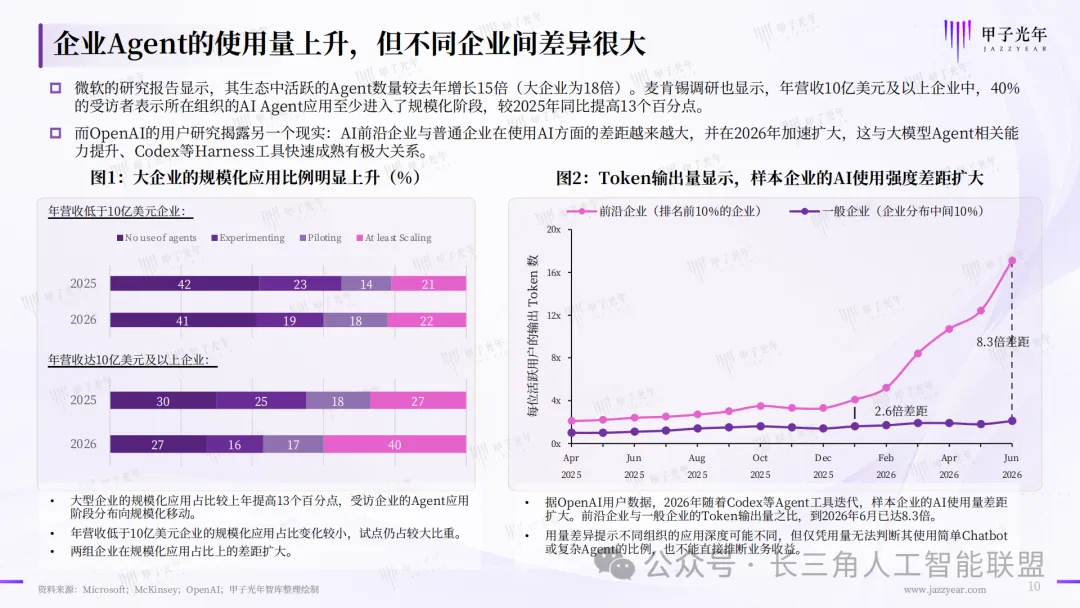
升温信号明确:微软生态活跃Agent数同比增15倍,麦肯锡调研中40%的大企业至少进入规模化,Token用量由Chat迁向Agent。但报告提醒:前沿与一般企业Token输出量之比 2026年6月达8.3倍,用量只说明应用深度,推不出收益。基调由此而定。
二、最强模型不等于最赚钱的 Agent
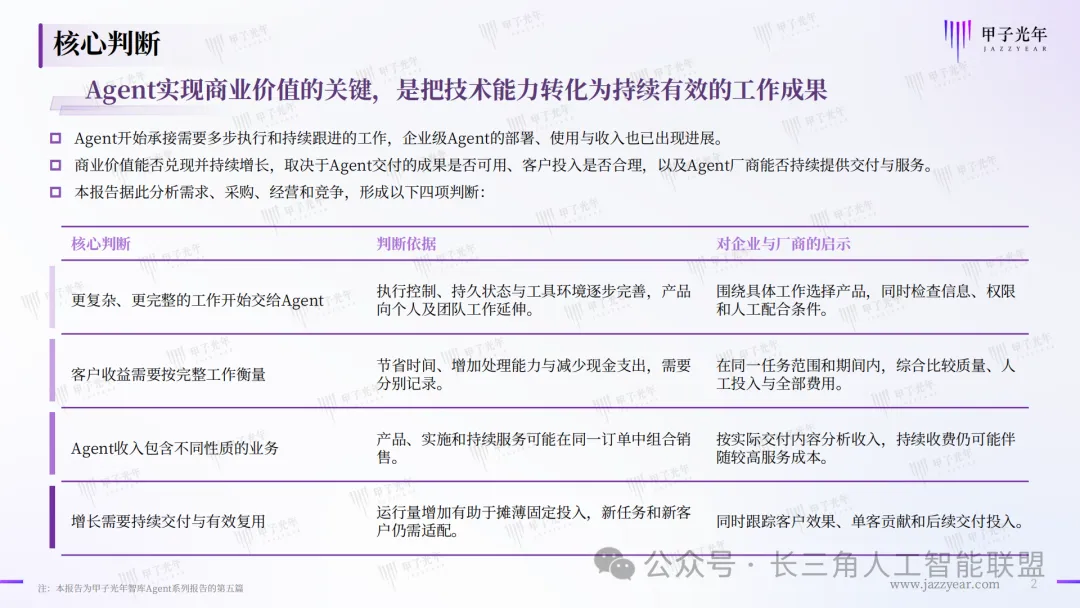
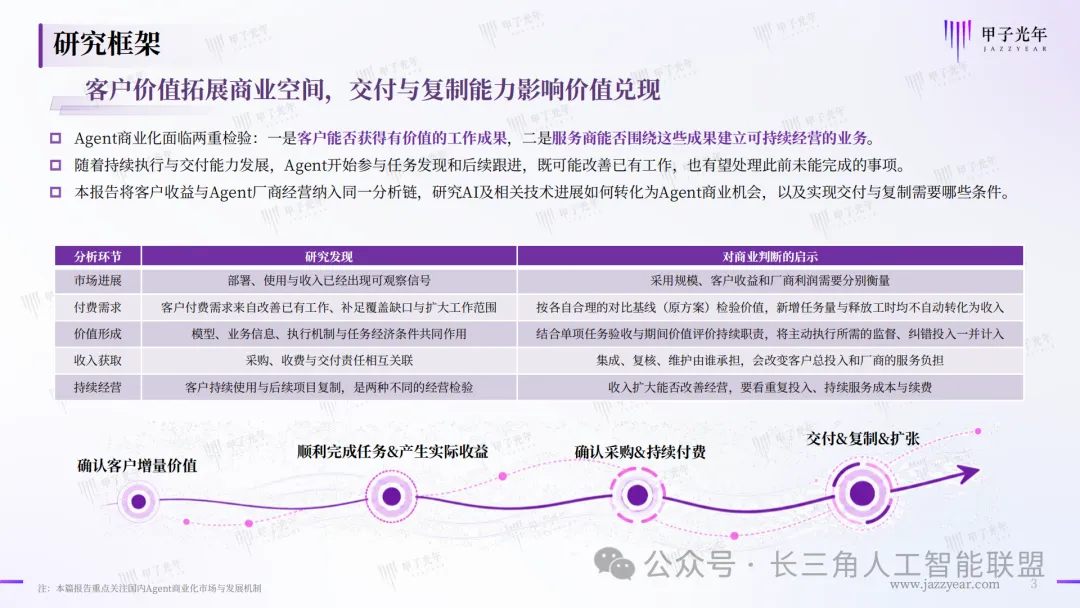
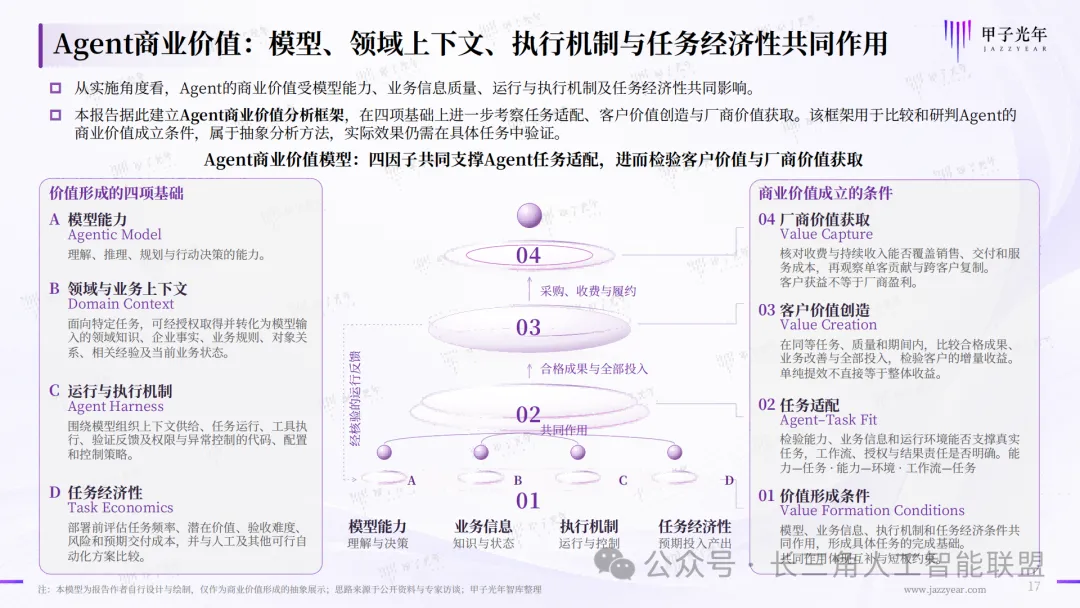
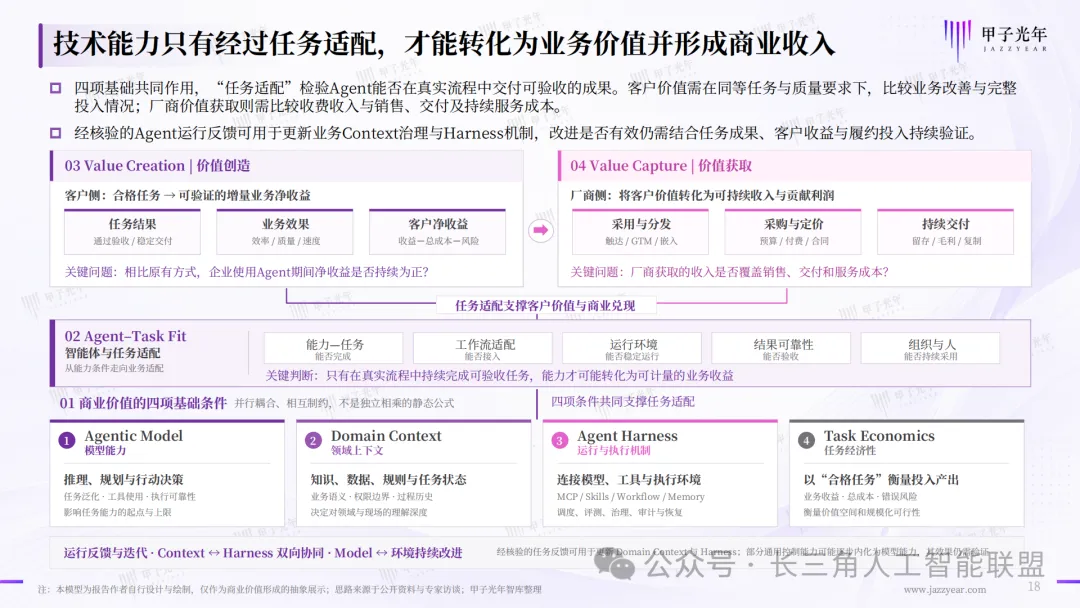
价值形成是一条链:模型能力、业务上下文、执行机制、任务经济性共同作用 → 任务适配 → 客户价值创造 → 厂商价值获取。客户获益不等于厂商盈利,是最容易被融资叙事抹掉的一跃。
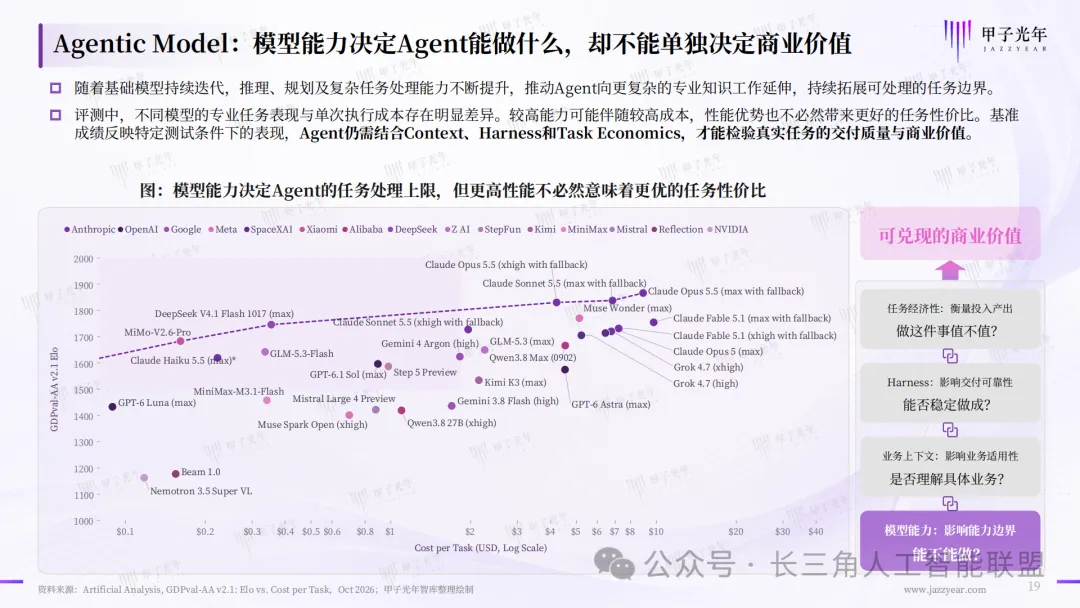
CData合成实验中,仅访问原始数据成功率0.25%(1/405),接入业务 Context后升到82.22%(333/405),工具调用与Token同步下降;同一模型换Harness,表现与成本明显不同,且无统一最优组合。模型决定「能不能做」,Context决定「懂不懂业务」,Harness决定「能不能稳定做成」。
任务经济性更常让项目停摆:除Token、API等显性成本,流程调整、培训、治理、复核、异常恢复与升级后的重新适配,是分散在其他预算里且持续发生的隐性投入。只有高频、可重复、易验收的工作流能靠规模摊薄固定成本;复核运维过重,规模越大越可能「负收益」。
三、两本账都要按全成本算
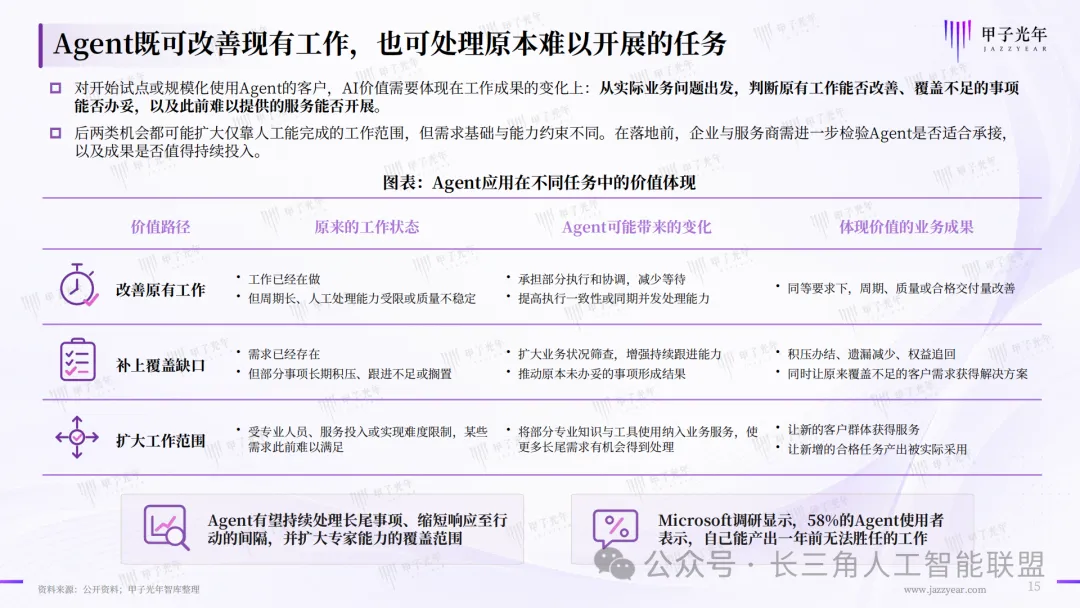
客户侧要在同等任务、质量与期间内比较成果与全部投入,把监督纠错计入,并分别记录节省时间、提升处理能力与减少现金支出。58%的使用者能产出一年前无法胜任的工作,但新增任务量与释放工时并不自动变成收入。厂商侧也不能只看签约额:产品、实施、持续服务常捆在同一订单,持续收费仍可能伴随高服务成本。BCG数据可作旁证:企业AI投入(占营收3.3%)中,IT预算外2.8%约为预算内0.5%的5.6倍,成本大头本就不在软件采购里。
四、门槛是复用,不是用量
竞争分三层:模型决定能否完成,Context与Harness决定能否稳定交付,触达、信任与任务经济性决定能否兑现;模型成为基础条件后,优势来自三层协同。供给则沿平台化、产品化、服务化并行。
BCG预测Agentic AI在AI价值中的占比从2025年17%、2026年22%升至2030年39%;但先进组约91%已实际运营,落后组64%仍在打基础或试点,增长预期不等于收益兑现。报告给出三个更硬的观察维度:从试点数量转向生产环境实际使用(活跃客户、续约扩容),从演示效果转向任务交付经济性(异常率、复核投入、单次成功交付成本),从单个项目转向跨客户复制(部署时间、边际交付成本)。最后一条才是规模经营与「不断重做项目」的分水岭。
五、怎么用
对企业是选型清单:定基线与验收口径、查权限与责任、按全成本决定要不要扩;对厂商,指标从发布数、签约数换成客户效果、单客贡献与后续交付投入。全篇最可贵的是克制:效果须在具体任务中验证。把「上岗后谁复核、谁维护、谁付钱」写清楚,比多给几个百分比更有价值。
本文基于甲子光年智库《2026 Agent商业化与竞争研究报告》(2026年10月发布)撰写,详细内容请查阅原文。
以下是内容节选↓↓↓ 文末点击链接免费下载pdf,扫二维码加入交流群
长三角人工智能联盟简介