研报速递
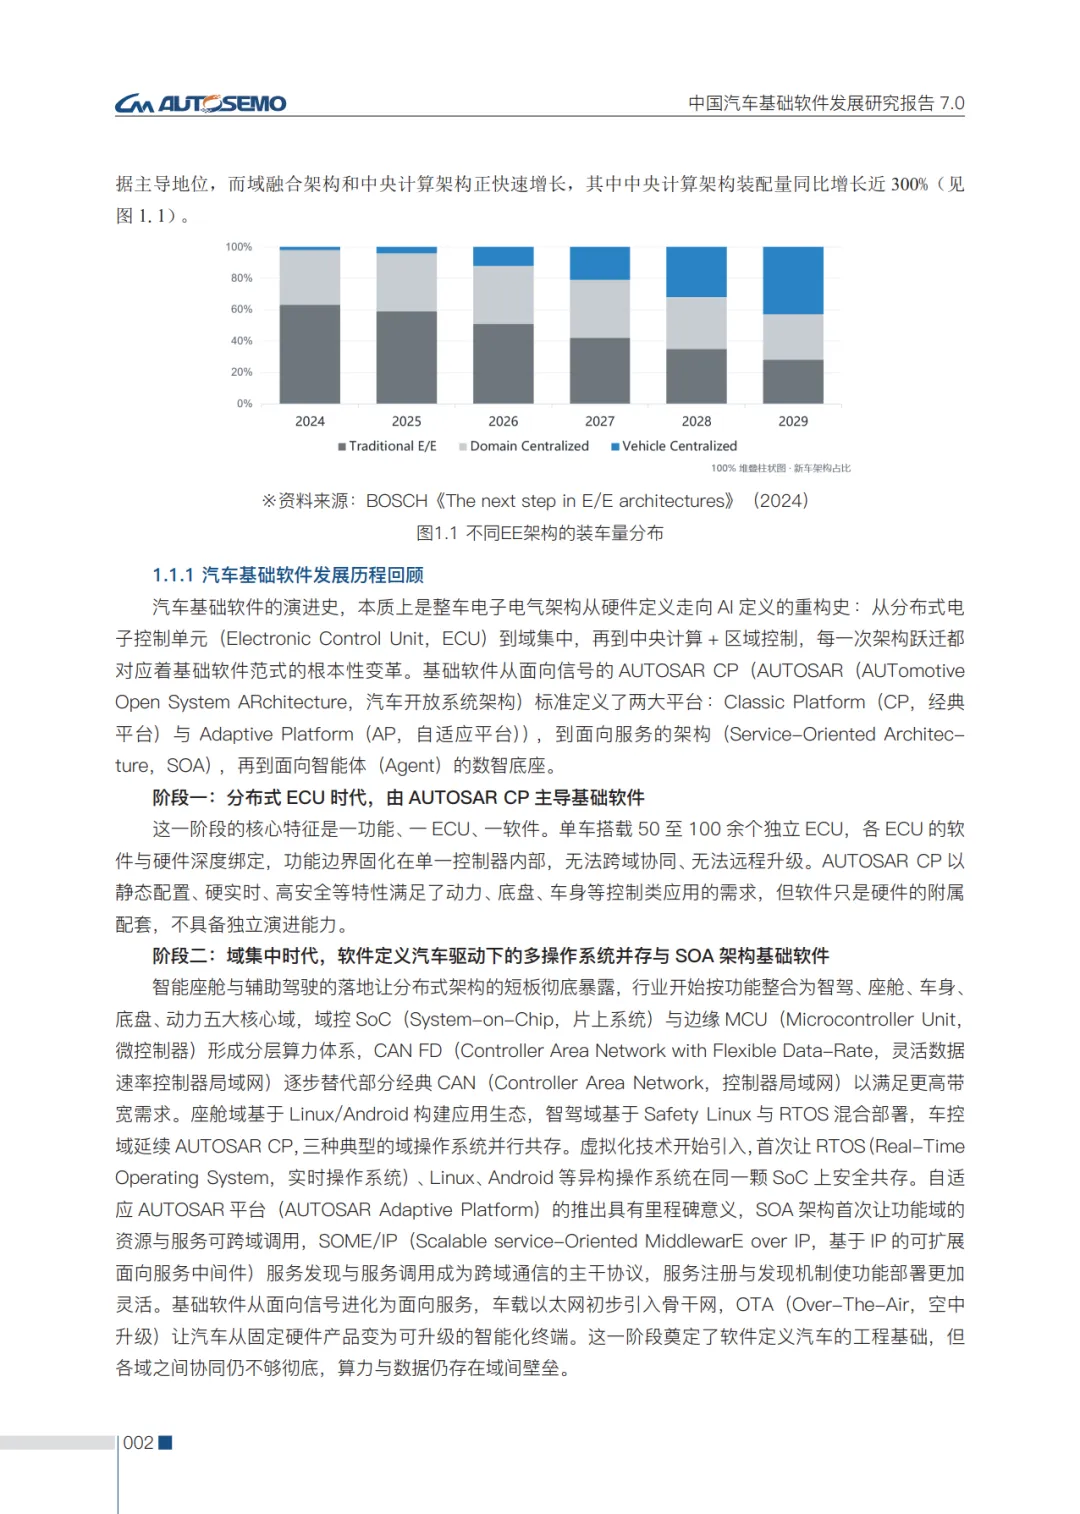
先看行业变了多少:中央计算装车量一年涨了近 300%
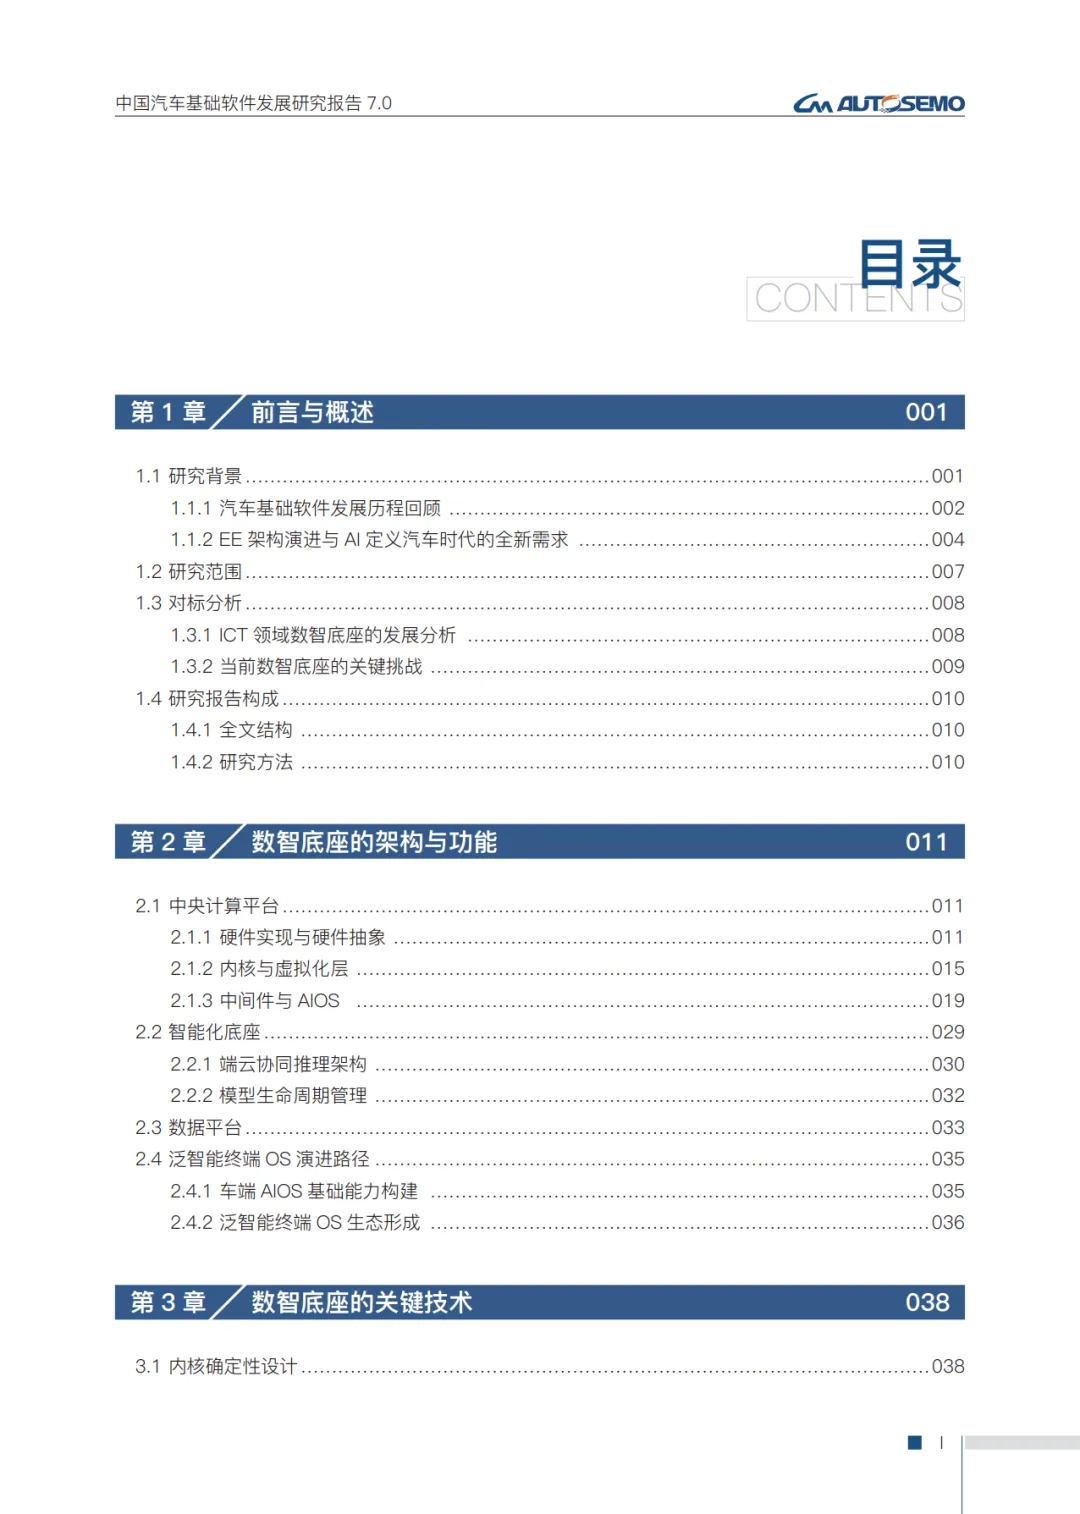
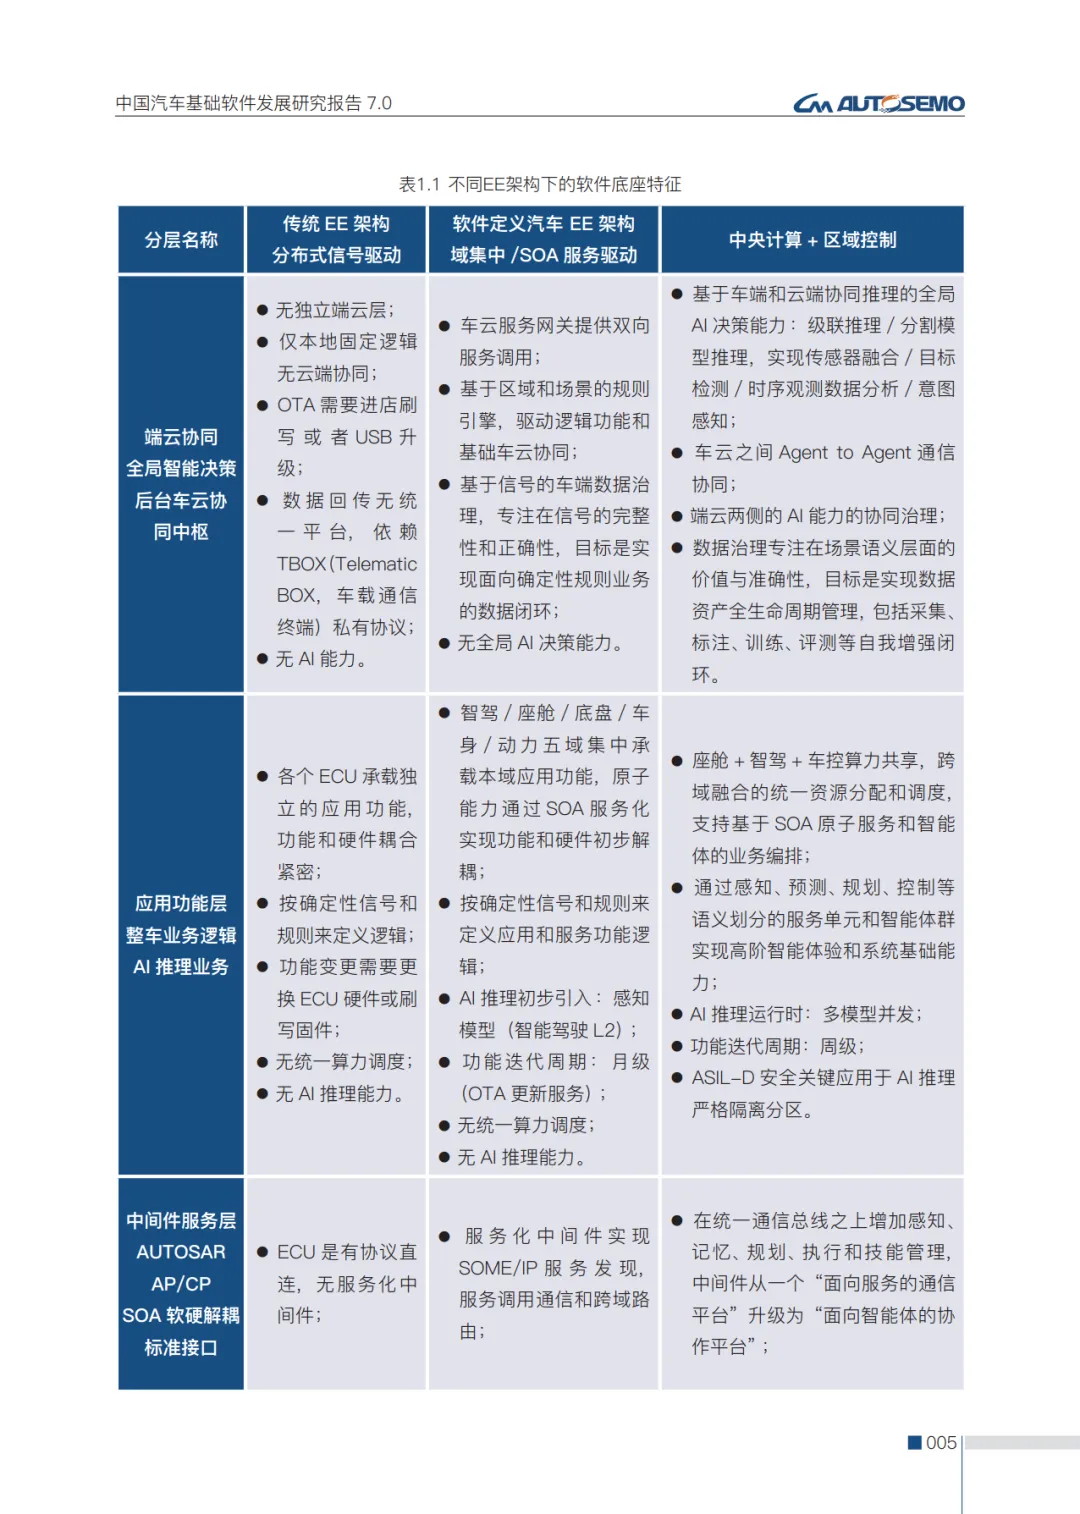
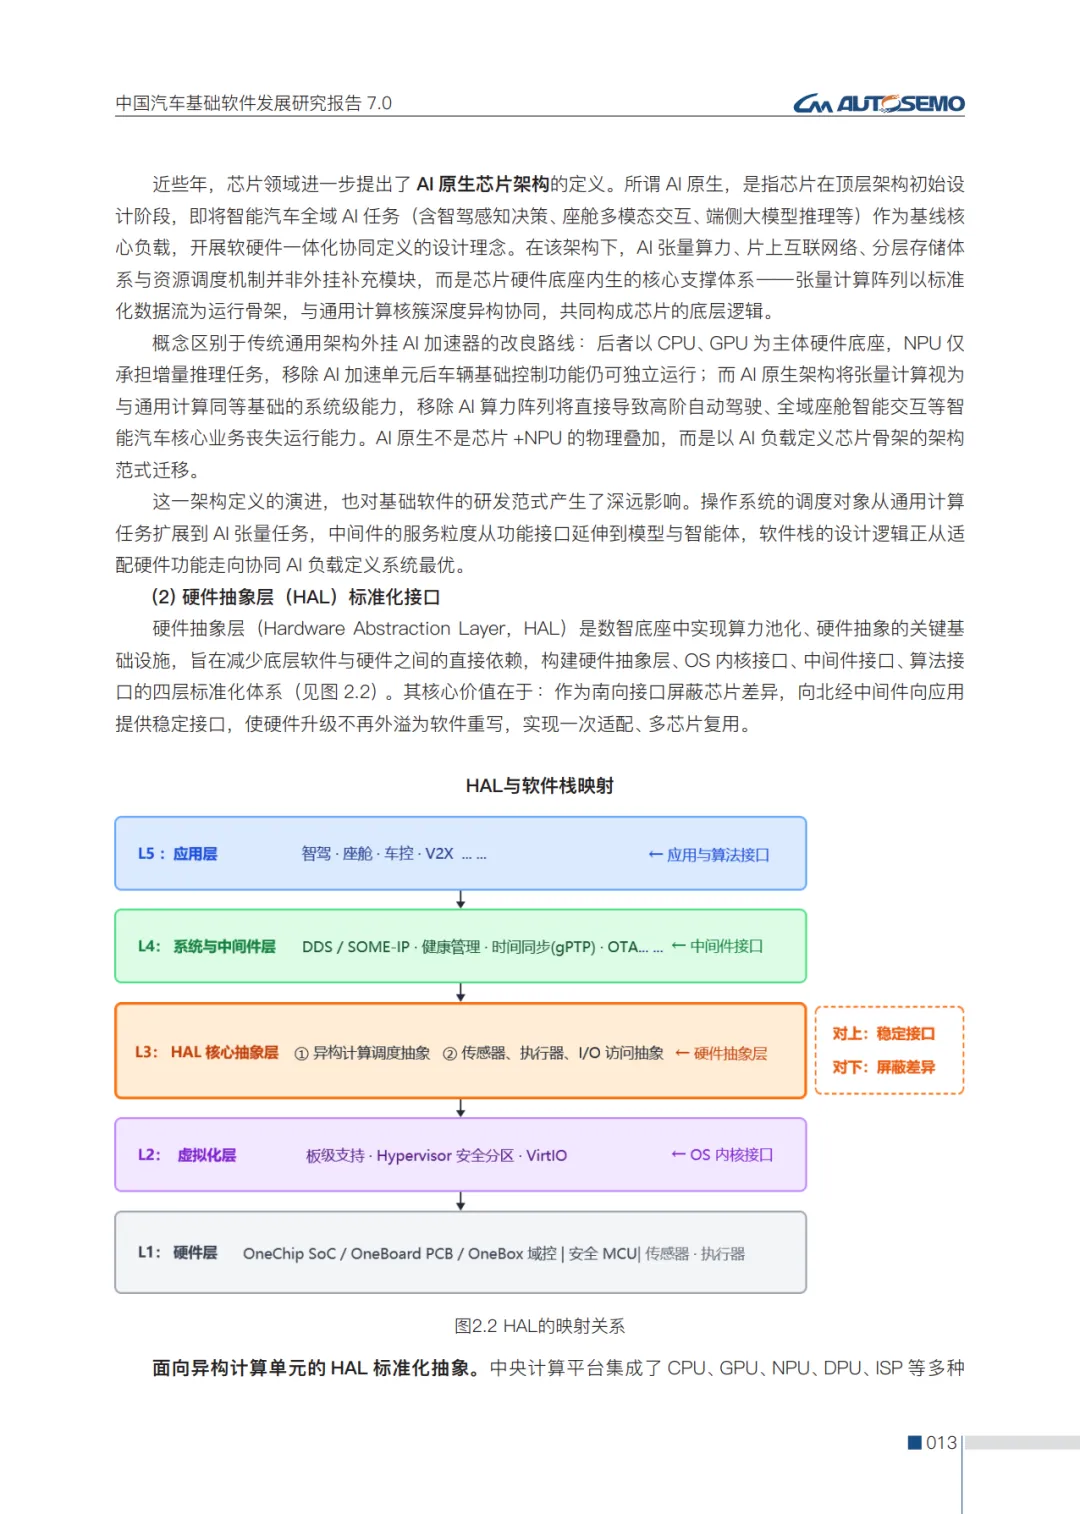
这份报告由 AUTOSEMO(中国汽车基础软件生态委员会)牵头、整车厂/Tier 1/芯片与基础软件厂商联合编写,清华大学李克强院士作序。开篇给出的产业坐标:国内乘用车市场多种电子电气架构并存,域集中式仍占主导,但中央计算架构装配量同比增长近 300%。整车正经历「硬件定义 → 软件定义 → AI 定义(AIDV)」的三段跃迁——分布式时代一辆车装 50–100 个 ECU,各管一段;中央计算时代收敛为 1–2 颗高性能 SoC,座舱、智驾、车控共用一个算力池。
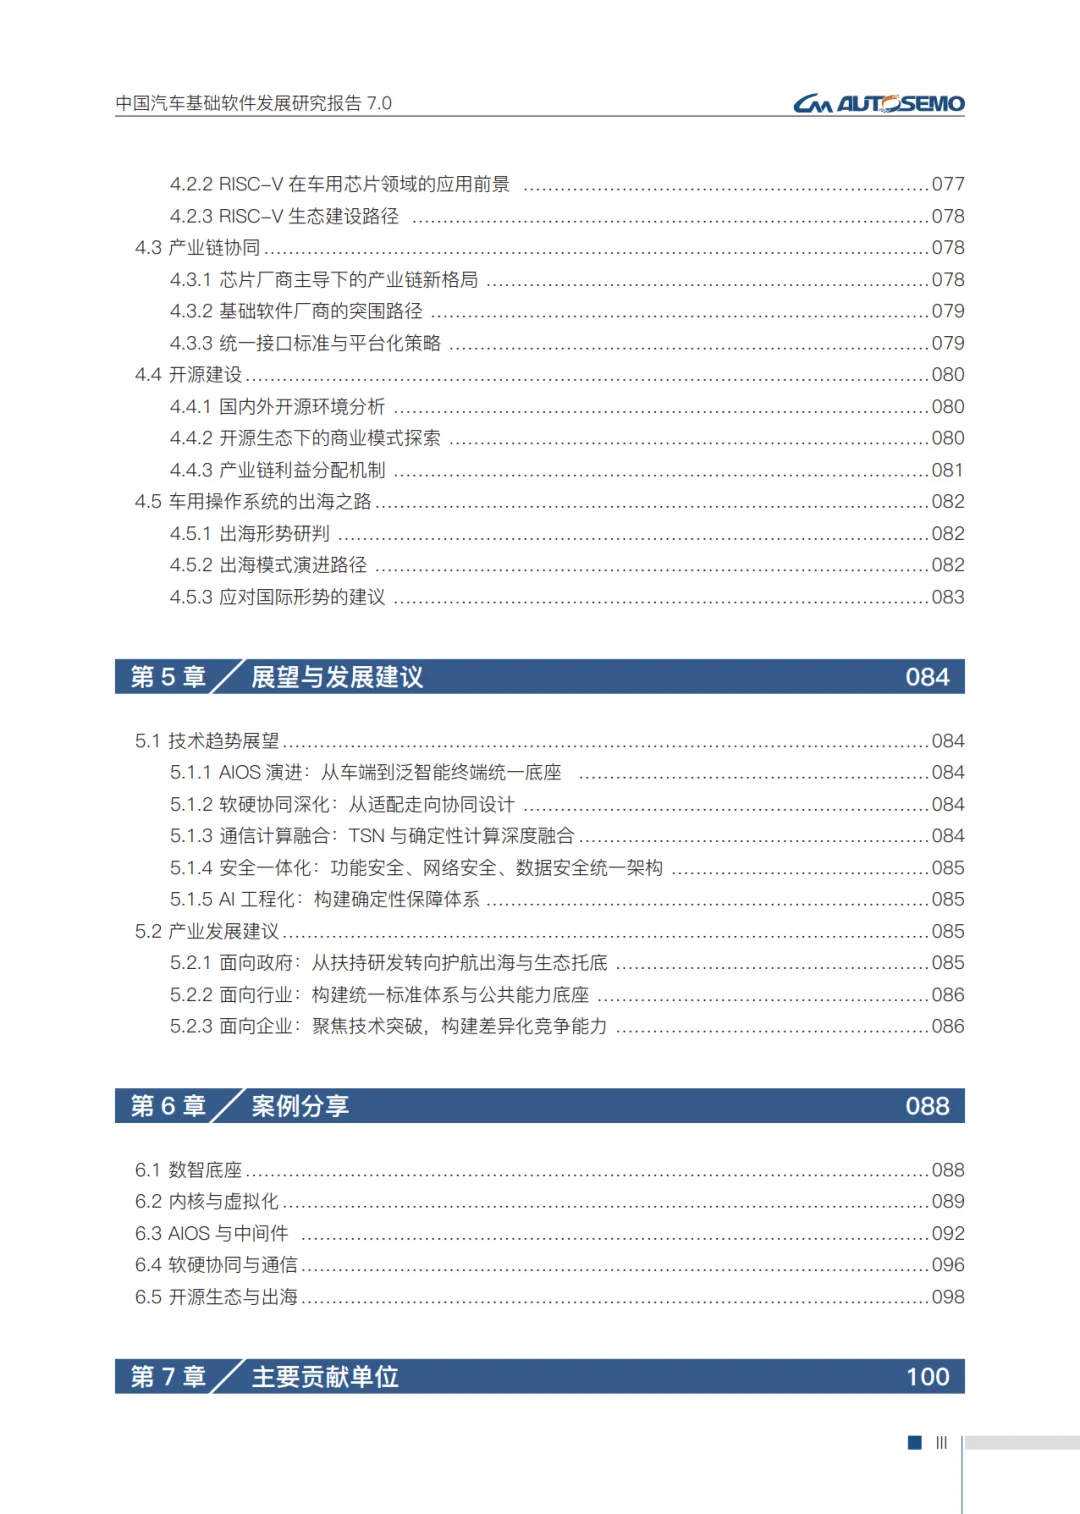
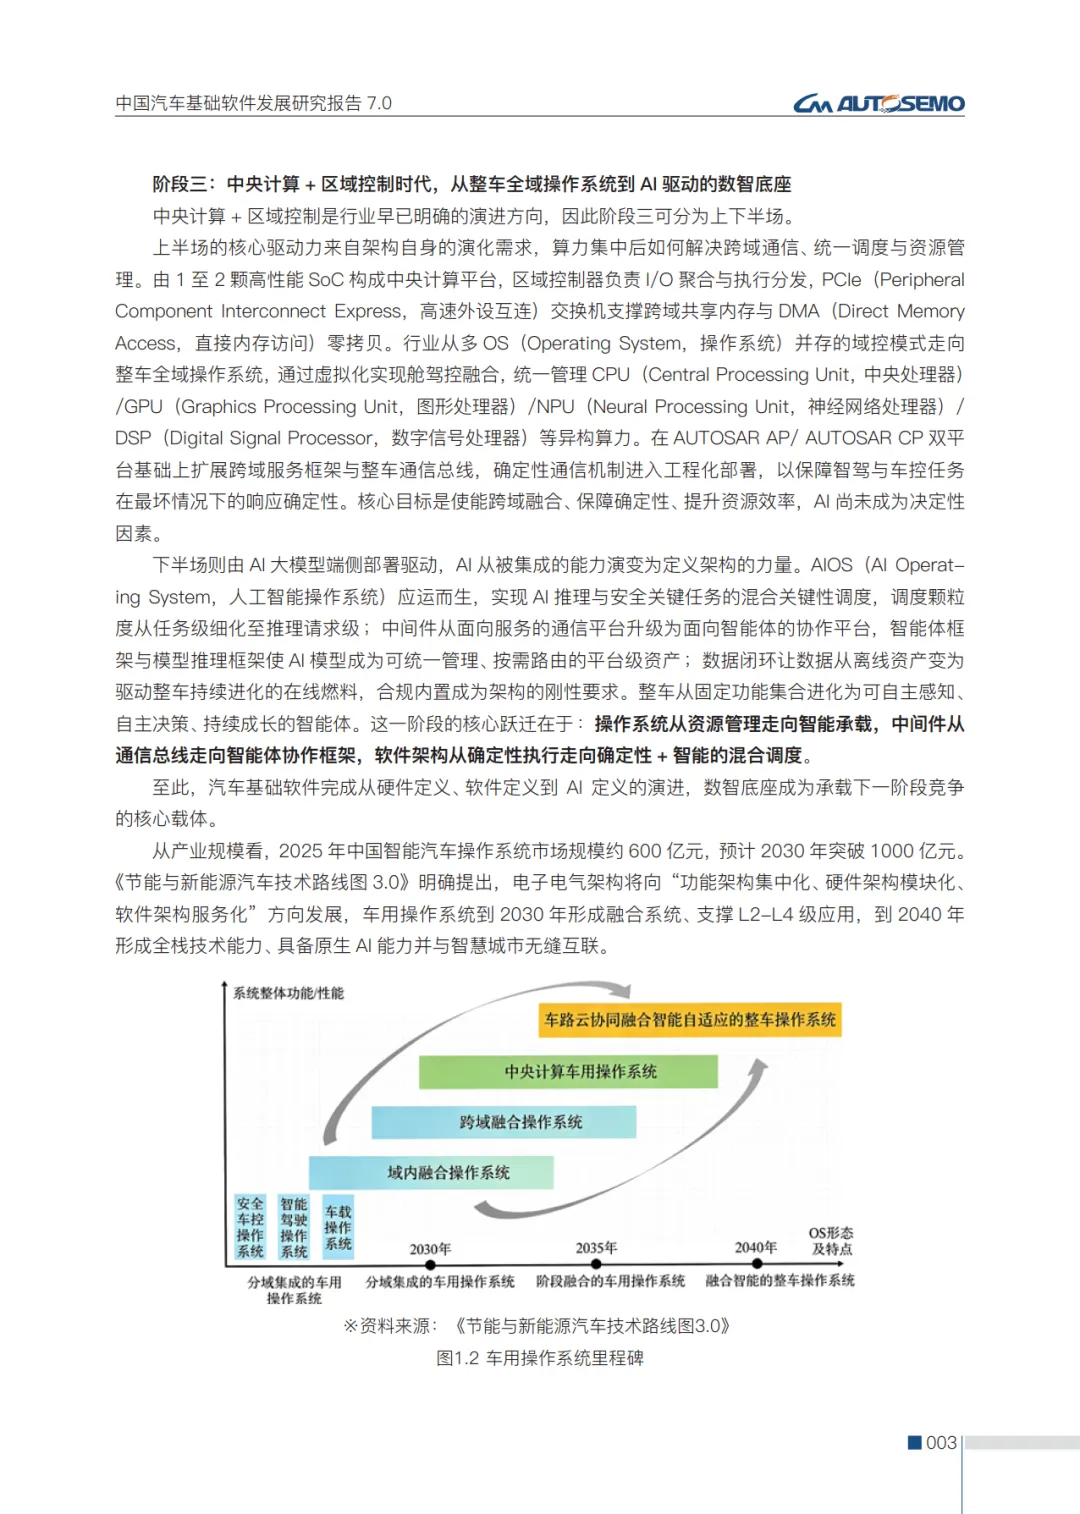
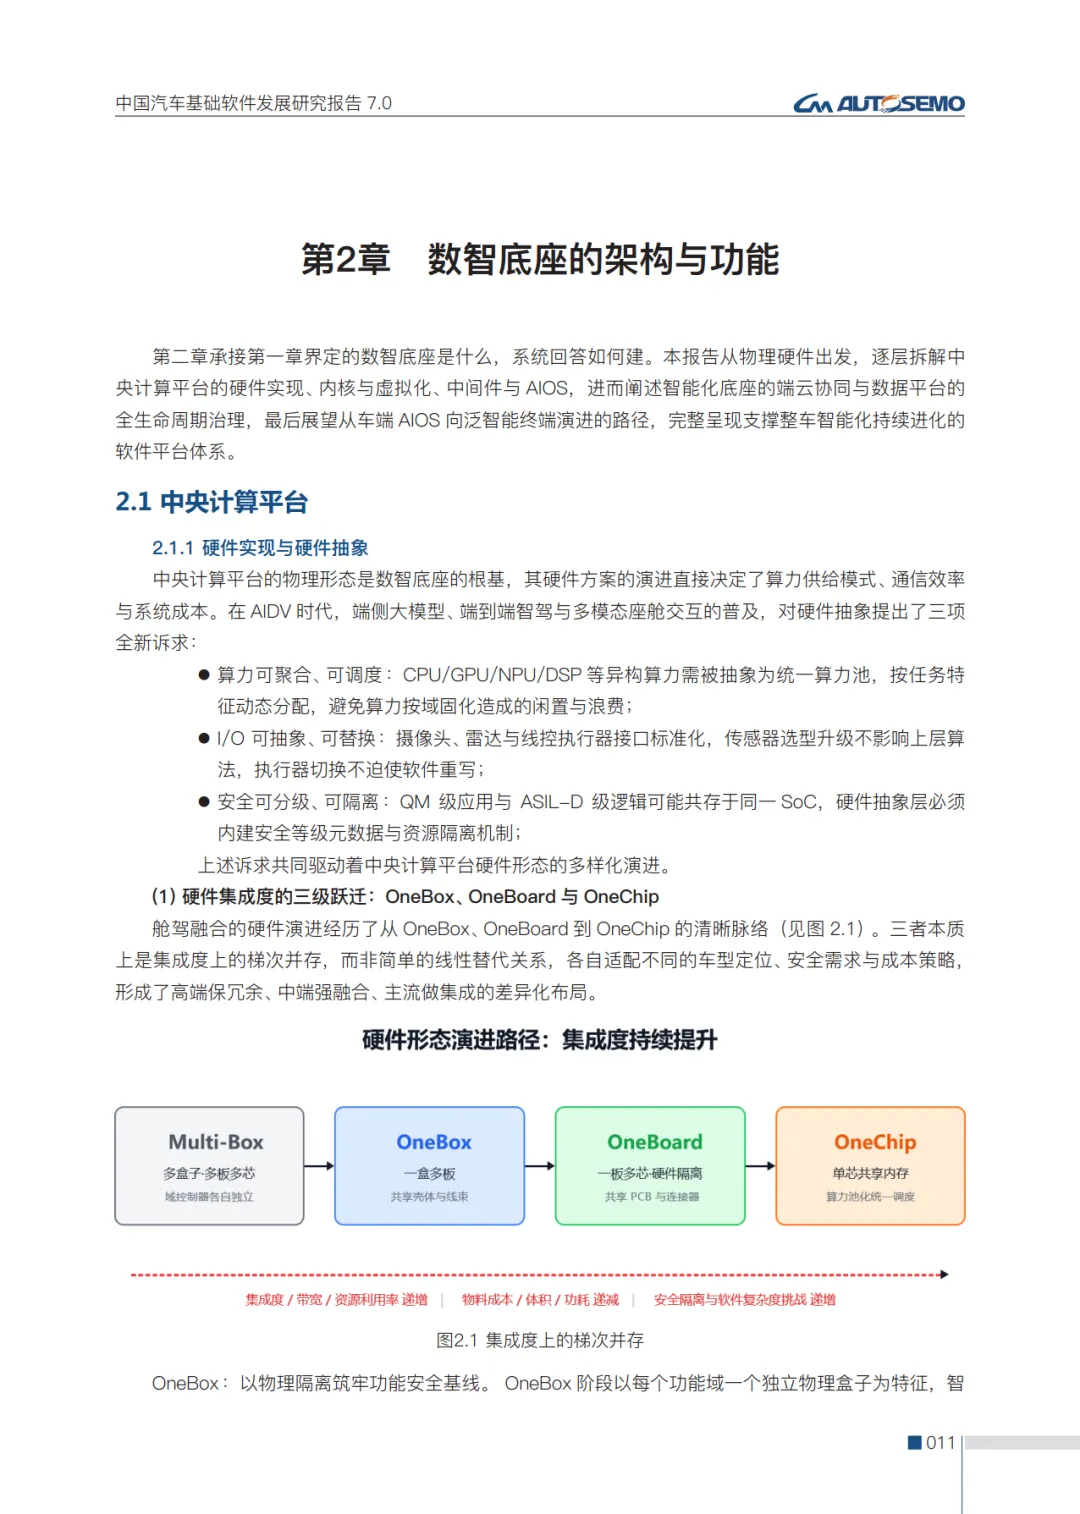
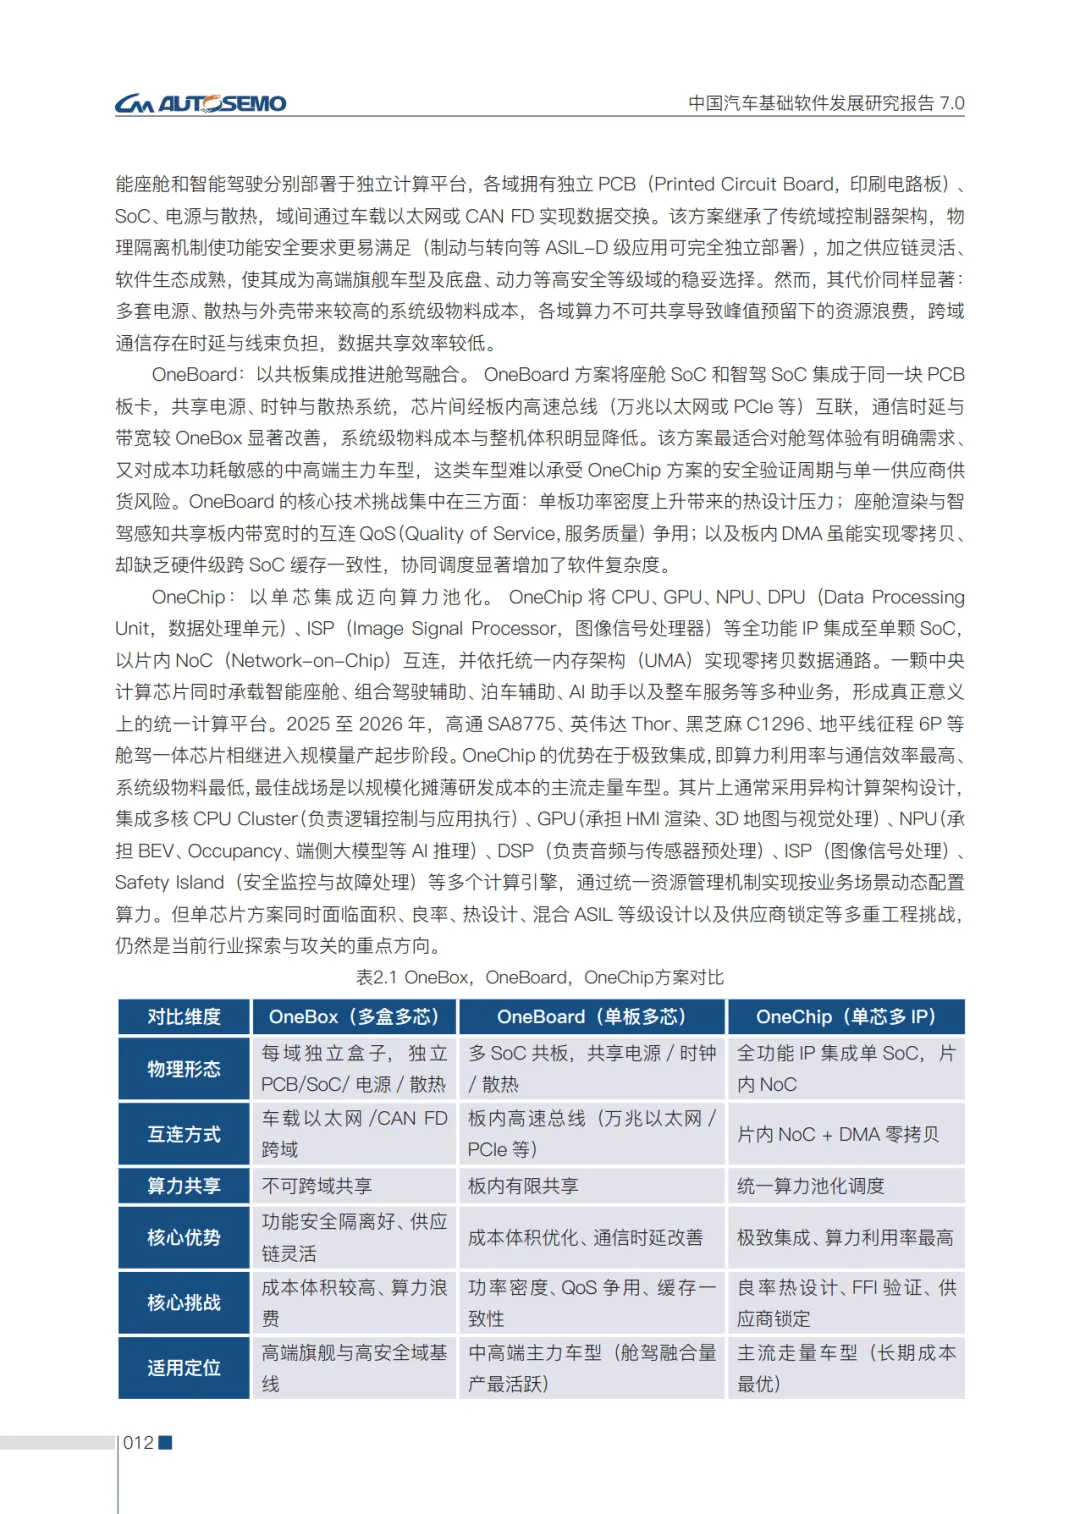
产业规模口径:2025 年中国智能汽车操作系统市场规模约 600 亿元,预计 2030 年突破 1000 亿元。报告提出的硬件演进三级路径——OneBox(每域一个独立盒子)→ OneBoard(舱驾 SoC 共板)→ OneChip(单芯集成全部 IP)——分别对应高端保冗余、中端强融合、主流做集成:三条路线梯次并存,不是谁取代谁。
全书最硬核的一笔账:智驾闭环 50 毫秒,装不下 7B
营销语境里「大模型上车」说得轻巧,报告第 2.2 节算的是物理账。大模型推理分两个阶段:Prefill 吃算力,Decode 是带宽受限负载——单 Token 生成耗时 ≈ 参数量 × 数据位宽 ÷ 有效存储带宽,跟芯片标称的 TOPS 没有直接关系。这就是为什么堆算力参数救不了端侧大模型。
代入数字:当前量产主流的 LPDDR5X 有效带宽约 200GB/s,在 50ms 智驾闭环时延约束下,只能稳定运行 1B–4B 的轻量模型;即便下一代 LPDDR6/GDDR7 把带宽提到 500GB/s,7B 模型仍需解码优化才能达标;而 70B–130B 的稠密大模型,无论当前还是远期车规硬件都进不了智驾闭环,只能走云端或 MoE 稀疏化路线。报告的结论相当不留情面:4bit 量化已逼近精度下限,带宽优化红利基本耗尽,未来 2–3 年存储带宽将是不可逾越的硬件壁垒。做车载 AI 规划的人,建议把这张「车端模型部署硬件匹配表」贴在会议室——它比任何宣传页都诚实。
另一道硬门槛:一千万行代码的 Linux,过不了 ASIL-D
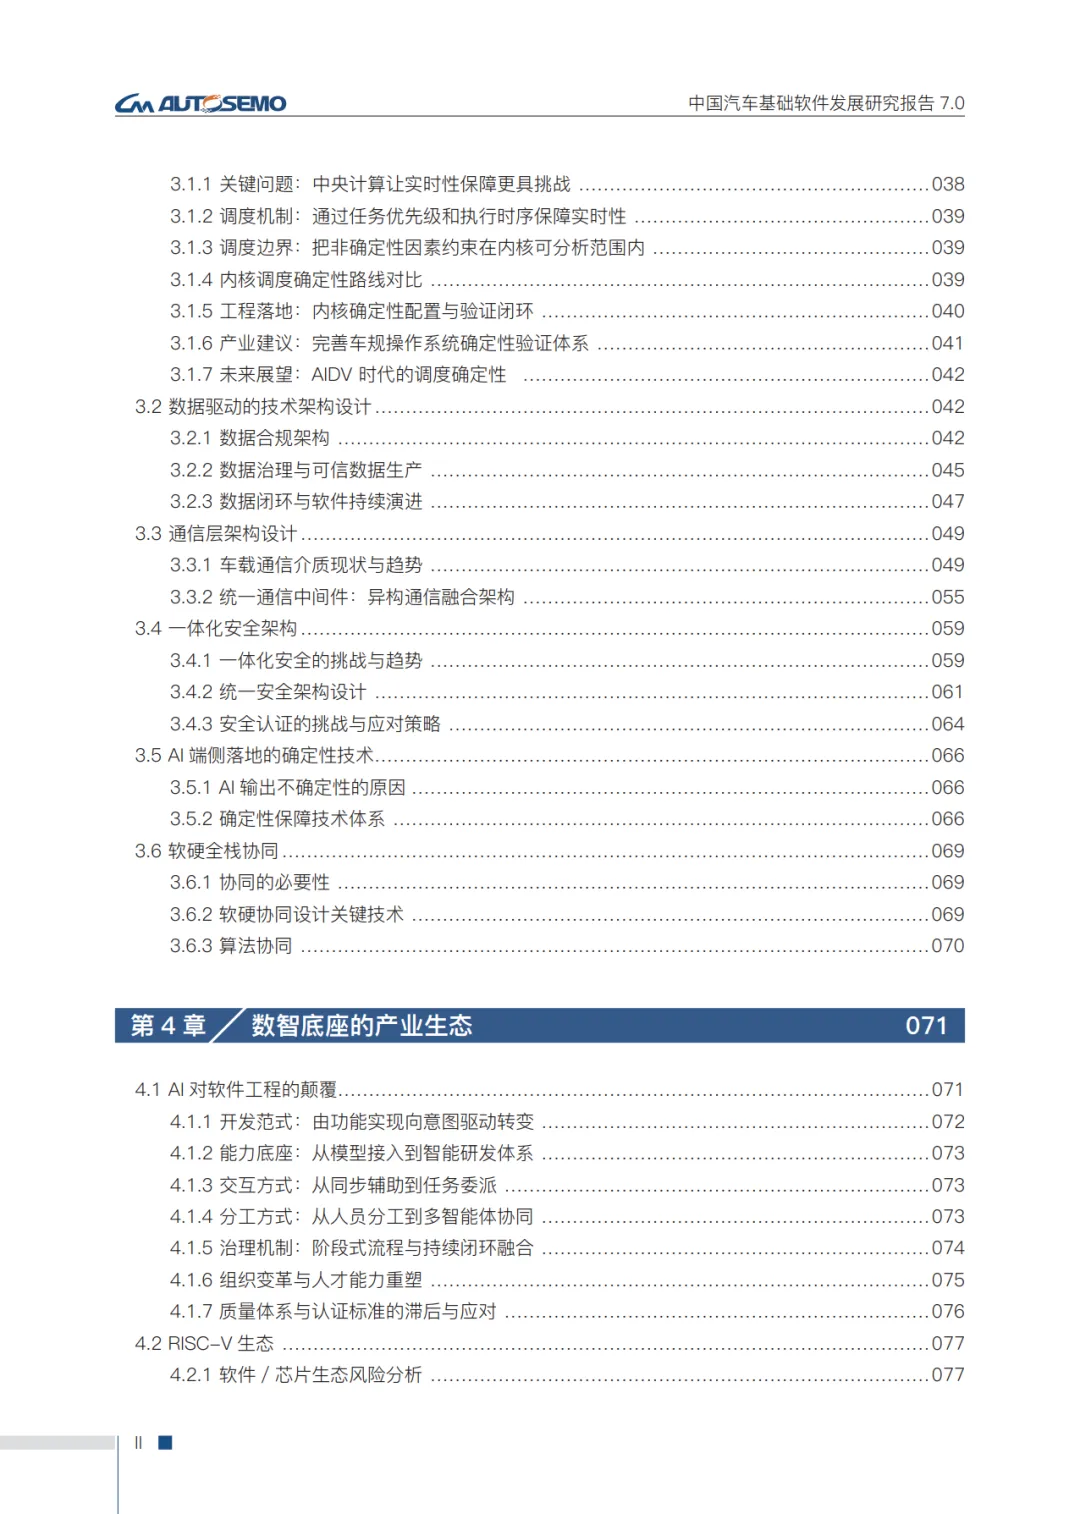
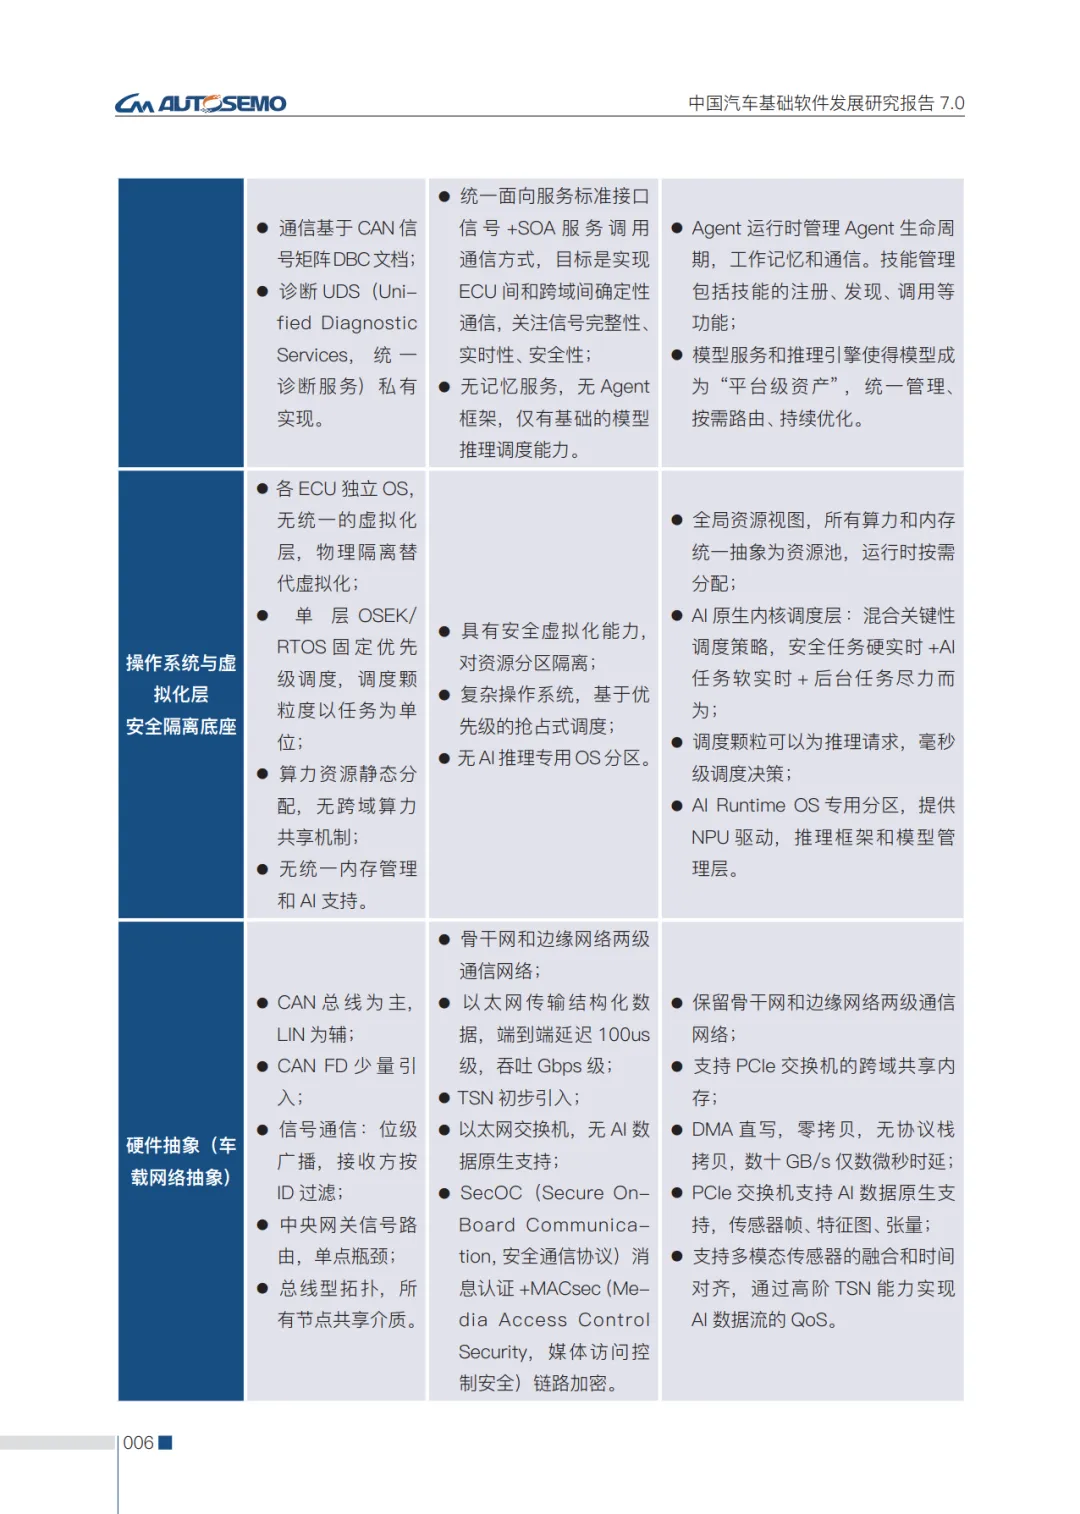
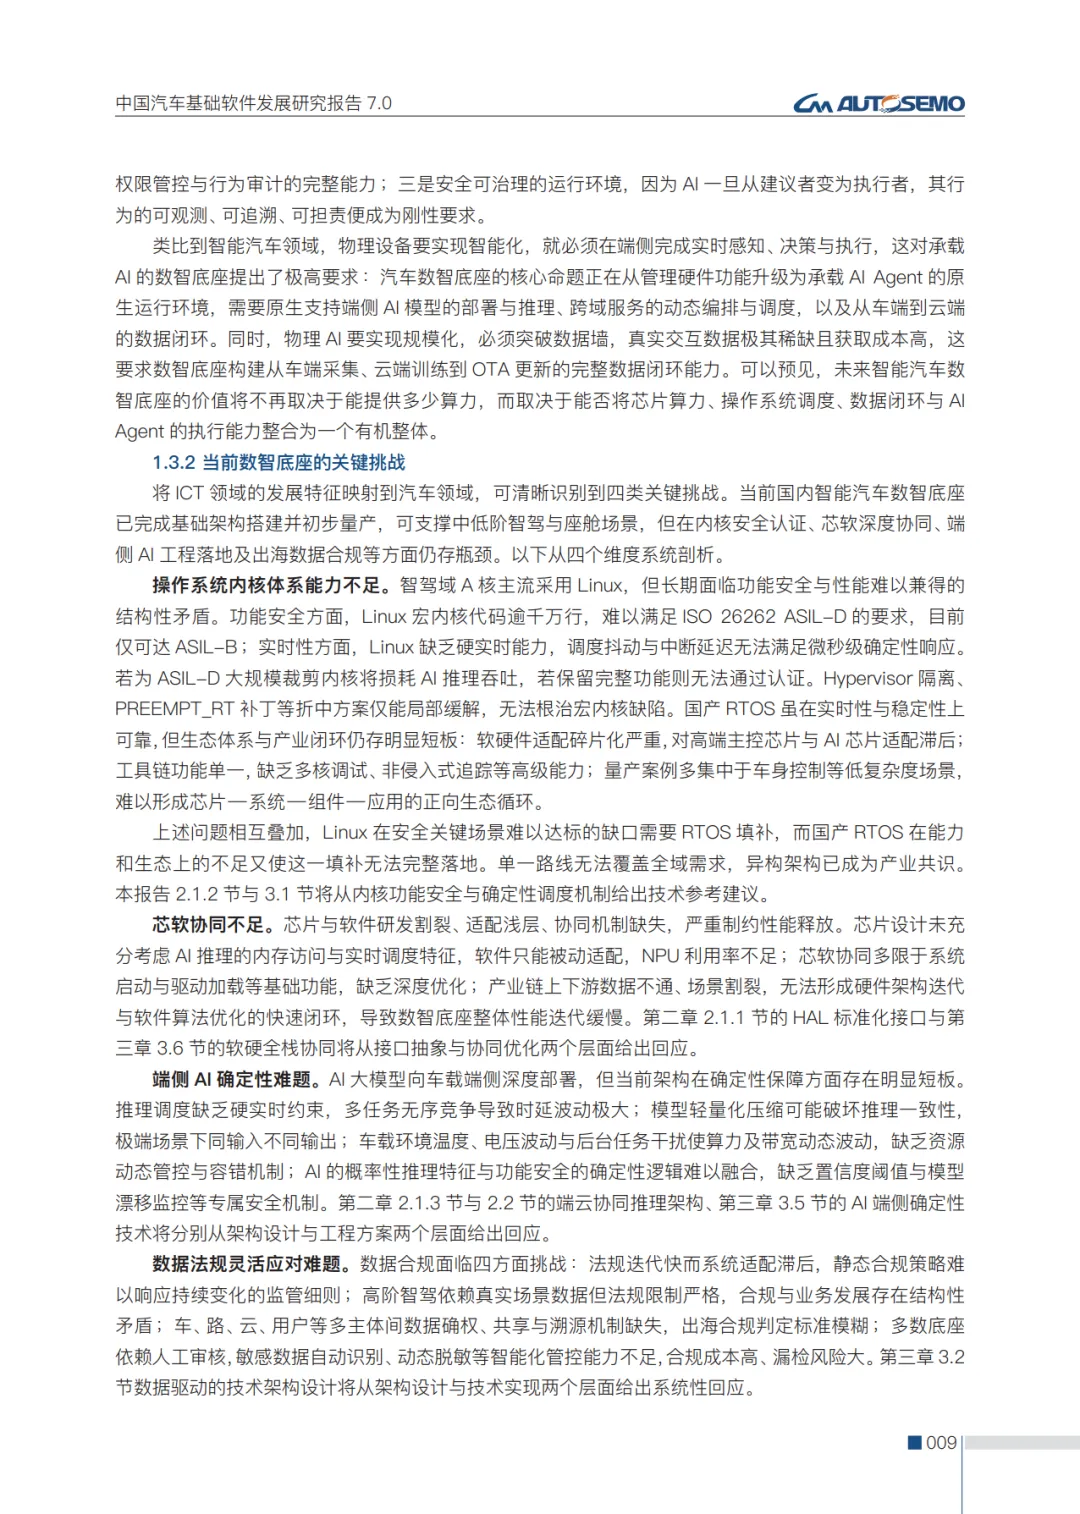
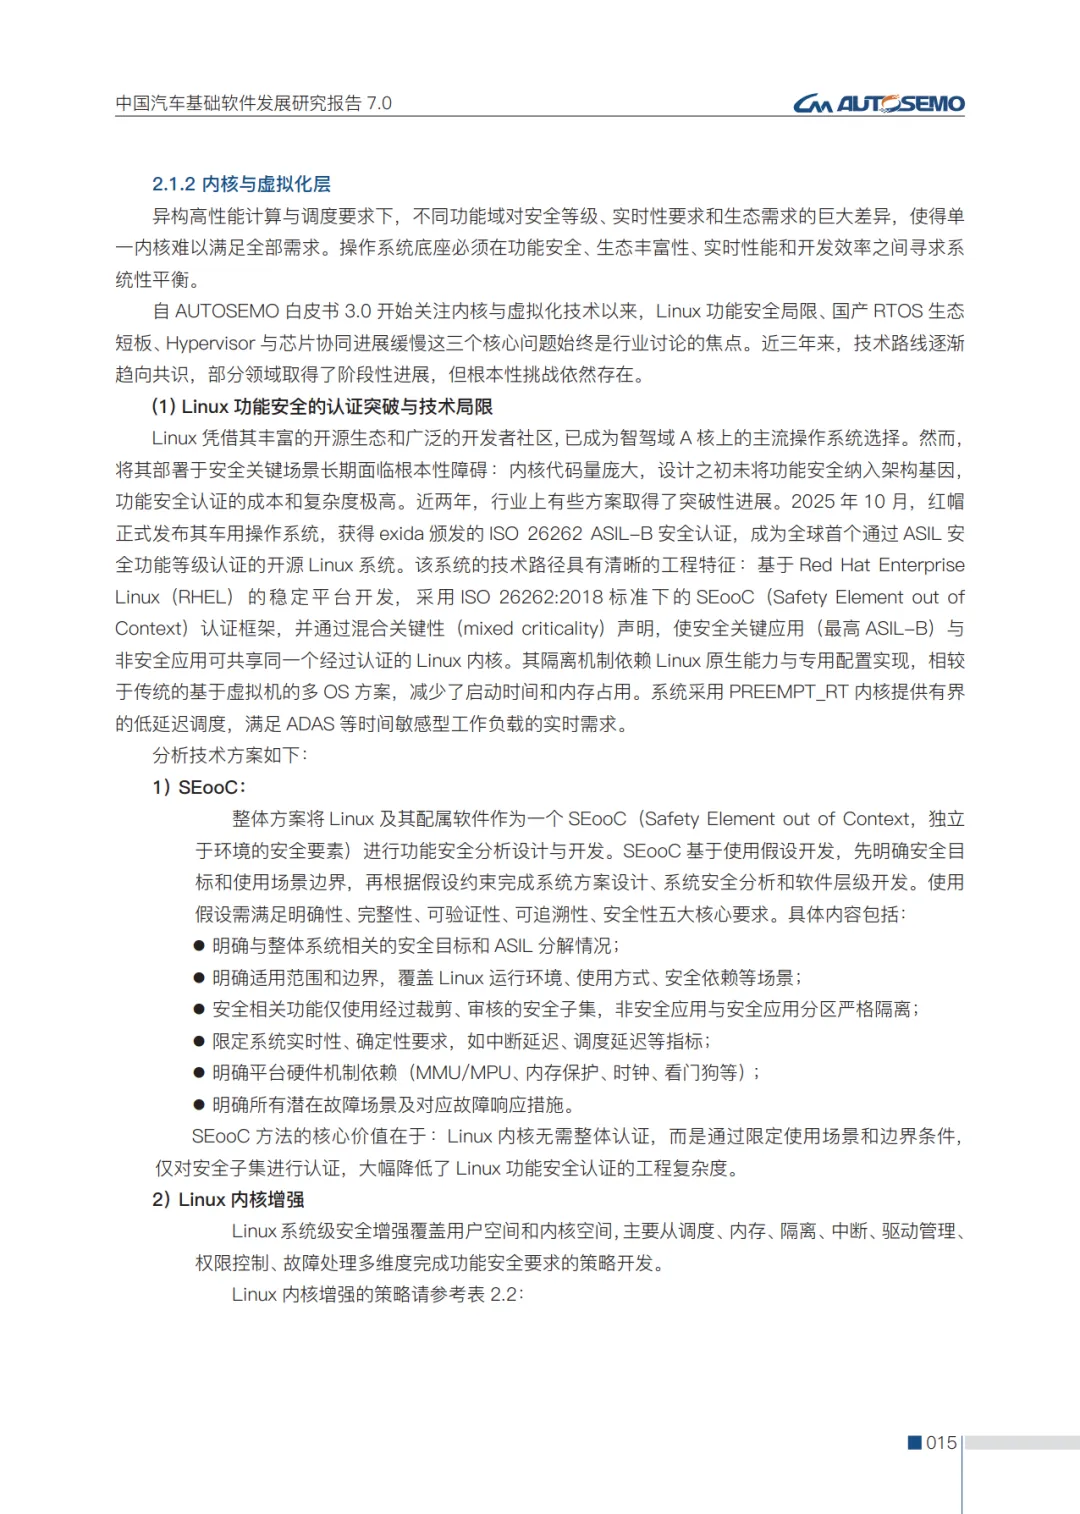
智驾域 A 核主流用 Linux,但报告点破了结构性矛盾:Linux 宏内核代码逾千万行,难以满足 ISO 26262 ASIL-D 要求,目前仅可达 ASIL-B;若为高安全等级大规模裁剪内核,会损耗 AI 推理吞吐,保留完整功能又通不过认证。2025 年 10 月红帽发布车用操作系统,成为全球首个通过 ASIL-B 认证的开源 Linux,路径是 SEooC 框架——不认证整个内核,只认证限定了使用假设的安全子集。但报告同时提醒:这类认证是「有限定条件的认证」,依赖预定义硬件平台,且 Linux 社区快速迭代的节奏与功能安全完整回归验证的要求之间存在结构性矛盾,尚未根治。
确定性这块国产 RTOS 有亮眼数据:在典型车控任务模型下,通过精确周期调度与静态核心绑定,周期激活响应抖动可控制在 10 微秒量级以内。但报告同样直言生态短板——第三方驱动支持滞后、工具链与 QNX 有差距、装车量刚起步。结论是产业共识式的:单一路线覆盖不了全域需求,RTOS 管硬实时、Linux 承载生态、虚拟化做隔离,异构混合部署是长期形态。
AI 写代码快了数倍,缺陷率没降
报告第 4.1 章对 AI 辅助开发的观察,放在任何软件行业都成立。悖论是:代码生成速度快了数倍,端到端交付质量并未等比例改善。根源有四:一是证据链断裂——AI 同时生成代码和测试,两者共享同一知识库,测试倾向于避开代码的真实弱点,形成「表面通过、实质缺陷」的幻觉验证;二是非确定性缺陷——同一 Prompt 不同时刻生成不同代码,缺陷在 1% 的罕见边界条件下爆发,从根本上挑战了「缺陷可复现」的工程假设;三是语义幻觉不可追溯;四是现有认证体系失效——ASPICE「过程决定质量」的因果链被 AI 的不确定性打破,组织从 L2 升到 L3,AI 代码缺陷率并未下降,因为幻觉来源根本不在流程管控范围内。
给出的工程对策很具体:建立 AI 溯源档案——每段 AI 生成代码附带 Prompt 原文、模型版本、时间戳、温度参数、重试次数;构建「形式检查 → 等效性验证 → 缺陷注入测试」三层验证,并由人工编写核心验证用例作为最后一道卡点。一句话总结报告的立场:下一代质量体系的核心原则,应从「消除不确定性」转向「管理不确定性」。
第三个冷数字:90% 的车端数据是废料
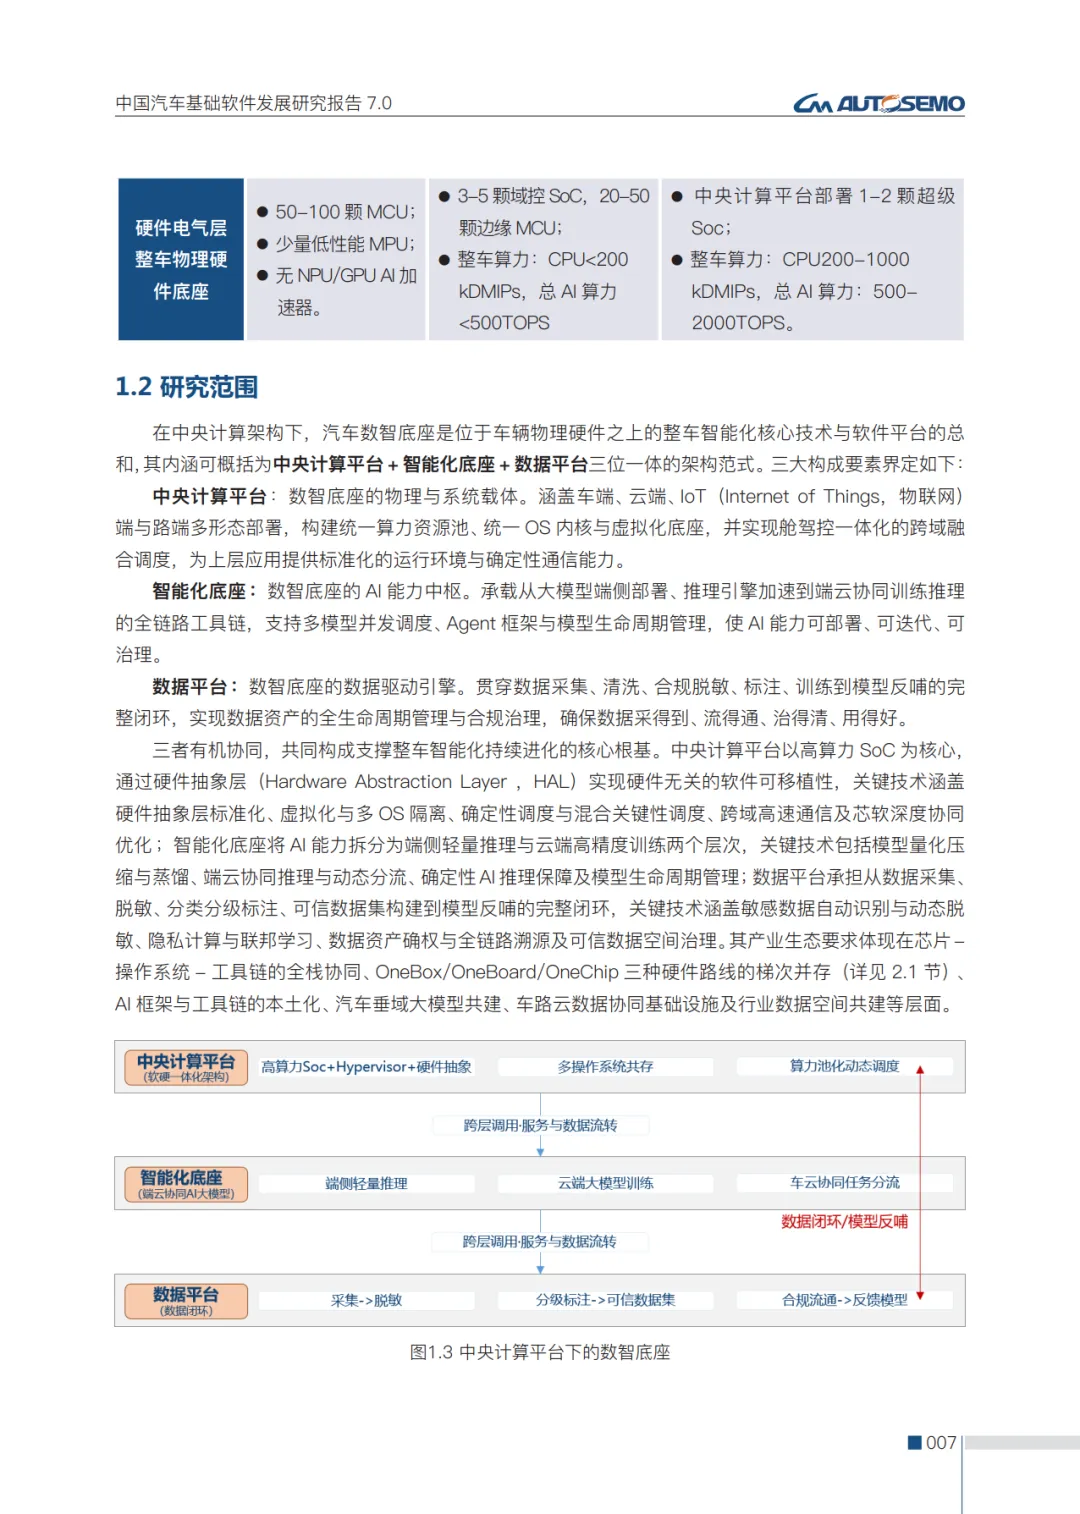
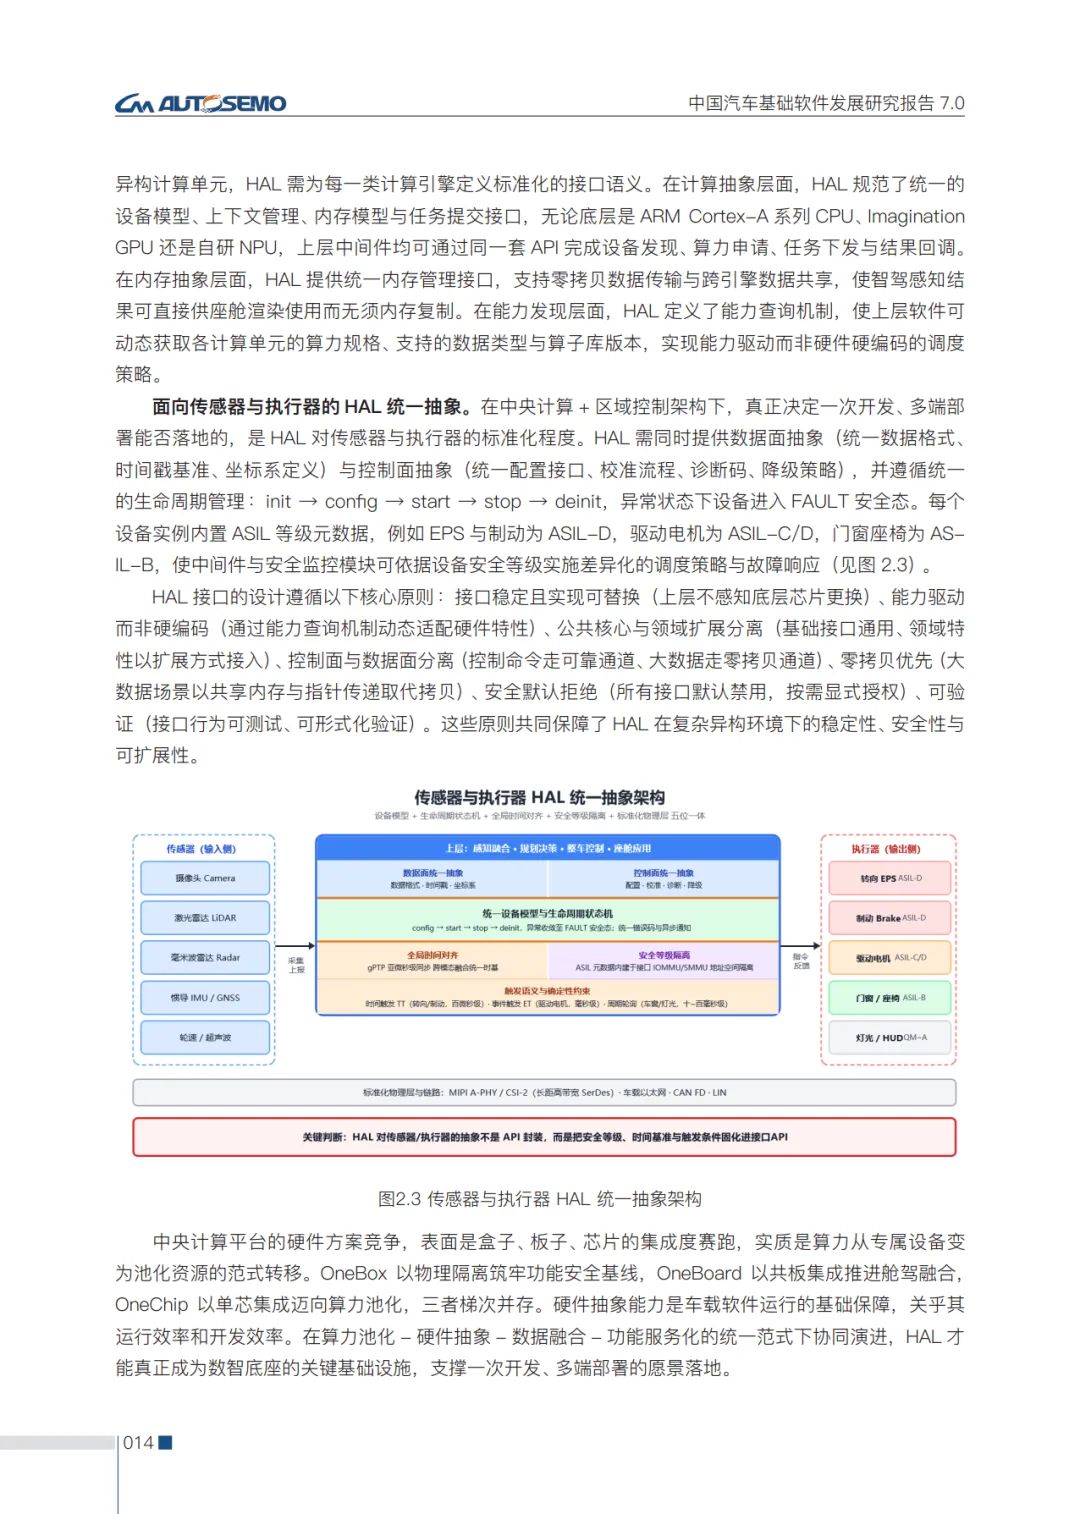
数据闭环被宣传了这么多年,报告给出了价值密度的真相:车端原始数据 90% 以上为重复或无效信号,传统全量采集、离线存储的模式成本高昂,有效场景被淹没在噪声里。智驾模型能力上限取决于稀疏却关键的 Corner Case(极端场景)数据——如何识别、采集、利用这些高价值低概率场景,才是制约 AI 上车速度的瓶颈。配套的提效数字:AI 预标注加人工校验,可将数据标注效率提升 80% 以上;数据合成正从辅助工具升级为核心生产资料,用极低成本生成暴雨、事故、异形障碍物等长尾场景。
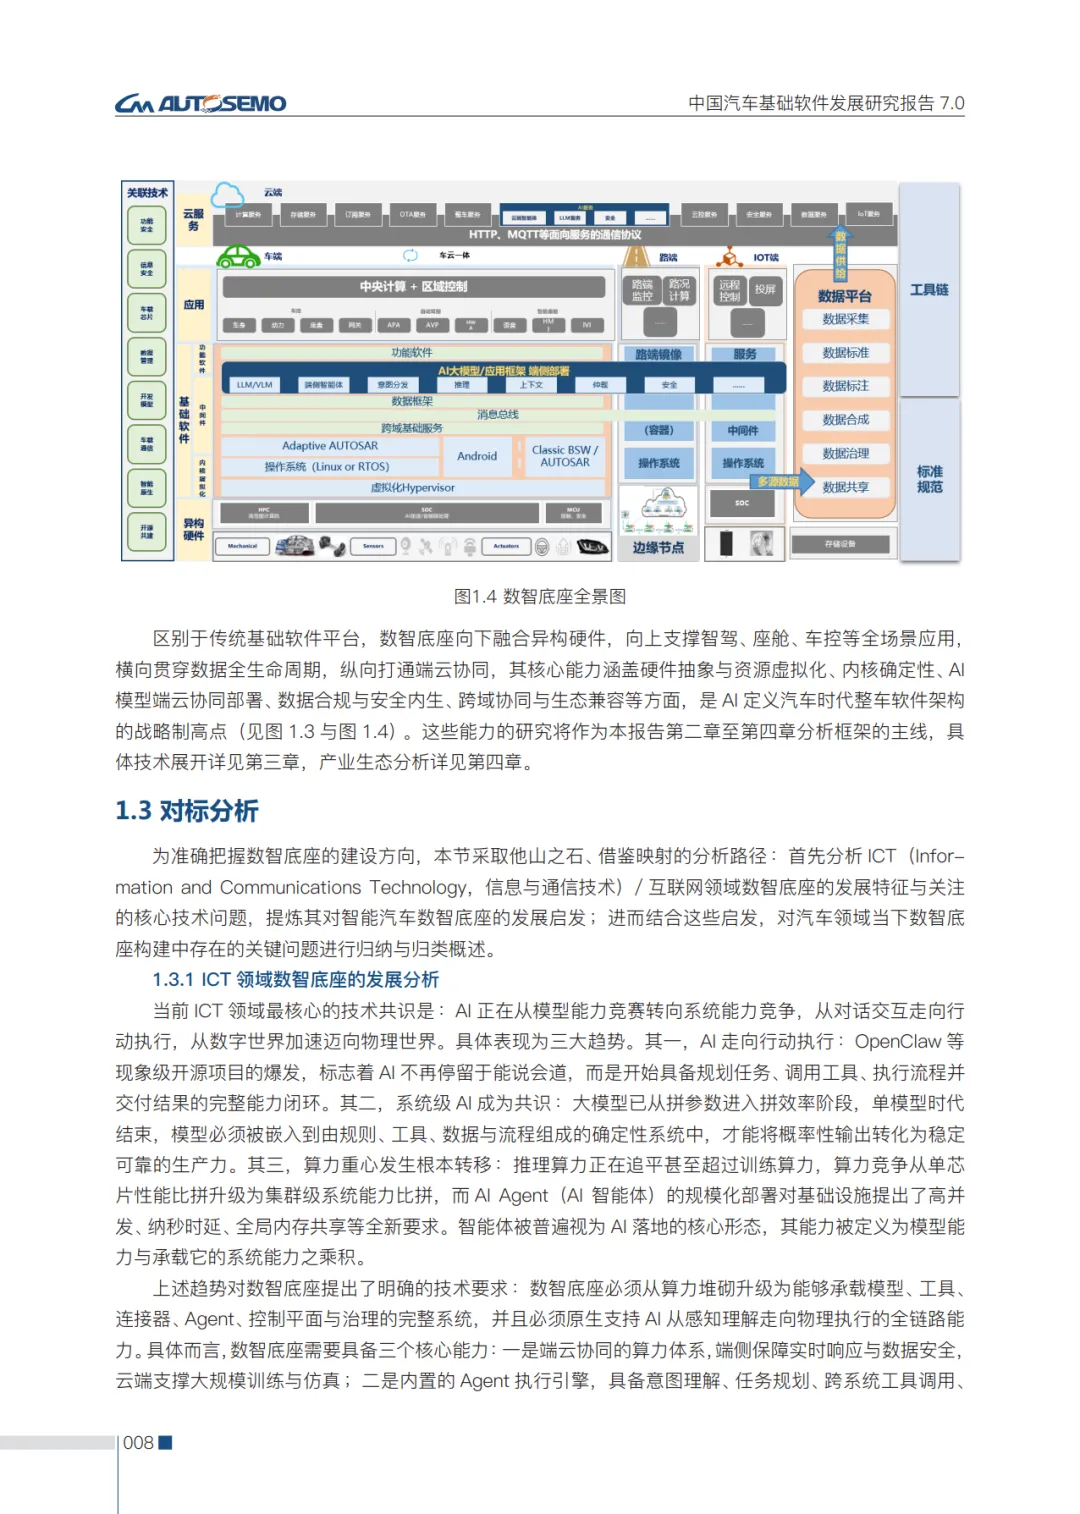
产业格局部分还有一组值得记住的数字:高通智能座舱芯片在中国市场占有率已超 70%,过去三年支持了 210 多款中国智能车型发布,中国车企为其汽车芯片业务贡献超 60% 的营收。芯片厂商正凭借「芯片—OS—工具链」的全栈闭环重塑产业链权力结构——报告的原话是:整车企业差异化空间被压缩,Tier 1 面临管道化风险,利润加速向上游集中。作为行业组织的 AUTOSEMO 给出的对策是「分层解耦、开放协作」:一个健康的产业链不应由单一环节通吃全栈,否则行业就陷入「要么全栈自研、要么被生态锁定」的两难。
大模型能不能上车,从来不取决于发布会上的参数表,而取决于 50 毫秒内、200GB/s 的带宽里,装得下几 B 参数。
以上为节选,关注本公众号,后台回复“宁智能分享”获得下载完整文档网址。
来源:中国汽车基础软件生态委员会
【推荐阅读】
GB 44721-2026 智能网联汽车 自动驾驶系统安全要求