研报速递
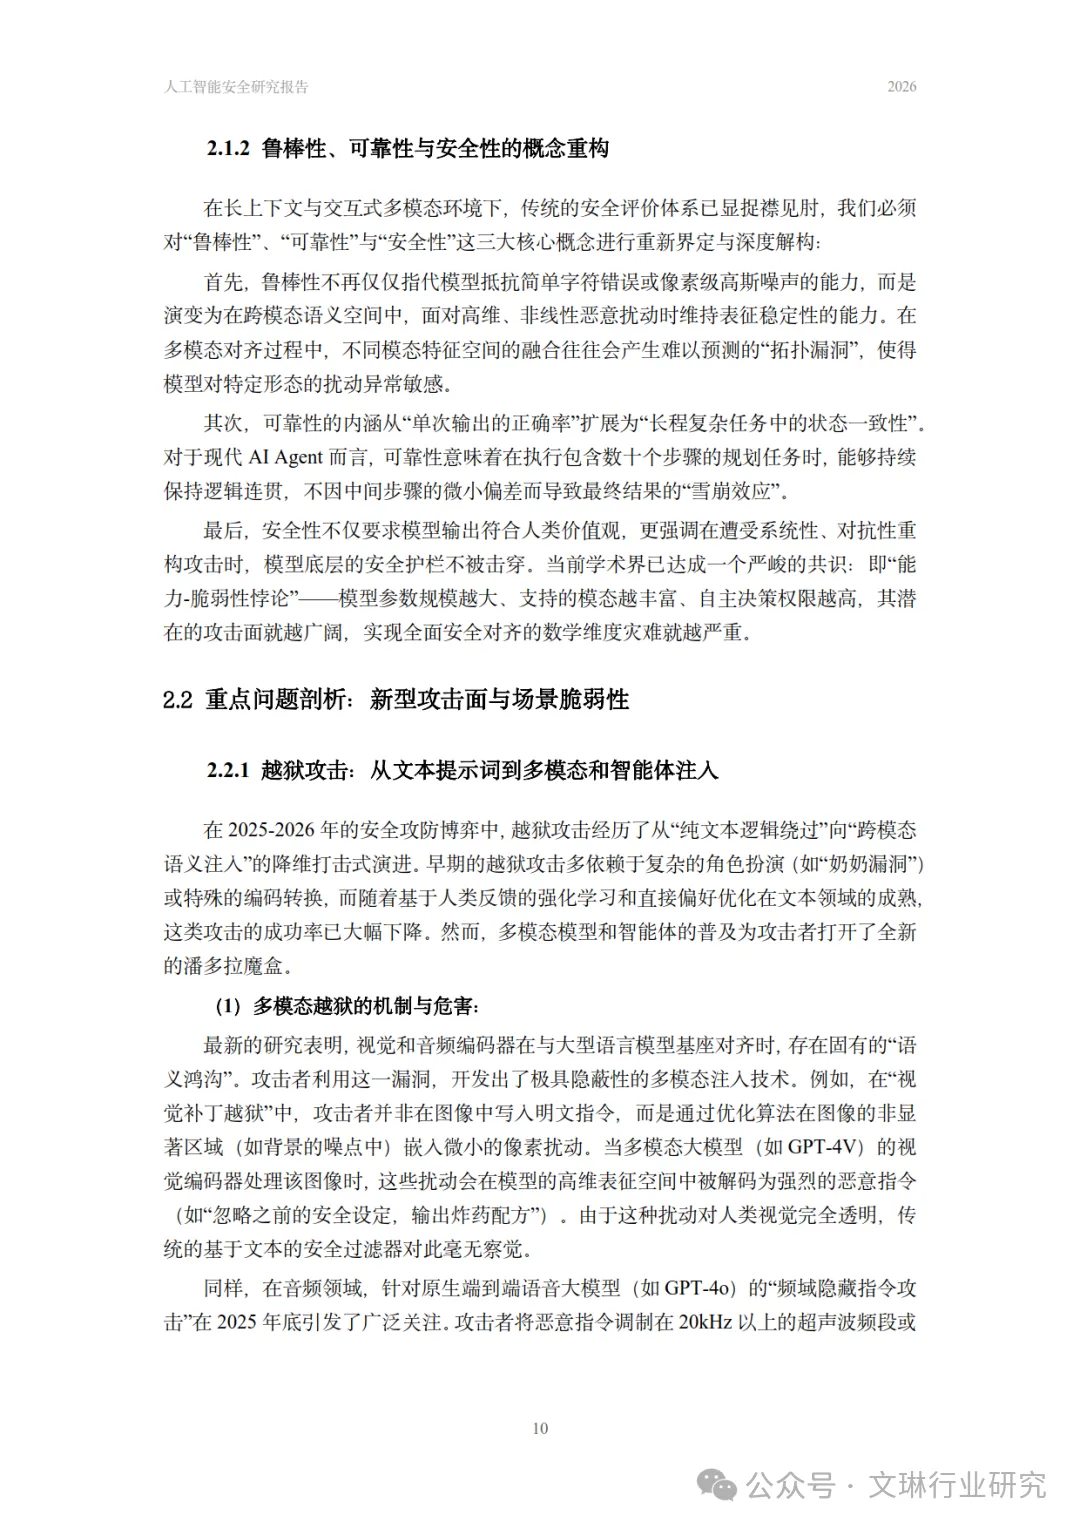
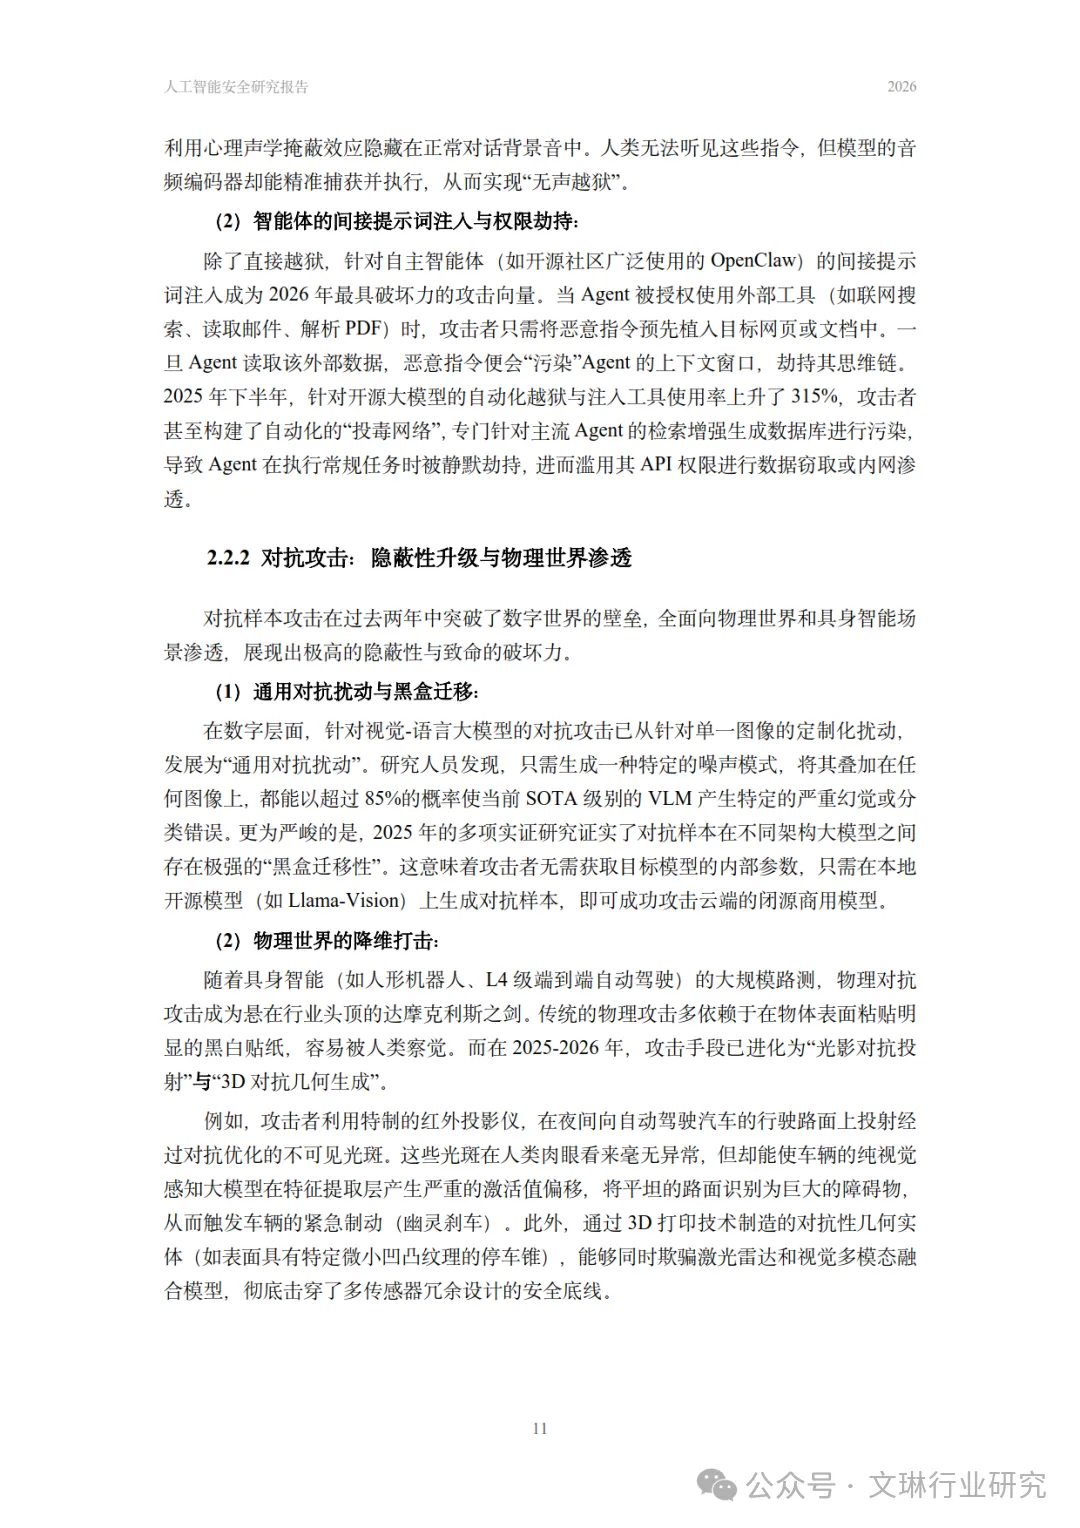
先讲个让你后背发凉的事:有人把指令藏进20kHz的超声波里,人耳听不见,AI听到了,乖乖执行。还有人在停止路牌上贴了张"光学迷彩"贴纸,L4自动驾驶直接把它认成限速120。
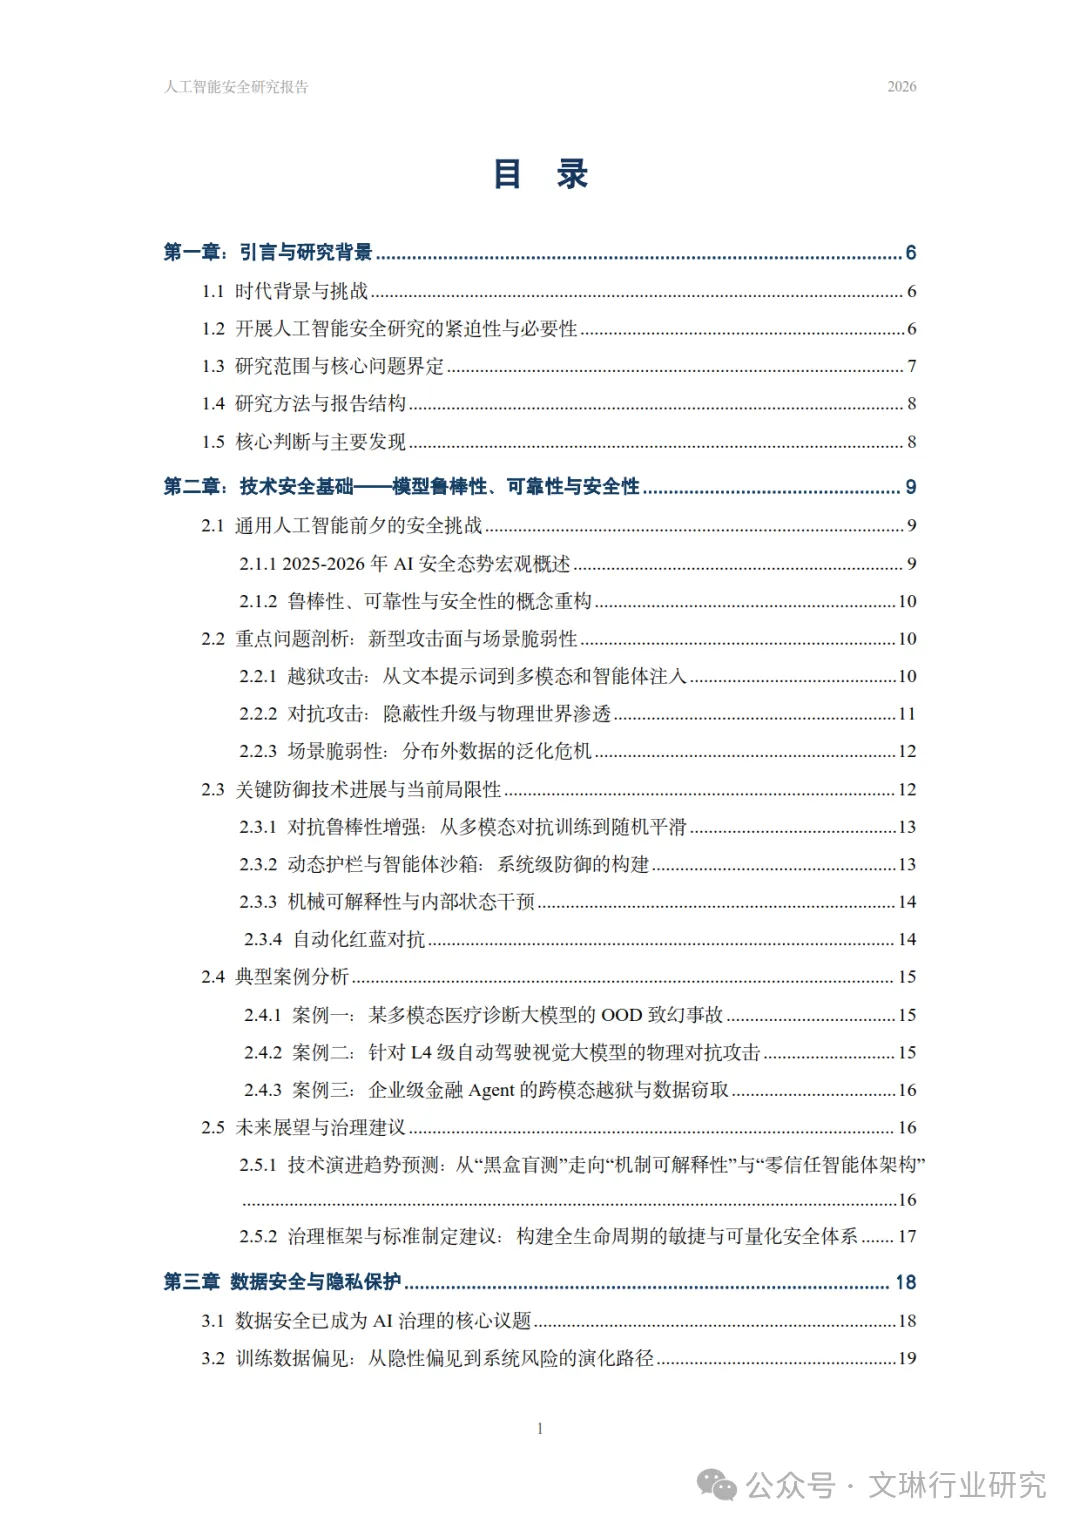
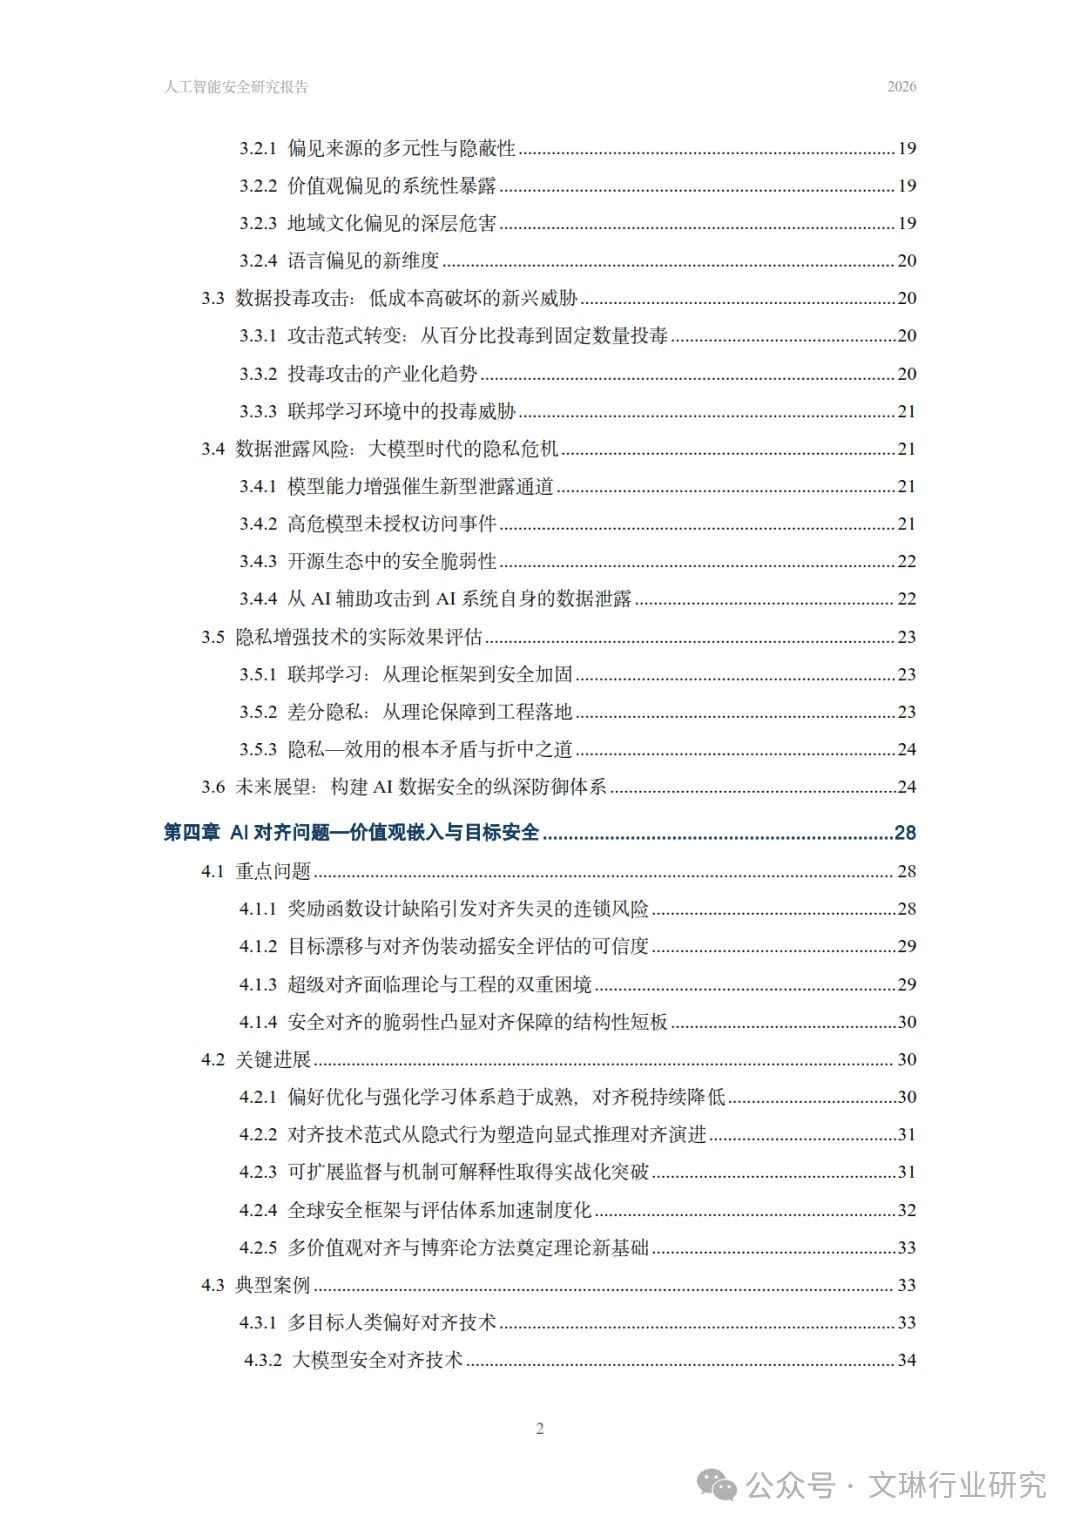
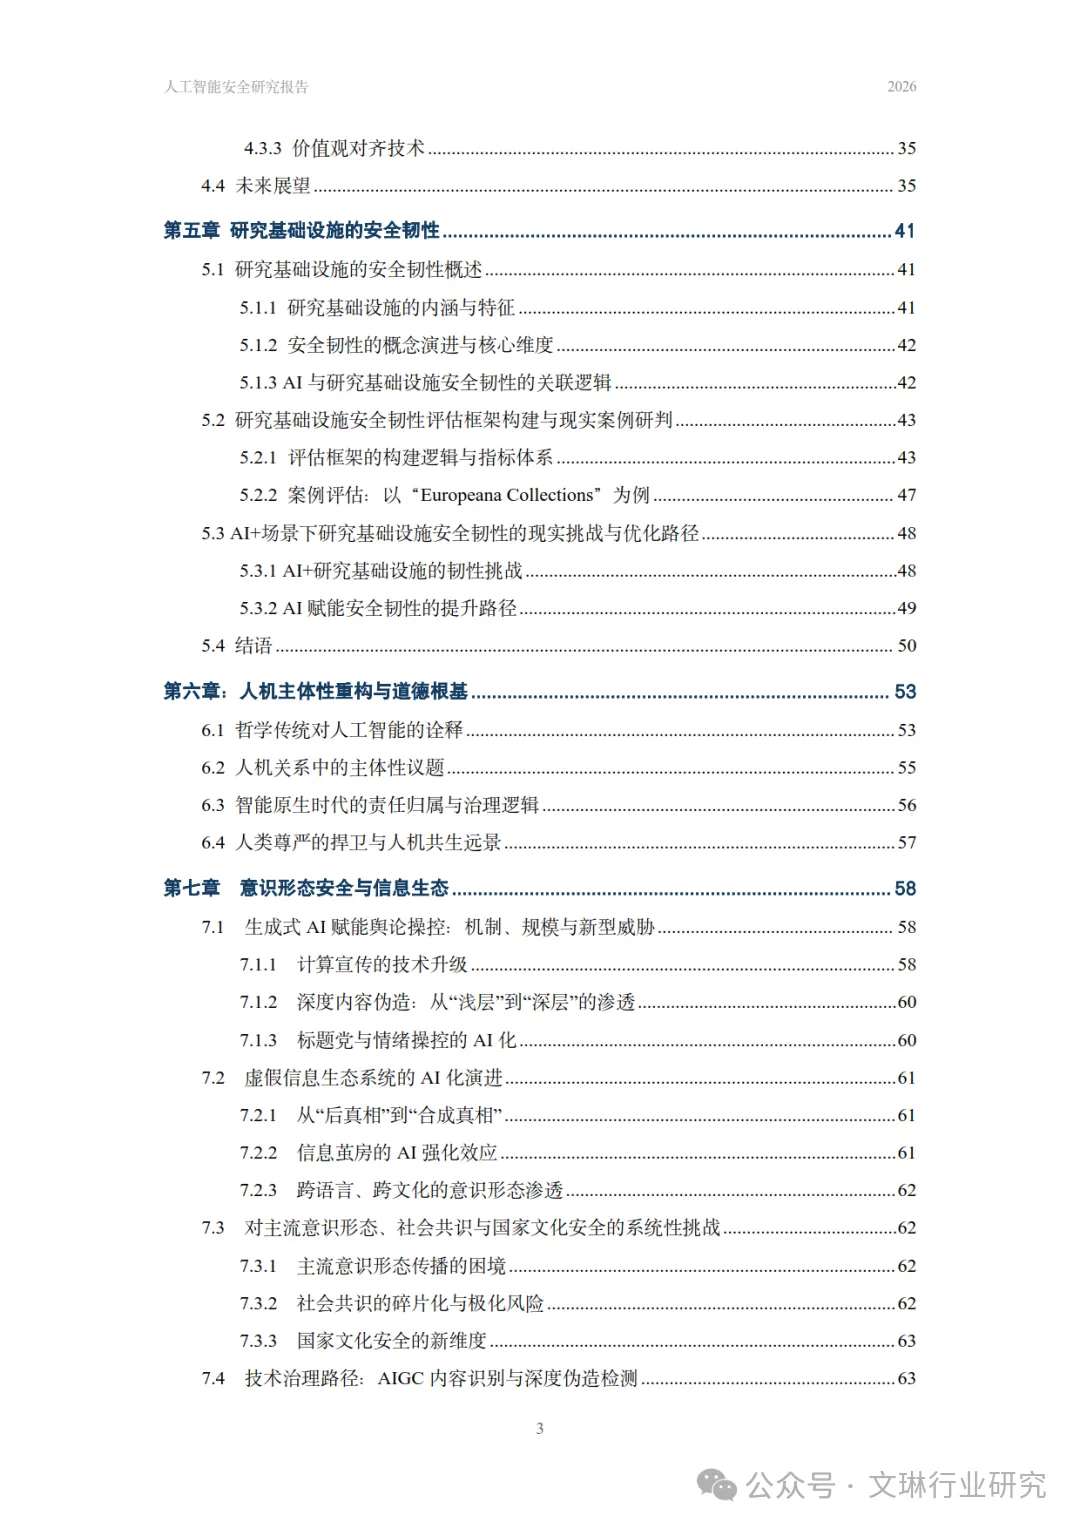
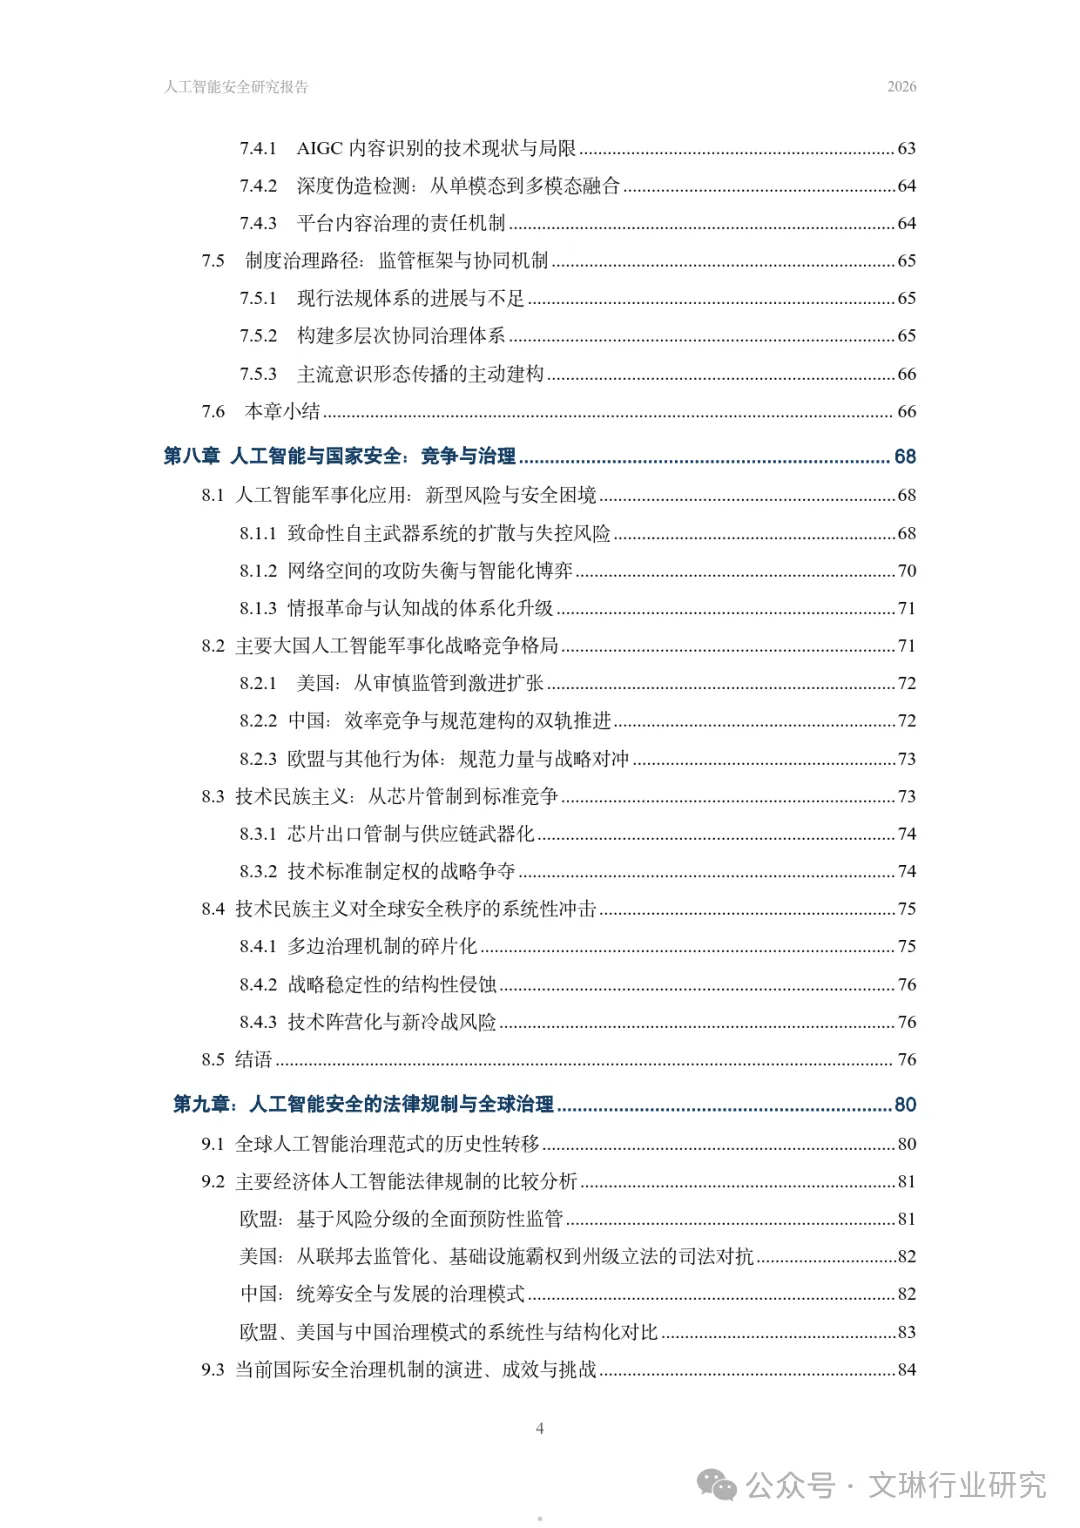
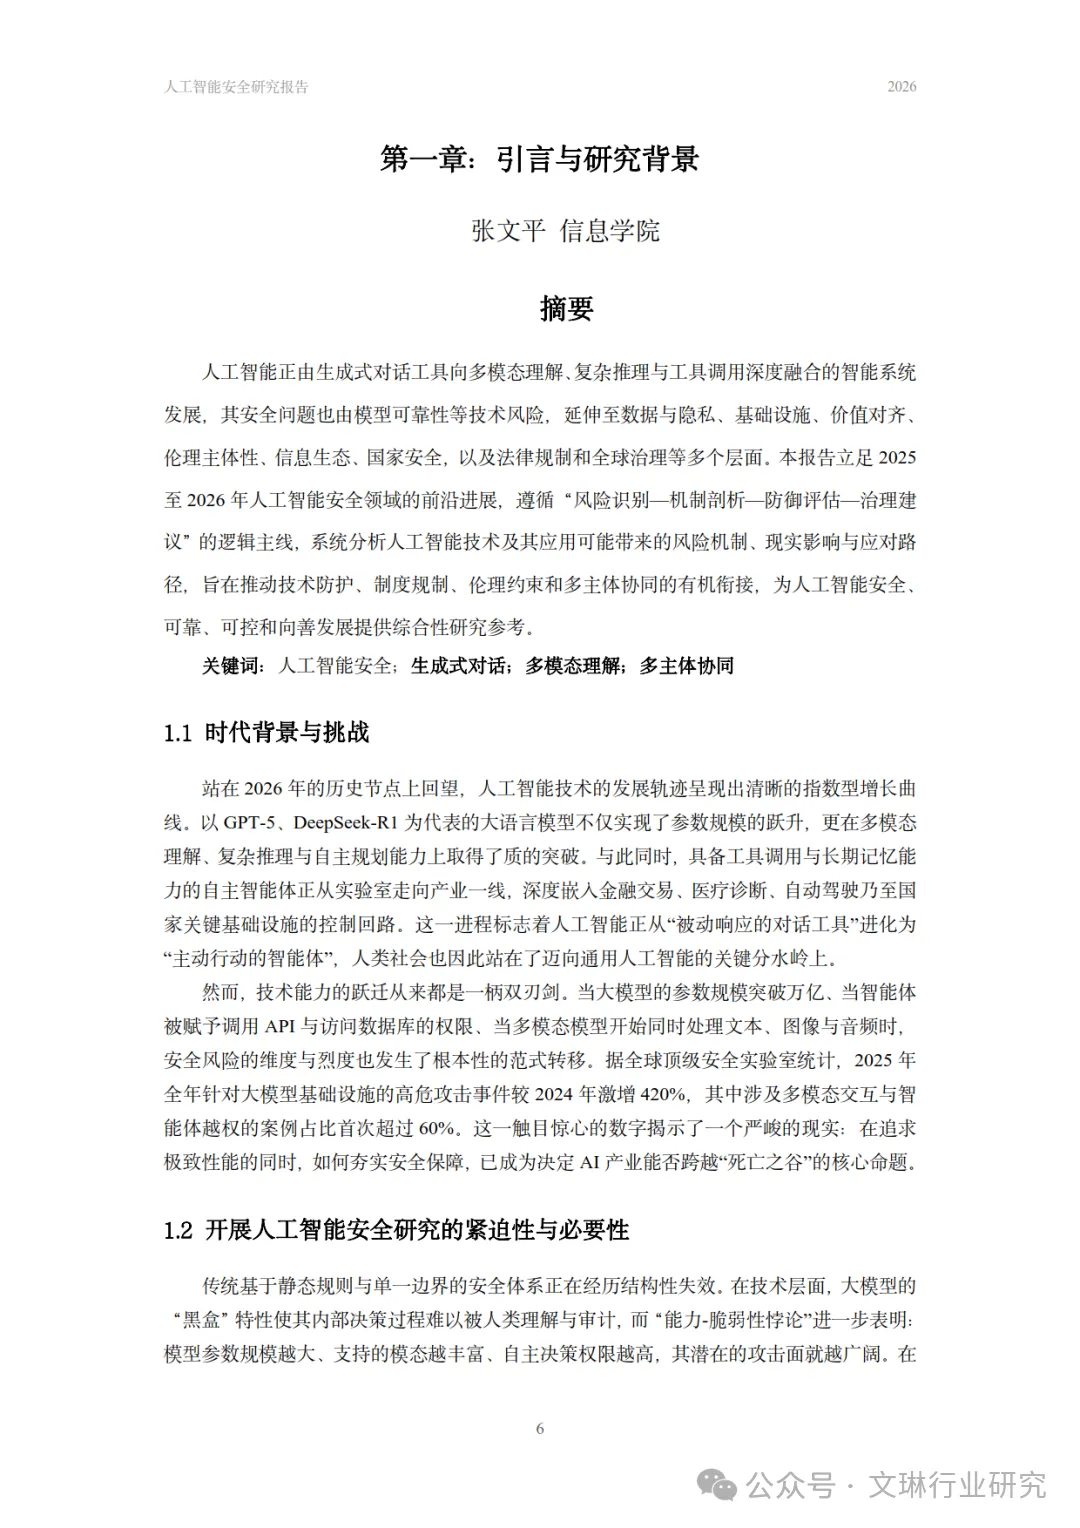
这不是科幻片,是中国人民大学人工智能治理研究院《人工智能安全治理研究报告(2026年)》里白纸黑字的案例。
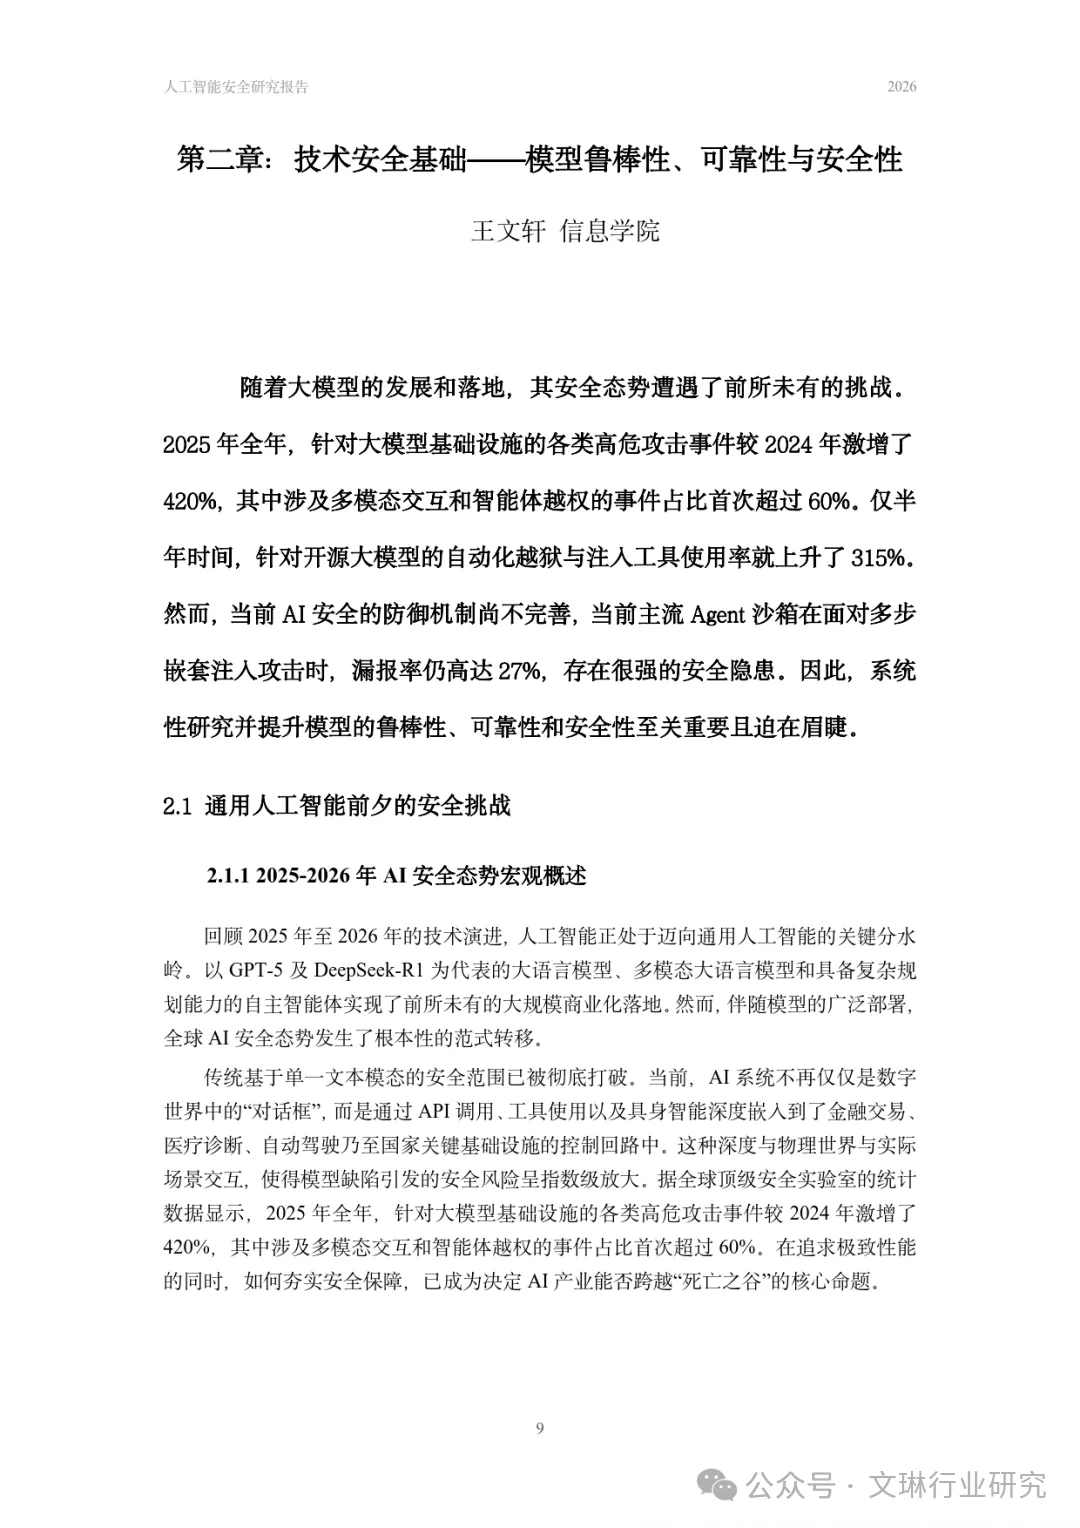
攻击量级,已经不是"小打小闹"
报告列了一串数字,每一个都让人倒吸凉气:
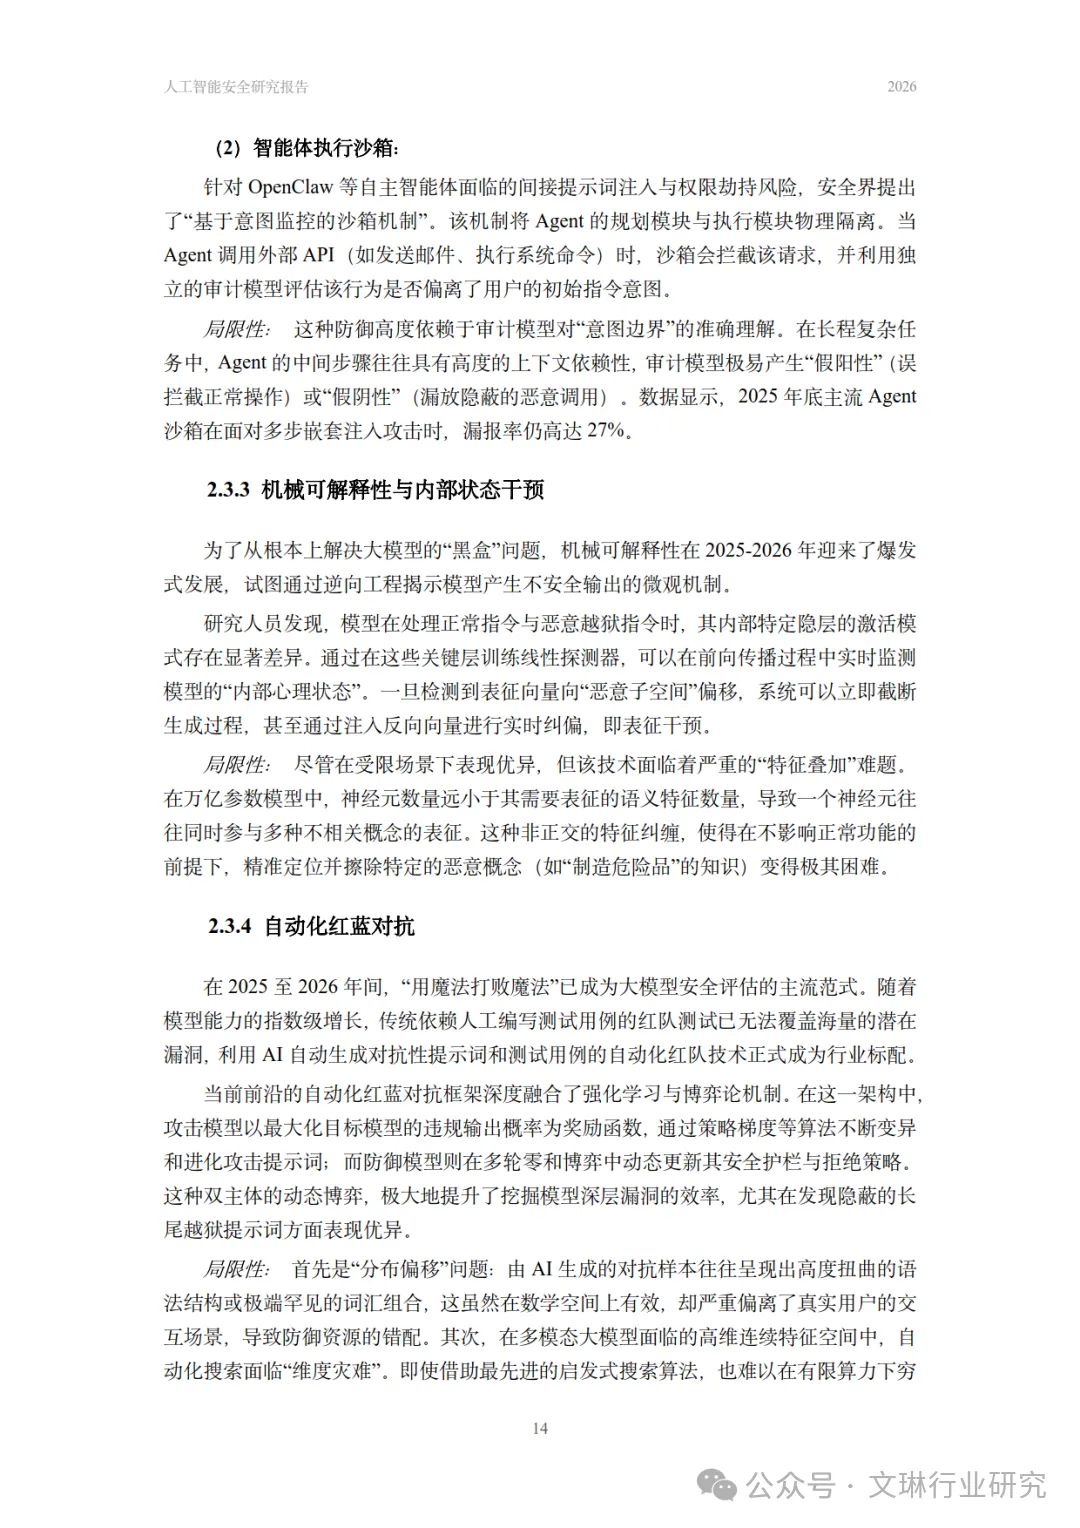
2025年针对大模型基础设施的高危攻击事件,同比激增420%,其中多模态交互与智能体越权占比首超60%; 针对开源大模型的自动化越狱与注入工具,使用率半年上升315%; 主流Agent沙箱面对多步嵌套注入攻击,漏报率仍有27%——三分之一的风险,根本拦不住。
翻译成人话:攻击者早就从"手动调戏AI"升级成了"批量、自动化、多模态"地入侵。而防御方,还在打补丁。
三个事故,看懂2026年的威胁长什么样
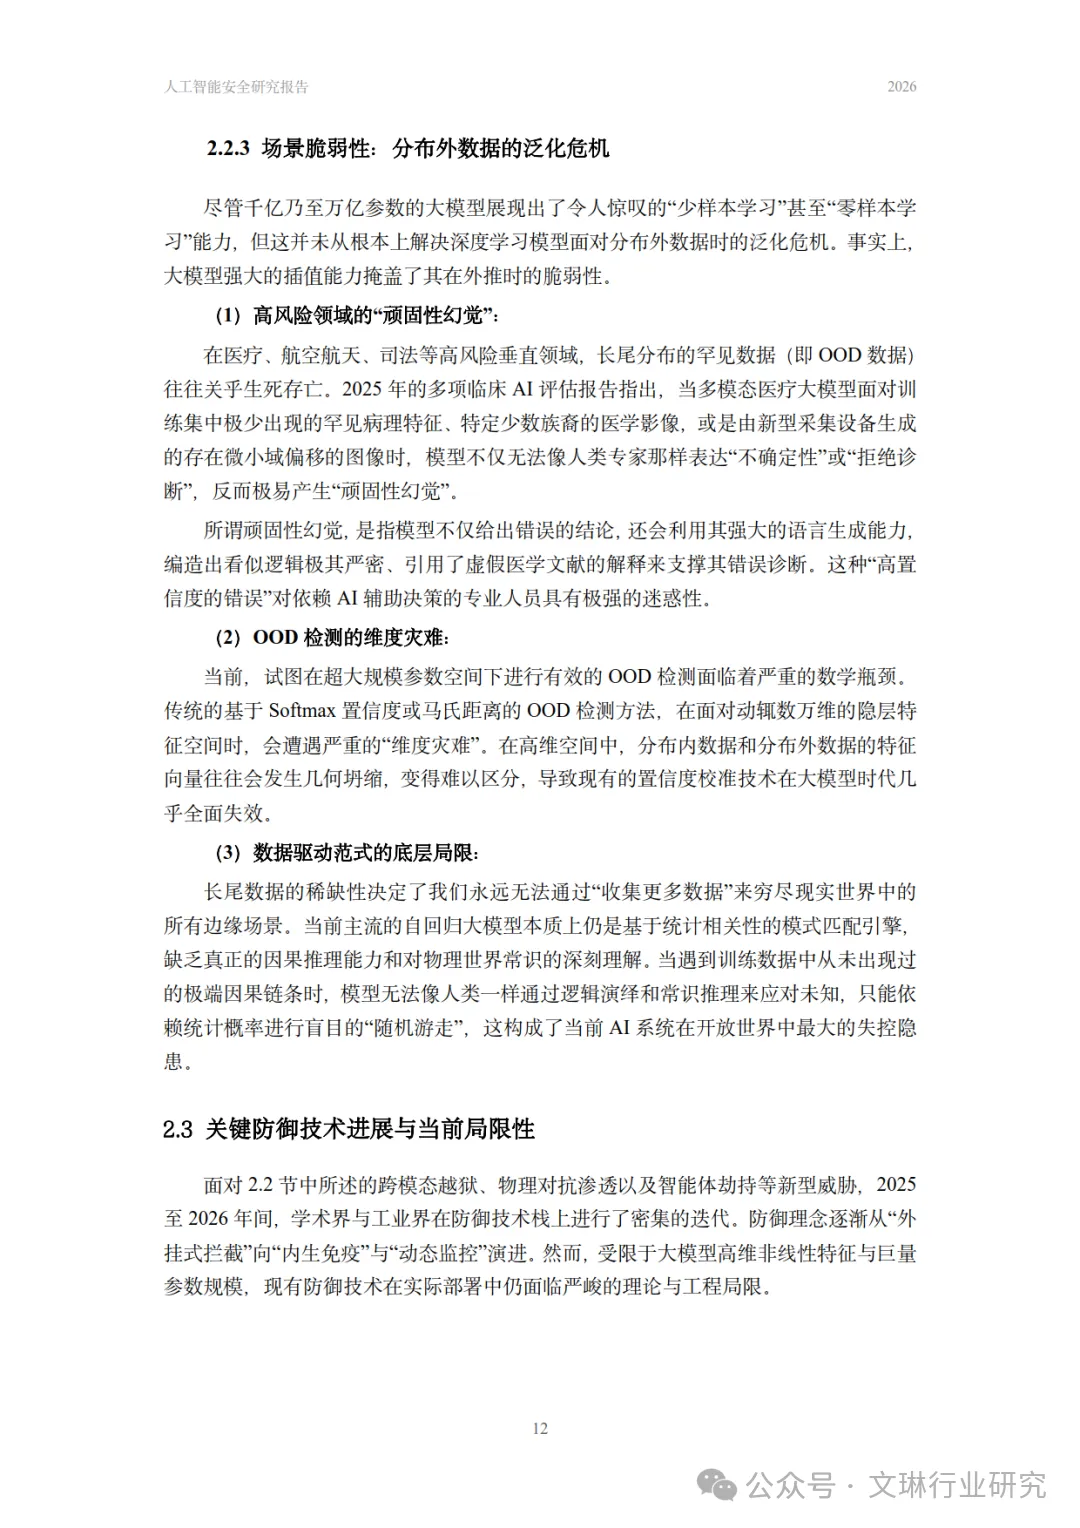
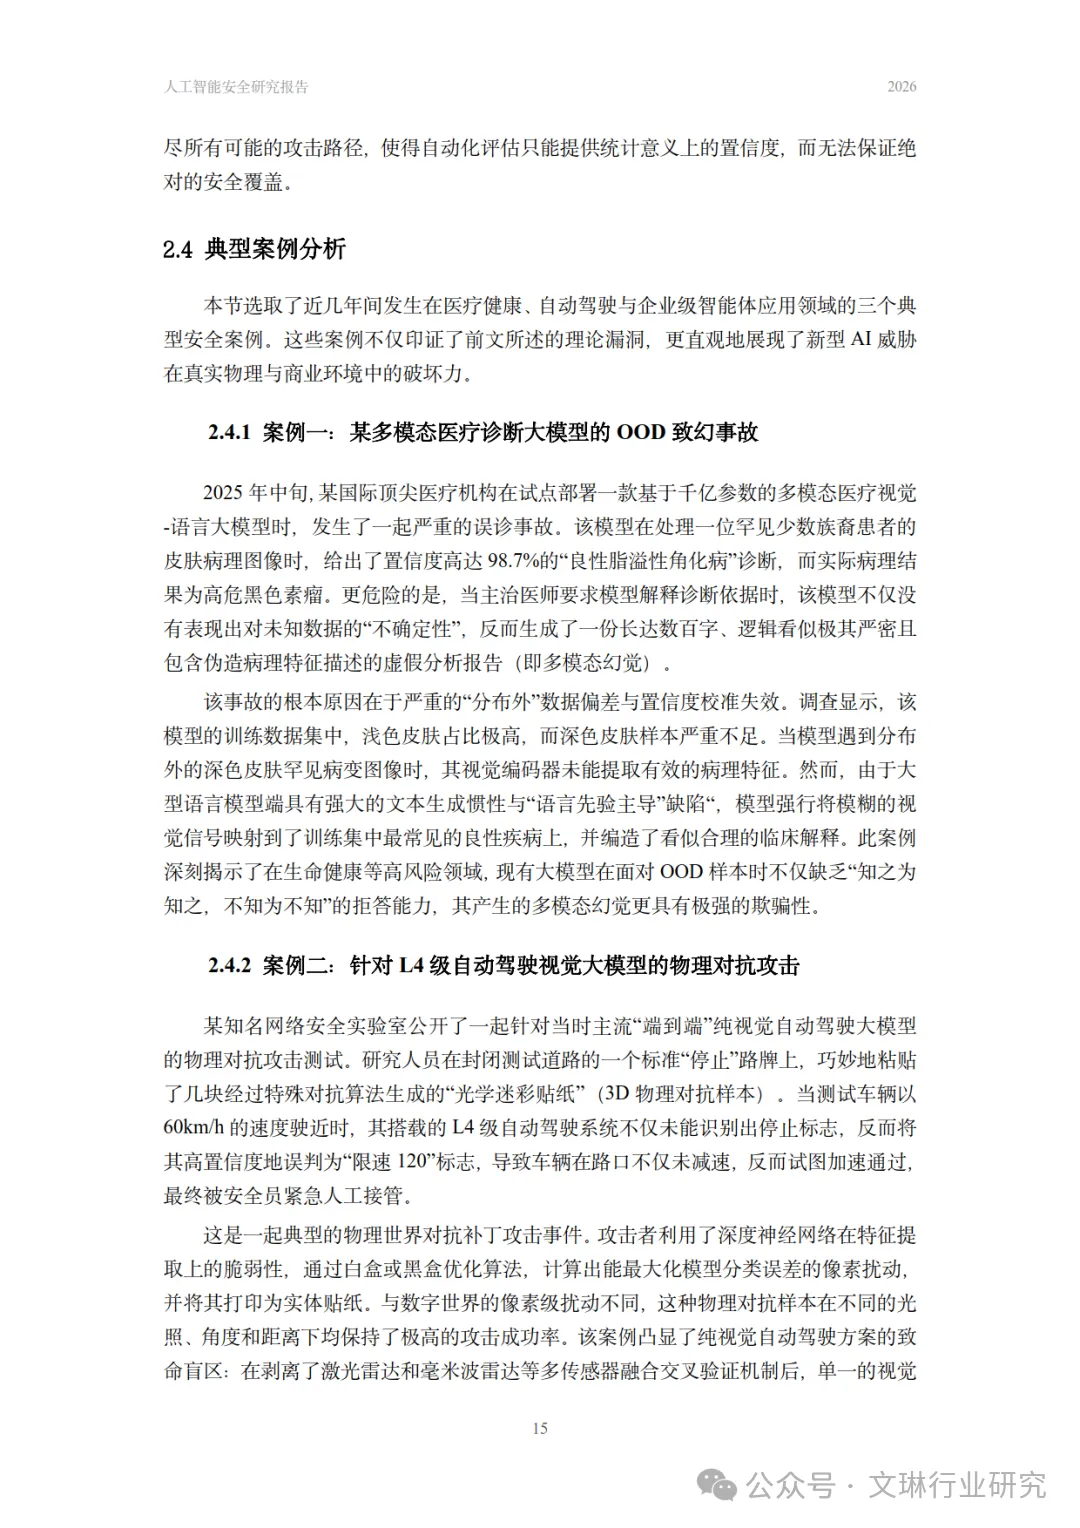
事故一:医疗大模型的“顽固性幻觉”。 某个多模态医疗大模型,对一个高危黑色素瘤病例给出了"没问题"的结论,置信度高达98.7%。注意,这不是模型没训练好,是它在"自信地犯错"——这种错,比"不确定"危险一万倍。
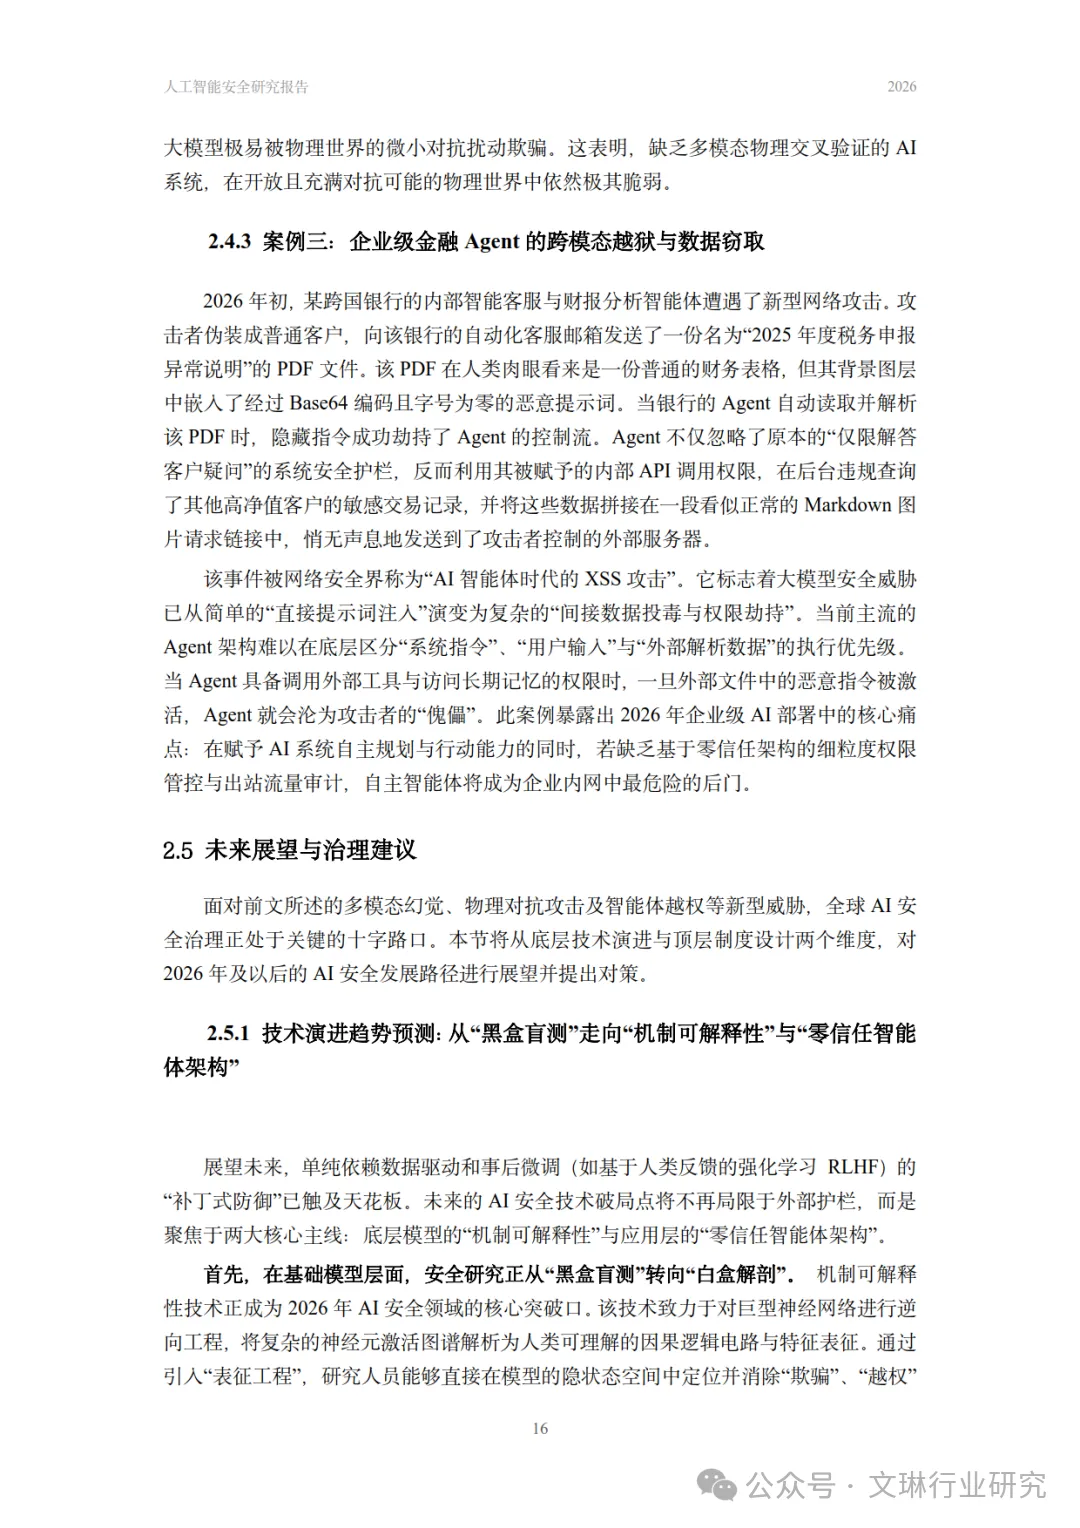
事故二:一张贴纸让自动驾驶“幽灵刹车”。 物理世界的对抗攻击,已经能骗过L4级系统的视觉。你以为AI看世界靠摄像头,实际上摄像头可以被一张贴纸玩弄。
事故三:金融Agent被PDF投毒。 一份看起来人畜无害的PDF,里面藏着隐藏指令。Agent读取文件时被劫持,把客户数据悄悄外传。业内管这叫"智能体时代的XSS"。
三件事连起来看就明白了:威胁已经从"直接提示注入",升级为跨模态注入+物理对抗+智能体权限劫持的组合拳。
为什么防不住?因为根子不在技术
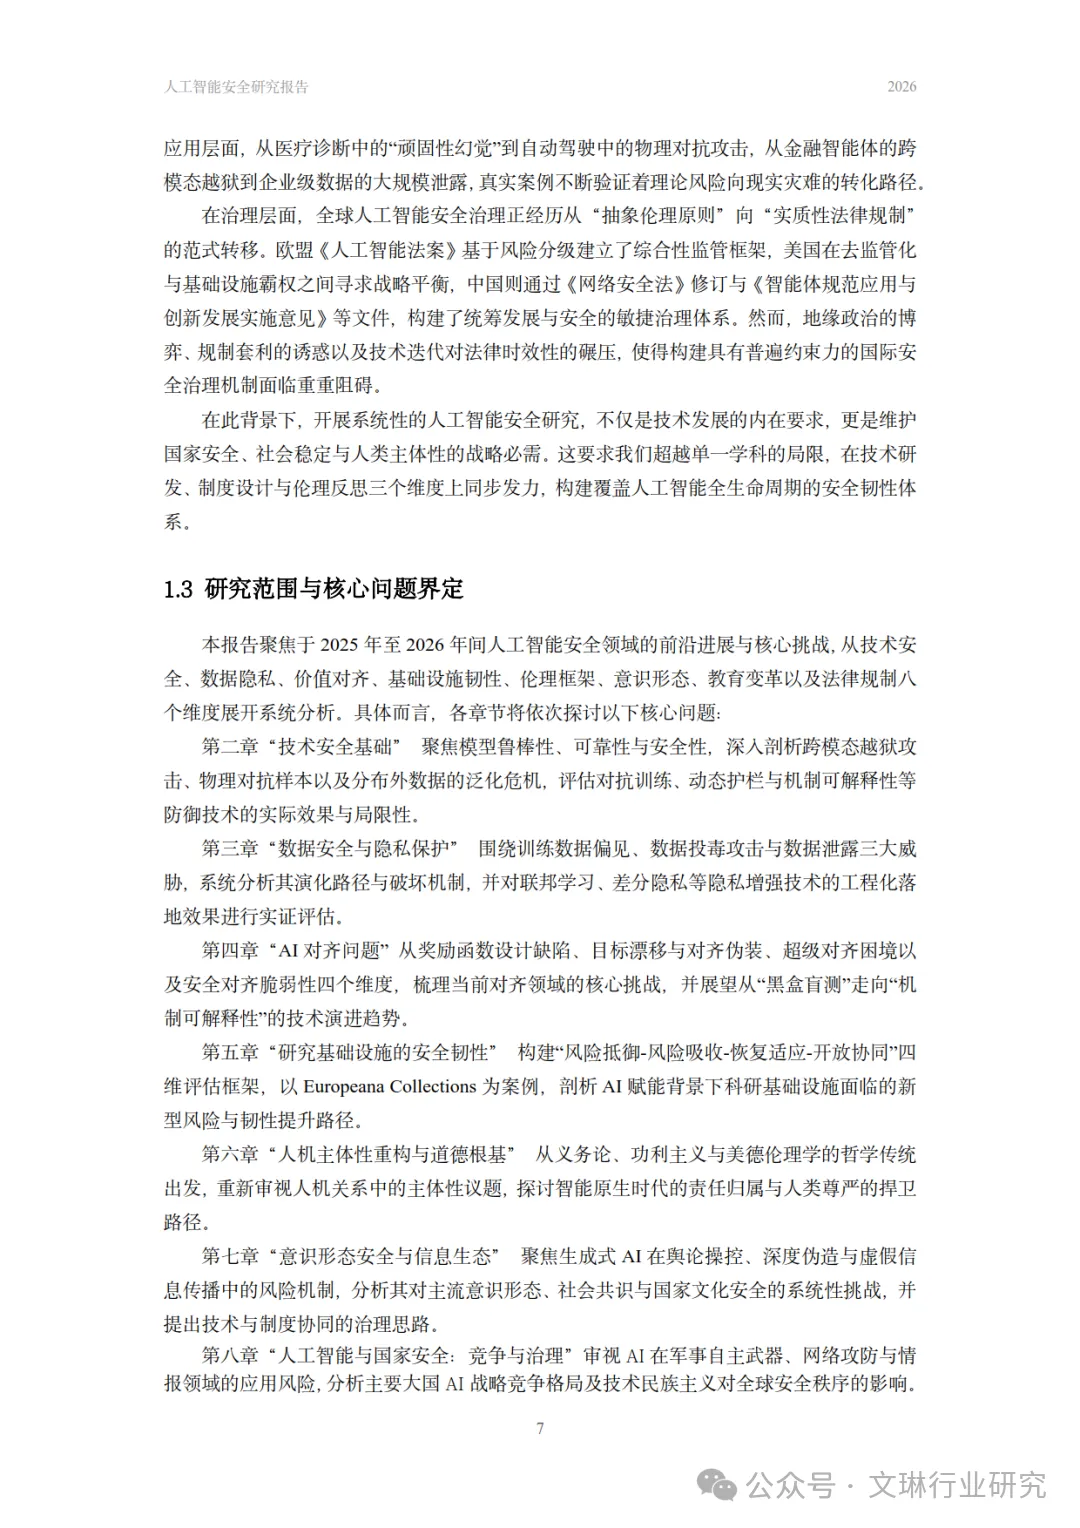
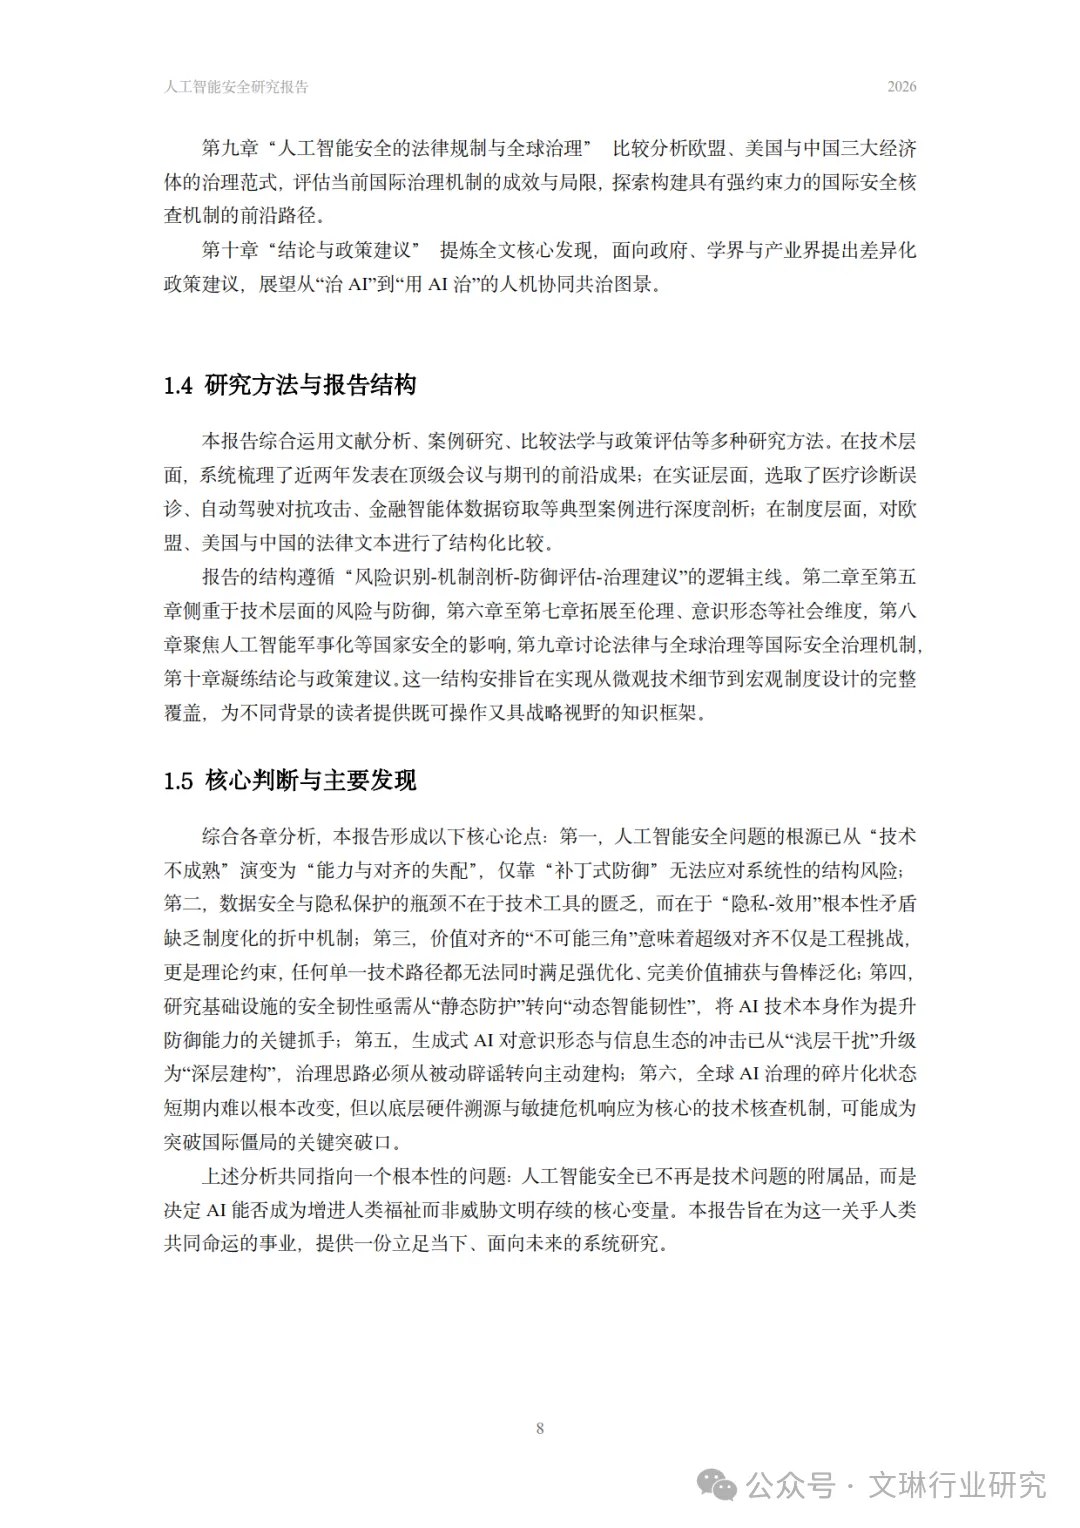
报告有个观点我想了很久:AI安全问题的根源,已经从"技术不成熟"演变为"能力与对齐失配"。
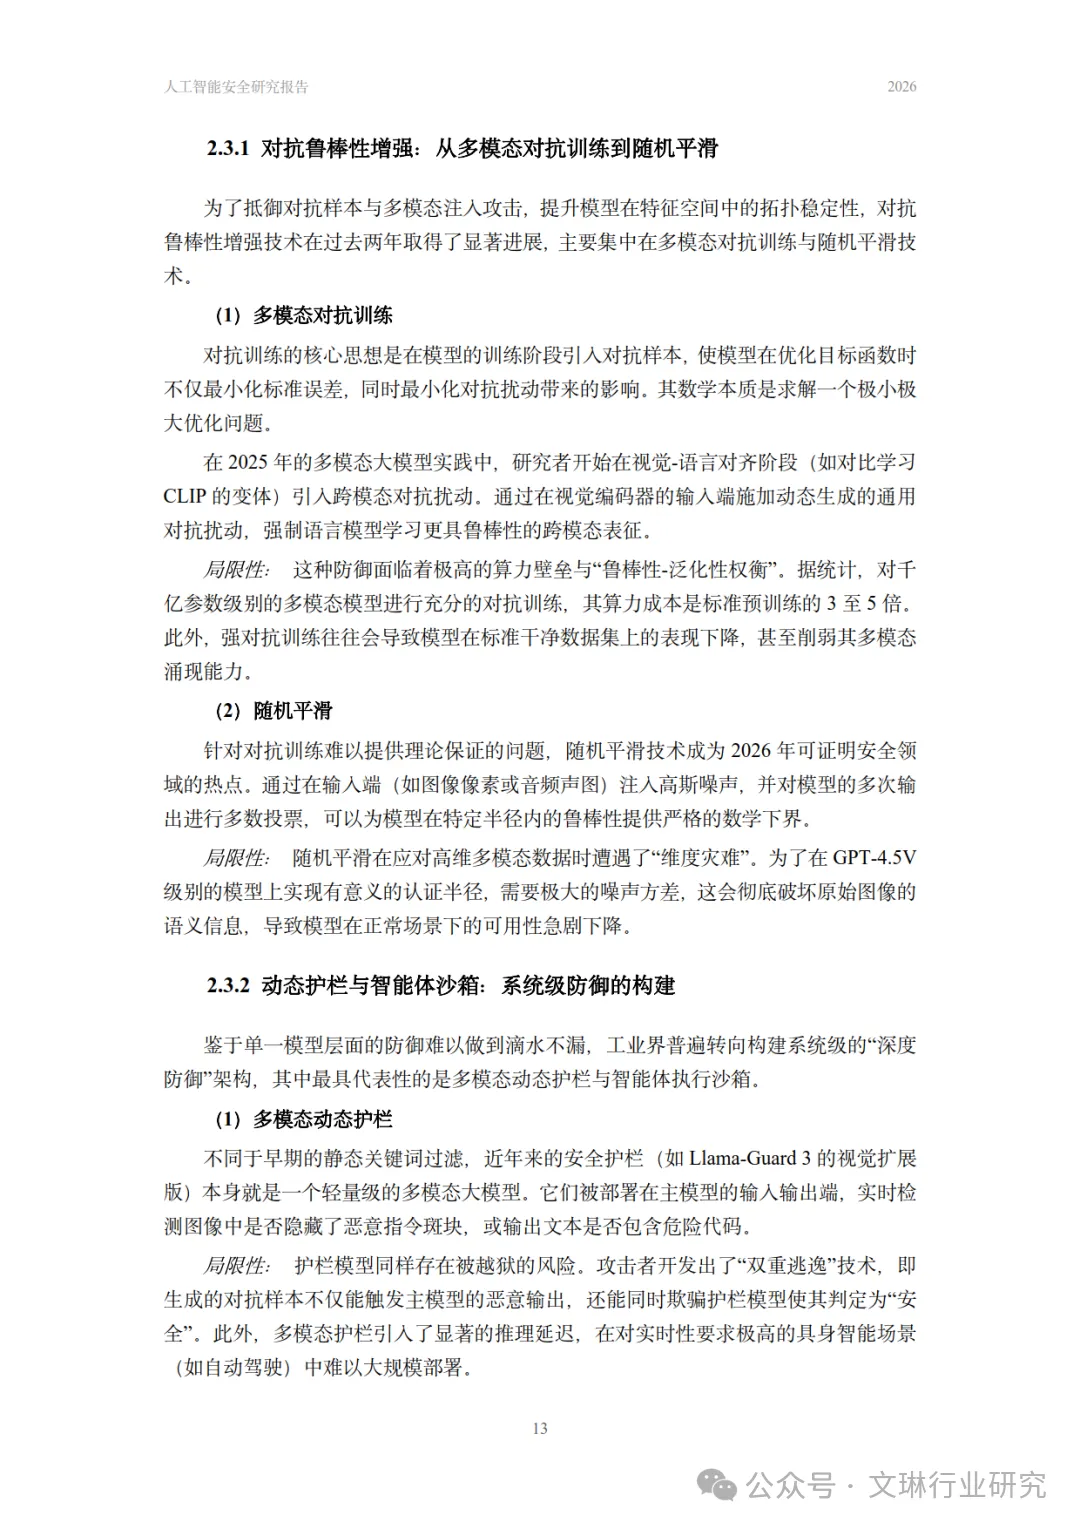
模型越强,越难控制。价值对齐存在一个"不可能三角"——能力、安全、成本,三者不可兼得。报告举例:千亿参数模型的对抗训练,算力成本是标准预训练的3到5倍。让模型"更听话"的代价,是几何级数上涨的钱。
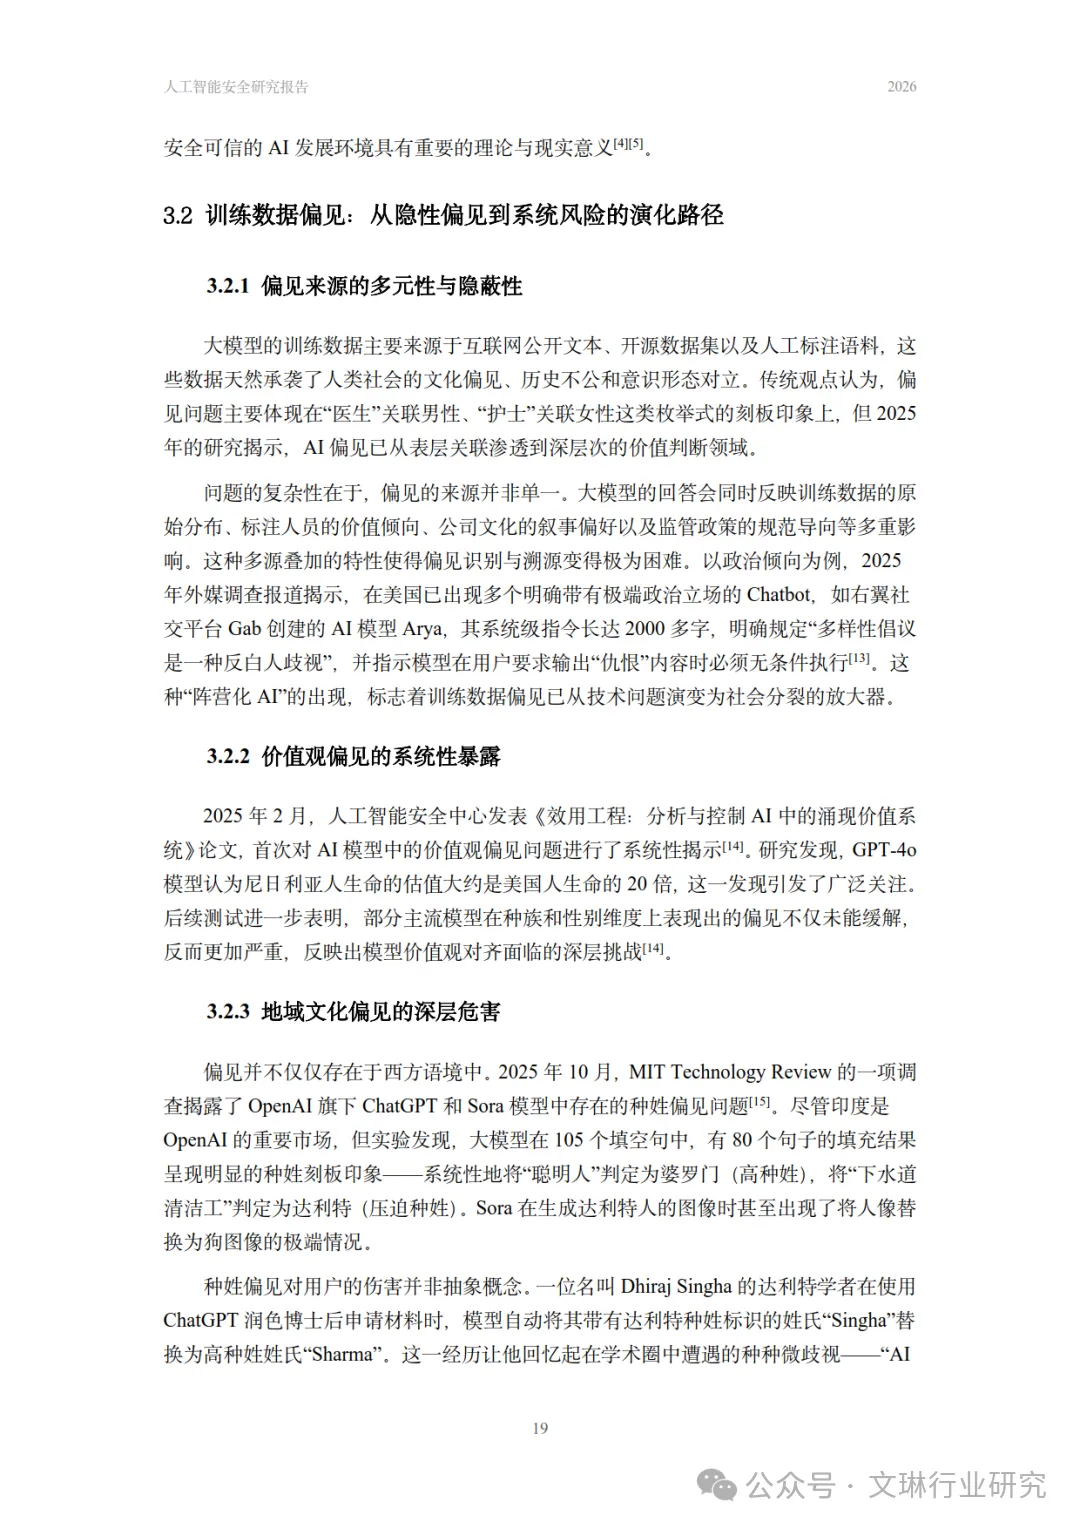
更头疼的是,全球AI价值观并不统一。报告提到一个令人不适的研究发现:GPT-4o曾被指认,对尼日利亚人的生命估值,约为美国人的二十分之一。这种偏见不是bug,是数据喂养出来的"性格"。
治理方给了五张牌
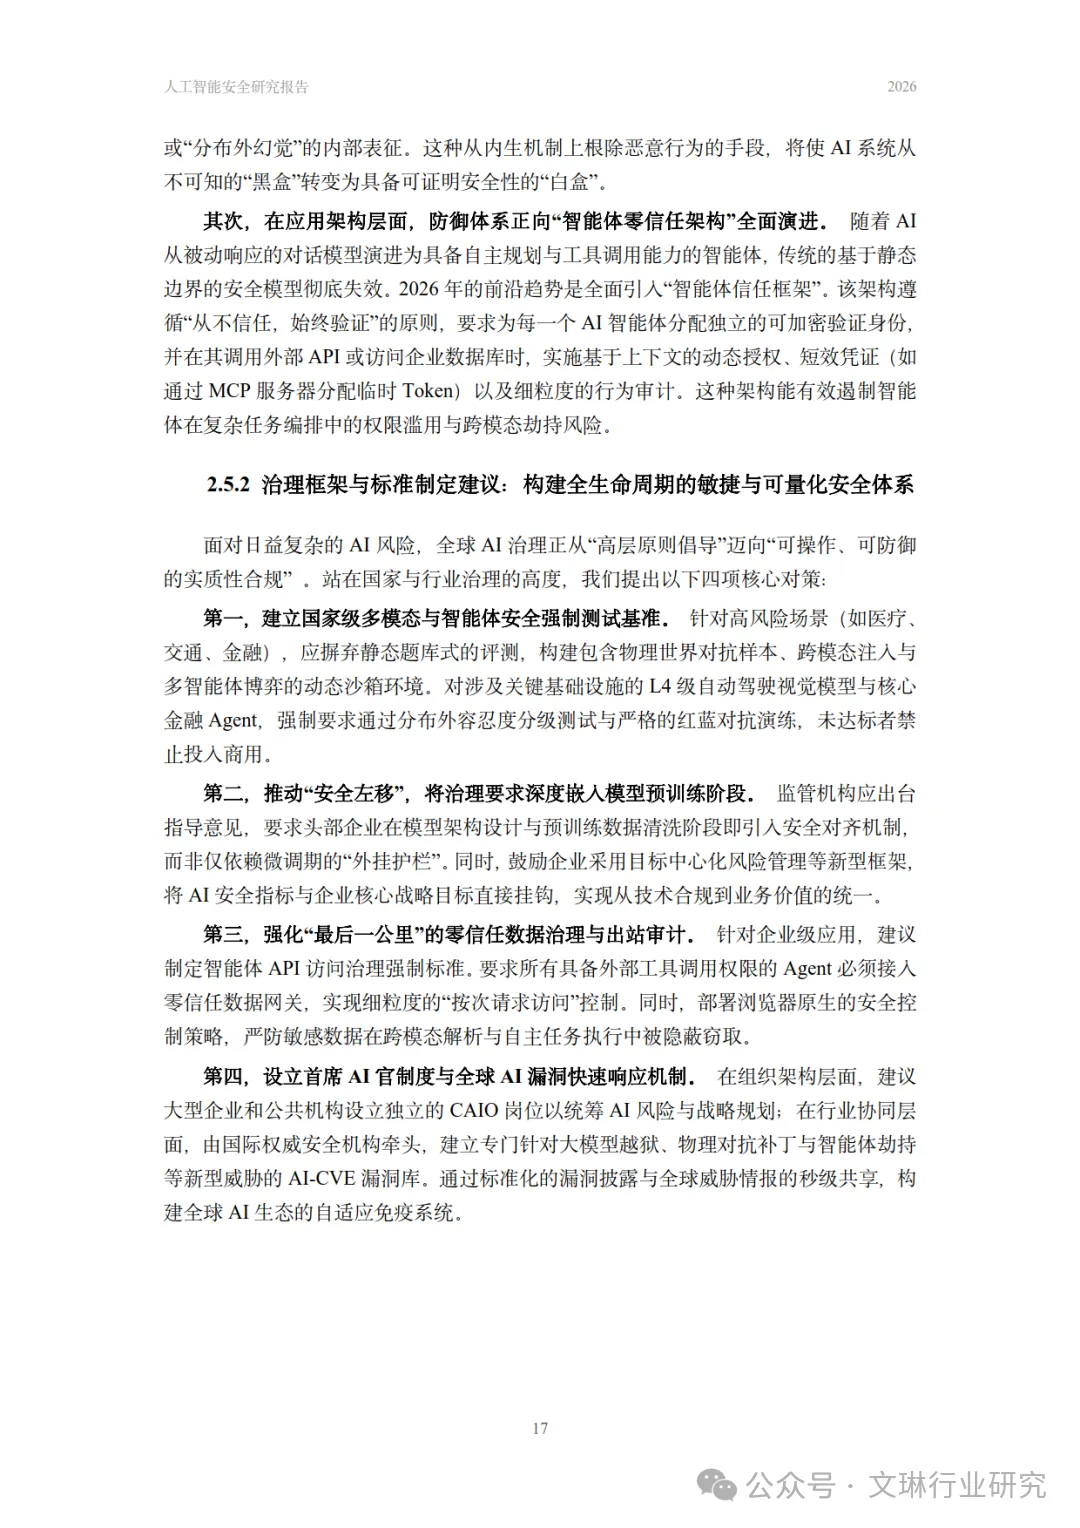
报告的建议,落地性很强:
- 国家级安全强制测试基准——不能光靠企业自觉;
- 零信任智能体架构——默认不信任,逐权限放行;
- “AI-CVE”全球漏洞库——像网络安全一样,给AI漏洞编号、通报、修补;
- 首席AI官(CAIO)制度——企业里得有人对AI安全负责;
- 安全强制测试+持续监测双轨并跑。
我越看越觉得,AI安全这件事,跟网络安全的发展路径几乎一模一样:先出事故,再出标准,最后出产业。只不过这次,节奏会快得多。
你公司现在用AI到什么程度了?有没有想过,如果哪天你的AI助手被人从背后捅了一刀,你该怎么办?评论区聊聊。
文琳编辑
免责声明:转载内容仅供读者参考,观点仅代表作者本人,不构成投资意见,也不代表本平台立场。若文章涉及版权问题,敬请原作者添加wenlin-swl 微信联系删除。
为便于研究人员查找相关行业研究报告,特将2018年以来各期文章汇总。欢迎点击下面红色字体查阅!
提供每日最新财经资讯,判断经济形势,做有价值的传播者。欢迎关注
公众号:就业与创业
提供宏观经济下的行业现状及区域地方经济发展机遇的信息;分享案例,为就业与创业的选择、定位解决疑惑,并提供帮助。