
 研报速递
基金季报里出现“风格漂移”四个字,对做投研的人来说既熟悉又难受。
熟悉,是因为它几乎每个季度都会出现在某些产品的点评里;难受,是因为它常常只是一个结论——“该基金发生风格漂移”——后面没有证据,没有链条,也没有动作。
我们在做基金研究时反复撞上同一个断层:数据端能算出这只基金这季度重仓了哪些行业、市值偏大还是偏小、成长还是价值;但要把这些数字变成“它违背了自己当初的承诺” “原因是基金经理换了” “所以应该调出核心池”这三句话,中间隔着大量的人工检索、阅读和判断。
这段工作以前只能靠人。而人做这件事有三个天然缺陷:慢、不可复现、说不清证据在哪。
所以我们花了很长时间,把这段“只有人会做的推理”拆成了一条可执行的 Agentic 推理链,并最终封装成一个 skill:输入基金代码与时间窗口,自动跑完全部环节,输出一份可点击、可追溯的全景看板。
这篇文章只讲三件事:为什么这件事必须用链而不是一次调用、这条链是怎么设计的、跑完之后究竟能拿到什么。
PART 01
漂移不是偏离市场,是偏离自己

市面上衡量风格的主流做法,是拿基金和市场基准比:相对沪深 300 的行业超低配、相对中证 800 的市值暴露、相对风格指数的因子载荷。
这套方法有用,但它回答的是“这只基金现在长什么样”,不是“这只基金有没有背叛自己”。
一只消费主题基金重仓了银行,从市场基准看也许只是行业配置的正常波动;但从它自己的合同承诺看,这是一次明确的越界。反过来,一只全市场选股的基金在某季度大幅偏向成长,如果合同本来就允许,那它只是风格切换,根本不构成漂移。
所以我们把基准换掉了:不用市场基准,用基金自己的承诺做基准。
这就引出了整个项目最底层的双基准结构:
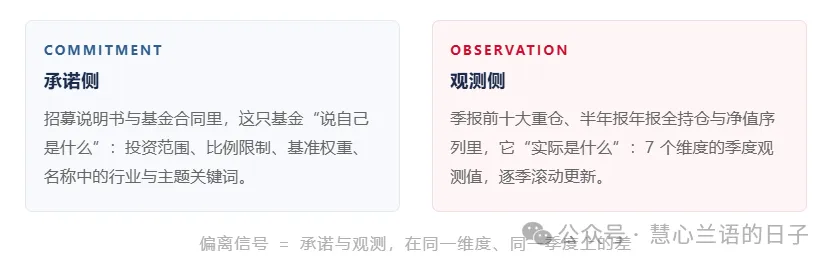
这个定义听起来朴素,但它一次性解决了三个老问题:
口径可复现 同一份合同永远抽出同一组承诺,换个人跑结果一样。
责任可界定 偏离的是合同,不是市场;这个问题能拿去和基金经理对话。
结论可证伪 承诺写得越具体,判断就越硬;写不清楚的,链条会诚实地告诉你判断不了。
PART 02
为什么必须是“链”,而不是一次调用

很多人的第一反应是:把季报丢给大模型,让它判断有没有漂移,不就行了?
我们试过,不行。不是因为模型不够聪明,而是因为这件事本身不是一个“判断”,而是一串判断,而且每一环的失败模式完全不同:
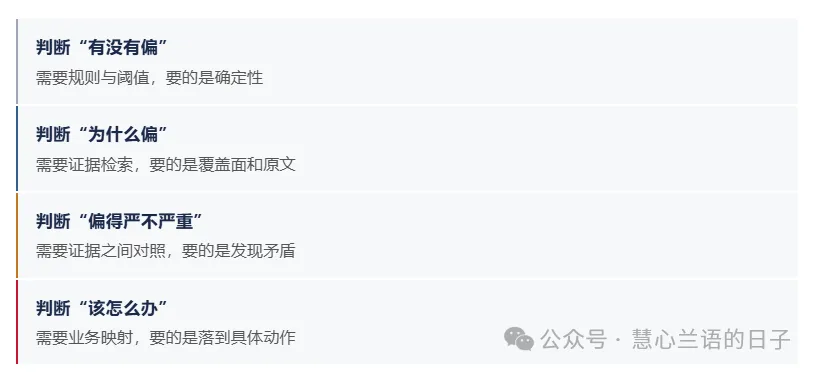
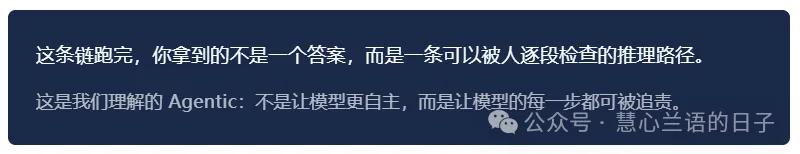
把这四件事塞进一个 prompt,结果是每一件都做到 60 分:阈值不稳、证据编造、矛盾看不见、结论悬空。所以我们的做法不是让模型一次答完,而是把它拆成六个连续动作——一条完整的六段式推理链。
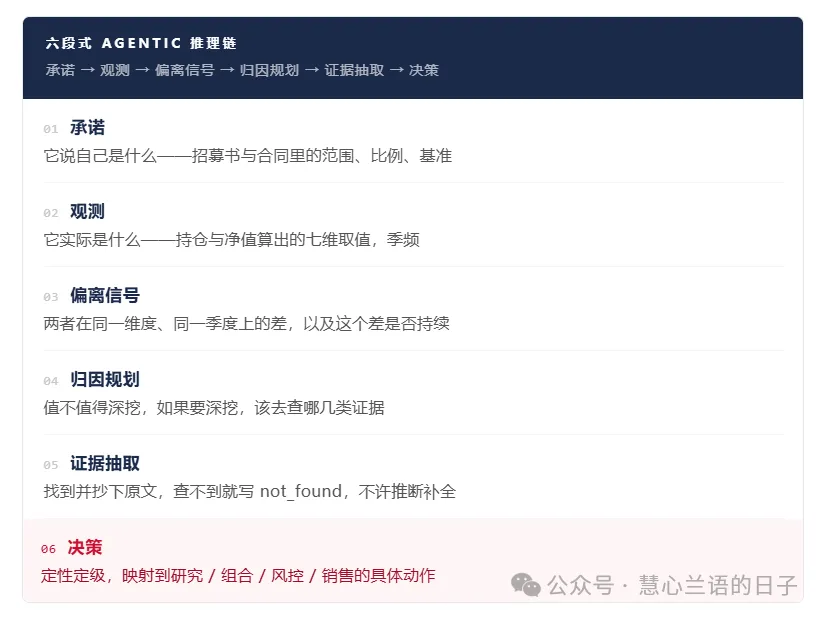
这六段里,前三段解决“是不是”,后三段解决“为什么、怎么办”。落到实现上,六段展开为七步——第五段“证据抽取”被拆成检索与验证两个角色、分别交给两个 Agent,因为“找得到”和“站得住”是两种完全不同的失败模式。
1归因规划 Agent
先决定“值不值得查”
它先做准入判定,四条判据:是否持续、是否跨维度、是否超阈值、是否无法由市场环境解释。命中两条以上才进入深挖,否则直接归档为“轻度、可解释”。通过准入的,再匹配 6 类根因假设,并按先硬后软排序:合同变更、基金经理变更、公告披露的投向调整属硬证据;新闻、访谈、行业景气解释属软证据。
输出 → attribution_plan.json (是“要去查什么”,不是结论)
2证据检索 Agent
只负责“找到并抄下来”
拿着清单去查公告、新闻、数据与季报原文。每条证据必须抽取结构化论元(时间、来源、主体、内容),并且强制摘录原文金句。这一环最容易被模型“美化”,所以我们加了一条硬约束:查不到就写 not_found,不允许推断补全。整条链的诚信度,取决于这一条。
输出 → evidence_pack.json
3验证与建图 Agent
整条链里最值钱的一环
它把证据分进两个篮子:支撑(supporting)与反驳(contradicting)。这一步是整个设计的关键,因为真实世界里证据几乎从不齐整——公告说“坚持原有策略”,但持仓已经换掉三个行业。
如果不设“反驳”这个篮子,模型一定会挑对自己有利的证据,最后给出一个漂亮但错误的结论。分完篮子再做三件事:检测矛盾、对缺口发起追加检索、给每条证据打置信度。最终产出不是一段话,而是一张证据图。
输出 → evidence_graph.json
4判定与映射 Agent
最后才允许下结论
把偏离定性为 6 类漂移性质之一,给出高 / 中 / 低危,并映射到四个视角的决策动作:研究口径怎么记、组合怎么调、风控怎么标、销售怎么解释。每一条结论都必须挂上证据编号。
输出 → judgment.json (挂不上 EVID 的,不允许进结论)
PART 03
三个不能让步的设计约束

回头看,这条链能跑通,靠的不是模型能力,而是三条约束。
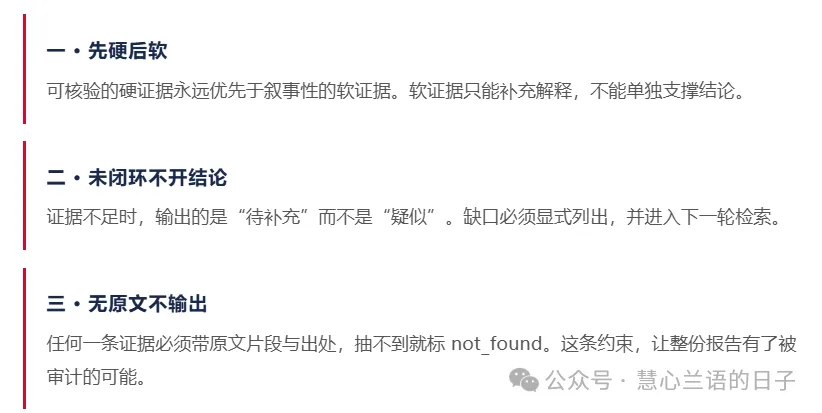
这三条听起来像工程规范,其实是投研规范。我们只是把它写进了链里。
PART 04
项目架构:一条流水线,六层判断

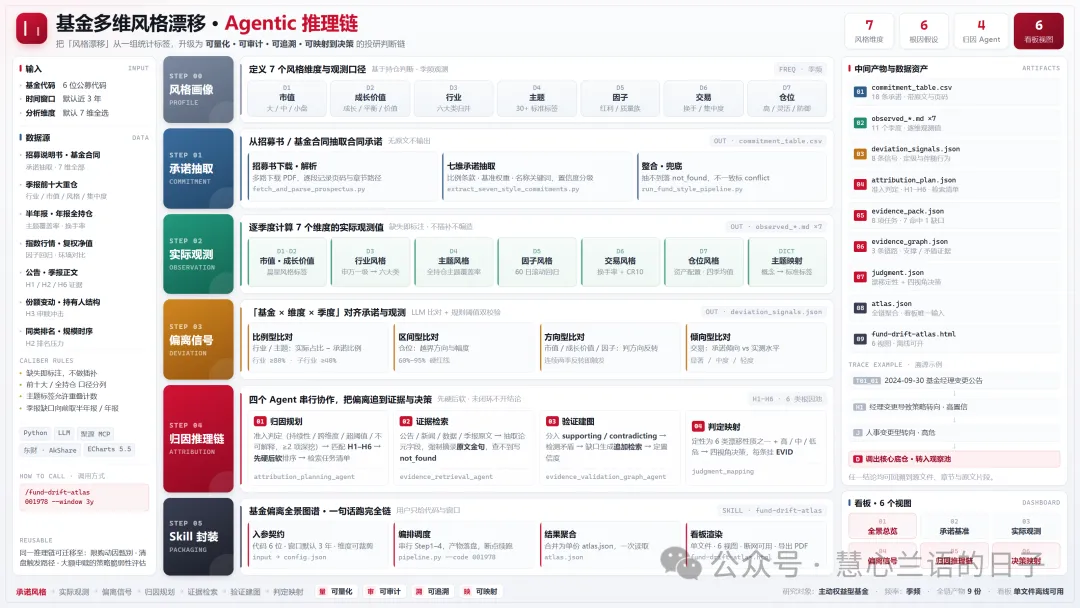
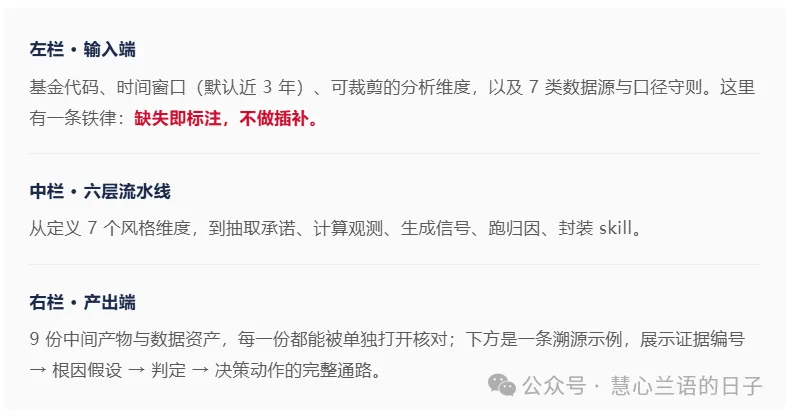
把上面所有东西落成一张图,就是下面这样。整张图分三栏看:左边是输入,中间是流水线,右边是产物。
PART 05
六个模块,各自解决一个“卡点”

STEP 00 风格画像
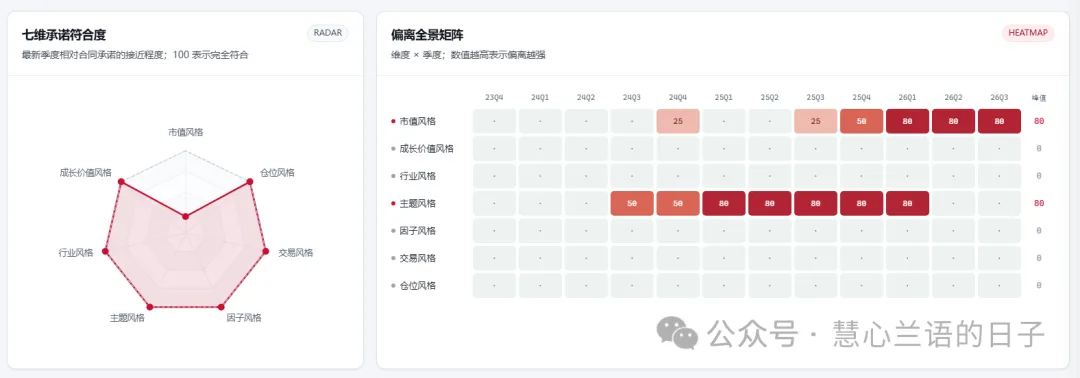
先把“风格”拆成可以分别观测的 7 个维度
市值、成长价值、行业、主题、因子、交易、仓位。这里最关键的决策不是维度怎么切,而是频率怎么定:因为这 7 个维度绝大部分要靠持仓判断,而全持仓只有半年报和年报才披露,季报只有前十大。
所以观测口径定为季频,但强制区分“前十大口径”与“全持仓口径”,季报缺口向前取半年报 / 年报,不做插值。承认数据的不完美,比用插值把它抹平更接近真相。
STEP 01 承诺抽取
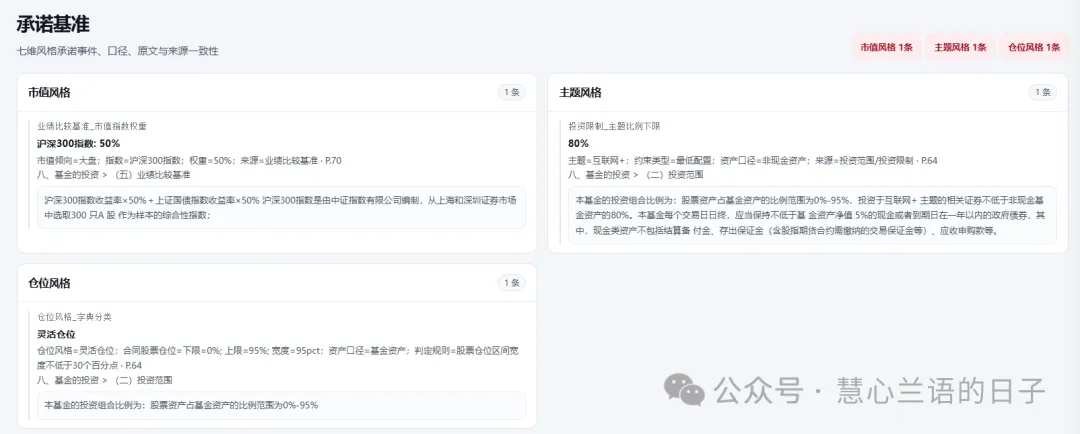
从招募书里,把“承诺”变成结构化字段
三件事:下载并解析招募说明书与基金合同(保留页码与章节路径);抽取七维承诺(比例条款、基准权重、名称关键词),并做置信度分级;整合与兜底——抽不到落 not_found,多源不一致标 conflict。
产出 commitment_table.csv,每一条承诺都带原文与页码。没有原文的承诺,不进表。
STEP 02 实际观测
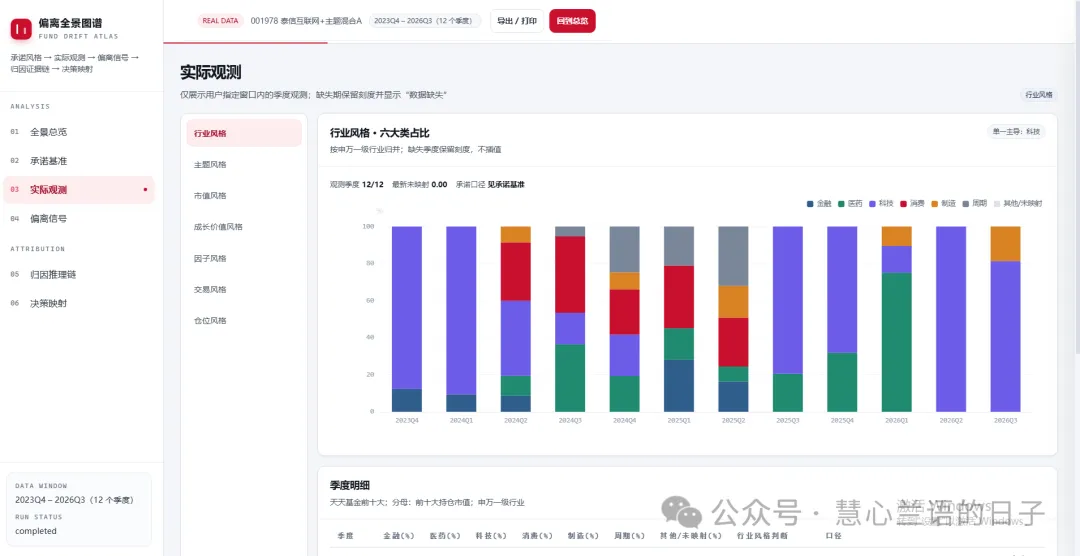
七个维度,七套算法,口径公开可查
市值与成长价值用风格标签;行业用申万一级归并到六大类;主题用全持仓的主题覆盖率(允许多标签重叠计数);因子用 60 日滚动回归;交易用换手率与 CR10 集中度;仓位用资产配置的四季均值。
产出 7 份 observed_*.md,逐季列出观测值。
STEP 03 偏离信号
四种比对类型,对应四种不同的“偏”
把承诺与观测在“基金 × 维度 × 季度”三个键上对齐,然后分型处理:
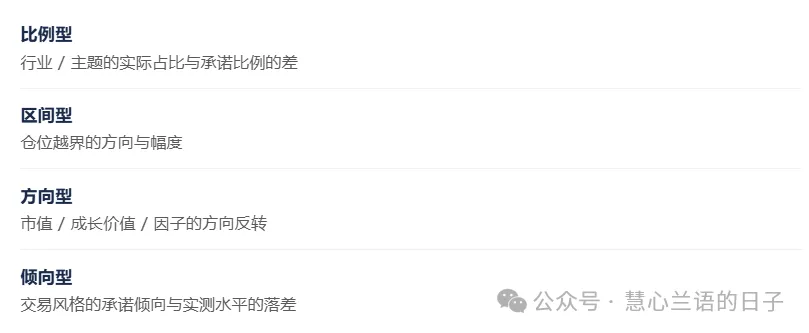
产出 deviation_signals.json,每条信号带定级与伴随行为。
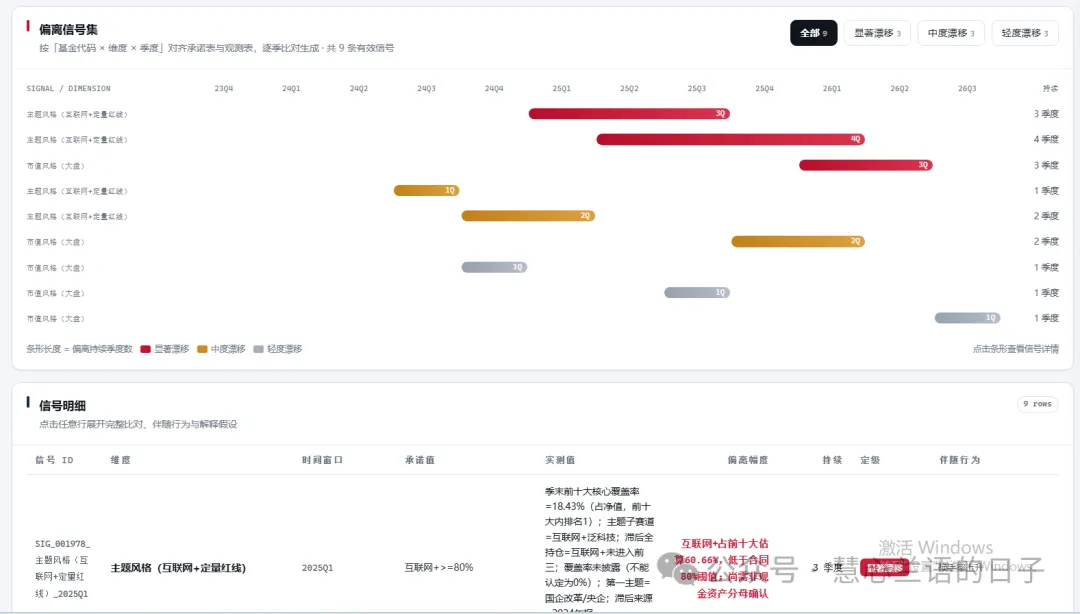
STEP 04 归因推理链
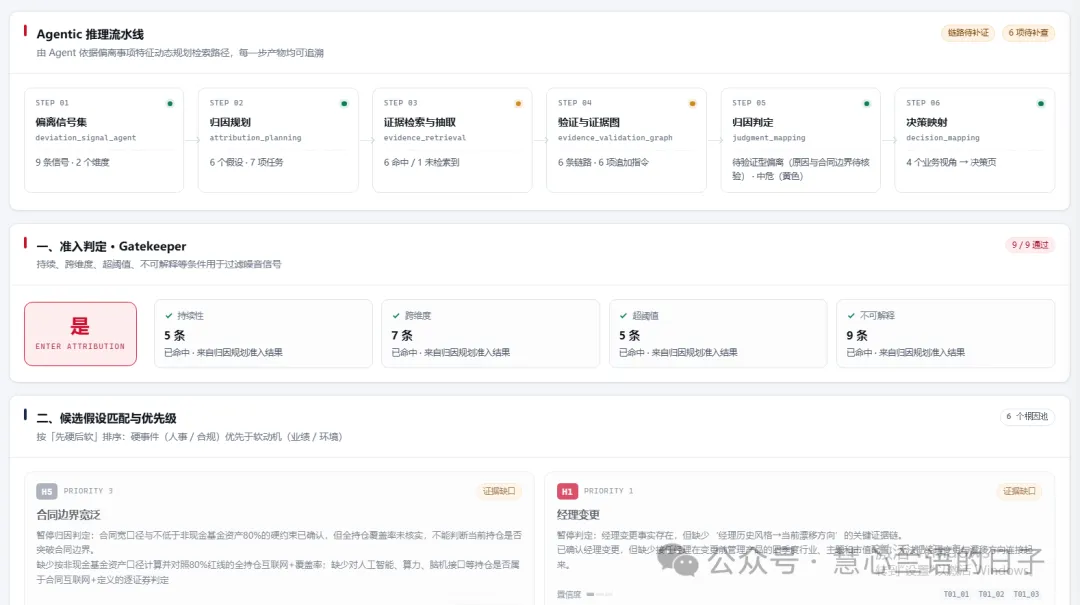
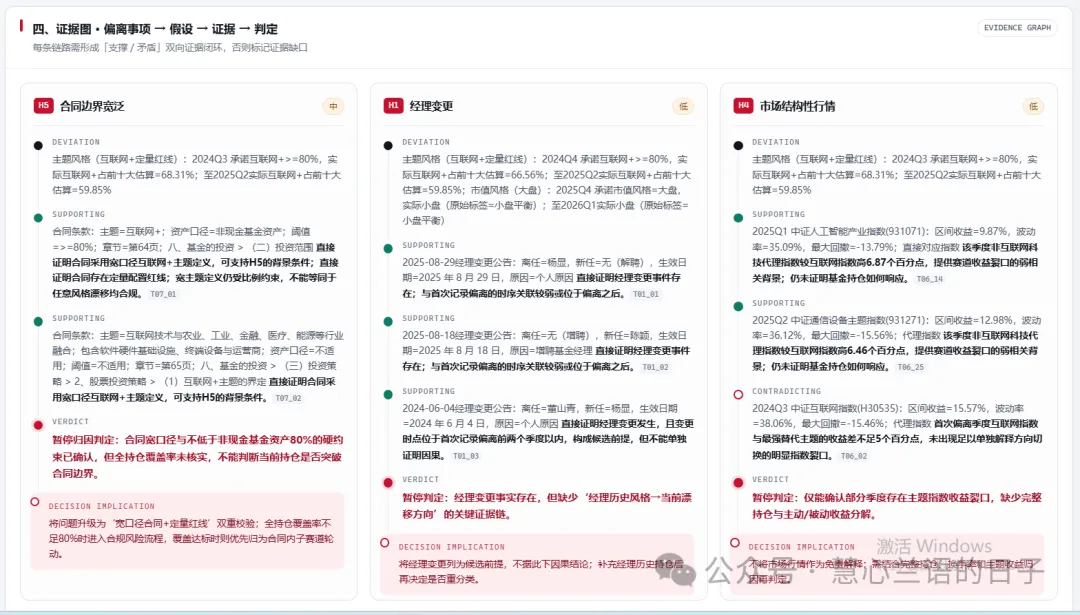
四个 Agent 串行,把“偏”追到“为什么”
就是 PART 02 讲的那条链:归因规划 → 证据检索 → 验证建图 → 判定映射。产出四份文件,每一步都能回看、能单独检验。
STEP 05 Skill 封装
把整条链收成一句话
整个项目最终被封装成一个可直接调用的 skill,使用者只需要知道基金代码和窗口:
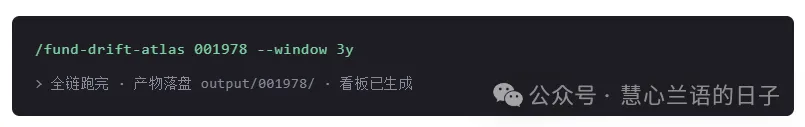
内部做四件事:入参契约、串行编排(产物落盘、断点续跑)、结果聚合(合成单份 atlas.json)、看板渲染(单文件 HTML, 6 个视图,断网可用、可导出 PDF)。
PART 06
跑完之后,手里有什么

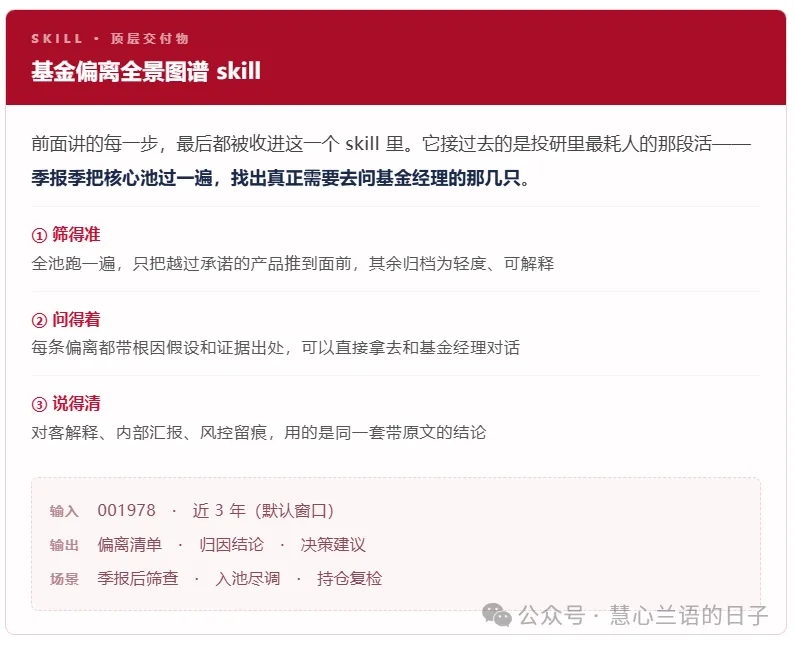
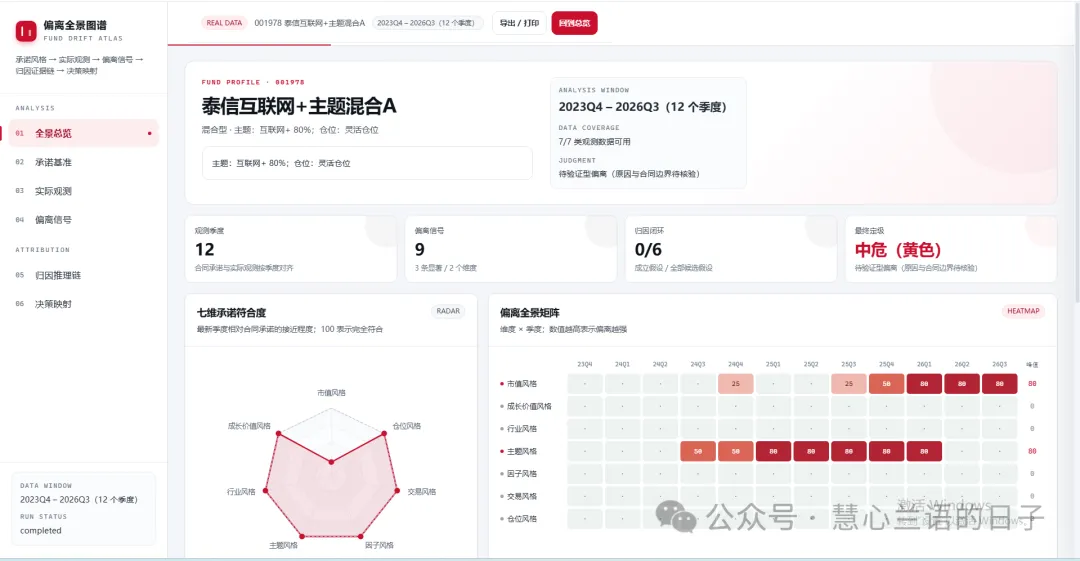
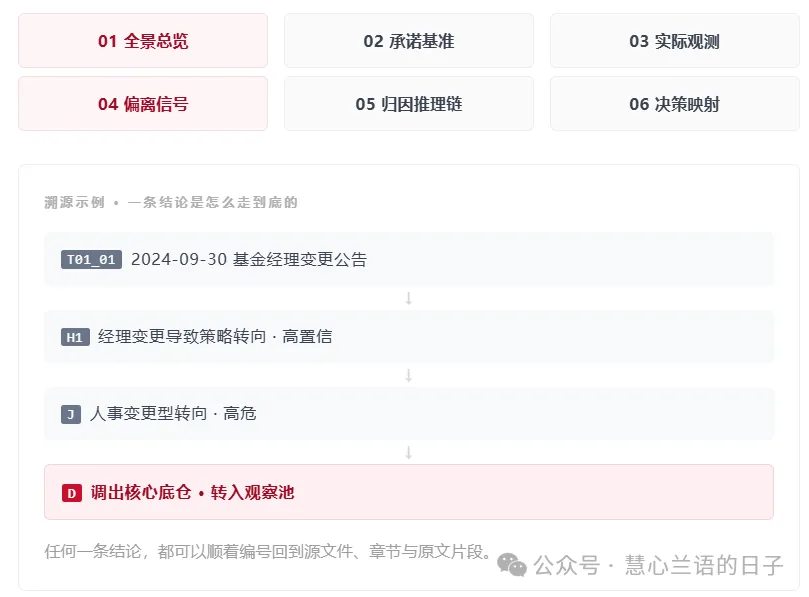
这份看板一共 6 个视图,从“看全貌”逐步下钻到“看动作”:
PART 07
这套方法的边界,必须说清楚

一、它依赖文本质量。招募说明书写得越含糊(“适度配置”“灵活把握”),承诺就越软,判断也就越弱。对这类产品,链条会诚实地输出“承诺不可量化”,而不是硬给一个结论。
二、它不预测收益。它判断的是“行为是否一致”,不是“未来会不会涨”。风格漂移是一个风险信号,不是一个 alpha 信号,两者不能混用。
三、阈值需要人来定。准入的四条判据、置信度分级、高危的界定,都需要业务方给口径。链条负责执行一致,不负责替你决定标准。
这套东西真正想解决的,是投研里一个很老的尴尬:我们能算出所有数据,却说不清一句判断。
Agentic 推理链的价值不在于让 AI 更聪明,而在于把“人做判断的过程”显式化——先定义、再观测、再比对、再规划、再检索、再验证、最后才映射到动作。每一步都留痕,每一环都能被推翻。
风格漂移只是第一个场景。同样的链,换一套承诺库和证据源,就能迁移到限购动因甄别、清盘触发路径、大额申赎下的策略脆弱性评估。
# Agentic 推理链 # 投研方法论 # 基金风格漂移 # 金融 AI 落地
免责声明:本文所介绍的方法、工具与流程仅用于提升研究效率与规范性,文中涉及的基金代码、数据均为方法演示,不构成任何投资建议或产品推荐。基金有风险,投资需谨慎。




