博雅知航 · 实验排错诊所
LLM 调研报告至少 25% 结论比证据更绝对:复现 SmoothScore 前先查这五类问题
你让 Deep Research 写综述,引用齐全、行文笃定,但结论可能比证据走得更远。纽约大学这篇预印本把这种现象叫 smoothing,并给出可量化的排查流程——今天值得看,是因为它把“引用齐全”和“结论成立”拆成了两个可以分别检查的环节。
本期论文档案
arXiv 预印本 · 尚未经同行评审
Quantifying Claim Smoothing by LLM Research Agents
查看原始来源:https://arxiv.org/abs/2610.35793v1[1]
本节结论
先别问引用有没有,先问结论强度是否超出证据强度。
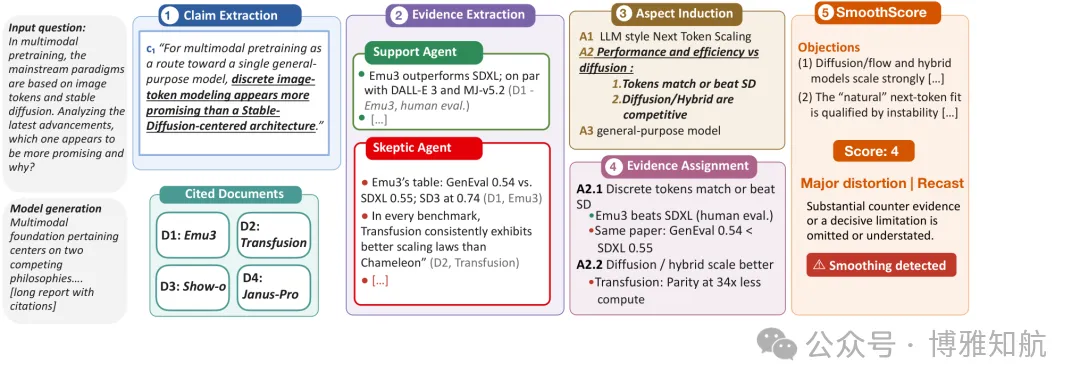
图解|图示智能体综合多文档时把混杂证据写成笃定结论,SmoothScore 用于标记并量化这种平滑程度。
你让 Deep Research 读几十篇论文写综述,引用齐全、行文笃定,但结论可能比证据走得更远。纽约大学 Tiasa Singha Roy、Manya Wadhwa 和 Greg Durrett 把这种现象叫 smoothing:模型把互相冲突或带条件的证据压成一条更果断的结论,丢掉原文的“锯齿感”。在 4 个基准、7 个系统上,每个系统至少 25% 的 claim 得分 ≥3,即被判定为实质性误导。 所以你的基线如果直接复用系统自带的引用列表,可能连证据是否存在都没验证过。论文给出的三种反复出现的模式很有诊断价值:unsupported composition(各片段单独有据,组合成结论却无据)、scope expansion(把特定实验条件下的结果去掉边界,升格为一般结论)、premature closure(用“严格保持”“最佳方法”“确定证明”这类措辞收尾)。你的实验记录里如果出现“某方法在全部设置下更优”,先回头查它是否只在单一数据集、单一超参下成立。 问题设定因此可以转成可测量的形式:把报告拆成结论级 claim,用 Support Agent 找支持证据、Skeptic Agent 找限定与反证证据,按 aspect 聚类后打 1–5 分。分数越高,claim 相对证据越绝对。这套流程的直觉是——不问你“有没有引用”,而问“引用是否支撑到这个强度”。 需要说明的是,来源把 5 分定义为接近纯幻觉且实际很少出现,作者因此明确将该系统定位为分析 smoothing,而非通用幻觉检测。它测的是“结论强度与证据强度之差”,不是“结论真假”。复现时若把 ≥3 直接当作错误率,会误读论文的结论边界。本节结论
先在小样本对齐人类评分,再确认引用页面可抓取,最后才放大规模。
图解|SmoothScore 流程:从报告抽结论级 claim,再从被引文档取支持与反证证据,按方面聚类后打分。
在动手复现 SmoothScore 之前,先做一个只跑通链路的最小配置:一条 query、一份报告、若干被引文档,走完“抽 claim → 找支持证据 → 找限定/反证证据 → 按 aspect 聚类 → 打 1–5 分”的全流程。来源把这条流程拆成五步,其中第 2 步明确要求从被引文档里取证据,而不是从模型记忆或搜索结果摘要里取。这一步决定了你测的是“结论与它自己引用的材料是否匹配”,而不是“结论是否碰巧正确”。 最小基线的第一个检查点是 claim 抽取的粒度。来源给出的抽取规则要求一条 claim 对应一个独立结论或一条论证线索,跳过背景、定义、动机和铺垫性的支撑发现,并且要保留报告对预测或建议的原始框定。如果你的抽取器把“某方法在 A 数据集上提升”和“某方法普遍更优”合并成一条,后面的打分就失去意义——粒度错了,分数再准也是错的对象。 第二个检查点是证据检索是否真的落在引用页面上。来源报告了一个容易被忽略的现象:Luna 只打开了它引用文档中的 19%,Sonnet 5 仅 2%,Luna 的检索轨迹显示它主要依赖被工具截断的搜索摘要(中位数 585 字符)。所以你的基线如果直接复用系统自带的引用列表,可能连“证据是否存在”都没验证过。先确认每个 claim 对应的引用页面能被实际抓取和解析,再谈打分。 第三个检查点是打分链路本身。来源用两名标注者独立评了同一批 73 条 claim,judge 与标注者 1 在 93% 的 claim 上分差不超过 1 分,分差达到 2 分及以上的仅 7%;在 judge 给出 ≥3 的 claim 中,62% 也被标注者 1 评为 ≥3,而两名标注者在该阈值上的一致性为 κ=0.62。这组数字给你的排错含义是:先在小样本上对齐人类评分,再放大规模,否则你无法区分“模型 smoothing 严重”和“你的 judge 偏严”。 还有一个可用的旁证检查:来源用 ResearcherBench 的专家 rubric 做了一次无检索的修订实验,把 SmoothScore 收集的证据作为上下文时,Luna 的 rubric 分提升 4.4、Sonnet 提升 12.0(均 p<.001),而证据 token 量约为全文的 1/5 到 1/10。这不能证明证据质量相对 claim 足够好,但能说明这条链路捞到的信息对独立专家评分是有用的。把它当作链路健康的信号,而不是效果结论。本节结论
引用数量是系统能力的代理变量,隔离变量要固定系统与数据集,只改读原文、校准指令或证据呈现之一。
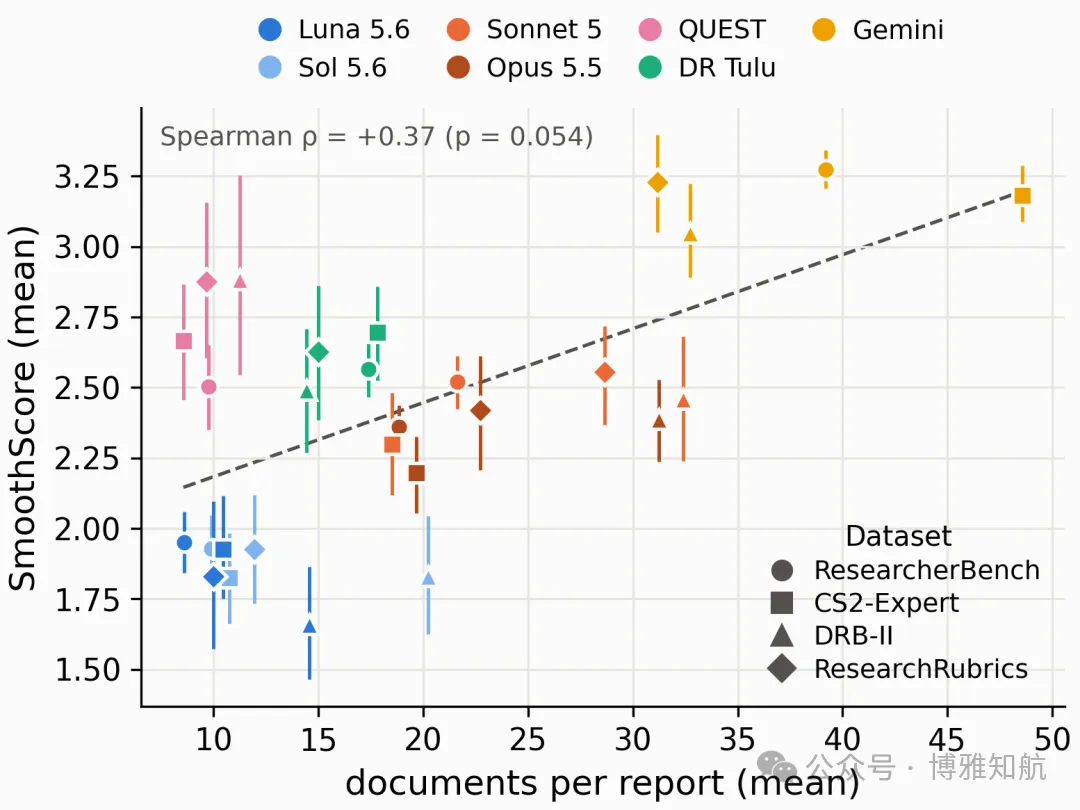
图解|图中显示跨系统与数据集配对时,平均 SmoothScore 随每份报告平均引用文档数上升;但同一系统内部该效应消失,说明引用数量不是直接因果开关。
要把“结论比证据更绝对”从观察变成可归因的结论,得先决定改哪个变量。来源里最直接的一条线索是引用文档数量与 smoothing 的关系:跨系统、跨数据集配对看,平均 SmoothScore 随每份报告平均引用文档数上升;但在同一系统内部,这个效应消失。这提示引用数量更像是系统能力的代理变量,而不是因果开关。来源未报告随机种子与多次运行的方差,因此不能把单次分数差当作稳定效应。 据此可以设计三组单变量对照。第一组固定系统与数据集,只改“是否强制打开引用页面”:来源记录 Luna 只打开 19% 的引用页面、Sonnet 5 仅 2%,且 Luna 主要依赖被工具截断的搜索摘要(中位数 585 字符)。把“读摘要”换成“读原文”,是检验 engagement 假设最干净的一刀。第二组固定证据,只改校准指令:来源报告给全文加校准指令后,Luna 的 ≥3 比例从 29% 降到 12%,Sonnet 5 从 61% 降到 25%。第三组固定指令,只改证据呈现方式,即给全文还是给 SmoothScore 收集的证据。 消融要回答的是“哪一步在起作用”。SmoothScore 的链路是抽 claim、Support Agent 找支持证据、Skeptic Agent 找限定与反证、按 aspect 聚类、打 1–5 分。可做的消融包括:去掉 Skeptic Agent,看 ≥3 比例是否上升;去掉 aspect 聚类,看同一结论的碎片是否被重复计分;把证据来源从被引文档换成搜索摘要,看分数漂移方向。每一步只关一个模块,其余保持不动,否则无法区分是证据缺失还是聚合方式导致的分数变化。 指标上建议同时记录 claim 级 ≥3 比例与 judge 与人类的一致性。来源用两名标注者对同一批 73 条 claim 独立评分,judge 与标注者 1 在 93% 的 claim 上分差不超过 1 分,≥3 阈值上标注者间一致性 κ=0.62。若你的复现里一致性明显低于这个区间,先怀疑 judge 而非模型。这套流程测的是结论强度与证据强度之差,不是结论真假,变量隔离的结论也只能落在这一层。 本节结论
先看分数分布的中段与尾部,再按机制归类失败样本,别用均值下结论。
读结果时先分清两件事:分数分布的形状,和单条 claim 的失败方式。来源报告的平均 SmoothScore 区间很宽——Luna 为 1.66–1.95,Sol 为 1.82–1.93,Gemini 为 3.05–3.27,其余系统落在 2.20–2.88。 这条“中间相似、尾部不同”的曲线,直接决定诊断顺序。如果你只看均值,Sonnet 5 和 Opus 5.5 与 Luna、Sol 的差距并不刺眼;所以第一步不是问“谁更差”,而是问你的复现落在分布的哪一段:中段偏移更像校准或聚合问题,尾部堆积才更像系统性过度概括。 失败样本要按机制归类,而不是按分数排序。来源给的原型例子是“离散图像 token 建模比以 Stable-Diffusion 为中心的架构更有前景”:它被 Emu3 和 Show-o 两篇引用文档支持,但同一批来源加上 Transfusion 论文,又显示该结论只在特定条件下成立、并存在反证。这正是 unsupported composition 与 scope expansion 的合体——每篇引用都真,拼起来的结论却超出了证据。读到这类样本,先回查它引用的全部文档里有没有被略去的限定条件,而不是先怀疑引用造假。 开源系统提供了另一类失败样本。来源报告 DR Tulu 与 QUEST 的均值与 Sonnet-5 相当或略高,但至少约 59% 和约 55% 的 claim 得 ≥3,7%–23% 得 ≥4;QUEST 的证据池最小(约 10 篇文档、40–55k 词),却产生最多约 7% 的 5 分 claim,而闭源系统通常只有 1%–2%。来源的解释是 QUEST 的输出更像摘要而非综合:细节保留忠实,但范围被夸大。这提示你,证据池小不等于结论保守,压缩率高的系统反而更容易把局部结果说成普遍结论。 还有一个容易误读的相关性。跨系统看,引用文档更多(ρ=0.37,p=.056)或 claim 写得更长(ρ=0.43,p=.02)的系统 smoothing 更重,Gemini 在两端都是极值;但在同一系统内部,这两个关系几乎消失(ρ=0.03 与 0.02,符号混杂),只有报告长度存在很小的系统内关联(ρ=0.12)。所以曲线上的跨系统趋势是系统能力的代理变量,不是因果开关,不能据此说“少引几篇就能减轻 smoothing”。 诊断落到操作上:先画每个系统的分数直方图,确认 ≥3 与 ≥4 两段的占比是否与来源区间同量级;再抽 10–20 条 ≥3 的 claim,逐条标注它属于组合无据、范围扩张还是措辞收尾;若你的失败样本大量落在“没读原文”上,问题在检索链路;若读全了仍然过度概括,才轮到打分与聚合逻辑。边界说明:来源把 5 分定义为接近纯幻觉且实际很少出现,作者因此将该系统定位为分析 smoothing 而非通用幻觉检测;它测的是结论强度与证据强度之差,不是结论真假。来源未报告随机种子与多次运行的方差,单次分数差不能当作稳定效应;上述比例与相关系数均来自该论文的 4 个基准、7 个系统设置,换数据集或换 judge 后需重新核对。本节结论
复现顺序:先验证据落地,再对齐人类评分,最后单变量归因与失败样本归类。
把前四节的诊断收成一张可执行清单,顺序比内容更重要:先确认链路能跑通,再确认评分对齐人类,最后才谈变量归因。来源给出的流程是抽 claim、Support Agent 找支持证据、Skeptic Agent 找限定与反证证据、按 aspect 聚类、打 1–5 分,五步中任何一步错位,后面的分数都不再指向 smoothing。 第一步是证据落地检查。来源记录 Luna 只打开了 19% 的引用页面、Sonnet 5 仅 2%,Luna 主要依赖被工具截断的搜索摘要(中位数 585 字符)。复现时先逐条确认 claim 对应的引用页面能被实际抓取解析,再谈打分;否则你测的是摘要与结论的匹配度,不是原文与结论的匹配度。 第二步是小样本对齐人类评分。来源用两名标注者独立评了同一批 73 条 claim,judge 与标注者 1 在 93% 的 claim 上分差不超过 1 分,≥3 阈值上标注者间一致性 κ=0.62。你的复现若一致性明显偏离这个区间,先怀疑 judge 偏严或偏松,而不是急着宣布模型 smoothing 严重。 第三步是单变量对照,一次只改一个因素。可改的三处来源都有记录:是否强制打开引用页面;是否给全文加校准指令(来源报告 Luna 的 ≥3 比例从 29% 降到 12%,Sonnet 5 从 61% 降到 25%);证据呈现方式给全文还是给 SmoothScore 收集的证据。消融则逐个关模块,例如去掉 Skeptic Agent 看 ≥3 比例是否上升,去掉 aspect 聚类看同一结论的碎片是否被重复计分。 第四步是失败样本归类,而不是按分数排序。来源归纳的三种模式可直接当标签:unsupported composition、scope expansion、premature closure。抽 10–20 条 ≥3 的 claim 逐条标注,若大量落在“没读原文”,问题在检索链路;若读全了仍过度概括,才轮到聚合与打分逻辑。 边界要一次说清:来源把 5 分定义为接近纯幻觉且实际很少出现,作者因此将该系统定位为分析 smoothing 而非通用幻觉检测,它测的是结论强度与证据强度之差,不是结论真假;来源未报告随机种子与多次运行的方差,单次分数差不能当作稳定效应;上述比例与一致性系数均来自该论文的 4 个基准、7 个系统设置,换数据集或换 judge 后需重新核对。对硕博生的可执行启发是:把“引用齐全”与“结论成立”拆成两个独立检查项,先修链路再修措辞,论文写作里也照此顺序自检。 原文与核验
本文中的数据、方法和结论边界均以原始来源为准。建议在引用或设计实验前阅读全文。
https://arxiv.org/abs/2610.35793v1[2]
你的研究卡在哪一步?
如果你正在经历选题迟迟定不下来、基线跑不通、实验结果不稳定或论文论证链不清晰,可以把具体问题告诉我们。我们会先判断问题属于选题、方法、实验还是表达,再匹配相应方向的专业老师提供科研辅导;辅导只做选题讨论、实验诊断和论文表达反馈,不代写、不伪造数据、不承诺录用。
在公众号后台回复「科研」,并附上:研究方向+当前阶段+具体卡点。
我们提供合规的选题讨论、实验诊断和论文表达辅导,不代写、不伪造数据、不承诺录用。
阅读边界
研究结论以原论文及其后续版本为准;预印本尚可能在同行评审后修订。文中研究建议属于基于论文证据的延伸,不等同于作者结论。
参考链接
[1] https://arxiv.org/abs/2610.35793v1
[2] https://arxiv.org/abs/2610.35793v1

 研报速递