
 研报速递
AI不生成文本,直接输出概率:Jev是不是下一代基础模型范式?
过去三年,大模型给人的印象是“越来越会聊天”。
但现实世界里,大量企业任务其实不需要“会说话”的模型,只需要对模糊状态做快速、可组合、带概率的判断。
比如:客服对话要不要转人工?发票该不该支付?这条代码检索结果是否相关?
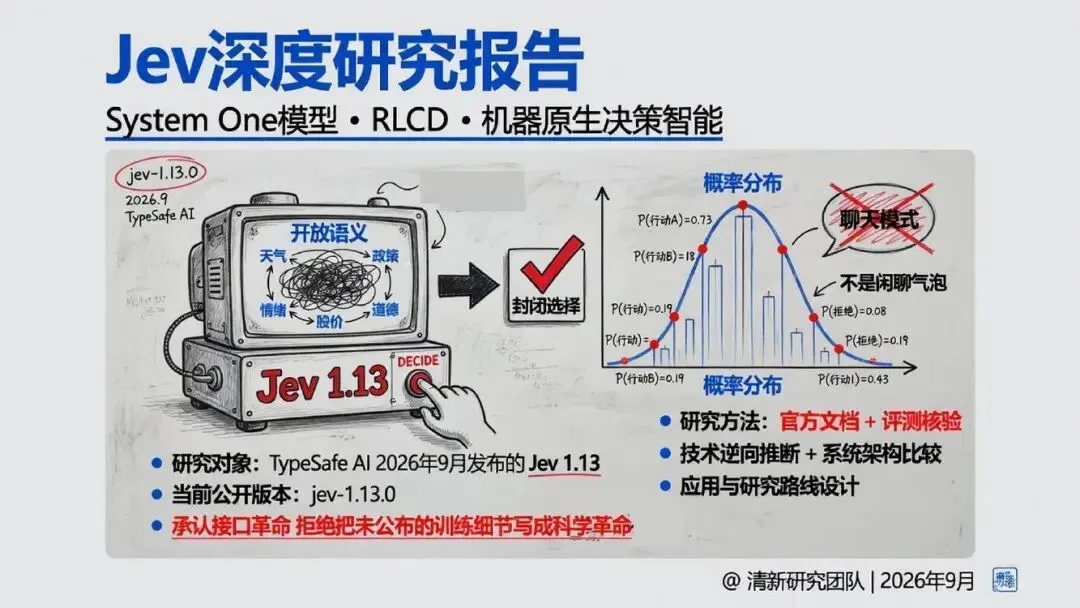
最近读了清华大学清新研究团队发布的《Jev深度研究报告》。报告的主角,是TypeSafe AI在2026年9月发布的System One模型——Jev 1.13。
它提供了一个非常不同的技术视角:不生成文本,直接输出封闭类型和概率。
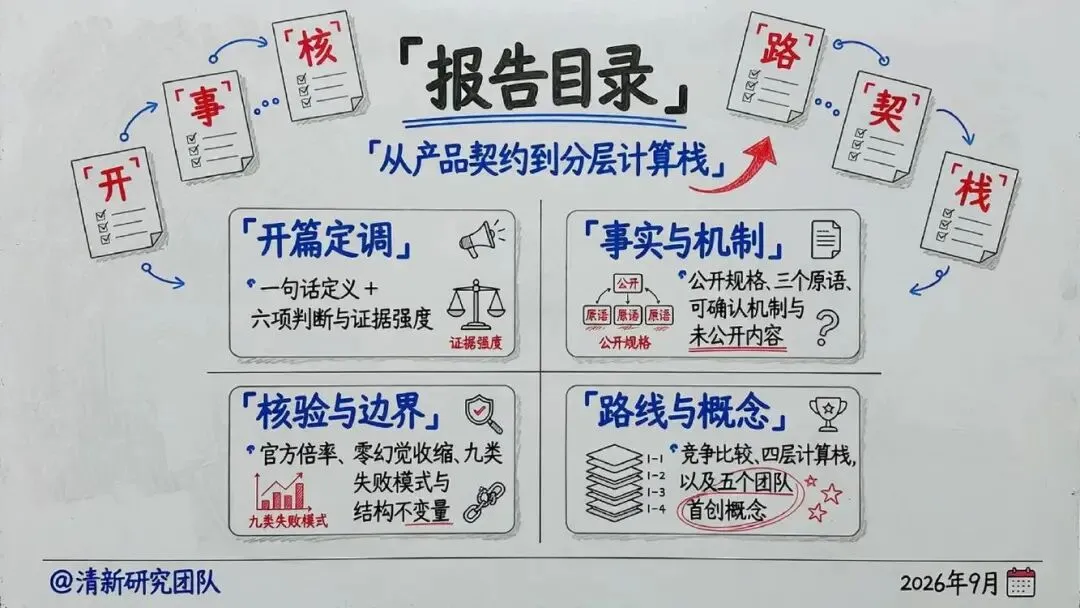
这份报告最难得的地方在于,它做了一件现在很稀缺的事:明确区分了“能确认的”和“不能确认的”。
01 Jev是什么?——从“生成字符串”到“封闭决策”
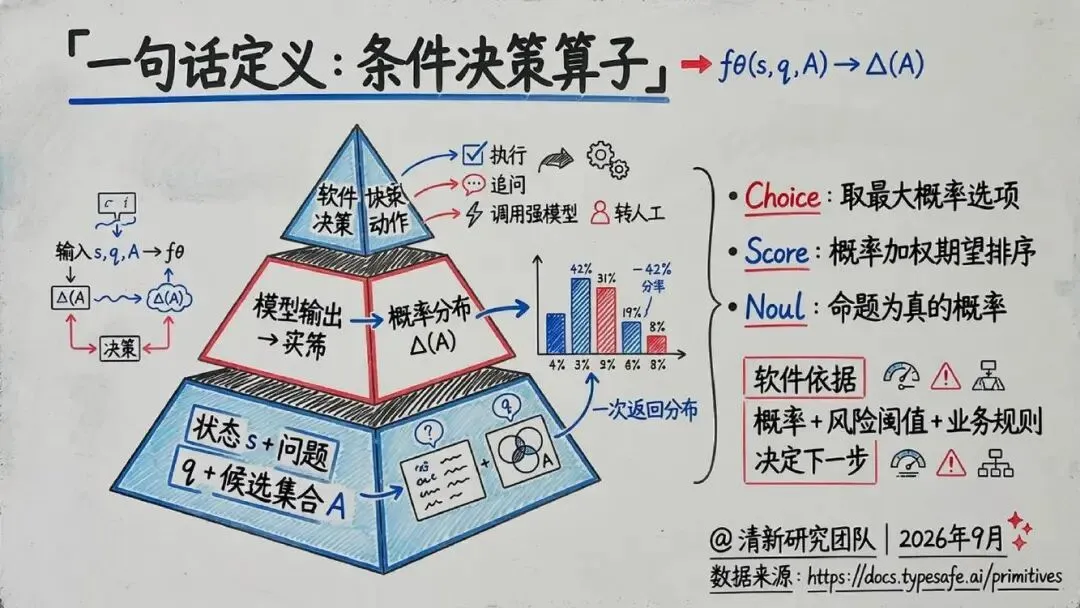
报告用一句话定义了Jev:
条件决策算子:fθ(s,q,A)→Δ(A)
简单说,你给它一个状态(state)、一个问题(q)和一个候选集合(A),它返回的是一个概率分布,而不是一段文字。
这和普通大语言模型的本质区别在哪?
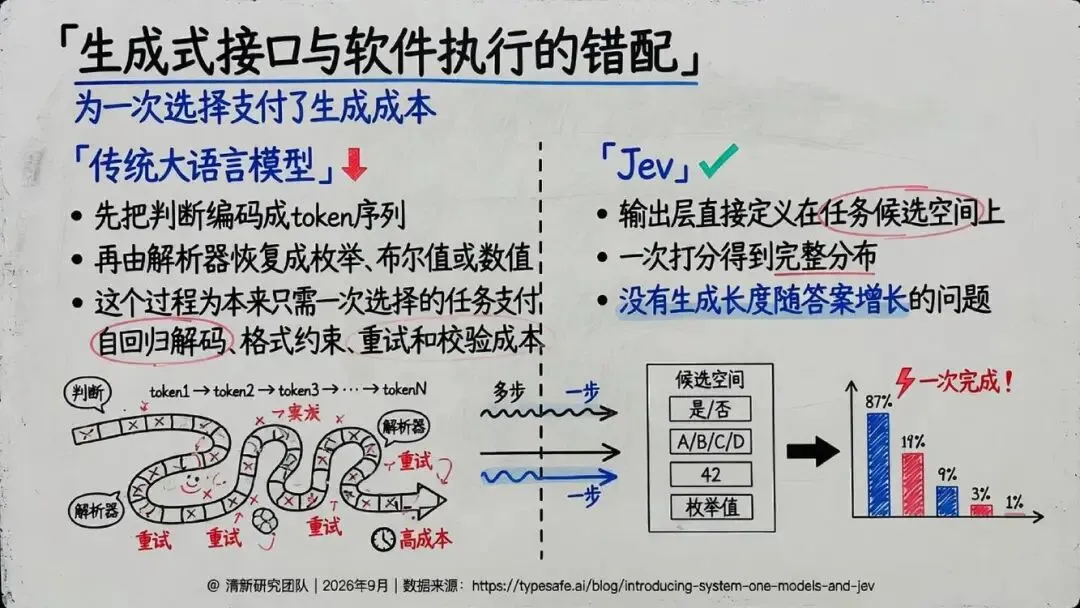
传统大模型的产品契约是生成字符串:它需要先把判断编码成token序列,再由解析器恢复成枚举、布尔值或数值。这个过程为本来只需一次选择的任务,付出了自回归解码、格式约束、重试和校验的成本。
Jev把产品契约改造成了:对开放语义进行封闭决策。
开放语义理解:依然用自然语言输入,保留零样本迁移能力;
运行时封闭输出:调用方给出合法答案集合,模型只能在这个集合上返回概率分布。
它用预定义的三个原语——Choice(选择)、Score(评分)、Noul(命题真伪)——换取了类型安全、并行计算、低延迟和可门控的不确定性。
02 为什么它可能更快、更便宜?
这些数字是如何成立的?报告梳理了五条机制解释(注意:是“机制解释”,不是“普遍保证”):
共享状态编码:一个state同时对应多个问题,模型只读一次状态;
并行问题求值:多个问题并行输出决策,无需逐token解码;
避免逐token解码:不生成自然语言,避开长输出费用;
任务拆成浅判断:用较浅判断取代长链推理,结构和算术交给代码;
极低输入价格:可能包含商业策略。
报告特别提醒:官方预期这些数字处于真实收益的高端区间,公司也承认无法证明当前价格未被补贴。倍率不能跨行业复写。
03 它在和谁竞争?——不是聊天模型,是“判断网关”
报告有一个很清晰的判断:Jev不与聊天模型争夺同一槽位。
真正的竞争,是软件如何得到一个类型化判断。它面对的是规则引擎、传统分类器、小模型结构化输出等六条路线的分工。
它和传统分类器的区别不是“输出为类别”,而是每次请求都能用自然语言现场定义新问题和新标签;它和大模型结构化输出的区别是,输出头与采样过程原生受限,而不是先生成token再验证。
但报告也强调:类型安全不是语义正确。 正确格式的答案,仍可能语义错误。
04 最难得的:区分“接口成熟度”与“模型成熟度”
接口成熟度:较高。 三个原语、并行问题模式、SDK和LangChain集成,都是公开可验证的。
模型成熟度:早期。 仅有Jev 1.13,权重未开放,官方文档列出了9类失败模式(字面理解、计数、日期、多跳间接、长状态干扰、对抗内容等)。
证据成熟度:不足。 RLCD(目标名称)没有论文、数据集、训练配方和校准图。
报告的核心结论是:
“承认接口革命,拒绝把未公布的训练细节写成科学革命。”
从公开证据看,Jev已经构成有意义的新产品路线,但尚不足以证明一种完整的新基础模型范式。
05 “零幻觉”的边界与结构不变量缺口
所谓零幻觉,只在语法和类型层面成立。
Jev不能生成不存在的字段、非法枚举或脱离格式的文本,类型幻觉可以被结构上消除。但它仍可能在证据不足时选错类别、误解否定词、把恶意文本当指令,或以很高概率支持错误判断。
报告还指出了一个“结构不变量缺口”:同一张工单上,Noul问“是否要求退款”得到0.22,而Choice的“yes”只有0.01;另一张工单上,退款Noul是0.72,非退款Noul是0.47,两者之和居然等于1.19。
这说明当前的输出更像“绑定于提问形式的条件评分”,而不是满足互补、守恒和单调性的世界模型。
缺口不否定产品价值,但否定把一次请求里的多个概率当成可以互相加减的物理量。安全关键系统必须在单一问法下校准阈值,并用代码强制一致性。
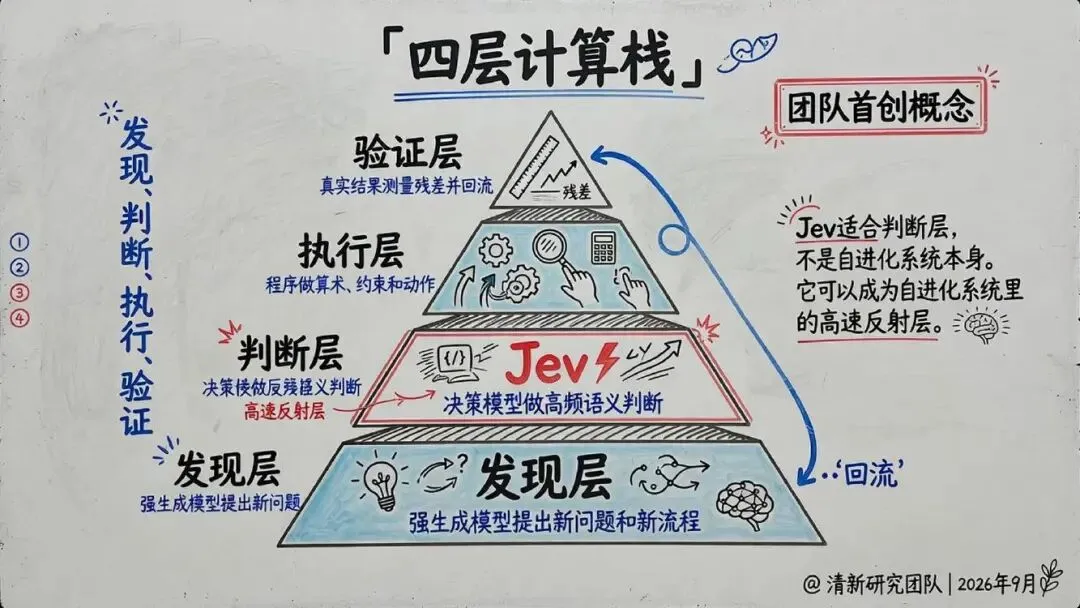
06 对实践者的启示:四层计算栈
发现层:强生成模型提出新问题和新流程;
判断层:决策模型(如Jev)做高频语义判断,作为高速反射层;
执行层:程序做算术、约束和动作;
验证层:真实结果测量残差并回流。
Jev适合判断层,不是自进化系统本身。它可以成为自进化系统里的高速反射层。
最值得复制的是:按信息形态分配模型、把概率当成接口、把稳定能力编译到更便宜的执行层。
写在最后
“Jev是重要的系统创新,也可能包含重要的模型创新,但公开证据目前只足以确认前者。”
对于企业技术选型和研发团队来说,它提供了一个非常有价值的视角:不是所有AI任务都需要“生成”,很多任务只需要“判断”。
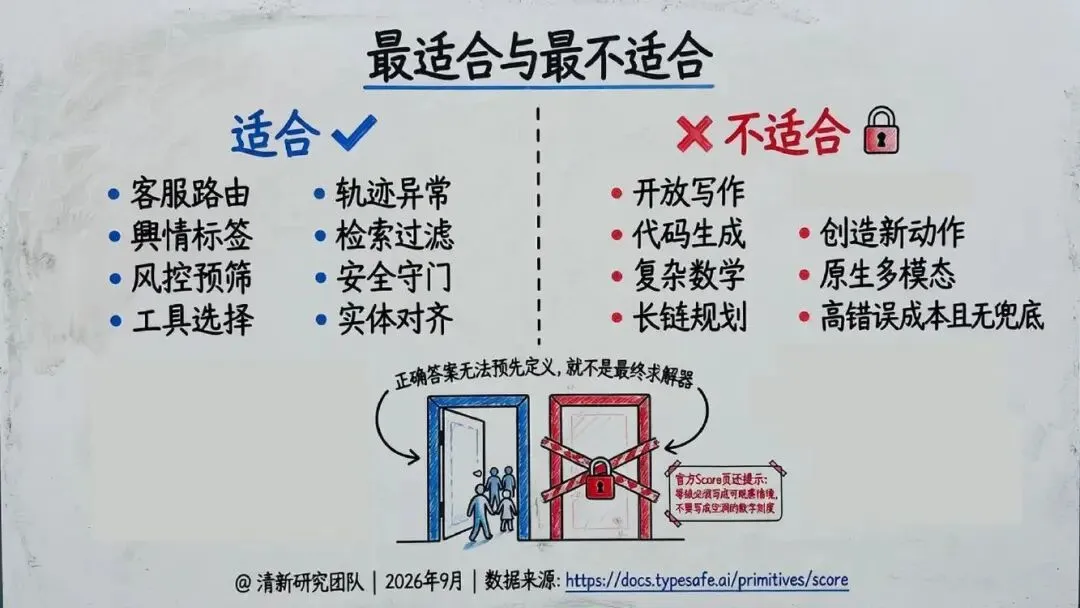
如果你们正在做客服路由、风控预筛、安全守门、检索过滤这类高频、有明确候选集、且结果可验证的任务,Jev代表的“封闭决策”范式值得关注。
但也要记住报告的提醒:把概率当接口意味着校准必须成为软件正确性的一部分;阈值不能跨风险类别通用;中文业务必须用中文金标准重测。
内容来源网络,侵权请联系删除。


发表评论
发表评论: