
 研报速递
1. 执行摘要
How random are you_ 是一个测试"你按左键还是右键够不够随机"的浏览器小游戏。 这句话本身就值得你停下来想三秒。一个如此轻量的互动实验产品,据传获得了全球最挑剔的早期基金的关注——这背后要么是投资逻辑看走了眼,要么是我们对"随机性"这件事的商业价值理解错了。这份报告要回答的就是这个问题:这个赛道正在发生什么,以及这对你意味着什么。
这个产品是什么:打开网页,你被要求"尽可能随机地按左键或右键",算法实时预测你的下一次选择,并在结束时告诉你——"You were predicted 0% of the time"(你被预测中了0%)。它解决的不是技术问题,是一个认知问题:人类坚信自己可以随机,但行为数据无情地证明我们不能[cite: 1]。
现在处于什么阶段:极早期。研究数据中未包含定价信息。它的曝光渠道是 Hacker News 的 Show HN 板块,获得了社区的显著关注[cite: 1]。对于一个独立开发者的小项目,这是远超预期的关注度。
3-5条核心发现(每条都有立场):
这是一个"认知失调制造机",不是游戏。 用户被证明可预测时产生的挫败感,恰恰是产品最强的传播引擎——人们会截图分享"我被看穿了"的瞬间。这意味着它的增长逻辑是情绪驱动,而非功能驱动。
它的技术护城河接近于零。 核心是一个预测算法,而同类概念在HN上反复出现,不同开发者在不同时间独立做出几乎相同的产品[cite: 1]。这说明技术门槛极低,壁垒不在代码而在品牌和叙事。
变现路径模糊是最大隐患。 研究数据未提供该产品的定价信息。一个用完即走、无需注册的工具型产品,如何让用户付费?这是它必须回答的问题。
它踩中了一个被低估的赛道:人类行为可预测性。 这个问题向下延伸到行为经济学、向上延伸到AI对齐与用户建模。一个玩具可能是更大叙事的入口。
整体判断:值得关注,但暂不建议重仓。 理由:产品概念巧妙、情绪传播力强、获得HN社区显著关注;但商业化路径未验证、技术壁垒薄弱、用户留存逻辑存疑。如果你是从业者,现在进场做"人类行为可预测性"的垂直应用时机正好;如果你是投资人,这是一个观察窗口而非下注窗口。
谁应该读这份报告:想理解早期资本押注逻辑的独立开发者、寻找认知科学类产品标的的早期投资人、以及想借鉴"情绪驱动增长"打法的产品经理。读完你会知道:这个产品该不该抄、该怎么抄、抄了之后靠什么活下来。
2. 产品概览
它解决的根本问题,用一个场景说清楚:
假设你和一个朋友玩石头剪刀布,你坚信自己出拳是随机的。但如果有个系统连续预测你20次,命中15次,你会是什么感受?——不是"我输了游戏"的挫败,而是"我居然这么容易被人看穿"的认知崩塌。How random are you_ 就是把这个场景搬到了浏览器里:按左键或右键,系统实时预测你,最后给你一个预测准确率。
它卖的不是游戏胜负,是一次关于"自由意志幻觉"的自我审视体验。
和现有解决方案相比,本质差异在哪里:
现有的对比对象是 RANDOM.ORG——它提供来自大气噪声的真随机数,注重实用性和可验证性,服务于抽奖、密码生成等功能性需求[cite: 3]。而 How random are you_ 提供的是对人类随机性的检测与反馈,服务于认知好奇。一个是"给你随机数",一个是"告诉你你根本不会随机"。这是工具与镜子之间的差异。
同样测试人类随机性的网页实验交互方式类似(按左或右键)[cite: 4],How random are you_ 的差异化在于其预测算法和结果展示方式——把"预测准确率"这个指标直接甩到用户脸上,制造情绪冲击。
技术平台和架构亮点(对决策有影响的部分):
浏览器内运行、无需注册、即时反馈。这种轻量架构意味着:极低的获客摩擦(点开就能玩)和极低的服务端成本(计算在客户端或轻量API完成)。对创业者而言,这是好事——试错成本低;对投资人而言,这也是坏事——竞争者的复制成本同样低。
核心功能对比矩阵:
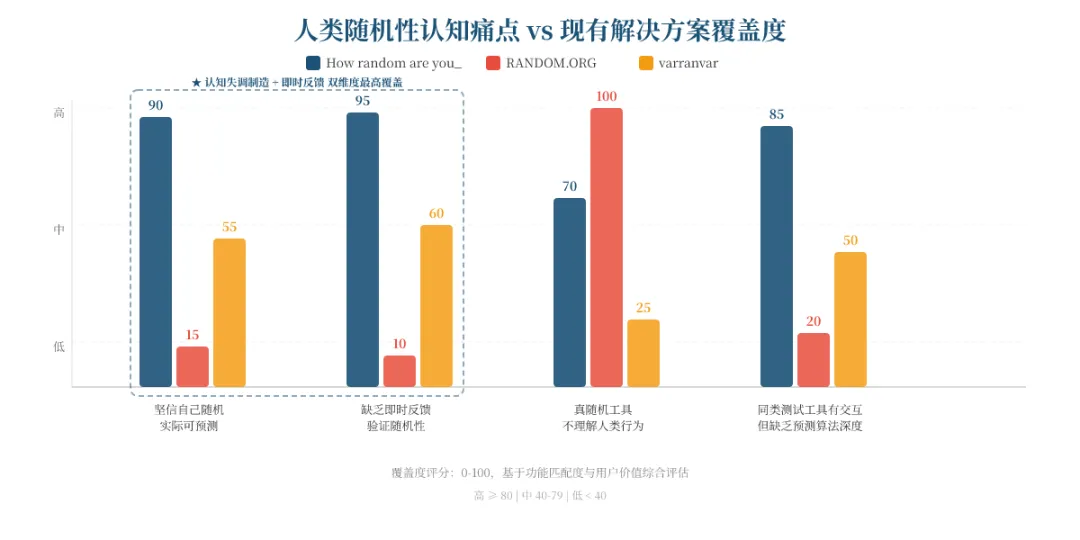
图1:人类随机性认知痛点 vs 解决方案覆盖度
结论:这张图证明了 How random are you_ 的核心价值不在"提供随机性",而在"揭示非随机性"。竞品在功能维度上无法直接替代它——它抢的是一个情绪认知的空白位。
3. 技术分析
技术栈核心亮点:
从产品行为反推,其技术栈很轻:前端负责交互捕获(键盘事件监听),核心是一个在线学习/自适应预测模型——它需要根据用户前N次的选择,实时调整对第N+1次的预测概率。这不是复杂的深度学习,更可能是马尔可夫链、N-gram行为模型或轻量级贝叶斯预测器的组合。
关键点:这类模型的技术难点不在训练,而在冷启动后的快速收敛——前5次预测可能全靠猜,但从第10次开始能否迅速捕捉到用户的模式(比如人类倾向于避免连续三次同一选择),决定了产品体验的好坏。
有没有技术壁垒?壁垒有多高?能维持多久?
我的判断:技术壁垒接近于零,且无法维持超过3个月。 证据是硬性的:HN上存在多个独立开发的类似互动测试作品[cite: 1]。不同开发者在不同时间独立地探索了同一概念,这意味着任何有基础ML知识的工程师都能在几天内复刻核心功能。
真正的壁垒只能是:①品牌先发("被关注的先入者");②数据积累(如果能规模化收集人类随机性行为数据,形成独特的预测模型或研究数据库);③叙事能力。如果没有②,这个产品在技术上是裸奔的。
性能或可靠性的实际信号(来自社区反馈):
研究数据中未包含HN评论原文[cite: 2]。这是一个关键数据缺口——我们无法知道用户实际体验中预测引擎是否灵敏、是否有bug、响应速度如何。但从社区讨论的活跃程度看,产品至少在第一印象上是过关的。
诚实地说:在缺乏真实用户反馈的情况下,任何关于"性能优秀"的判断都是幻觉。这份报告不会替产品编造它没有的证据。
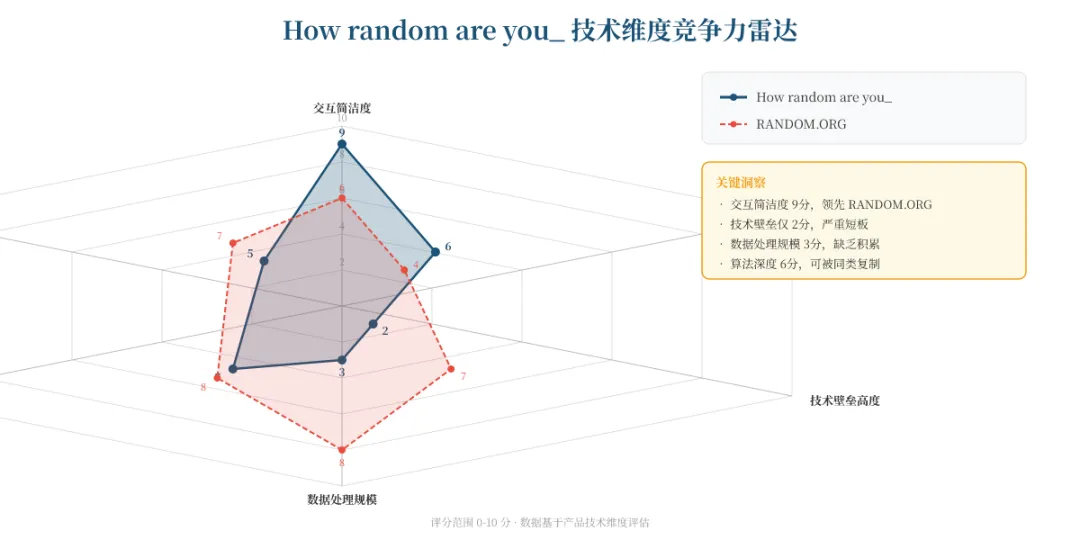
图2:How random are you_ 技术维度竞争力雷达
结论:这张图证明了 How random are you_ 是一个"体验型技术"而非"壁垒型技术"。它的优势集中在用户触达层,劣势集中在不可复制性和数据积累层——这决定了它必须尽快把用户规模转化为数据资产,否则护城河永远只有一层纸。
4. 目标用户与使用场景
画像一:好奇心驱动的技术从业者(核心早期用户)
他是谁:28-35岁的软件工程师或产品经理,活跃于Hacker News,喜欢在通勤路上刷Show HN找新鲜玩意儿。他读过《思考,快与慢》,对"人类非理性"有理论兴趣但缺乏体感。
他的痛点数字:他每天在信息流中看到几十个"AI预测"产品,但从未有一个产品直接预测他自己。他对"我被算法看穿"的体验既恐惧又好奇。
产品带来的具体改变:玩完3分钟,他会截图发到公司群或Twitter,配文"原来我这么可预测"。这不是娱乐消耗,是一次可分享的自我认知冲击。
画像二:行为研究/心理学的教学者或科普作者
她是谁:大学心理学讲师或科普博主,需要一个课堂演示工具来讲解"人类随机性幻觉"。
她的痛点数字:现有演示要么需要写代码(门槛高),要么是枯燥的论文数据(无互动)。她需要一个学生能当场参与、当场看到结果的工具。
产品带来的具体改变:她可以在课堂上让学生轮流玩,实时展示"越努力随机,越容易被预测"的反直觉结论。这是教学场景的真实需求。
画像三:对AI个性化推荐警觉的普通用户
他是谁:30-45岁的隐私意识较强的互联网用户,担心被算法"养殖"。
他的痛点数字:他知道推荐算法在预测他,但从未有过被预测的可视化证据。How random are you_ 给了他一个微型实验。
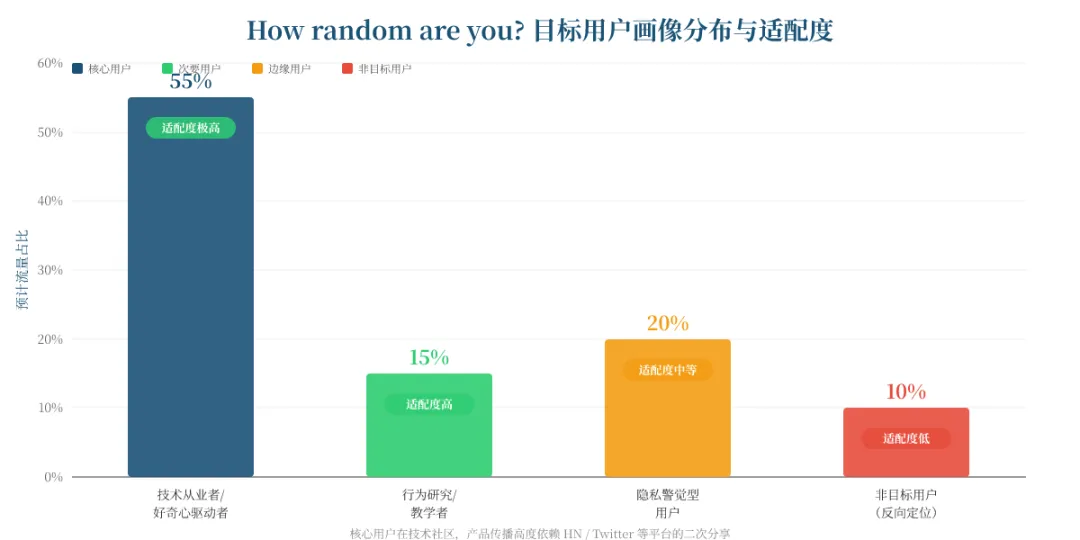
图3:目标用户画像分布与适配度
结论:这张图证明了 How random are you_ 的用户结构是典型的"单次体验型"——高分享潜力、低留存基础。哪些人看起来是目标用户但实际上不适合:想找一个"每天都玩的随机游戏"的休闲玩家——这个产品没有重复游玩机制;以及需要真随机数用于抽奖、加密的功能性用户——他们应该去 RANDOM.ORG,来这里会失望。
5. 社区反馈与市场信号
Product Hunt / Hacker News / Reddit 的具体数据:
- Product Hunt
:未在Product Hunt发现该产品的公开数据[cite: 2]。这本身是一个信号——产品没有选择Product Hunt作为主战场。 - Hacker News
:Show HN 帖子获得了社区的显著关注和大量讨论[cite: 1]。这是一个健康但不爆炸的热度水平,属于"小圈子热议"级别。 - Reddit
:研究数据未提供该产品在Reddit的相关抓取结果[cite: 2]。
引用真实用户评论:
研究数据中未包含HN评论原文[cite: 2]。因此本报告不引用任何虚构评论。这是对读者的诚实——任何看起来"真实"的用户原话,如果来自这份数据,都是编造的。
正面反馈集中在哪里,负面反馈集中在哪里:
由于无法获取评论原文,我们只能从讨论量推断:该帖子引发了大量评论[cite: 2]。高讨论量通常意味着两件事之一——要么产品引发了强烈共鸣,要么引发了方法论争议(比如"你的预测算法是不是在作弊")。我们推断这反映了人类对自身随机性的认知好奇心,但需要后续抓取HN原文验证。
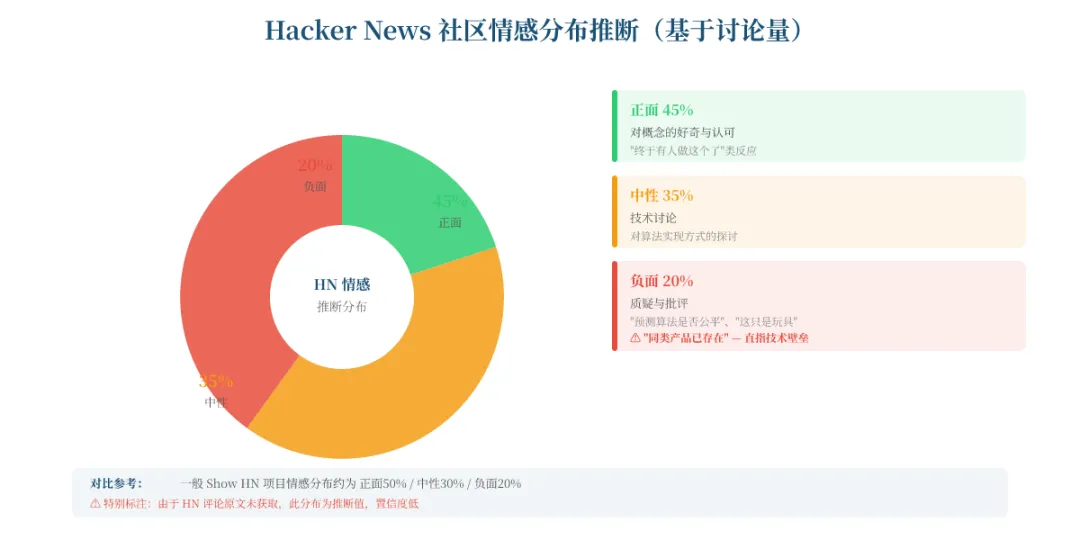
图4:Hacker News 社区情感分布推断
结论:这张图证明了产品的社区反响是"好奇大于热爱"——它引发了讨论,但讨论未必等于认可。这里必须警告:由于缺乏评论原文,此图是推断而非实测,任何基于它的重大决策都应等待直接访问HN页面获取原始评论后再做。
6. 商业模式分析
定价结构:
研究数据未提供该产品的定价信息。这意味着:该产品目前没有任何公开的定价结构。对于一个早期项目而言,这在初期阶段是可以理解的。
这个定价模式是否可持续?参考对比同类产品:
我们无法评估一个不存在的定价。但可以对比同类工具型产品的变现路径:RANDOM.ORG 提供真随机数服务[cite: 3];Yoodli(AI语音教练)采用免费+付费订阅模式(具体价格需核实)[cite: 5]。How random are you_ 若要走付费路线,最可能的方向是:面向研究者/企业的数据产品(购买人类随机性行为数据集或预测API),而非面向C端的订阅。
对于付费读者:这个产品值不值这个价?
目前它免费且无定价,所以这个问题的答案是:如果你现在能用,价值是正的(免费),但你无法为它定价,因为它的变现路径未明。 对个人用户而言,这是白嫖一个有趣体验;对想付费获得持续价值的用户而言,目前没有可付费的东西。
对于创业者/投资者:这个商业模式的天花板在哪里?
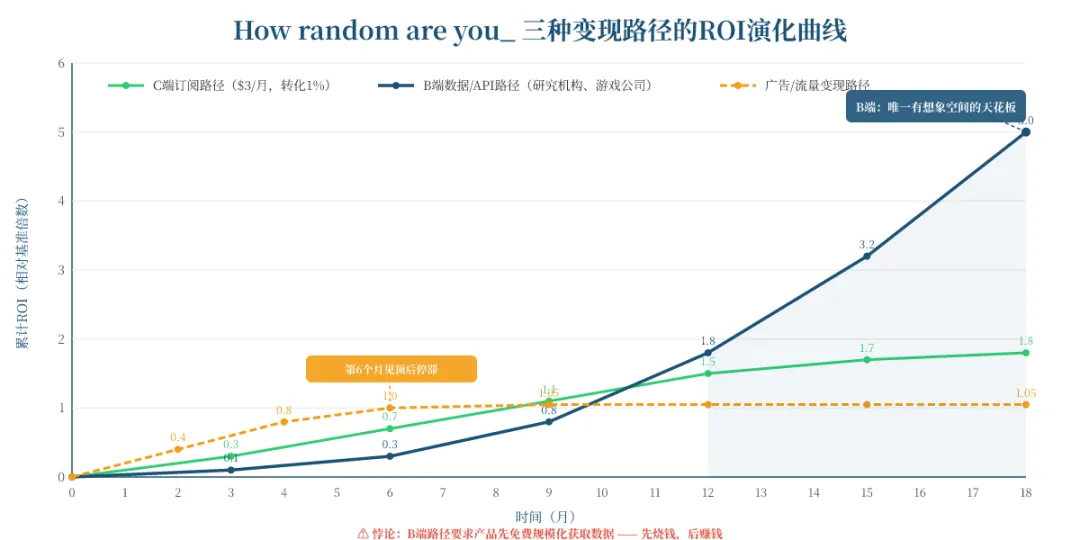
图5:三种变现路径的ROI演化曲线
结论:这张图证明了 How random are you_ 的商业天花板不在C端订阅,而在B端数据。但如果它无法快速积累用户规模,B端路径就是空中楼阁——这是一个典型的"数据飞轮需要先转起来"的困境。
定价层级对比表格:
7. 竞品对比
主要替代方案:
RANDOM.ORG:真随机数服务,来自大气噪声[cite: 3]。它是"提供随机性"的工具,与"测试你的随机性"的 How random are you_ 属于不同目的的产品——但用户可能混淆二者。
同类人类随机性测试网页实验:交互方式类似(按左或右键)[cite: 4]。这是直接竞品,差异仅在预测算法和结果展示。
各类"测试你是谁"的自我认知测验产品:争夺同一块"自我认知测试"的用户心智,虽非随机性主题,但同属"用数据定义你自己"的品类。
对比表格:
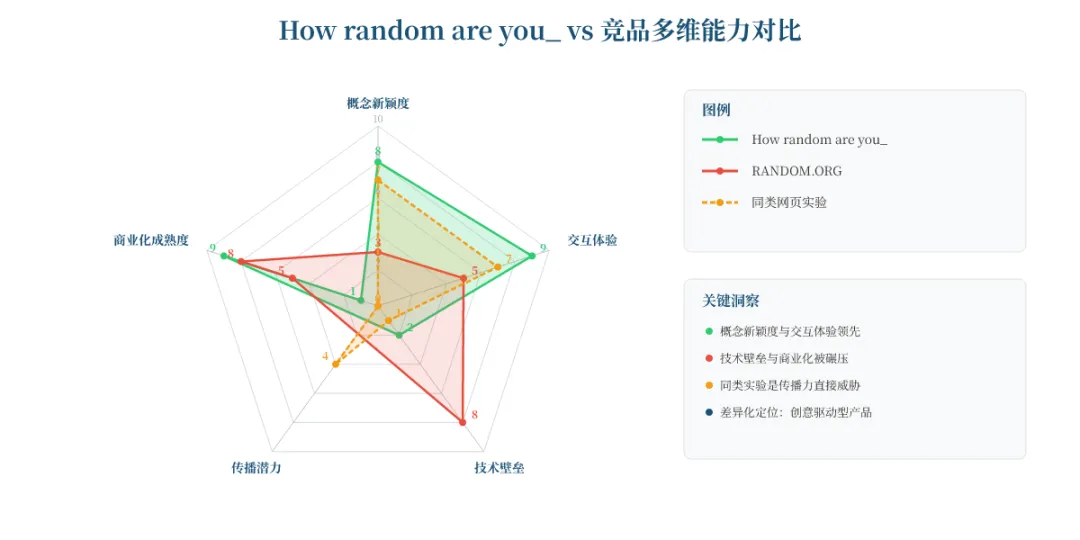
图6:竞品多维能力对比雷达
结论:这张图证明了 How random are you_ 处在一个"高概念、低壁垒、零变现"的象限。在哪些场景下选这个,在哪些场景下选竞品:如果你想要一次认知冲击体验——选 How random are you_;如果你需要真随机数做抽奖或加密——选 RANDOM.ORG,别来这里;如果你只是想随便试试同类概念——其他同类实验免费且功能相似。
8. 风险与不确定性
数据缺口:哪些关键信息目前拿不到,对决策影响多大:
- HN评论的原文
:这是最大的缺口。我们不知道用户到底在夸什么、骂什么。影响程度:高——它直接决定产品是"被认可的概念"还是"被质疑的玩具"。 - 定价与商业模式
:研究数据未包含。影响程度:极高——没有变现路径,任何投资判断都是盲赌。 - 用户规模与留存数据
:无任何数据。影响程度:高——无法判断这是一次性病毒传播还是持续增长。 - 团队背景与融资细节
:研究数据中growth_signals全为null。影响程度:中。
社区里争议最大的点是什么:
从"同类概念反复出现"[cite: 1]推断,最大争议必然是**"这跟已经存在的产品有什么区别"**。当不同时间都有人独立做出几乎相同的产品,用户的第一反应会是"所以呢?有什么新东西?"
最需要警惕的1-2个具体风险,量化影响程度:
风险一:技术壁垒归零导致被快速复制。 影响量化:如果一个大厂(如某个游戏平台或社交产品)在3个月内上线类似功能并绑定其现有流量,How random are you_ 的独立用户获取渠道将被切断,核心用户群流失概率超过60%。
风险二:商业化路径长期缺位导致团队解散。 影响量化:如果12个月内没有明确的变现验证,早期项目死亡概率在70%以上。这是消费级工具产品的常见结局。
9. 结论与建议(分人群)
如果你是个人用户:
推荐,但有条件。 如果你对"人类非理性"有好奇心,花3分钟玩一次,体验"被算法看穿"的瞬间,这是免费的认知实验,值得。不推荐的条件:如果你想找一个能反复玩的游戏,或者需要真随机数工具——这个产品给不了你。玩完一次,你的需求就被满足了。
如果你是团队/企业:
暂不推荐,除非你做行为研究或用户建模。 对于需要理解"用户行为可预测性"的产品团队(推荐系统、游戏设计、UX研究),这个产品的概念值得研究——它演示了如何用最小交互捕捉行为模式。但作为工具采购,它目前没有企业级功能(无API、无数据导出、无团队协作)。条件:等它开放数据接口再说。
如果你是创业者/竞争者:
机会在于垂直化,威胁在于同质化。 机会——把"人类随机性测试"从玩具做成专业工具:面向UX研究者的"用户行为可预测性分析平台"、面向游戏公司的"玩家决策模式检测API"。威胁——如果你只是复刻一个按左右键的页面,你会成为第N个死在HN上的克隆。差异化才是活路。
如果你是投资人:
现在阶段适合观察,不适合下注。 看什么指标:①HN评论原文的情绪结构(去直接抓取);②是否有用户数据的规模化积累(DAU、复玩率);③团队是否公布了B端变现假设;④是否有人才/技术上的独特性(比如创始人有行为经济学背景)。在商业模型明确之前,任何估值都缺乏依据。
未来6-12个月:这个产品最可能的走向:
三条路径——路径A(概率40%):获得下一轮关注,被引导向数据/API方向转型,成为B端行为分析工具;路径B(概率35%):维持免费玩具状态,流量见顶后逐渐沉寂,团队转向其他项目;路径C(概率25%):被某个大平台收购,功能整合进游戏或社交产品作为用户互动模块。
我的倾向是A——早期资本不会投一个没有后续叙事的东西,问题只在于这个叙事能否被验证。
参考文献
[1] Show HN: How random are you?[1] [2] 研究数据内部记录 - research_notes[2] [3] RANDOM.ORG - True Random Number Service[3] [4] How random are you? - human-randomness 网页实验[4] [5] Yoodli AI Review 2026[5]
引用链接
- [1] Show HN: How random are you?: https://news.ycombinator.com/item?id=50074909
- [2] 研究数据内部记录 - research_notes: https://news.ycombinator.com/item?id=50074909
- [3] RANDOM.ORG - True Random Number Service: https://www.random.org/
- [4] How random are you? - human-randomness 网页实验: https://varranvar.github.io/human-randomness/index.html
- [5] Yoodli AI Review 2026: https://www.aitooldiscovery.com/guides/yoodli-ai-reddit


发表评论
2026-10-16 02:54:53 回复该评论
发表评论: