
 研报速递
📄 本文PDF完整版已上传云盘,点击链接保存后可随时查阅:https://pan.quark.cn/s/0c61b62a472d
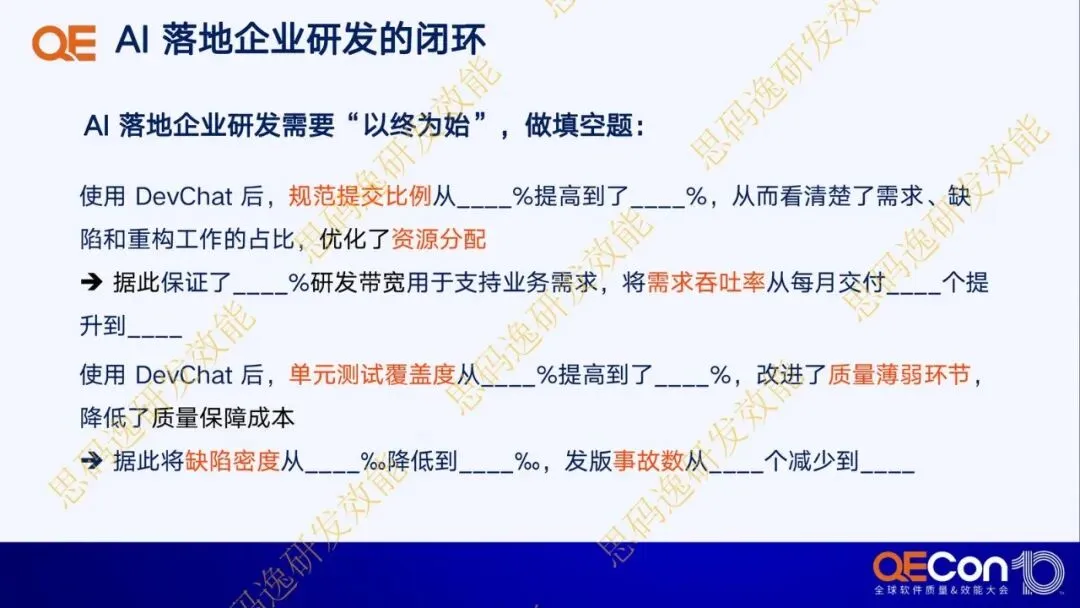
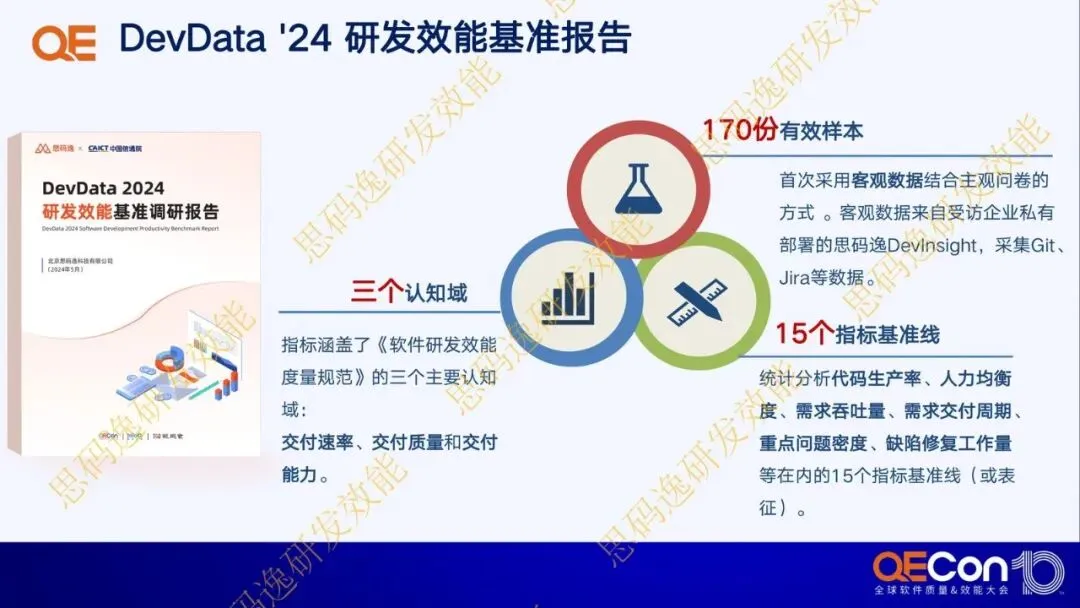
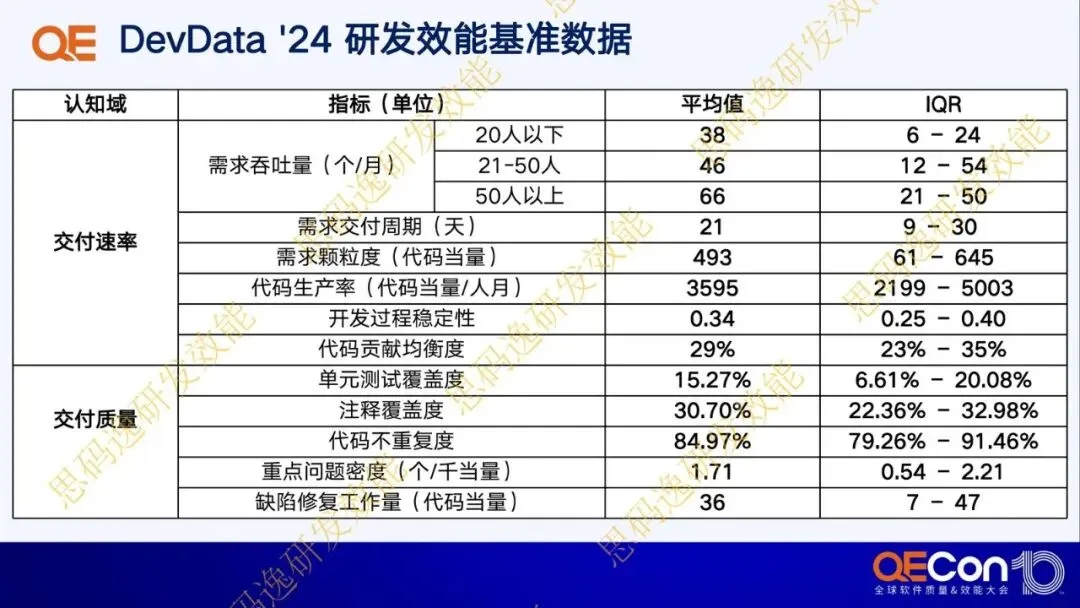
大模型进研发,卡点不在模型够不够聪明,而在企业还没把“写代码—测代码—交付—反馈”收成闭环;DevData24 的基准把这件事说得很硬:中位单元测试覆盖度只有 15.27%,注释覆盖约 30.7%,真正能稳交付的团队变更失败率才压在 15% 以内。
现在谈落地,是因为生成代码已经能进仓库,但效能数据还停在“能写、不敢放、测不全”的阶段。受益的是能把当量、覆盖率、失败率串成度量的团队;受损的是只会堆 Copilot 席位、需求仍以百当量以上大颗粒往下砸的组织。后文就盯三件事:测试地基、贡献结构、需求切法。
效能地基比模型更薄
单元测试覆盖度中位 15.27%,区间大约 6.61%–20.08%。注释覆盖度中位 30.70%,落在 22.36%–32.98%。代码不重复度相对好看,中位 84.97%,区间 79.26%–91.46%。
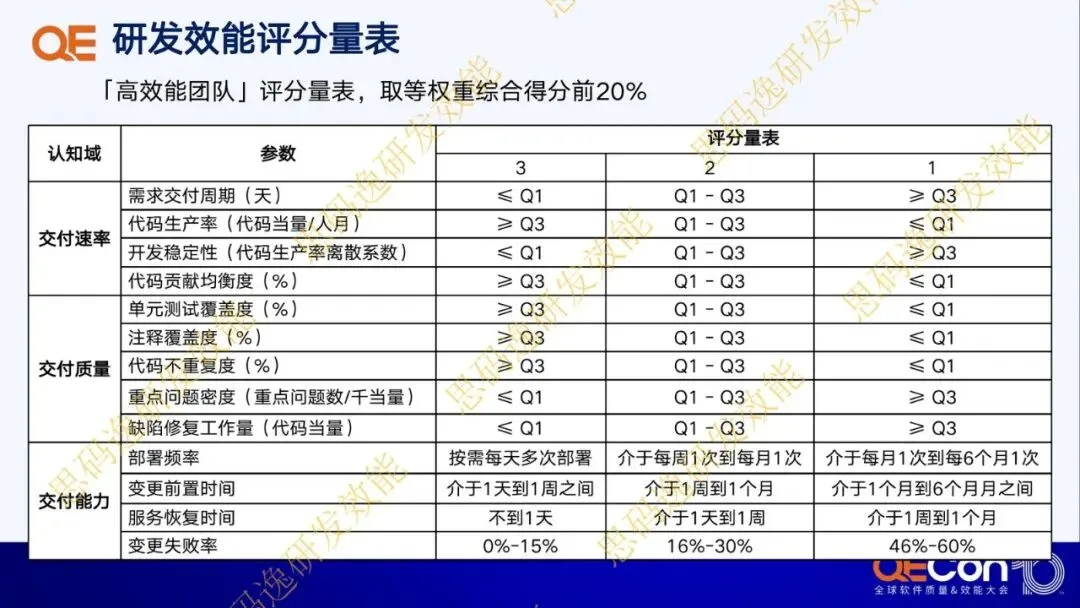
生成代码会放大“没测的部分”。覆盖率停在一成五附近时,模型写得越快,回归面越大。不重复度近八成五,说明复制粘贴不是主矛盾;主矛盾是可验证性。谁会先受益:本来就把单测和注释当交付门槛的团队。谁会先疼:靠人工盯 diff、失败率已经滑到 16%–30% 甚至 46%–60% 的团队。
人效不平均,闭环更容易断在少数人身上
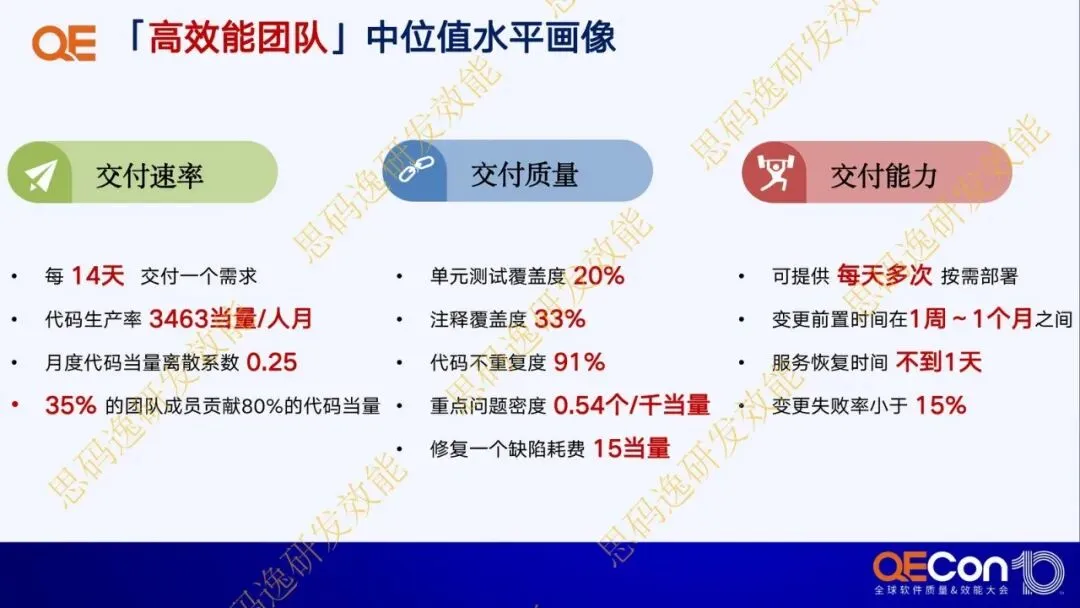
约 35% 的团队成员贡献了 80% 的代码当量。基准侧还给出一组“像样”的水平:代码生产率约 3463 当量/人月,注释覆盖约 33%,重点问题密度 0.54 个/千当量,变更失败率小于 15%,变更前置时间多在 1 周到 1 个月。
贡献过度集中,大模型席位如果只发给那 35%,产出会再被抽成更陡的二八。失败率压不住 15%、前置时间还在周到月量级,说明瓶颈在评审、测试和发布,不在敲键盘。接下来该盯的是:当量向腰部扩散,还是头部更忙、失败率跟着模型用量一起爬。
需求切不小,模型很难进闭环
约 34% 的软件需求,平均颗粒度在 100 当量以内。换句话说,大部分需求仍偏大。大颗粒需求喂给模型,得到的是一大坨难测、难回滚的变更;小颗粒才对得上单测覆盖和低于 15% 的失败率。
现在值得看,是因为落地叙事已经从“会不会用助手”转到“能不能按当量切片、按失败率关门”。受益的是产品和技术能把需求拆到百当量内、并用覆盖率卡发布的团队。受损的是继续按项目制甩大需求、却指望模型一次性写完的团队。
观察清单
- 单元测试覆盖度能否从中位 15.27% 往区间上沿(约 20%)挪,而不是模型用量先翻倍、覆盖率不动。
- 变更失败率是否稳定落在 15% 以内;一旦滑进 16%–30% 或更高档,优先停扩生成代码范围。
- 需求侧 100 当量以内的比例能否明显高于 34%;切不小就先别谈闭环。
- 代码当量是否仍由约 35% 的人贡献 80%;腰部当量起来且问题密度仍靠近 0.54 个/千当量,才算提效而不是加班。
- 注释覆盖能否靠近 33%、代码不重复度守住约 85%;两者掉下去,多半是生成代码在堆不可维护资产。
以下为原文预览:
需要查看更多专题研究报告,可以微信扫一扫/长按识别下方优惠券付费成为会员,30000+份报告,随意下载,不受限制,报告涵盖全行业。
【大吉行业专题报告库】:公众号@大吉研报星球
作者 选择加入即可获得:
1. 星球精选专题研报
2. 1v1研报专题定制整理、查找与下载服务
戳“阅读原文”下载报告


发表评论
发表评论: