
 研报速递
本文首发于公众号「奇研智」
栏目介绍: 本文为「AI投研技术」栏目第 14 篇。本栏目面向金融从业者、量化爱好者和AI应用开发者,用通俗语言分享"AI怎么帮做投研"的实战经验,每期一个具体话题,附可复用的代码和方法。
本文是AI投研自动化实践分享,继续"AI分析"系列。上一期聊了"多模型交叉验证拦住AI胡说",这一期解决另一个高频痛点:研报太多、太长,人读不过来。核心思路是"结构化抽取 + 真实数据核验 + 压成一张表",把几十页研报变成一行可查可比的记录。
一、一份50页的研报,你真正能带走的只有三样东西
先还原一个场景。周五晚上,你的自选股里几只票同时出了深度研报,每份五六十页。你想在周一开盘前把关键信息摸清,结果发现:读一份要一个小时,读到第三份,前两份讲了啥已经模糊了。
但回头想想,一份研报真正有用的信息,其实翻来覆去就三样:
第一,它的核心结论——看好什么逻辑、给什么评级、目标价多少。第二,它引用的关键数字——营收增速、毛利率、渗透率,这些是支撑结论的"硬证据"。第三,它提示的风险——通常藏在文末,写得最诚实。
剩下的几十页,大半是论证过程的铺陈、行业背景的科普、图表的重复解释。这些不是没用,但对"先摸清状况"这个目的来说,属于可以后置的细节。
传统做法是人肉精读——一个分析师一天能啃两三份就算高效。这就是瓶颈:研报的产量在爆炸(一家券商一天能发几十份覆盖报告),人的阅读速度却是常数。
所以这一期要解决的问题很具体:怎么让AI把一份几十页的研报,自动压成一张"一眼能看完"的表,同时保证它没把数字读错。
二、为什么"直接让AI总结"这条路不够
你可能想:这还不简单?把PDF丢给AI,让它总结一段摘要不就完了。
这条路能走通一半,但有三个坑,正好是上一期"交叉验证"埋下的伏笔:
第一,AI总结会"丢数字"。 让AI自由发挥写摘要,它会倾向保留"逻辑流畅的结论",丢掉"冷冰冰但关键的数字"。你拿到的摘要读起来很顺,但没法用来做决策——因为没数字。
第二,AI会"脑补数字"。 研报原文没写的东西,AI为了把话说圆,会自己编一个补上。上一期说过,它编的时候语气特别笃定,你根本分不出来。
第三,自由文本没法"批处理"。 十份研报总结成十段摘要,你想横向对比"谁看好、谁看空、谁给的增速最高",还得回头一篇篇翻。文本不结构化,就做不了"表"。
所以正确的姿势不是"总结",而是抽取——用一套固定的字段模板,把研报里的信息"对号入座"地抽出来。抽出来的结果是结构化数据,既能核验、又能成表。
三、解决方案:三步走,把研报压成一张表
整体思路分三步,每步都有明确的目的:
第一步,结构化抽取。 定义一套固定字段(来源、日期、标的、核心逻辑、关键数字、风险),让AI只做"填空",不做"自由发挥"。
第二步,真实数据核验。 抽出来的关键数字,尤其是盈利预测,拉一遍真实数据对照,标出"研报说法"和"实际情况"的差异。
第三步,压成一张表。 把结构化结果渲染成 markdown 表格,一份研报一行,多份研报放一起就能横向对比。
先看第一步——结构化抽取的核心,是把"字段清单"写进 prompt,并要求输出严格 JSON:
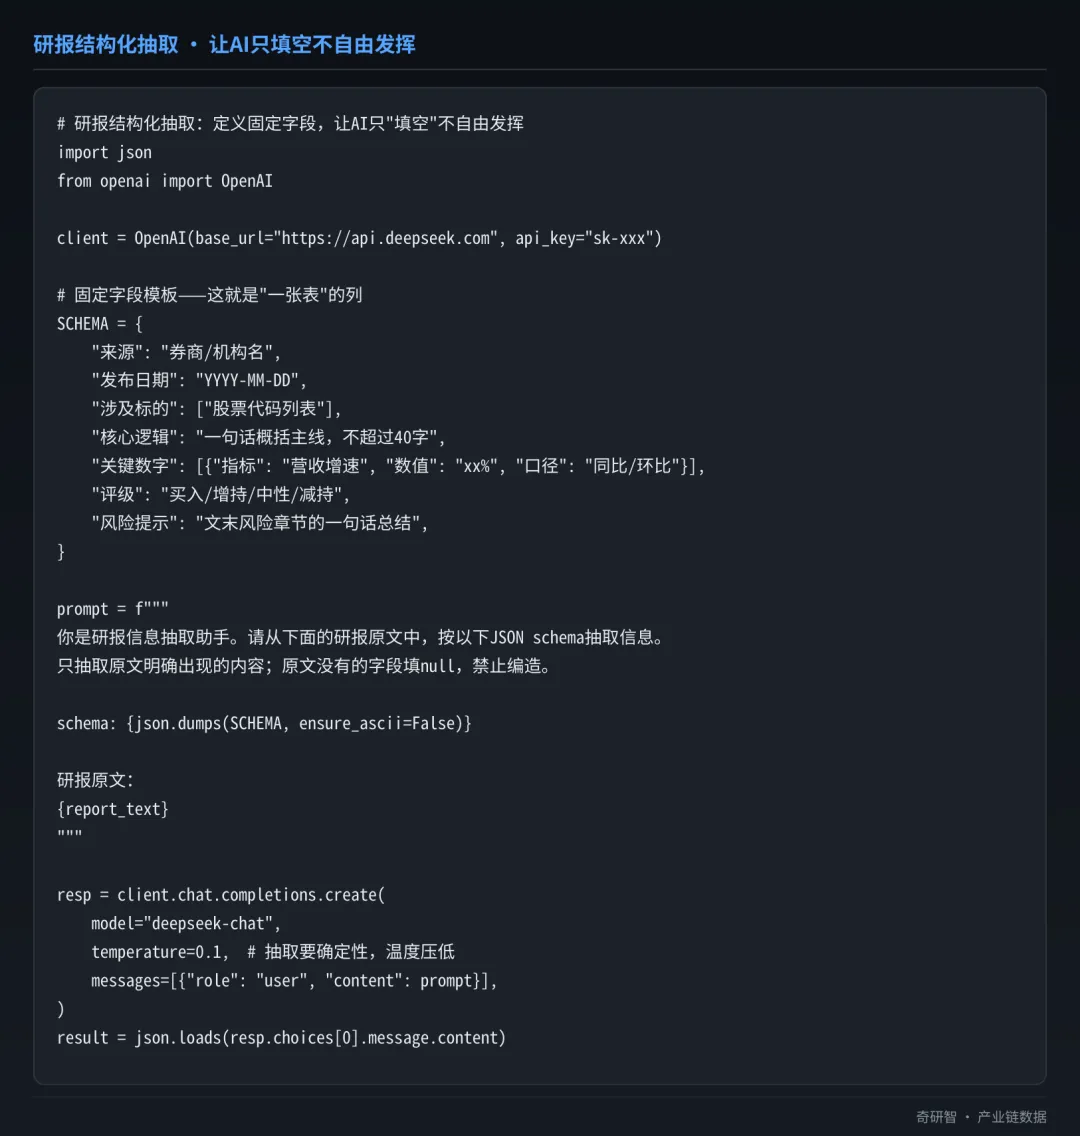
三个细节值得强调:
一是温度设 0.1。 抽取不是创作,要的是"照抄",不是"发挥"。温度越低,AI越倾向于忠实原文,越不容易脑补。
二是"禁止编造、没有就填 null"。 这句话是防幻觉的关键。你不写这句,AI遇到原文没有的字段会自己"合理推测"一个填上;写了这句,它就老实填 null,你一眼能看出哪个字段是缺的。
三是输出强制 JSON。 只要结果是 JSON,后面"成表"就是一行代码的事;如果是自由文本,你还要再解析一遍,等于把问题留到下一步。
第二步是核验——这一步最容易漏,但最值钱。研报里的盈利预测是"预测",不是"事实",必须拉真实数据对照:
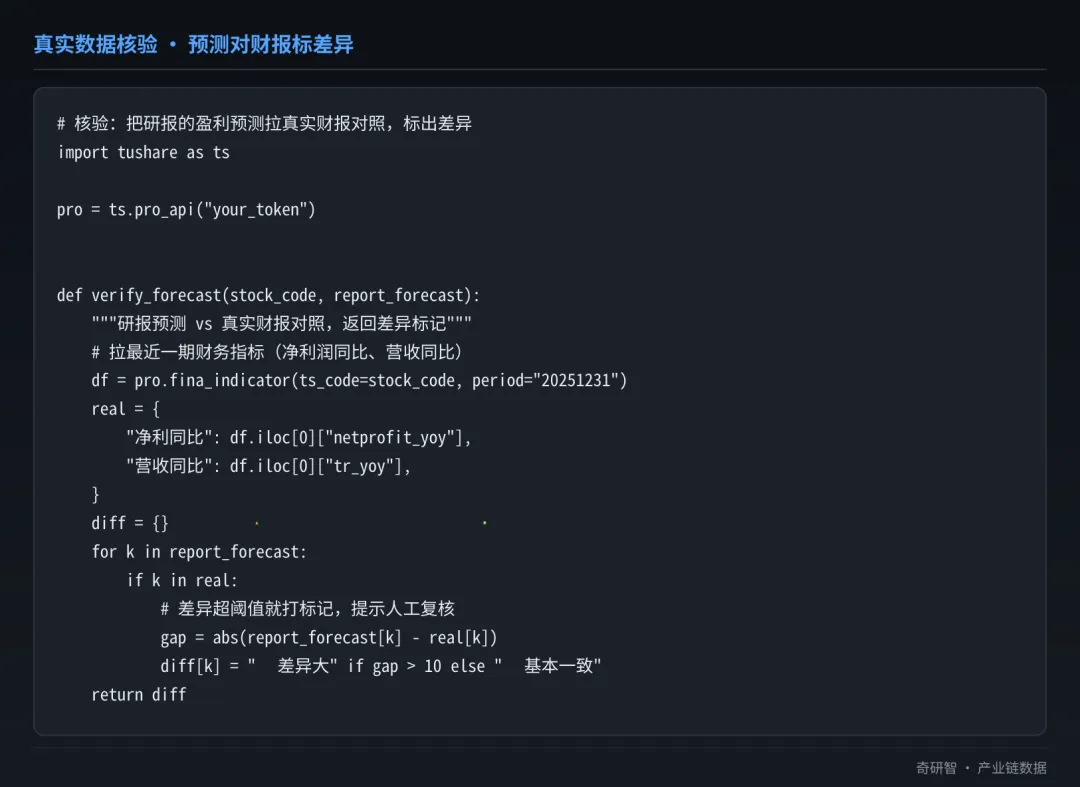
这里有个关键判断:研报和真实数据的差异,不一定是研报错了。 研报可能是"全年预测",而财报是"单季度";也可能是"净利"和"扣非净利"的差别。所以核验的结果要标"差异大,请人工看",而不是武断地判"研报错了"。上一期说过,有客观锚点的问题才值得核验——盈利预测对财报,就是典型的客观锚点。
第三步成表,最简单也最出效果:
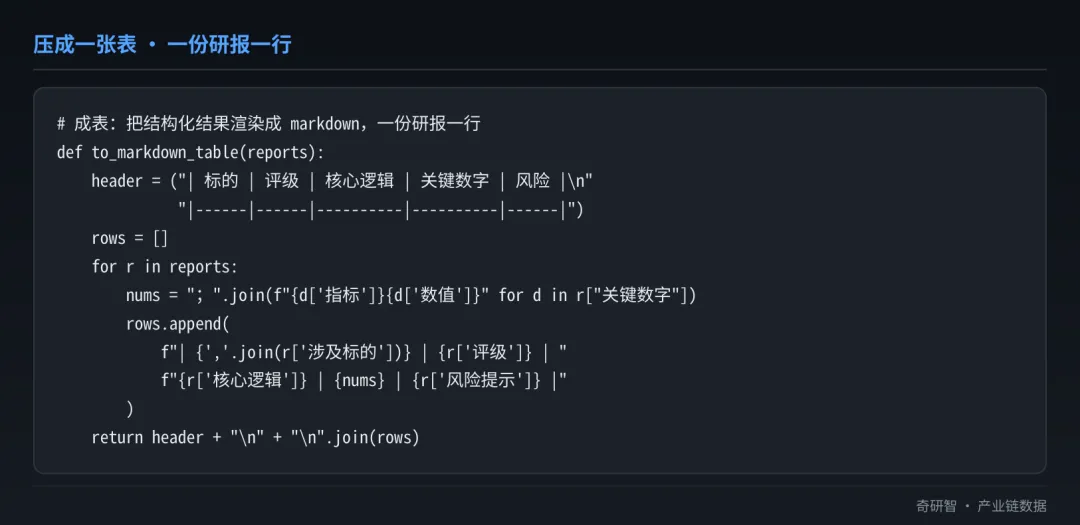
三份研报进来,一张三行的表出去,一眼就能看出谁给"买入"、谁的增速预期最高、谁的风险提示最重。
四、踩坑记录:抽取阶段最容易翻车的三个坑
一、PDF/图片型研报根本抽不出来。 券商研报很多是 PDF,甚至是扫描件(图片)。直接喂文本,AI拿到的是一堆乱码。解决办法是前面加一道"版式还原"——用工具把 PDF 转成带结构的文本,图片型的还得上 OCR(光学字符识别,把图片里的文字认出来)。这道工序决定了后面抽取质量的上限,别省。
二、数字口径会"打架"。 同一份研报里,"营收增长 30%"可能指同比,"净利增长 50%"可能指扣非净利。抽取时如果不强制 AI 标注"口径"字段(同比/环比/扣非/含非),抽出来的数字摆在一起就是一笔糊涂账。所以 schema 里那个"口径"字段不是多余,是救命。
三、结论句和事实句要分开。 研报的"核心逻辑"是分析师的观点(可能主观),"关键数字"是客观事实。这两个字段必须分开存,不能混成一段。分开之后,核验只针对"关键数字",观点则留给后续的"多篇研报观点聚合"去处理——这是下一期的伏笔。
五、效果对比:从"读一天"到"扫一眼"
| 维度 | 人肉精读 | AI抽取成表 |
|---|---|---|
| 一份50页研报 | 约1小时 | 约1-2分钟 |
| 十份研报横向对比 | 靠记忆,容易漏 | 一张表,一眼看全 |
| 数字可信度 | 靠人细心 | 自动核验标差异 |
最大的变化不是"快",是"可对比"。以前读完十份研报,脑子里只剩一个模糊印象;现在一张表摆出来,谁给的预期最高、谁的风险提示最重、谁和真实数据对不上,全都一目了然。这才是"把研报读薄"的真正含义。
六、延伸思考与下期预告
单份研报抽成表只是第一步。真正的价值在三件事上:一是多篇聚合——同一个标的一周出了五份研报,把五份的评级和预测并在一起,看分歧;二是自动更新——新研报入库时,自动和已有记录比对,标出"这家券商这次上调还是下调了预期";三是情绪分析——不只看研报,把每天的新闻快讯也接进来,让AI给几十条快讯自动打上"利好/利空/中性"的情绪标签。
这正好引出下一期的主题——AI分析·第十五期:情感分析,怎么让AI给每天的几十条新闻快讯自动打上情绪标签。如果你也被"研报读不完、读完了记不住"折磨过,欢迎留言交流,我们下期接着聊。
风险提示
本文为AI投研系统搭建经验的个人分享,不涉及任何具体投资标的与投资建议。文中代码为思路示意,需结合自身环境调整,模型接口、token 与阈值请以实际情况为准。市场有风险,投资需谨慎。
📚 往期回顾|AI投研技术
▎《AI会一本正经地胡说,多模型交叉验证怎么拦住它》(2026-09-26)让多个模型互相判卷,一致采信、打架报警
▎《体检和自愈都在跑,怎么一眼看清系统今天健不健康》(2026-09-19)健康看板:把体检与自愈状态收拢成一眼可读的分数与灯
▎《体检报了警,怎么让系统自己修好再喊你》(2026-09-12)自愈闭环:系统发现异常后自己修、修不了再喊人
📖 订阅「AI投研技术」合集,不错过每期教学干货
👉 点击文末左下角「阅读原文」进入合集
📌 更多市场解读与深度拆解,点击文末左下角「阅读原文」→ 奇研智
本文由AI整理自日常投研笔记,仅供信息参考,不构成投资建议。市场有风险,投资需谨慎。
关注公众号「奇研智」,获取更多AI投研内容。
📌 回复「框架」获取投研体系全景图
发表评论
2026-10-11 02:50:53 回复该评论
发表评论: