
 研报速递
先说个很多做性能测试的人都熟悉的晚上。
压测跑完了。JMeter 的聚合报告开着,TPS、响应时间、错误率的曲线躺在那儿,数字一个不少。你盯着屏幕,心里其实清楚这次压测大概是个什么状况——但要把它变成一份「能发项目组、能贴进评审材料」的文档,还差着十万八千里。
于是你打开 Word。然后是两个小时。
响应时间 800ms,到底算好算差?跟行业标准比呢?
TPS 涨到某个点就平了,是脚本的问题,还是服务端的问题?
优化建议怎么写才不像套话?「建议加索引」这五个字发出去,是要被开发追着问的。
你不是不会做性能测试。你缺的是一套把压测结果翻译成结论的标准路径。
经验散在脑子里、聊天记录里、上一次那份没归档的报告里。每出一次报告,都是现场重新拼装一遍。
这份 Performance Test Report Skill 干的就是这件事:你把压测结果截图丢进去,加一句简单描述,它按固定标准做指标解读、分层瓶颈推断,给可执行建议,最后吐出一份结构固定、能直接发出去的 HTML 报告。
今天把它的结构、五章报告模板、内置的三类资源,一次摊开讲。
先把一件事说清楚:这套 Skill 不是我写的。 它是别人已经整理好的一套配置,我把它拆开给你看——因为它的设计思路,比它本身更值得研究。
01
PART
它到底做了什么:三件事
WHAT IT DOES
用一句话概括:把「截图 + 描述」变成「专业性能分析报告」。拆开是三个动作。
① 看你的压测结果
它接住两样输入:
截图
1 张或多张。JMeter 的聚合报告、Gatling 的 HTML 报告、LoadRunner 的 Analysis 图、云压测平台的结果页、自研平台的监控大盘,都能吃。
一段文字描述
说清场景、工具、关心什么。这段是辅助,但影响很大。
② 做专业分析
结合内置的性能测试知识库,从截图和描述里把关键指标拎出来,按「操作系统 → 中间件 → 数据库 → 应用」的顺序做分层瓶颈推断,再给可操作的优化建议。
③ 输出标准报告
生成一份 HTML 格式的分析报告,固定五个章节:测试概述、测试结果截图与说明、性能瓶颈分析、优化建议、总结与后续建议。单文件、内嵌样式,浏览器打开就能看,可以直接邮件发出去、贴进 Wiki,或者打印转 PDF。
解决的三个问题也很直白:
02
PART
为什么是「Skill + 截图」,而不是直接问 AI
WHY A SKILL
很多人第一反应是:我直接开个对话,把截图扔给 AI 让它写不就行了?我为什么要装一个 Skill?
能用,但差在稳定性上。区别在这里:
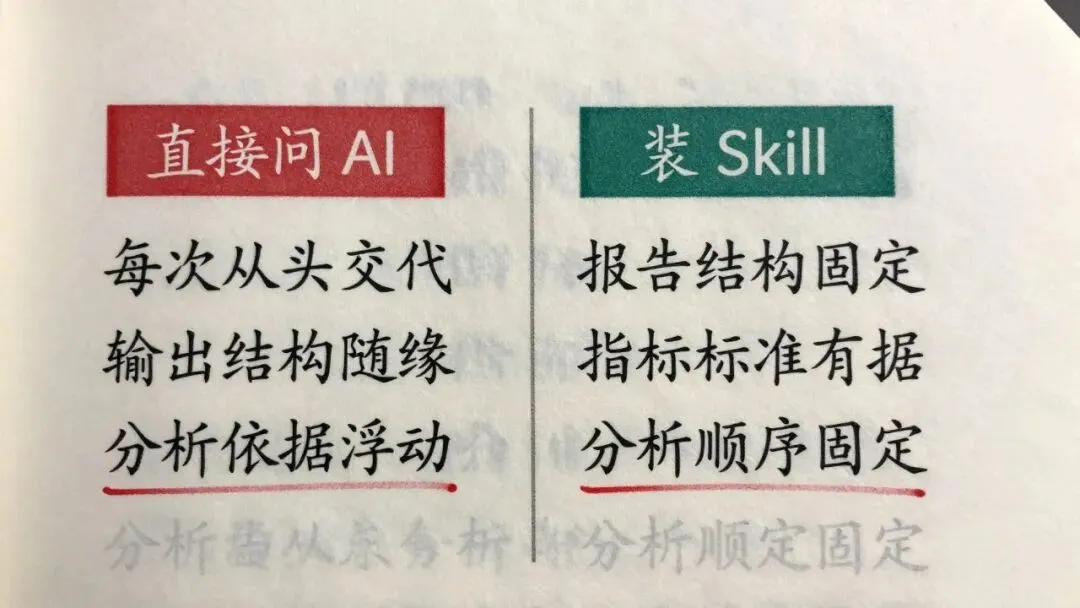
— 左栏是「直接问 AI」的三种情况,右栏是「装 Skill」的三项固定
直接问 AI 的问题不在能力,在每次都要重新交代一遍。
你得反复说明你是谁、报告给谁看、什么格式、关注哪些指标。
输出结构随缘——这次给你分点,下次给你写散文,再下次直接给你一段总结。
分析依据是浮动的,同一个数据换个对话可能就是两套说法。
最关键的是:你没有任何东西可以约束它。
Skill 换来的,是把三样东西固化下来:
报告结构
五章,写什么、怎么写,都定死。
指标标准
什么算好、什么算差、参考区间在哪,有据可依。
分析顺序
瓶颈从哪一层开始排,不是随机选。
打个比方:性能分析报告和体检报告是同一类东西。体检报告之所以能跨医院读得懂,不是因为医生水平一致,是因为指标、单位、参考区间是统一的。 你写出来的性能报告如果每次结构都不一样,那这份文档的价值就只能停在「记录」,到不了「沟通」。
Skill 起的作用,就是给这份报告定下统一的指标和格式。
03
PART
整包长什么样:目录结构
STRUCTURE
先把骨架摆出来,你照着建目录,后面每个文件都有落点。
performance-test-report/
├── SKILL.md # 技能主文件:元数据、工作流、填写原则、资源说明
├── references/
│ ├── report-structure.md # 报告五章结构与填写规范
│ ├── performance-testing-knowledge.md # 性能测试知识库(指标、行业参考、瓶颈与调优)
│ └── perf-tools-guide.md # 常见压测工具界面与指标识别
├── assets/
│ └── report-template.html # 固定版式 HTML 报告模板(含占位 SECTION)
└── performance-report.html # 运行一次之后生成出来的示例报告
一共五类落点,别搞混它们各自的分工:
SKILL.md 是主文件,负责元数据定义、工作流、填写原则和资源说明。它是给 AI 看的说明书,不是给你的模板。
references/ 里的三份文档,才是这份报告「专不专业」的来源。 没有它们,AI 输出的东西就会退回成一段泛泛而谈。
assets/report-template.html 管版式。所有报告共用这一份模板,靠占位符(SECTION)把内容填进去——这是「每次格式一致」的物理保证。
最后那个 performance-report.html 不是必须的准备文件,是运行一次之后自动产出的结果,相当于一份自带示例。
想改版式,编辑 report-template.html,只要保住 <!-- SECTION: xxx --> 这类占位就行。想改分析标准,去改 references/ 下对应的 md——这一步很关键,后面会专门讲。
04
PART
输出的报告长什么样:五章
THE REPORT
这是整份 Skill 的交付物。五章,每一章都有明确的职责:
第二章容易被写废。 很多人做报告就是把图贴上去,连说明都不写——读者看到一堆曲线,还得自己判断哪条是重点。这一章要求的「对每张图做简要说明」,是在替你完成「引导阅读」这个动作。
第五章也容易被糊弄。 「后续建议」不是客套话。写清复测条件(改完之后按什么条件再压一轮)和监控重点(上线后盯哪几个指标),这份报告才算闭环。
05
PART
报告的专业度靠谁兜:三类内置资源
THREE RESOURCES
这是我最想跟你拆的部分。因为很多人抄 Skill,只抄了 SKILL.md 那一个文件,把 references/ 里的东西扔了。
那等于把刹车卸了还猛踩油门——外壳看着一样,一跑就失控。
三份资源,各管一件事:
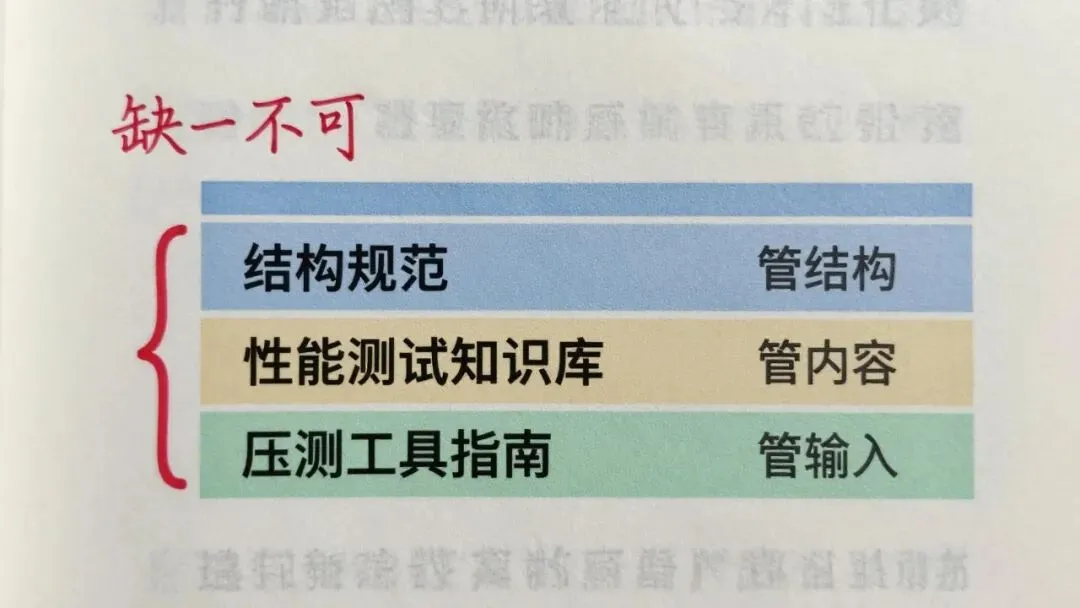
— 结构规范管结构,知识库管内容,工具指南管输入,缺一不可
① report-structure.md —— 管骨架
它定义五章各自写什么、怎么写:测试概述要包含哪些要素、截图与说明用什么形式呈现、瓶颈分析的表格怎么组、优化建议怎么分层表述。
它还规定了一件事:分析顺序必须遵循「操作系统 → 中间件 → 数据库 → 应用」,不允许只谈现象不谈层次。
最后它约定模板里的占位区域,保证每次生成的报告结构一致。
② performance-testing-knowledge.md —— 管专业度
这是决定分析水平的核心文档。里面装着:
性能测试的概念与分类
基准、负载、稳定性、压力、并发测试的区别和关注点。作用是让你能在概述和总结里给这次测试「定性」——你到底跑的是哪种测试。
核心指标与行业参考
响应时间、TPS/QPS/HPS 的含义与典型参考区间;并发用户数、错误率/成功率的定义与参考;以及响应时间的用户体验原则。
资源与中间件指标
CPU、内存、磁盘、网络利用率的警戒参考;中间件和数据库的常见关注点,比如线程池、连接池、GC、慢 SQL、锁。
瓶颈分析规范
按层次分析的顺序、常见瓶颈表现(响应时间上升、错误率突增、TPS 出现拐点、资源打满),以及书写要求——现象 + 依据 + 可能原因。
调优方向规范
按中间件、数据库、应用、系统资源四个方向给可操作建议,避免空泛。
指标评估与解读技巧
比如响应时间由哪几段组成、TPS 和并发的关系、峰值 QPS 怎么估算。
③ perf-tools-guide.md —— 管识别准确率
针对 JMeter、Gatling、LoadRunner、云压测 / 自研平台的典型界面和常见指标做说明:JMeter 聚合报告的字段有哪些、Gatling 的 requests/s 和 P95/P99 长什么样。
它的作用是防止 AI 看错指标、误读曲线。截图识别错一个字段,后面整段分析就是错的。
三份资源的分工可以这么记:结构规范管骨架,知识库管内容,工具指南管输入。缺任何一份,报告都会在对应环节掉链子。
06
PART
为什么要按「操作系统 → 中间件 → 数据库 → 应用」排
LAYER ORDER
这个顺序是硬性要求,值得单独说两句。
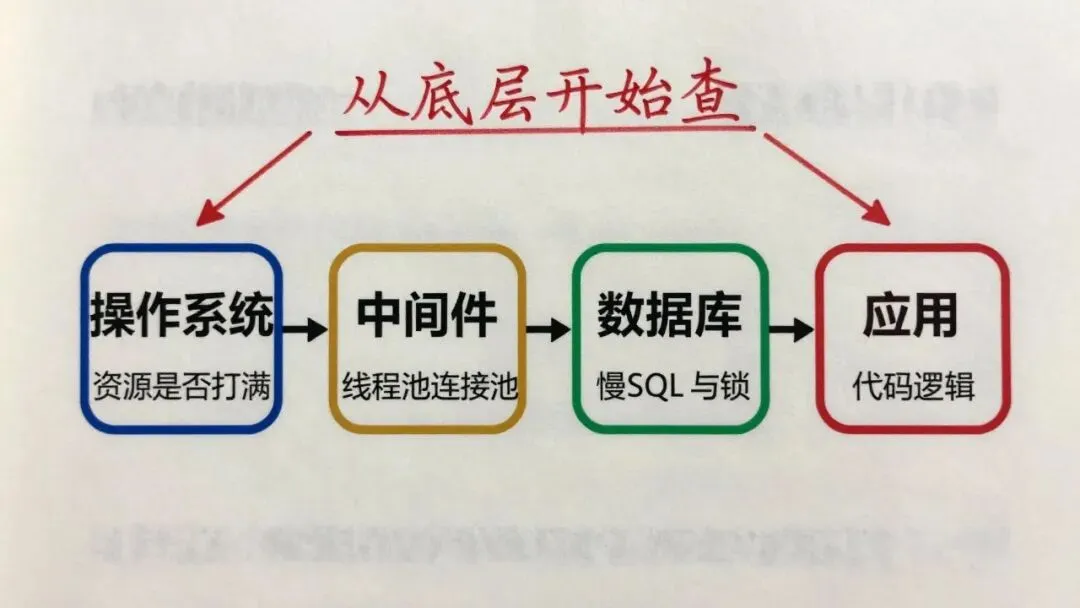
— 四个排查层次依次是操作系统、中间件、数据库、应用,从底层开始查
压测里最怕的一种报告,是通篇只有现象:TPS 上不去、响应时间变长、错误率涨了——然后建议「优化代码」。
这个顺序解决的,是「从哪一层开始找」的问题。
把排查顺序定成从底层往上走,好处有三个:
它对应真实的请求链路。 一个请求进来,先经过操作系统和网络,再到中间件,然后落数据库,最后是应用逻辑。从下往上排,你是在按数据实际流过的地方走。
它防止只用上层解释。 很多人一看 TPS 上不去就怀疑代码写得慢,结果一查是数据库慢 SQL 拖着,或者连接池早就打满了。先看底层,能挡住一批「想当然」。
它让报告里的建议天然分层。 分析按层次走,优化建议自然就分成应用、数据库、中间件、资源四类——开发拿到手,各找各的部分,不用自己拆。
顺序不是形式,它决定了你和开发沟通时,是从「我觉得代码有问题」开始,还是从「数据库这一层有这个证据」开始。
07
PART
在 Cursor 里怎么用:四步
HOW TO USE
确保 Skill 已启用
把 performance-test-report 整个目录放进当前项目或 Cursor 能识别的技能目录,再在 Cursor 里启用它(具体位置以你的 Cursor 版本为准,一般是项目下某个目录,或设置里的 Skill 列表)。
注意是整个目录,不是只放 SKILL.md。
发起对话
在对话里上传 1 张或多张压测结果截图,粘贴或拖拽都行。然后用文字简单说明。
可以直接这么说:
「根据这些截图和描述做性能分析,并生成一份 HTML 报告。」
或者更具体一点:
「这是登录接口的 JMeter 聚合报告,请分析并输出性能测试报告。」
这一步描述写得好不好,直接决定报告贴不贴你的诉求。 建议至少说清四件事:
测试场景(比如「登录接口 100 并发」「下单流程混合场景」)
使用的工具(如果截图里看不明显)
关注点或目标(比如「看 P99 是否低于 500ms」「验证能不能顶住 1000 TPS」)
环境说明(测试环境还是预发,可选)
其中后两项最常被省掉,但它们恰恰是报告里「测试概述」和「总结」的骨架。
等它生成
AI 会按 Skill 里的工作流走一遍:读报告模板和知识库 → 分析截图和描述 → 逐章填写 → 输出完整 HTML。
这里有个细节要注意:如果你提供的是截图文件路径,报告里会尝试按路径把图嵌进去;如果你只是把图粘贴在对话里,报告里会保留文字说明,并提示你把截图存到指定路径后刷新。
想要图真的出现在报告里,用文件路径。
查看和二次编辑
报告会存到约定路径(比如项目下的 performance-report.html),或者你指定的位置。浏览器打开就行。要调整表述或者补信息,可以直接改 HTML,也可以让 AI 再出一版。
08
PART
它能识别哪些压测工具
TOOLS
这套 Skill 在设计上不绑定某一款工具——只要截图能看出是性能测试结果,它就能接。重点做了识别支持的包括四类:
如果你用的是别的工具——Locust、k6、wrk 之类——只要在描述里说清工具名称和截图含义,它依然能基于通用指标(响应时间、TPS、错误率、资源占用)和知识库里的通用分析框架出报告。
更好的做法是:把你自己那款工具的识别要点补进 perf-tools-guide.md。 这一步是这套 Skill 从「能用」到「好用」的分界线。
09
PART
它兜不住什么
LIMITS
好话说了一半,剩下的一半得说实话。这套东西有几个明确的边界,用之前心里要有数。
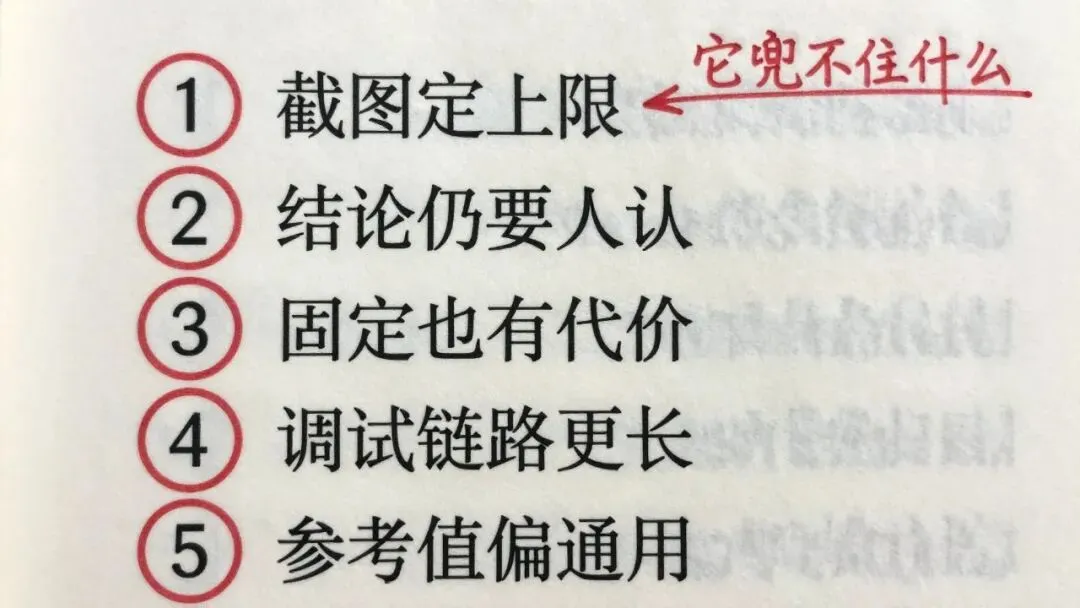
— 五条边界:截图定上限、结论仍要人认、固定也有代价、调试链路更长、参考值偏通用
第一,截图质量决定分析上限。 输入的是模糊的小图、被裁掉的表头、只有半截的曲线,输出就不可能是精准的。它是读取已有数据的工具,不是补数据的地方。
第二,结论仍然需要人来认。 Skill 能给的是「可能瓶颈」和「优化方向」,用词是「现象、可能原因、依据」。根因认定、上线决策这些事,不会也不该由一份自动生成的报告来签。
第三,固定结构是有代价的。 好处是统一,代价是——如果你的团队有自己习惯的汇报格式,或者某些项目需要特殊章节,就得自己动模板。
第四,调试链路会变长。 报告里出现了不合你预期的表述,可能是截图识别的问题,可能是描述交代不清,也可能要回去调知识库。比手写报告,多了一个「找问题出在哪一环」的动作。
第五,知识库的默认参考值是通用的。 想让它像「你们团队的测试专家」,就得往里喂你们自己的东西——而这个动作,它替不了你。
避坑速查,用之前先看一眼:
10
PART
适用边界:什么时候用,什么时候别用
WHEN TO USE
适合的场景
压测执行完,需要快速出一份给项目组 / 领导的正式报告
多轮压测对比,希望每一轮的报告结构一致、便于横向比
测试开发在脚本或平台里跑完压测,把结果截图交给 AI 自动成文
开发 / 运维自己做接口压测或容量摸底,需要一份带结论的简报,而不是一堆原始曲线
单场景压测结束(登录接口、下单流程、混合场景)需要留档或评审
不适合的场景
还没有压测结果。 它不负责设计压测、不负责施压,只负责把结果翻译成文档。
探索性的性能调优。 路径不确定的排查,需要的是人一步步试,不是一次性成文。
需要深度根因定位的场合。 它能给出方向和依据,最终定位还是要靠人。
只想快速看一眼数据、不打算出文档的场景。 那是看监控大盘的事,不必绕这一圈。
一句话:它最适合「流程固定、反复执行、每轮都要出文档」的场景。
11
PART
怎么把它变成你们团队的报告标准
MAKE IT YOURS
装好就能用。但「能用」和「像你们团队的专家」中间,还差三次调整。
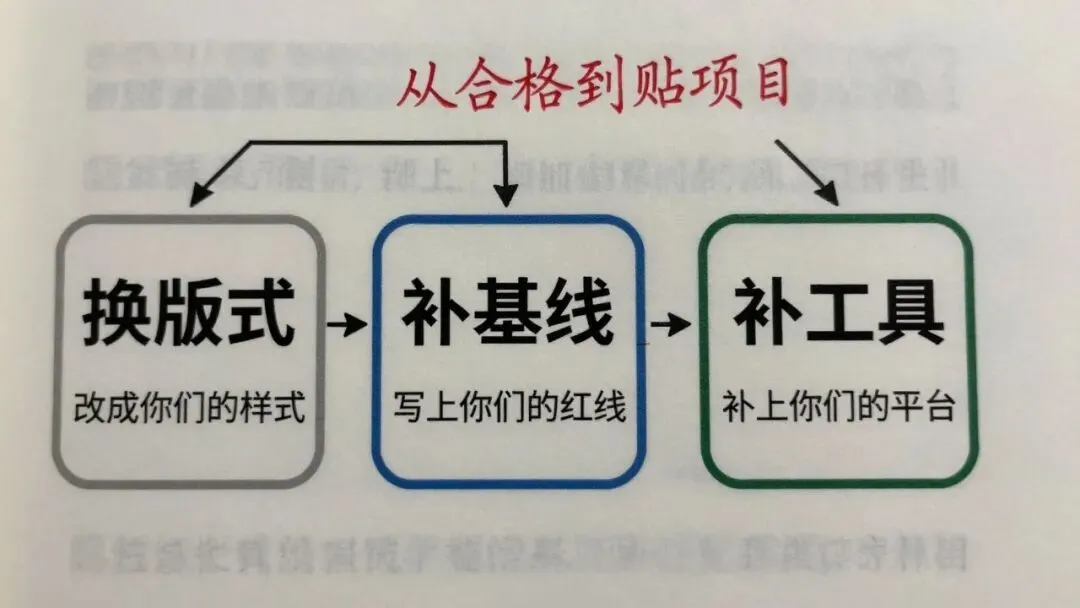
— 三次调整:换版式、补基线、补工具,最后一格最重
第一次调整:换版式。
编辑 assets/report-template.html,把标题区、配色、页眉页脚改成你们习惯的样子。只要保留 <!-- SECTION: xxx --> 这类占位,内容就能继续正常填进去。
第二次调整:补基线。
这一步价值最高。知识库里放的是行业通用参考值,但你们团队一定有自己的数:核心接口的响应时间红线是多少、大促前的 TPS 目标是多高、哪些中间件的线程池配置是敏感项。
把这些写进 performance-testing-knowledge.md,报告里的「好」和「坏」就是按你们的标准判的,而不是按通用标准判的。这是让输出从「合格」走向「贴项目」的唯一办法。
第三次调整:补工具。
如果你们用的是自研压测平台,或者内部封装的监控大盘,把它的界面特征和指标含义补进 perf-tools-guide.md。截图识别准了,后面的分析才站得住。
三步做完,它输出的就不再是「一份合格报告」,而是「你们团队的报告」。
另外还有两个使用习惯值得养起来:
描述里把场景、工具、目标写全。 这三样决定概述和总结写得好不好。
多张图一起给。 既有 TPS 曲线又有资源监控的,一起传上去,报告会分图说明再做综合分析——只看一张图,很多结论是下不了的。
12
PART
真正的差距在哪里
THE REAL GAP
普通测试把压测数字贴进文档,高级测试把压测数字翻译成结论、依据和下一步。
你可能会说:报告让 AI 写,那我的价值在哪?
恰恰相反。正因为分析框架被固化了,你才更需要看得懂它给出的每一层依据。 只有你自己清楚「操作系统 → 中间件 → 数据库 → 应用」这个顺序意味着什么,你才能在它给出的结论里挑出哪条站得住、哪条还得补证据。
而且还有一个更深的分水岭:
普通测试每做一次压测,重写一遍报告。高级测试把报告标准写一次,之后每一轮都按同一套标准产出。
你今天做完登录接口,写了一份报告;明天做下单流程,又得从头想一遍「这次概述该写什么、建议该分几层」。每次都是从零开始。
而把结构和标准固化下来的做法是:不管跑的是哪个接口、哪条链路,报告都用同一个骨架,分析都按同一个顺序,建议都按同一套分层。你省下的不只是写文档的时间,是每一轮都要重新组织表达的脑力。
一个是在生产文档,一个是在生产标准。前者是体力活,后者是资产。
13
PART
写在最后
FINAL WORDS
性能测试这件事上,会压的人不少,能把压出来的东西讲清楚的人不多。
压测脚本可以复制,压测数据可以重跑,但「把一堆曲线翻译成别人能看懂、能据以决策的结论」这个能力,才是拉开差距的地方。
如果你这周刚好有一轮压测结果躺在文件夹里,别急着开 Word。把截图丢进去跑一遍,比看十篇讲性能指标的文章都直观。
而这套结构不用等现成的包:建一个目录、写三份参考文档、定一个五章模板,第一版糙一点没关系。补基线这件事本来就得你们团队自己动手,而它,正是这套东西从「能用」变成「你们团队的」那条分界线。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING

发表评论
发表评论: