
 研报速递
一、先破最大的误区:"调用别人的模型"不等于"没事了"
二、四条合规线全景:各管什么、找谁、多久
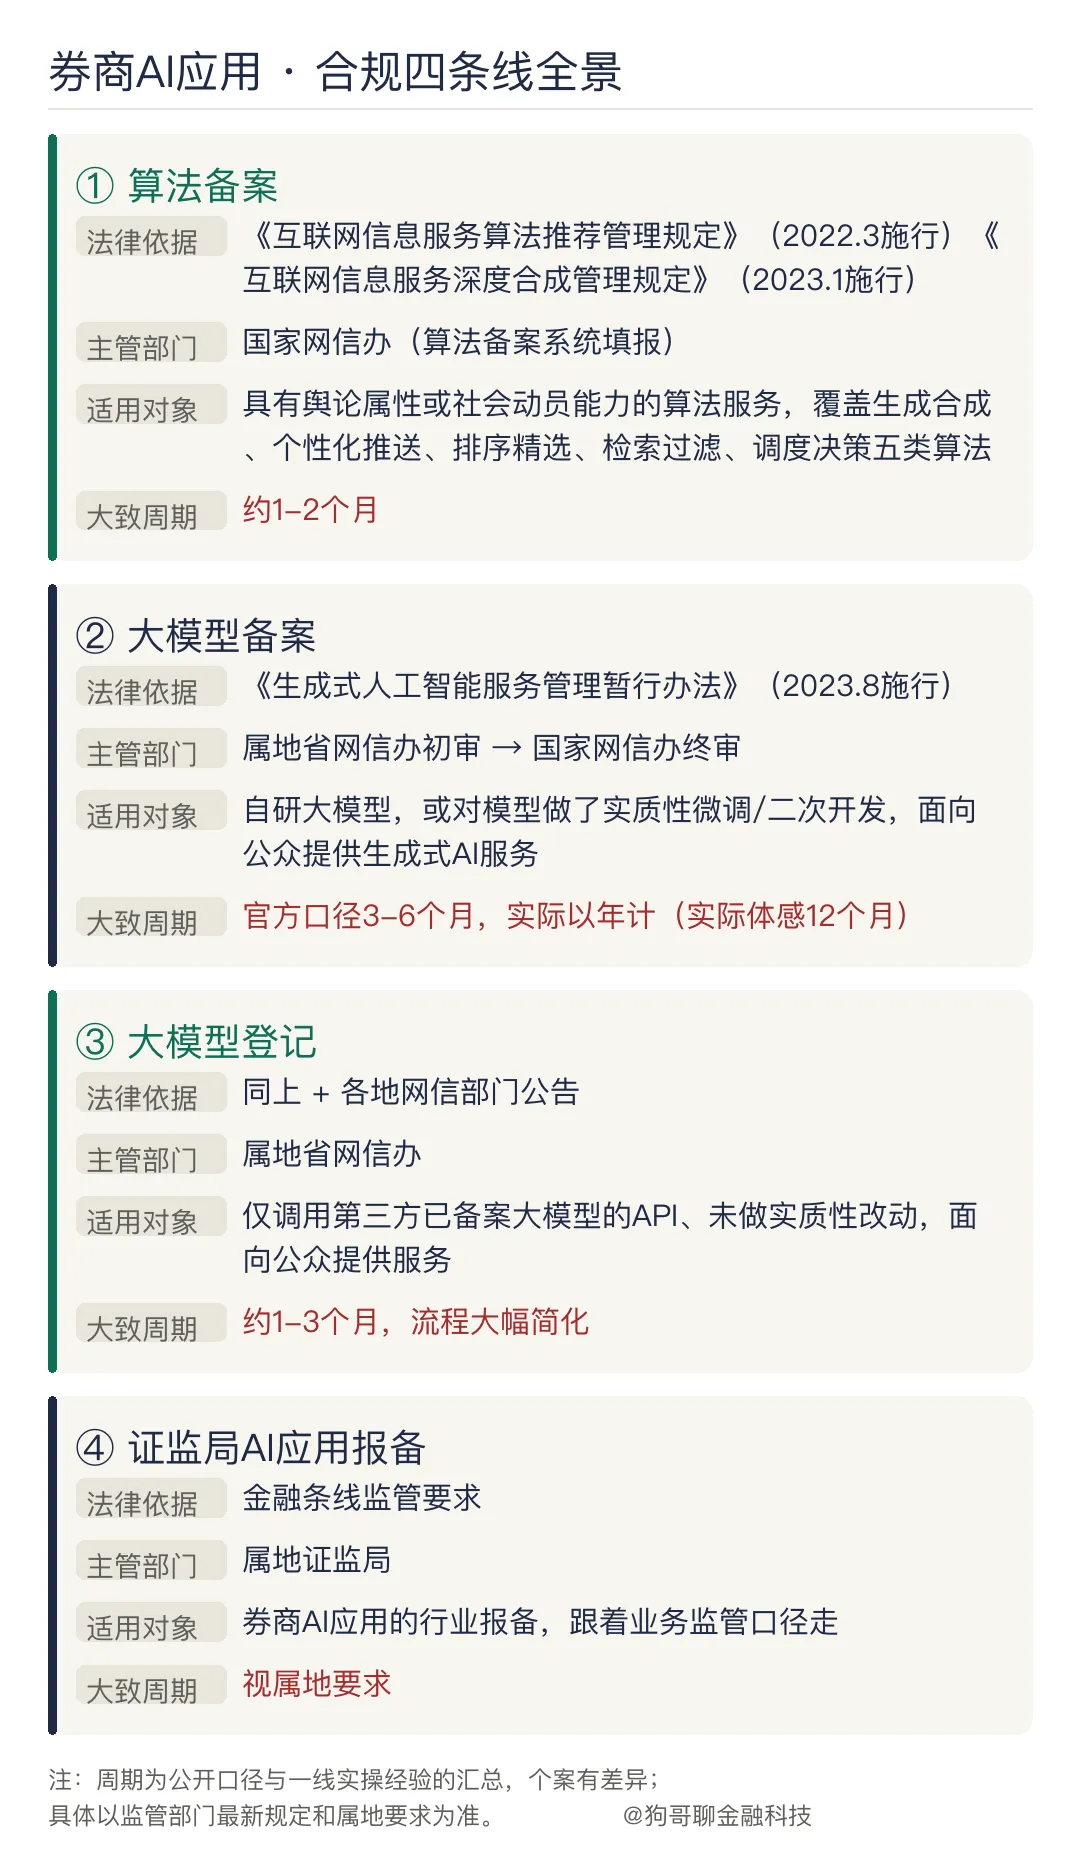
算法备案和大模型备案不是替代关系,是叠加关系。 算法备案是"基础合规入场券"——只要你的服务具有舆论属性(面向公众、有信息交互分发功能基本就算),生成合成类算法备案就是必须的;大模型备案/登记是"生成式AI专项线",管的是模型本身。做生成式AI服务,通常两条线都要走。 "备案"和"登记"的分界线,比想象中细。 官方口径是:纯调用API、不改模型 → 登记;对模型做了微调、二次开发,甚至只是对输出做了实质性二次处理 → 可能被认定为"实质性修改",要求走完整备案。这条边界各地网信把握尺度不一,拿不准就提前咨询属地网信办,别自己猜。 备案信息是公开可查的。 国家网信办官网定期公告已备案/已登记的生成式AI服务清单——截至2025年底,全国累计748款完成备案、435款完成登记。而且已上线的AI应用要在产品显著位置公示所用模型名称及备案号。你可以直接查同行走到了哪一步,同行也能查到你。 内部使用是豁免区。 员工端场景(内部知识库、代码辅助)不面向公众,不触发上述备案/登记义务——这也是我在第一篇里说"员工端放心跑"的合规底气。
三、你的场景走哪条线:一张判断表
业务形态 | 合规义务 |
自研大模型,直达C端 | 大模型备案 + 算法备案 |
基于开源模型实质性微调/二次开发 | 大模型备案 + 算法备案 |
仅调用已备案大模型API,未做修改 | 大模型登记 + 算法备案 |
调用API但对输出做了实质性二次处理 | 可能被认定"实质性修改"→走大模型备案 |
仅内部员工使用 | 无强制备案/登记义务 |
证券AI应用(对客) | 上述网信线 + 证监局报备 |

发表评论
发表评论: