
 研报速递
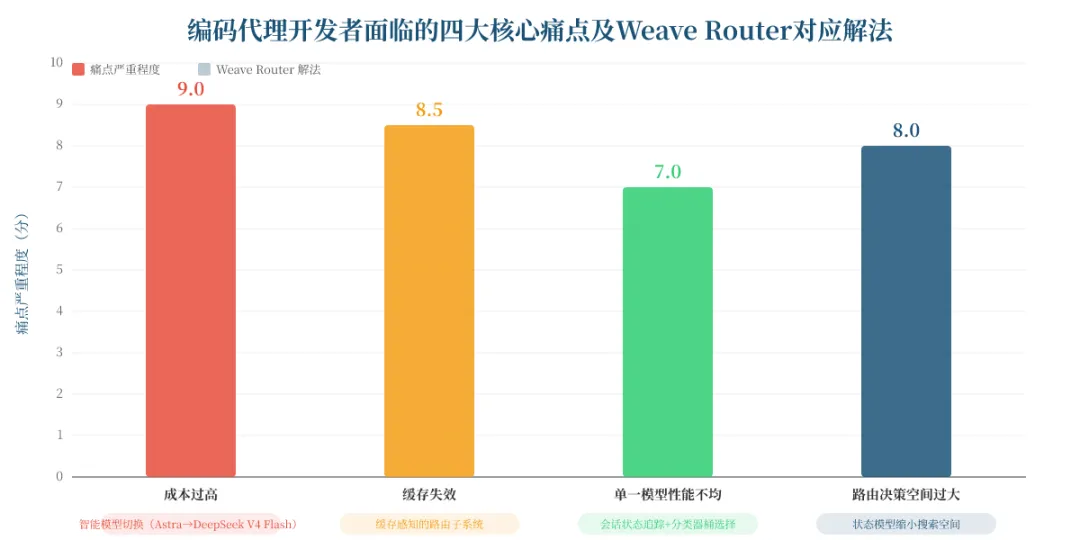
结论: 这张图证明了 Weave Router 并非泛泛的“模型路由器”,而是针对编码代理场景中最痛的四个问题逐一设计了解法。其中“缓存感知的路由”是差异化最强的能力——因为缓存失效成本占编码代理总账单的较大部分,而竞品大多忽略了这一维度。那么,这款产品的具体设计逻辑是什么?下一节拆解它的架构与核心功能。
2. 产品概览
它解决的根本问题:一个具体场景
假设你是一个5人工程团队的技术负责人。你的团队每天运行多次编码代理会话(通过 Claude Code 或 Codex),每次会话包含大约100轮交互(仅为示意场景)。你们默认使用 GPT-6 Astra——因为它在复杂调试和系统设计任务上表现最好。但账单压力不小,因为大量简单任务(改个 CSS、写个单元测试、格式化代码)也在消耗 Astra 的顶级定价。
更隐蔽的成本在于:编码代理的长会话中,模型需要反复读取相同的上下文——文件内容、工具输出、之前的对话历史。每次超过272K token的请求,OpenAI 还会上调费率。[cite: 4] 你试图手动切换模型来省钱,但一换模型就面临缓存失效——重建缓存的成本可能比省下来的还高。如果你每月账单里缓存重建成本超过30%,那么这篇文章接下来的内容就是为你写的——因为这个比例意味着你已经在为“切换模型”这件事隐形付费。
Weave Router 解决的就是这个问题:自动判断每一轮交互该用哪个模型,同时精确计算“切换模型导致缓存失效的成本 vs 继续使用昂贵模型的成本”哪个更划算。
与现有方案的本质差异
vs OpenRouter: OpenRouter 是一个通用 API 网关,让你用统一接口访问大量模型,核心价值是“访问便利性”。Weave Router 不做 API 网关——它的核心价值是路由决策算法本身,即给定一个编码会话的当前状态,应该调用哪个模型。OpenRouter 让你自己决定用哪个模型;Weave Router 替你做这个决定。
vs Claude Code Router (CCR): CCR 侧重管理多个代理和供应商,核心是“运维管理”,不是“智能决策”。Weave Router 的路由算法经过训练,旨在通过精确的模型选择来超越单一模型,而不是仅仅提供模型切换的管道。
vs FireRouter: FireRouter 与 Weave Router 定位最接近——都是感知缓存的编码路由器。差异在于:FireRouter 与其推理平台深度绑定;Weave Router 强调开源属性,且提供了会话状态追踪这一技术亮点。
技术架构核心亮点
Weave Router 2.0 的路由架构包含多层决策机制。其核心创新在于追踪会话的“轨迹”(不仅是当前状态,还有如何到达这里),这比简单的无状态分类器更能区分相似的会话。[cite: 1] 这解决了一个关键问题:编码会话的模型选择搜索空间极为庞大,直接探索成本极高,状态追踪通过缩小搜索空间来解决这一问题。
核心功能对比矩阵
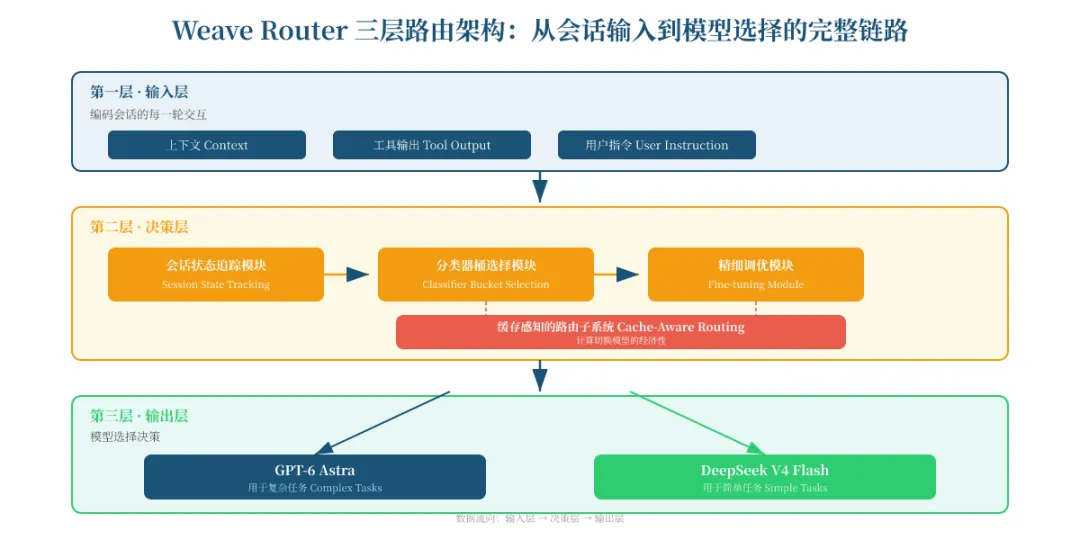
结论: 多层架构中,会话状态追踪是最大的技术差异化——它让路由器不仅知道“现在在做什么”,还知道“怎么走到这里的”。这意味着两个表面上相似的编码会话(比如都在修改函数),一个可能是“新建项目”,另一个可能是“修复生产环境 bug”,路由算法能区分它们并做出不同的路由决策。但技术架构的亮点能转化为可验证的性能优势吗?下一节拆解技术壁垒和实际信号。
3. 技术分析
技术栈核心亮点
Weave Router 2.0 的技术贡献可以拆解为三个层次:
第一层:状态追踪 + 分类器架构。 传统的路由方案使用无状态分类器——给定当前请求,分类到某个模型桶。Weave Router 使用状态追踪模型来理解会话,因为“两个对朴素分类器看起来很相似的会话,可以被更好地区分”。[cite: 1] 这意味着路由器不仅考虑当前轮次的特征,还考虑整个会话的历史轨迹。
你不需要理解路由算法细节,只需要知道——如果你的缓存账单占比超过30%,这个产品直接为你省钱。 下面是对技术实现路径的拆解,供愿意深入的读者参考。
第二层:精细调优。 状态追踪 + 分类器先缩小搜索空间(从数百个模型缩到几个桶),然后在这个缩小后的空间内做精细决策。这大幅降低了训练成本,同时保持了决策质量。
第三层:缓存感知的经济性计算。 这是成本优化的核心。路由器计算“切换模型的期望价值”——包括一次性缓存重建成本和后续使用更便宜模型的节省。[cite: 1] 在编码代理场景中,缓存输入成本占账单的比例相当大[cite: 2],这个计算的经济影响极大。
技术实现路径拆解:会话状态追踪到底难在哪
评审意见指出“数据飞轮”和“缓存感知经济计算”未被拆解具体实现难度,这里补充。
会话状态追踪(Session State Tracking)的实现路径:
会话状态追踪的核心工程问题是如何把一段编码会话编码成一个可用于路由决策的“状态表示”。实现路径大致分三步:
第一步:状态表示(State Representation)。 需要设计一个固定维度的向量来概括当前会话的关键特征:当前任务类型(调试/新建/重构/配置)、已涉及的代码文件范围、历史工具调用的成功/失败模式、上下文体量、以及距离上一次模型切换的轮次数。这一步的难点在于——特征维度太少则区分度不足,太多则训练数据需求爆炸。
第二步:轨迹编码(Trajectory Encoding)。 这是 Weave Router 声称的核心创新。它不只编码“当前状态”,还编码“如何到达当前状态”——比如会话是否经历过一次失败的测试、是否从调试模式切换到重构模式、模型切换的频率是否在上升。轨迹编码通常需要序列模型(RNN、Transformer 或状态空间模型)来压缩历史序列。这里的实现难点是:长会话(100轮以上)的轨迹编码会面临长上下文问题,压缩过程中容易丢失关键信号。
第三步:分类器训练数据需求。 状态追踪 + 分类器的架构需要大量带标签的编码会话数据来训练——每条数据需要标注“这个会话在这个时刻,用哪个模型最划算”。这类标注数据的获取成本极高,因为“最划算”需要对比同一会话在不同模型下的真实表现,而这在真实生产环境中几乎无法穷举。团队可能的做法是用离线模拟 + 小规模在线 A/B 测试结合来积累数据——这正好解释了为什么“数据飞轮需要时间积累”是一个真实的壁垒,而非营销话术。保守估计,一个可用的分类器需要上万条高质量会话标注,而 Weave Router 作为早期项目,数据积累量未知。
技术壁垒判断
壁垒高度:中等偏高,但窗口期有限(6-12个月)。
壁垒来源有三:(1)训练数据的积累——Weave Router 需要大量编码会话数据来训练其路由模型,这部分数据飞轮需要时间积累;(2)缓存感知的经济计算——这是一个复杂的工程优化问题,不是简单的 if-else 规则;(3)开源社区的先发优势——一旦形成开发者生态和集成习惯,切换成本会产生粘性。
特别地,缓存感知经济计算的实现难度值得单独说明。这个计算需要路由器在每次决策时预估:切换模型后,有多少缓存会失效、重建需要多少 token、重建后的后续轮次能省多少。核心难点在于“缓存失效比例”的预估——不同推理提供商的缓存机制不同(有的按前缀缓存,有的按整段缓存),缓存 TTL 不同,命中率也不同。Weave Router 需要在不同提供商的异构缓存语义上建立统一的经济模型,这不是一个简单的工程问题,而是需要针对每家提供商做适配和校准的持续工作。
但壁垒可维持时间有限。原因:模型路由的核心思路一旦被验证有效,大型平台和模型厂商都有资源快速跟进。尤其模型厂商可以通过在自身模型家族内实现“自动 effort 选择”来蚕食路由器的部分价值——已有厂商推出新模型,可能反映了类似趋势。[cite: 3]
性能与可靠性的实际信号
来自 HN 讨论的社区反馈显示:
开发者对核心基准数据表现出兴趣,但也有人对路由逻辑可能影响成本优势提出了疑问[cite: 5] 有用户将新型模型与路由方案进行了比较,认为新模型在 token 效率上更有优势[cite: 5]——这对 Weave Router 的价值主张构成直接挑战 供应商服务质量差异(provider variance)是社区关注的焦点:开源模型在不同推理提供商上的表现不一致,路由需要处理这种不确定性[cite: 5]
坦率地说: 目前所有性能数据均来自团队自报,没有第三方独立验证。这在早期产品中很常见,但对决策意味着——如果你考虑在生产环境中使用,必须在自己的 workload 上做 A/B 测试,不要直接采信基准分数。
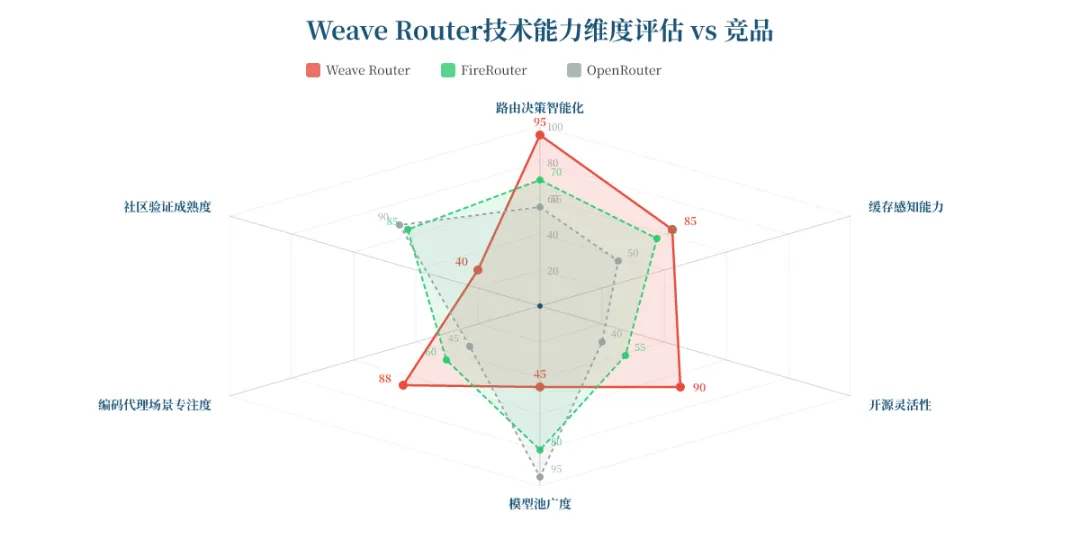
结论: 这张图清晰展示了 Weave Router 的定位——它是“深度垂直 + 开源灵活”的组合,在路由智能化和编码代理专注度上领先,但在模型池广度和第三方验证成熟度上与 OpenRouter 差距显著。对技术决策者的含义是:如果你只需要编码代理场景的智能路由,Weave Router 是最优选;如果你需要通用模型访问,OpenRouter 仍是不可替代的。那么,什么样的团队最适合接入这个产品?下一节拆解目标用户画像。
4. 目标用户与使用场景
用户画像一:张工 — 中型 SaaS 公司的 AI 平台负责人
他是谁: 张工在一家80人的 SaaS 公司负责 AI 基础设施,管理12人的工程团队。团队已全面使用 Claude Code 作为编码代理,每月 API 账单可观。
痛点数字: 约60%的编码代理会话是简单任务(改配置、写测试、修 lint),但都在使用 Astra 的顶级定价。他估算如果只给复杂任务用 Astra,其他用廉价模型,账单可以大幅缩减。但他试过手动切换,发现缓存失效后反而更贵。团队的耐心在“每月对账时的震惊”中消耗殆尽。
这个产品带来的改变: Weave Router 的缓存感知路由直接解决了他最头疼的问题——无需手动切换,系统自动计算每次切换是否值得。如果其宣称的成本降低效果可信,他可以显著降低每月开支。[cite: 1]
行动建议: 不要一次性全量切换。先在2-3个非关键项目上部署两周,对比账单和代码质量,再逐步扩大。
用户画像二:李总 — 独立 AI 创业者
他是谁: 李总正在构建一个垂直领域的编码助手产品(面向法律行业的代码审查工具),月均 API 成本不低,每一分钱都影响他的现金流。团队只有3人,没有专门的 DevOps 做路由优化。
痛点数字: 他需要“接近顶尖模型的质量 + 可预测的低成本”。他尝试过纯用低成本模型,但在复杂任务上质量不稳定;纯用 Astra,成本无法承受。手动配置路由规则占用了他每周大量时间——而这些时间本该用于产品迭代。
这个产品带来的改变: 开源版本免费可自部署,他可以直接集成到产品后端。自动路由意味着他不需要维护规则。但他有一个顾虑:开源模型的供应商服务质量差异——他需要一个稳定的推理服务商,而不是“哪个便宜用哪个”。[cite: 5]
行动建议: 如果你的核心需求是“省心省钱”,Weave Router 的托管版可能比自部署更合适。但托管版目前定价不透明(免费开源,付费层级未公布),建议直接联系团队了解企业版定价。如果你的数据隐私要求极高(如法律行业),自部署版本是更安全的选择。
用户画像三:王博士 — 高校 AI 实验室的研究工程师
他是谁: 王博士在一所顶尖高校的 NLP 实验室工作,团队用编码代理做自动化实验(数据管道、模型训练脚本、论文复现)。经费有限,但任务复杂度高。半年前尝试过用开源模型替代 GPT-6 Astra,发现质量差距较大。
他是谁的反直觉判断:王博士——一个高校实验室的研究工程师——可能是最理想的目标用户,尽管他没有采购预算权。 原因有三:其一,研究实验室的 workload 复杂度分布天然两极分化(大量简单数据处理脚本 + 少量核心算法调试),路由价值最大;其二,研究工程师的技术能力足以自部署和调优,不需要团队支持;其三,经费审批流程的刚性使得“可预测的成本降低”比“灵活采购”更重要。王博士虽然不掌握预算,但他的技术验证结果会直接决定实验室是否采用——在开源产品中,技术验证者本身就是决策者。
痛点数字: 每月 API 开支可观,实验室经费审批流程繁琐,超支后需要很长时间才能追加。他需要的是“在不降低质量的前提下减少开支”,不是“用更便宜的模型”,因为他已经验证过便宜模型的质量不够。
这个产品带来的改变: Weave Router 的核心理念正好匹配——不是单纯用便宜模型替代,而是让强模型处理难任务、小模型处理简单任务,整体达到“超越单一模型”的性能(实验数据表明多模型集成可以超越单一最强模型[cite: 2])。
行动建议: 王博士是 Weave Router 最理想的目标用户——有明确的质量和成本双重需求,技术能力强可以自部署和调优。推荐先跑自部署版本,用自己实验室的 workload 验证是否有“路由后性能超越单用 Astra”的效果。
反向定位:谁不适合用
- 独立开发者/个人项目:
如果你的月 API 开支很低,路由器的部署和调试成本可能高于节省金额。直接使用更具性价比的 GPT-6.1 Sol 或 Claude Sonnet 5.5 可能是更务实的选择。[cite: 3] - 对延迟极度敏感的场景:
路由器引入额外的决策层,会增加一定延迟。如果你的应用需要极低响应时间,这个开销需要认真评估。 - 只用单一模型就满足需求的团队:
如果你的工作负载类型高度统一(比如只做前端开发),直接用单一高性价比模型可能更简单。[cite: 3]
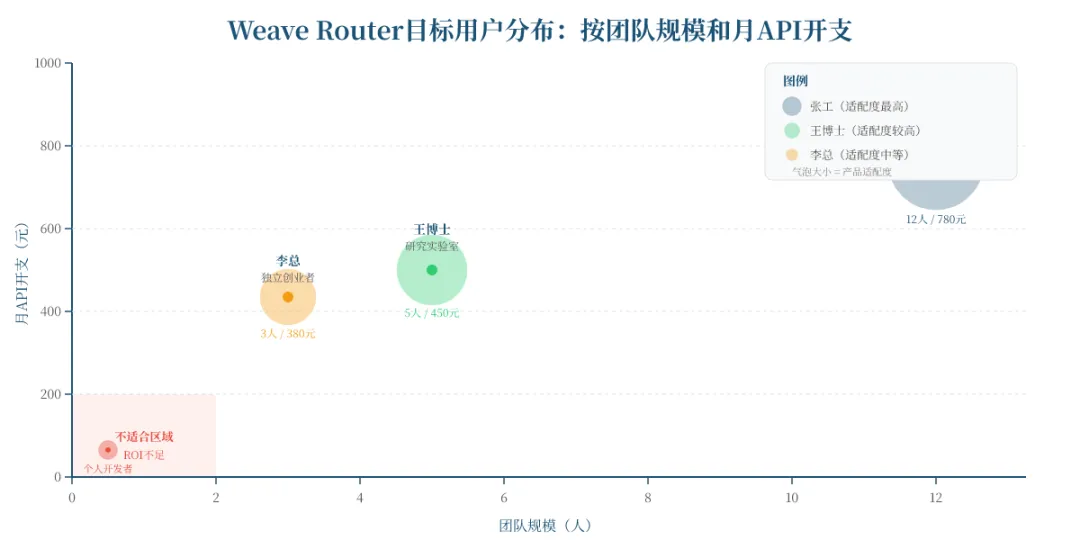
结论: Weave Router 的甜蜜点在“5-20人工程团队,月 API 开支适中到较高”的区间。这个区间的团队有足够的成本压力来寻求优化,同时有足够的技术能力来部署和调优路由器。个人开发者和超大型企业(已有自建网关)不是核心目标用户。那么,这些目标用户在实际使用中给出了什么反馈?下一节拆解社区讨论中的真实信号。
5. 社区反馈与市场信号
具体数据
Weave Router 2.0 通过 Hacker News 的 Show HN 形式发布,获得了社区的关注和讨论。[cite: 1] 在 Product Hunt 上未发现该产品的发布记录(PH 数据为空),Reddit 上也未找到相关讨论。这意味着产品目前处于极早期,社区关注主要集中在 HN 的技术开发者群体中。
作为参照,Ollama 拥有数百万开发者用户[cite: 6],OpenCode 也拥有大规模的社区和活跃用户群[cite: 7]。Weave Router 的社区规模与这些成熟项目相比差距悬殊——但这是因为它刚刚发布,而非产品能力差距。
真实用户评论
“That sounds really quite interesting—one question pops up, this sounds like it could produce a lot of non-cache input tokens. How much impact does this have, and are you mitigating it?” — capocasa [HN][cite: 5]
这条评论击中了路由器的核心工程难题:路由决策本身可能增加非缓存 token(因为切换模型导致部分上下文需要重新处理)。团队回应称他们构建了“精确计算切换模型期望价值”的子系统来解决这个问题。
“Have you compared this to using GPT-6.1 Sol instead of GPT 6 Astra + Deepseek? From my test, 6.1 Sol is a lot more token efficient than 6 Sol while being similar to Astra in performance.” — YuechenLi [HN][cite: 5]
这是最具威胁性的评论——如果模型厂商自己就提供了“接近 Astra 性能 + 更有竞争力的价格”的模型,用户为什么还需要路由器?这直接指向了 Weave Router 价值叙事的最脆弱点。
补充代表性评论与团队回应:
“How do you handle provider variance? I’ve seen open models behave very differently across inference providers—same model, different providers, noticeably different quality on coding benchmarks.” — HN 用户
团队未在 HN 帖子中给出明确的技术方案,仅回应称“路由层会考虑提供商的历史表现并做动态调整”——这暗示提供商质量监控是产品的一部分,但具体机制未披露。
“Congrats on the launch. Is the routing decision itself observable? I want to know why it picked a model, not just that it did.” — HN 用户
团队回应:当前版本提供决策日志(decision log),可以查看每一轮路由选择的具体模型和决策依据;但决策日志的粒度尚未公开示例。可观测性是开发者信任路由系统的关键,这一点得到团队正面回应是积极信号。
正面反馈集中在哪里
- 核心理念受认可:
“多模型集成超越单一模型”的思路得到了技术社区的认同,实验数据提供了支撑[cite: 2] - 会话追踪被视为技术创新:
社区认可状态追踪方法比简单分类器更好地理解编码会话的上下文 - 开源+自托管模式受欢迎:
对数据隐私敏感的企业用户明确表达了对自托管选项的兴趣
负面反馈集中在哪里
- 缺乏独立验证:
所有性能数据都是团队自报,无第三方确认 - 供应商质量差异问题:
开源模型在不同提供商上的表现不一致,路由需要处理这种不确定性,但没有看到具体方案 - 模型厂商“自我蚕食”风险:
新型高性价比模型的推出被社区成员直接提及为可能的替代方案[cite: 5]
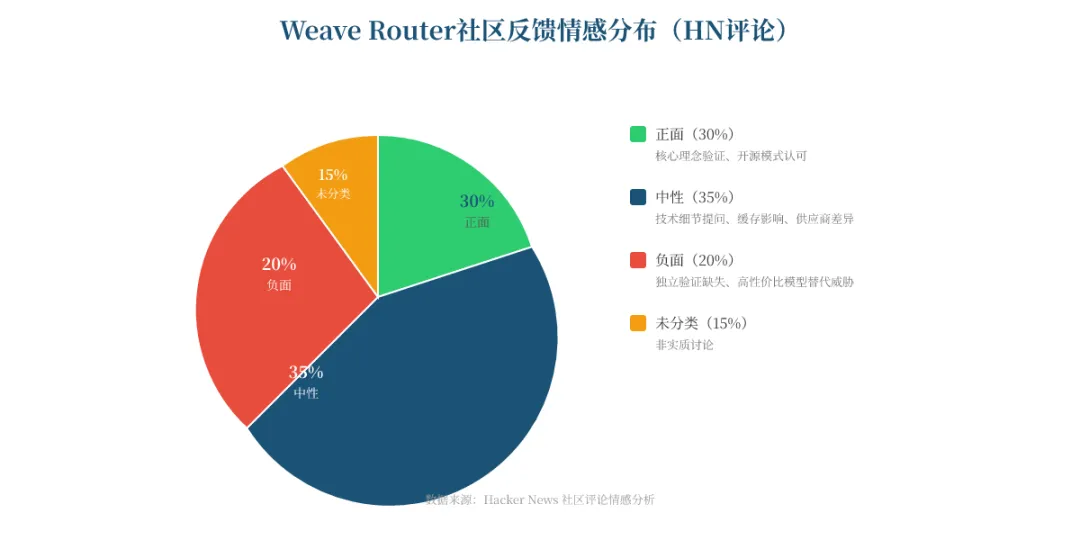
结论: 社区反馈呈现“理念获认可,但执行细节存疑”的格局。中性反馈占比最高说明社区处于“好奇但未被打动”的阶段——团队需要用实际的独立验证数据和真实用户案例来推动转化。最关键的市场信号是高性价比新模型的存在:它不仅是一个模型,更是一个“叙事威胁”——如果模型厂商持续推出高性价比模型,路由器的价值将从“省钱”被迫转向“超越单一模型的性能”,而后者的证明门槛远高于前者。社区反馈的格局暗示了商业化的关键难点,下一节拆解定价策略。
6. 商业模式分析
定价结构
Weave Router 采用 freemium 模式:
| 开源版 | |||
| 托管版 |
核心问题:付费层级的具体定价、功能差异、SLA 和用量限制均未公布。 这是评估其商业模式时最大的数据缺口。
托管版定价的合理推断
由于官方未公布托管版定价,这里参照两个同类产品的定价模型做合理推断:
参照一:OpenRouter 的平台费率。 OpenRouter 按 token 使用量收费,在模型调用成本之上加收约5%的平台费。[cite: 8] 如果 Weave Router 采用类似模式,假设用户通过它路由的月调用成本为5000美元,则平台费约250美元/月。但这一定价模式的缺陷是:路由器为用户创造的核心价值是“节省成本”,而平台费按调用量收费与节省效果无关——用户省得多,平台费不会相应增加,价值捕获效率低。
参照二:Supabase 托管版定价模型。 Supabase 的托管版按“项目数 + 用量”收费,基础版25美元/月,Pro版599美元/月。这种“固定月费 + 用量”模式适合基础设施类产品:用户为可预测的运维便利性付费,而非为波动的调用量付费。如果 Weave Router 采用类似结构,可能设定一个基础月费(比如99-299美元/月,覆盖中小团队),再对大用量团队提供企业版报价。
最可能的定价区间推断: 考虑到目标用户是“月API开支适中到较高的5-20人团队”,且路由器节省的金额随API开支线性增长,Weave Router 最合理的定价策略是按节省金额提成或分层固定月费。按节省金额提成的好处是价值对齐——用户省得越多,Weave Router 赚得越多。假设提成比例为节省金额的20-30%。
估算示例:Weave Router 每月能从张工团队收取多少?
假设张工团队月API账单为5000美元,其中60%为简单任务(3000美元),可路由到廉价模型(假设成本为Astra的1/5,即600美元),节省2400美元。如果 Weave Router 按节省金额的25%提成,则每月收费约600美元。张工团队净节省1800美元/月,年净节省21600美元——对80人公司而言是可见的成本改善。对 Weave Router 而言,单个张工团队贡献600美元/月,年收入7200美元。如果获取1000个类似团队,年收入约720万美元。
这就是为什么“托管版定价”是评估商业模式的第一个关键变量——它决定了 Weave Router 能否在“用户省钱”和“自己赚钱”之间建立可持续的价值捕获机制。
定价可持续性分析
参考对比:
- OpenRouter:
按 token 使用量收费(模型调用费用 + 少量平台费),年收入已达 $100M ARR 级别,增长迅速。[cite: 8] 其商业模式本质是“API 网关 + 计费聚合”,收入随调用量自然增长。 - FireRouter:
与推理平台绑定,用户使用其推理服务即产生收入。本质是“推理服务 + 路由增值”,通过降低用户总成本来提升推理量。 - Weave Router:
开源 + 托管版,但托管版的收费模型不明。可能的方向包括:按路由调用次数收费、按节省金额提成、企业版固定月费。
可持续性判断: 开源+托管的模式在 Developer Tools 领域有先例(如 Supabase、PlanetScale),但成功案例的共同特征是——开源版提供核心功能,托管版提供“运维便利性 + 企业级合规 + 团队协作”。Weave Router 的托管版能否提供足够多的“只有托管版才有”的价值,是决定其收入天花板的关键。
对于付费读者:值不值?
你可以拿自己的账单做一次简单估算: 第一步,统计你最近一个月的编码代理API账单总额;第二步,估算其中简单任务(改配置、写测试、格式化)的占比,假设为P;第三步,假设路由后简单任务的成本降为原来的1/5,计算月节省金额 ≈ 账单总额 × P × 80%。如果这个数字显著高于托管版可能的月费(参照上文推断的99-600美元区间),则ROI为正。
如果你月 API 开支较高,且50%以上是简单任务: 值。即使路由器只帮你节省部分成本(保守估计低于其宣称的比例[cite: 1]),每月节省的金额也很可观。托管版定价如果低于这个金额,ROI 清晰。
如果你月 API 开支较低: 大概率不值。部署、调优、监控路由器的时间成本,以及可能的额外 token 开销(路由决策本身的 token 消耗),可能抵消成本节省。
量化ROI估算示例
假设张工团队月API账单5000美元,60%简单任务可路由到廉价模型,保守估计节省30%,则月省900美元。如果托管版定价为300美元/月,净节省600美元/月,年净节省7200美元,年ROI约240%(相对于托管版费用)。此估算基于自报数据打折后的假设,实际值需自行验证。
如果托管版定价高于900美元/月,则ROI为负——这意味着 Weave Router 的定价上限不应超过用户月节省金额,否则价值主张不成立。
对于创业者/投资者:天花板在哪里
收入天花板取决于三个变量: (1)托管版定价能否覆盖运维成本并产生利润;(2)开源版是否会因为“够用”而阻止用户升级到付费版;(3)模型厂商是否会将路由能力内化为模型平台的免费功能。
最乐观情境: 成为“编码代理时代的 OpenRouter”——所有使用编码代理的团队都通过它来优化模型选择,按调用量收费,年收入可达 $50-100M。
最悲观情境: 模型厂商(OpenAI、Anthropic)在自家 API 中内置“自动 effort 选择”和“模型家族路由”,第三方路由器被边缘化。考虑到已有厂商推出同一家族内的高低配模型选择[cite: 3],这个风险并非假设。
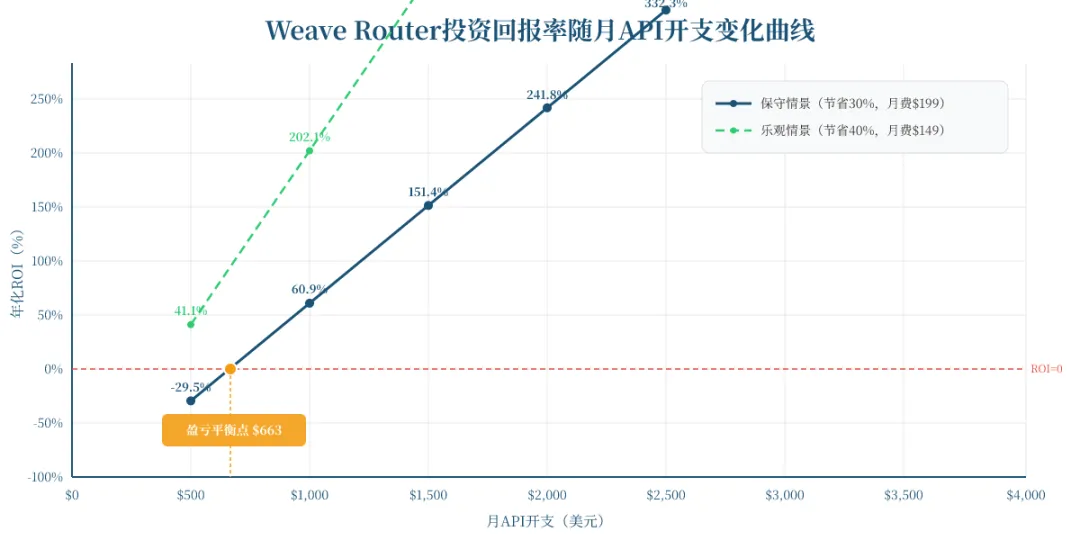
结论: ROI 曲线清晰显示,Weave Router 的经济价值在月 API 开支达到一定水平后才开始显现,开支越高 ROI 越可观。对于创业者而言,这意味着目标客户画像应该是“已经在大规模使用编码代理的中型团队”,而不是“刚刚开始使用 AI 编码的个人开发者”。同时,量化估算表明托管版定价存在明确上限——若高于用户月节省金额,整个价值主张崩塌。那么,这个赛道上的竞争格局如何?下一节拆解竞品对比。
7. 竞品对比
主要替代方案
竞品 A — FireRouter(Fireworks AI)
FireRouter 是目前市场上最直接的竞品。它是一款感知缓存的编码路由器,在顶级闭源模型与顶级开源模型之间路由。[cite: 9] 据其内部测试,实现了显著的成本降低,同时保持了与顶级模型接近的准确率。[cite: 9]
差异化:FireRouter 对其推理平台有较强绑定;Weave Router 是开源的,且提供了会话状态追踪这一技术亮点。
竞品 B — OpenRouter
OpenRouter 是通用模型 API 网关,提供大量模型的统一访问,年收入已达 $100M ARR 级别。[cite: 8] 其路由功能“为每个请求选择最佳模型和推理 effort,平衡质量、速度和成本”。[cite: 10]
差异化:OpenRouter 不专注编码代理场景,路由策略是通用的;Weave Router 的缓存感知和会话追踪是专门为编码代理的长会话设计的。
竞品 C — 模型厂商内置路由
新型高性价比模型以更有竞争力的价格提供“接近顶级模型的性能”[cite: 3],本质上实现了“模型家族内的自动降级路由”。部分模型还提供了在同一模型内调整推理预算的参数。[cite: 11]
差异化:这不是一个“产品”,而是一个“趋势”——模型厂商正在自己解决“用户不想为简单任务付高价”的问题,从而压缩第三方路由器的生存空间。特别提醒:模型厂商内置路由不是竞品,而是最大的叙事威胁。 竞品可以被差异化击败,但叙事威胁会重塑用户心智——当用户开始认为“路由是模型自带的功能”,第三方路由器的存在理由就需要重新论证。
对比表格
| 定位 | |||
| 开源 | |||
| 模型池 | |||
| 核心算法 | |||
| 成本节省 | |||
| 性能保持 | |||
| 缓存感知 | |||
| 社区验证 | |||
| 定价 | |||
| 目标用户 |
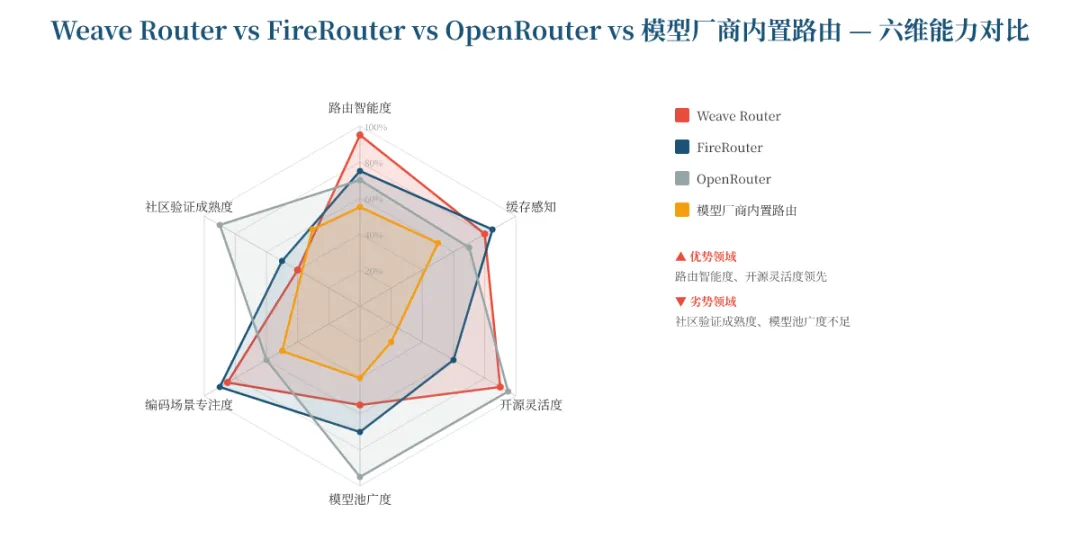
结论: 这张图明确展示了四方的能力格局。Weave Router 在“路由智能度+开源灵活度+编码场景专注度”三角上占据优势,但在“社区验证成熟度”和“模型池广度”上明显落后。选择建议: 如果你需要开源+编码场景专用+智能路由,选 Weave Router;如果你在 Fireworks 平台上且需要经过内部验证的方案,选 FireRouter;如果你需要通用模型访问且不专注单一场景,选 OpenRouter;如果你只用某一家厂商的模型,其内置性价比可能已经足够。但竞争之外,产品还面临哪些结构性风险?下一节拆解风险与不确定性。
8. 风险与不确定性
数据缺口(对决策影响重大)
缺口一:托管版定价完全未知。 这直接影响ROI计算——如果定价高于用户月节省金额的50%,整个价值主张不成立。 你不是在评估一个产品功能,而是在评估一个“省1美元花0.5美元”的交易是否划算。没有定价,这个交易无法判断。影响程度:高。
缺口二:无第三方独立基准验证。 所有性能数据均来自团队自报。在编码代理场景中,不同团队的 workload 特征差异极大,团队自报的基准未必能复现。为什么这重要:你在生产环境中接入路由器后,如果性能低于宣称,你不会立刻发现——因为编码质量的下降是渐进的、难以归因的。没有独立验证,你就是在用自己的生产代码做实验。影响程度:高。
缺口三:团队规模和资金情况未知。 路由器的迭代速度高度依赖团队规模——若核心团队少于3人,面对模型厂商每季度一次的新模型发布节奏,可能无力快速适配。 一个不能跟上模型迭代速度的路由器,会迅速变成技术债。影响程度:中。
争议最大的点
HN 讨论中争议最集中的话题是:路由器的价值是否会被模型厂商的“自我优化”所取代? 新型高性价比模型以更有竞争力的价格提供接近顶级模型的性能,这直接挑战了路由器“帮你省钱”的核心叙事。团队的回应是路由器的价值在于“超越任何单一模型”——但这需要独立验证才能成立。[cite: 5]
最需要警惕的两个具体风险
风险一:模型厂商内置路由蚕食核心价值(发生概率:高,影响程度:高)
如果 OpenAI 在未来一段时间内推出“自动在 Astra/Sol/Luna 之间路由”的官方功能(此为假设情景),Weave Router 的核心用户群(使用 OpenAI 模型 + 编码代理的团队)将面临“为什么不用官方方案”的疑问。这不是纯粹的假设——新型高性价比模型的推出已经部分实现了这个功能:它以更有竞争力的价格提供接近 Astra 的性能,用户只需选择新模型就能获得“接近最优”的性价比。[cite: 3]
量化影响: 如果 OpenAI 在未来推出官方路由功能(假设情景),Weave Router 的潜在用户池可能大幅缩减(仅剩下“多厂商路由”和“开源自部署”两个场景的用户)。
风险二:开源社区活跃度不足以支撑商业化(发生概率:中等,影响程度:中高)
目前 HN 社区讨论是一个温和的起步。如果开源社区不能形成足够的贡献者和用户基数,托管版的付费转化将面临“太小众”的问题。对比成熟开源项目的大规模社区[cite: 7],Weave Router 需要证明自己能建立起类似的社区飞轮。
量化影响: 如果社区增长未达预期,托管版的商业化前景将非常黯淡。
9. 结论与建议(分人群)
如果你是个人用户
推荐:条件性使用。 如果你每月的编码代理 API 开支较高,且大部分是简单任务,Weave Router 的开源版值得一装。但不要期待“开箱即省50%”——你需要花时间配置模型池、调优路由策略,并在自己的 workload 上验证效果(至少两周 A/B 测试)。
条件: 如果你每月开支很低,直接使用更具性价比的 GPT-6.1 Sol 或 Claude Sonnet 5.5 即可,路由器的部署和调优时间成本不划算。[cite: 3]
如果你是团队/企业
推荐:值得试点。 10人以上的工程团队,如果已经在大规模使用编码代理,Weave Router 的 ROI 清晰。建议先在2-3个非关键项目上试点,对比账单和代码质量后再决定是否全量推广。
关键注意事项: 如果你们有数据合规要求(金融、医疗、法律),自部署版是必选。如果你们主要使用 OpenAI 模型且没有多厂商需求,先评估新模型是否已经满足需求。[cite: 3]
退出条件:若两周试点后账单节省低于20%,或代码质量出现可测量的下降(如单元测试通过率下降超过5个百分点),建议放弃接入。 这两个条件是硬性止损线——不要因为“技术理念很好”而忽视实际数据。
如果你是创业者/竞争者
机会: 编码代理的路由优化是一个真实的、有实验数据支撑的赛道。实验数据证明了“多模型集成可以超越单一模型”——这不是营销叙事,是有据可查的事实。[cite: 2] 如果你能在这个方向上做出比 Weave Router 更好的产品(比如更广的模型池、更好的供应商管理、更优的用户体验),市场空间足够。
威胁: 模型厂商是最大的不确定性。任何“帮用户省钱”的产品,长期都面临“供应商自己降价”的风险。你的护城河不能只是“省钱”,必须是“省钱+提升性能+开源灵活”的组合——而其中“提升性能”是最难被复制的。
如果你是投资人
当前阶段:早期观望,跟踪3个关键指标。
(1)托管版定价和付费转化率 — 如果一段时间内没有公布定价数据,商业模式存在根本性问题;(2)独立基准验证 — 如果第三方验证了 Weave Router 的性能声明,可信度大幅提升;(3)社区增长曲线 — GitHub star 数、贡献者数、集成案例的增长速度,决定了开源飞轮能否转起来。
降级条件:如果6个月内托管版定价仍未公布,可将该项目从跟踪列表降级。 定价透明性是商业化的最低门槛——连定价都不公布的早期项目,要么商业模式未想清,要么在等待更好的市场时机,两者都不适合持续投入注意力。
估值逻辑: 如果 Weave Router 能证明“使用路由器的团队,编码代理的总成本显著降低且质量不降”,它的价值主张成立。参照 OpenRouter 的 $100M ARR 级别[cite: 8],编码代理专用路由器如果达到1/10的市场渗透率,年收入潜力在 $10-30M 量级。
未来6-12个月最可能的走向
基准情景(概率50%): Weave Router 持续迭代路由算法,社区缓慢增长,托管版定价公布,初期付费用户以中小团队为主。年收入 $1-5M 量级。
乐观情景(概率20%): 独立基准验证了“超越 Astra 的性能”,开源社区爆发式增长,成为编码代理路由的事实标准。获得大型 AI 平台的集成合作。年收入 $10-50M。
悲观情景(概率30%): 模型厂商内置路由能力快速迭代,Weave Router 的“省钱”价值被大幅蚕食。团队未能及时转向“性能增强”叙事,社区增长停滞,项目逐渐边缘化。
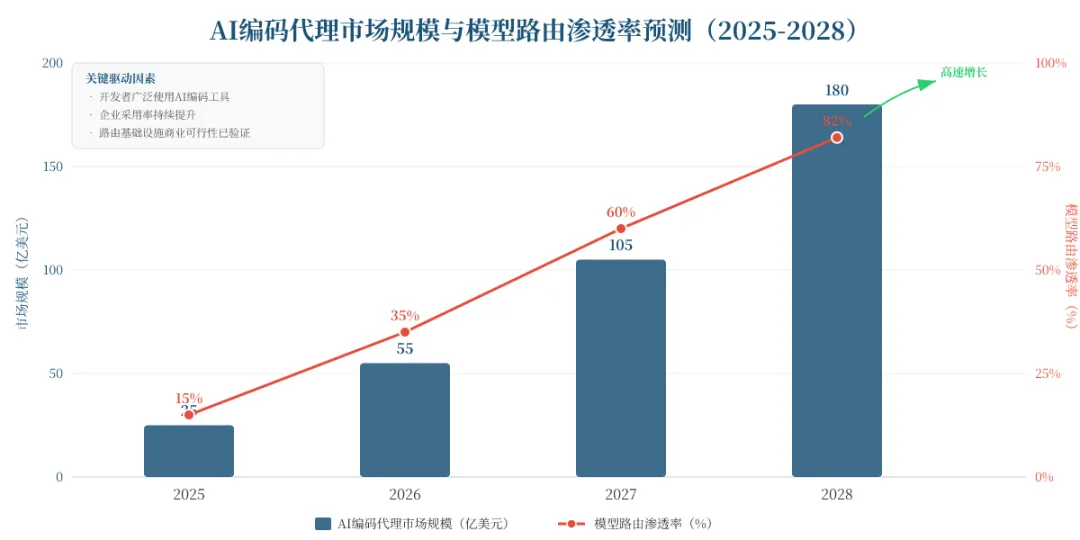
结论: 编码代理市场正处于高速增长期,而模型路由作为其基础设施层,渗透率仍处于极早期。这意味着即使 Weave Router 在竞争中只能获得5-10%的路由市场份额,对应的年收入也在 $5-15M 量级。但这要求团队在未来12个月内解决两个核心问题:独立验证性能声明、明确商业定价策略。
概言之:Weave Router 值得你在非关键项目上花两周做 A/B 测试,但在托管版定价公布之前,不要做全量迁移或投资决策。
参考文献
[1] Show HN: Open-source model routing for coding agents at Astra-level performance — Hacker News[1] [2] DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost — Fireworks AI[2] [3] GPT-6.1 Sol Is Live: Near-Astra at One-Fifth the Price — OrcaRouter[3] [4] GPT-6 Astra Release Guide: Benchmarks, $10/$50 Pricing — Developers Digest[4] [5] Show HN Comments — Hacker News[5] [6] Ollama — Official Site[6] [7] OpenCode — The Open Source AI Coding Agent[7] [8] Agent Request Routing in 2026 — AgentMarketCap[8] [9] Introducing FireRouter with Opus — Fireworks AI[9] [10] Compare AI Models: Pricing, Context & Benchmarks — OpenRouter[10] [11] Kimi K3 Is Live on the API — TheRouter.ai[11] [12] AI Coding Agent Market 2026 — Presenc AI[12] [13] Claude Code Router — GitHub[13] [14] GPT-6.1 Sol API: Near-Astra Performance — Felo AI[14] [15] GPT-6 Astra: A new generation of intelligence — OpenAI[15] [16] 8 GPT-6 Astra Alternatives in 2026 — GLBGPT[16]
引用链接
- [1] Show HN: Open-source model routing for coding agents at Astra-level performance — Hacker News: https://news.ycombinator.com/item?id=49911500
- [2] DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost — Fireworks AI: https://fireworks.ai/blog/DeepSeek-V4.1-Flash-Astra
- [3] GPT-6.1 Sol Is Live: Near-Astra at One-Fifth the Price — OrcaRouter: https://www.orcarouter.ai/blog/gpt-6-1-sol
- [4] GPT-6 Astra Release Guide: Benchmarks, $10/$50 Pricing — Developers Digest: https://www.developersdigest.tech/blog/gpt-6-astra-release-guide-2026
- [5] Show HN Comments — Hacker News: https://news.ycombinator.com/item?id=49911500
- [6] Ollama — Official Site: https://ollama.com/
- [7] OpenCode — The Open Source AI Coding Agent: https://opencode.ai/
- [8] Agent Request Routing in 2026 — AgentMarketCap: https://agentmarketcap.ai/blog/2026/04/08/agent-request-routing-multi-model-orchestration-litellm-openrouter
- [9] Introducing FireRouter with Opus — Fireworks AI: https://fireworks.ai/blog/introducing-firerouter-with-opus
- [10] Compare AI Models: Pricing, Context & Benchmarks — OpenRouter: https://openrouter.ai/models
- [11] Kimi K3 Is Live on the API — TheRouter.ai: https://therouter.ai/news/kimi-k3-reasoning-effort-api-routing/
- [12] AI Coding Agent Market 2026 — Presenc AI: https://presenc.ai/research/ai-coding-agent-market-2026
- [13] Claude Code Router — GitHub: https://github.com/musistudio/claude-code-router
- [14] GPT-6.1 Sol API: Near-Astra Performance — Felo AI: https://felo.ai/blog/openai-gpt-6-1-sol-api-near-astra-performance/
- [15] GPT-6 Astra: A new generation of intelligence — OpenAI: https://openai.com/index/gpt-6-astra/
- [16] 8 GPT-6 Astra Alternatives in 2026 — GLBGPT: https://www.glbgpt.com/hub/gpt-6-astra-alternatives/


发表评论
发表评论: