
 研报速递
本文选自申万研报,仅供学习参考
1. 应用长周期与技术短周期共同驱动交换机迭代
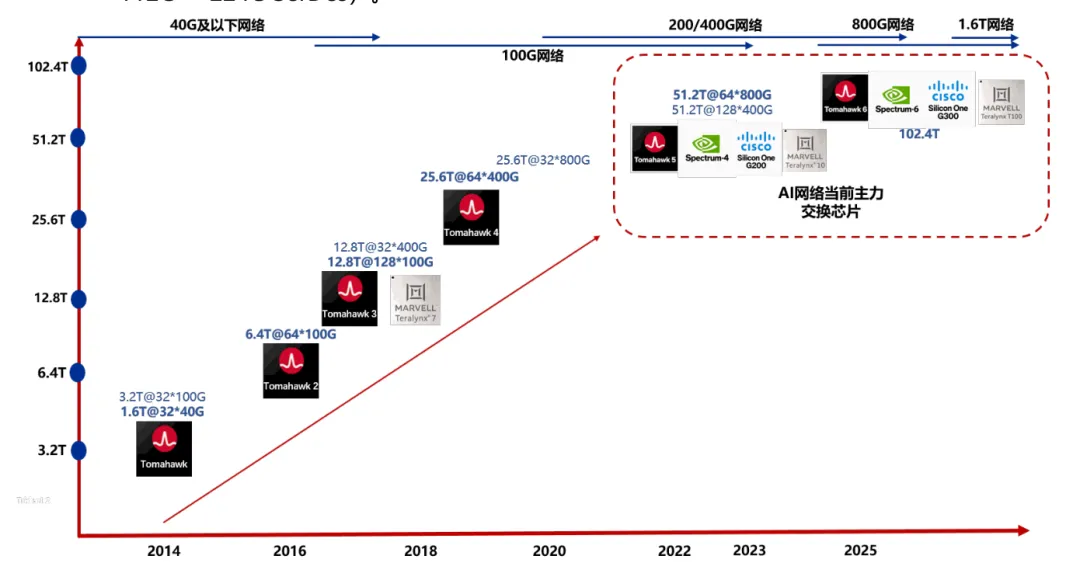
网络/交换机行业呈现长周期嵌套短周期特征。
• 长周期(10-15年),由应用的总体需求决定(企业网络 -> 云服务 -> AI/HPC);
• 短周期(2-3年),由交换芯片容量提升和SerDes速率升级驱动(10G -> 25G -> 56G ->112G ->224G SerDes)。
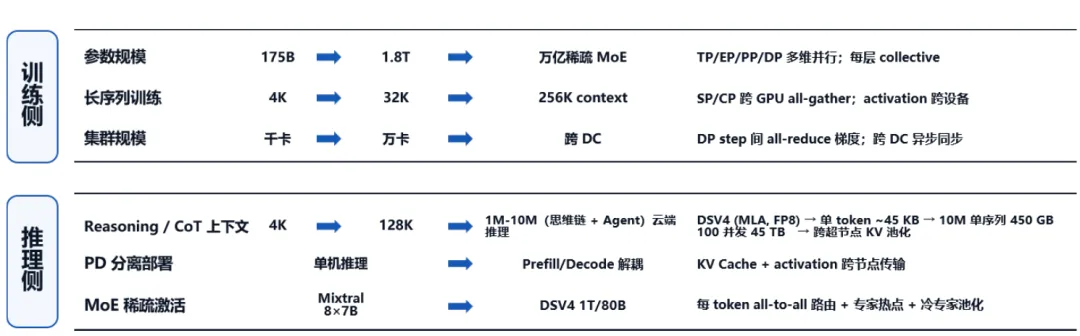
网络受到来自训练与推理的双重迭代压力:
• 训练侧:随着模型参数、上下文和集群规模扩大,梯度同步、激活值交换及MoE专家通信持续增加,通信瓶颈会增加XPU等待时间,降低集群利用率。集群扩张既增加网卡、交换端口和光模块需求,也推动网络向更高带宽、更低尾时延和更强拥塞控制升级。
• 推理侧:长上下文、CoT、MoE及PD分离增加跨卡、跨节点的KV Cache搬运和专家通信,高并发进一步放大流量的突发性与不均衡性。因此,推理集群扩张不仅增加网络设备需求,也提高了对RDMA、高速端口和低尾时延的要求。
◼ 国内外技术演进方向趋同,未来的智算中心将会采用更高密度的计算及存储硬件和更高性能的网络连接,以获得更高利用率的并行计算与通信能力。
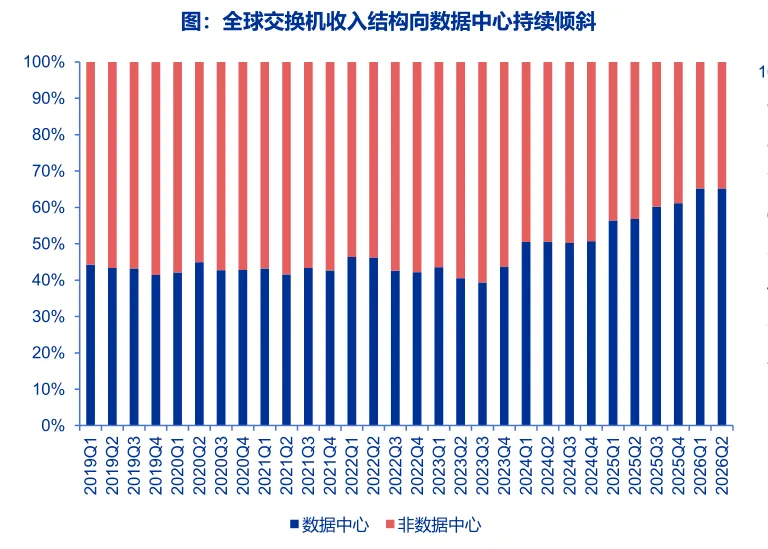
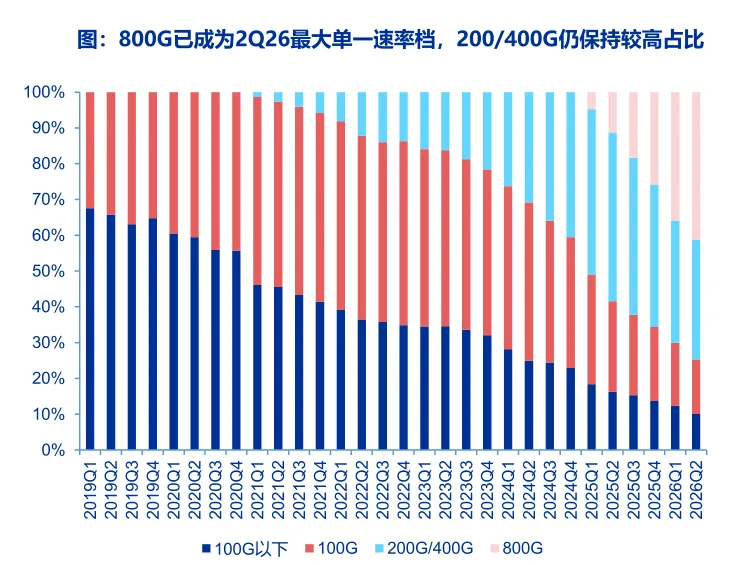
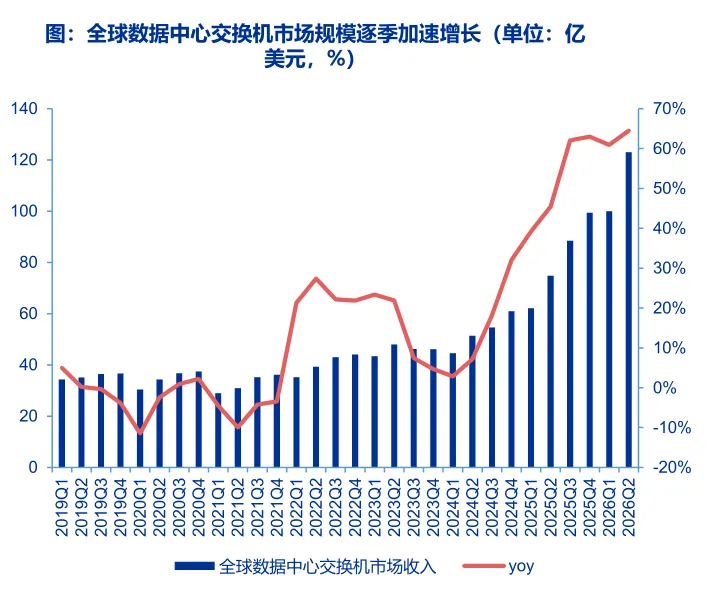
AI算力集群扩张推动交换机需求向数据中心集中,端口速率升级周期明显缩短,多代高速率产品将持续并存。
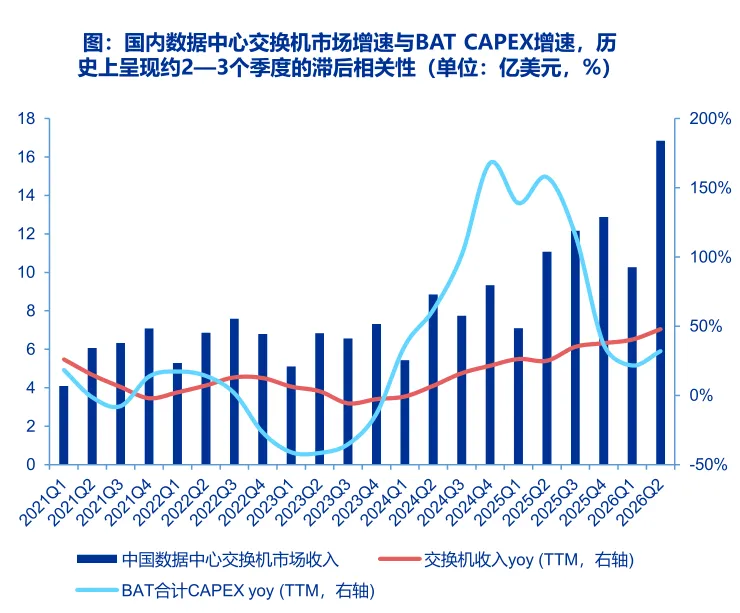
• 需求结构:数据中心交换机收入占比持续提升,交换机行业的增长重心正由园区网等传统市场转向数据中心。
• 产品结构:端口速率升级显著加快。2Q26全球数据中心以太网交换机收入中,800G占比已升至41.2%,高于200/400G的33.6%;考虑网络层级、客户建设周期与存量集群代际差异,100G、200/400G与800G仍将长期并存
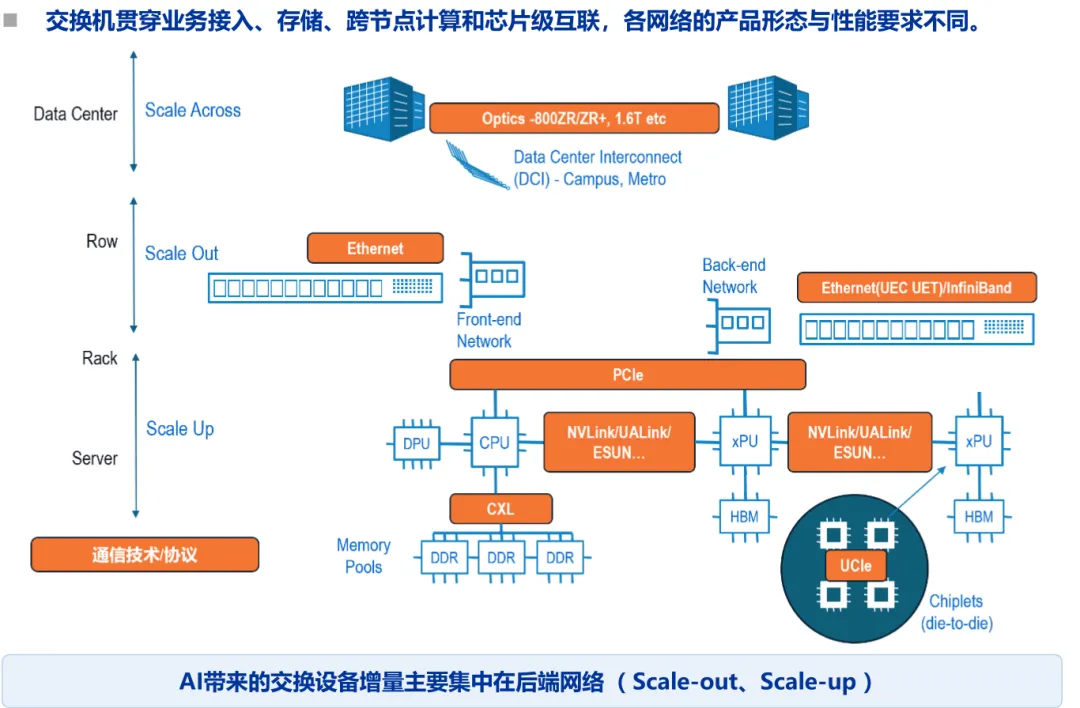
2.1 AIDC网络分工:多层网络各司其职
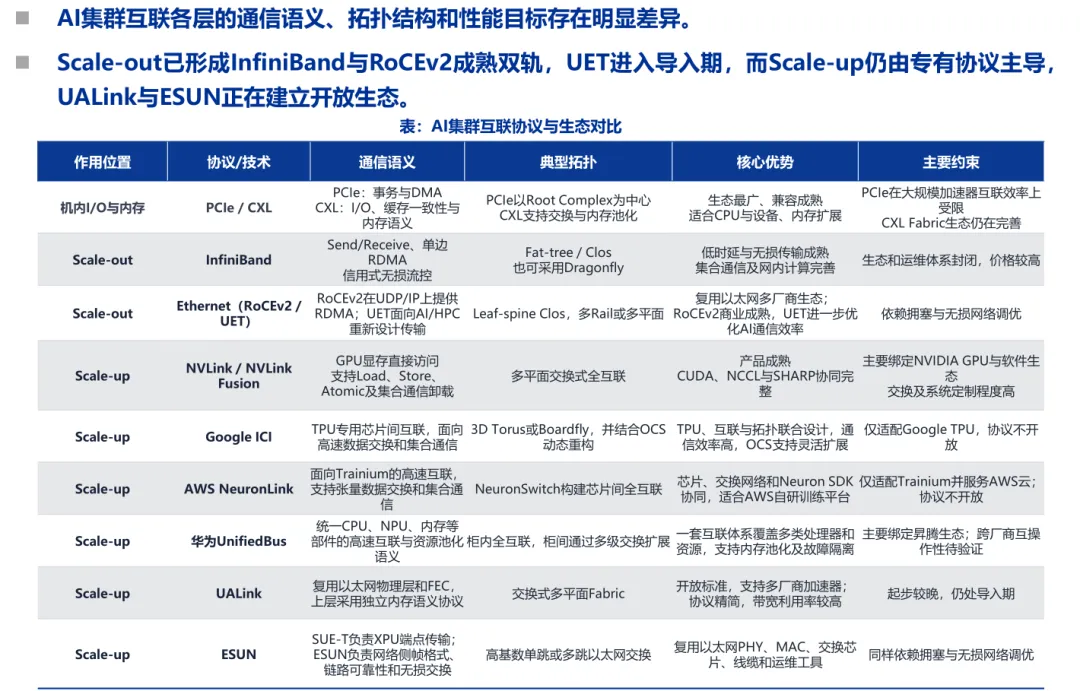
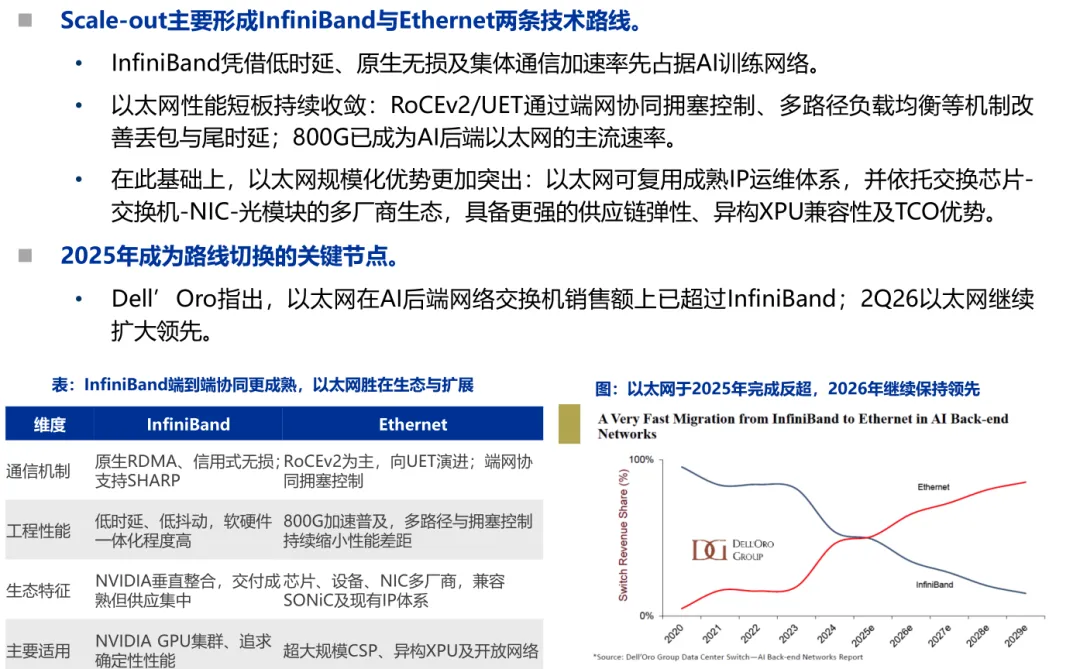
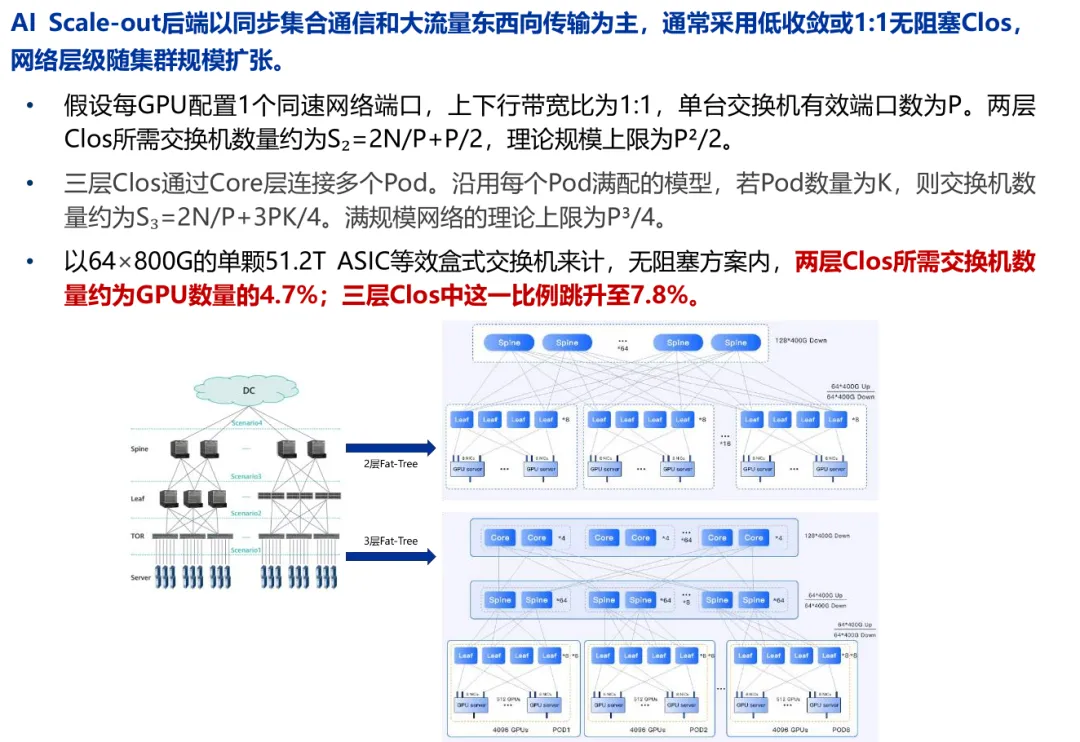
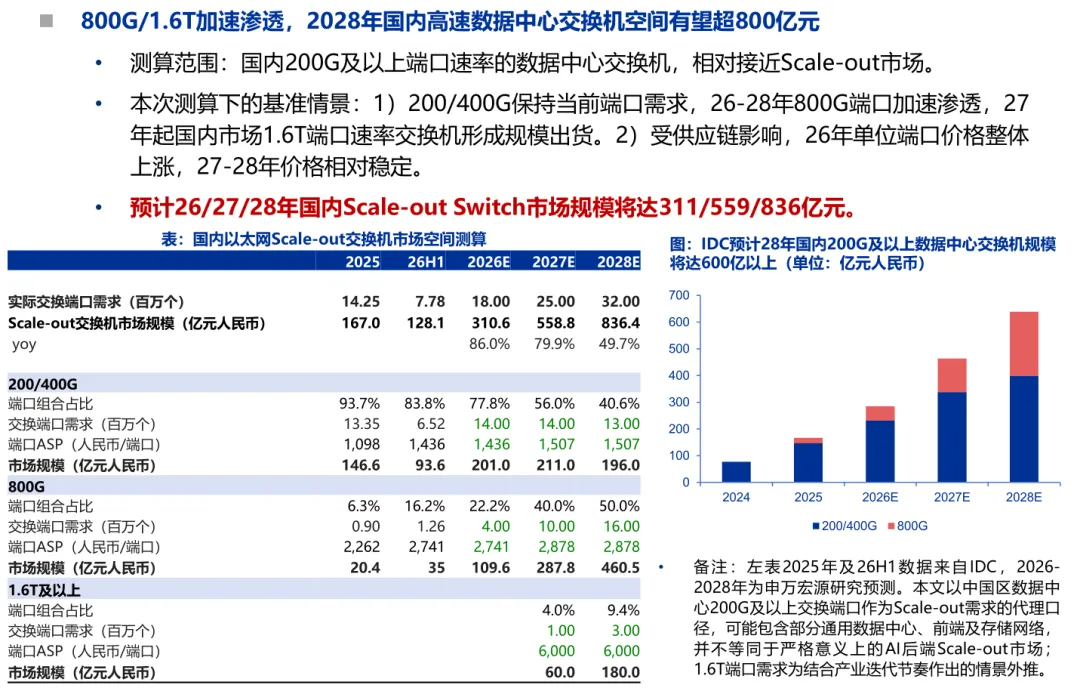
2.2 Scale-out:有固定配比,网络层级增加推升交换机用量
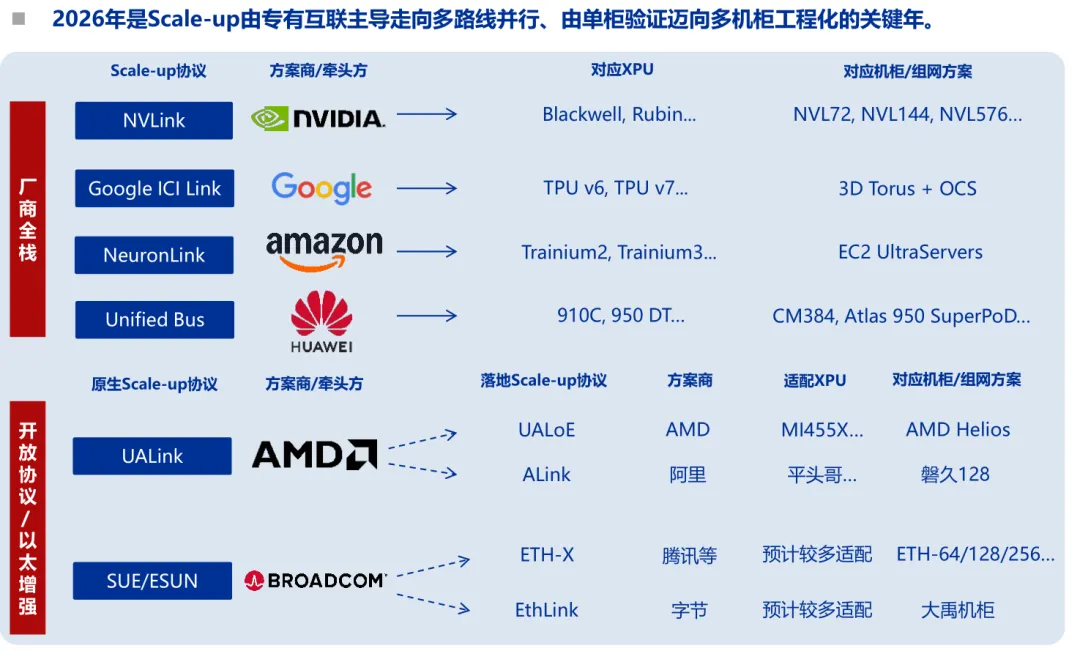
2.3 Scale-up:闭环整机柜与解耦白盒双线演进
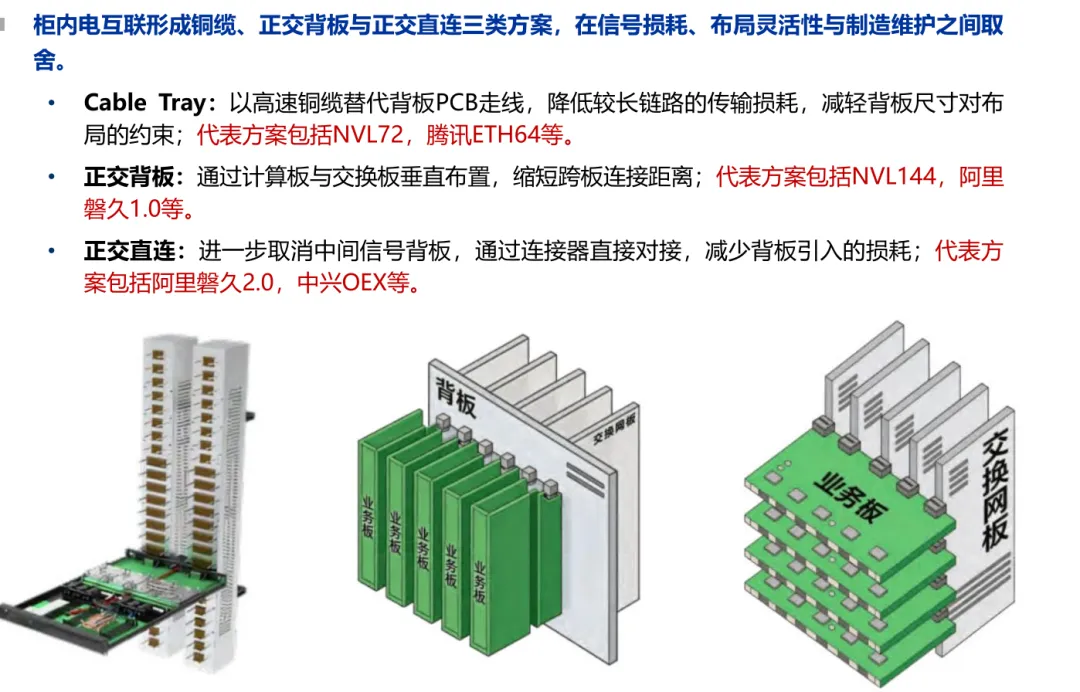
2.3.1 整机柜Scale-up:电互联方案并行,正交设计缩短高速信号路径
2.3.1 整机柜Scale-up:Vera Rubin NVL72
NVLink 6全栈协同,单柜形成72卡统一Scale-up域
• 组网拓扑:72颗Rubin GPU通过36颗NVLink 6 Switch ASIC组成单层All-to-All Fabric。每颗GPU的36条NVLink链路分别接入36颗交换ASIC,实现任意GPU之间的单级交换互联。
• 落地方案:18个Compute Tray与9个NVLink Switch Tray采用计算与交换分离的托盘化设计,并通过柜后NVLink Copper Spine连接。
• 数量关系:GPU : NVLink 6 Switch ASIC : Switch Tray为72 : 36 : 9,即8 : 4 : 1。GPU与交换ASIC之比为2 : 1,每个Switch Tray包含4颗NVLink 6 Switch ASIC。
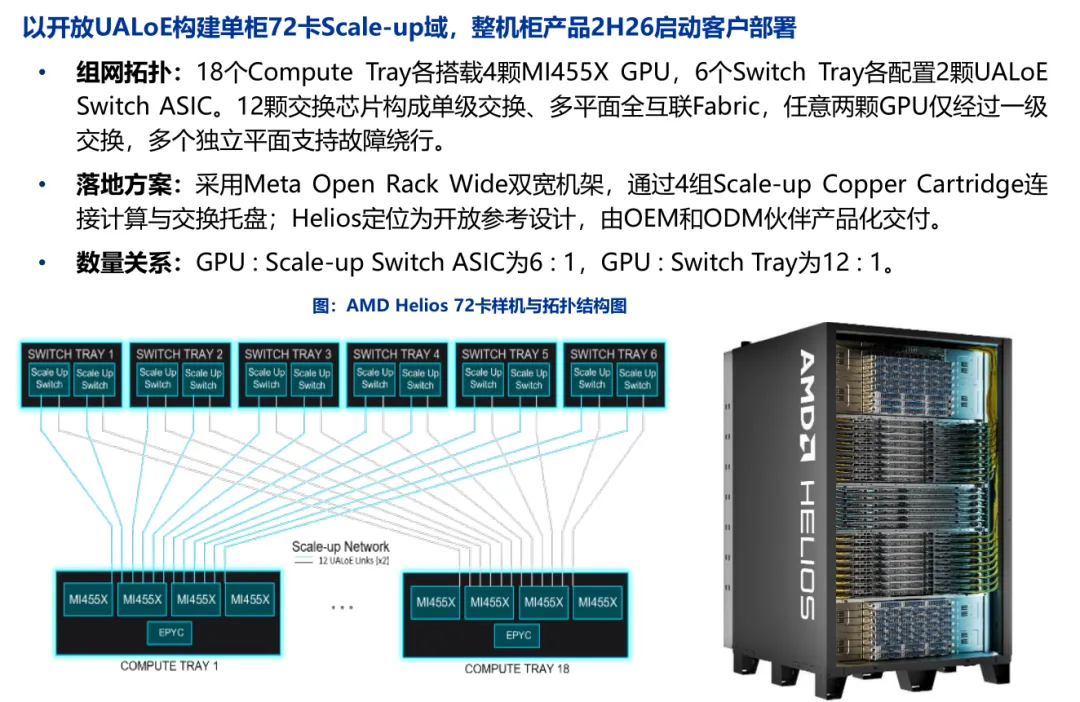
2.3.1 整机柜Scale-up:AMD Helios
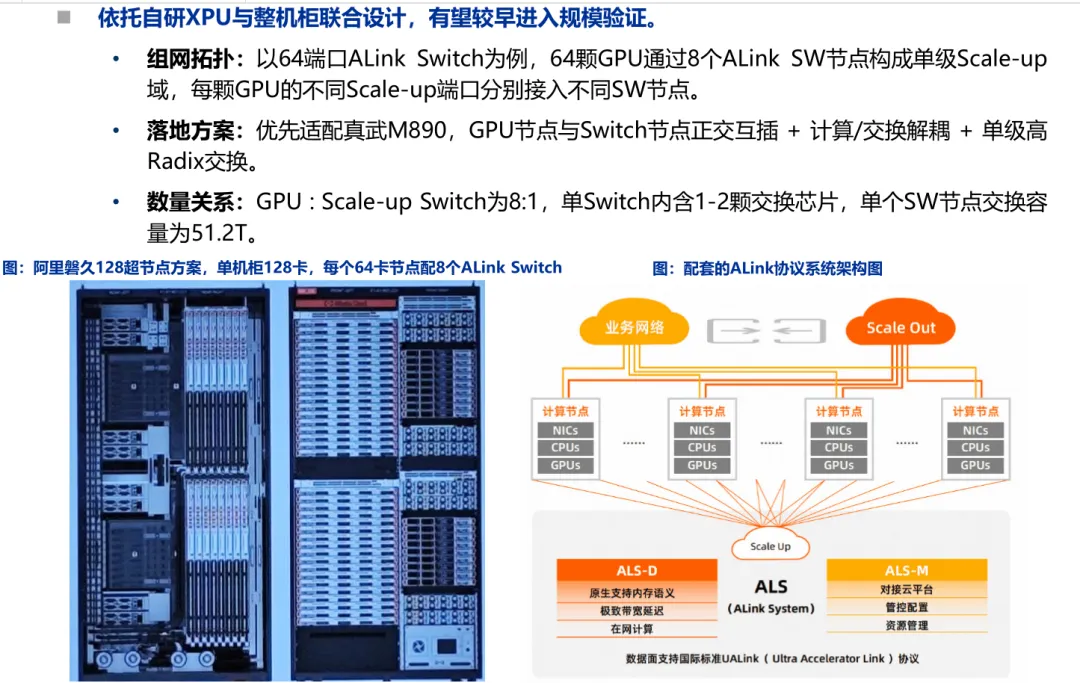
2.3.1 整机柜Scale-up:阿里磐久2.0
2.3.1 整机柜Scale-up:腾讯ETH-X
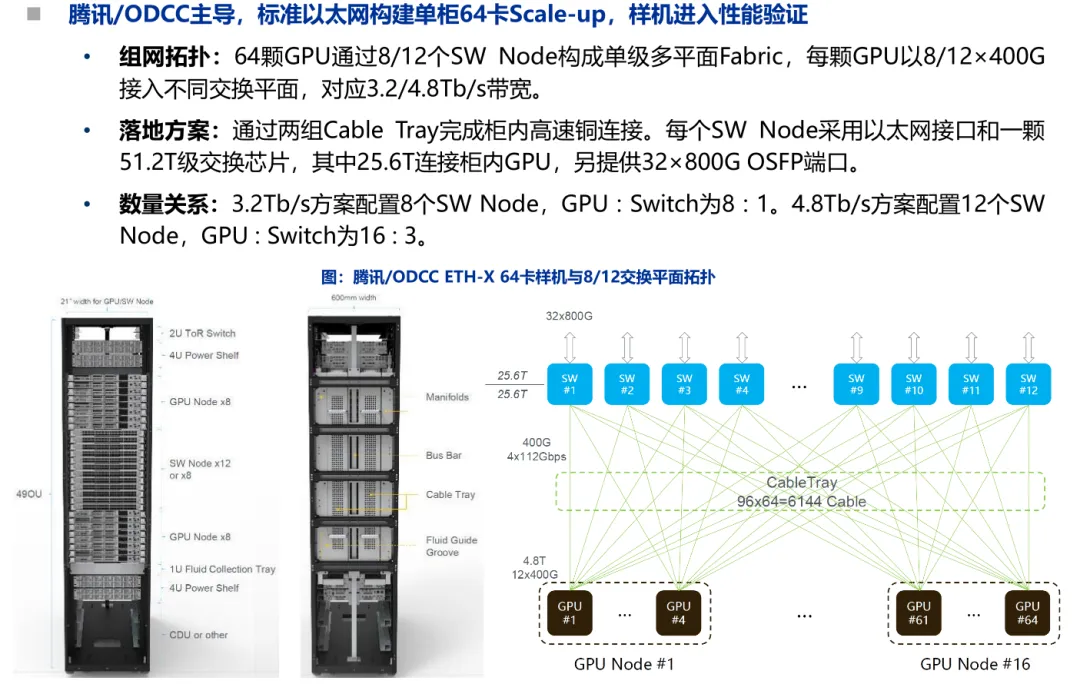
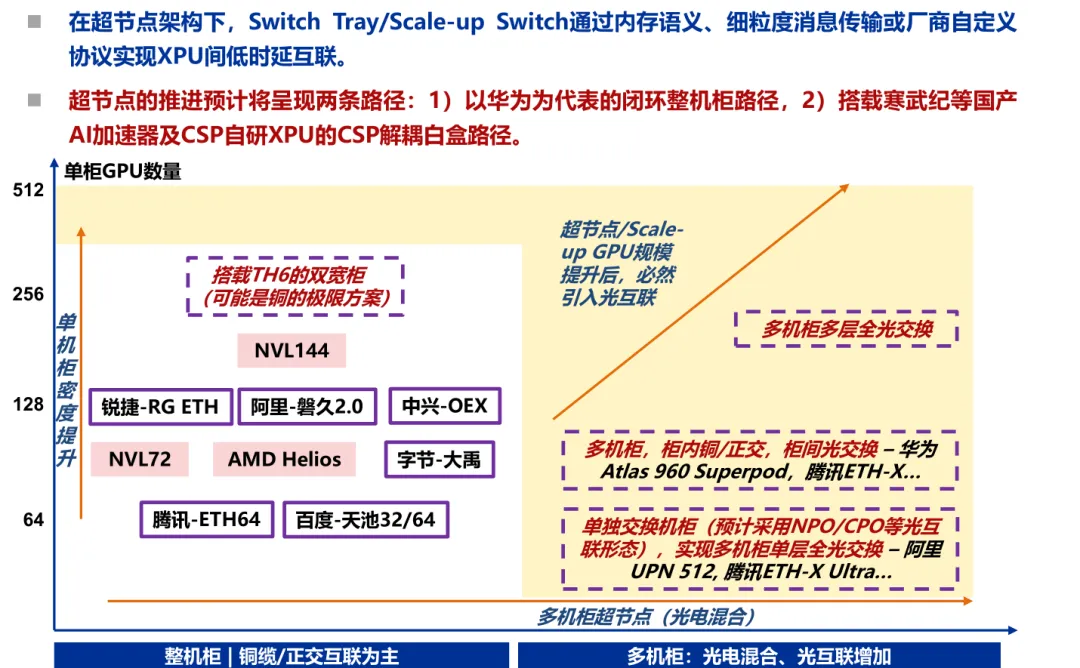
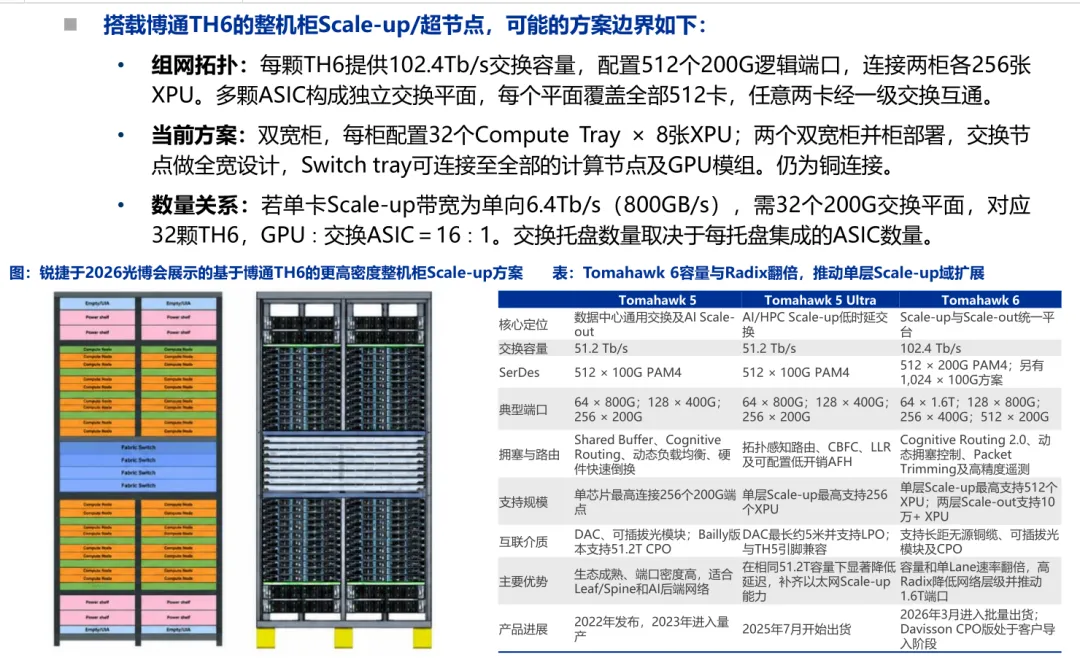
2.3.1 解耦整机柜Scale-up极限方案 – 或为双宽柜+并柜部署,搭载博通TH6,承载最高512张XPU
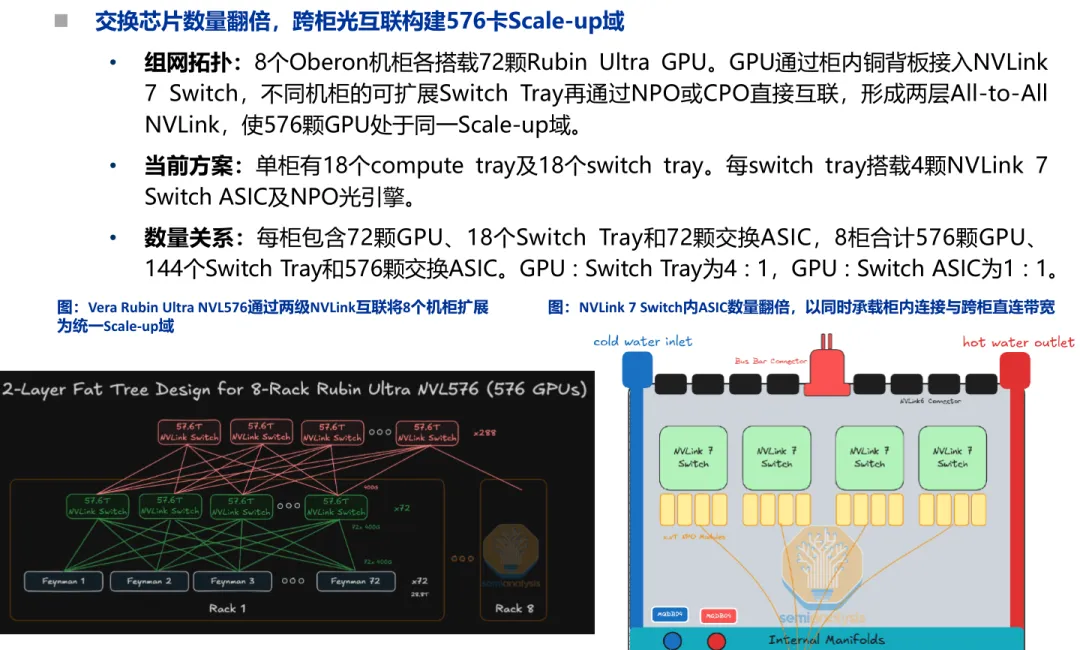
2.3.2 多机柜Scale-up:Vera Rubin Ultra NVL576
2.3.2 多机柜Scale-up – 昇腾960超节点
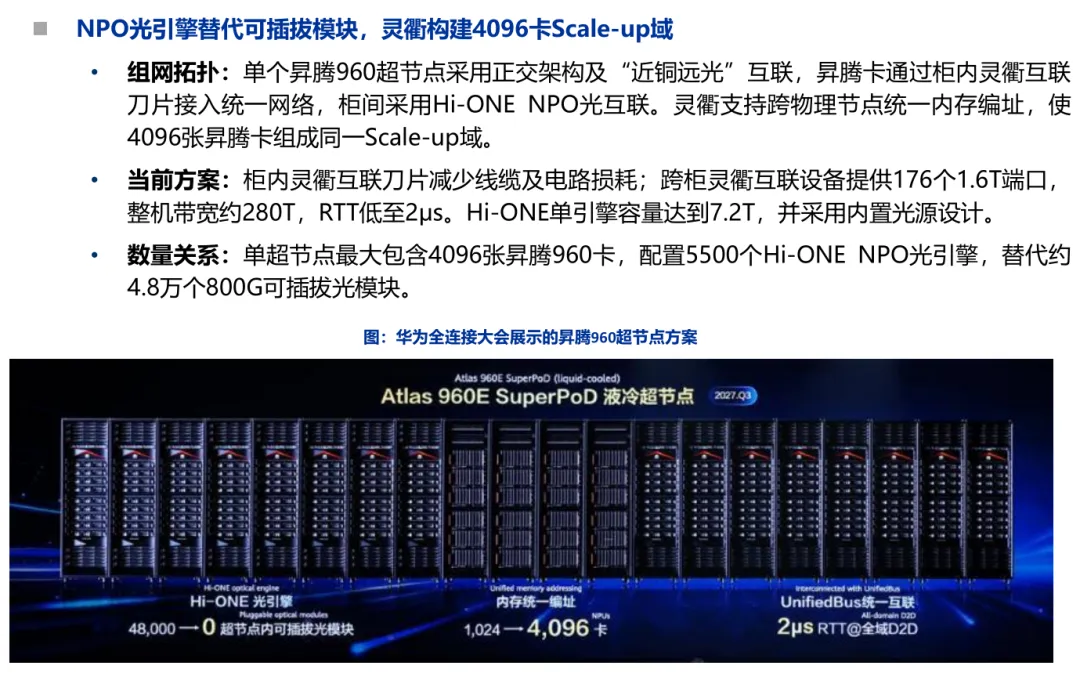
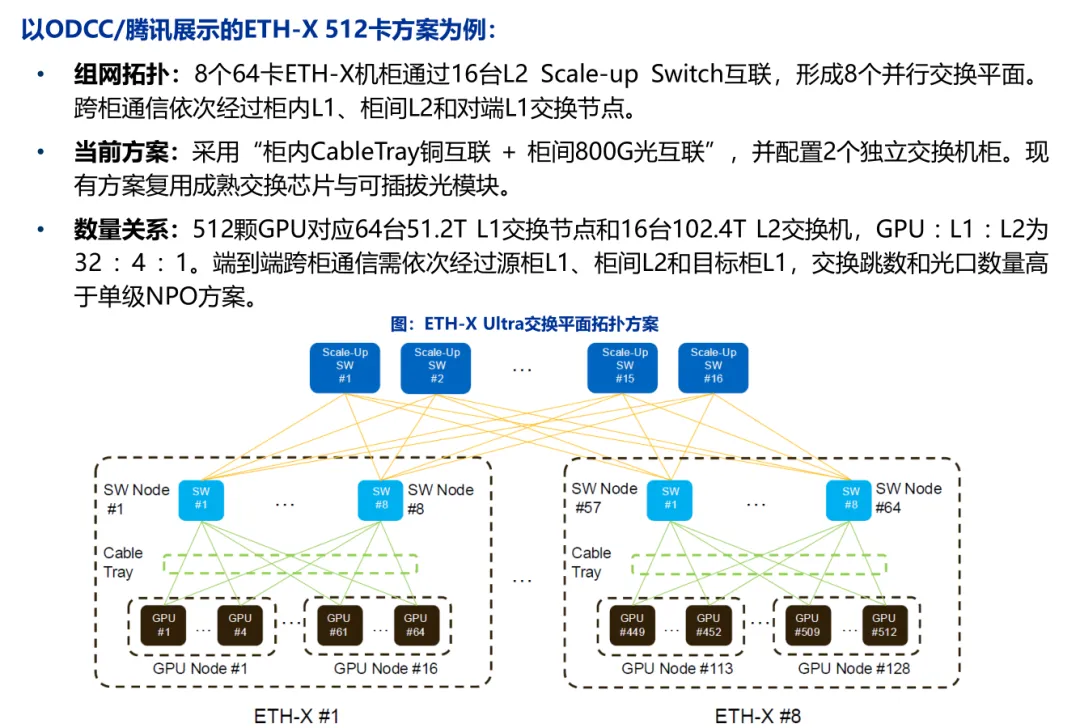
2.3.2 解耦多机柜Scale-up方案:铜+光,两层Scale-up
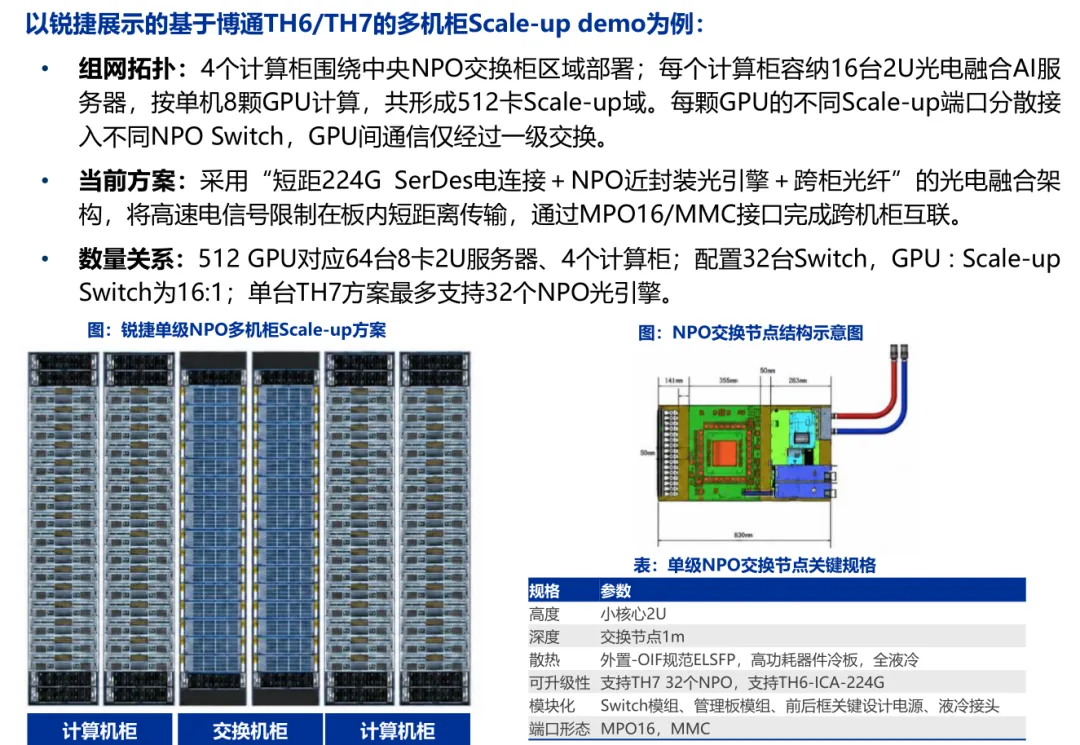
2.3.2 解耦多机柜Scale-up方案:单级NPO光互联
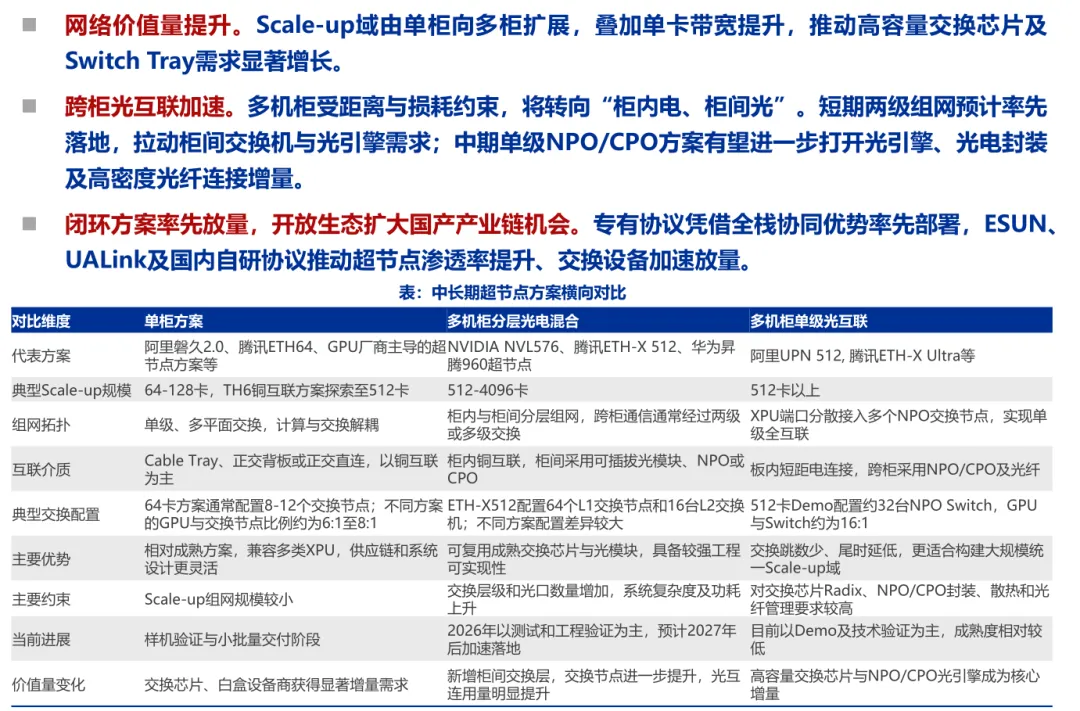
2.3.3 横向对比与核心结论
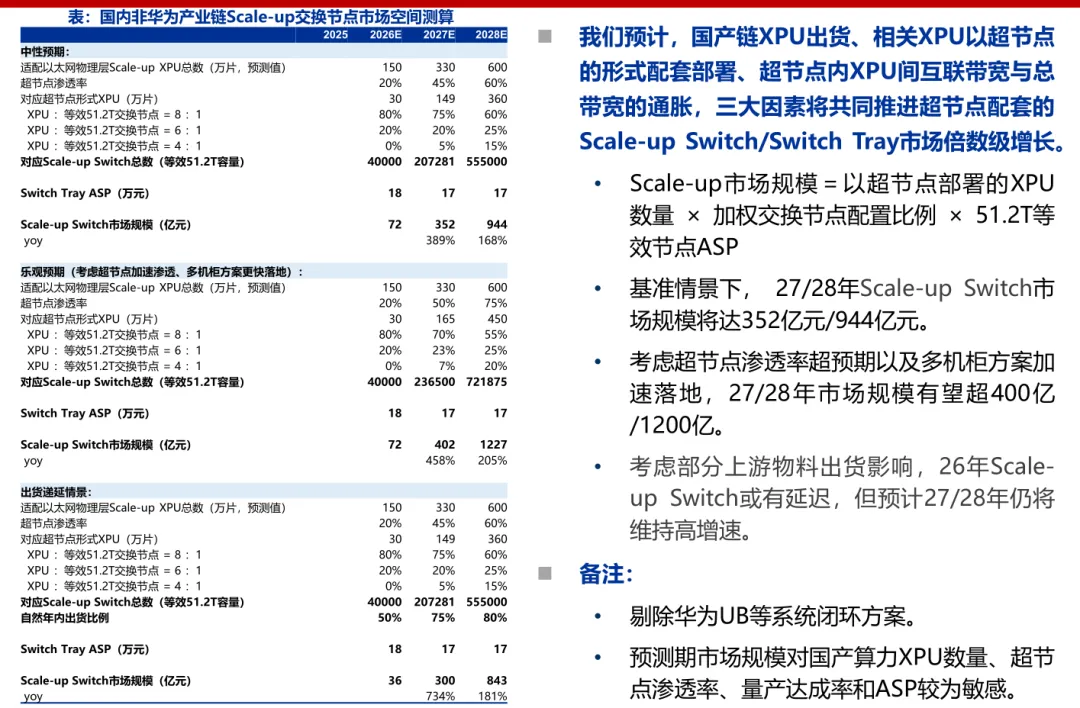
2.4 Scale-up场景下,国内配套交换机空间测算(不含华为)
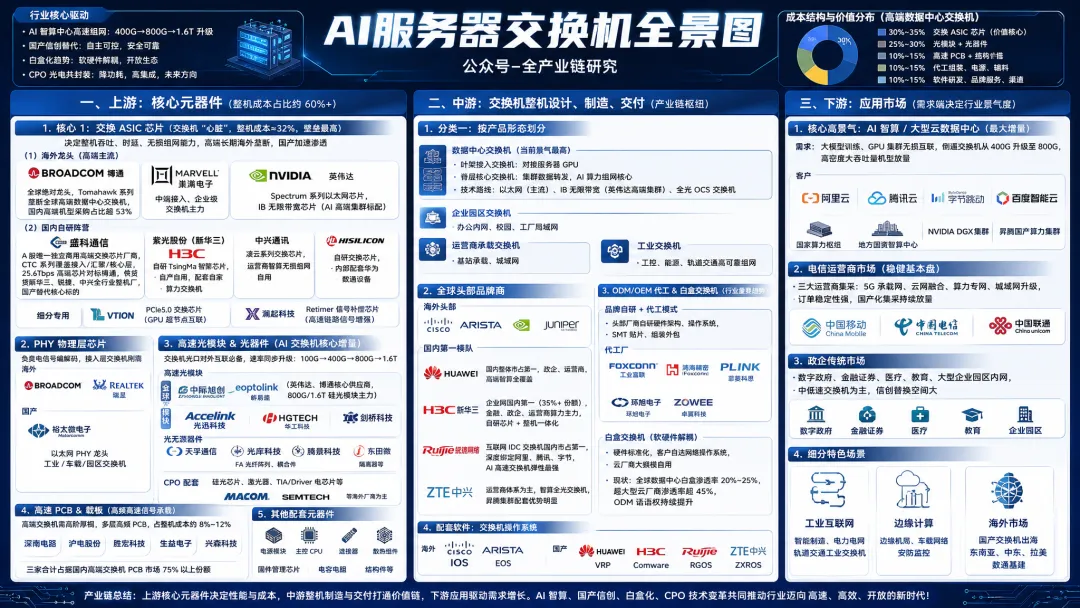
3.1 以太网交换机产业链拆解
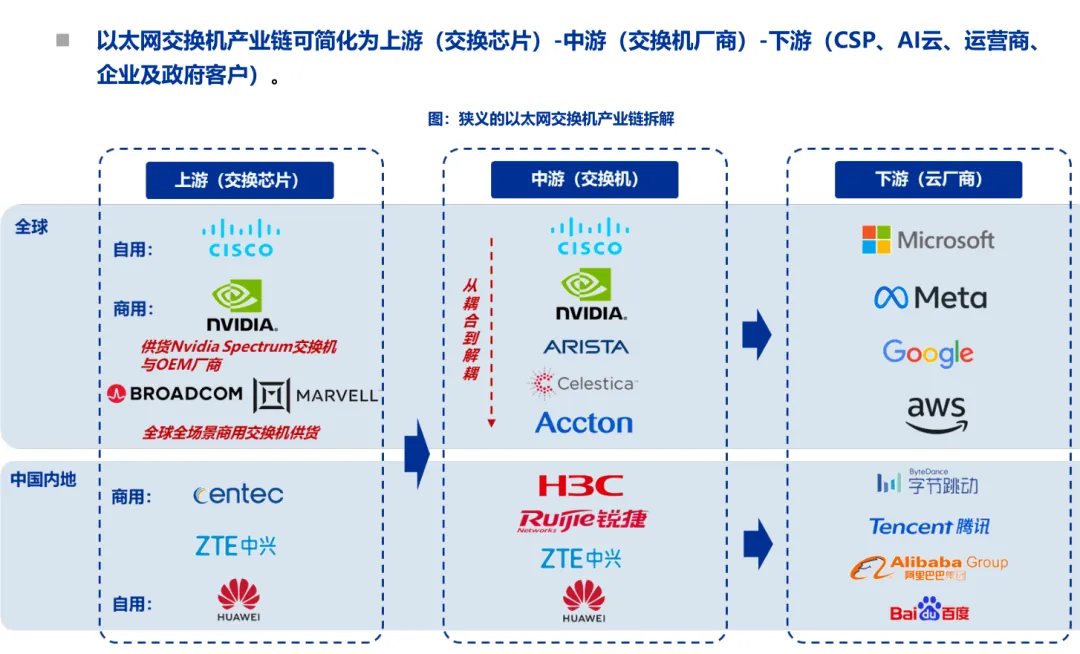
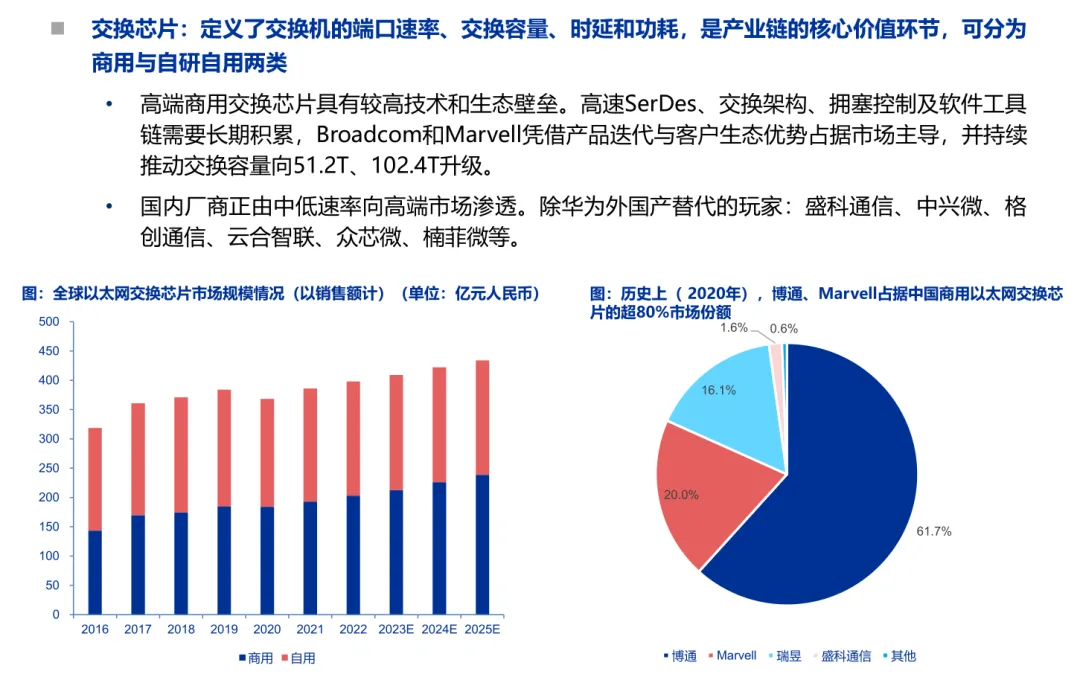
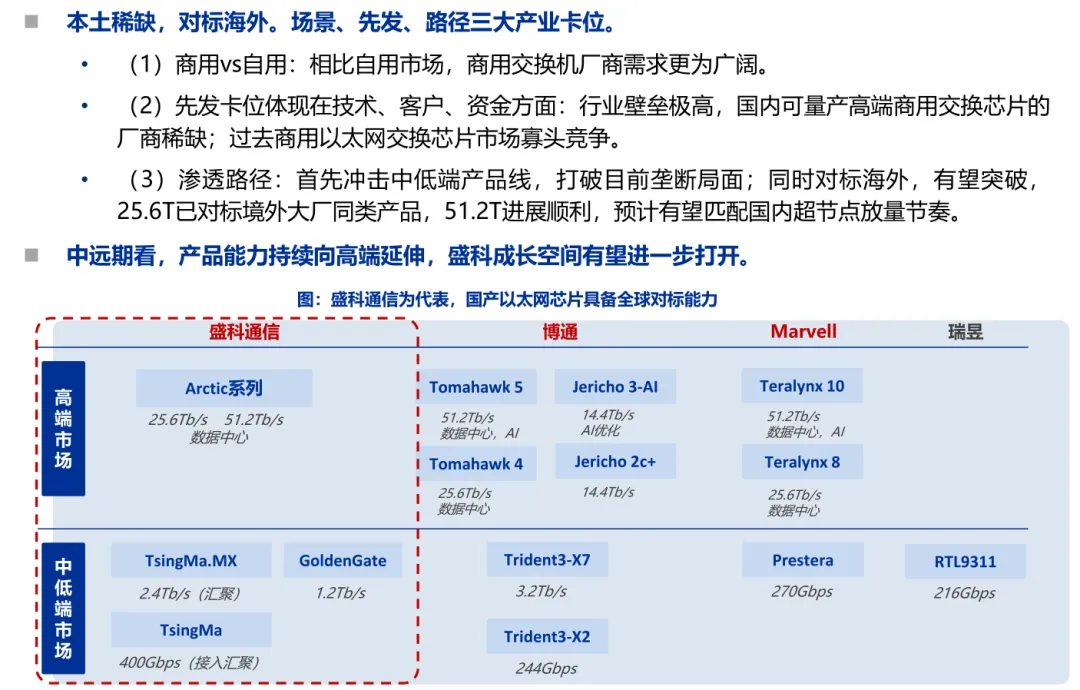
3.1 交换芯片:高端商用市场集中,国产替代向上突破
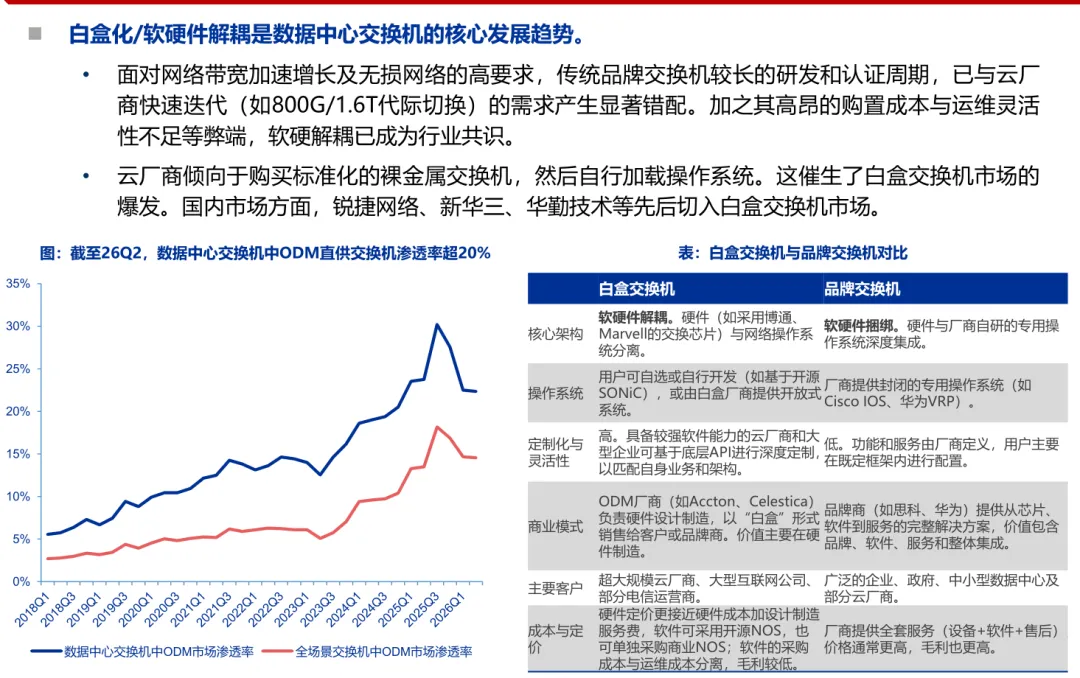
3.2 规模持续扩张,白盒趋势显著
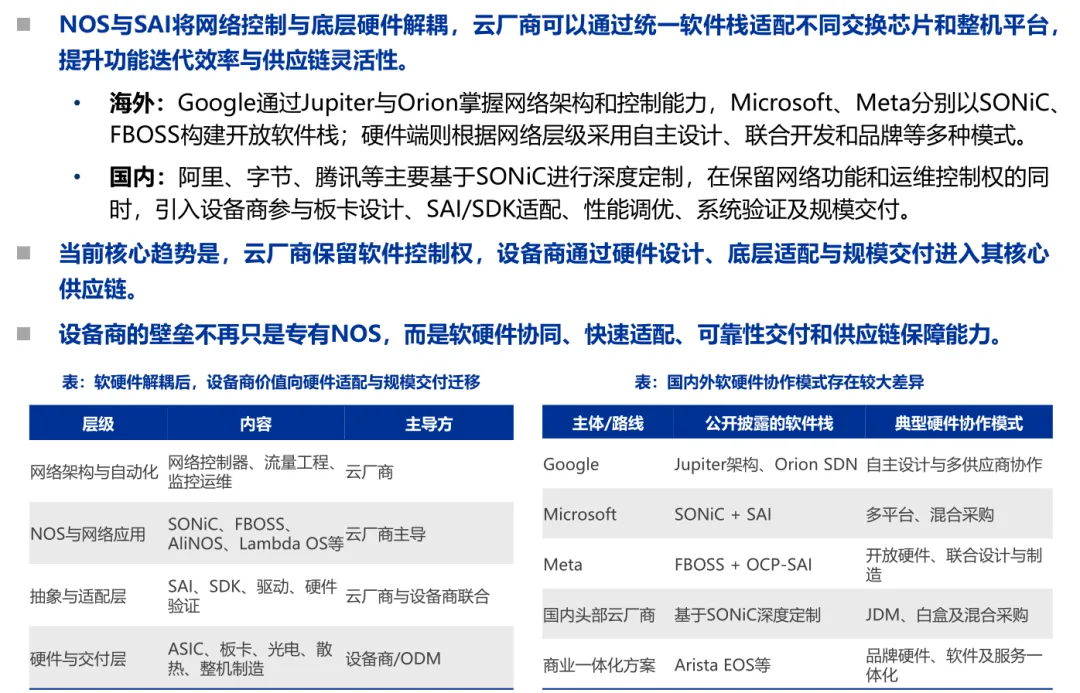
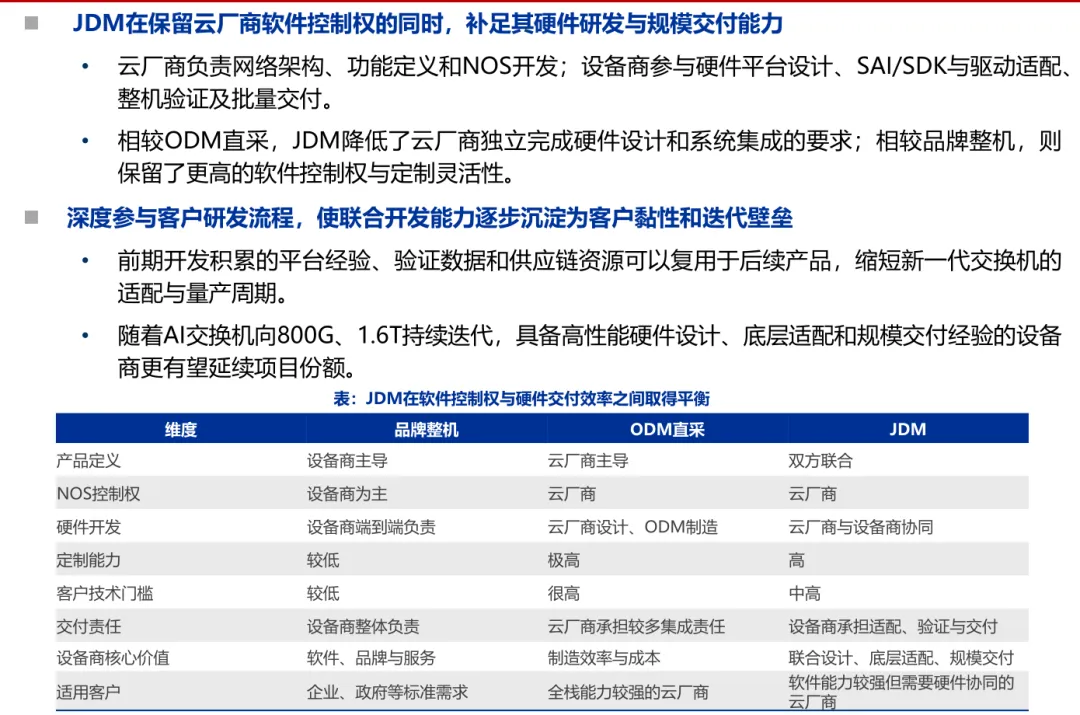
3.2 JDM深化软硬件协同,沉淀客户与交付壁垒
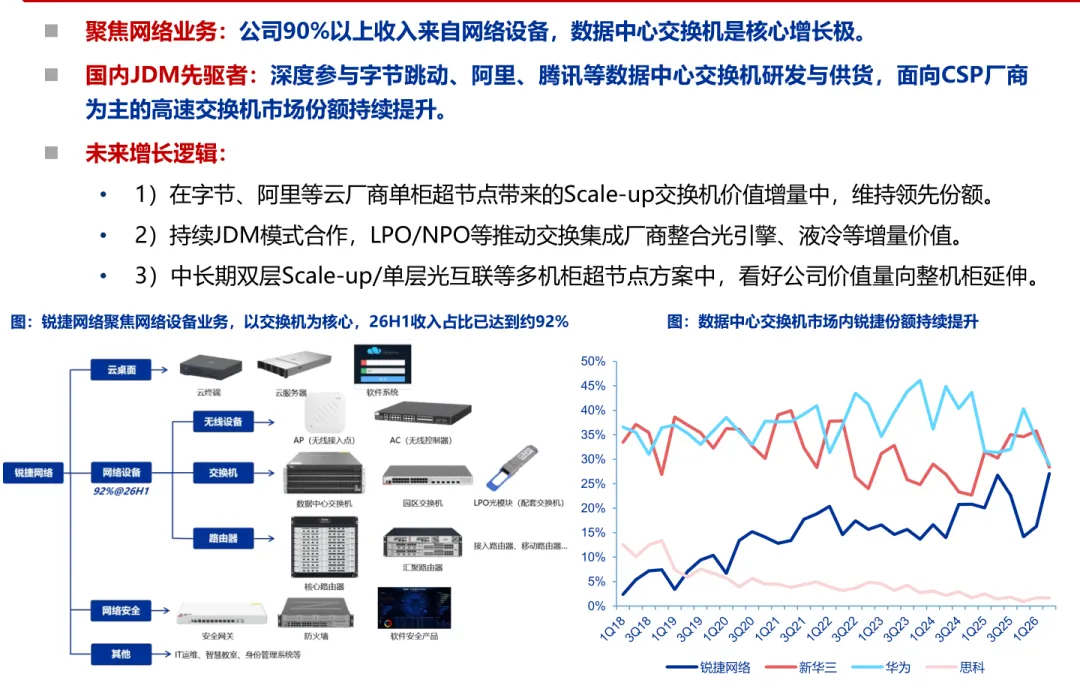
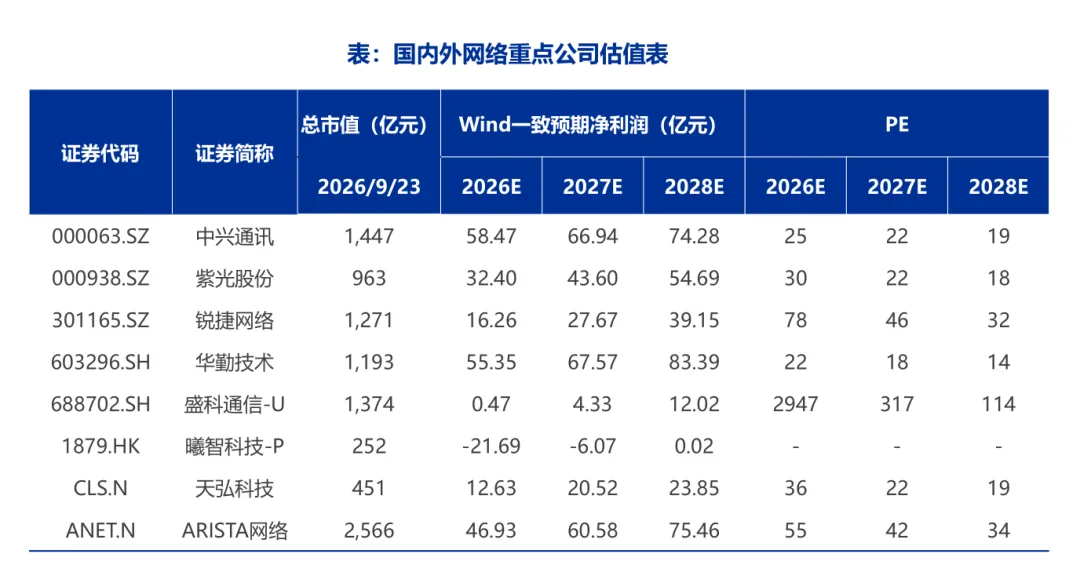
3.3 锐捷网络:JDM先发优势突出,卡位AI交换机增量
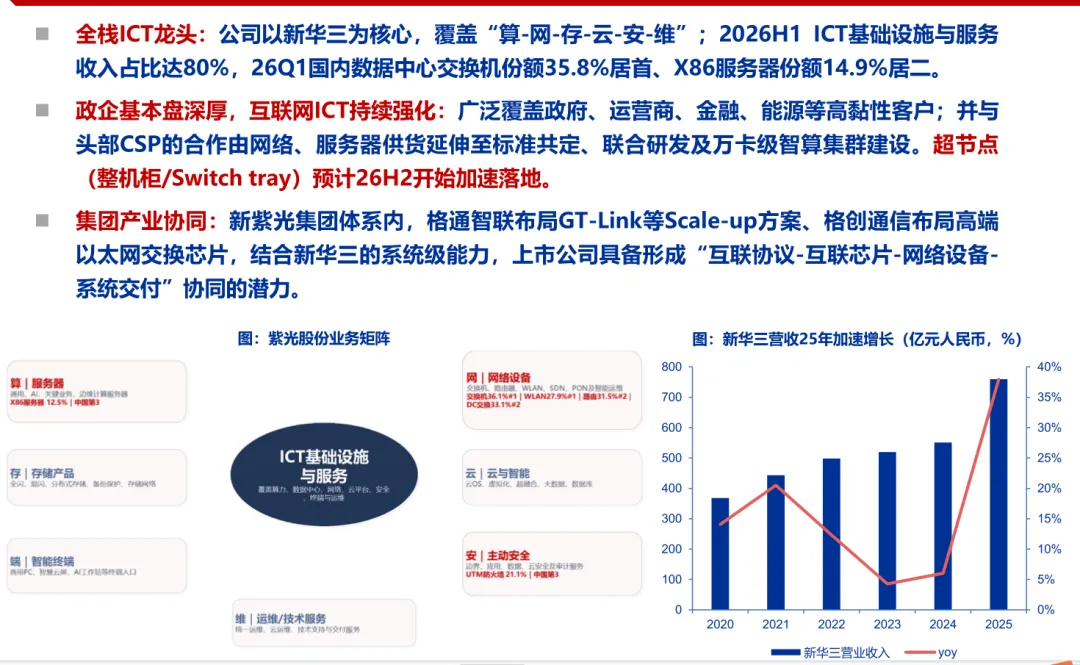
3.3 紫光股份:ICT领军,超节点放大系统交付价值
3.3 华勤技术:超节点与高速交换机双轮驱动
3.3 盛科通信:国产以太网交换芯片领军
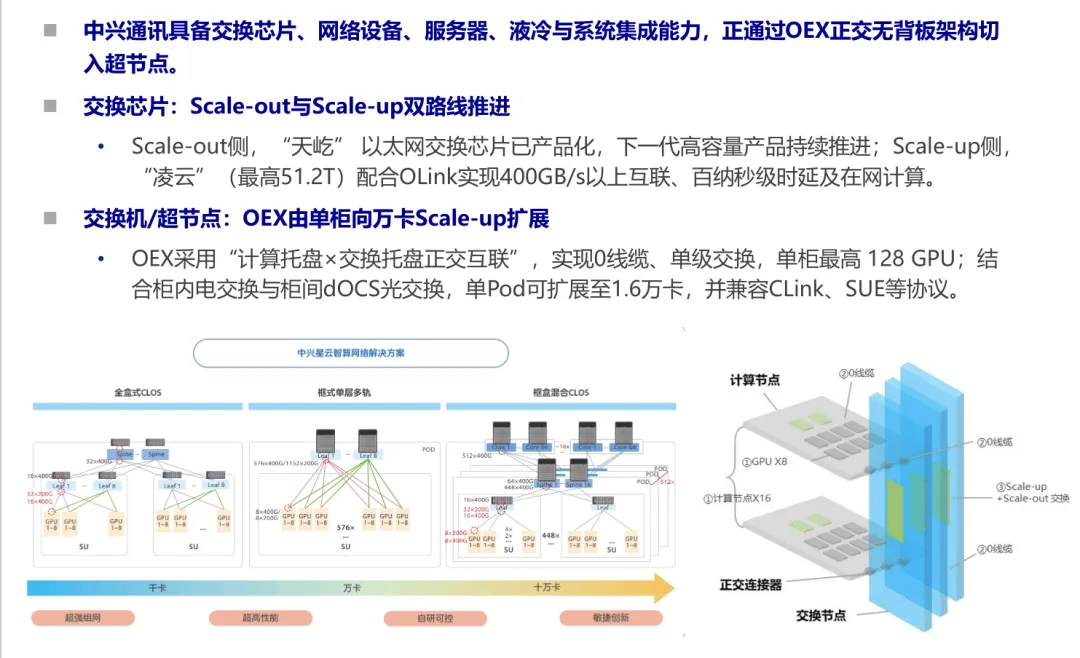
3.3 中兴通讯:自研芯片支撑算网一体化
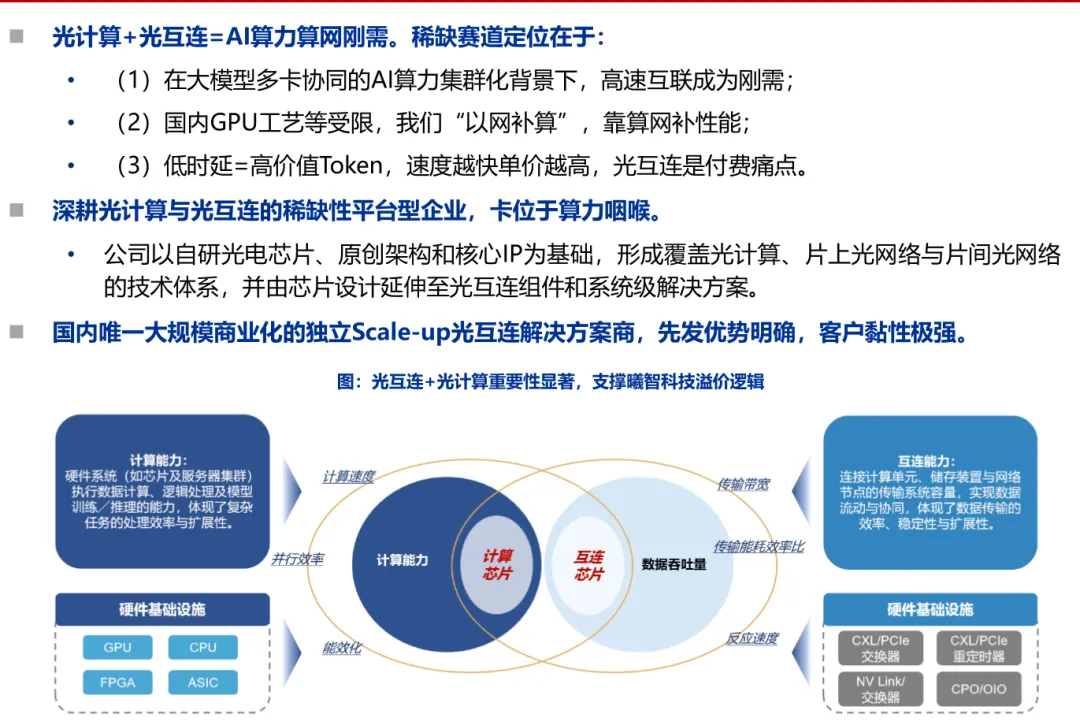
3.3 曦智科技:稀缺的光互连+光计算领军
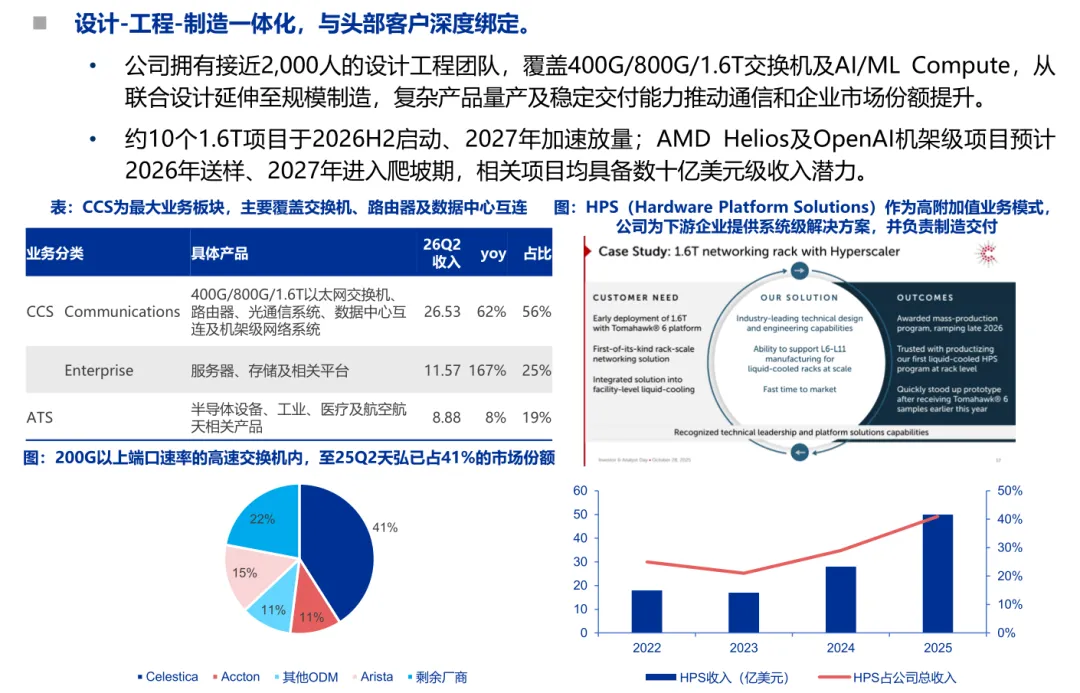
3.3 Celestica:海外ODM直供核心标的
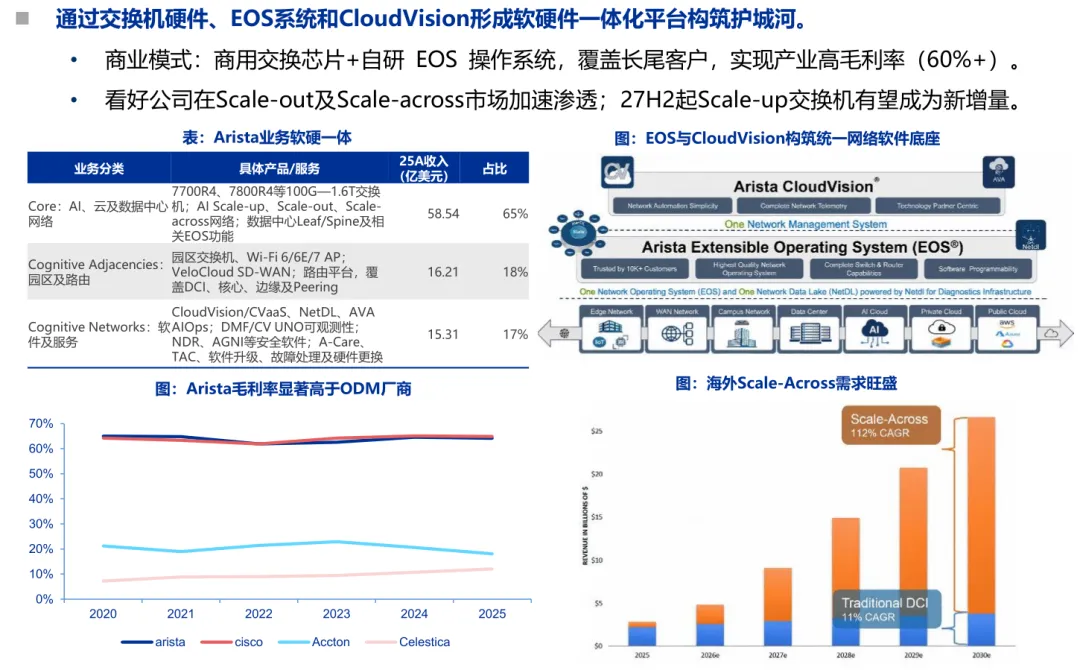
3.3 Arista:海外软硬件一体化交换机核心标的

发表评论
发表评论: