
 研报速递
COMPANY · 企业动态
ORPHIC BRANDOS · 2026
AI 交回的用户研究报告
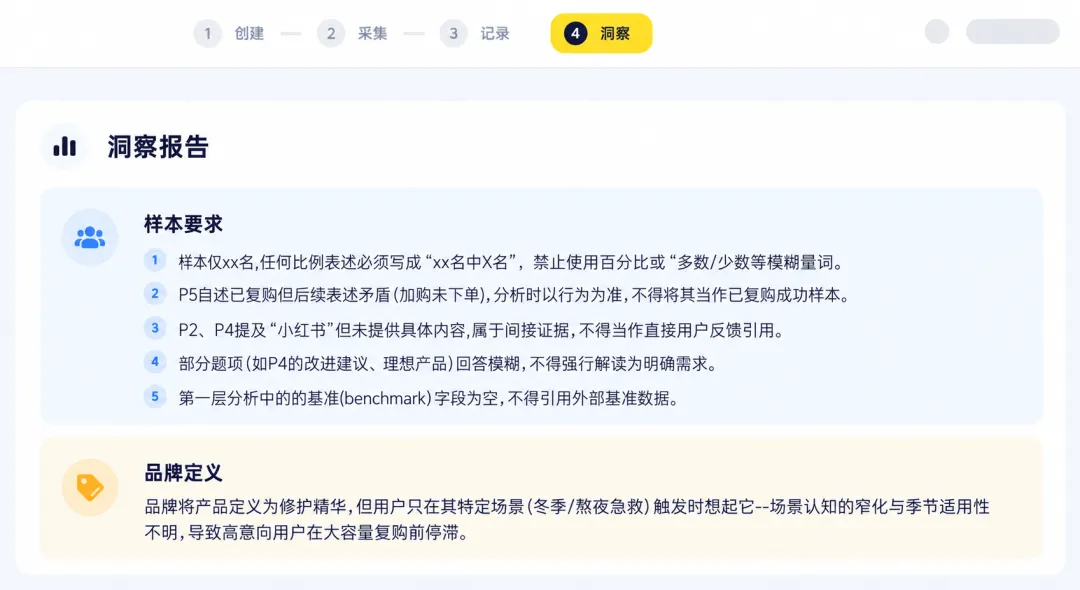
第一页是五条限制
一份用户研究做完,报告交回来,第一页不是结论。
是五条它为自己划的边界。
样本量未到统计门槛时,比例必须写成「几名中几名」,禁止使用百分比与「多数」「少数」
受访者自述与后续表述冲突时,以行为为准
公开平台内容属间接证据,不得直接引用
模糊回答不得强行解读为需求
外部基准缺失时,一个字都不许引用
看过一些用户研究报告的人,大概不常见这种开头。第一页先把自己能说什么、不能说什么,一条条写清楚。
01
REAL CHALLENGE
一道真实的复购难题
一家护肤品牌把一道真实的难题交给了Orphic 用户洞察。
他们的修护精华,三百元左右的价位,首购表现不差,三个月后的复购率却明显低于同价格带。内部猜了两件事,定价偏高,效果感知不足,两件都拿不出用户侧的证据。
品牌方把题目原样交给它,没给答案。这是一次完整的试运行,从题目到报告,中间没有人工补写。
一批受访者,都是过去一年买过这款产品的人。线上招募,一对一语音访谈,每场几分钟,跑的全是改完的第二版提纲。访谈在同一天下午连着跑完,全部加起来不到半小时,回收的回答近百个。最后一场结束到报告生成,二十来分钟。
02
PROTOCOL REVIEW
提纲被审了一遍
第一版访谈提纲交上来,就是这次要用的那份问卷,它先做了一轮审查。挑出来的问题不是句子太长这类文风毛病,是逻辑。
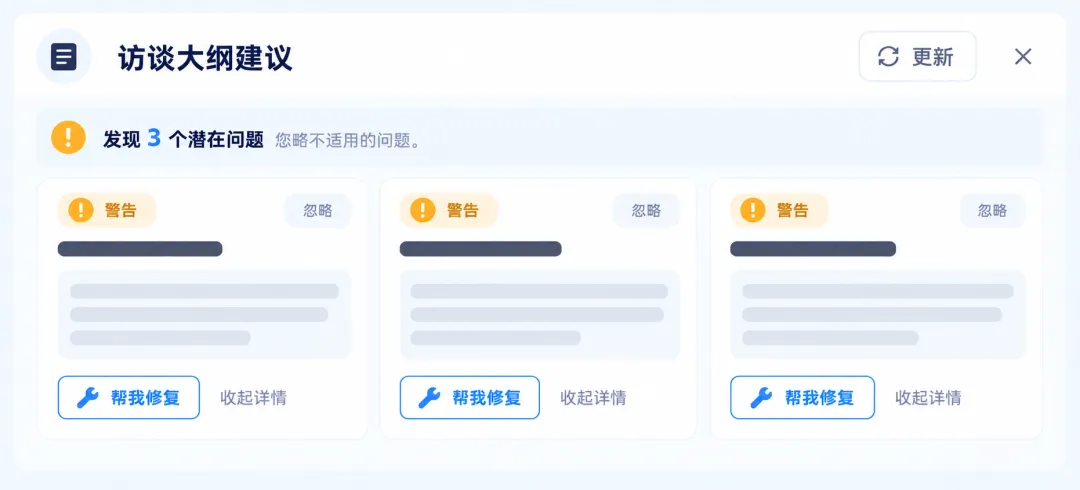
它给了三条,每条都带一句解释。
Q15 未筛选不复购人群。研究目标锁定的是不再复购的人,甄别环节却没确认受访者到底复没复购,万一她其实买过第二瓶,Q15 那句「你没再买第二瓶」就和事实冲突。
Q16 预设现在有使用修护产品。题目直接问「你现在用的修护产品是什么」,前面却没确认她是不是正在用别的修护产品。
Q12 预设连续使用一段时间。题目问「你后来是连续用了一段时间吧」,可甄别条件允许「买过但没用完」,她可能压根没连续用过。
三条都标着「警告」,每条旁边两个按钮,一个「忽略」,一个「帮我修复」。
03
ITERATION
十几轮对话,把提纲磨成了要用的样子
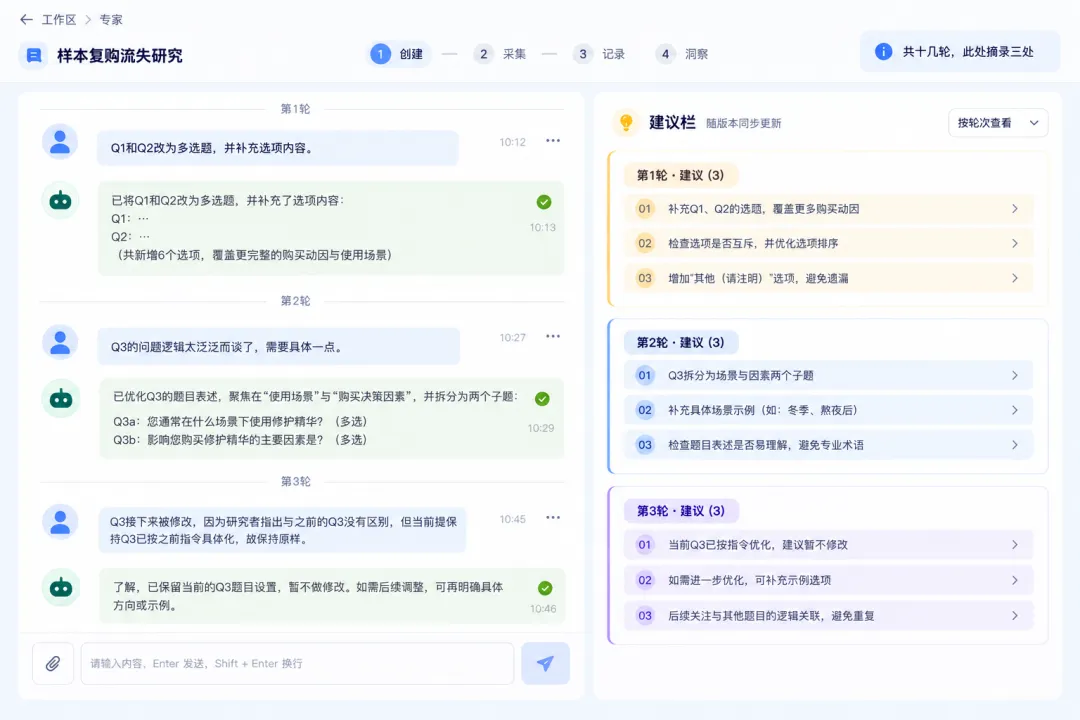
后面十几轮提纲,是品牌方和它在对话窗口里一条条磨出来的。左边提要求,中间改正文,右边看建议。
十几轮下来,改动最多的不是措辞,是三件事。
问法够不够中性。原本有一题写着「让你觉得需要买东西来急救一下」,改成了「让你觉得需要购买修护精华」。急救是品牌自己的判断,不是用户的说法。
题型和选项够不够完整。能展开的地方就展开,Q3 转成多选之后,选项也补齐了:修护皮肤屏障、缓解泛红敏感、保湿滋润、熬夜急救、淡化痘印。
甄别条件够不够准。原来只分「买过」和「没买过」,后来收紧成只有「是,买过且用完」才通过,同时新增两道题,专门用来筛出没复购的人。
每一轮改了什么、为什么改,都留在对话记录里。提纲从第一版走到第二版,十几轮下来,每一处改动都能翻回当时的对话。
这套流程的意义在于,提纲不是一次写定的文件。它可以被对话改,也可以被审查改,改完之后,一路的过程都留着。
04
FOLLOW-UP
把一句空话追成一段原话
真正拉开差距的是追问。
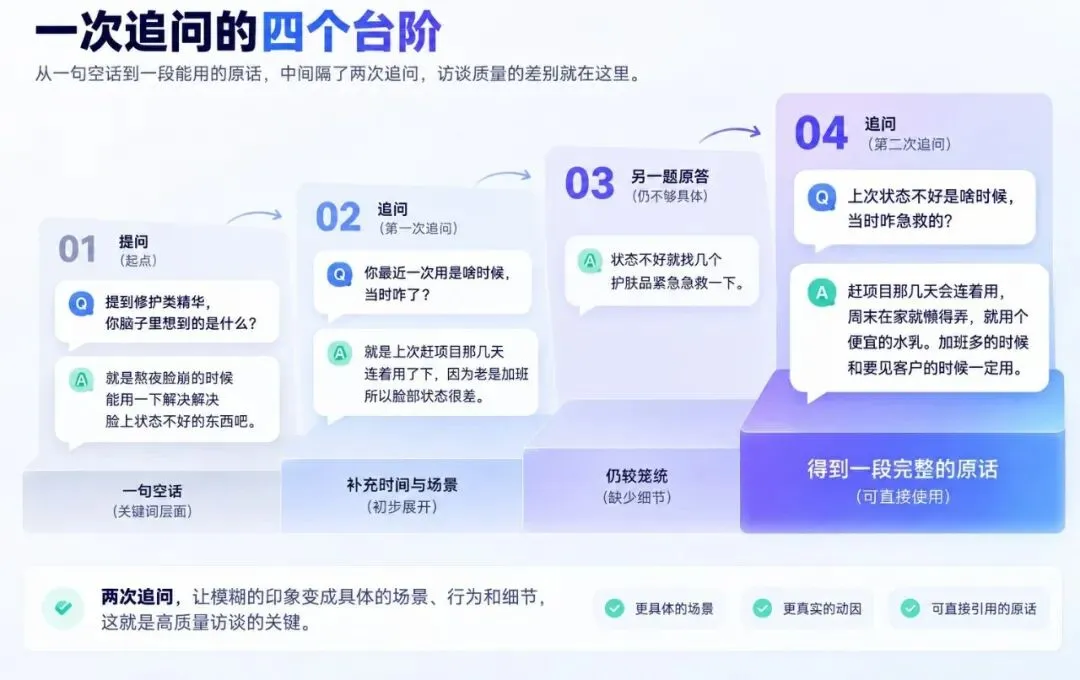
一位做互联网运营的受访者,被问到「提到修护类精华,你脑子里想到的是什么」。
就是熬夜脸崩的时候能用一下解决解决脸上状态不好的东西吧
— 受访者原话
这句话听着像回答,其实什么也没说,既没说什么时候用,也没说怎么用。如果访谈在这里翻页,记下来的就是一句「用户认为产品可以急救」。
它没有翻页,接着问:你最近一次用是啥时候,当时咋了。
就是上次赶项目那几天连着用了下,因为老是加班所以脸部状态很差
— 受访者原话
后面一题她答得更空:状态不好就找几个护肤品紧急急救一下。它又追:上次状态不好是啥时候,当时咋急救的。
这一次,她说出了整份记录里最有价值的一段话:
赶项目那几天会连着用,周末在家就懒得弄,就用个便宜的水乳。加班多的时候和要见客户的时候一定用。
— 受访者原话
从「状态不好就急救一下」,到「加班和见客户的时候一定用,周末在家懒得弄」,中间隔了两次追问。产品的真实位置,是在这两次追问之后才浮出来的。
05
DATA INTEGRITY
被标出来的受访者,一个都没有被剔掉
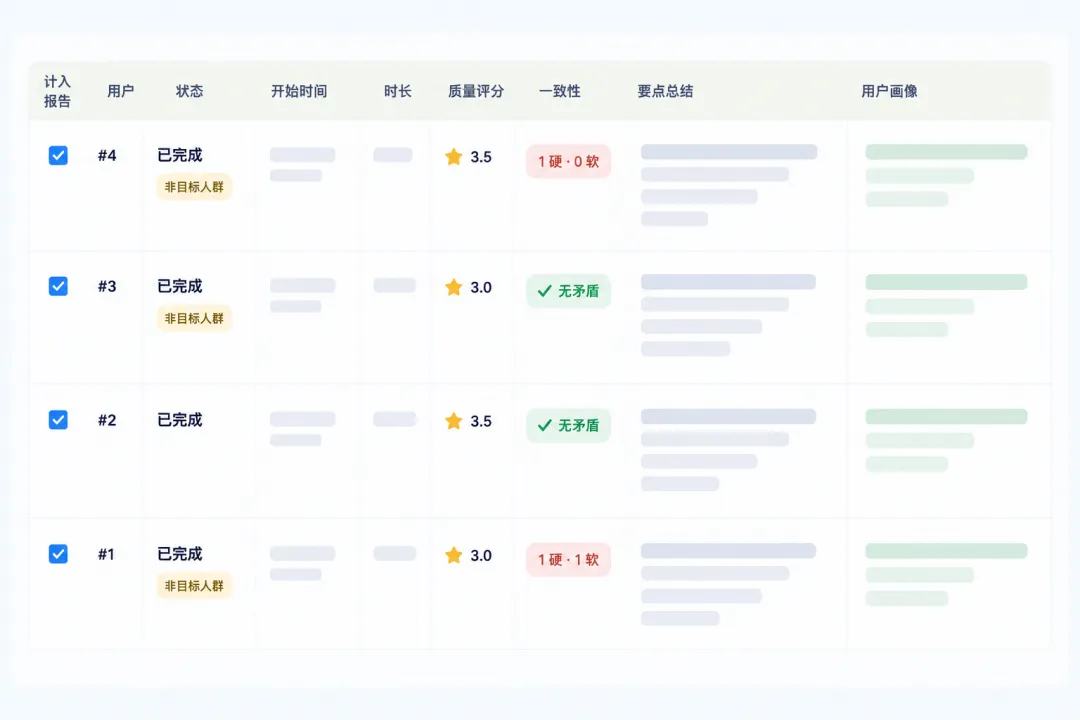
访谈开始前,先过了甄别题。有几位受访者甄别环节被标了不完全符合条件:有人对「是否买过并且用完」的回答是「买过但没用完」,还有人对「是否已经复购过第二瓶」的回答是「是」。
按常理,这些人该剔出去。它没有剔。它把人留着,把标注也留着,同时把结论的证据强度降了下来。
访谈一场没少,标注全部写进了报告。
06
FINDINGS
五条结论,和每条后面的那行小字
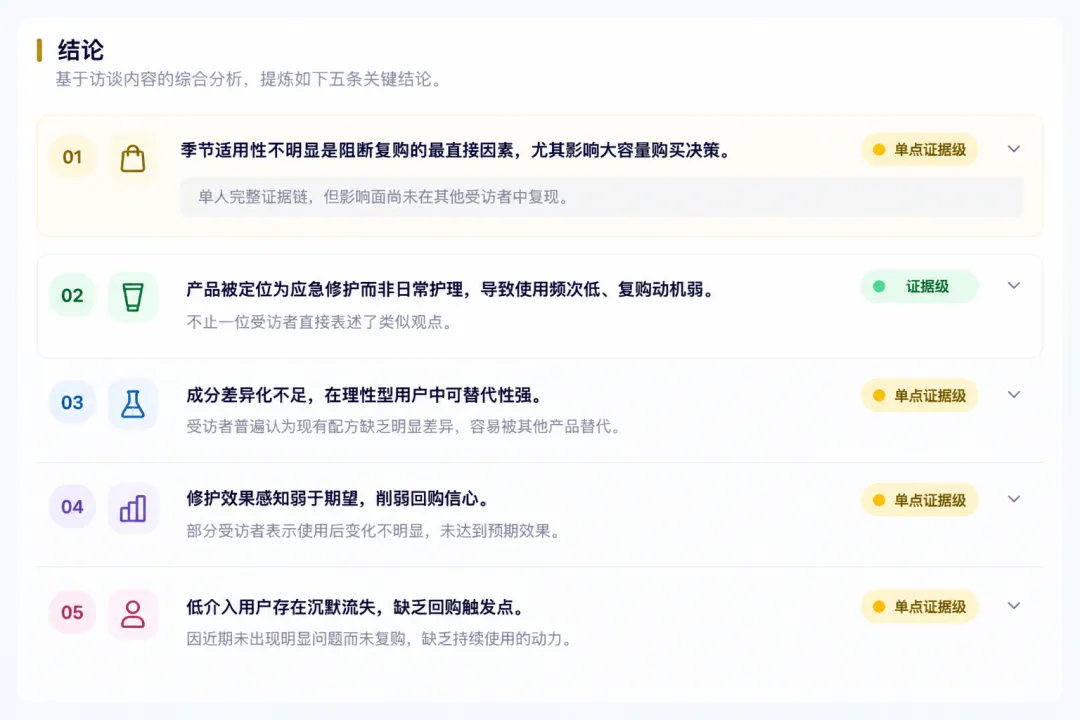
报告最后给出五条结论。每一条下面都跟着一行小字,标的是这条结论的证据强度。
理由是不止一位受访者直接说了类似的话。另外四条标「单点证据级」,理由写得很直白,其中一条是:单人完整证据链,但影响面尚未在其他受访者中复现。
结论本身比想象中具体。
一位受访者把两支装加进了购物车,放了两个月没下单:
如果确定一年四季能用,我就直接买两支装了。现在我不确定,那买两支就是浪费。
— 受访者原话
她的阻碍不是价格,是一个详情页没有回答的问题。品牌讲了整个冬天的干敏场景,从没说过夏天怎么办。
另一位受访者,油痘肌,早晚各一次,一次两到三滴。她能完整复述产品的配方组合,却从来没接收过主打的场景叙事:
我不看品牌自己写的东西,只看成分表和第三方测评。
— 受访者原话
她放弃复购的理由是配方重叠,手上还有一支同功效的产品。品牌引以为傲的成分组合,在她的表格里并不是唯一选择。
还有一位只在状态差的时候才用。用她的话说,
它不是那种用完了得补的,是那种状态不好的时候才想起来的。
— 受访者原话
她的瓶子还没用完,客观上还没到该复购的时间点,而这种沉默此前被品牌方读成了流失。
07
RISKS
报告的另一半
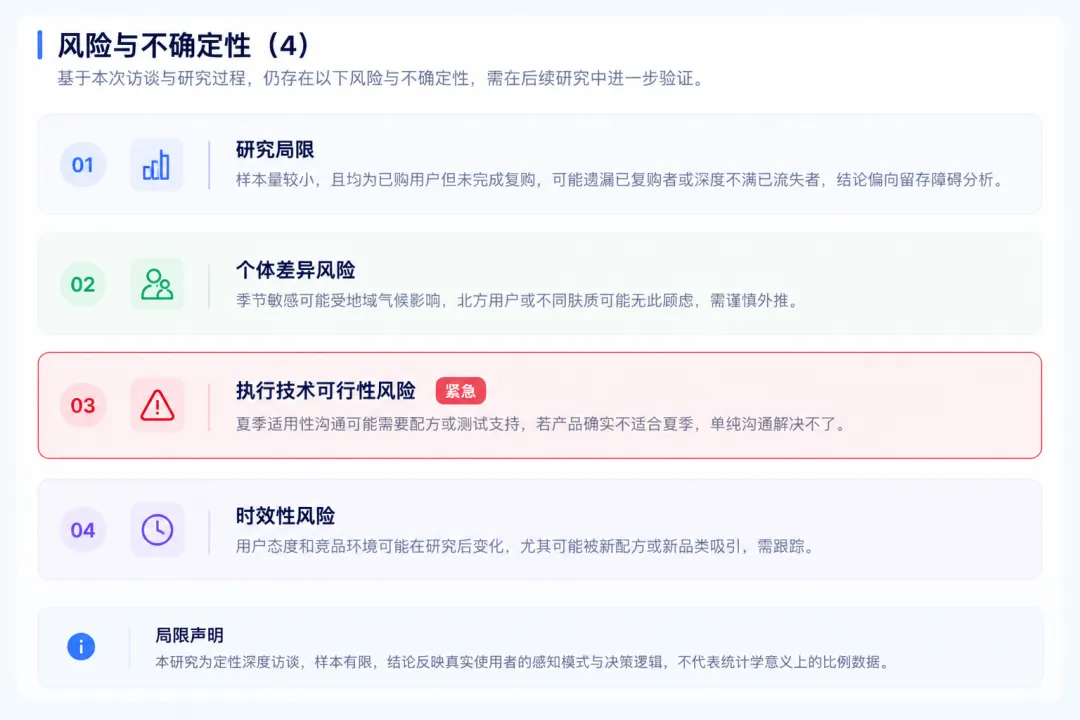
除了五条结论,报告里还有四条风险与不确定性,和结尾一句话的局限声明:样本有限,结论反映真实使用者的感知模式与决策逻辑,不代表统计学意义上的比例数据。
四条风险里有一条被标成「紧急」:建议的夏季适用性沟通可能需要配方或测试支持,如果产品确实不适合夏季,单纯沟通解决不了问题。
它给出四条行动建议之后,主动提醒,排在最前面那条可能根本执行不了。
很难说有多少同类产品愿意这么写。但用户研究最稀缺的东西恰恰在这里。
08
BOUNDARIES
样本的边界,是它自己先说的
这件事报告自己也写了。
它主动标注了样本量的限制,也标注了每一条结论的证据强度。这份克制不是品牌方要求它做的。
我们做 Orphic 用户洞察的出发点很简单,让用户研究快一点。现在觉得,比快更难的,是在快的时候还愿意承认自己哪里不确信。
这份报告交回来的时候,带的不只是五条结论。第一页的五条限制、提纲的十几轮修改、每一次追问的原始记录、每条结论后面的证据强度、四条风险与不确定性,全都一并交了出来。这些东西加起来,才是它能被拿进会议室的原因。
EXPLORE WHAT'S NEXT
让用户研究快一点,也诚实一点
从题目到报告,中间没有人工补写。每一次追问、每条证据强度、每个风险标注,都一并交出。
MetaNovas
AI Infrastructure for Consumer Product Innovation

发表评论
发表评论: