
 研报速递
关注下方“公众号”,获取更多开源资讯
导读
证监会《证券期货业科技发展"十四五"规划》把数字化转型列为行业基础设施建设的核心方向;国家数据局等 17 部门《数据要素×三年行动计划(2024—2026 年)》将"金融服务"列为数据要素重点应用场景,推动金融数据资产化。
对券商来说,最现成的数据要素不是交易流水,而是存量知识材料——尽调报告、私募产品资料、管理人档案、研报等等。这些材料规模以 TB 计,但归档之后大多处于"沉睡"状态。
但是材料找得到,不等于结论信得过。
券商的尽调材料,为什么做完一次就"沉睡"了?
答案:因为材料入库时未经治理——归档的是文档,不是结论。
券商知识管理有三个长期存在的痛点:
尽调成果难复用。对同一家私募基金管理人的尽调,团队 A 做过一遍,报告写了几十页,归档进系统。半年后团队 B 接手同一主体的新业务,往往要从头再来一遍——既有的尽调结论躺在库里,无法被结构化继承。人力重复投入,进度重复等待。
指标口径没有并存机制。同一指标在不同材料里取值不一致——比如某资产的管理规模,尽调报告写一个数,产品推介材料写另一个数。传统系统不会提示分歧,查询时只会给出其中一个取值。业务人员如果没发现,这个冲突值就直接进入了工作结论。
跨文档问题没有结构支撑。"某位投资经理关联哪几家管理人"——这类问题没有自然语言答案,因为它需要的不是检索某一段文字,而是把散落在多份材料中的对象关系串起来。
共同成因一句话:材料未经治理即进入索引。向量化解决了"材料找得到",解决不了"结论信得过"。
材料都进了知识库,为什么有些问题还是答不了?
答案:因为通用检索问答在设计上不覆盖这类问题。
行业里很多券商已经部署了知识库问答系统,检索材料的能力已经普及。但有三类高频问题,纯"检索 + 大模型生成"的方案在方法上就答不好:
计数与聚合类。"待审核文档共有多少篇?"检索召回的片段里没有这个数,模型只能推断——同一个问题换种问法,答案就变了。没有结构化数据支撑,计数类问题无从谈起。
跨文档关系类。"某投资经理关联哪几家管理人?"检索能召回零散片段,但完整性无法保证,也无法枚举——漏掉哪一家,系统不知道,问的人也不知道。
口径冲突类。"甲资产的管理规模是多少?"两份材料两个取值,系统择一输出,不提示分歧存在。这在尽调和研报场景里是合规风险,不是体验问题。
还有第四类,更根本:**"这个字段抽自哪一句、由何人确认?"** 这个问题不属于检索问答的问题域——但在尽调场景中,取值的可信度与确认记录本身就是业务要求的组成部分。
所以结论是:通行方案提升的是"召回质量",而券商场景需要的是"结论可信"。两者的差距,不在模型,在知识治理。
三条技术路线,差别到底在哪?
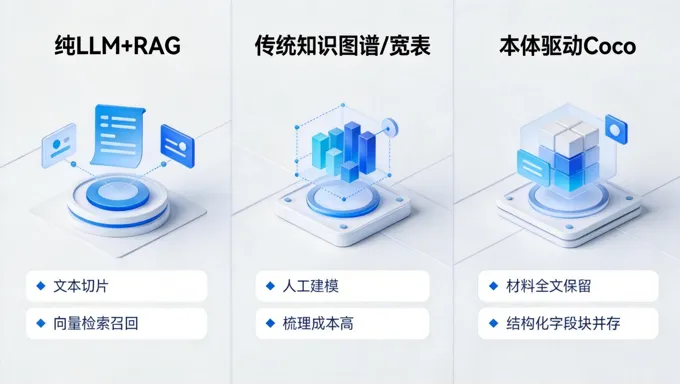
答案:差别不在模型,在于治理发生在哪一侧、材料以什么形态入库。
再看与主流厂商的方案定位,主要公开能力集中在"知识库检索问答 + 金融大模型 + 智能体平台",治理重心在检索侧;对"指标口径冲突的显式提示与双出处保留""结构化结论的句级出处回查""字段级行级权限与追加写审计链",公开信息中未见系统性描述——而这三点正是券商尽调、研报、投行底稿场景的合规硬约束。
这里要说明 Coco 的定位:解决"机构的材料怎么变成可审计的知识资产"。
路线层面的分野说清楚了。下面落进一个具体场景:一只私募产品的准入尽调。前面提到的每一类痛点,都会在这个场景里出现;Coco 的每一个做法,都会挂在场景的具体材料上。
场景:一只私募产品的准入尽调,从一包材料开始
券商财富管理条线引入一只新私募产品。按准入流程,产品部、风控、合规三个条线要对管理人做尽调。管理人发来的材料包:
路演 PPT,80 页——管理规模、投资策略、投研团队、历史业绩 尽调问卷 Word,23 页——按券商模板逐项填写 电话访谈录音,2 小时——投资总监口述 视频会议记录,1 段——投研团队答辩 产品净值月报,36 期
三个条线要从这包材料里回答同一组问题:这家管理人靠不靠谱、规模多大、团队稳不稳、业绩经不经得起复核。问题就出在这里。
第一个坎:两年前尽调过一次,这次为什么还要从头来?
两年前,这家管理人发行过另一只产品,当时做了完整尽调,报告两百多页,已经归档。
这次准入新产品,负责团队换了人。旧报告躺在系统里,结论没有字段化、没有结构化——要复用,只能把两百页报告从头再读一遍。多数团队的实际选择是:重新尽调一遍。
同一家管理人,两遍尽调,人力重复投入,准入周期重新拉长。材料归档了,结论没有沉淀。这是第一个坎。
第二个坎:管理规模三个数,到底哪个准?
材料包里的管理规模,出现三个版本:
路演 PPT 写 50 亿 基金业协会公示数据是 45 亿 从净值月报反推,在 47 亿左右
传统的检索问答系统面对这个问题,会给出其中一个取值,不提示另外两个的存在。50 亿和 45 亿之间 5 亿的差异被静默抹平——而这个数字,直接影响产品准入的评级、额度和风控结论。
第三个坎:这位投资经理,关联过哪几家管理人?
尽调必查项:核心投资经理的职业历史。他以前在哪些管理人任职、任职期间业绩如何、有没有过合规处罚。
这些信息散在材料包的角落里:简历在 PPT 的某一页,任职经历在问卷的一个问题里,一段处罚记录藏在录音访谈的一句话里。要拼出完整画像,需要跨文档关联——而"跨文档关系查询"恰恰是通用检索问答在方法上做不到的:召回的是零散片段,完整性无法保证,漏掉哪一家,问的人不知道。
Coco 在这一单尽调里,具体做什么
沿尽调流程走一遍:
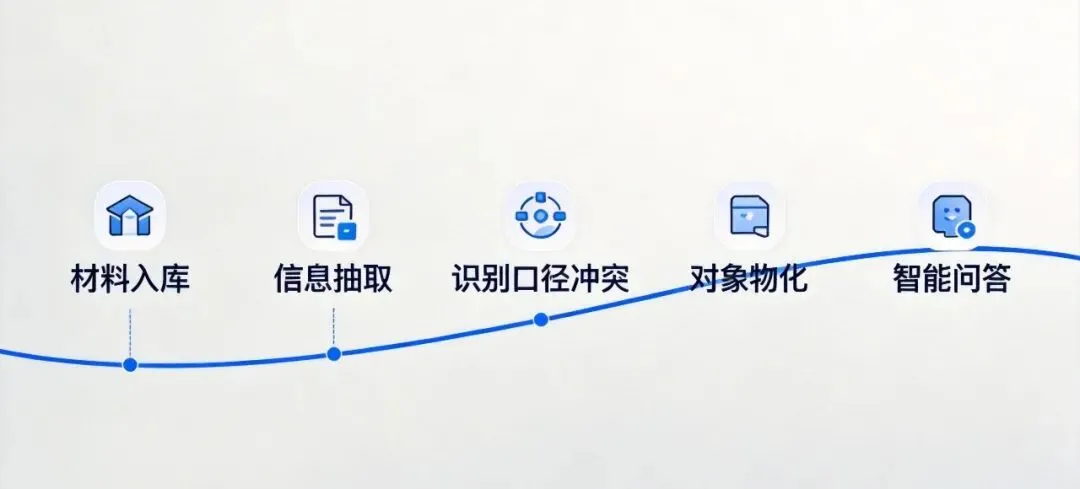
入库。材料包里的 PPT、Word、录音、视频全部解析成可抽取的文本,进入写入侧治理链路:解析 → 抽取 → 例外路由 → 审批入库 → 对象物化 → 建立索引。材料全文保留,与结构化字段块同库关联——原文永远可回查。
抽取。按本体定义抽取字段:管理规模、成立时间、策略类型、核心人员、产品业绩。每个字段值附句级出处与置信度。高置信且有原文依据的自动放行;只有三类例外转人工:多源冲突、原文依据缺失、关键字段置信不足。
口径冲突。管理规模的三个取值先做量纲归一,再按阈值判定冲突——构成冲突时,三个取值连同各自出处一起呈现,转入人工复核队列。分歧不被掩盖,出处双方保留。人工审定必须保留:这是可信度的必要成本,系统做的是把人工工作量压缩到只审例外、只审冲突、只审关键字段。
对象物化。管理人、产品、投资经理被物化为对象,跨文档合并去重。投资经理对象关联到他历史上任职的每一家管理人——"关联过哪几家"从散落信息变成可枚举、可统计的关系网络,逐条附出处。
问答。业务人员直接问:"张某关联过哪几家管理人?""这家管理人的规模三个口径差多少?"答案来自结构化对象网络,每条结论都能回查到原文哪一句、由何人确认。
Agent 落地。抽取、候选发现、多跳取证、横向对比由智能体执行;业务人员在审定提案箱里逐条裁定,驳回记录原因,全程留痕。智能体嵌在写入侧治理链路里,是持续运行的执行层,不是演示。
风控和合规,凭什么敢用?
内网部署。文档存储、解析抽取、对象库、检索索引、私有大模型与智能体层,全部在券商内网,无公网传输链路。材料不出机构。
行级权限。取数层行级过滤——越权文档在进入证据集合之前就被排除,智能体与大模型全程接触不到这部分数据。提示词约束是软约束,数据层过滤是硬约束,异常可定位到具体规则。
审计链。追加写审计链 + 哈希防篡改;每次问答记录命中的证据与生效范围。风控复核时,每个结论都能回查依据。
写在最后
从行业全景回到这一单尽调:一只私募产品,两年前做一遍、今天做一遍——结论能不能沉淀下来直接复用;管理规模三个口径,是静默择一,还是显式呈现。这两个细节,就是券商知识管理"可检索"与"可审计"的分界线。
三条路径的决策本质:纯向量库解决"可检索",宽表/图谱解决"可查询",本体驱动解决"可生长"。材料越攒越多是趋势,尽调不会少做——差别在于:结论靠人翻,还是靠资产复用。
中奥 Coco Agent支持合作伙伴私有化部署,支持二次开发构建行业场景专用智能体。如果您有技术交流或合作意向,欢迎添加小助手联系我们~
© THE END
转载请联系本公众号获得授权
 分享、点赞与在看,至少帮我拥有一个~

发表评论
发表评论: