研报速递
判断一家实验室是不是在造会加速自己的机器,最直接的办法是看它愿不愿意把账本摊开。11 月 18 日,OpenAI 摊开了第二本。
这份题为《Research acceleration: The jagged frontier》的报告,是 9 月首份研究加速报告的续篇,全部数据来自 OpenAI 内部测量,自家研究员每天在编码 agent 上花多少钱、agent 独立完成研究任务的成功率涨到多少、重大研究想法还是不是人想出来的。报告的定位也很直白,OpenAI 在 9 月那篇里主张所有 AI 实验室都应该被要求公开追踪递归自改进(recursive self-improvement,指 AI 加速开发未来 AI 系统的过程)的指标,这一篇就是它按自己主张交的作业。
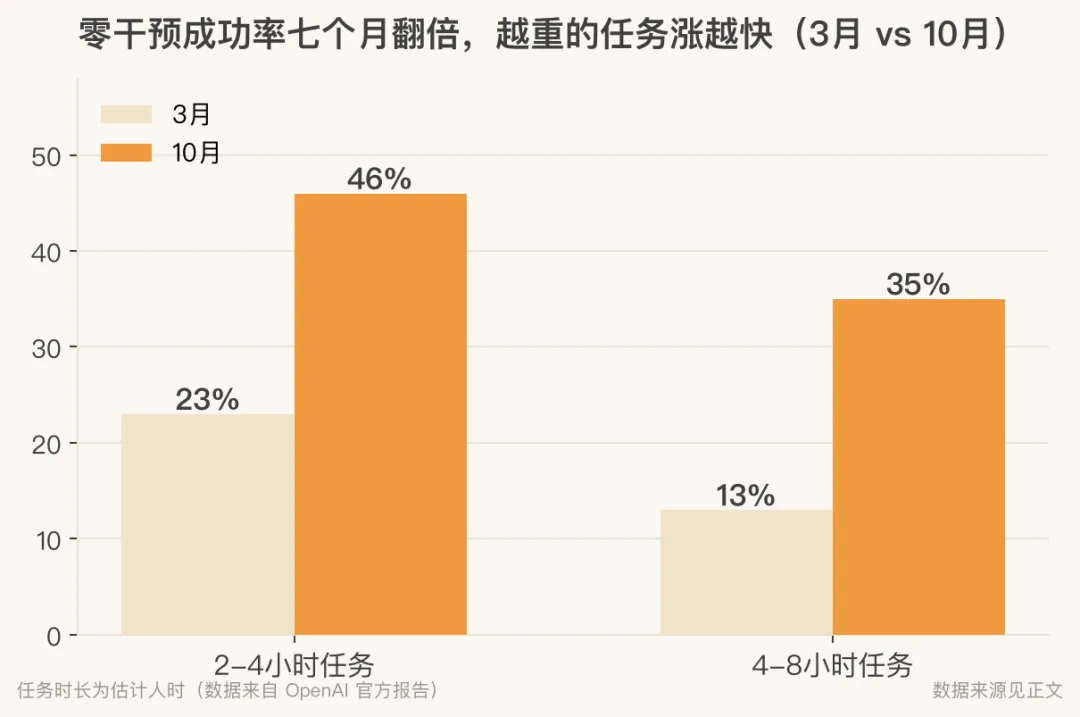
最抓人的数字是这组,3 月到 10 月,估计需要人类干两到四小时的研究任务,agent 无人工干预独立完成的比例从 23% 涨到 46%;四到八小时的任务从 13% 涨到 35%。一半以内,而且是最重的活涨得最快。
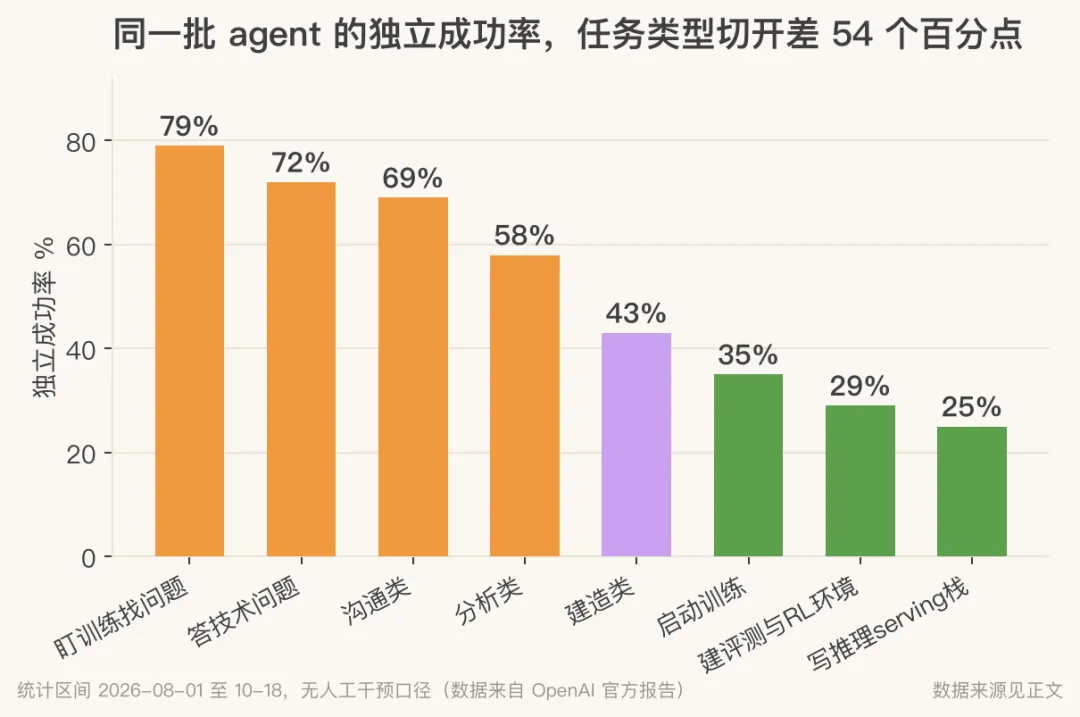
但这份报告真正值钱的地方,是它没把这组数字当胜利宣布。标题里的「参差」(jagged)二字才是全文题眼,同一批 agent,盯着训练运行找问题成功率高到 79%,动手写推理和 serving 代码只剩 25%。一份数据册读完,它讲的其实是同一件事的两面,AI 正在成为研究的主力劳动力,同时人类仍然是这套流程里绕不开的环节。
一、账本先行,一家实验室给自己测体温
先把坐标系立住。衡量「AI 加速 AI 研发」这件事,此前业界的通行做法是外部测评,METR 的时长跨度测量、Epoch AI 的能力指数都属此类,测的是模型在标准化任务上的表现。这类测量有个先天缺口,模型考分再高,也不等于真的在实验室里干活。OpenAI 这份报告补的正是缺口的后半段,不看考卷看工位。
报告的结构按 AI 研究的生产函数切成三段,投入(inputs)、过程(process)、产出(outputs)。投入段盯着编码 agent 的使用强度,过程段盯着任务委派与成功率,产出段盯着实验数量和能力指数。这个框架本身就是一种表态,研究加速不是一个感觉,是一组可以逐月登记的账目。
同类动作正在变成行业惯例。报告脚注里点了一排同行,Anthropic 已经独立发布了三份同类报告,记录内部模型部署如何加速自己的研究流程;Google DeepMind 在 Gemini 4 Argon 安全报告第 3.4.2 节里,实证概述了内部 AI 编写代码份额的增长;METR 与 Anthropic 合作发布了一份加速报告,估计内部 Claude 模型加速能力前沿的程度。四家头部实验室加上一个测量机构,都在往同一个方向登记数字。
口径先交代清楚。这份报告里的每一笔数字都是 OpenAI 自己的内部估计,没有外部审计。费用按 API 牌价折算,不是实际账单;成功率指任务在无人工干预记录的情况下完成;「小时数」是估计该项任务需要多少人时。带着这个前提读数字,结论更稳。
二、投入,一个研究员一天用掉 2400 美元
投入段的第一组数字是钱。10 月,按 API 牌价计,研究员中位数每人每天在 agentic AI 工具上消耗约 2400 美元,比 9 月的 1500 美元涨了 62%;第 90 百分位的研究员每天约 23000 美元,比 9 月的 11000 美元涨了 105%。一个月内翻倍的增速出现在用得最重的那批人身上,头部用户和中位用户的差距在拉大,不是缩小。
时间口径的数字更直观。OpenAI 把 agent 每运行八小时记作一个「agent 工作日」,按这个口径,研究员人均每天消耗的 agent 工作日从 0.5 涨到 5.7,涨了十一倍。预训练和后训练团队最凶,人均每天约 8 个 agent 工作日,意思是 agent 干活的时长已经是每名研究员日历时间的八倍;scaling 和基础设施团队约 4 个。报告自己补了限定,这个口径一般只计交互式使用,自动化任务没算进去,真实数字可能更高。
并发数也在爬。到 10 月中旬,超过三分之二的被统计研究员的每日峰值是至少 4 个 agent 并行干活,超过 10% 的人峰值至少 16 个。一个人的工位,旁边站着的是一个流水线。
钱和时间对照着看更有意思。9 月,研究组织里 agentic AI 使用的 API 等价价值,大约是研究员非股权薪酬的两倍,预训练和后训练团队的比例更高。要知道 OpenAI 研究员的目标薪酬里股权通常占七到八成,这个「两倍」是在剔除了大头之后算出来的。不过另一面也要看到,内部部署合计(内部 Codex、ChatGPT 和 API 用量)只占研究总算力的 2%。算力的大头仍然在训练上,agent 消耗的是 token,不是 GPU 时段。
这些数字背后还有一个容易漏掉的注脚。8 月 21 日 OpenAI 内部部署过一个临时的 harness 效率改进,输入 token 利用骤降,账面支出被严重压低;9 月 10 日起这个改动因与支出无关的原因逐步回退,token 支出迅速回升。也就是说 8 月账上有一个技术性的坑,9 到 10 月的暴涨里有一部分是在填坑。另外,OpenAI 研究员目前没有任何 agentic coding 配额限制,用多少都不设上限。
研究员自己怎么估价这批工具。8 月底到 9 月初,OpenAI 对 101 名研究员工做了调研,题目是个假设,假如未来三个月团队被收回所有强于 GPT-5.2 的编码 agent,愿意付出什么换回来。中位数答案,40% 的团队编制,或者换一道题,30% 的团队算力;若把问题设定在 2027 年 1 月,算力口径涨到 50%。还有一个更狠的数字,如果不许用编码 agent(只留 GitHub Copilot 和 ChatGPT),中位数研究员估计团队要三个月才能完成与上月同等价值的工作。
调研的局限 OpenAI 自己也写了,自我报告可能失真,抽样方式是临时的。101 人的样本对一家研究组织来说不算大,假设性问题的答案也不等于真实决策。但方向和用量数据互相咬合,钱花到每天 2400 美元的人,不会觉得这工具只值三成算力。
三、参差,79% 与 25% 之间隔着整条前沿
过程段是标题的出处。
按任务时长分桶,3 月到 10 月,两到四小时档的零干预成功率从 23% 到 46%,四到八小时档从 13% 到 35%。七个月翻一倍以上,这条趋势线是全文的主动力。
但报告紧接着自己拆自己的台。原话的限定是,随着 agent 能力上升,研究员在每个时长桶里委派的任务类型可能已经变了,桶内成功率的变化同时反映能力提升和委派偏好的变化。数字涨了,分母也在漂。这是内部测量无法回避的问题,OpenAI 把它写在正文里,而不是藏在脚注。
按任务类型切开,参差就露出来了。8 月 1 日到 10 月 18 日,用 Epoch AI 开发的 O*NET AI R&D 分类法统计,沟通类任务成功率 69%,分析类 58%,建造类 43%。落到具体任务,盯训练运行找问题 79%,回答技术问题 72%,启动训练运行 35%,搭建评测、强化学习和 agent 环境 29%,写推理和 serving 栈的代码 25%。
这张表的形状值得多看一眼。得分最高的是「看」和「答」,盯着运行中的训练找异常、回答研究者的技术提问,这类活的共同点是输入明确、判断标准清晰、出错了损失可控。得分最低的是「建」,推理 serving 栈是模型上线交付的管线,RL 环境是强化学习的地基,这类活的共同点是牵一发动全身、错了代价极高、需求往往说不清楚。agent 的高分区全在人类把关成本低的地方,低分区全在把关成本高的地方。
报告对这组数字的推断也很冷静,只要模型在 AI 研发相关任务上的表现是异质的,低分项就可能成为整体提升的瓶颈。翻译一下,46% 的均值不等于一个团队能把一半工作甩给 agent,真正的吞吐量由那 25% 的短板任务决定。
标题里那个「参差」,在这张表上有了具体的形状,看和答在一端,建在另一端,中间隔着的是研究能否全自动的整条分水岭。
短木板卡在哪里,10 名研究员的访谈给了细节,受访者来自预训练、后训练和安全三个方向。一位做评测的安全研究员说,从前移植一个开源评测并把消融实验跑通,要一周半到两周才能回答「这个评测能不能用」,现在从零到跑起来是一天,最多几天。一位做强化学习环境的安全研究员则说,模型通常没法一次性提出自己解决不了的良构问题,让模型生成数据点,生成一百次每次都差不多。另一位后训练研究员的方法论是先让 agent 做一个样本,人工审核修改,然后再让它批量做剩下的,直接吩咐它「照着那个任务的样子做这个」,试过太多次,每次都不完全对,改起来反而更费劲。
想法的出处是访谈里最微妙的部分。报告请预训练、后训练、安全监控三个方向的各一到四名关键贡献者,为 GPT-6 Astra 和 GPT-6.2 Astra 两个版本各提名一到三个最重要的想法,并追问想法从哪来、AI 参与多深。后训练和安全监控的研究者说,两个版本的全部想法都是人提出的,模型只协助实现。预训练的研究者把 GPT-6 Astra 的想法完全归给人。但对 GPT-6.2 Astra,出现了新说法,有研究者描述了与 Codex 在对话中共同推进想法的过程,一人把关键洞察的识别归功于 Codex,另一人说主要想法是自己的,但在 Codex 建议了一处修改之后才真正成立。
这是整份报告里离递归自改进最近的一句话。到 10 月为止,重大想法的主体仍然是人,但「人机共同孕育」已经在预训练方向出现了具名案例。分界线从「谁提出的」变成了「谁的作用不可删」。
四、安全侧的曲线拐点在 7 月
投入段的另一组数据藏着这份报告里最安静的转折。
研究员的时间流向哪了。OpenAI 收集了 1 月到 9 月每个研究员在公司内可见的 Slack 帖子、pull request 和内部文档,用分类器归入研究方向,每名研究员的一周按验证过的项目均分。这个口径测的不是行政隶属,是注意力。
结果是,2026 年各研究方向的记录工作量都在涨,而 Safety and Alignment 的绝对增量在所有主要方向里排第一,记录工作周数从 1 月到 9 月涨了 77%,几乎翻倍,来源是新招聘加上现有研究员向安全项目的转移。这条曲线的拐点,报告写得明白,与 7 月 Hugging Face 事件及其后续处理在时间上重合。OpenAI 随后为前沿 AI 训练开发和改进 safety cases(安全案例,指训练前对模型风险做出系统评估的流程),这个方向覆盖对齐评测、可监测性、reward hacking(奖励破解,指模型钻奖励函数空子的行为)研究。安全投入的增长在时间上是一次事件驱动的,7 月的蜂群攻击事件之后安全工作周几乎翻倍,那之前九个月的增长平缓得多。由事故驱动的安全投入能在多大程度上领先于下一次事故,这条曲线本身给不出答案。
五、产出,实验多跑了 68%,能力指数每年涨 16.4 分
产出段回答最后一个问题,投入涨了、过程变了,研究本身变快了吗。
两项活动量指标先看。每位活跃贡献者的代码变更行数相对 2025 年前的基线在 2026 年持续大幅上升,这次改用 28 天滚动平均,并把测试代码从统计里剔除,口径比 9 月那版更严。每位活跃实验者运行的实验数量,截至 10 月 18 日的四周内是 2025 年基线的 1.68 倍。
活动量不等于进展,代码写得多可能只是在空转,实验跑得多可能只是在试错。报告没有停在活动量上,引入了第三项指标,OpenAI ECI(OECI),Epoch Capabilities Index 的内部版。方法论与 Epoch 的公开版接近,差别在基准组合,OECI 用公开基准与 OpenAI 内部基准混合。图上画了 20 个公开发布的 OpenAI 模型和 28 个其他厂商的模型。
数字是,自 2025 年 8 月以来,OpenAI 模型的 OECI 前沿每年增长 16.4 分;Epoch 观察到的公开趋势是自 2024 年末以来每年 14 分。两组数字之间的差,报告自己给了解释,OpenAI 模型在 OECI 上的相对得分高于在 Epoch 公开版 ECI 上的表现,可能源于基准组合不同。自家版的指数跑赢公开版,这个偏差的方向值得读者自己掂量。
三项产出合起来,活动量在涨(实验 1.68 倍)、能力前沿在涨(每年 16.4 分)、投入在指数涨(每天 2400 美元)。因果链的最后一环仍然是断开的,实验多了 68% 是因为 agent 更强,还是因为愿意做实验的人更多、模型迭代节奏本身在加快,报告没有拆。
六、报告没说透的三处
这份报告的坦诚程度在同类里算高的,成功率下降的年份它照发,口径漂移它自己写,调研局限它自己标。但有三处它点到为止。
第一处是成功率与生产力的距离。全文没有给出「研究产出提速了多少」的端到端数字,实验 1.68 倍是最接近的代理指标,但实验数量与模型能力提升之间的转化率没有任何测量。第二处是基准组合的自我偏差,OECI 比 Epoch 公开版每年多涨 2.4 分,报告归因于基准不同就停了,没有做任何去偏处理。第三处是反例的沉默,结论里承认最近前沿模型在数学领域出现了突然而迅速的突破,历史趋势线「可能无法预测未来 AI 驱动的进展」,深度学习里会不会复现类似的快速突破正在监测中。这句话承认了整份报告的方法论边界,账本式指标是后视镜,突破式进展从不走后视镜里那条线。
结语照例是判断。这份报告最大的价值不在任何一个数字,而在它把「研究加速」从叙事变成了账目,投入有价格,过程有成功率,产出有指数,每个月可以重测一次。四家机构都在往这个方向走,Anthropic 三份,OpenAI 两份,DeepMind 一节,METR 一份。当测量变成惯例,谁先停更谁先可疑,这套账目的威慑力大于其中任何一个数字。至于 25% 那条短板,推理和 serving 代码的独立完成率,它才是未来几个月最值得盯的一条线,递归自改进如果真的发生,不会发生在 agent 最擅长的看和答里,只会发生在它现在最不擅长的建里。