研报速递
10. 平台参考架构与工程实施
10.1 分层架构与治理横切面
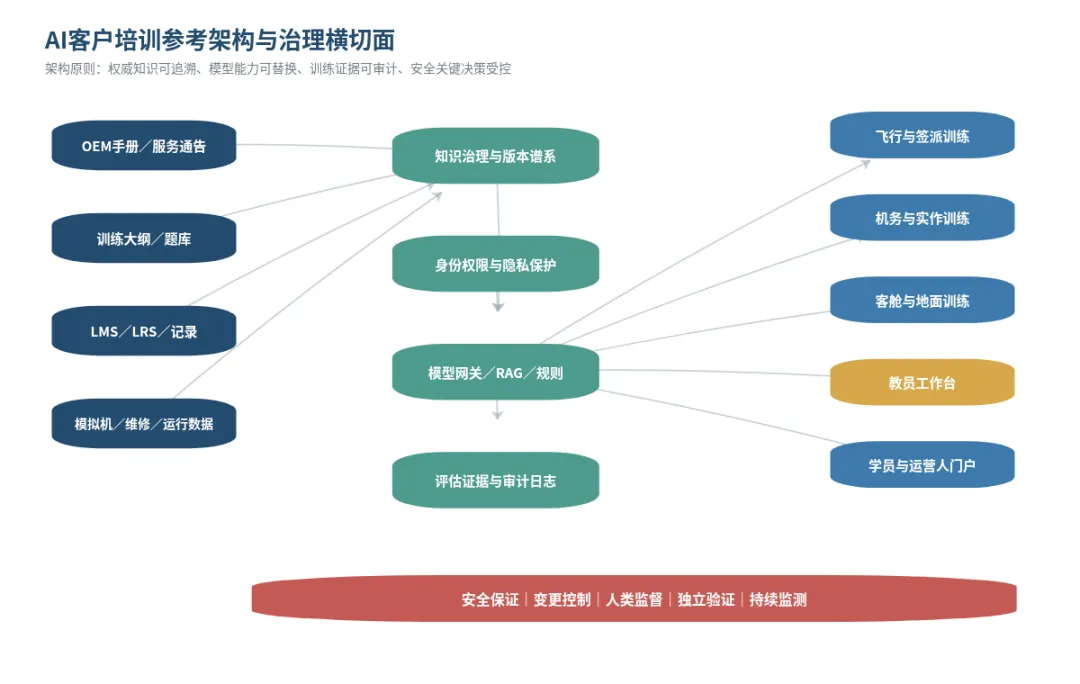
参考架构由数据源、知识与数据治理、模型服务、应用和安全保证横切面组成。数据源包括OEM手册、服务信息、训练大纲、题库、LMS/LRS、模拟设备和经授权的运行反馈;治理层负责构型、版本、权限、元数据和记录谱系;模型层通过统一网关连接RAG、规则、机器学习和外部模型;应用层面向不同岗位、教员、学员和运营人提供受控功能。安全保证、变更控制、人类监督、独立验证和持续监测不能作为上线后的附加模块,而应贯穿所有层。
模型网关是降低供应商锁定和实施一致治理的关键。它可以统一身份、调用配额、敏感信息处理、提示模板、模型路由、输出过滤、日志和成本计量,使不同场景使用不同模型而不重复建设控制。高风险场景可路由到经过专门验证的模型和固定知识版本,低风险翻译或摘要可使用更灵活的模型组合。网关还应支持快速禁用某一模型、插件或知识源,并保留完整回滚配置,避免故障时只能关闭整个培训平台。
10.2 LMS、LRS与互操作标准
AI平台不应另建一个与既有训练记录割裂的学习孤岛。LMS继续承担课程、人员和进度管理,LRS用于记录更细粒度的学习经验,模拟设备和实作工具通过受控接口提供事件证据,正式训练记录则由授权流程确认。xAPI已成为学习经验互操作的重要规范,IEEE 9274.1.1-2023将其标准化;LTI 1.3可用于学习工具与平台集成,Caliper Analytics提供另一类学习事件表达。选择何种标准应依据现有生态和记录需求,而不是为了标准化而复制所有数据(IEEE(standards.ieee.org), 1EdTech(1edtech.org))。
事件模型必须区分“系统观察”“AI解释”和“正式结论”。例如,设备可以记录某时刻的检查单状态,模型可以推断某程序步骤延迟,教员可以确认该证据是否构成能力缺口;三者若被写成同一条不可分记录,就难以复核和纠正。建议采用统一人员、课程、构型和设备标识,给AI输出附加模型版本、置信信息、证据链接和审核状态,并为跨系统失败设置幂等、重放和对账机制,防止训练记录丢失或重复。
10.3 LLMOps、测试与可观测性
培训AI的持续工程包括数据版本、知识索引、提示模板、模型参数、评测集、发布配置和运行监测。每次变更都应能回答“哪个版本在什么时间向哪些用户提供了什么输出”,并能够重现或解释关键结果。对于生成系统,完整重现可能受模型服务变化影响,因此更要保存输入、检索证据、输出、模型标识和必要配置;外部模型升级不能被默认视为无影响的常规维护。
评测应分层开展:检索层测量正确资料召回和过期资料排除,生成层测量证据忠实度和拒答行为,应用层测量任务完成与教员工作负荷,学习层测量保持和迁移,安全层测量滥用、注入和越权。上线后需要监测的不只是延迟和成本,还包括无答案率、引用覆盖率、人工修改率、投诉、风险事件和不同群体的误差。指标异常应触发限制功能、回退到只检索模式或人工交付,而不是等待下一次常规版本迭代。
10.4 数据质量服务等级与知识可观测性
航空知识平台需要像管理关键服务一样管理数据质量。可以为不同知识域定义完整性、及时性、适用性、一致性和可追溯性指标,例如有效资料是否都有责任人和版本,已发布变更是否在规定周期内进入课程审核,客户构型是否能正确映射到内容,索引重建后是否出现资料丢失。服务等级不能只承诺服务器可用,而应承诺知识更新、异常响应和问题纠正的处理时限,并明确无法达到时的人工替代流程。
知识可观测性要求把用户问题、检索路径、资料版本和回答结果连接起来。若某类问题持续出现低置信检索,可能意味着资料缺口、术语不一致或解析失败;若某段资料经常被引用后又被教员否定,可能存在适用范围或教学解释问题;若某版本发布后错误突然增加,应立即进行差异分析和影响追踪。通过这些信号,平台能够把质量管理从定期抽查转为持续发现,但自动告警仍需要知识负责人确认和处置。
数据质量指标也应防止追求单一数值。提高检索召回可能增加不相关资料,提高自动回答率可能减少合理拒答,提高更新速度可能压缩审核。建议采用成对约束指标,例如召回率与误召回、回答覆盖与无依据回答、更新周期与审核退回率,并按知识域和风险层级设定不同阈值。这样可以把“数据质量”转化为可运营的控制体系,而不是在项目初期完成一次清理后逐步退化。
11. 数据治理、隐私与网络供应链安全
11.1 数据权属、目的分离与客户信任
客户培训数据至少包括OEM知识产权、客户专有程序、学员个人信息、教员评估、设备数据和运行反馈。它们不能用一条“平台可改进服务”的授权概括处理。合同和系统设计应明确原始数据、派生特征、聚合指标、模型参数和反馈结论分别由谁控制,哪些用途需要单独授权,客户退出后如何返还或删除,以及OEM能否把某客户数据用于其他客户的产品改进。数据可用性与商业秘密保护应通过最小化、隔离和聚合共同实现。
目的分离是建立信任的核心。用于帮助学员改进的记录,不应在未告知和未授权的情况下直接用于纪律处罚;用于验证某课程的数据,不应自动变成通用模型训练集;用于跨客户安全改进的聚合指标,应有防止重新识别和泄露客户运行信息的门槛。OEM可以提供数据使用透明面板,让客户看到数据流向、当前授权和模型用途,并允许不同客户选择本地处理、专属实例或只上传必要摘要。
11.2 学员隐私、评估公平与比例原则
训练数据具有职业影响,细粒度视频、语音、眼动、行为轨迹和心理状态推断尤其敏感。项目应优先使用达成教学目标所需的最少数据,设置短期原始数据和长期必要记录的分层保存,严格控制谁能查看个人、谁能查看班级聚合。对人脸、声纹等生物识别或持续监测,不应因技术可得就默认采用;必须评估必要性、替代方案、适用法规和学员权利,并避免把拒绝非必要采集等同于训练不配合。
公平性验证不能只比较总体准确率。系统应按语言、经验、地区、设备和其他与用途相关的群体检查误差与推荐差异,同时遵守当地对敏感属性处理的限制。发现差异后,需要判断是数据代表不足、界面可用性、课程内容还是模型本身造成,并制定补救。学员应有渠道对错误记录和AI辅助结论提出异议,教员和管理者应有权纠正;涉及资格或职业机会的高影响决定,更需要明确人工复核和申诉路径。
11.3 提示注入、数据投毒与供应链
RAG系统会把文档内容转化为模型上下文,因此恶意或被污染的文档可能包含间接提示注入,引导模型泄露信息、忽略规则或调用不当工具。NIST关于对抗机器学习的分类和生成式AI风险管理文件提示,生成系统的攻击面覆盖数据、模型、输入和运行环境。培训平台应把外部文档视为不可信输入,采用内容扫描、指令与资料分离、工具最小权限、敏感操作二次确认和输出审计,不能仅依赖系统提示词要求模型“不要服从恶意指令”(NIST(nvlpubs.nist.gov), NIST GenAI(nvlpubs.nist.gov))。
供应链范围还包括基础模型、嵌入模型、解析器、开源插件、向量数据库、模拟数据接口和外部云服务。每个组件都应有来源、版本、漏洞、支持期限和替换方案,关键组件需开展红队和故障演练。模型或知识库更新可能造成静默性能变化,供应商退出可能影响课程连续性,因此合同应包含提前通知、导出能力、审计配合、事件通报和退出支持。对安全关键功能,组织需要保留不依赖单一云服务的降级交付方案。
12. 适航、训练监管与AI法规合规
12.1 中国训练规则下的变更识别
中国客户培训需要结合具体业务适用CCAR-121、CCAR-141、CCAR-142、CCAR-66及相关维修培训和设备要求。CCAR-142涉及训练机构、课程、人员和记录等管理,CCAR-121包含运营人训练要求,CCAR-66涉及维修人员基础与实作培训、考试和机型培训。AI项目不能笼统声称“符合全部规章”,而应把系统功能映射到具体条款、批准文件和运营人程序,识别其是否改变课程内容、训练方法、评估方式、教员职责、设备用途或记录系统(中国民航局142(caac.gov.cn), 中国民航局121(caac.gov.cn))。
同一技术在不同部署中可能具有不同合规后果。课后为学员提供参考资料检索,可能主要是内容和信息安全问题;把AI生成的差异单元纳入正式课程,可能涉及大纲和课程变更;把模型评分写入正式训练记录,可能涉及评估与记录控制;让AI实时改变批准模拟设备的训练过程,则可能同时涉及设备和课程。项目应建立书面变更分类,必要时及早与主管监管方沟通,并保存“不需要批准”的判断依据,而不是只有上线批准文件。
12.2 ICAO、FAA与EASA的对照启示
ICAO提供能力本位训练和评估的共同框架,FAA通过训练中心、设备和课程批准等制度实施具体要求,EASA则在AI路线图中采取风险为本、分级和渐进的安全保证思路。EASA AI Concept Paper Issue 2围绕学习保证、数据保证、可解释性、伦理评估等构建指导,2026年Proposed Issue 3进一步面向机器学习应用更新指导。对跨国OEM而言,合理做法不是把某一法域的术语机械复制到全球,而是建立统一工程证据底座,再按部署地映射差异(EASA Issue 2(easa.europa.eu), EASA Issue 3(easa.europa.eu))。
FAA 2024年发布的AI Safety Assurance Roadmap强调以渐进方式推进航空AI安全保证。FAA Part 142的现行要求则提醒项目:课程、教员、评估员、设备和记录各有明确责任,AI不能成为绕开这些责任的通用豁免。对照三类框架可以得到一个共同原则,即自动化功能越深入正式训练与评估,越需要说明预期用途、运行范围、训练数据、性能边界、人类监督和持续符合性,而不能只提交一次模型准确率报告(FAA Roadmap(faa.gov), eCFR(ecfr.gov))。
12.3 生成式AI与欧盟AI法的逐用途分类
在中国提供生成式AI相关服务时,需要结合服务对象、公开属性和具体功能判断《生成式人工智能服务管理暂行办法》等要求的适用性;2025年发布的《人工智能生成合成内容标识办法》进一步提出生成合成内容标识要求。企业内部受控培训工具、面向客户的付费服务和面向公众的开放助手,可能具有不同义务,不能因底层使用同一大模型而采取同一合规模板。界面标识也不能替代知识准确性和训练安全控制(国家网信办(cac.gov.cn), 国家网信办标识办法(cac.gov.cn))。
欧盟AI法对航空安全相关部件与教育培训用途存在不同路径。附件III列示的部分教育和职业培训用途包括准入或分配、学习结果评估、教育层级评估以及考试监测等;航空产品安全部件还可能通过相应产品立法路径处理。客户培训AI应逐用途形成书面分类:普通知识检索、个性化学习推荐、自动成绩评定、考试监考和资格相关判断不能打包判断,跨境部署还需核查当时生效和适用的条款(EUR-Lex(eur-lex.europa.eu))。
12.4 合规证据包与变更门径
建议每个AI训练产品建立可复用证据包,至少包括预期用途与用户、禁止用途、岗位和课程范围、数据与知识来源、模型和组件清单、风险分析、验证结果、人类监督、信息安全、隐私、输出标识、记录保存、事件响应、回滚和变更历史。证据包不是一次性认证材料,而应随版本更新,并能追踪到具体发布。对R3和R4场景,应增加评分构念、群体误差、教员一致性、独立验证和监管沟通材料。
变更门径可分为提案、分类、影响分析、验证、授权发布和持续监测六步。门径的严格程度与风险层级匹配:R1也必须有内容和权限测试,R3则需要跨职能批准和更完整的证据;任何级别都不应允许供应商后台更新绕过客户告知。若监测发现错误答案、异常评分或数据泄露,系统应能按场景回退到旧知识版本、只读检索或纯人工流程,并评估已经形成的学习记录是否需要纠正。
12.5 训练记录、电子证据与可审计性
AI参与后,训练记录的对象从最终结果扩展到产生结果的过程。除了课程完成、成绩和教员签署,还可能需要保存系统使用的资料版本、模型或规则版本、关键推荐、人工确认和修改原因。并非所有原始交互都要永久保留,记录粒度应根据法规、课程、风险和数据最小化原则确定;关键是正式结论能够追溯到足够证据,且记录保存不会因追求可审计而变成无边界收集。
电子证据必须区分生成、确认和批准状态。AI生成的反馈草稿不能因进入记录系统就自动获得正式效力,教员确认也不能掩盖其未获得足够信息或时间的事实。系统应采用明确状态机,记录谁在何时以何种权限改变状态,并防止后台任务直接覆盖已确认内容。对后续发现的错误,需要以追加纠正和保留历史的方式处理,避免无痕修改导致过去与当前结论无法比较。
审计还应验证记录的完整性和可用性,而不只是检查数据库中存在字段。抽样人员应能从一份正式结论返回相关证据、课程和知识版本,也能从一次模型或知识更新正向找到可能受影响的训练记录。跨系统环境下,需要定期对账、检查时间同步和身份映射,并测试供应商退出或平台迁移后记录是否仍然可读。可审计性最终是一种持续运营能力,而不是上线时一次性导出的证明文件。
13. 安全保证、人因与验证方法
13.1 从模型风险到训练安全案例
训练AI的安全分析应从输出如何影响人员和课程出发。错误知识可能导致错误学习,错误推荐可能造成训练覆盖不足,错误评分可能改变资格判断,界面干扰可能影响模拟训练,数据泄露可能损害客户和个人。项目可使用危害分析、失效模式分析和威胁建模,把每项危害连接到原因、控制、验证和剩余风险。NIST AI RMF以Govern、Map、Measure、Manage组织可信AI活动,可作为企业管理体系的通用参考,但航空项目仍需结合训练和适航要求具体化(NIST(nvlpubs.nist.gov))。
安全案例应说明为什么在给定运行设计域内,系统可以接受。运行设计域不仅包括机型和课程,还包括语言、用户经验、设备、网络条件、知识版本和可用人工支持。一个在线知识助手在课程开发办公室可控,在学员移动端可能面临不同使用方式;一个模拟事件模型在特定设备和脚本上有效,在开放场景上可能超出验证范围。明确禁止用途和越界检测,比笼统宣称“高可靠”更有实际价值。
13.2 独立验证、红队与边界测试
验证团队应在合理程度上独立于开发和场景所有者,避免只复用开发者的测试假设。测试集要包含正常、困难、边界、对抗和过期知识,保留已知正确答案与不可回答问题,并测量漏答、错答、无依据回答和错误拒答。对推荐和评分系统,应检验不同经验与语言群体、不同设备和教员,以及训练分布之外的输入;对生成场景,应验证物理和程序约束、可复现性及教员干预。
红队不应只测试明显恶意攻击,还要模拟忙碌教员、误解界面的学员、配置错误的管理员和异常供应商响应。很多事故并非来自高明攻击,而是来自自动化偏见、权限配置、旧缓存和错误默认选项。测试报告需要记录发现、严重度、修复、剩余风险和发布决定,重大缺陷不能以“后续通过用户反馈优化”替代上线前处理。对持续学习或外部模型服务,还应设置周期性复测和触发式复测。
13.3 有效人类监督与组织人因
有效监督要求人员有能力、有时间、有信息、有权限进行干预。培训组织需要为教员提供AI基本原理、已知限制、证据阅读和异常处置训练,并通过实际工作观察评估其是否能识别错误。系统可以显示置信和证据,但过多技术指标也会增加负担;更好的界面是围绕任务呈现关键不确定性、冲突来源和建议行动,同时提供快速查看原始资料的入口。
监督绩效不能以采纳率为目标,否则组织会无意中鼓励盲从。更合理的指标包括高风险错误的发现率、人工修改质量、复核耗时、异常升级及时性和不同教员之间的一致性。对AI过度依赖和完全拒绝两种行为都应分析原因:前者可能源于界面权威感和工作负荷,后者可能源于早期错误、缺乏参与或责任不清。教员参与产品设计、试点和复盘,是建立适当信任而非最大化信任的关键。
系列导航 | 本文为《AI赋能民用飞机客户培训深度分析报告》系列第四篇(共 7 篇)
◻ 第一篇 (一)执行摘要、研究范围与需求背景 ◻ 第二篇 (二)能力本位训练、AI 能力地图与飞行训练 ◻ 第三篇 (三)机务、签派客舱训练与知识工程 ▶ 第四篇 (四)平台架构、数据治理与适航合规 ◻ 第五篇 (五)产业案例、组织模式与实施路线 ◻ 第六篇 (六)效果评估、投资回报与风险登记 ◻ 第七篇 (七)战略行动、未来演进与附录