研报速递
导语:研报与论文里最值钱的数字,经常被锁在折线图、柱状图或散点图里,复制不了,只能对着屏幕手敲。开源多模态视觉模型(如 Qwen2.5-VL、DePlot 一类图表对齐架构)可以在本地做图表逆向:标定坐标轴和刻度,把像素点还原成 CSV。
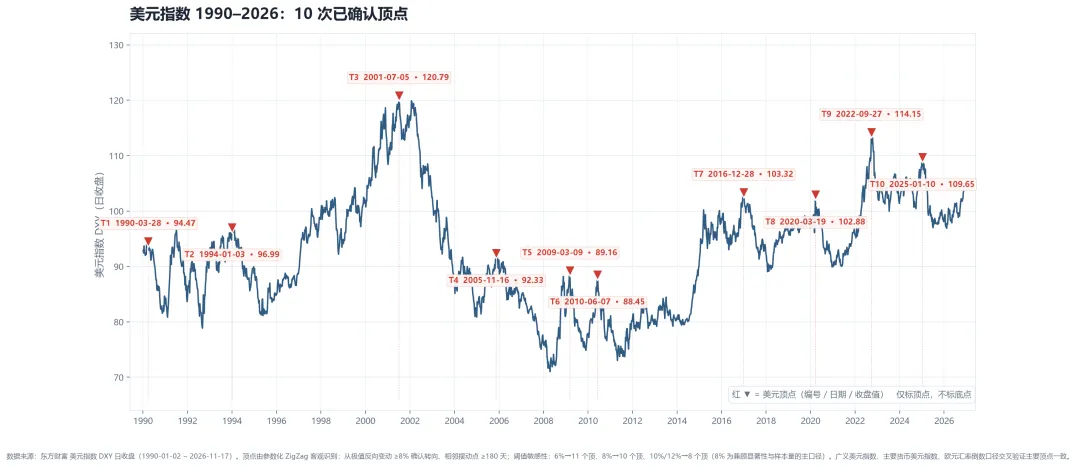
读券商白皮书或实验报告时,最硬核的数据——电池衰减曲线、芯片功耗对照、季度营收对比——经常只以静态图出现。要拿去 Excel、Pandas,或拿去给 Home Assistant 做能耗拟合,像素是复制不了的。
老办法就两条:屏幕放大到 300%,拿尺子对着纵坐标估,一个数一个数敲;或者用旧的屏幕取点工具,在图上手工点几十下。前者慢且容易录错,后者操作也很烦。
还有人把截图丢给普通大模型,让它“整理成表格”。结果要么只给定性描述(“整体上升”),要么在密集折线或截断坐标轴上开始胡编,数字看起来像样,和坐标对不上。
坑在把图丢给通用聊天模型就当原始数据。不建议把这类模型吐出来的数字直接填进表格或拟合脚本。
要做图表逆向,得用带几何坐标能力的视觉模型,在本地跑一套 Chart-to-Table:识别图表类型、标定原点和刻度,再输出结构化 CSV。
普通模型为什么看不准图
图表和风景照不是一类任务。风景照认错几个像素无所谓;图表靠的是亚像素位置和符号对应。
- 坐标轴标定
:纵轴零点未必在图底,可能从 50 截断;刻度可能是线性,也可能是对数。模型要先认出轴上的数字标签,和刻度线锚定,算出“每像素代表多少”。 - 图例和曲线绑定
:四条折线可能只靠实线/虚线、圆点、深浅蓝区分。色差一钝,交叉处就会串系列。 - 重叠和遮挡
:散点挤在一起、柱体互相挡住时,传统 OpenCV 轮廓提取容易粘连、断裂。
以自然语言为主的图文模型,预训练里高精度几何监督本来就少,面对图表只能猜轮廓——这就是普通模型提取图表时算术幻觉多的原因。
Qwen2.5-VL 这类模型怎么标定坐标
专为细粒度视觉任务设计的模型(Qwen2.5-VL、图表专用模型)多半会引入动态分辨率和绝对坐标感知。
先看分辨率。旧多模态模型常把图压成 224×224 或 448×448,细小刻度数字和密集拐点会糊成马赛克。较新的模型可以吃 2K/4K 原图,用二维旋转位置编码和动态视觉 Token 切块,把刻度线、图例文字送进注意力层。
再看两阶段流程:
阶段一:先定位标题、X 轴范围和单位、Y 轴步长、图例颜色映射。 阶段二:顺着 X 轴离散刻度垂直扫描曲线交点,按已标定的 Y 轴比例反投影,在解码层输出浮点数。
给下游的不应是散文,而应是列名与图例对齐的结构化数据。即便如此,仍建议把提取结果重新画一遍,和原图叠看,不要直接当标定数据。
本地工作流:抽图生成 CSV,再叠图校验
在个人电脑或本地 GPU 上,用 Python 把本地视觉模型和清洗脚本串起来即可。数据可以不出网。
步骤一:本地拉起多模态服务(以 Qwen2.5-VL-7B 为例)。vLLM、Ollama 或 HuggingFace Transformers 都行。7B 量化到 4-bit 后,大约 6GB 显存,或在 Mac 统一内存上也能离线跑。
步骤二:给图表逆向写死输出契约。例如 chart_to_csv.py:
import base64import jsonimport urllib.requestdef image_to_base64(image_path: str) -> str: with open(image_path, "rb") as f: return base64.b64encode(f.read()).decode("utf-8")def extract_chart_data(image_path: str): base64_data = image_to_base64(image_path) system_prompt = """你是一个专业的图表数据逆向工程专家与资深数据科学家。请仔细审阅传入的图表图片(折线图/柱状图/面积图/散点图),严格执行以下两步分析:1. 识别图表的主标题、X轴物理量与单位、Y轴物理量与单位,以及所有图例(Legend)对应的系列名称;2. 标定坐标轴的刻度比例尺,提取图表中每一个数据点的真实数值。必须严格且仅输出如下格式的标准 CSV 数据,严禁包含任何前言、总结或解释性文字:
[X轴列名],[系列1列名],[系列2列名]...
[数值X1],[数值Y1_1],[数值Y1_2]...
请保证提取出的数值保持严格的数学合理性,保留原始图表中呈现的有效数字精度。""" payload = { "model": "qwen2.5-vl:7b", "messages": [ { "role": "user", "content": [ {"type": "text", "text": system_prompt}, {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{base64_data}"}} ] } ], "temperature": 0.05 # 极低采样温度,降低随机幻觉 } # 向本地模型 API 发送请求(Ollama 默认监听,按你本机实际端口改) req = urllib.request.Request( "http://localhost:11434/api/chat", data=json.dumps(payload).encode("utf-8"), headers={"Content-Type": "application/json"} ) with urllib.request.urlopen(req) as resp: res = json.loads(resp.read().decode("utf-8")) raw_text = res["message"]["content"] csv_match = re.search(r"```csv\s*(.*?)\s*```", raw_text, re.DOTALL) clean_csv = csv_match.group(1).strip() if csv_match else raw_text.strip() return clean_csv
步骤三:用 Pandas 解析,并立刻重绘做叠图校验。谁别用“抽完就信”的流程——对数轴、截断纵轴、交叉多系列,坑就在这里。
import ioimport pandas as pdimport matplotlib.pyplot as pltcsv_text = extract_chart_data("battery_curve.png")df = pd.read_csv(io.StringIO(csv_text))print("成功逆向还原数据表:")print(df.head())# 将提取出的数据立即重新绘制为折线图,与原图进行视觉叠图验证df.plot(x=df.columns[0])plt.title("Re-plotted from Extracted Data")plt.savefig("verification_plot.png")
叠图能看拐点、峰值是否对得上。对不上就回到阶段一,先查轴标定,不要先改拟合公式。
工控处理器功耗曲线这种图,怎么拆
一份工控处理器在不同 DVFS 挡位下的“频率-功耗-发热”官方 PDF,常常只给一张对比折线图,不给原始表。要把曲线送进电源调度或 Home Assistant 温控看门狗,过去只能拿尺子量。
用上面这套流水线时,实际要盯三件事:
- 先截图再抽
:只丢折线区域,少带页眉页脚和无关示意图。 - 多曲线先对图例
:横轴是主频(GHz)、纵轴是核心功耗(W)时,要分清“单核满载”“双核满载”“全核突发”各自对应哪条线,交叉处最容易串。 - 抽出 CSV 必须重绘
:文档若只给了十几个采样频点,拟合前先和原图叠一遍。不建议把模型口算的误差百分比写进结论里。
适合折腾、能接受本地起模型和叠图校验的人。不适合小白:没有 GPU/统一内存,或图是三维爆炸图、热力图混排时,先别装这套当一键神器。