研报速递
当前,大模型正从“以模型为中心”转向“以数据为中心”。截至2026年8月,全国高质量数据集总体量已超1815PB。但在繁荣背后,“作坊式”生产、主体壁垒、评价标准缺失等问题依然尖锐。
近日,由信通院等70余家单位联合编制的《面向高质量数据集的数据基础设施研究报告》重磅发布。本文结合原报告核心内容为你深度拆解:高质量数据集的基础设施到底该怎么建?(文末附全文下载)
一、行业现状与四大痛点:为什么我们还在 “手工作坊”?
报告指出,虽然我国高质量数据集供给已初具规模,但仍面临四大结构性阻碍:
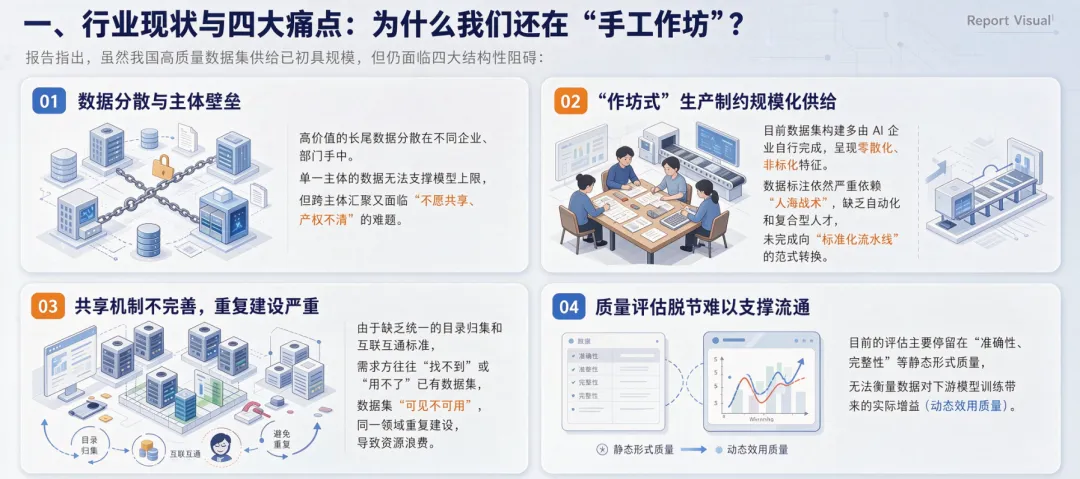
🧩 数据分散与主体壁垒高价值的长尾数据分散在不同企业、部门手中。单一主体的数据无法支撑模型上限,但跨主体汇聚又面临 “不愿共享、产权不清” 的难题。
🏭 “作坊式” 生产制约规模化供给目前数据集构建多由 AI 企业自行完成,呈现零散化、非标化特征。数据标注依然严重依赖 “人海战术”,缺乏自动化和复合型人才,未完成向 “标准化流水线” 的范式转换。
🔁 共享机制不完善,重复建设严重由于缺乏统一的目录归集和互联互通标准,需求方往往 “找不到” 或 “用不了” 已有数据集,数据集 “可见不可用”,同一领域重复建设,导致资源浪费。
📊 质量评估脱节难以支撑流通目前的评估主要停留在 “准确性、完整性” 等静态形式质量,无法衡量数据对下游模型训练带来的实际增益(动态效用质量)。
二、 总体架构:不是四层,是“五平台体系”
报告创造性地跳出了传统的IT分层架构,提出了一套以支撑平台为基础、供给平台为核心、应用与流通平台双轨驱动、安全合规平台全程护航的“五平台体系”。
同时,这五大平台并非死板的并列,而是围绕“数据飞轮”(需求定义→资源接入→生产加工→中试验证→应用交付→反馈迭代)动态运转。
在这个闭环中,基础设施必须完成:明确数据模态与配比(需求)、核验授权与敏感识别(接入)、去重清洗与标注合成(加工)、质量检验与训练增益测试(中试)、面向模型/知识库/智能体交付(应用),以及最后将训练误差与幻觉失败案例回流(迭代)。
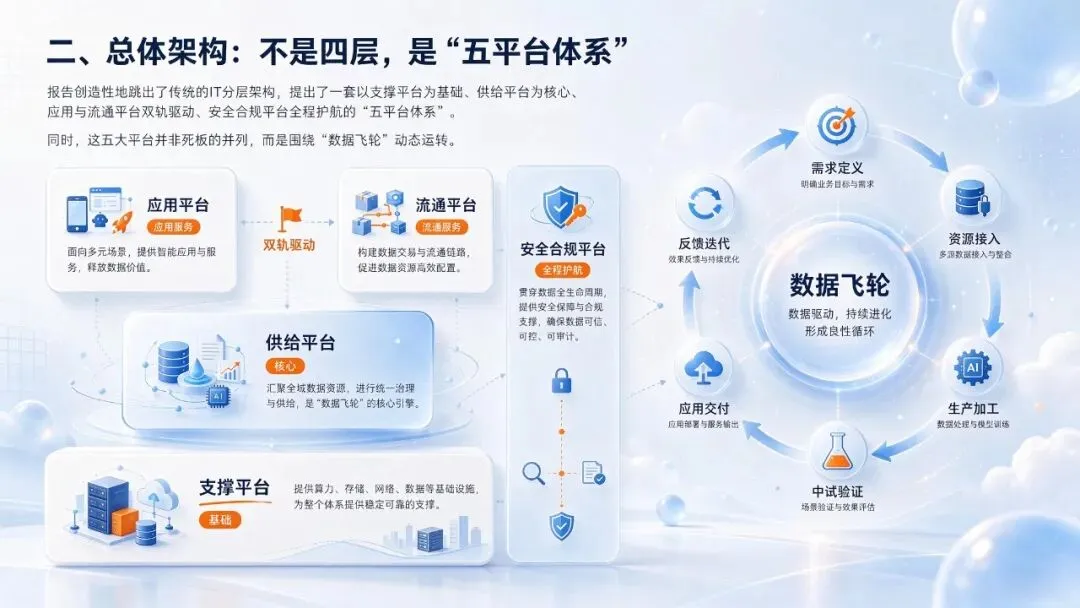
五大平台的具体分工如下:
1. 支撑平台(底层资源)
提供网络(5G-A、确定性网络、空天地一体化)、算力(异构调度、绿色低碳)和存储(分级存储、多协议互通、密文流通)等底层硬核设施。
2. 供给平台(核心引擎)
这是数据集生产的“工业流水线”,由三级车间+共性组件构成:
储备车间:负责多源接入、汇聚与预处理,形成统一资源池。
生产车间:完成清洗、增强、合成、人机协同标注与质检。
中试车间:这是整份报告的题眼。 它要求把生产好的数据集丢进真实的模型任务里进行测试(测格式、标注、分布覆盖、训练增益、鲁棒性、公平性),过了才能发版。
⚠️ 关键判断:中试环节是高质量数据集发布的必过关口,不是可选插件。
共性组件:提供任务编排、数据目录、数据血缘、版本管理、数据编织等全局管控能力。
3. 应用平台(价值释放)
面向四类核心出口:大模型的训练/微调/推理、RAG知识库、本体与知识图谱(实现语义化和跨域互操作)、智能体(多智能体协同、工具调用、轨迹回流)。
4. 流通平台(可信交易)
解决跨主体“不敢给”的问题,包含数据交付(接口/受控评测)、使用控制(机器可执行的数字合约)、隐私保护计算(联邦学习、TEE、安全多方、密态计算)以及溯源计量(区块链存证、贡献度量化、按量分账)。
5. 安全合规保障平台(纵向贯穿)
全程护航身份认证与访问控制、内容合规与投毒检测、去标识化与差分隐私、监测审计与水印溯源。
三、 关键技术:“三大车间”把数据变成资产
报告在技术路线部分,极具实操性地提出了数据集生产的“车间化”运作模式:
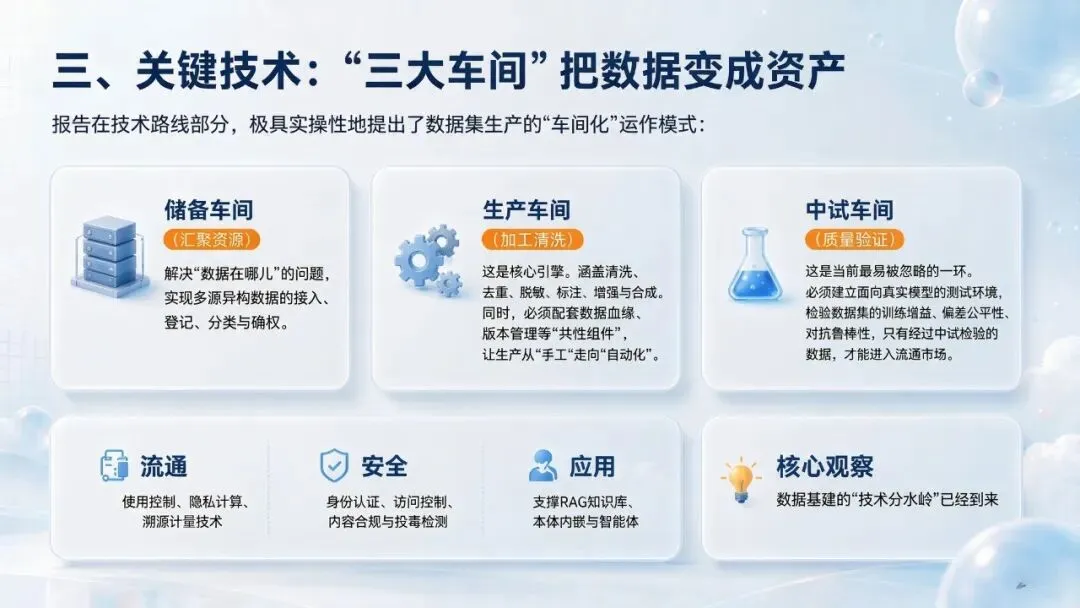
储备车间(汇聚资源):解决“数据在哪儿”的问题,实现多源异构数据的接入、登记、分类与确权。
生产车间(加工清洗):这是核心引擎。涵盖清洗、去重、脱敏、标注、增强与合成。同时,必须配套数据血缘、版本管理等“共性组件”,让生产从“手工”走向“自动化”。
中试车间(质量验证):这是当前最易被忽略的一环。 必须建立面向真实模型的测试环境,检验数据集的训练增益、偏差公平性、对抗鲁棒性。只有经过中试检验的数据,才能进入流通市场。
此外,在流通和安全环节,报告强调了使用控制、隐私计算、溯源计量技术;在应用环节,则聚焦支撑RAG知识库、本体内嵌与智能体。
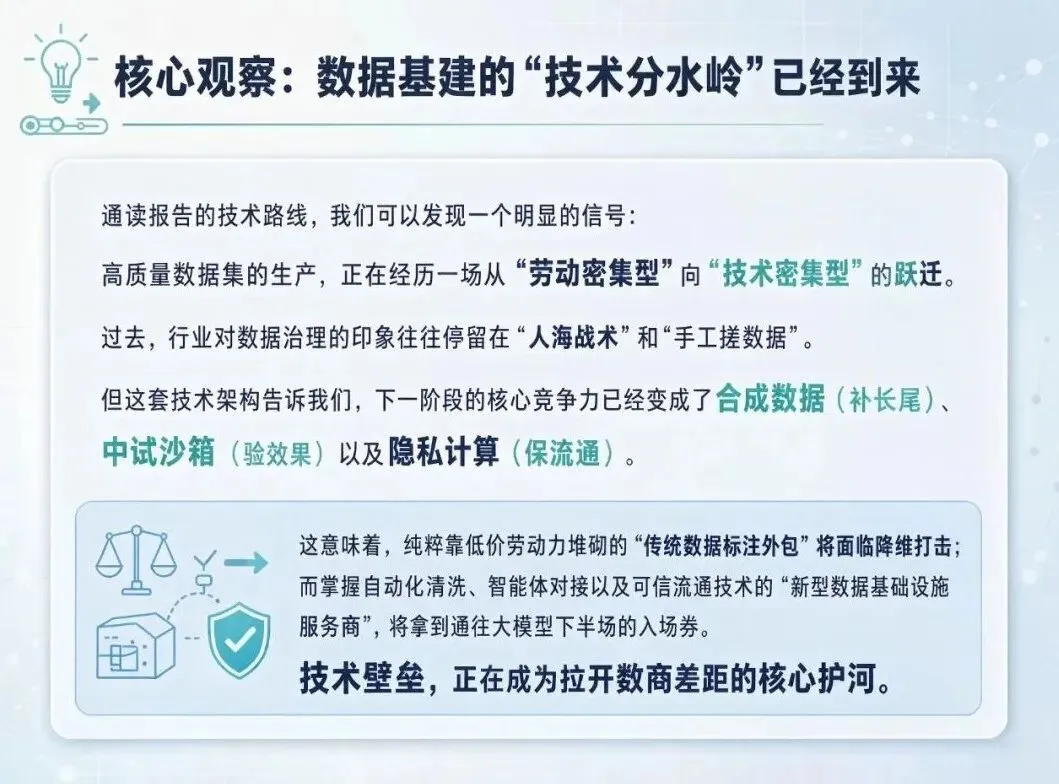
四、 行业实践:从“纸上架构”走向“产业实景”
理论架构再好,最终要接受产业检验。报告第五章收录了城市治理、医疗健康、能源环保、交通汽车四大领域的标杆实践,展示了基础设施如何在不同场景下发挥效能:
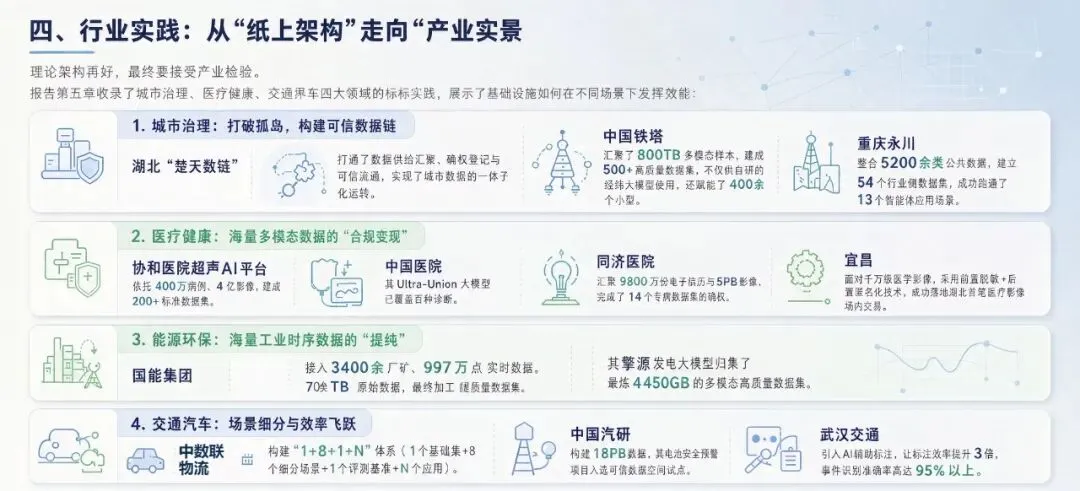
1. 城市治理:打破孤岛,构建可信数据链
湖北“楚天数链”:打通了数据供给汇聚、确权登记与可信流通,实现了城市数据的一体化运转。
中国铁塔:汇聚了800TB多模态样本,建成500+高质量数据集,不仅供自研的经纬大模型使用,还赋能了400余个小模型。
重庆永川:整合5200余类公共数据,建立54个行业侧数据集,成功跑通了13个智能体应用场景。
2. 医疗健康:海量多模态数据的“合规变现”
协和医院超声AI平台:依托400万病例、4亿影像,建成200+标准数据集。其Ultra-Union大模型已覆盖百种诊断。
同济医院:汇聚9800万份电子病历与5PB影像,完成了14个专病数据集的确权。
宜昌:面对千万级医学影像,采用“前置脱敏+后置匿名化”技术,成功落地湖北首笔医疗影像场内交易。
3. 能源环保:海量工业时序数据的“提纯”
国能集团:接入3400余厂矿、997万点实时数据。其“擎源”发电大模型归集了700TB原始数据,最终加工提炼出450GB的多模态高质量数据集。
4. 交通汽车:场景细分与效率飞跃
中数联物流:构建“1+8+1+N”体系(1个基础集+8个细分场景+1个评测基准+N个应用)。
中国汽研:依托18PB数据,其电池安全预警项目入选可信数据空间试点。
武汉交通:引入AI辅助标注,让标注效率提升3倍,事件识别准确率高达95%以上。
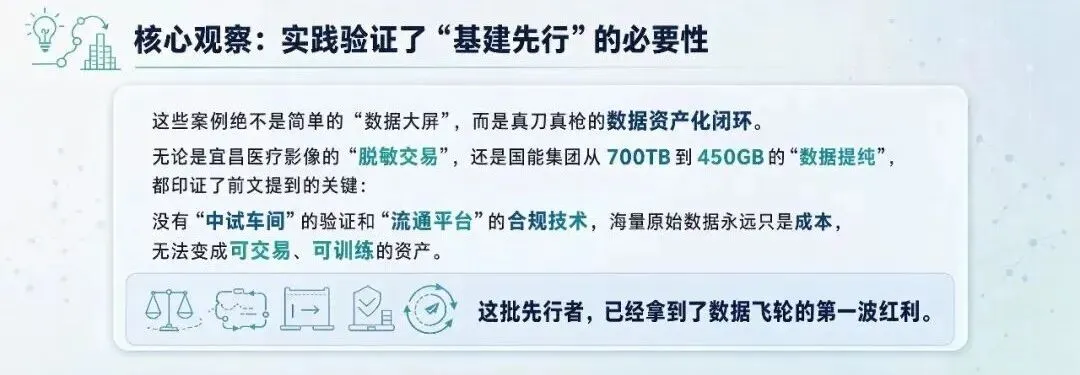
五、 产业机遇:三类主体的破局方向
结合报告的发展建议与行业实践,以下三类主体将迎来重大机遇:
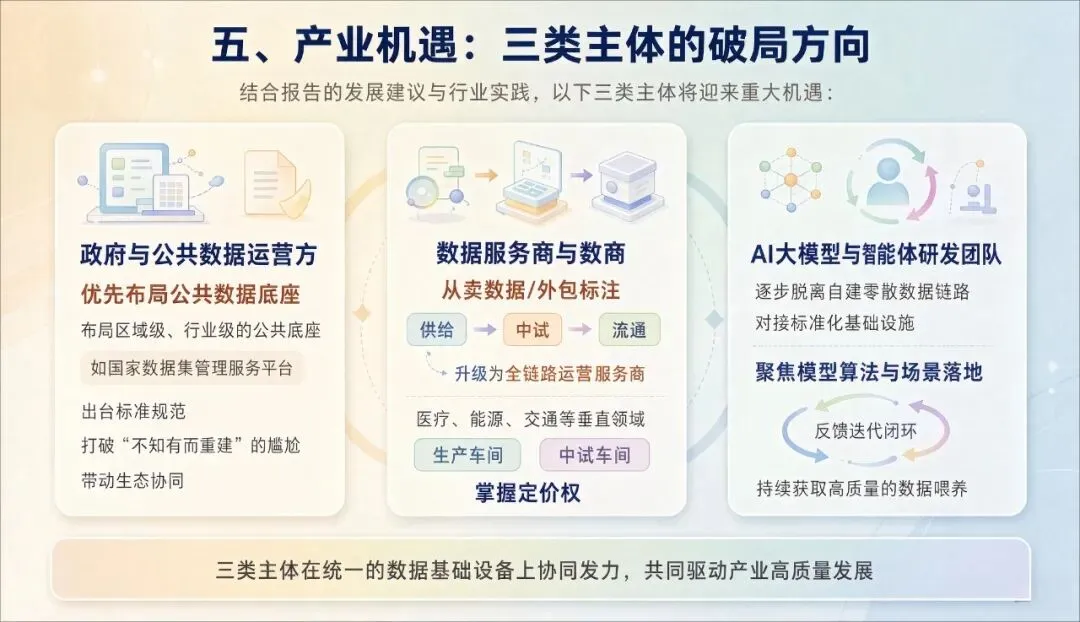
👉 政府与公共数据运营方应优先布局区域级、行业级的公共底座(如国家数据集管理服务平台),出台标准规范,打破“不知有而重建”的尴尬,带动生态协同。
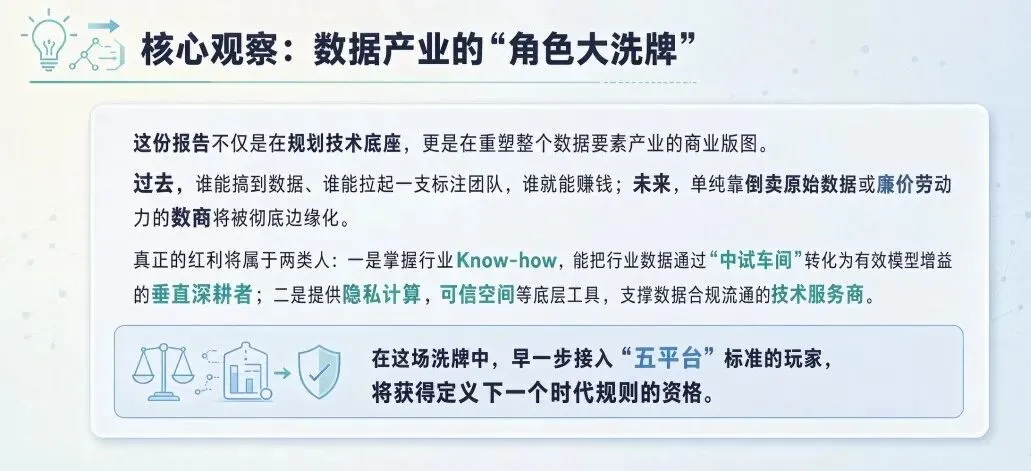
👉 数据服务商与数商必须转型:从单纯的“卖数据”或“接外包标注”,升级为提供“供给-中试-流通”全链路运营的服务商。特别是在医疗、能源、交通等垂直领域,谁能率先建成行业专属的“生产车间”和“中试车间”,谁就能掌握定价权。
👉 AI大模型与智能体研发团队应逐步脱离自建零散数据链路,对接标准化基础设施。把精力放在模型算法和场景落地上,通过基础设施的“反馈迭代”闭环,持续获取高质量的数据喂养。
六、 报告建议:构建高质量数据集的“五大抓手”
在报告的最后,编制组从宏观视角出发,为产业界给出了五条极具落地价值的推进路径:
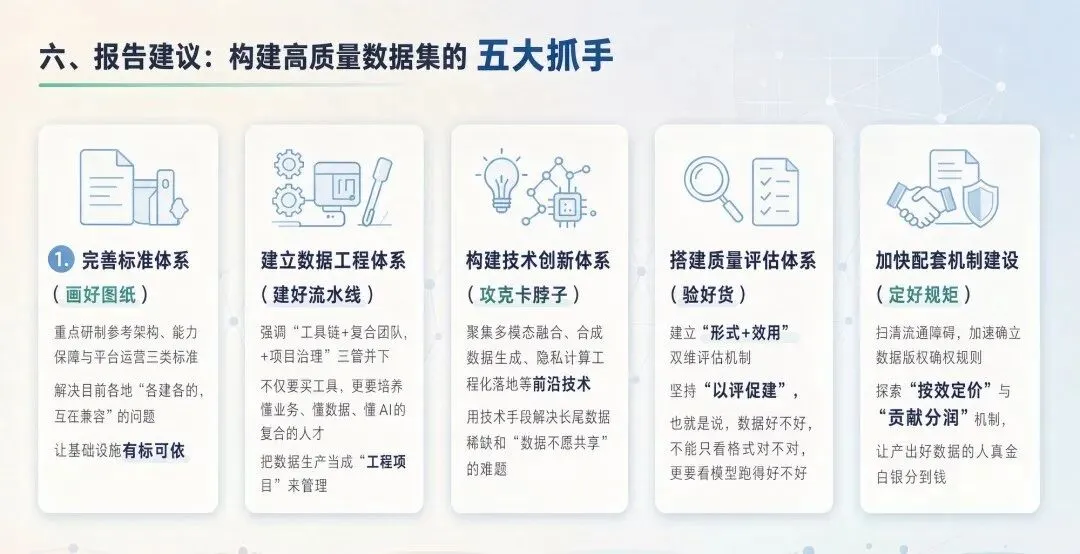
1. 完善标准体系(画好图纸)重点研制参考架构、能力保障与平台运营三类标准。解决目前各地“各建各的、互不兼容”的问题,让基础设施有标可依。
2. 建立数据工程体系(建好流水线)强调“工具链+复合团队+项目治理”三管齐下。不仅要买工具,更要培养懂业务、懂数据、懂AI的复合型人才,把数据生产当成“工程项目”来管理。
3. 构建技术创新体系(攻克卡脖子)聚焦多模态融合、合成数据生成、隐私计算工程化落地等前沿技术。用技术手段解决长尾数据稀缺和“数据不愿共享”的难题。
4. 搭建质量评估体系(验好货)建立“形式+效用”双维评估机制,坚持“以评促建”。也就是说,数据好不好,不能只看格式对不对,更要看模型跑得好不好。
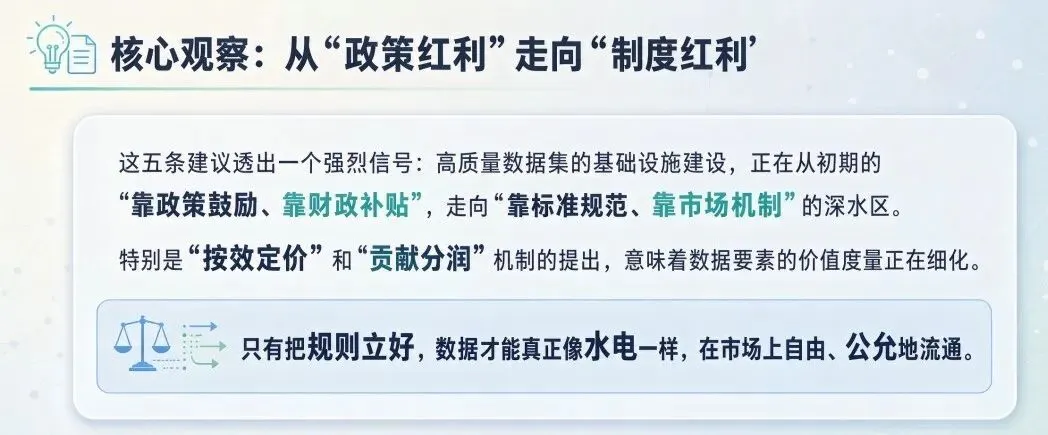
5. 加快配套机制建设(定好规矩)扫清流通障碍,加速确立数据版权确权规则,探索“按效定价”与“贡献分润”机制,让产出好数据的人真金白银分到钱。
七、数界总结
大模型上半场拼算力,下半场拼高质量数据。这份报告的最大价值,是把数据集从一次性交付的“成果”,升级为一套可运营、可持续迭代的“基础设施能力”。
面向未来,谁率先跑通这套包含“三大车间”的底座体系,谁就能让数据飞轮转起来,在垂直智能、智能体、具身智能等赛道抢占先机。
🎁 完整版报告获取方式:
受篇幅限制,本文为报告核心精编解读版。原报告包含更详细的技术架构图、各行业(城市治理、医疗、能源、交通)的落地实践案例。
👉 获取方式:
点击下方关注公众号【数界研析】。
在公众号对话框回复关键词 “基建报告”。
即可免费下载 《面向高质量数据集的数据基础设施研究报告》完整版PDF。
(如果你想看哪个行业的具体实践,欢迎在评论区留言,我们后续会出文拆解。)