研报速递
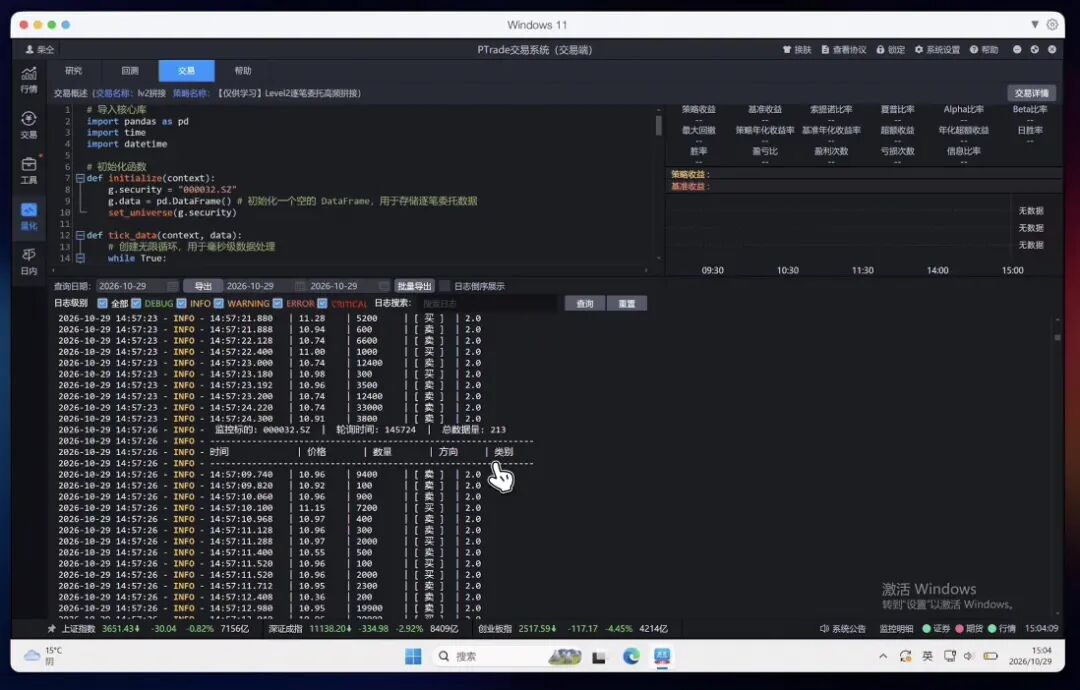
众所周知,tick数据是3s刷新一次,而Level2数据是逐笔实时刷新。
数据颗粒度不一样,那策略的速度自然也就天差地别,这里很明显后者更快。
那怎么获取Level2数据呢?
先科普个小知识,咱们量化用的Level 2数据,不是花钱买来用肉眼看的那个图表。
那是给人眼做分析用的,而量化里的 Level 2 数据是给计算机做分析用的,通过函数接口来调取。
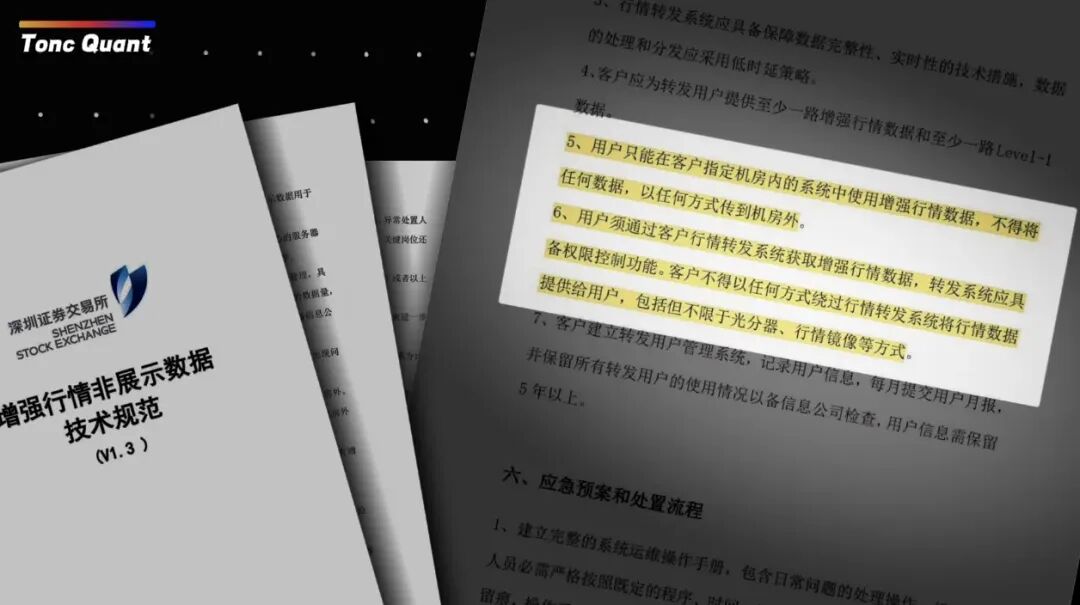
另外根据相关规定,这种非展示Level2数据不能离开券商机房。
所以外面那些在售的实时lv2数据基本都属于擦边行为,需要谨慎。
那其实想要获取实时lv2数据,压根也不需要去外面付费。
我们完全可以通过PTrade来免费调取实时lv2数据。
由于PTrade本身就在券商机房运行,所以不用担心合规问题,免费又高效。
ok,我们直接打开 PTrade API文档,找到「获取逐笔成交行情」这个函数。
来看看怎么用它白嫖 Level 2 数据。
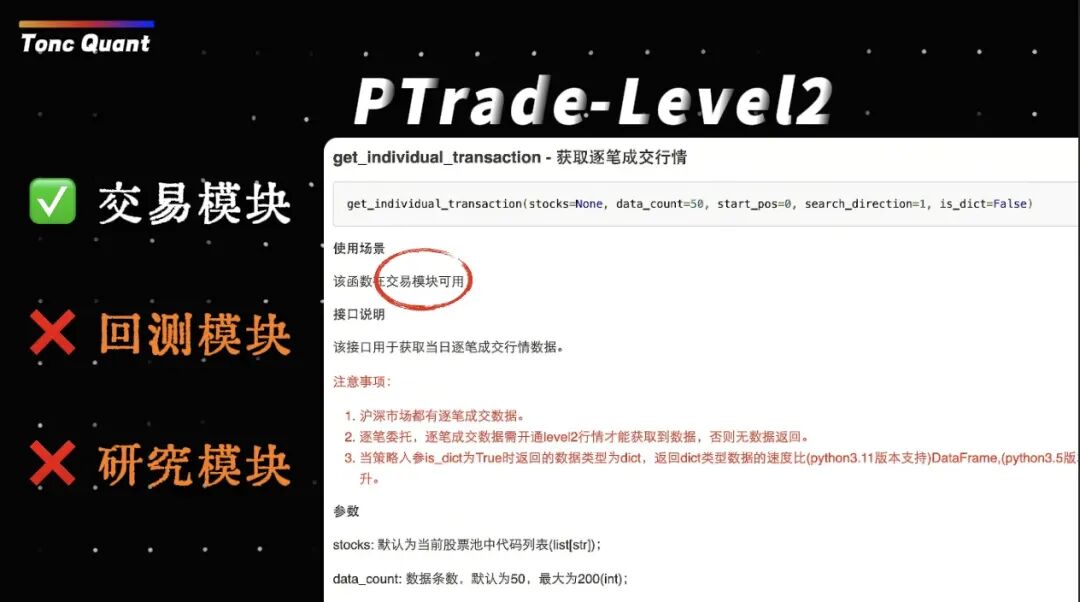
这里使用场景限定在交易模块。
也就是说只能在实盘交易的时候调取,像平常在回测、研究策略时,就不能调取了。
这样做估计也是为了减小服务器压力,保障实盘体验,可以理解。
下面我们来看看每一个参数的具体作用~
先看第一个参数 stocks,它决定我们要抓哪些股票的逐笔成交数据。
填一个代码,就只抓这一只;填两个代码,就同时抓这两只。
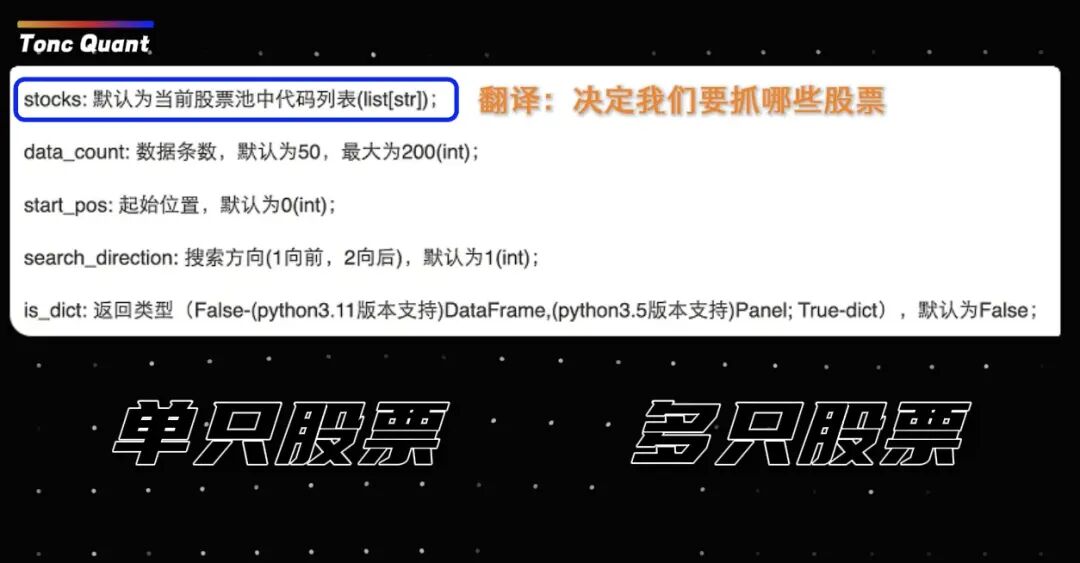
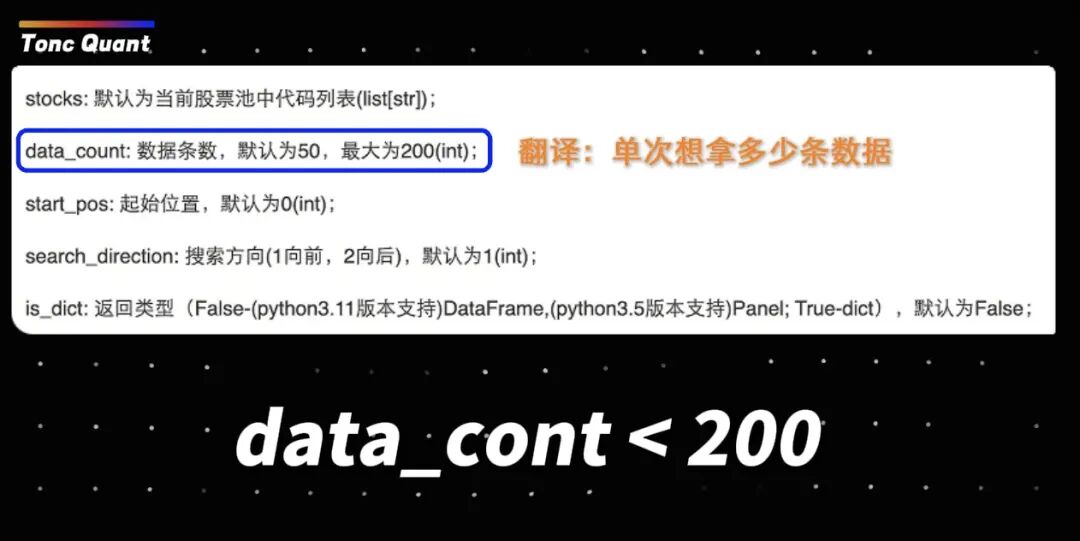
接下来是 data_count,也就是一次想拿多少条逐笔成交数据。
填 50,就是拿 50 条。注意,一次最多只能拿 200 条。
但这也不是啥大问题,我们可以分批多拿几次。
好的,接下来这两个参数有点难懂,我们先捋捋。
假设交易所下发逐笔数据到PTrade, 这时PTrade会生成一个数据库,专门存放源源不断推送过来的数据。
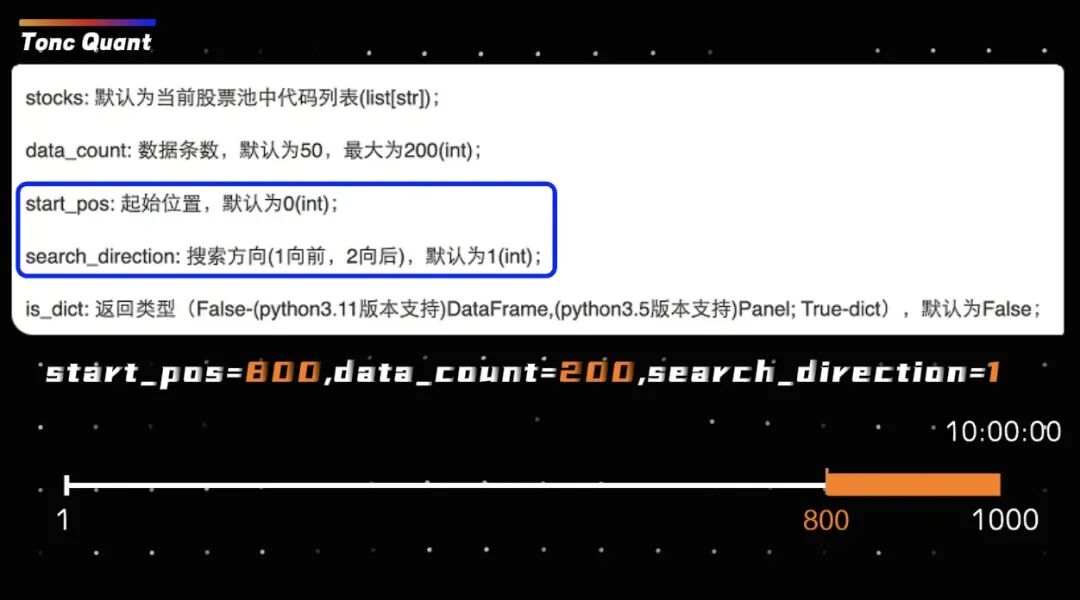
比如在早上十点,系统内部的逐笔成交数据缓存区大概有 1000 条数据,编号从 1 到 1000。
那start_pos就可以理解为我的起点,search_direction 决定我向前跑还是向后退,而data_count 则是我要跑的步数。
比如设置 start_pos 等于 800、data_count 等于 200、search_direction 等于 1。
也就意味着我要从800的位置向前跑200步到编号1000的位置,这就是获取最新的 200 条逐笔成交数据。
那如果把参数改成 start_pos 等于 200、data_count 等于 200、search_direction 等于 2。
这就意味着,我要从200的位置往后退200步到编号1的位置,也就是获取当天时间最早的200条数据。
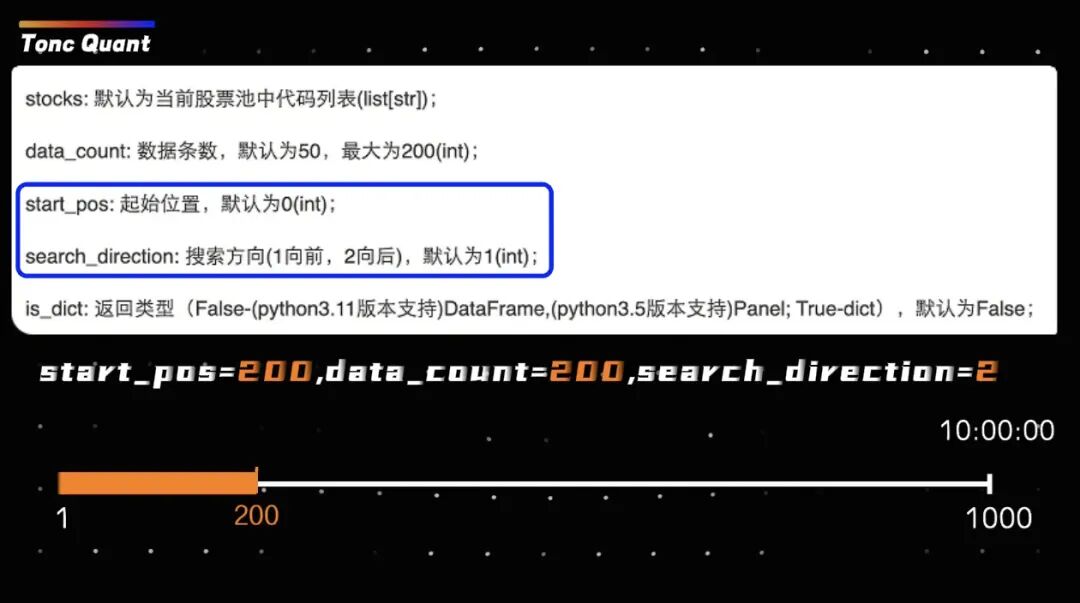
这样一来,通过控制 start_pos 的位置来分批次请求,就能获取到一整天的lv2逐笔成交数据,既没有遗漏,也不会重复。
最后这个【is_dict:返回类型】填True就是以字典格式返回数据,填False 就是以表格形式返回数据。
建议填 True,这样速度更快,可以提高策略性能。
这里我们放一段完整的代码示例。
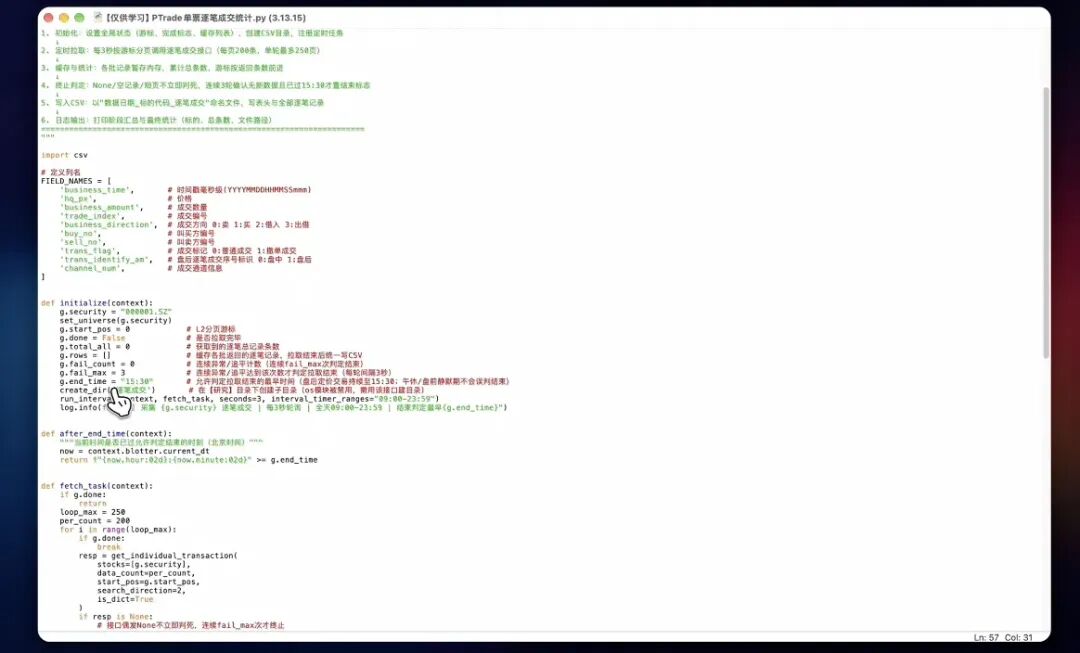
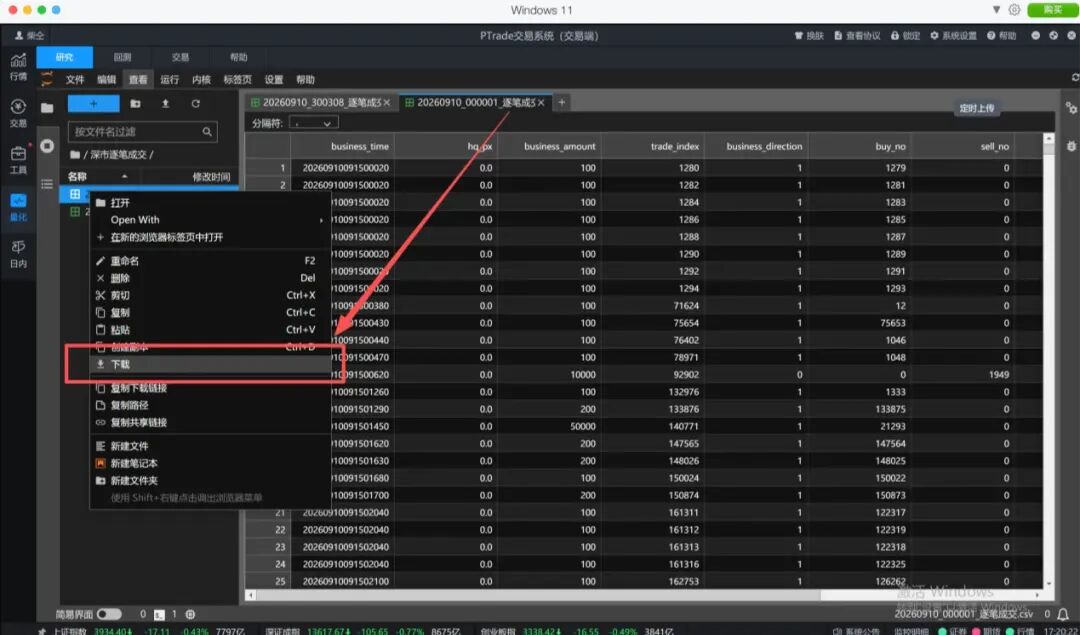
另外,用PTrade获取到lv2数据后,我们还可以将它保存到研究目录下。
然后手动从这里以表格形式下载到本地电脑,用来做数据分析。
是不是夯爆了?
好的,那以上就是 PTrade 策略交易中 Level 2 数据的获取方法。
文中涉及到的代码我也整理好了,大家可以拿去测试验证一下。
我们下期再见!
专业创造价值,量化穿越牛熊
下面是我准备的一些量化感兴趣的后台找我