研报速递
本期信熹研究聚焦共封装光学(CPO)这一光互连演进的关键方向。报告从光互连的必要性出发,梳理从可插拔光模块到CPO的技术演进脉络,分析CPO对光互连价值分配格局的重构,并研判其量产时点与市场规模;进而系统对比“快而窄”与“慢而宽”两条技术路线下的五种实现方案;同时梳理海外领导者与国内企业的产品布局;最后对产业格局与技术走向进行总结。
一、概述
1.1 | 为什么需要光互连
大模型计算正从单机计算向大规模分布式计算演进,一方面,单一集群内的GPU数量持续增长;另一方面,AI集群的物理范围也开始横跨多个数据中心。分布式计算需要GPU在训练和推理过程中持续进行大规模数据交换,例如数据并行需要不同GPU在完成局部计算后同步梯度、模型并行需要位于不同GPU上的模型分片交换中间结果、MoE等架构还会产生不同专家之间的All-to-All通信,因此计算与通信贯穿整个模型运行过程。
历年来,计算吞吐量呈现每2年翻3倍的趋势,但互连带宽仅提升1.4倍(图1(a)),从而造成了“带宽墙”。即影响整体效率的关键制约因素变成了移动、访问和存储数据所造成的延迟和能耗开销。由于制造工艺成熟且与CMOS技术兼容,电互连在短距离通信中仍不可或缺,但其带宽密度和能效受限于铜线本身的固有特性,会随着通信距离的增加而迅速恶化(图1(b))。
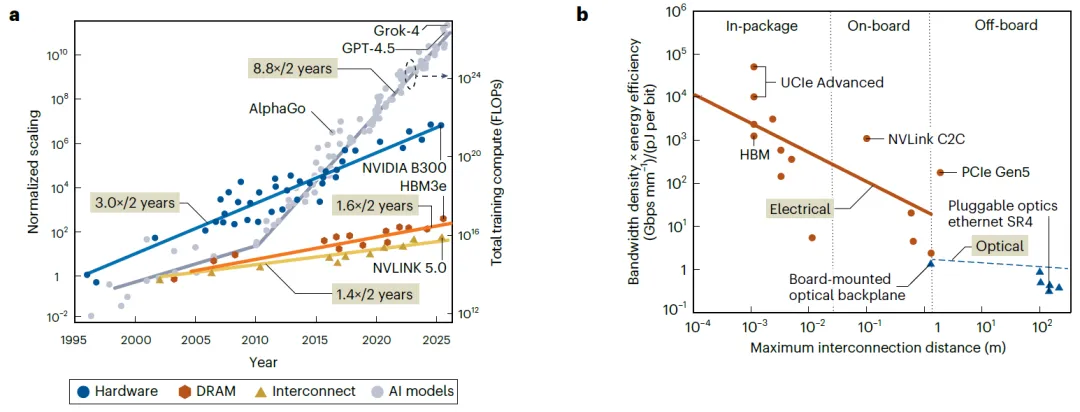
图1 | (a)带宽增长趋势,(b)电互连的带宽能效随距离大幅下降
(来源:文献[1])
AI集群的互连架构如图2所示,分为Scale-up(单节点内芯片间互连)、Scale-out(跨节点互连)和Scale-across(跨数据中心互连)三个层级,目前在Scale-out和Scale-across层级均使用的是光互连,主要为可插拔光模块,在Scale-up层级则使用的是铜缆电互连。
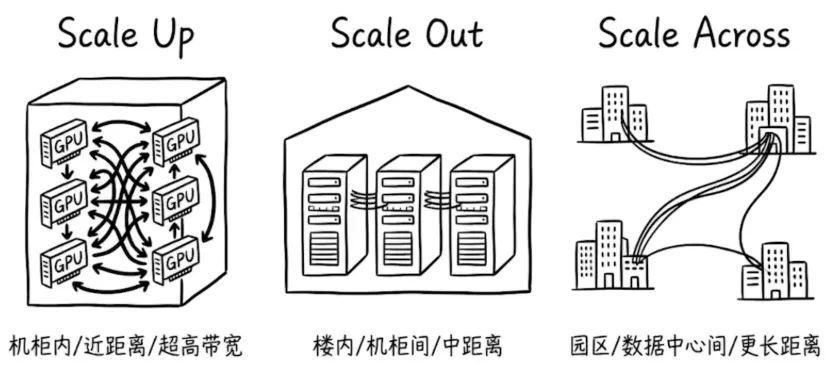
图2 | AI算力集群的互连架构
(来源:网络[2])
Scale-up承载着GPU之间的全互连(All-to-All)通信,在AI模型训练阶段占数据中心总带宽的80%以上。当前基本都采用的是电互连,要进一步提升带宽密度,唯一的选择就是提高比特率,代价是牺牲传输距离和增加功耗。200G PAM4速率下无源铜缆的传输距离已不足一米,要延长传输距离,只能依靠有源铜缆(ACC),3米传输距离需额外消耗1.1 pJ/bit。而且,ACC也无法解决带宽密度问题。NVIDIA的NVL72机柜内部包含超过5000根无源铜缆,总长约3.2公里,截面为1.5 mm²,机柜内部有限的空间最终决定了带宽密度的上限。随着华为与Google各自规划超过9000颗算力芯片的超节点,Scale-up的链路长度正从1米级扩展到30米级,光互连成为唯一可持续的选项。
1.2 | 光互连的演进:从可插拔到共封装光学(CPO)
能效是光互连最重要的指标之一,传统的可插拔光模块存在“互连损耗高、功耗占比大”的痛点。可插拔光模块的损耗如图3所示,可以看到,信号频率越高,集肤效应越明显,铜走线的导体损耗越大,在200G PAM4速率下,仅将数据从处理器搬到可插拔光模块,就需要克服ASIC封装、PCB走线、过孔和连接器等多段累计约22 dB的损耗。
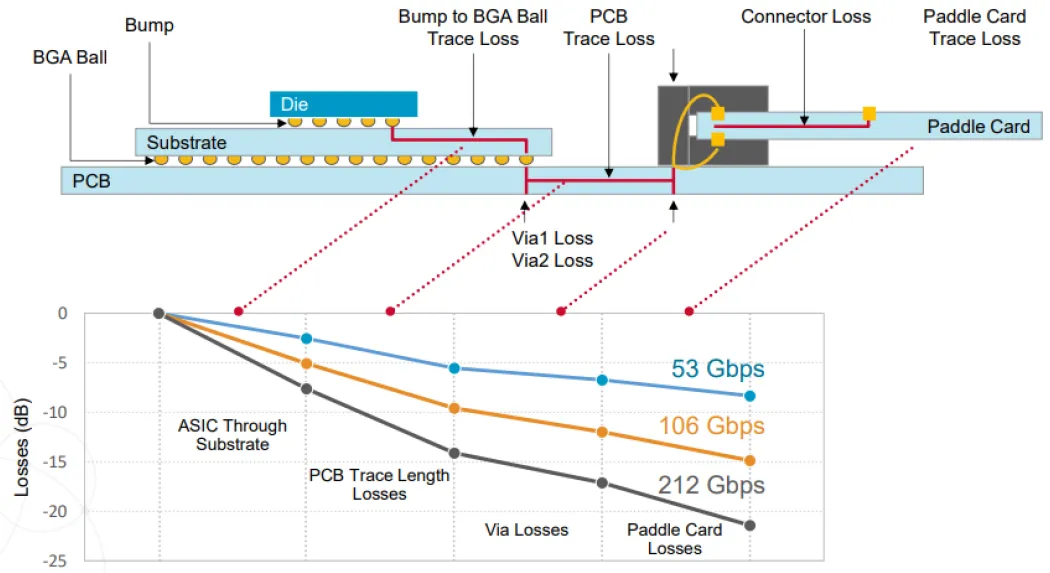
图3 | 可插拔光模块的累积电损耗分布
(来源:Broadcom,文献[3])
另外,高速信号通过较长电路传输后会产生衰减和失真,在发送端和接收端需要利用均衡、时钟恢复及DSP等方式重新恢复信号。因此,电通道越长、速率越高,相应的信号调理复杂度和功耗压力也越大。
根据文献[4]的数据,在200G PAM4速率下,将数据从处理器搬到可插拔光模块消耗约3.5 pJ/bit。要达到10米及以上距离,主流技术是内置 DSP的可插拔模块,这类模块自身约消耗10 pJ/bit,整链能效为13.5 pJ/bit。若要提升能效,在光引擎(OE)线性度足够好的前提下,可以去掉模块内的DSP,这就是所谓的线性驱动可插拔光模块(LPO),代价是SerDes侧要做更多处理,LPO典型的整链能效约为10 pJ/bit。
光互连的演进,本质上是光电转换点不断向交换芯片和算力芯片靠拢、高速电连接持续缩短的过程。如图4所示,这一演进可分为五个阶段:可插拔光模块(Pluggable)、板载光学(OBO)、近封装光学(NPO)、共封装光学(CPO)和光输入输出(OIO)。其中,OBO将光模块移至板上,能效改善有限,难以成为主流;NPO以极短PCB通道连接ASIC与光引擎,是能效与可维护性之间的折中;CPO将光引擎与交换芯片安装到同一封装基板上,电通道损耗和阻抗不连续性大幅下降;OIO则进一步把光I/O直接集成到计算与存储芯片上,以光I/O取代传统电I/O。
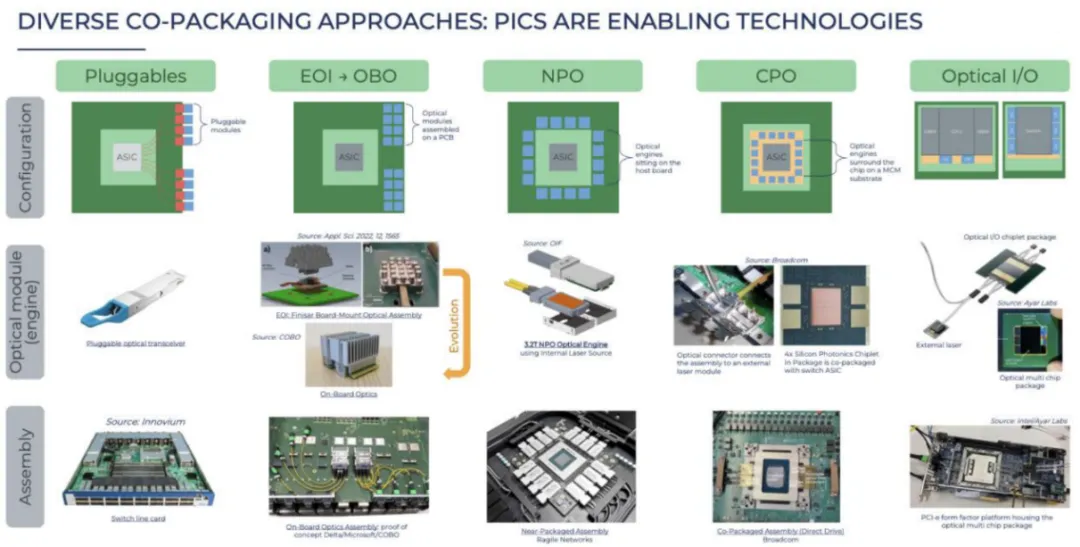
图4 | 光互连的演进历程
(来源:YOLE官网,文献[5])
需要说明的是,演进历程的CPO指狭义的交换芯片共封装,业内也常将光器件与电芯片共封装的方案统称为广义CPO,OIO亦可归入。本文后续所述CPO为广义CPO。
1.3 | CPO重构光互连的价值分配
当传统可插拔光模块向CPO方案演进,独立模块外壳、模块PCB以及前面板插槽和高速连接器的需求将相应减少。同时,随着ASIC与光引擎之间的高速电连接距离缩短,原本用于补偿较长电通道损耗的DSP功能也会部分削弱或重新整合至ASIC/EIC侧。与此同时,PIC、EIC、激光器等核心光电功能仍然存在,光模块功能由独立产品形态拆解为多个封装级和系统级功能模块。
光引擎进入交换芯片或计算芯片封装后,光引擎中的EIC和PIC需要完成更高密度的异质集成(图5),PIC还需要直接建立与光纤的低损耗光学连接。与此同时,测试也从传统光模块成品测试扩展至晶圆、光引擎和最终CPO产品多个阶段。图6展示了光模块主要部件或环节的价值变化。
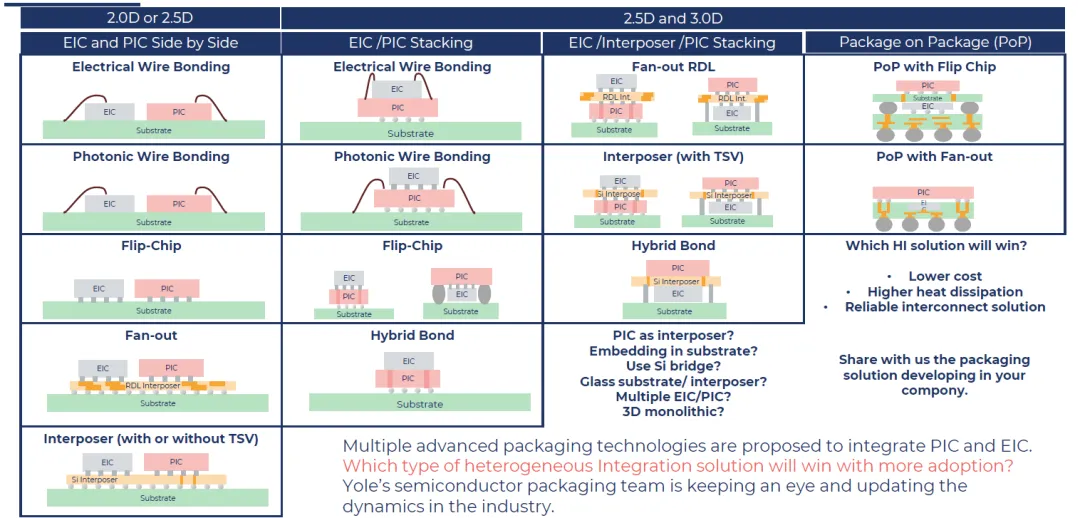
图5 | 光引擎中的EIC和PIC的异质集成方案
(来源:文献[6])
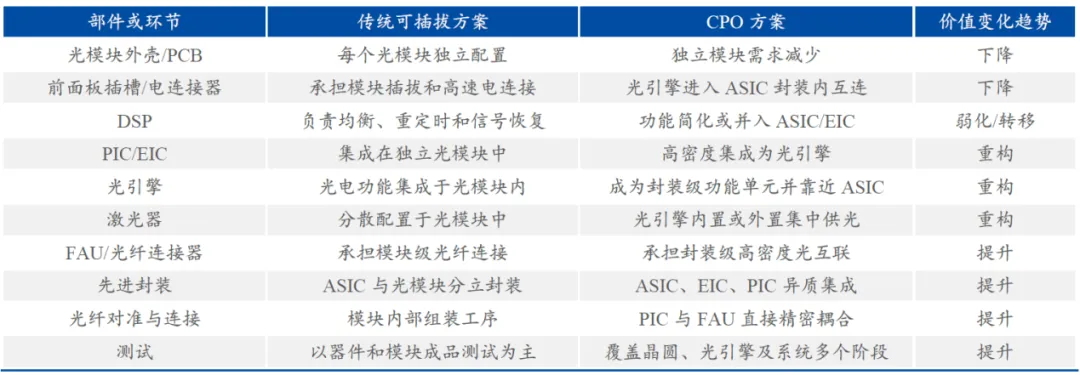
图6 | CPO重构光模块价值分配
(来源:文献[3])
1.4 | CPO量产时点与市场规模
NPO作为可插拔光模块到CPO的过渡形态,量产时间在2027年。CPO正由试点验证进入量产导入,不同应用场景的产业化节奏存在明显差异。如图7所示,面向网络交换的CPO已由概念验证进入量产爬坡阶段,Broadcom和NVIDIA是当前的主要推动者。面向HPC/AI、内存解耦和资源池化等Scale-up场景的CPO整体仍处于概念验证和试点测试阶段,规模部署时间相对更晚。
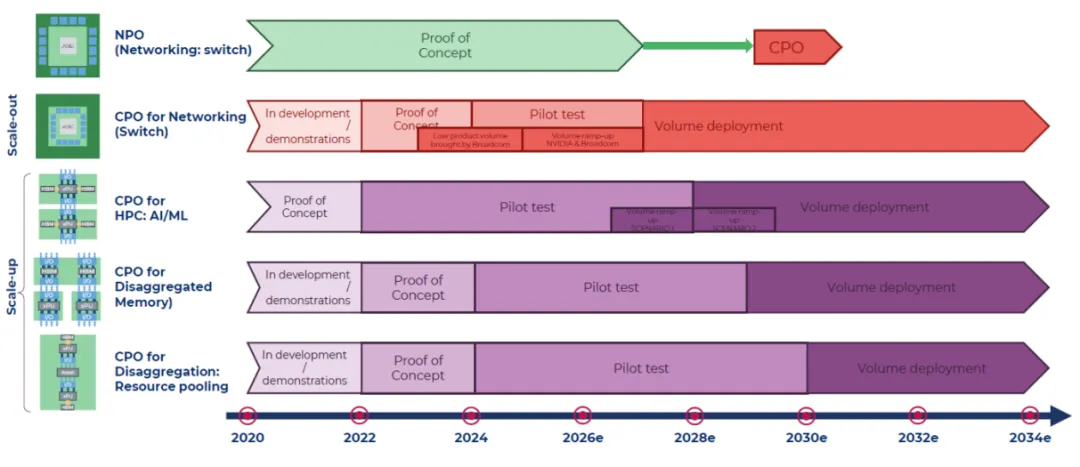
图7 | CPO量产时点
(来源:文献[6])
Broadcom的CPO路线目前已经迭代至第三代,2021年第一代TH4-Humboldt用于积累早期制造经验,第二代TH5-Bailly是首个定义量产的CPO方案,已在Delta Electronics和Micas Networks协助下导入量产,2025年第三代TH6-Davisson将单通道速率提升至200G、交换容量提升至102.4T,已向早期客户送样。
NVIDIA于2025年同时推出面向InfiniBand的Quantum-X Photonics和面向以太网的Spectrum-X Photonics两条CPO交换机产品线。其中,Quantum-X Photonics产业化进展相对领先,Lambda于2026年3月披露,其采用Quantum-X Photonics CPO交换机构建的AI集群已经覆盖超过1万颗NVIDIA GB300 GPU,并投入生产运行。与此同时,Spectrum-X Photonics也于2026年进入生产,并向部分合作伙伴出货,预计下半年进一步扩大产能。
随着Broadcom、NVIDIA等厂商陆续推进CPO量产和客户导入,CPO正由早期产品验证逐步进入商业化放量阶段。根据天孚通信港股招股书援引的弗若斯特沙利文数据,2025年全球CPO市场规模仅约1亿美元,预计2026-2027年分别增长至4亿美元和18亿美元,并于2030年达到286亿美元。同期全球数据通信光互连市场预计由2025年的162亿美元增长至2030年的887亿美元,CPO有望由当前占比较低的新兴方案成长为光互连市场的重要组成部分。
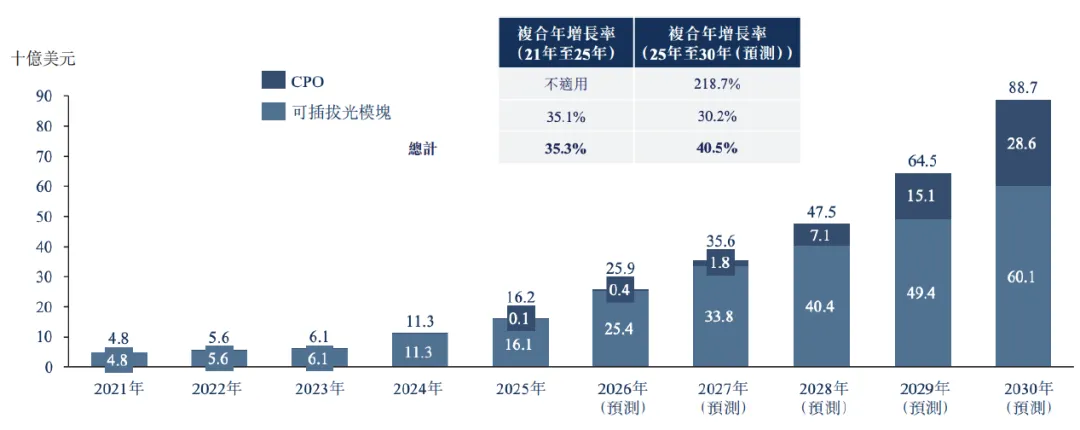
图8 | 全球光互连和CPO的市场规模
(来源:天孚通信港股招股书,弗若斯特沙利文,文献[3])
二、技术路线
2.1 | 两条路线:快而窄(FaN)与慢而宽(SaW)
CPO光互连存在两条基本路线。其一是“快而窄”(Fast-and-Narrow,FaN):单通道速率大于100G、采用PAM4调制,以较少通道数叠加总带宽,优势是可沿用现有铜互连的SerDes与协议生态,但持续提升速率会恶化驱动电路能效并迫使引入DSP。其二是“慢而宽”(Slow-and-Wide,SaW):单通道速率降至64G以下、退回NRZ调制,以大量低速并行通道叠加总带宽,低速带来的高信噪比允许移除DSP与前向纠错电路,显著简化电子链路并降低接收端所需光功率。
2.2 | 方案一:FaN VCSEL
VCSEL即垂直腔面发射激光器,属于直接调制方案,通过改变注入电流直接完成电光转换,不需要独立调制器与外置激光源。VCSEL在可插拔光模块中已有25年应用历史,累计出货数亿只,是成熟度最高的光发射器件;其光斑圆形对称、对反射光不敏感,通常一个透镜即可高效耦合进光纤,可省去隔离器,结构天然简化。
该路线的标志性进展是2026年发表于IEEE JSSC的108G PAM4 VCSEL直调光引擎样机(图9):光引擎能效仅0.9 pJ/bit,整链(含UCIe接口)预计约2 pJ/bit,以此构建3.2T tile仅需32颗VCSEL。目前200G/lane VCSEL已接近实现,意味着该路线可在与铜完全相同的SerDes与协议体系下平滑升级,互操作性最好。
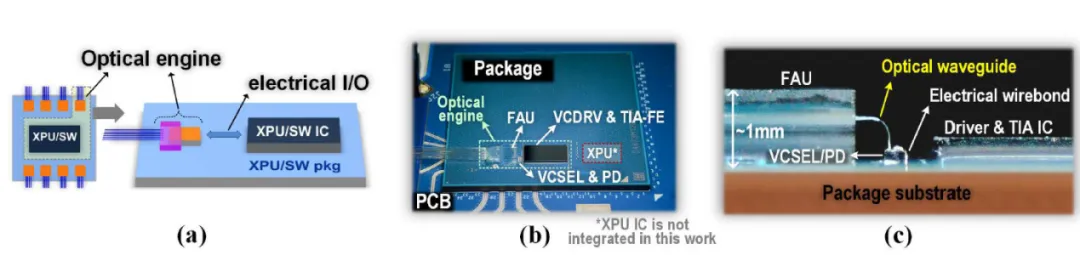
图9 | 108G PAM4 VCSEL直调光引擎概念与封装实物
(来源:文献[7])
可靠性方面,Coherent的100G VCSEL在120结温下FIT低于0.05,即使按每通道0.2 FIT的上限估算,32×100G的3.2T tile的FIT约6.4,满足CPO不可更换器件的可靠性要求。该路线的主要约束在传输距离,多模光纤的模式色散将100G FaN链路限制在100至150米,但对1至30米的Scale-up场景并不构成实质障碍。
2.3 | 方案二:FaN硅光调制
这是当前Scale-out侧CPO的主流路线,NVIDIA与Broadcom的量产CPO交换机均采用该方案。其架构属于间接调制:激光器与调制器分离,光引擎通过ELSFP外置激光模块获取连续波激光,再由硅光调制器完成电光转换(图10)。激光器对温度敏感,外置后便于散热、维护与独立升级,但也带来额外的光纤连接与耦合损耗,同时会推高成本。
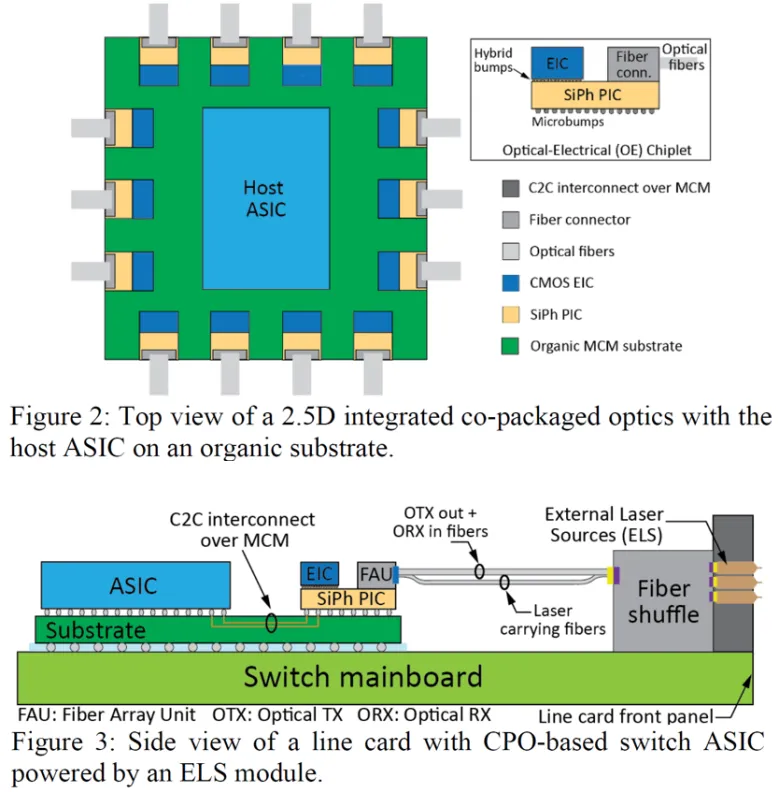
图10 | NVIDIA的外置激光光源加硅光光引擎方案
(来源:文献[8])
硅光调制器主要有MZM(马赫-曾德尔调制器)和MRM(微环调制器)两类。
其中MZM由输入Y型分支器、两个平行波导臂和输出Y型分支器构成,通过电极施加电压改变波导折射率,使两臂产生相位差,再经干涉实现光强调制。其优势是工作波长范围宽、热稳定性强、传输距离远,支持多波长波分复用。但是它的器件尺寸偏大,通常在毫米级,驱动电压也大,单芯片可集成的通道数与能效比提升空间因此受限。Broadcom量产的第二代CPO交换机即采用的该方案,后续开始转向MRM方案。
MRM采用的是环形谐振腔结构,由环形波导与总线波导耦合构成,在微环PN结上施加电压改变有效折射率,使谐振波长漂移,实现光强调制。其器件尺寸极小,通常在数微米至数十微米,驱动电压低,通过多微环阵列与波分复用组合,单颗PIC就能支撑上百个高速光通道,在集成密度上更具优势。短板是谐振波长对温度高度敏感,高温下易出现波长漂移,必须配套温控与热补偿设计。NVIDIA量产的CPO交换机即采用的该方案。
量产验证数据来自Meta对Broadcom Bailly 51.2T CPO交换机的大规模评估(文献[9])。实测CPO光学功耗较2×400G FR4可插拔模块降低约65%(每800G由约15.5W降至5.4W),在120颗光引擎、240颗外置激光器的统计规模下,应力环境中超过100万400G端口设备小时未出现一次链路抖动,0.8T光引擎tile不可维修失效率低于66 FIT。可靠性提升结合链路抖动消除,可使大模型训练因网络故障重启造成的成本下降约50%。硅光光引擎当前能效约6.7 pJ/bit,含SerDes整链约8 pJ/bit,仍有改进空间。
2.4 | 方案三:SaW硅光微环(波分复用)
硅光微环同样可走SaW路线:在同一根总线波导上集成大量谐振波长错开的微环,以波分复用而非提高单波速率的方式扩展带宽,单通道退回NRZ低速调制,从而移除DSP并简化SerDes。该路线的代表是Ayar Labs,其TeraPHY光引擎以UCIe标准接口与主芯片连接(图11),整链能效低于5 pJ/bit,公司已将其方案定义为可投入生产。
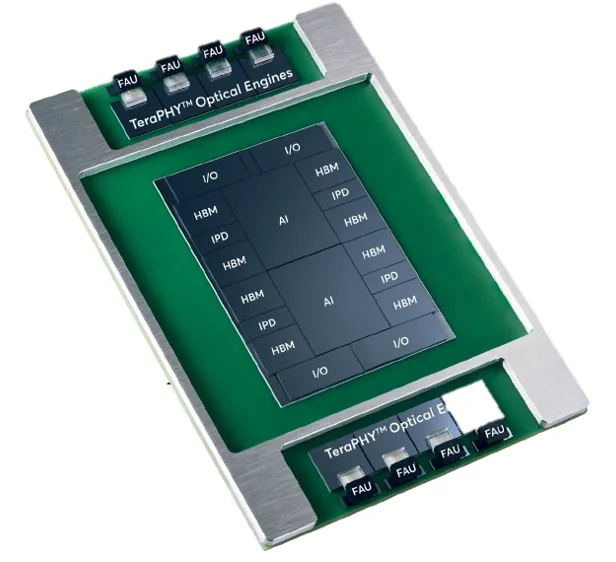
图11 | Ayar Labs TeraPHY光引擎与AI芯片共封装
(来源:文献[10])
该路线的能效天花板很高:微环调制本身能耗极低,学术界已在三维集成架构下演示10G/lane时光引擎能效0.3 pJ/bit,结合UCIe接口有望实现0.5至0.6 pJ/bit的整链能效。主要挑战在光源侧,波分复用需要同时产生大量波长的频率梳激光源。其次,微环阵列须逐环锁定到对应波长,控制复杂度高。另外,单根波导上串联多个谐振器件,任一环节失效可能波及相邻通道,冗余设计不如并行架构直接。
2.5 | 方案四:SaW Micro-LED阵列
Micro-LED以氮化镓为基底制备微米级发光单元,可见光波长可直接用标准CMOS工艺高效探测,无需昂贵的高速探测器,器件占位小且与CMOS共集成成熟。微软和Avicena是这项技术的主要研发推动者,图12展示了Avicena的Micro-LED阵列光引擎,其集成304个并行通道,单通道速率约3.5~4 Gbps,总带宽约1.2 Tbps,光链路能效小于1 pJ/bit。但Micro-LED存在光谱宽、发射轮廓广的问题,和光纤的耦合难度较大,所以它依赖成像光纤束里的空间复用技术来实现通信。该路线的短板主要在单通道速率和传播距离。
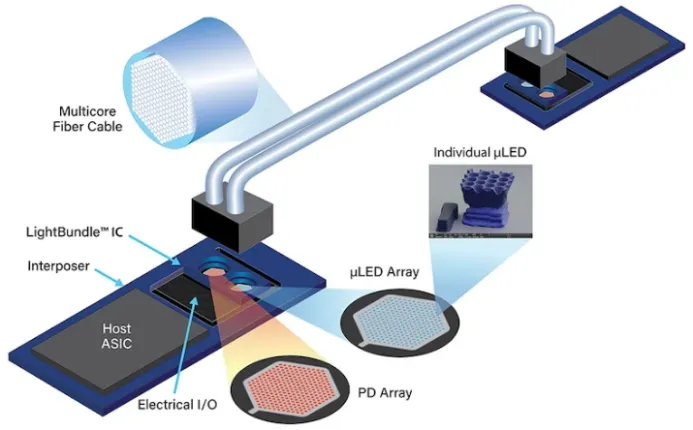
图12 | Avicena的Micro-LED阵列光引擎方案
(来源:网络,Avicena)
2.6 | 方案五:SaW VCSEL阵列
SaW VCSEL阵列与Micro-LED路线同属空间复用,但光源由LED换为VCSEL。优势在于光纤耦合容易、传输距离更长、单通道速率更高。其系统构型如图13所示,XPU信号经UCIe后直达光引擎,VCSEL与探测器阵列通过透镜与多芯光纤耦合,光纤纤芯与阵列通道一一对应。
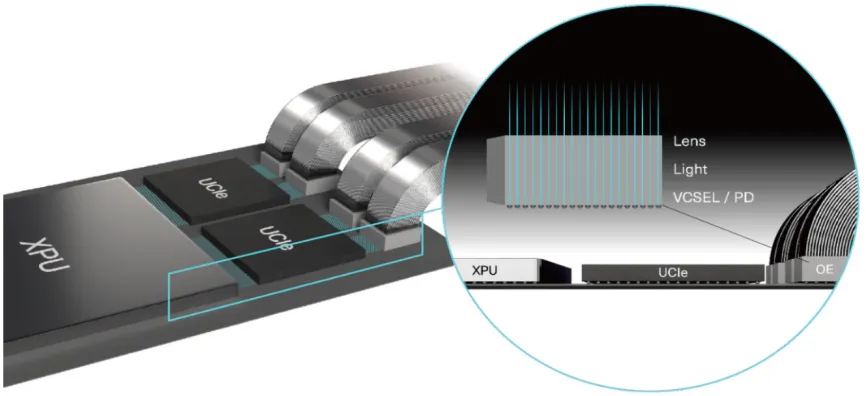
图13 | Coherent的VCSEL阵列光引擎方案
(来源:文献[4])
VCSEL在0.5 mA驱动电流下即可实现约15 GHz带宽,配合电压驱动发射端与低电容探测器,预计32G NRZ阵列整链能效约0.75 pJ/bit,进一步在4G/lane速率下去除TIA、采用电阻负载探测,有望降至0.5 pJ/bit。
可靠性方面,SaW架构允许低成本地配置冗余通道。如图14所示,在阵列中增加9%的备份通道即可将FIT降低一个数量级。
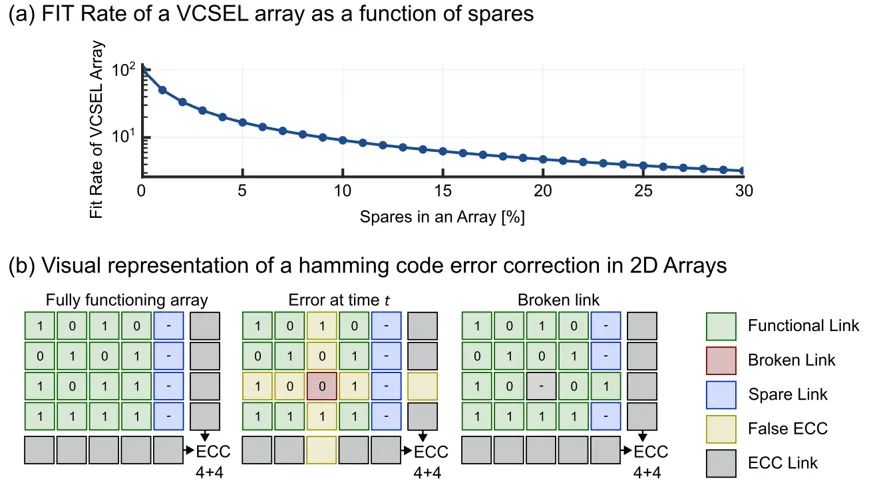
图14 | 冗余备份对VCSEL阵列FIT的改善及二维阵列纠错示意
(来源:文献[4])
三、企业与产品
3.1 | 海外领导者企业及其产品
在CPO领域的海外领导者企业及其产品性能如图15所示,其中Broadcom、NVIDIA、Ranovus使用的是FaN硅光调制技术,Ayar Labs、Intel、Lightmatter使用的是SaW硅光微环技术,Avicena、Microsoft使用的是SaW Micro-LED阵列技术,Celestial AI(已被Marvell收购)使用了SaW的EAM硅光调制方案。
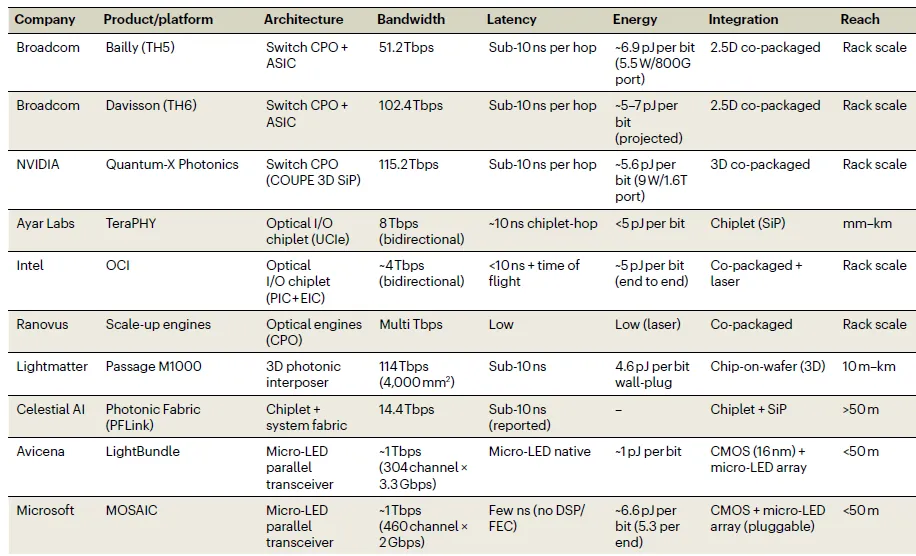
图15 | 典型的CPO产品
(来源:文献[1])
3.2 | 国内企业及其产品
与海外由Broadcom、NVIDIA等平台及芯片巨头主导不同,国内缺少交换机或GPU芯片巨头主导,CPO行业整体处于零部件“技术验证向工程化、送样过渡”阶段,尚无规模级量产产品。
3.2.1 | 可插拔光模块硅光芯片量产企业
第一梯队是光模块上市企业,如中际旭创、新易盛等。第二梯队有羲禾科技、塞勒科技、熹联光芯等未上市企业。
羲禾科技(上海)是全球最主要的独立第三方硅光芯片公司之一,400G/800G/1.6T光模块对应的硅光芯片已规模量产,累计出货超1200万颗、2025年全球市占约13%位列第二。单波400G样品完成,3.2T/6.4T NPO/CPO收发一体芯片2026年上半年已实现首批销售,并成为某云厂商该品类唯一中标方。2026年10月14日科创板过会。
赛勒科技(上海)由MIT甘甫烷团队创立,坚持纯硅高速调制器与EPIC光电共集成的差异化路线。单波100G/200G已量产,400G完成突破并规划2027年小批量,400G/800G/1.6T光模块量产。2026年4月获光莆股份5000万元增资,持股5.88%。
熹联光芯(常州)2021年并购德国Sicoya形成中德双引擎,走SiN-SOI与EPIC单片集成路线。单波200G已量产,800G DR8规模量产、1.6T批量交付,CPO/NPO与单波400G在储备中。B5轮融资数亿元,常州10亿元基地达产后规划年销20亿元。
3.2.2 | NPO/CPO硅光光引擎新势力
曦智科技(上海)是港股上市公司,在光计算与光互连双线布局。3.2T NPO单芯片集成16路53/106Gbaud调制与探测通道(带宽均超55GHz),已完成流片验证。6.4T NPO将Driver/TIA与32通道硅光芯片在封装内集成。2026年WAIC联合交换机ASIC企业推出51.2T CPO交换机原型,自研光引擎配国产硅光工艺,整机功耗降30%、光互连功耗省60%。
光联芯科(北京)是国内OIO首家独角兽,通过自研的设备把微环量产良率从不足10%提升至99%。产品包括3.2T光引擎、量子点晶圆及微环波长修调用无掩膜光刻设备。2026年A轮近5亿元、A+轮近10亿元,投后估值超10亿美元。
芯光界(上海)以国际硅光团队为班底,按“NPO切入、CPO主流、OIO布局”推进,首款NPO光引擎已进入头部GPU与数据中心客户验证。2026年5月成立,五个月内完成五轮融资、累计近10亿元。
芯界光核(上海)脱胎于上海交大光通信全国重点实验室,硅光PIC单波100至400G已进入量产阶段、基于3D光电合封的光引擎计划2026年底送样。2026年1月成立,9月完成数亿元天使轮融资。
澜昆微电子(上海)2026年9月发布国内首款符合OCI MSA的微环光I/O芯片Denali:单片集成上百个微环谐振器与大规模波导光路,构建单纤8波长WDM架构、单芯片3.2Tb/s,电子侧UCIe接口达1Tbps/mm,基于格罗方德45SPCLO工艺流片。2026年6月完成天使+轮融资。
英伟芯科技(西安)由聂辉博士(贝尔实验室、英特尔背景)领衔,做200G硅光PIC、微环OIO与3D光引擎的全栈自研。6.4T CPO符合OPEN CPX MSA(32×224G PAM4、30W功耗预算),并参与中国移动DORA架构,是国内少数直接对标MSA标准的初创。
量引科技(珠海)主要从事硅光PIC、OIO与CPO光芯片,在CPO方向上,与国内头部GPU厂商达成合作并进入PoC阶段,重点攻克接口、GPU和光引擎之间的光电信号转换及协议层适配。2026年5月获珠海科创投数千万元天使轮。
灵熹光子(北京)定位CPO/OIO微环光引擎,已完成单通道500Gb/s微环与16×256Gb/s波分复用验证,3.2T/6.4T光引擎原型在研。2026年2月完成数千万元天使轮。
灵动芯光(深圳)的硅基集成超窄线宽激光器已量产并完成国产替代,在研SmartComb多波长光源与SmartPHY光I/O芯粒,直指CPO的光源共性瓶颈。2026年4月完成数千万元天使++轮。
奇点光子(苏州)提供1.6T、3.2T、6.4T超高速光互联解决方案,并规划单波200G硅光芯片、OIO芯片光互连等前沿产品,产品形态为光电融合的Chiplet。2026年5月完成数千万美元Pre-A轮。
3.2.3 | Micro-LED阵列路线
光擎源(上海)由复旦田朋飞团队与北大沈波团队孵化,金刚石基InGaN Micro-LED将20 um黄光器件在6.25A/cm²下的调制带宽做到2850MHz、1.5Gbps下发射端能效仅0.056pJ/bit。目前正推进CMOS驱动与阵列集成,规划1.6Tbps量级样机。成立于2026年6月,完成数千万元种子轮融资。
星火辰光(北京)2026年9月成立,联合清华大学与元旭半导体打通“外延—芯片—玻璃基封装”,样品在500A/cm²下-3dB带宽达3.5GHz。成立一个月即获红杉中国领投、三安光电跟投的天使轮。
除了刚成立的初创企业,大型LED企业(如华灿光电、三安光电等)以及CIS企业(如思特威)均开始谋求突破,整体以样品研发和客户验证为主,正稳步向商业化推进。
四、总结
CPO的本质是光电转换点向芯片无限靠拢,以光互连突破电互连的带宽密度与能效天花板。驱动因素明确:AI集群Scale-up链路从1米级扩展到30米级,铜缆已触及物理极限;Scale-out交换机端口速率从400G向1.6T演进,可插拔光模块的功耗与可靠性瓶颈日益突出。
技术路线呈现清晰的代际分工。FaN路线(单通道100G+、PAM4调制)依托现有SerDes生态,是当前Scale-out侧CPO量产的主流选择,Broadcom与NVIDIA已率先导入。其中硅光调制器(MZM向MRM演进)为平台厂商采用,VCSEL直调则在能效和成本上具备差异化优势。SaW路线(单通道64G以下、NRZ调制、大量并行通道)通过移除DSP大幅简化电子链路,瞄准Scale-up与OIO的长期需求,微环波分复用、Micro-LED阵列和VCSEL阵列三条子路线各有优劣,尚处技术验证向工程化过渡阶段。
产业格局上,海外由Broadcom、NVIDIA等平台及芯片巨头主导,CPO已从概念验证进入量产爬坡。国内初创企业密集涌现,但整体仍处于送样验证阶段。
估值与预测需要保持审慎,CPO规模由2025年的1亿美元增至2030年的286亿美元,隐含年均增速超过200%,属于乐观情景,不宜作为估值基准。国内部分企业成立数月即完成多轮融资,个别估值已超过10亿美元,热度明显领先于技术兑现。
参考资料:
[1] Byungsoo Kim, et al. Co-packaged optics for high-performance computing and artificial intelligence. Nature Electronics, 2026
[2] 硅谷坐标对话TeraHop于让尘 | https://news.qq.com/rain/a/20260425A038T100
[3] 光电共封走向量产,封装测试成为关键环节. 财通证券 2026
[4] Manuel Kohli, et al. VCSEL-Based Co-Packaged Optics for Scale-Up in A.I. Datacenter — Status and Perspectives. IEEE Communications Magazine, 2026
[5] 光通信系列报告二:光电共封装重构算力互连架构,CPO 开启高密度高能效新时代. 国投证券 2026
[6] Status of High-End Performance Packaging (2.5D & 3D) and Co-packaged optics. Yole, 2025
[7] S. Mondal, et al. A 108 Gbps PAM-4 VCSEL-Based Direct-Drive Optical Engine for Co-Packaged Optics Applications. IEEE Journal of Solid-State Circuits, 2026
[8] Nandish Mehta, et al. All-SMF Arrays for Co-Packaged Optics: Optimizing Cost, Complexity and Performance. IEEE, 2025
[9] S. Amiralizadeh, et al. Co-packaged Optics Technology Evaluation for Hyperscale Data Center Fabric Switches. ECOC, 2025
[10] E. Shaizaf, et al. Enabling Next-Gen AI Infrastructure with Co-Packaged Optics and Advanced Packaging. Ayar Labs / TSMC OIP Ecosystem Forum, 2025
[11] K. Benyahya, et al. MOSAIC: Breaking the Optics versus Copper Trade-off with a Wide-and-Slow Architecture and MicroLEDs. ACM SIGCOMM, 2025
[12] Stojanovic, V., A UCIe optical I/O retimer chiplet for AI scale-up. IEEE Hot Chips 37 Symposium, 2025
END
延伸阅读
北外滩科创会客厅
信熹洞见 · 研究